Java 语言特性:泛型(Generics)
泛型(Generics)是 JDK 5 引入的类型安全检测机制,让编译器在编译期拦截非法的类型,把错误消灭在运行之前。此特性的本质是"参数化类型",即把所操作的数据类型本身当作一个参数,在声明类 / 接口 / 方法时先用占位符(如 T)占位,推迟到创建对象或调用方法时才指定具体类型。接下来我们从需要泛型地的原因开始,具体理解这段话的含义。
一、为什么要使用泛型
1. 类型安全
在没有泛型时,集合 ArrayList 存放的类型是 Object,即所有类的父类,如下图所示:
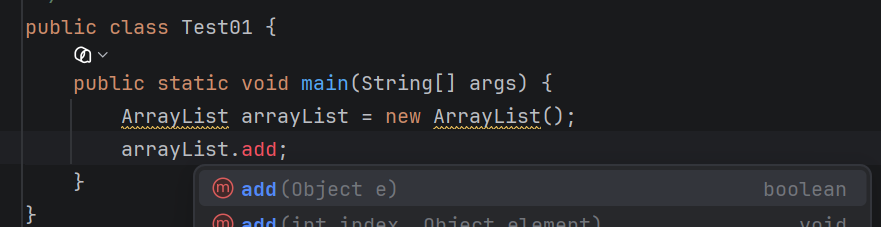
试着在集合中添加三个字符串,运行后能正常输出。
java
public class Test01 {
    public static void main(String[] args) {
        ArrayList arrayList = new ArrayList();
        arrayList.add("111");
        arrayList.add("222");
        arrayList.add("333");
        Iterator iterator = arrayList.iterator();

        while (iterator.hasNext()){
            //System.out.println(iterator.next());

			String str = (String) iterator.next();
			System.out.println(str);
        }
    }
}
集合中每个元素的类型都是 Object,可以通过迭代器直接打印查看,也可以通过类型强转得到每个元素对象。运行结果:
然而,如果我们再往集合中添加一些 String 类型之外的元素,例如:
java
arrayList.add(123);编译阶段不会报错,因为往集合中添加任意类型的元素都是被允许的,问题会在运行时才暴露:
Exception in thread "main" java.lang.ClassCastException: class java.lang.Integer cannot be cast to class java.lang.String
Integer 类型不可被强转为 String 类型,因为它并不是 String 的子类。如何避免这种情况呢?我们就会用到泛型。
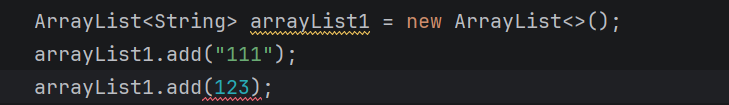
通过在初始化阶段就指定集合存放的类型是 String,即可在编译期就能发现类型错误,从而避免把 ClassCastException 拖到运行期。在没有泛型的时期,程序员只能自己写大量繁琐的强制类型转换,但是这类类型安全问题不能得到解决。
2. 代码复用
除了类型安全,泛型的第二个价值是代码复用 :同一套代码,适配任意类型。
如果我们要写一个 "能存一个元素" 的 Box 类,可以利用泛型轻松实现:
java
public class Box<T> {
    private T value;
    public void set(T v) { this.value = v; }
    public T get() { return value; }
}

Box<String> sb = new Box<>();    // 只装 String 的盒子
Box<Integer> ib = new Box<>();   // 只装 Integer 的盒子
如果没有泛型,我们只能用 Object 实现,只能取出 Object,每次使用都要强转。而泛型仅靠类型参数 T 的不同,就可让同一个 Box 类就"复制" 出针对任意类型的版本 ,这正是 "参数化类型":类型本身成了参数,具体是什么类型在使用处注入。
二、泛型的使用
我们已经通过上面的例子初步接触了泛型的使用方法,接下来我们进一步拓展与深入。
1. 泛型类
泛型类的定义格式为:修饰符 class 类名<类型> (public class Box<T>),其中 T 为任意标识,常见形式有 T、E、K、V 等。
回到我们所举的 Box 类的例子,假设不使用泛型,利用 Box 装载元素时只能指定类型(如指定 value 为 string),但每次要用别的类型就要修改或重新创建对应类;或者我们可以将 value 指定为 Object,如此我们也可以传递不同类型的参数,但如第一节所说,这种做法存在类型安全问题。
再来看泛型类:
java
public class Box<T,E> {
    private T value;
    private E name;

    public E getName() {
        return name;
    }

    public void setName(E name) {
        this.name = name;
    }

    public T getValue() {
        return value;
    }

    public void setValue(T value) {
        this.value = value;
    }
}其中private T value; private E name;与Box<T,E>相对应,即在类中定义的成员属性泛型 T、E 与我们在类上定义的泛型类型是相同的。
java
public class Test {
    public static void main(String[] args) {
        Box<Integer,String> b1 = new Box<>();  // T=Integer, E=String
        b1.setName("abc");
        b1.setValue(123);
        System.out.println(b1.getName());
        System.out.println(b1.getValue());
    }
}需要注意,类型参数只能传引用类型(Integer、Double、Character) ,不能是原始类型(int、double、char),这是因为泛型基于 Object 体系工作,而基本型不是对象,具体细节我们到"类型擦除" 一节再分析。
此外,静态成员不能使用类的类型参数,静态成员属于类本身 ,不依赖任何对象,而类的类型参数 T 只有在创建对象(Box<String>、Box<Integer>)时才被确定。
java
public class Box<T> {
    private static T s;        // 编译错误:'Box.this' cannot be referenced from a static context
    public static T get() { return null; }
}
2. 泛型方法
泛型方法的格式是
java
[修饰符] <T1, T2, ...> 返回类型 方法名(参数列表) {
    // 方法体,T1、T2 可用于参数、返回值和局部变量
}
例如:
java
public class GenericMethodDemo {
    public <T> T show(T t){
        return t;
    }
}调用时一般不需要显式写类型参数 ,编译器从实参自动推断,比如我们只需要写 g.show("abc"),把鼠标放在上面用快捷键ctrl + alt + v,编译器就可判断出 String 类型,自动创建变量。
java
public class Test02 {
    public static void main(String[] args) {
        GenericMethodDemo g = new GenericMethodDemo();
        String abc = g.show("abc");
        Integer show = g.show(123);
        Double show1 = g.show(20.66);
    }
}
为什么需要泛型方法呢?总的来说,泛型方法解决的是 "与类无关的通用算法,如何在保证类型安全的前提下复用" 的问题,我们来具体分析。
如果不使用泛型实现上述的 show 方法,我们可能需要进行多次方法重构以覆盖所有可能的数据类型,如:
java
public class GenericMethodDemo {

    public String show(String s) {
        return s;
    }

    public int show(int s) {
        return s;
    }

    public double show(double s) {
        return s;
    }

}
这造成代码冗余不利于复用,或者使用 Object 接收参数,这会带来类型安全问题。泛型方法同时解决这两个问题个方法,它适配所有类型(代码复用),同时返回精确类型,在编译期检查(类型安全)。
需要注意的是,对比泛型类,泛型方法可用于静态方法 ,一些通用工具方法(排序、查找、交换、集合转换)天然静态,而且它们处理的类型与本类没有关系,例如交换方法,它并不需要知道数据的类型:
java
public static <T> void swap(T[] arr, int i, int j) {
    T temp = arr[i];
    arr[i] = arr[j];
    arr[j] = temp;
}
这使得让 "算法逻辑"与"数据类型"分离,这类解耦使方法应用更加便利广泛,在Java 源码中十分常见,如:
java
// java.util.Arrays
public static <T> List<T> asList(T... a)      // 可变参数泛型方法

// java.util.Collections
public static <T> void sort(List<T> list)     // 注意:T 有上界,后面通配符节展开
public static <T> T max(Collection<? extends T> coll)
此外,在泛型类内部再定义泛型方法,若方法类型参数与类类型参数同名,方法的 T 会遮蔽类的 T。
java
public class Box<T> {
    public T get() { return value; }        // 类的 T

    public <T> T convert(T t) { return t; } // 方法的 T,与类的 T 无关
}
3. 泛型接口
在接口名后面声明类型参数 <T>,这个接口就是泛型接口。与泛型类一样,类型参数在接口体内可用于抽象方法的参数、返回值。其格式为:
java
public interface 接口名<T1, T2, ...> { // 抽象方法中可以使用 T1、T2 }以常见的比较器接口和集合接口为例:
java
// 1. 比较器接口
public interface Comparable<T> {
	int compareTo(T o);
}
// 2. 集合接口
public interface List<E> {
	boolean add(E e);
	E get(int index);
}
实现泛型接口有三种写法。先定义一个简单的打印接口用于演示:
java
public interface Printer<T> {
    public void print(T t);
}第一种实现写法是实现类指定具体类型 ,也是最常见的写法,比如 T 在实现时就确定为 String:
java
public class StringPrinter implements Printer<String>{

    @Override
    public void print(String s) {
        System.out.println(s);
    }
}第二种写法是实现类保留类型参数,此时实现类本身也是泛型类,实现类名后必须写 <T>,T 的类型在使用泛型类时才会决定。
java
public class GenericPrinter<T> implements Printer<T> {
    @Override
    public void print(T t) { System.out.println(t); }
}
最后是部分指定类型参数:
java
public class KeyValueMap<K> implements Map<K, Integer> { ... }接口有两个参数 K、V,实现类只保留 K,把 V 定为 Integer。
三、泛型边界(Bounded Type Parameters)
接下来我们分析泛型边界,这是后面是擦除规则和通配符 PECS 的重要前置知识。
1. 什么是边界
默认的 <T>表示 "任意类型 "。但有时我们希望限定 T 是某个类型或其子类 。这个限定就是边界(bound) ,写 extends:
java
<T extends 上限类型> 注意,这里的 extends 有两层含义和普通的继承不同 ------ 它既表示 "继承某个类 ",也表示"实现某个接口 ",两种都写 extends。
java
<T extends Number>              // T 是 Number 的子类(Integer、Double...)
<T extends Comparable<T>>       // T 实现 Comparable 接口
2. 为什么需要边界
没有边界时,泛型方法内能做的事较为有限,比如说:
java
public static <T> T max(T a, T b) {
    return a.compareTo(b) > 0 ? a : b;   // 编译错误
}
在后面学习擦除后我们会了解到,<T>没有边界,擦除后 T 是 Object,而 Object 没有 compareTo 方法,编译器不允许调用。此时 T 只能调用 Object 的方法(toString、equals、hashCode)。
但如果加上边界,我们可以让 T 至少是 Comparable 的实现类 ,于是编译器允许调用compareTo 方法:
java
public static <T extends Comparable<T>> T max(T a, T b) {
    return a.compareTo(b) > 0 ? a : b;   // 编译通过
}可以发现,边界的作用是在保证类型安全的前提下,拓宽类型参数的能力范围。
3.多个边界
一个类型参数可以有多个上限 ,接口边界可以多个,用 & 连接,但是类边界最多一个 ,且必须写在最前面,因为类是单继承的。
java
public class Demo<T extends Number & Comparable<T>> {
    // T 必须同时满足:是 Number 的子类 + 实现了 Comparable<T>
}
四、类型擦除(Type Erasure)
1. 定义与规则
擦除指的是:泛型信息只存在于编译期 。编译完成后,字节码里的类型参数会被替换为它的边界。"擦除到哪里"取决于上限。
| 声明 | 擦除结果 |
|---|---|
| <T> | Object |
| <T extends Number> | Number |
| <T extends Number & Comparable<T>> | Number |
2. 擦除的机制
擦除将类型参数 T 用它的上限替换,例如对于原来的 Box<T> ,编译后"相当于"变为:
java
class Box {
    private Object value;            // T → Object
    public void set(Object v) { this.value = v; }
    public Object get() { return value; }
}
问题来了:get() 返回 Object,调用方拿到的又是任意子类的引用,是不是退回到裸类型了呢?其实不然,用 get() 方法时编译器自动补强转,相当于:
java
Box box = new Box();                     // 类型参数擦除
box.set("hello");
String s = (String) box.get();           // 编译器强转
强转由手写变成了编译器代劳,而且编译器能保证这个强转一定安全,因为第一步已经拦住了错误类型。
我们可以通过一段程序来直观地看到擦除的效果和机制:
java
public class ErasureProof {
    public static void main(String[] args) throws Exception {
        // 运行时无法区分"泛型不同"的两个列表
        List<String> strList = new ArrayList<>();
        List<Integer> intList = new ArrayList<>();

        System.out.println("strList 与 intList 运行时是同一个类吗? "                + (strList.getClass() == intList.getClass()));
        System.out.println("运行时真实类型:" + strList.getClass().getName());

        // 反射绕过编译期检查
        add.invoke(strList, 123);   // 运行时检查不存在,塞入成功
        System.out.println("反射绕过泛型检查后 strList = " + strList);
    }
}
先看运行结果:
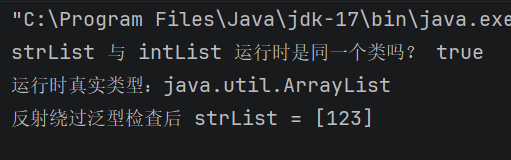
对于第一段程序,两个 "泛型不同" 的列表,运行时是同一个类 (java.util.ArrayList)。如果泛型信息在运行时未被擦除,List<String> 和 List<Integer> 应该是两个不同的类,但它们不是。
再看第二段程序,我们通过反射拿到 add(Object) 方法,绕过编译期检查,成功把 Integer 123 塞入了 List<String>,这是因为运行时没有泛型检查,从反面证明泛型的全部约束都在编译期。
3. 擦除的作用
那么 Java 泛型为什么需要擦除呢?这并不是因为泛型本质需要擦除,而是与 Java 的历史生态有紧密联系。
Java 5 之前已有大量编译好的 .class 文件和类库,如果 Java 5 让 List<String> 和 List<Integer> 在运行时变成不同类,JVM、类文件格式、方法描述符、反射、链接规则都要进行大幅修改,导致旧字节码可能无法运行。
而正如上方代码所示,擦除后泛型的标签与旧版本基本一致,从而实现二进制兼容 。同时,擦除还实现了源码兼容 和渐进迁移 ,像用原始类型的旧代码List list = new ArrayList();,虽然有unchecked警告,但还是可以编译,给了企业和类库逐渐泛型化的空间。
此外,擦除避免了大幅修改 JVM 类型系统。JVM 原本不认 List<String> 等参数化类型,擦除让 JVM 可以继续只处理原始类型(List 、ArrayList、Object、Number)。而泛型的类型安全主要由 javac 保证。
由此我们大致了解了,泛型擦除是 Java 的历史兼容性选择,让 Java 5 在不推翻旧 JVM、旧类库、旧字节码的前提下加入泛型。
当然,擦除不是没有代价的,它有诸多限制。以下写法错误都是因为擦除机制,我们现在可以有更加清晰的认知了:
java
T t = new T();                 // 运行时不知道 T 的构造器,new Object()无意义
T.class                        // 类型参数不能当类字面量
instanceof List<String>        // instanceof是运行时判断,只能 instanceof List<?>
new List<String>[10]           // 泛型数组不安全,数组需要运行时元素类型
static T field;                // 静态上下文没有类的类型参数
方法重载也会冲突:
java
void f(List<String> list) {}
void f(List<Integer> list) {}
擦除还会带来堆污染隐患(一个参数化类型的变量,引用了一个内部状态不符合该参数化类型的对象。)如果我们绕过泛型:
java
List<String> list = new ArrayList<>();
List raw = list;
raw.add(1);             // 编译警告,但可以运行
String s = list.get(0); // 运行时 ClassCastException最后需要澄清:运行时并不是完全没有泛型信息 ,只有类 / 接口定义上声明的泛型 ,会存放在字节码 Signature 属性,反射 API 可以读取。
java
// 定义带泛型的父类
public class MyList extends ArrayList<String>{}

public class Test {
    public static void main(String[] args) {
        // 获取父类泛型参数String
        Type type = MyList.class.getGenericSuperclass();
        ParameterizedType pt = (ParameterizedType) type;
        System.out.println(pt.getActualTypeArguments()[0]);
        // 输出:class java.lang.String
    }
}
五、桥方法(bridge method)
桥方法是 编译器自动生成的合成方法,用来在"源码层面的重写"和"JVM 层面的方法描述符"之间搭桥。它可以用于解决泛型擦除带来的"签名冲突"问题:擦除会让父类方法签名变宽,子类具体方法签名变窄,JVM 就不再认为它们是同一个方法。下面我们具体来看擦除带来了什么问题,桥方法又是如何填补这个裂缝的。
Java 语言层面的 "重写" 是编译期概念 ,按方法签名(方法名 + 参数列表)判断。返回类型必须相同,或协变 ,比如父类返回 Object,子类返回 String。同时泛型参数可以具体化,比如父类 T get(),子类 String get()。
而JVM 层面的 "重写" 是运行时方法选择 ,按方法描述符(方法名 + 参数类型 + 返回类型 )严格匹配,只要描述符不同,JVM 就认为这是两个不同方法。
这种差异就带来了问题:
java
class Box<T> {
    T get() { return null; }
}

class StringBox extends Box<String> {
    @Override
    String get() { return "hello"; }
}
源码上,StringBox.get() 确实重写了 Box<String>.get()。
但擦除后:
java
class Box {
    Object get() { ... }
}

class StringBox extends Box {
    String get() { ... }
}
两个 get() 方法的方法描述符如下:
Box.get()Ljava/lang/Object;StringBox.get()Ljava/lang/String;
它们的返回类型不同,描述符自然不同。 所以 JVM 层面不认为 StringBox.get() 重写了 Box.get()。
或者我们换一种方式,用父类引用调用:
java
Box<String> box = new StringBox();
String s = box.get();
编译后相当于:
java
Box box = new StringBox();
String s = (String) box.get();这里box.get()在 JVM 层面依然会去找Box.get()Ljava/lang/Object;,但StringBox里只有get()Ljava/lang/String;。如果没有桥方法,就会调用到父类的Box.get(),就不存在多态了。
所以编译器必须在StringBox里额外生成一个桥方法:
java
Object get() {
    return this.get(); // 实际调用 String get()
}
父类方法的参数类型或返回类型是泛型都需要生成对应的桥方法:
java
class StringBox extends Box {
    String get() { ... }

    // 桥方法:重写 Box.get()Object
    @Override
    Object get() {
        return get(); // 调用 String get()
    }

    void set(String value) { ... }

    // 桥方法:重写 Box.set(Object)
    @Override
    void set(Object value) {
        set((String) value); // checkcast 后调用 String set(String)
    }
}需要注意,桥方法在源码里并不存在 ,因为 Java 语言不允许仅返回类型不同来重载。它只存在于字节码中 。
此外,桥方法不只为泛型服务,协变返回类型也会产生桥方法。
java
class Parent {
    Object get() {
        return null;
    }
}

class Child extends Parent {
    @Override
    String get() { // String 是 Object 的子类,协变返回
        return "x";
    }
}编译器自动给子类Child生成桥方法:
java
Object get() {
    return get(); // 调用 String get()
}
接口泛型的桥方法也是类似的,此处不再赘述。
之前提到的擦除带来的源码层面的限制,桥方法不能解决,它只能解决 JVM 重写描述符不一致的问题。
六、通配符(Wildcards)
1. 为什么需要通配符
泛型具有一个重要性质------不变性。我们来看一个集合的例子:
java
void printList(List<Object> list) { ... } List<String> names = new ArrayList<>(); printList(names); // 编译错误如果这里用Object[]和String[],虽然有类型安全问题,但是编译可以通过。然而List<String> 和 List<Object> 在泛型体系里是两个完全不同的类型 ,没有继承关系,不可协变,这就是泛型的不变性。如果允许赋值,集合中就可以加入 Integer 等其他类型的元素,引发堆污染。
但现实中我们经常需要"能接收任意 List" 的方法,这时就需要通配符 ?。通配符有三种类型。
2. 无界通配符 ?
java
static void printList(List<?> list) { ... }List<?>表示 "元素类型未知的列表"。它能接收一切 List ,但是读写都受限 。
它只能读出 Object 类,因为?是 "未知类型",唯一确定的只有它是对象,自然不能转为其他类型。
而"写"同理,集合中只能写入 null 。当写 List<?> 时,编译器会把它捕获成一个具体的、未知的、固定不变的类型变量 ,命名为CAP#1,即编译器的 "捕获转换(capture conversion) ",CAP#1 是一个具体类型,但它是不确定的。只有null能转换成任何引用类型,因此它是唯一合法的写入。
3. 上界通配符 ? extends T
java
List<? extends Number> list;这表示 list 是某种Number子类型的列表,具体是List<Integer>还是List<Double>等是未知的。
java
List<Integer> ints = new ArrayList<>();
List<Double> doubles = new ArrayList<>();
List<Number> nums = new ArrayList<>();

List<? extends Number> a = ints;    // 可以
List<? extends Number> b = doubles; // 可以
List<? extends Number> c = nums;    // 可以,Number 是 Number 的子类型
上界通配符的特点是**"只读"**:
java
Number n = list.get(0); // 可读,因为里面至少是 Number 类型的数据只读意味着它不能写:
java
list.add(1);      // 编译错误
list.add(3.14);   // 编译错误
list.add(null); // 可以,null 是唯一例外原因与无界通配符不可写类似,编译器无法知道list到底是List<Integer>还是List<Double>,这会带来类型安全问题。
因此,? extends T被称为 生产者(Producer):它只能从中读数据,不能写数据。
4. 下界通配符 ? super T
java
List<? super Integer> list;这表示 list 是某种Integer父类型的列表,比如List<Integer>、List<Number>、List<Object>。
java
List<Integer> ints = new ArrayList<>();
List<Number> nums = new ArrayList<>();
List<Object> objs = new ArrayList<>();

List<? super Integer> a = ints; // 可以
List<? super Integer> b = nums; // 可以
List<? super Integer> c = objs; // 可以
下界通配符的特点是**"能写"**:
java
list.add(123); // 可以,因为 123 是 Integer 不管list实际是 List<Integer>、List<Number> 还是 List<Object>,Integer都能放进去。对于 List<? super Integer>,唯一能安全添加的非 null 类型 是 Integer (以及它的子类,但 Integer 是 final,没有子类)。
而它读只能读成 Object :
java
Object o = list.get(0); // 只能读成 Object这是因为编译器只知道它是 Integer 的某个父类型,不知道具体是Integer、Number 还是 Object ,只能保证读出来是 Object。
总的来说,? super T可以写,但读出来只能当 Object 。它适合 "往里放元素" 的场景,被称为消费者(Consumer)。
5. PECS 原则
PECS 是 Producer Extends, Consumer Super 的缩写,它回答了**什么时候用? extends T,什么时候用? super T**的问题:如果这个泛型容器是"生产者",只从里面读数据,用? extends T。反之如果这个泛型容器是"消费者",只往里面写数据,用? super T。如果既读又写,用具体类型参数<T>。
**"读"关心的是从容器里读取的数据能赋给什么类型的变量,因此它需要一个上界T保证读的元素都是其子类,用T接收是安全的;而 "写"**关心的是容器的元素类型能否装下要写的数据,因此它需要一个下界T,保证写入T类数据是安全的。
我们来看PECS 最经典的例子: Collections.copy
java
public static <T> void copy(List<? super T> dest, List<? extends T> src) {
    for (int i = 0; i < src.size(); i++) {
        dest.set(i, src.get(i));
    }
}其中src是源,需要从里面读数据(生产者),所以用? extends T,dest是目标,要往里面写数据(消费者),所以用? super T。
调用感受一下:
java
List<Number> dest = new ArrayList<>();
List<Integer> src = Arrays.asList(1, 2, 3);
Collections.copy(dest, src);
T 被推断为 Number。src是List<Integer>,满足? extends Number,dest是List<Number>,满足? super Number。
假设我们把通配符都换成具体类型参数:
java
public static <T> void copy(List<T> dest, List<T> src)那么dest和src必须是同一种 T。 List<Number>和List<Integer>不满足,调用会失败。可见 PECS 让 API 更灵活。
当然,PECS 只适用于 "单方向 " 操作的场景。如果方法既读又写,通配符就不再不适用,我们直接用具体类型参数,例如排序:
java
// 既要读(比较大小)又要写(交换位置)
public static <T extends Comparable<? super T>> void sort(List<T> list)
这里我们额外看一下 Comparable<? super T> 不是 Comparable<T>:
java
class Fruit implements Comparable<Fruit> {
    public int compareTo(Fruit other) { ... }
}

class Apple extends Fruit {
    // Apple 没有实现 Comparable<Apple>
}Apple继承了Fruit的compareTo(Fruit)。 如果要求T extends Comparable<T>,那么Apple不满足Comparable<Apple>。 但Apple实现了Comparable<Fruit>,自然满足Comparable<? super Apple>,因为Fruit是Apple的父类,且Fruit implements Comparable<Fruit>。这和我们之前提到的写场景应用是一回事,只是这里"消费"不是在集合,而是把 Apple 作为参数传给compareTo。
七、总结
泛型是 Java 里少有的"表面语法简单、底层机制复杂"的语言特性。它用编译期的类型检查换来了运行时的兼容,在字节码中涉及擦除、强转桥方法等。通配符和 PECS 又使其在不变性之上有了灵活性。类文件中保留的签名则应用于反射与框架生态。泛型还有很多能够更深入挖掘的空间,读者可以自行探索。