前言
在生产环境的数据库运维与后端研发中,Lock wait timeout exceeded; try restarting transaction 是一个出现频率极高且破坏性较强的异常。当系统抛出此错误时,通常意味着数据库的并发处理能力正在受到严重阻碍,若不及时干预,极易引发连接池耗尽和应用雪崩。
一、 问题现象与报错特征
在应用日志中,该异常通常伴随 ORM 框架(如 MyBatis、Hibernate)的 SQL 执行失败堆栈出现。典型的报错信息如下:
text
org.springframework.dao.CannotAcquireLockException:
### Error updating database.  Cause: com.mysql.cj.jdbc.exceptions.MySQLTransactionRollbackException:
Lock wait timeout exceeded; try restarting transaction
### SQL: UPDATE order_info SET status = ?, update_time = ? WHERE order_no = ?
### Cause: com.mysql.cj.jdbc.exceptions.MySQLTransactionRollbackException:
Lock wait timeout exceeded; try restarting transaction核心特征:
- 发生在
UPDATE、DELETE等写操作上,或带有SELECT ... FOR UPDATE的读操作上。 - 当前事务试图获取某一行或某几行的排他锁(X锁),但该锁正被另一个未提交的事务持有。
- 等待时间超过了 MySQL 系统变量
innodb_lock_wait_timeout(默认 50 秒)的阈值,InnoDB 主动中断当前等待事务并抛出回滚异常。
二、 底层原理解析
要彻底解决锁等待超时,必须理解 InnoDB 的行锁机制。
InnoDB 的行锁是基于索引 实现的。当执行更新操作时,InnoDB 会扫描 SQL 语句中 WHERE 条件涉及的索引:
- 如果
WHERE条件命中了索引,InnoDB 只会对命中的索引记录加锁(行锁)。 - 如果
WHERE条件没有命中索引 ,或者发生了隐式类型转换 导致索引失效,InnoDB 将退化为全表扫描。在 RR(可重复读)隔离级别下,这会对扫描到的每一行加锁,实质上等同于表锁。
当发生锁冲突时,后续的事务会进入锁等待队列。如果持有锁的事务迟迟不释放(Commit 或 Rollback),等待队列中的事务就会在达到 innodb_lock_wait_timeout 设定的时间后超时崩溃。
三、 紧急止血:生产环境排查与恢复 SOP
当生产环境爆发此问题时,第一要务是紧急止血,恢复系统可用性,其次才是定位代码缺陷。
1. 定位阻塞源
通过查询 information_schema 库,可以快速定位当前正在运行且持有锁的长事务。
sql
-- 查询当前所有正在运行的事务,按启动时间升序排列
SELECT
    trx_id,
    trx_state,
    trx_started,
    trx_mysql_thread_id,
    trx_query,
    trx_rows_locked
FROM information_schema.INNODB_TRX
ORDER BY trx_started ASC;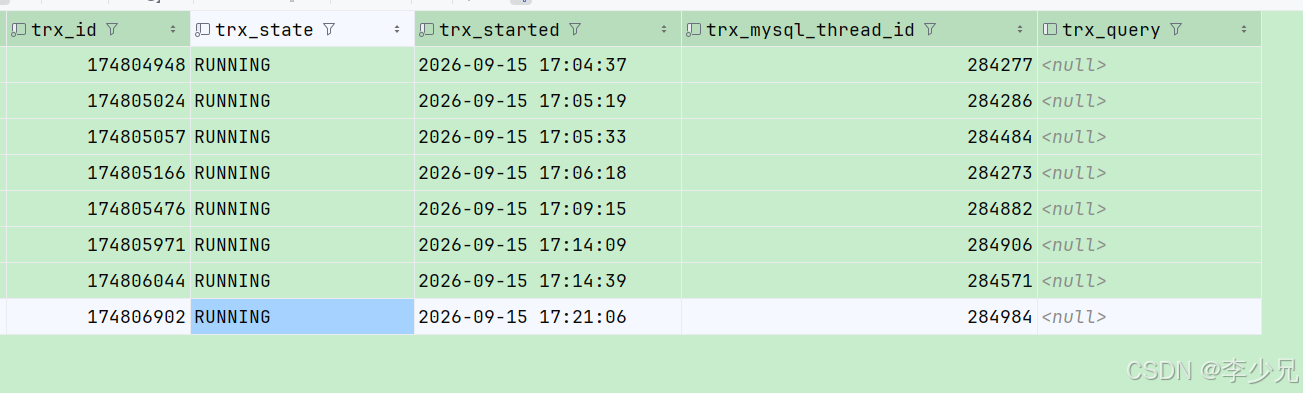
关键指标分析:
trx_started:如果某个事务的启动时间距离当前时间已经过去了几分钟甚至更久,这绝对是一个异常的"长事务"。trx_query:如果该字段为<null>,通常意味着该线程当前并没有在执行具体的 SQL,而是事务开启后,控制权交还给了应用层,应用层正在执行非数据库操作(如网络请求),或者连接被闲置但未提交。trx_mysql_thread_id:这是 MySQL 内部的线程 ID,用于后续 KILL 操作。
2. 执行 KILL 操作
找到导致阻塞的根源线程 ID(通常是运行时间最长、且状态为 RUNNING 的那个),直接终止它,释放其持有的行锁。
sql
-- 假设查出的异常 trx_mysql_thread_id 为 88492
KILL 88492;
注:KILL 掉线程后,MySQL 会自动回滚该线程未提交的事务,等待队列中的其他事务即可获取锁继续执行。
3. 深度锁等待关系分析(MySQL 8.0+)
在 MySQL 8.0 中,推荐使用 performance_schema 下的数据锁表来精准分析"谁阻塞了谁"。
sql
SELECT
    r.trx_id AS waiting_trx_id,
    r.trx_mysql_thread_id AS waiting_thread,
    r.trx_query AS waiting_query,
    b.trx_id AS blocking_trx_id,
    b.trx_mysql_thread_id AS blocking_thread,
    b.trx_query AS blocking_query
FROM performance_schema.data_lock_waits w
INNER JOIN information_schema.innodb_trx b ON b.trx_id = w.blocking_engine_transaction_id
INNER JOIN information_schema.innodb_trx r ON r.trx_id = w.requesting_engine_transaction_id;
通过上述 SQL,可以清晰地看到 blocking_thread(阻塞者)和 waiting_thread(等待者)的对应关系。
四、 根因剖析
排查出长事务只是表象,真正的根源往往隐藏在应用层的代码设计中。以下是导致该问题的四大典型场景及重构方案。
场景一:大事务包裹外部耗时调用(最常见原因)
在带有 @Transactional 注解的方法中,执行了数据库更新操作,随后又调用了外部 HTTP 接口或发送 MQ 消息。如果外部接口响应缓慢,数据库连接和行锁将被长时间挂起。
错误示范:
java
@Service
public class OrderService {

    @Autowired
    private OrderMapper orderMapper;
    @Autowired
    private LogisticsClient logisticsClient;

    // 错误:事务边界过大,包含了网络 IO
    @Transactional(rollbackFor = Exception.class)
    public void confirmOrder(String orderNo) {
        // 1. 更新订单状态(此时 InnoDB 对该行加 X 锁)
        orderMapper.updateStatus(orderNo, "CONFIRMED");

        // 2. 调用物流系统下发发货单(假设耗时 3 秒,若网络抖动可能耗时 60 秒)
        logisticsClient.dispatchDelivery(orderNo);

        // 3. 发送 MQ 消息通知下游
        mqProducer.send("ORDER_CONFIRMED_TOPIC", orderNo);

        // 直到方法执行完毕,事务提交,行锁才会释放。
        // 若 logisticsClient 超时,行锁将被持有数十秒,导致其他查询或更新该订单的请求全部阻塞。
    }
}正确示范:
严格缩小事务边界,将非数据库操作(网络 IO、文件 IO、复杂计算)剥离出事务之外。
java
@Service
public class OrderService {

    // 正确:事务仅包裹纯粹的 DB 操作
    @Transactional(rollbackFor = Exception.class)
    public void doUpdateOrderStatus(String orderNo) {
        orderMapper.updateStatus(orderNo, "CONFIRMED");
    }

    public void confirmOrder(String orderNo) {
        // 1. 先执行本地事务,快速提交并释放行锁
        doUpdateOrderStatus(orderNo);

        // 2. 事务提交后,再执行外部调用(此时即使耗时,也不会占用 DB 行锁)
        logisticsClient.dispatchDelivery(orderNo);
        mqProducer.send("ORDER_CONFIRMED_TOPIC", orderNo);
    }
}
进阶技巧 :如果业务要求强一致性,必须保证外部调用和 DB 操作同成功同失败,应引入本地消息表 或事务消息等最终一致性方案,坚决杜绝在事务中同步等待外部网络响应。
场景二:索引缺失或失效导致"行锁"退化为"表锁"
更新语句的 WHERE 条件字段没有建立索引,或者传入的参数类型与数据库字段类型不匹配,导致隐式转换。
错误示范:
sql
-- 假设 user_phone 字段是 VARCHAR 类型,且建有普通索引
-- 错误写法:传入数字类型,导致 MySQL 对 user_phone 进行隐式转换,索引失效
UPDATE user_account SET balance = balance - 100 WHERE user_phone = 13800138000;
后果 :InnoDB 无法走索引,只能进行全表扫描。在扫描过程中,它会对表中的每一行都尝试加锁。这会导致整个表被锁住,任何并发更新都会引发 Lock wait timeout。
解决方案:
- 检查执行计划:使用
EXPLAIN分析 UPDATE 语句,确保type不是ALL,且key列显示了正确的索引。 - 保证类型一致:Java 实体类中的字段类型必须与数据库表结构严格对应,避免传入
Long去匹配VARCHAR。 - 补齐索引:对于频繁作为更新条件的字段,务必建立合适的索引。
场景三:循环中执行数据库操作
在 for 循环中逐条执行 UPDATE 操作,且整个循环被包裹在一个大事务中。
错误示范:
java
@Transactional(rollbackFor = Exception.class)
public void batchUpdateStock(List<StockDTO> list) {
    // 错误:在循环中频繁获取和释放行锁,且事务持续时间随 list 大小线性增长
    for (StockDTO dto : list) {
        stockMapper.deductStock(dto.getSkuId(), dto.getCount());
    }
}
如果 list 包含 1000 条数据,这个事务将持有极长的时间,且极易引发死锁。
正确示范:
使用批量更新语法,或分批次提交事务。
java
@Autowired
private TransactionTemplate transactionTemplate;

public void batchUpdateStock(List<StockDTO> list) {
    // 每 200 条提交一次事务
    List<List<StockDTO>> partitions = ListUtils.partition(list, 200);
    for (List<StockDTO> batch : partitions) {
        transactionTemplate.execute(status -> {
            stockMapper.batchDeductStock(batch);
            return null;
        });
    }
}
场景四:客户端或连接池事务未正常提交
除了代码逻辑问题,运维和测试环节也常引发此问题:
- 客户端未提交 :开发人员在 Navicat/DBeaver 等工具中执行了
BEGIN; UPDATE ...,但忘记点击"提交"或"回滚",直接关闭了查询窗口。这会导致该行数据被永久锁定,直到 DBA 介入 KILL。 - 连接池配置不当 :应用异常崩溃,导致数据库连接未被正常归还,事务未正常结束。需确保 HikariCP 或 Druid 等连接池开启了连接泄漏检测(如
leakDetectionThreshold)。
五、 防御与规范
解决单次报错只是治标,建立规范的防御体系才是治本。
1. 严禁盲目调大超时参数
很多开发者在遇到此问题时,第一反应是修改 MySQL 参数:
sql
SET GLOBAL innodb_lock_wait_timeout = 120;这是极其危险的做法 。调大超时时间只是掩盖了长事务的问题,会导致大量请求线程堆积在 Tomcat/Undertow 的工作队列中,最终耗尽应用服务器的线程池,引发系统级雪崩。默认值 50s 已经足够长,通常建议在生产环境将其设置为 10s ~ 30s,让阻塞快速失败,保护系统整体可用性。
2. 建立长事务监控告警
在数据库监控平台(如 Prometheus + Grafana,或云厂商 RDS 控制台)配置长事务告警。
- 告警规则 :当
INNODB_TRX表中存在trx_started超过 5 秒(或 10 秒)的事务时,触发告警。 - 这样可以在事务引发大面积
Lock wait timeout之前,提前介入处理。
3. 推行乐观锁替代悲观锁
对于高并发下的状态流转或余额扣减场景,尽量减少使用 SELECT ... FOR UPDATE 这种悲观锁机制。可以通过引入 version 字段实现乐观锁:
sql
-- 更新时携带版本号,若版本号不匹配则更新失败,由应用层重试
UPDATE account
SET balance = balance - 100, version = version + 1
WHERE id = 1 AND version = 5;
这种方式完全避免了数据库层面的行锁等待,将并发冲突的处理上移到了应用层,极大提升了数据库的吞吐量。