关键词:学工系统,学生工作台,数据集成,流程引擎,行为预警,微服务,权限模型
**摘要:**高校学工系统本质是把分散的学生业务数据打通并工程化。本文从架构视角拆解:学籍、缴费、门禁等源头如何用 CDC 接入统一数据模型,审批流如何用 BPMN 流程引擎编排,预警如何用规则引擎落地,以及 RBAC 加数据范围的权限设计、API 网关与高可用要点。
为什么学工系统难做
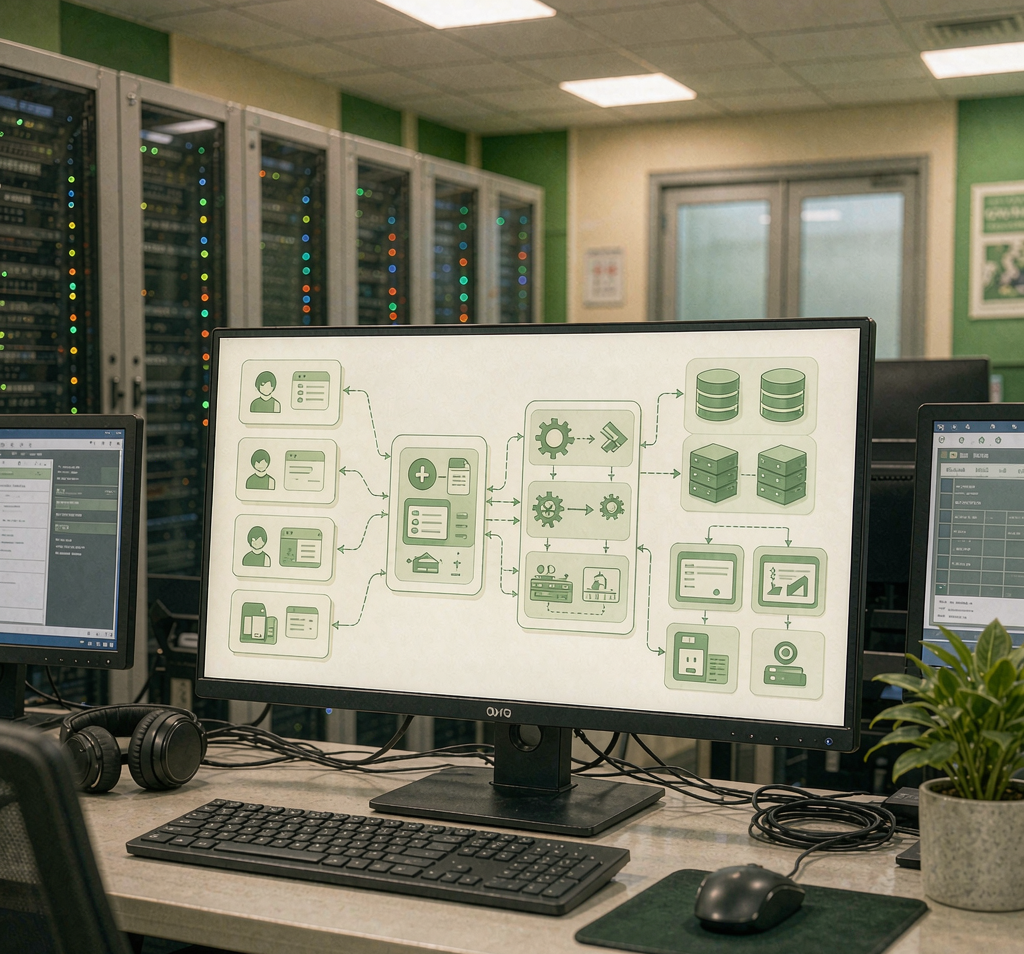
学工系统的难点不在单点功能,而在数据散。学籍在教务库、缴费在财务库、门禁在一卡通、消费在后勤库,彼此没有统一主键,同一学生在不同系统里是不同编号。要做统一工作台,第一步是把这些源用变更数据捕获(CDC)近实时同步到中间层,再用学号作为唯一键归并成统一学生视图。归并时要处理脏数据:空格学号、重复档案、转专业后的历史归属,这些都是上线前必须清洗的坑。
统一数据模型是地基
把多源数据归并后,需要一个稳定的学生主题模型:基础信息、学籍状态、缴费状态、住宿、门禁、消费、奖惩。模型用宽表加维度表的方式落地,宽表供看板查询,维度表供下钻。这里的关键是字段口径一致,比如"在校"的定义要覆盖休学、保留学籍等边界状态,否则预警会漏判。模型一旦定下,上层应用都围绕它开发,后续加事务类型不必改表结构。
流程引擎编排审批
奖助、请假、转专业这些事务本质是工作流。用 BPMN 流程引擎比在业务代码里写状态机更稳:每个环节是节点,审批人是候选人,会签、或签、退回都能配置。流程定义外置成 XML,学工老师改环节不用动代码。难点在并发与回退:同一申请被多人同时处理要加锁,退回要保留历史轨迹供审计。引擎要做好任务表分库,开学季请假高峰才不会卡。
预警的规则引擎实现
行为预警适合用规则引擎而不是写死判断。把"连续三天晚归""月消费低于阈值""门禁一周异常"做成规则 DSL,每条规则含指标、窗口、阈值、动作。调度器按 cron 跑批,命中后生成预警工单推给对应辅导员。规则要支持灰度:先观察不推送,验证准确率再上线。命中率太低会淹没辅导员,太高又漏判,阈值靠历史数据回测定,别拍脑袋。
权限与数据范围
学工数据敏感,权限不能只做功能级。用 RBAC 加数据范围:辅导员只看自己所带班级,学院书记看本学院,学工处长看全校,范围用部门树映射。行级权限在查询层注入,避免前端绕过。操作要留全量审计日志,谁看了谁的记录、改了哪条预警都可追溯。涉密字段如消费明细要做脱敏,列表展示掩码,详情才解密。
高可用与接口治理
学工系统面向全校师生,开学季是流量高峰。网关做限流与鉴权,读多写少用缓存扛看板,写操作走消息队列削峰。服务拆成学生视图、流程、预警、报表几个微服务,各自独立部署独立扩容。数据库主从分离,报表查询走从库不抢主库。灰度发布加健康检查,单服务挂了不影响填报。监控要覆盖同步延迟,CDC 断了看板会旧,得有告警。
监控与可观测性常被忽视。学工系统上线后,要盯的不只是接口成功率,还有 CDC 同步延迟、流程任务积压、预警命中率这些业务指标。建议把同步延迟和预警命中率也接入监控看板,设阈值告警。一次迎新高峰就能暴露同步链路和队列的瓶颈,提前压测比事后救火划算。
值得一提的是,学工系统的数据模型最好预留扩展位。奖学金、心理、就业这些业务会不断加进来,模型若每次都要改表就太脆。用宽表加扩展字段或 JSON 明细承载变动属性,新增事务类型只配不开发,系统才跟得上学校业务的变化节奏。这点在上线前想清楚,后面少返工,也少求着厂商排期改结构。数据层稳了,流程层和预警层才有底气持续生长,整体架构才经得起业务演进的考验,不至于每学期都推倒重来。
工程落地还有一点常被忽略:灰度。新流程和新规则先在小范围学院试运行,观察同步延迟、命中率、老师反馈,再全校推开。灰度能把大问题拆成小问题,出问题影响面可控,也便于边跑边调,比一次性全量上线稳得多。