🌟🌟 欢迎来到我的技术小筑,一个专为技术探索者打造的交流空间。在这里,我们不仅分享代码的智慧,还探讨技术的深度与广度。无论您是资深开发者还是技术新手,这里都有一片属于您的天空。让我们在知识的海洋中一起航行,共同成长,探索技术的无限可能。
🚀 探索专栏:学步_技术的首页 ------ 持续学习,不断进步,让学习成为我们共同的习惯,让总结成为我们前进的动力。
🔍 技术导航:
- 人工智能:深入探讨人工智能领域核心技术。
- 自动驾驶:分享自动驾驶领域核心技术和实战经验。
- 环境配置:分享Linux环境下相关技术领域环境配置所遇到的问题解决经验。
- 图像生成:分享图像生成领域核心技术和实战经验。
- 虚拟现实技术:分享虚拟现实技术领域核心技术和实战经验。
🌈 非常期待在这个数字世界里与您相遇,一起学习、探讨、成长。不要忘了订阅本专栏,让我们的技术之旅不再孤单!
💖💖💖 ✨✨ 欢迎关注和订阅,一起开启技术探索之旅! ✨✨
文章目录
- 背景介绍
- [DDS 解决的核心问题](#DDS 解决的核心问题)
- 以数据为中心的架构思想
- 去中心化发现机制
- [QoS:DDS 最重要的配置层](#QoS:DDS 最重要的配置层)
- 一个简单的发布/订阅示例
- [带基本 QoS 的 Cyclone DDS 示例](#带基本 QoS 的 Cyclone DDS 示例)
- 典型应用场景
- [常见的 DDS 实现](#常见的 DDS 实现)
- 调优与排障时需要关注的点
- 与其他通信方式的对比
- 总结
背景介绍
在机器人、自动驾驶、工业控制、航天器以及一些大型仿真平台里,系统通常不是简单的一对一通信。一个感知模块发布的障碍物列表,可能同时被规划、预测、显示、日志记录等多个节点消费;底盘控制模块发出的状态,也会被故障诊断、运动控制和人机交互订阅。传统做法往往是用 TCP 或 UDP 自己定义一套消息协议,再加上点对点连接、心跳、重连、序列化、线程调度等逻辑。系统小的时候还可以维护,但一旦节点数量增加,通信拓扑会迅速变得复杂。
这类系统的共性是:参与者对"某类数据什么时候出现"感兴趣,而不关心对端进程在哪个主机上,也不希望把精力花在建立连接、转发消息和处理断线上。ROS 2 在选择中间件时放弃了自研的底层通信协议,转而采用 DDS,也是出于这个原因。DDS 的全称是 Data Distribution Service,中文一般叫数据分发服务。它最初来自 OMG 的规范体系,后来在实时性和可靠性要求较高的领域得到了大量使用。
与常见的消息队列不同,DDS 并不是一个中心化的 Broker。发布者和订阅者之间直接通信,没有像 Kafka、RabbitMQ 那样必须依赖一个持续运行的消息服务进程。这个特点在机器人系统和分布式控制系统中很重要,因为这类系统通常要求数据链路尽量短,同时不能让一个中心节点成为单点故障。
DDS 解决的核心问题
如果用一个比较直白的说法概括,DDS 解决的是"分布式系统里不同节点之间如何可靠、实时、低耦合地共享数据"的问题。
假设一个机器人系统里有一个激光雷达节点,它持续发布点云数据。下游的建图模块、避障模块和可视化模块都需要这份数据,但它们关心的细节并不一样:建图模块可能要求可靠传输,不能丢帧;避障模块更在意低延迟,宁可丢掉旧点云,也要尽快拿到最新一帧;可视化模块只要周期性看到画面即可,对带宽消耗比较敏感。
如果直接使用 TCP 连接,开发人员需要自己处理这些问题:谁先启动?断线后怎么恢复?多播还是单播?每一类数据的可靠性策略是否一样?不同订阅者要不要分别维护队列?这些逻辑如果散落在业务代码里,系统规模越大越难维护。
DDS 把这些内容抽象成了发布/订阅模型和一组 QoS 策略。通信的双方只需要约定 Topic 和数据类型,再把各自的可靠性、历史缓存、生命周期等需求表达出来,底层中间件就会负责匹配、连接、传输和资源管理。也就是说,DDS 把很多分布式通信里容易重复实现的基础能力前移到了中间件层。
以数据为中心的架构思想
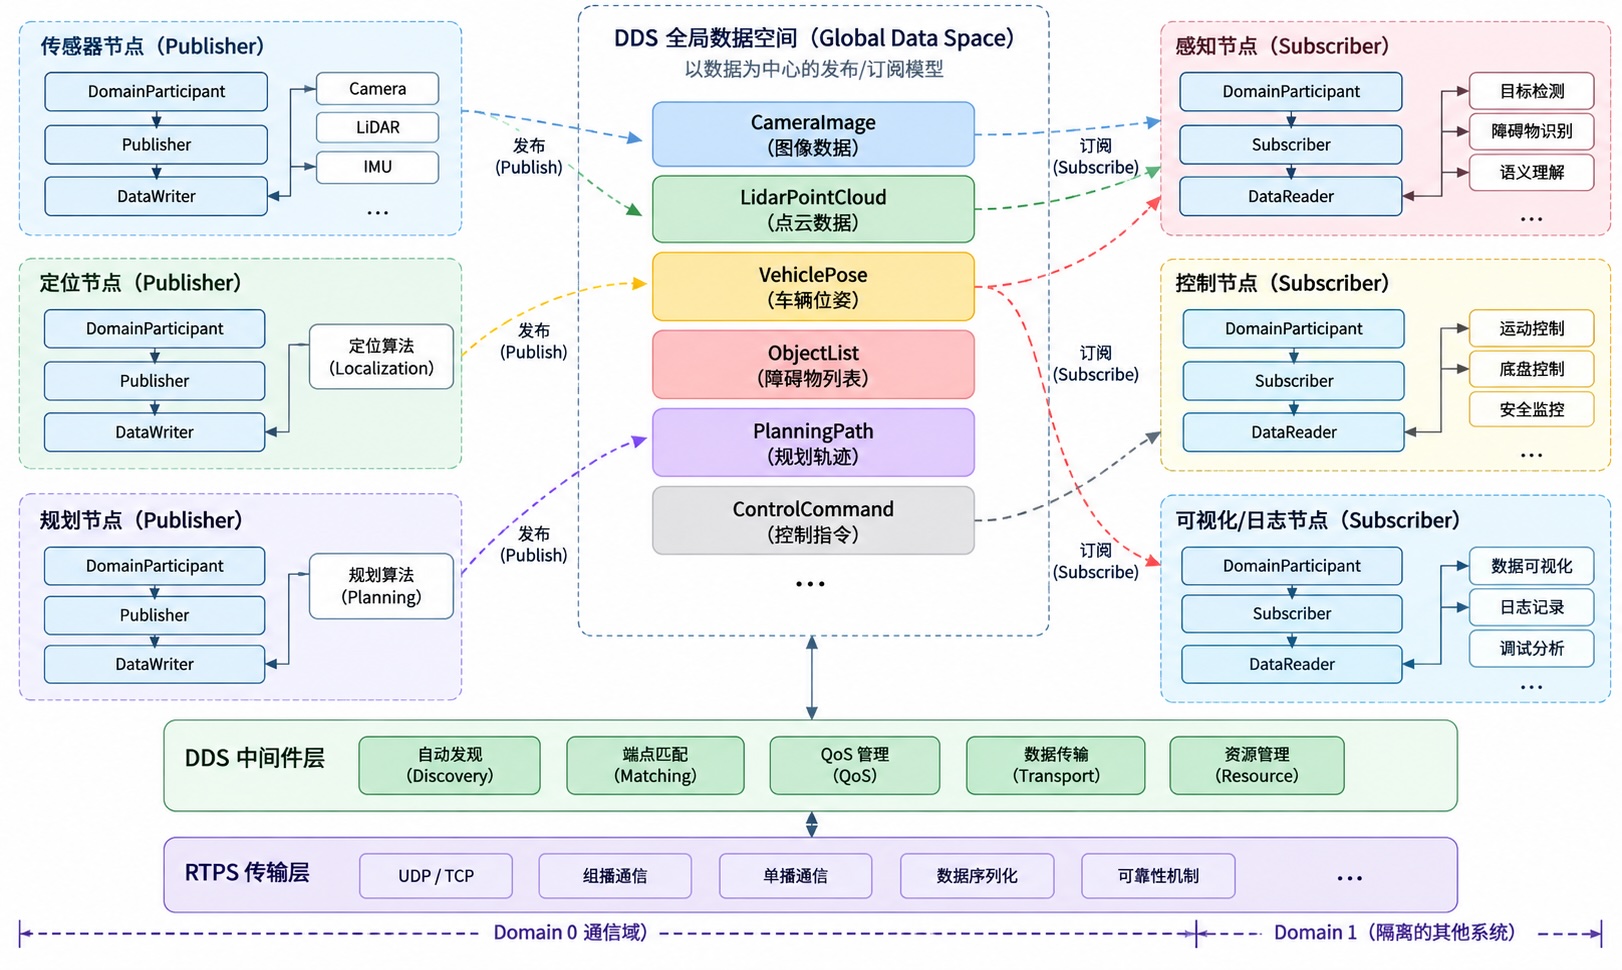
DDS 与普通 Pub/Sub 中间件最大的差异,在于它强调"以数据为中心"。传统 Pub/Sub 通常围绕消息主题和消息体组织系统,节点之间彼此知道对方的 Topic。而 DDS 把系统建模成一个"全局数据空间"。某个模块发布的是这个数据空间里的对象状态,订阅者看到的是这些状态在本地维护的副本。
可以把 DDS 的数据空间理解成一个逻辑上的共享内存。它并不要求所有数据真的集中存储在某台机器上,而是通过底层协议把数据的最新值和状态变化分发到需要的节点。订阅者拿到数据后,可以直接在自己的本地缓存里读取。这种模型对机器人系统很自然:传感器数据、定位结果、地图、控制指令,本质上都是系统中的状态数据。
DDS 中有几个基础概念需要先分清楚。
Domain 表示一个通信域。不同的 Domain 之间默认完全隔离,即使两个节点位于同一台机器或同一个局域网中,只要 Domain ID 不同,它们也不会互相发现、不会互相通信。这个机制很适合把不同功能子系统隔开,比如规划仿真使用 Domain 0,传感器原始数据使用 Domain 1。
DomainParticipant 是节点进入某个 Domain 的入口。一个进程里可以创建多个 Participant,但大多数情况下一个节点只需要一个。
Publisher 和 Subscriber 分别是数据发送侧和接收侧的容器。它们下面再创建具体的 DataWriter 和 DataReader。真正读写数据的对象是 DataWriter 和 DataReader,而 Publisher/Subscriber 更多承担组织和资源管理的职责。
Topic 是数据主题,用来描述"这一类数据是什么"。它由 Topic 名称和数据类型共同决定。只有 Topic 名称和数据类型都能匹配时,DDS 才会把发布端和订阅端关联起来。
简单来说,一次 DDS 通信的参与对象大致是:
text
DomainParticipant
  ├── Publisher
  │     └── DataWriter
  │           └── Topic
  └── Subscriber
        └── DataReader
              └── Topic
去中心化发现机制
DDS 有一个非常关键的特性:没有中心 Broker。那么两个节点如何知道彼此的存在?答案是自动发现。
DDS 中的发现协议通常称为 RTPS Discovery,底层一般依赖组播和单播。一个 Participant 启动后,会向预先约定的组播地址发送自己的信息,包括 Domain ID、Participant ID、可用的传输地址、支持的 Reader/Writer 实体等。同一 Domain 中的其他 Participant 收到这些报文后,会尝试建立单播连接。之后双方会交换更详细的端点信息,比如哪些 Topic 存在、数据类型是什么、QoS 是否兼容。
如果两条链路之间的 QoS 不兼容,即使 Topic 名称和数据类型一致,DDS 也不会把这两端匹配起来。一个典型例子是发布端设置了 BEST_EFFORT,订阅端设置了 RELIABLE。这种情况下订阅端拿不到可靠语义,匹配会失败。反过来,发布端 RELIABLE、订阅端 BEST_EFFORT 通常可以匹配,因为订阅端只是选择不要求可靠性。
这种去中心化发现的好处是,DDS 没有集中的注册中心,新增节点不会造成一个服务进程的连接风暴。节点之间直接交换端点信息,数据路径也更短。缺点是组播环境必须可用,或者说 DDS 的发现端口和地址必须能正常访问。在一些容器网络、虚拟机网络、多网卡机器和复杂防火墙环境下,DDS 的发现经常出问题。很多工程师第一次使用 DDS 时遇到的现象并不是代码错误,而是"程序正常运行,但两个节点互相看不见"。这时通常需要配置网络接口、对端地址列表,或者显式关闭/开启组播。
RTPS 是 Real-Time Publish-Subscribe Protocol 的缩写,它是 DDS 规范底层的线协议。可以把 DDS 理解成上层 API 和系统模型,而 RTPS 负责把这些模型在网络上具体实现。不同厂商的 DDS 实现只要遵循 RTPS,就有机会与彼此通信。
QoS:DDS 最重要的配置层
DDS 的强大之处不只在于自动发现,还在于 QoS。QoS 决定了数据如何在时间、可靠性和资源之间权衡。常见的策略包括:
- Reliability:可靠传输或尽力传输。
- History:本地缓存策略,如保留最近 N 条或只保留最后一条。
- Durability:后加入的订阅者能否收到历史数据。
- Deadline:数据必须多久更新一次。
- Lifespan:数据的有效期,过期后自动丢弃。
- Ownership:多个发布者写同一 Topic 时的仲裁方式。
以传感器数据为例,激光雷达、相机、IMU 这类数据通常更在意实时性。如果网络抖动导致旧帧堆积,继续把 200 ms 前的点云发给避障模块意义不大,甚至可能造成误判。所以这类 Topic 通常会配置:
text
Reliability = BEST_EFFORT
History = KEEP_LAST, depth = 1 或 2
而控制指令、安全状态、地图更新这类数据则可能相反。丢一帧可能带来严重后果,因此更适合使用:
text
Reliability = RELIABLE
History = KEEP_LAST, depth = 10
Durability = TRANSIENT_LOCAL
TRANSIENT_LOCAL 的意义是:新加入的订阅者可以拿到发布者本地保留的一部分历史数据。比如系统启动较晚的参数查询节点,仍然有机会读到最近一次系统状态。
QoS 并不是孤立的开关。不同策略之间会相互作用,配置不当也会带来性能问题。例如 RELIABLE 不等于无限重传,它依然受到传输层、缓存和资源限制的影响;KEEP_LAST 的 depth 过大,可能造成旧数据堆积,过小则可能丢掉对业务有价值的数据。实际项目中最好根据数据频率、帧大小、容忍延迟和消费者处理能力来调整。
一个简单的发布/订阅示例
下面用 C++ 说明 DDS 的基本写法。这里以 Cyclone DDS 为例,IDL 类型定义部分先省略,只看核心流程。
假设已经通过 IDL 生成了 HelloWorld 类型,代码骨架大致如下。
发布者
cpp
#include <dds/dds.hpp>
#include "HelloWorld.hpp"

using namespace org::eclipse::cyclonedds;

int main()
{
    dds::domain::DomainParticipant participant(0);

    dds::topic::Topic<HelloWorld> topic(participant, "HelloWorldTopic");

    dds::pub::Publisher publisher(participant);
    dds::pub::DataWriter<HelloWorld> writer(publisher, topic);

    HelloWorld sample;
    sample.index(0);
    sample.message("hello dds");

    for (int i = 0; i < 10; ++i) {
        sample.index(i);
        writer.write(sample);
        std::this_thread::sleep_for(std::chrono::milliseconds(500));
    }

    return 0;
}
订阅者
cpp
#include <dds/dds.hpp>
#include <iostream>
#include "HelloWorld.hpp"

using namespace org::eclipse::cyclonedds;

int main()
{
    dds::domain::DomainParticipant participant(0);

    dds::topic::Topic<HelloWorld> topic(participant, "HelloWorldTopic");

    dds::sub::Subscriber subscriber(participant);
    dds::sub::DataReader<HelloWorld> reader(subscriber, topic);

    while (true) {
        auto samples = reader.take();

        for (const auto &sample : samples) {
            if (sample.info().valid()) {
                const HelloWorld &data = sample.data();
                std::cout << "index: " << data.index()
                          << ", message: " << data.message()
                          << std::endl;
            }
        }

        std::this_thread::sleep_for(std::chrono::milliseconds(100));
    }

    return 0;
}
这段代码体现了 DDS 的一个基本特点:发布者和订阅者没有显式连接对方的地址。双方只声明了自己的 Domain、Topic 和类型。只要发现协议正常工作,两端就能自动匹配。
带基本 QoS 的 Cyclone DDS 示例
实际项目中通常需要给 Topic 配置 QoS。下面是一个把 Reliability 设置为 Reliable、History 设置为 KEEP_LAST 10 的例子。
cpp
#include <dds/dds.hpp>
#include "HelloWorld.hpp"

using namespace org::eclipse::cyclonedds;

int main()
{
    dds::domain::DomainParticipant participant(0);

    dds::topic::Topic<HelloWorld> topic(participant, "HelloWorldTopic");

    dds::pub::qos::DataWriterQos writer_qos;
    writer_qos.reliability(dds::core::policy::Reliability::RELIABLE);
    writer_qos.history(dds::core::policy::History::KeepLast(10));

    dds::pub::Publisher publisher(participant);
    dds::pub::DataWriter<HelloWorld> writer(publisher, topic, writer_qos);

    HelloWorld sample;
    sample.index(0);
    sample.message("reliable hello");

    for (int i = 0; i < 20; ++i) {
        sample.index(i);
        writer.write(sample);
        std::this_thread::sleep_for(std::chrono::milliseconds(200));
    }

    return 0;
}
订阅端如果不设置 RELIABLE,发布端的可靠语义可能无法匹配成功。一个常见做法是在订阅端也使用相同或兼容的 QoS:
cpp
dds::sub::qos::DataReaderQos reader_qos;
reader_qos.reliability(dds::core::policy::Reliability::RELIABLE);
reader_qos.history(dds::core::policy::History::KeepLast(10));

dds::sub::DataReader<HelloWorld> reader(subscriber, topic, reader_qos);
如果使用 ROS 2,很多 DDS 概念会被封装在 Node、Publisher、Subscriber、Service 和 Action 之下。但它的 QoS Profile、发现机制、传输策略仍然来自 DDS。理解 DDS 对排查 ROS 2 的网络问题和调优通信性能很有帮助。
典型应用场景
机器人系统
机器人系统通常是典型的多节点协作场景。感知、定位、规划、控制、诊断和日志模块可能分布在同一台工控机上,也可能分布在相机控制器、底盘控制器和远程监控端。DDS 的发布/订阅模型可以直接映射到传感器流和状态流的共享,同时通过 QoS 区分不同数据的重要性。例如 IMU 数据适合低延迟传输,电池状态适合可靠传输,地图更新则可以结合 Durability 让晚启动的模块拿到最新状态。
自动驾驶
自动驾驶中,大量数据在感知、融合、规划、控制之间流动。DDS 的实时性、去中心化和 QoS 能力适合这类场景。特别是当系统中存在多路相机、毫米波雷达、激光雷达和车辆状态数据时,每一类数据都有不同的频率、丢包容忍度和处理延迟要求。使用统一的 DDS 中间件可以减少各模块自行实现传输细节的成本。
工业和轨道交通
在工业控制、轨道交通、电力监控等领域,DDS 常用于实时状态同步和控制命令分发。这些场景通常关注确定性、可用性和可观测性。DDS 提供的 Deadline、Liveliness、Ownership 等 QoS,可以帮助系统表达"某个数据多久必须更新一次""某个发布者是否仍然存活""多个控制源之间谁优先"这类约束。
仿真与测试平台
仿真平台往往需要同时连接多个仿真节点、测试工具和可视化工具。DDS 可以让仿真数据、测试指令、车辆模型状态在不同的进程和主机之间共享,而不必为每个工具单独实现通信接口。
常见的 DDS 实现
目前常见的 DDS 实现包括 Cyclone DDS、Fast DDS、RTI Connext DDS、OpenDDS 等。
Cyclone DDS 的实现比较轻量,性能表现良好,配置相对直观,在 ROS 2 中也是常见选择。Fast DDS 是 eProsima 的实现,同样广泛用于 ROS 2 生态。RTI Connext DDS 是商业产品,功能完整,工具链强大,很多安全关键领域使用较多。OpenDDS 是开源实现,历史较长,适合一些传统项目。
不同实现的 API 大体遵循 DDS 规范,但在安装方式、配置文件、默认行为、调试工具和性能细节上有差异。项目选型时,除了关注吞吐和延迟,还要考虑许可协议、平台支持、工具链、配置能力以及团队维护经验。
调优与排障时需要关注的点
DDS 使用起来的门槛往往不在写代码,而在网络环境和 QoS 配置。实际项目中,以下几个方面值得重点关注。
第一是多网卡问题。一台机器可能同时存在有线网卡、无线网卡、Docker 虚拟网卡和 VPN 网卡。DDS 发现过程可能会选择错误的接口,导致本机两个进程能通信,跨机器节点却无法互相发现。这类问题通常可以通过配置 General/Interfaces、AllowedInterfaces 或类似的网络接口过滤策略解决。
第二是组播是否可用。部分云环境、容器网络或交换机配置会限制组播。此时 DDS 可以配置为只使用单播,或者通过 Peer 列表显式指定对端地址。
第三是大消息传输。相机图像、点云、大地图等数据可能超过 UDP 报文的安全大小。DDS 底层通常会进行分片,但如果接收端处理慢或网络质量差,可能出现丢帧、重组失败或内存占用上升。必要时可以开启共享内存、调整分片大小,或者降低单条消息的大小。
第四是 QoS 不匹配。DDS 的自动匹配是强约束的。Topic 名称相同、类型相同,但 Reliability、Durability、Ownership 等策略不兼容时,两端不会连起来。排障时不要只盯着代码里的字符串,还要检查 QoS Profile。
第五是历史队列深度。KEEP_LAST 模式下,depth 决定了发布端或订阅端保留多少条数据。消费者处理慢时,队列会被覆盖或堆积。对实时数据来说,depth 通常不宜太大;对命令或事件类数据,则要根据重放和容错需求设计。
与其他通信方式的对比
与 TCP 直接通信相比,DDS 提供了类型系统、自动发现、发布/订阅模型和 QoS,省去了大量自定义协议代码。它更适合多对多、动态加入退出、数据状态频繁更新的系统。
与 Kafka 或 RabbitMQ 这类 Broker 架构相比,DDS 没有中心服务进程,数据路径更短,实时性更容易控制。Kafka 更适合大规模日志、事件回放和数据管道,RabbitMQ 常用于业务解耦和任务队列。DDS 则偏向实时分布式系统中的状态数据共享。
与 gRPC 相比,gRPC 更偏远程调用,接口形式通常是请求/响应。DDS 更偏持续数据流的发布与订阅。两者不是互斥关系。在一些系统里,管理接口和服务调用可以使用 gRPC,而高频状态流、传感器流和控制流使用 DDS。
总结
DDS 的价值在于,它把分布式系统中很多底层通信问题抽象成了数据模型和策略配置。开发者面对的不再是地址、端口、连接和重连逻辑,而是 Participant、Topic、DataWriter、DataReader 和 QoS。系统通过自动发现完成端点匹配,通过 RTPS 完成实际的数据传输,通过 QoS 表达不同数据的可靠性、实时性和生命周期需求。
它的核心思想可以概括为三点:以数据为中心,没有中心 Broker,用 QoS 表达通信约束。对机器人、自动驾驶、工业控制这类系统来说,DDS 并不是万能的,也不是所有场景下都最优,但在多节点实时数据共享场景中,它提供了一套非常成熟的工程模型。
如果只是发几条测试消息,DDS 的代码看起来可能比直接写 TCP 更复杂。可一旦系统扩展到几十个节点、上百个 Topic,并且存在不同的实时性和可靠性要求,DDS 带来的结构化能力就会明显体现出来。真正用好 DDS,关键还是理解自己的数据特征:哪些数据允许丢,哪些数据必须到达,哪些数据只需要最新值,哪些数据要交给后加入者,哪些数据要求周期更新。把这些业务语义映射到 DDS 的 Topic 和 QoS 上,往往比照抄默认配置更重要。
🌟 在这篇博文的旅程中,感谢您的陪伴与阅读。如果内容对您有所启发或帮助,请不要吝啬您的点赞 👍🏻,这是对我最大的鼓励和支持。
📚 本人虽致力于提供准确且深入的技术分享,但学识有限,难免会有疏漏之处。如有不足或错误,恳请各位业界同仁在评论区留下宝贵意见,您的批评指正是我不断进步的动力!😄😄😄
💖💖💖 如果您发现这篇博文对您的研究或工作有所裨益,请不吝点赞、收藏,或分享给更多需要的朋友,让知识的力量传播得更远。
🔥🔥🔥 "Stay Hungry, Stay Foolish" ------ 求知的道路永无止境,让我们保持渴望与初心,面对挑战,勇往直前。无论前路多么漫长,只要我们坚持不懈,终将抵达目的地。🌙🌙🌙
👋🏻 在此,我也邀请您加入我的技术交流社区,共同探讨、学习和成长。让我们携手并进,共创辉煌!