一个全栈需求
产品过来说:「加个活动报名功能,一个人只能报一次。」
前端的动作几乎是条件反射:打开编辑器,先写类型。
ts
type ActivitySignup = {
  id: string
  userId: string
  activityId: string
  createdAt: string
}
写完这段,心里基本就踏实了:字段齐了,剩下的交给 AI 生成接口和页面。可这张表到底该怎么建,还没开始想。
需求说了什么,没说什么
需求给的是一个功能。至于这张表该有哪些字段,是你照着习惯自己顺手补的。真正没人会跟你说的,是这三个:
- 同一个人连点两次报名,怎么办?
- 他取消了,过两天再报一次,算不算重复?
- 按活动拉一份报名名单,这个查询快不快?
前两条问的其实是规则。功能写在代码里就行,规则得写在表上:写数据的入口不止一个(接口、定时任务、后台管理界面、你手敲的那句 SQL),规则放进代码,每个入口都得记得抄一遍,漏一个就破;交给数据库,每次写入它替你检查。
但这两条不是一回事:第二条是产品规则,得在评审时问产品(第三步展开);第一条是你自己拍的技术判断。至于第三条「查得快不快」,那不归约束管(后面「约束管不了的那一半」再说)。
前端转全栈的第一道坎,就是这个翻译:把需求里没人明说的规则,翻译成数据库能自己执行的约束。约束,就是数据库替你记住、你的代码改不掉的那些规则。
前端的第一反应:先写 TS 类型
上面那段 type ActivitySignup,是前端最熟练的动作,也是这次最容易骗到自己的地方。它有三个问题:
- 它编译完就没了。 数据库不知道
userId存在,更不知道它不能为空。 string什么都能装。 空字符串、别人的 id、随便一段文本,类型上全都合法。- 它描述的是「一个对象长什么样」,不是「哪些情况不允许发生」。
这三个问题,编译器一个都报不出来:前两个它压根不管,第三个连人也不会替你管------而这恰恰是数据库最擅长的:
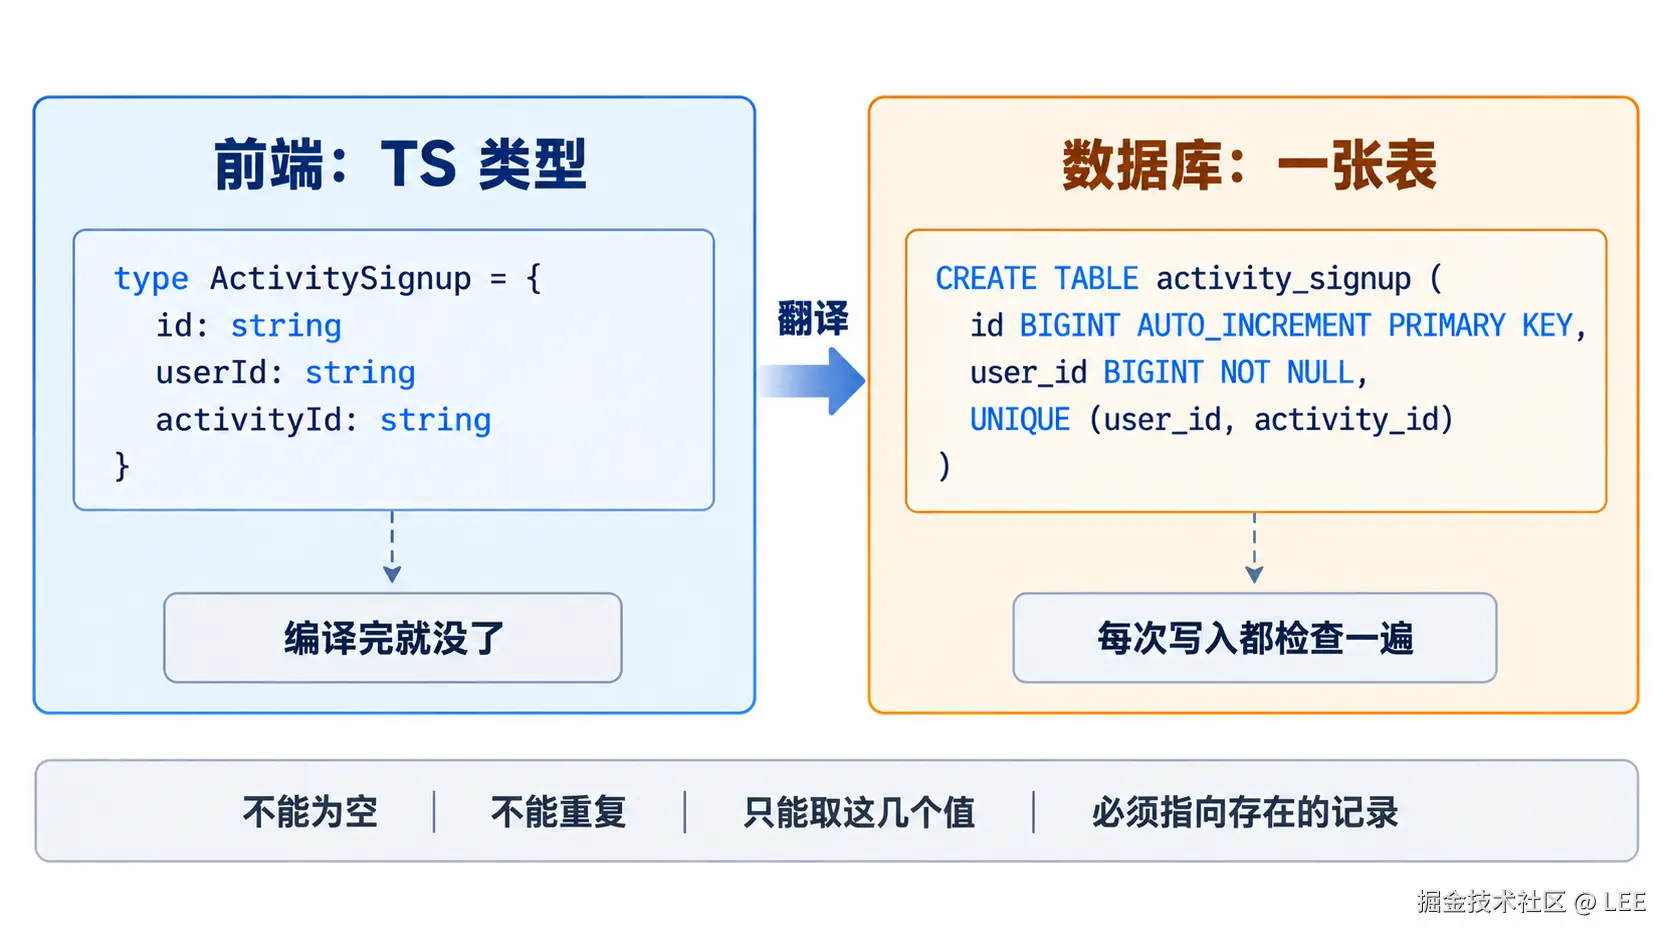
type 和 CREATE TABLE 长得像,管的事完全不一样。前端对「数据模型」的全部经验几乎都停在左半边。
而这一停,代价是最贵的那一档:改表一次,比改代码一次贵得多。改 TS 类型是保存、编译一遍,几秒钟;改表要写迁移脚本、做存量数据回填、想好怎么回滚(这三件都得靠脚本),还得挑一个没人用的上线窗口------跑错了数据就没了。
这套系列把数据建模放在最前面,就是因为这个。
一张翻译表
我一开始也以为活动报名是最简单的那种表------直到「取消了还能不能再报」把我问住。真正卡住我的是需求里没写出来的那条规则。
翻译之前,每张表先得有个身份:主键 (全表唯一、不能空)。这条需求里不会有,是每张表自己的前提。其余的规则都藏在措辞里:拿到需求,先圈出「只 / 不能 / 必须 / 取消」这类规则词,每个词背后都是一条要翻译的规则。
| 要翻译的那句话 | 翻成结构里的什么 | 人话 |
|---|---|---|
| 「只能一次」 | 唯一约束 | 每次写入替你查一遍,重没重 |
| 「必须是真用户 / 真活动」 | 外键(你补的) | 值必须指向另一张表里真有的一行 |
| 「只能取这几个值」 | CHECK(你补的) | 写入时只放行你列出的取值 |
| 「取消了」「不要了」 | 状态字段·软删(你补的) | 行留着只打标记,不真删 |
| 「按活动拉名单要快」 | 索引(你补的) | 给这列建个目录,没它得整张表翻一遍 |
只有第一行是需求原话(「一个人只能报一次」),其余几行,要么是你要追问的,要么是你自己判断的。这正是「翻译」要你出的那份力。
前四行翻出来的都是约束 ,最后一行翻成的是索引,管快慢、不管对错,不属约束那一类;这条界留到「约束管不了的那一半」再说清。
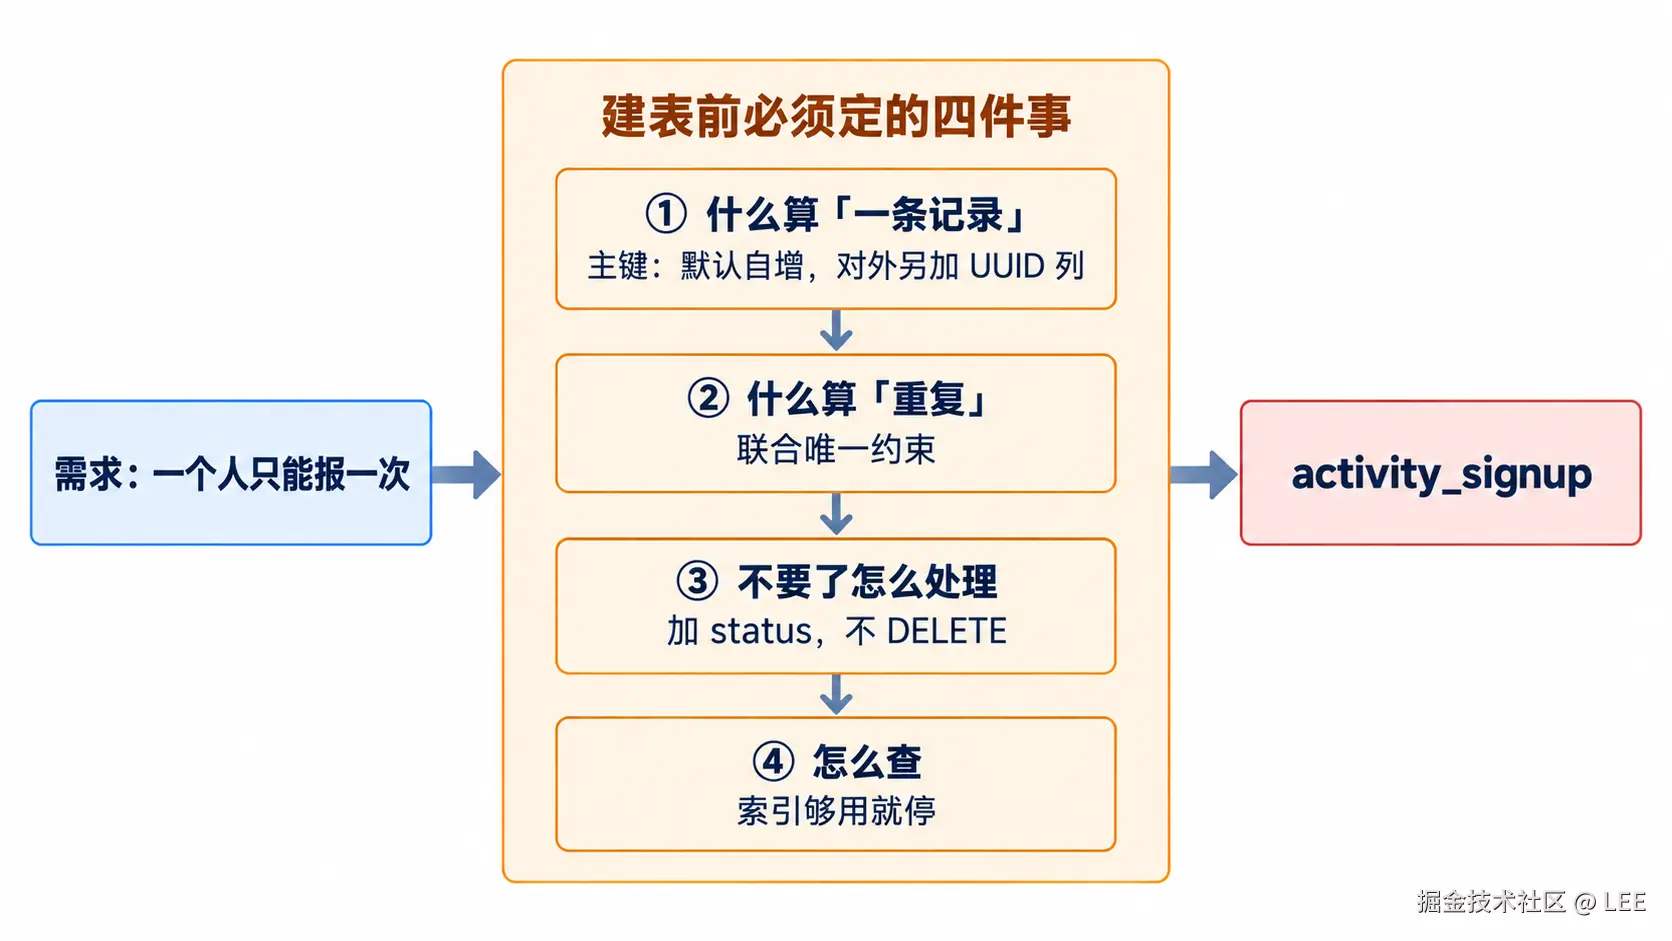
最小实现路径:四步把表建出来
上面那张表,落到这张具体的表上,就是下面四步。顺序不能换:先有身份,才能谈重复。
第一步:什么算「一条记录」
先定主键。前端写类型时顺手就是 id: string,从没想过它在库里该是什么样子。这里值得多问一句:这个 id 会不会给用户看到?
- 不会 (纯内部关联)→ 自增(MySQL 里就是
AUTO_INCREMENT)。小、快、排查问题方便。 - 会 (出现在 URL、接口参数、导出文件里)→ 别把主键直接换成 UUID:
id=10000等于告诉别人你只有一万条数据;更要命的是 MySQL 的表按主键顺序摆放,主键一随机,插入就得在中间挪来挪去,越插越慢。
最小路径:主键默认自增;真要对外,再另加一列 public_id CHAR(36) 装 UUID。对外看不到自增,内部又不吃亏。
第二步:什么算「重复」
需求里那句「一个人只能报一次」,落下来就是一个联合唯一约束 :user_id 和 activity_id 这两列的组合,全表不许出现第二次。
sql
CONSTRAINT uniq_signup UNIQUE (user_id, activity_id)(它的形状到第三步还会改一次。)
注意不要在自己写的接口代码里去判断:
ts
// 这样写,并发下必错
const exists = await db.signup.findFirst({ userId, activityId })
if (exists) throw new Error('已经报过名了')
await db.signup.create({ userId, activityId })
两个人同时点,两个请求都查到「没有」,两个都插入。检查和写入之间有时间差,这个差靠代码里的 if 填不平------得由数据库在写入的那一刻收尾。你代码里的 if 永远慢一拍。
正确姿势反着来:别先查,直接插,让唯一约束去撞;撞到了,就当「已经报过了」处理。
(约束要落到表上,才挡得住并发;并发本身是下一篇的事。)
第三步:不要了怎么处理
「取消报名」听起来像删除,但不能 DELETE。真删了,下面这些问题就永远答不出:
- 多少人是报了又取消的?
- 用户说「我没取消过」,你拿什么作证?
- 他取消完又报了一次,这是第几次?
所以加一个状态字段(软删:行留着,只打个标记,跟真删相反),而不是真删:
sql
status VARCHAR(16) NOT NULL DEFAULT 'active' -- active | canceled(顺带还给出一条信息:什么时候取消的 ,所以留了一列 canceled_at。)
加完立刻撞上第二步:唯一约束还在,那条 canceled 的记录占着位子,用户重新报名会被数据库拦下来,报「已经报过了」。
这里先停一下------「取消之后还能不能再报」,需求里没说,评审时就该拿去问产品。「一个人只能报一次」有两种读法:一辈子一次,还是同一场一次、取消了可以再来。下面先按后者写;产品要是说前者,第三步照做,只是别让它让位:软删照加(不然「谁取消过」照样答不出),唯一约束保持第二步原样。
A:把状态也放进唯一约束 :UNIQUE (user_id, activity_id, status)。简单,但同一个人在同一场活动上只能取消一次:第二次取消要把 status 改成 canceled,撞上已经躺着的那条,会被约束拦下报错。
B:让唯一约束只管「还有效的」那部分 :这是更干净的做法。MySQL 不支持「只对一部分行生效」的约束,用生成列绕出来------这一列的值不是你写进去的,是数据库按公式替你算的:
sql
-- MySQL 8:生成列 = 「只在 active 时才参与唯一」,取消后置 NULL
ALTER TABLE activity_signup
  ADD COLUMN active_key VARCHAR(64)
    GENERATED ALWAYS AS (
      IF(status = 'active', CONCAT(user_id, ':', activity_id), NULL)
    ) STORED,
  ADD UNIQUE KEY uniq_active_signup (active_key);
(写成 ALTER TABLE 是假设表已建好、要补这一列;从零建表不用跑它------第四步那份完整的 CREATE TABLE 里已经含了。)
巧处在于:生成列在取消后是 NULL------NULL 是「未知」,两个未知不算重复,唯一约束自然不会拦;位子就这么让开了。
第四步:怎么查
回头想想这张表会被怎么查。两个最典型的场景(WHERE 就是「只取满足这个条件的那些行」):
- 按活动拉名单(后台那一屏)→
WHERE activity_id = ? AND status = 'active' - 我的报名(只看还有效的)→
WHERE user_id = ? AND status = 'active'
两个查询的主过滤条件都落在 activity_id / user_id 上,正好是这张表的两个外键。MySQL 建外键时会自动为它建索引,这两个不用你操心。
要先想清楚的是第三步那个唯一约束:它实际建在生成列 active_key 上,不在 (user_id, activity_id) 上,这两个查询它一个都服务不了。
但索引不是越多越好:每多一个索引,每次写入都要多维护一份,代价落在写上。为「以后可能会查」先建的索引,先拖慢的是每一次报名。最小路径是该有的齐了就停手 :外键列 MySQL 自动建了,唯一约束自带的那个是为查重服务的、也不算多余;除这两类之外,只给真会出现在 WHERE、又能筛掉大部分行的列 建;status 这种只有两三个值的低基数列不算,其余等慢查询来了再说。
四步走完,落成这样:
sql
CREATE TABLE activity_signup (
  id          BIGINT UNSIGNED NOT NULL AUTO_INCREMENT,
  user_id     BIGINT UNSIGNED NOT NULL,
  activity_id BIGINT UNSIGNED NOT NULL,
  status      VARCHAR(16) NOT NULL DEFAULT 'active',
  created_at  DATETIME NOT NULL DEFAULT CURRENT_TIMESTAMP,
  canceled_at DATETIME NULL,
  active_key  VARCHAR(64)
    GENERATED ALWAYS AS (
      IF(status = 'active', CONCAT(user_id, ':', activity_id), NULL)
    ) STORED,

  PRIMARY KEY (id),
  UNIQUE KEY uniq_active_signup (active_key),
  -- user_id / activity_id 的索引由下面的外键自动带上,不必手写
  CONSTRAINT fk_signup_user     FOREIGN KEY (user_id)     REFERENCES app_user (id),
  CONSTRAINT fk_signup_activity FOREIGN KEY (activity_id) REFERENCES activity (id),
  CONSTRAINT ck_signup_status   CHECK (status IN ('active', 'canceled'))
) ENGINE=InnoDB DEFAULT CHARSET=utf8mb4;(前提:app_user、activity 是另外两张表,得先建好,id 也必须是 BIGINT UNSIGNED 主键;MySQL 要求外键列与被指向列的类型完全一致,否则建表时直接报 Cannot add foreign key constraint。)
(版本提醒:上面的写法以 MySQL 8.x 为准。CHECK 约束要到 8.0.16 才真的执行,更早的版本会照收不拦;生成列从 5.7 起就有。)
约束管不了的那一半
四步走完,得说清这张表没管什么,不然你会当它万能。
约束只认数据库的约束语言能写出来的那几种:这一行不空、不重、取值就在这几个里、外键指向的行真在。这几样之外,它就使不上劲了。最要紧的是两类:
- 快慢:「按活动拉名单快不快」归索引管,跟约束无关(第四步那条线)。
- 跨行、跨时间的规则 :「一人最多报 3 个活动」「总名额 100」「同一时段不能报两场」,都要数别的行、比时间。约束的语言里写不出来(连条
COUNT都不让你写),只能靠事务、锁、业务代码来守。这是下一篇的正题。
所以「把需求翻译成约束」只翻得动规则的一半。另一半没有数据库这道兜底,更难。
AI 能替你做多少
把开头那段 TS 类型丢给 AI,说「照着建张表」,它一秒就给你:
sql
CREATE TABLE activity_signup (
  id          VARCHAR(36) PRIMARY KEY,
  user_id     VARCHAR(36),
  activity_id VARCHAR(36),
  created_at  DATETIME
);
字段一个不少,因为字段是你告诉它的。还照着你的 id: string 把主键定成了 VARCHAR(36),正好踩中第一步那个坑:MySQL 上拿随机 UUID 当主键,越插越慢。而「一个人只能报一次」「取消后还能重报」「按活动拉名单要快」这三条,它一条都没写进去,其中一条还得先问产品,你才知道该往表上写什么。
因为它不知道。你没说。
这跟 AI 行不行无关,问题出在「说出来的需求」和「没说出来的约束」之间那道缝:AI 只翻得动你说出口的那部分,你没说的规则,它一个字都写不出来,剩下的只能你填。它会写,但会写错------原理和取舍必须你定。
你能拿走什么
一份建表决策清单
下次建表前,拿这张清单把上面那套翻译走一遍。注意「答案从哪来」这一列:只有最后一行在你脑子里。两条在需求那边(一条原话已经给了,一条得去评审会上问),一条看一眼接口就知道。
| 问题 | 答案从哪来 | 落在表上 |
|---|---|---|
| 这个 id 会不会给用户看到? | 看你的接口 | 会 → 另加一列 UUID 对外;不会 → 直接用自增主键 |
| 哪几个字段同时相同算「重复」? | 需求原话(「一个人只能报一次」) | 联合唯一约束,别在你代码里用 if 查一遍 |
| 这条记录会被「不要」吗? | 评审时问产品 | 会 → 加 status,不 DELETE;取消的记录要不要在唯一约束里让位? |
哪几列会出现在 WHERE 里? |
你自己 | 外键列先确认有索引(MySQL 自动带);其余等慢查询 |
一个验收脚本
迁移文件里写了什么,和库里真正建成 什么样,是两回事:生成列被漏掉、约束没建上、同事手动改过,都不在你的迁移文件里。下面四段对着库里真实的结构跑一遍,四步各验一条 ,表名换成你的:只有第 1 段是「结果为空就是过」 (有主键,而且得是自增的);第 2、3、4 段列的都是现状,有没有问题要对着第二、三、四步自己判。查的是数据库自己的元数据,只读,不碰你的数据。
脚本以 MySQL 8 为准,查的是它自带的 information_schema。
sql
-- 1. 第一步:有没有主键;有的话,是不是自增的
SELECT t.table_name, '没有主键' AS 问题
FROM information_schema.tables t
WHERE t.table_schema = DATABASE()
  AND t.table_name   = 'activity_signup'
  AND t.table_type   = 'BASE TABLE'
  AND NOT EXISTS (
    SELECT 1 FROM information_schema.table_constraints c
    WHERE c.table_schema = t.table_schema
      AND c.table_name   = t.table_name
      AND c.constraint_type = 'PRIMARY KEY'
  )
UNION ALL
SELECT c.table_name, '主键不是自增的(第一步说的是默认自增)'
FROM information_schema.columns c
WHERE c.table_schema = DATABASE()
  AND c.table_name   = 'activity_signup'
  AND c.column_key   = 'PRI'
  AND c.extra NOT LIKE '%auto_increment%';
(表名写错也是空结果,先确认这张表真的在。结果里若出现「主键不是自增的」,那就是 AI 那个 id VARCHAR(36) PRIMARY KEY 留下的病。)
sql
-- 2. 第二步:「重复」是按哪几列算的(对照你要的那一组)
SELECT k.constraint_name, k.column_name, k.ordinal_position
FROM information_schema.key_column_usage k
JOIN information_schema.table_constraints c
  ON  c.constraint_schema = k.constraint_schema
  AND c.constraint_name   = k.constraint_name
  AND c.table_name        = k.table_name
WHERE c.constraint_type = 'UNIQUE'
  AND k.table_schema = DATABASE()
  AND k.table_name   = 'activity_signup'
ORDER BY k.constraint_name, k.ordinal_position;
第 2 段列出这张表上所有的唯一约束 :UNIQUE KEY、后来 CREATE UNIQUE INDEX 补的,MySQL 都记进来,一条不落。看到 active_key 这种眼生的列别急着下结论:那是把两列规则编进了一列,正面例子;它是不是生成列,第 3 段会替你认出来。
sql
-- 3. 第三步:唯一约束到底建在哪几列上(只罗列,过不过你自己对着第二、三步判)
--    前提:这里假设产品取的是「取消了可以再报」这一读法。
--    若取「一辈子一次」,唯一约束**应该**留在 (user_id, activity_id) 上------那它就不是问题。
--    软删列不叫 status 的,把下面的 'status' 换成你的列名。
SELECT k.constraint_name, k.column_name, k.ordinal_position,
       CASE WHEN col.generation_expression <> '' THEN '生成列'
            WHEN col.column_name = 'status'       THEN '软删列'
            ELSE '普通列' END AS 列的类型
FROM information_schema.key_column_usage k
JOIN information_schema.table_constraints c
  ON  c.constraint_schema = k.constraint_schema
  AND c.constraint_name   = k.constraint_name
  AND c.table_name        = k.table_name
LEFT JOIN information_schema.columns col
  ON  col.table_schema = k.table_schema
  AND col.table_name   = k.table_name
  AND col.column_name  = k.column_name
WHERE c.constraint_type = 'UNIQUE'
  AND k.table_schema = DATABASE()
  AND k.table_name   = 'activity_signup'
ORDER BY k.constraint_name, k.ordinal_position;
-- generation_expression 只有生成列才非空(别用 extra:里面的 DEFAULT_GENERATED
-- 说的是「默认值是个表达式」,不是生成列)
第 3 段没有「空就是过」一说:它把每个唯一约束由哪几列组成、每列是普通列还是生成列/软删列,原样列出来。看到约束落在生成列 上(active_key 那种),是第三步 B 方案,对;看到 status 也在约束里,那是 A 方案,只能取消一次;看到光秃秃的 (user_id, activity_id),要不要报警取决于产品采的是哪个读法:取「取消了可以再来」就是拦住了重报,取「一辈子一次」反而是对的。
sql
-- 4. 第四步:这张表上的索引------该在的在不在,多余的有没有
SELECT index_name, column_name, seq_in_index, non_unique
FROM information_schema.statistics
WHERE table_schema = DATABASE()
  AND table_name   = 'activity_signup'
ORDER BY index_name, seq_in_index;
第 4 段只看一件事:多出来的 那些。两个外键列该在(MySQL 自动带上);唯一约束自带的索引也该在,它是为查重服务的,删了「只能报一次」就没了,别看它不进任何 WHERE 就想动它。剩下的只在真会进 WHERE 时才该在:多出来的索引,代价落在每一次报名上。
一条降级路径:前后端都是 TS 时
如果后端也是 TS,类型这件事可以少写一半------用一份 schema 同时产出类型和校验:
ts
import { z } from 'zod'

export const signupInput = z.object({
  userId: z.coerce.bigint().positive(),      // 和表里的 BIGINT UNSIGNED 对上
  activityId: z.coerce.bigint().positive(),
})

export type SignupInput = z.infer<typeof signupInput>
但别把它当成表的替代品:Zod 管的是「进来的请求长什么样」,表管的是「数据库里能存在什么」。请求可以绕过 Zod(定时任务、你手敲的 SQL),但绕不过表。两者都要有。
从为界面负责,到为数据负责
前端的老本行是为界面负责:页面崩了、加载态没做,是你的活;接口给的值对不对、库里那一行该不该在,那不归你管,你只是把它画出来。
转全栈之后,写数据的代码、建的表、定的约束,都是你的。数据错了,没人替你担。
接口能重写,页面能重构,数据错一次可能永远补不回来。约束又只兜得住规则的一半,跨行、跨时间的那些得你自己守。下次接到「加个功能」,打开编辑器之前先问一句:这张表里的每一行数据,往后都归你负责。
参考
- MySQL 8.4: Generated Columns(官方文档,生成列可声明 UNIQUE、可被索引)
- MySQL 8.4: CREATE INDEX Statement(官方文档,「唯一索引允许多个 NULL」出自此页)
- MySQL 8.4: FOREIGN KEY Constraints(官方文档,「外键会自动建索引」出自此页)
- MySQL 8.4: The INFORMATION_SCHEMA TABLES Table 与 TABLE_CONSTRAINTS Table(官方文档;验收脚本查的元数据表同属
information_schema:脚本 1 用 TABLES、TABLE_CONSTRAINTS、COLUMNS,脚本 2、3 用 KEY_COLUMN_USAGE、TABLE_CONSTRAINTS(脚本 3 另用 COLUMNS),脚本 4 用 STATISTICS)