成为全栈·Node 后端篇·点赞系统:幂等点赞与计数原子增减
"点个赞"看着就是个数字 +1。可真要做对,至少有三个问题要回答:同一个人能不能重复点?网络抖动手滑点了两次算几次?并发一来,计数会不会漂?
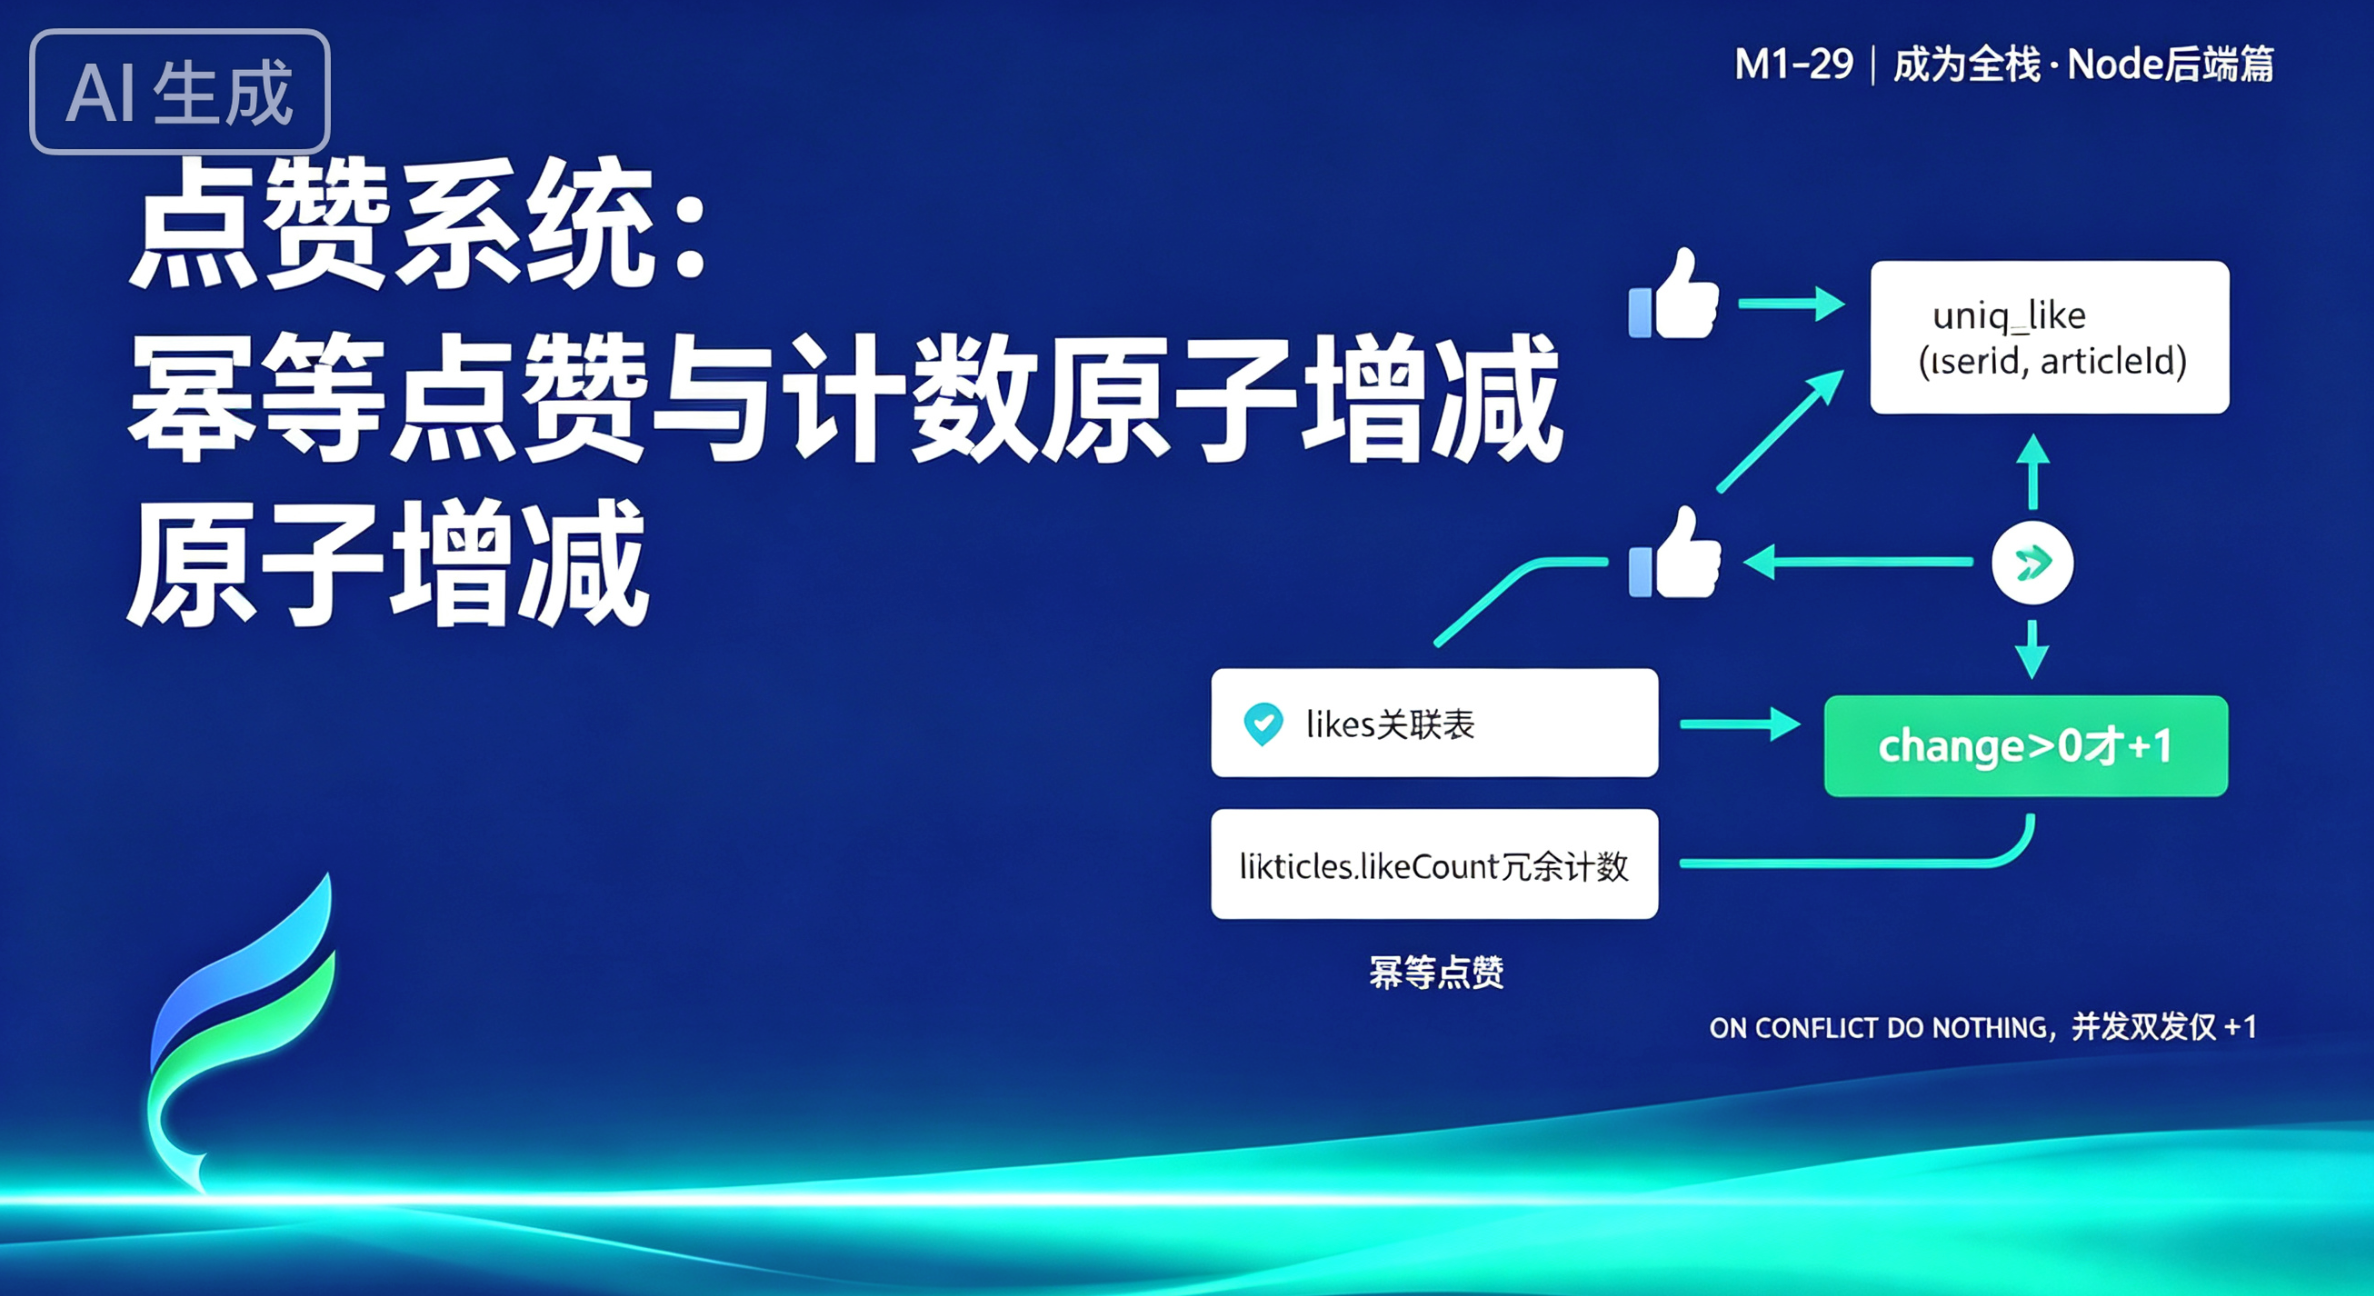
这一篇对照真实的 src/services/likes.ts,讲清点赞怎么做到幂等 + 原子计数 :为什么用 ON CONFLICT DO NOTHING 挡重复、取消时为什么要把计数下限夹在 0、以及"点赞数"为什么宁可存冗余字段,也不每次 COUNT 一遍。
一、点赞不是简单的 +1 字段
如果只在 articles 表加个 like_count,然后"谁点赞就 UPDATE + 1",会立刻出问题:
- 重复点赞:同一个用户点 N 次,计数 +N,显然不对------点赞应该是"赞过 / 没赞过"的二元态,不是累加器。
- 并发竞态 :两个请求同时
SELECT like_count再UPDATE + 1,后到的会覆盖先到的,计数少算。 - 取消变负:取消点赞时若没查清楚"到底赞过没",可能把计数减成负数。
所以正确建模是两张表协作 :一张 likes 关联表记录"谁赞了哪篇"(天然去重 + 可查态),一张 articles.likeCount 冗余字段存"当前总赞数"(读快)。下面看真实代码怎么串起来。
二、数据模型:关联表 + 冗余计数
schema.ts 里 likes 表有 uniq_like 唯一索引 (userId, articleId)------这正是一道硬约束:同一个用户对同一篇文章,关联表里最多一行。它既是"防重复点赞"的物理保障,也是后面幂等逻辑的依赖。
而 articles.likeCount(integer default 0)是去规范化的冗余计数 :理论上 COUNT(likes WHERE articleId=?) 随时能算出来,但我们把它冗余存着,换"读时零计算"的速度。这个取舍就是 P-49 的核心,第五节细讲。
三、P-44:幂等点赞,并发双发亦仅 +1
likeArticle 是点赞的核心,真实实现非常讲究:
ts
// src/services/likes.ts --- likeArticle
export const likeArticle = async (
  userId: number,
  articleId: number,
): Promise<{ liked: true; likeCount: number }> => {
  await requireLikeArticle(articleId);
  const db = getDb();
  // DB 层幂等:唯一约束 ON CONFLICT DO NOTHING,并发双发不会撞约束 500。
  const res = await db
    .insert(likes)
    .values({ userId, articleId, createdAt: new Date() })
    .onConflictDoNothing()
    .run();
  // 仅当本次确实新增一行时才原子 +1,避免应用层读改写竞态导致的计数漂移。
  if (res.changes > 0) {
    await db
      .update(articles)
      .set({ likeCount: sql`like_count + 1` })
      .where(eq(articles.id, articleId))
      .run();
  }
  const fresh = (
    await db
      .select({ likeCount: articles.likeCount })
      .from(articles)
      .where(eq(articles.id, articleId))
      .limit(1)
      .all()
  )[0];
  if (!fresh) throw new AppError(ErrCode.INTERNAL, 500);
  return { liked: true, likeCount: fresh.likeCount };
};
精妙在三点:
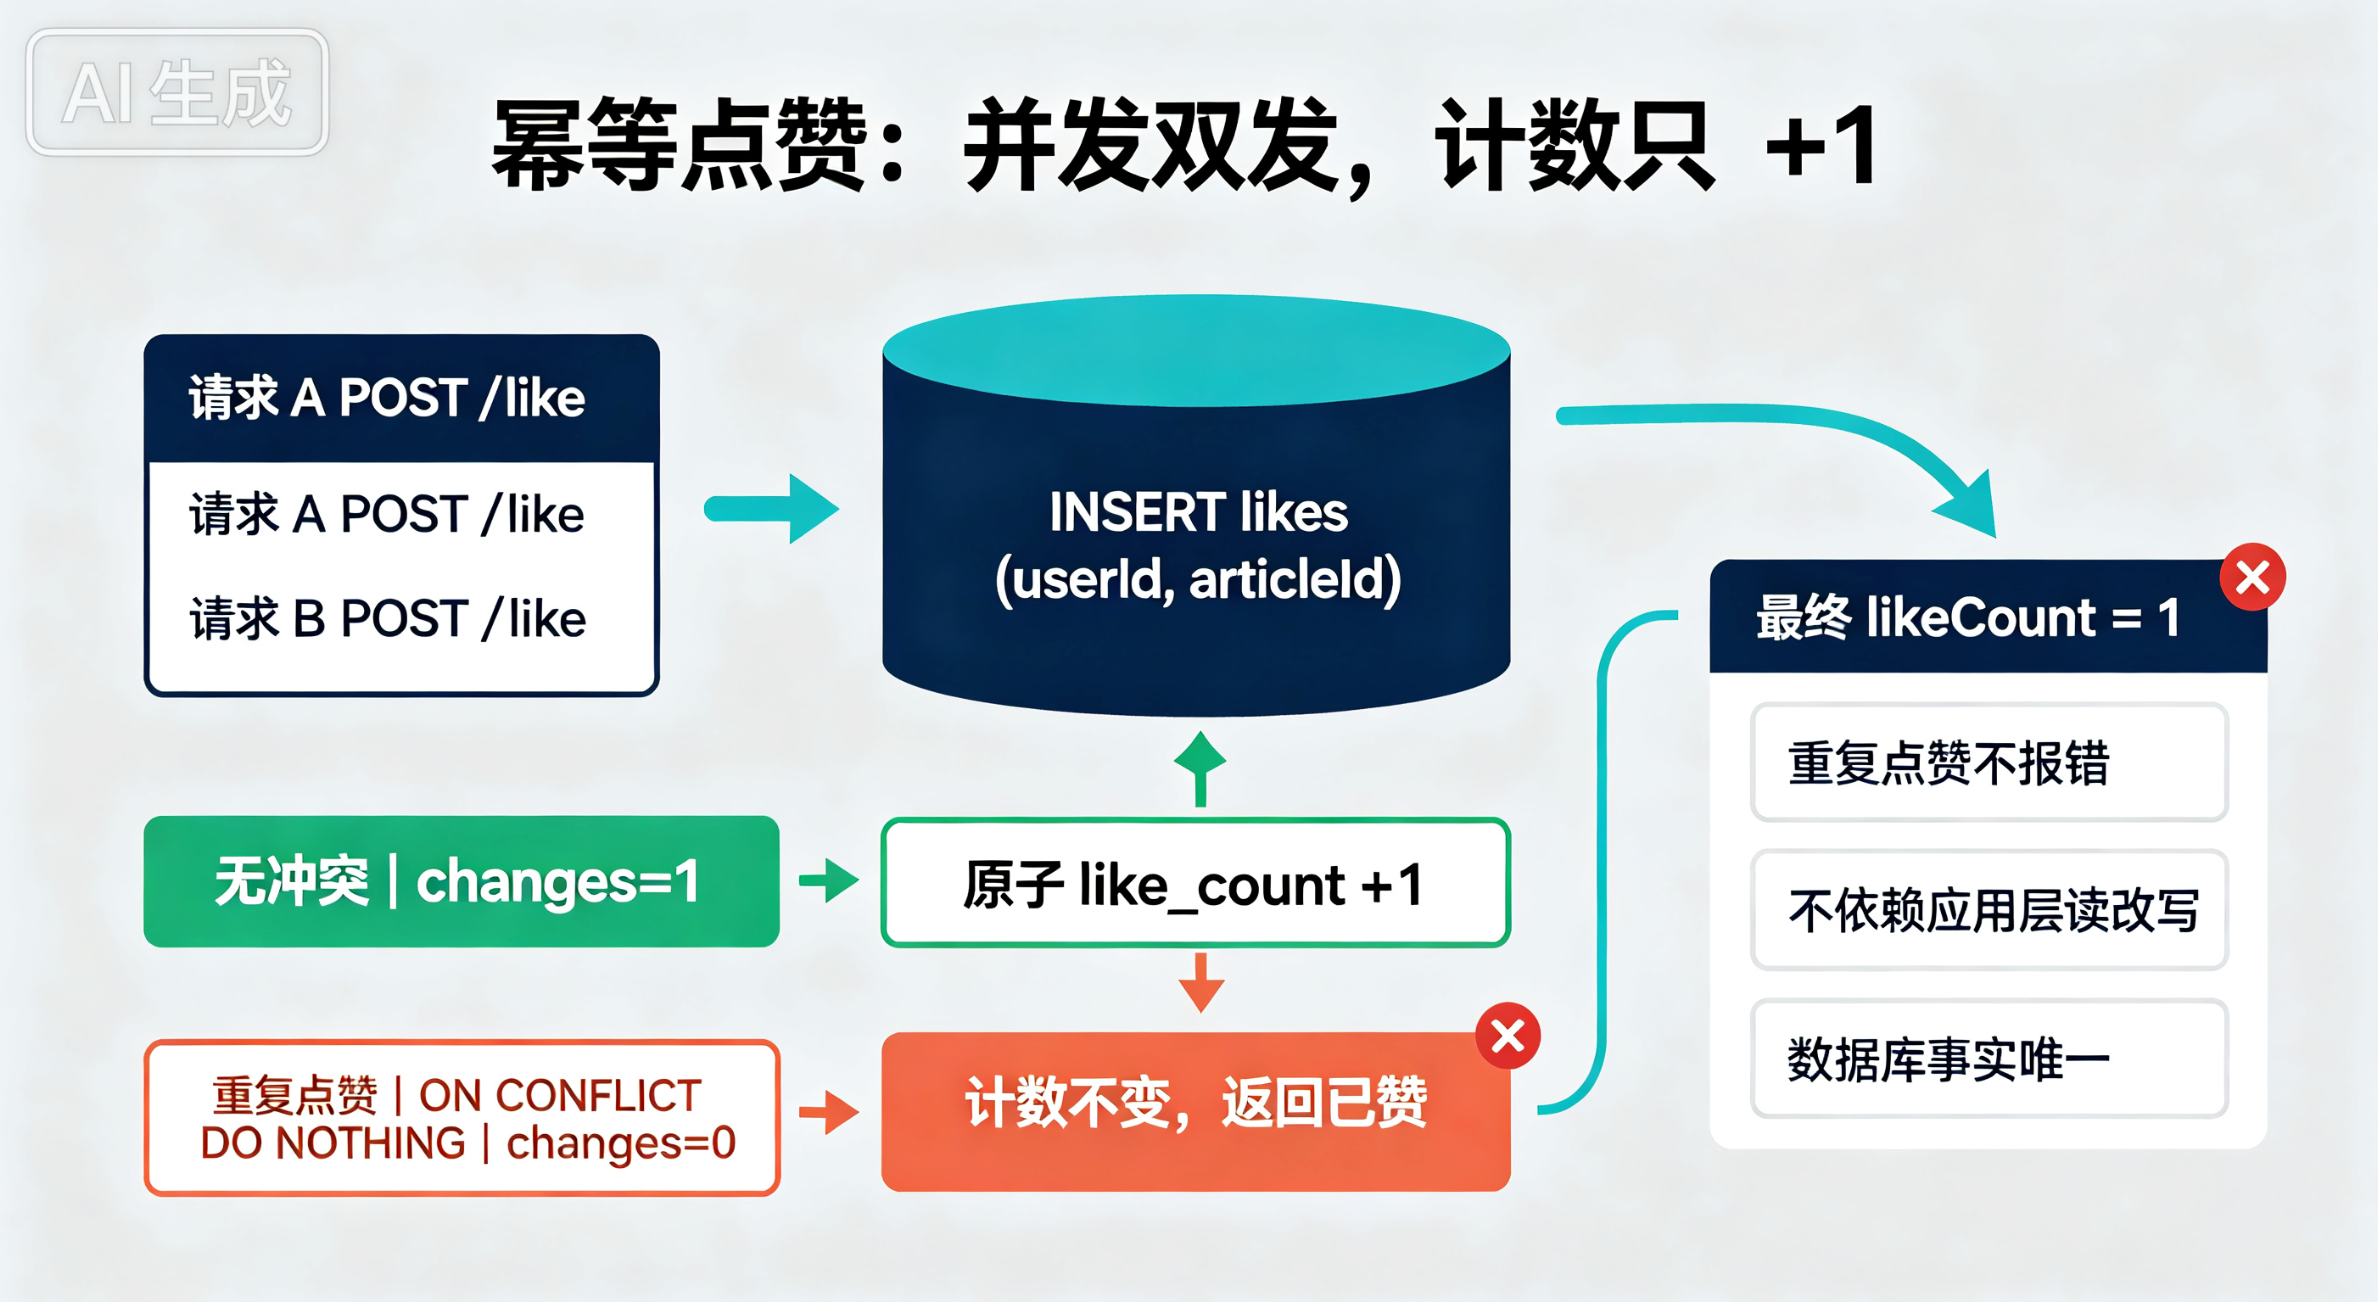
ON CONFLICT DO NOTHING:靠uniq_like唯一索引,重复点赞时插入被静默忽略,不会抛唯一约束错误(不会 500)。res.changes > 0才 +1 :数据库告诉你"这次到底插进去了没有"。插进去了(changes=1)才给like_count + 1;没插进去(重复点赞,changes=0)就不动计数。这就彻底消除了"应用层先 SELECT 再 UPDATE"的竞态------计数的增减,完全由"数据库这次有没有真正新增行"这一个事实驱动。- 原子
like_count + 1:+1在 SQL 表达式里完成(sql\like_count + 1``),不依赖先读出旧值,并发下不会丢更新。
所以"网络抖动点了两次"或"前端重复发请求",结果都是赞数只 +1,且绝不报错------这就是幂等的教科书实现。
四、P-44:幂等取消,下限夹 0 防负数
unlikeArticle(取消点赞)对称但更小心:
ts
// src/services/likes.ts --- unlikeArticle
export const unlikeArticle = async (
  userId: number,
  articleId: number,
): Promise<{ liked: false; likeCount: number }> => {
  await requireLikeArticle(articleId);
  const db = getDb();
  const existing = (
    await db
      .select({ id: likes.id })
      .from(likes)
      .where(and(eq(likes.userId, userId), eq(likes.articleId, articleId)))
      .limit(1)
      .all()
  )[0];
  if (existing) {
    await db.delete(likes).where(eq(likes.id, existing.id)).run();
    // 原子下限夹 0:-1 永不产生负数,且并发下读数陈旧也不漂移。
    await db
      .update(articles)
      .set({ likeCount: sql`CASE WHEN like_count > 0 THEN like_count - 1 ELSE 0 END` })
      .where(eq(articles.id, articleId))
      .run();
  }
  const fresh = (
    await db
      .select({ likeCount: articles.likeCount })
      .from(articles)
      .where(eq(articles.id, articleId))
      .limit(1)
      .all()
  )[0];
  if (!fresh) throw new AppError(ErrCode.INTERNAL, 500);
  return { liked: false, likeCount: fresh.likeCount };
};
要点:
- 先确认赞过再取消 :
existing不存在(用户本来就没赞)就不动计数直接返回liked:false,幂等------取消一个不存在的点赞,不该把赞数减成负数,也不该报错。 CASE WHEN like_count > 0 THEN ... - 1 ELSE 0 END:这是防负数的关键。即使因为某种并发导致读数陈旧,赞数也永远不会低于 0 。数学上赞数本就非负,用CASE把这条不变量焊死在 SQL 里,比应用层if (count > 0) count--更可靠(后者仍有竞态窗口)。
五、P-49:为什么存冗余 likeCount,而非每次 COUNT
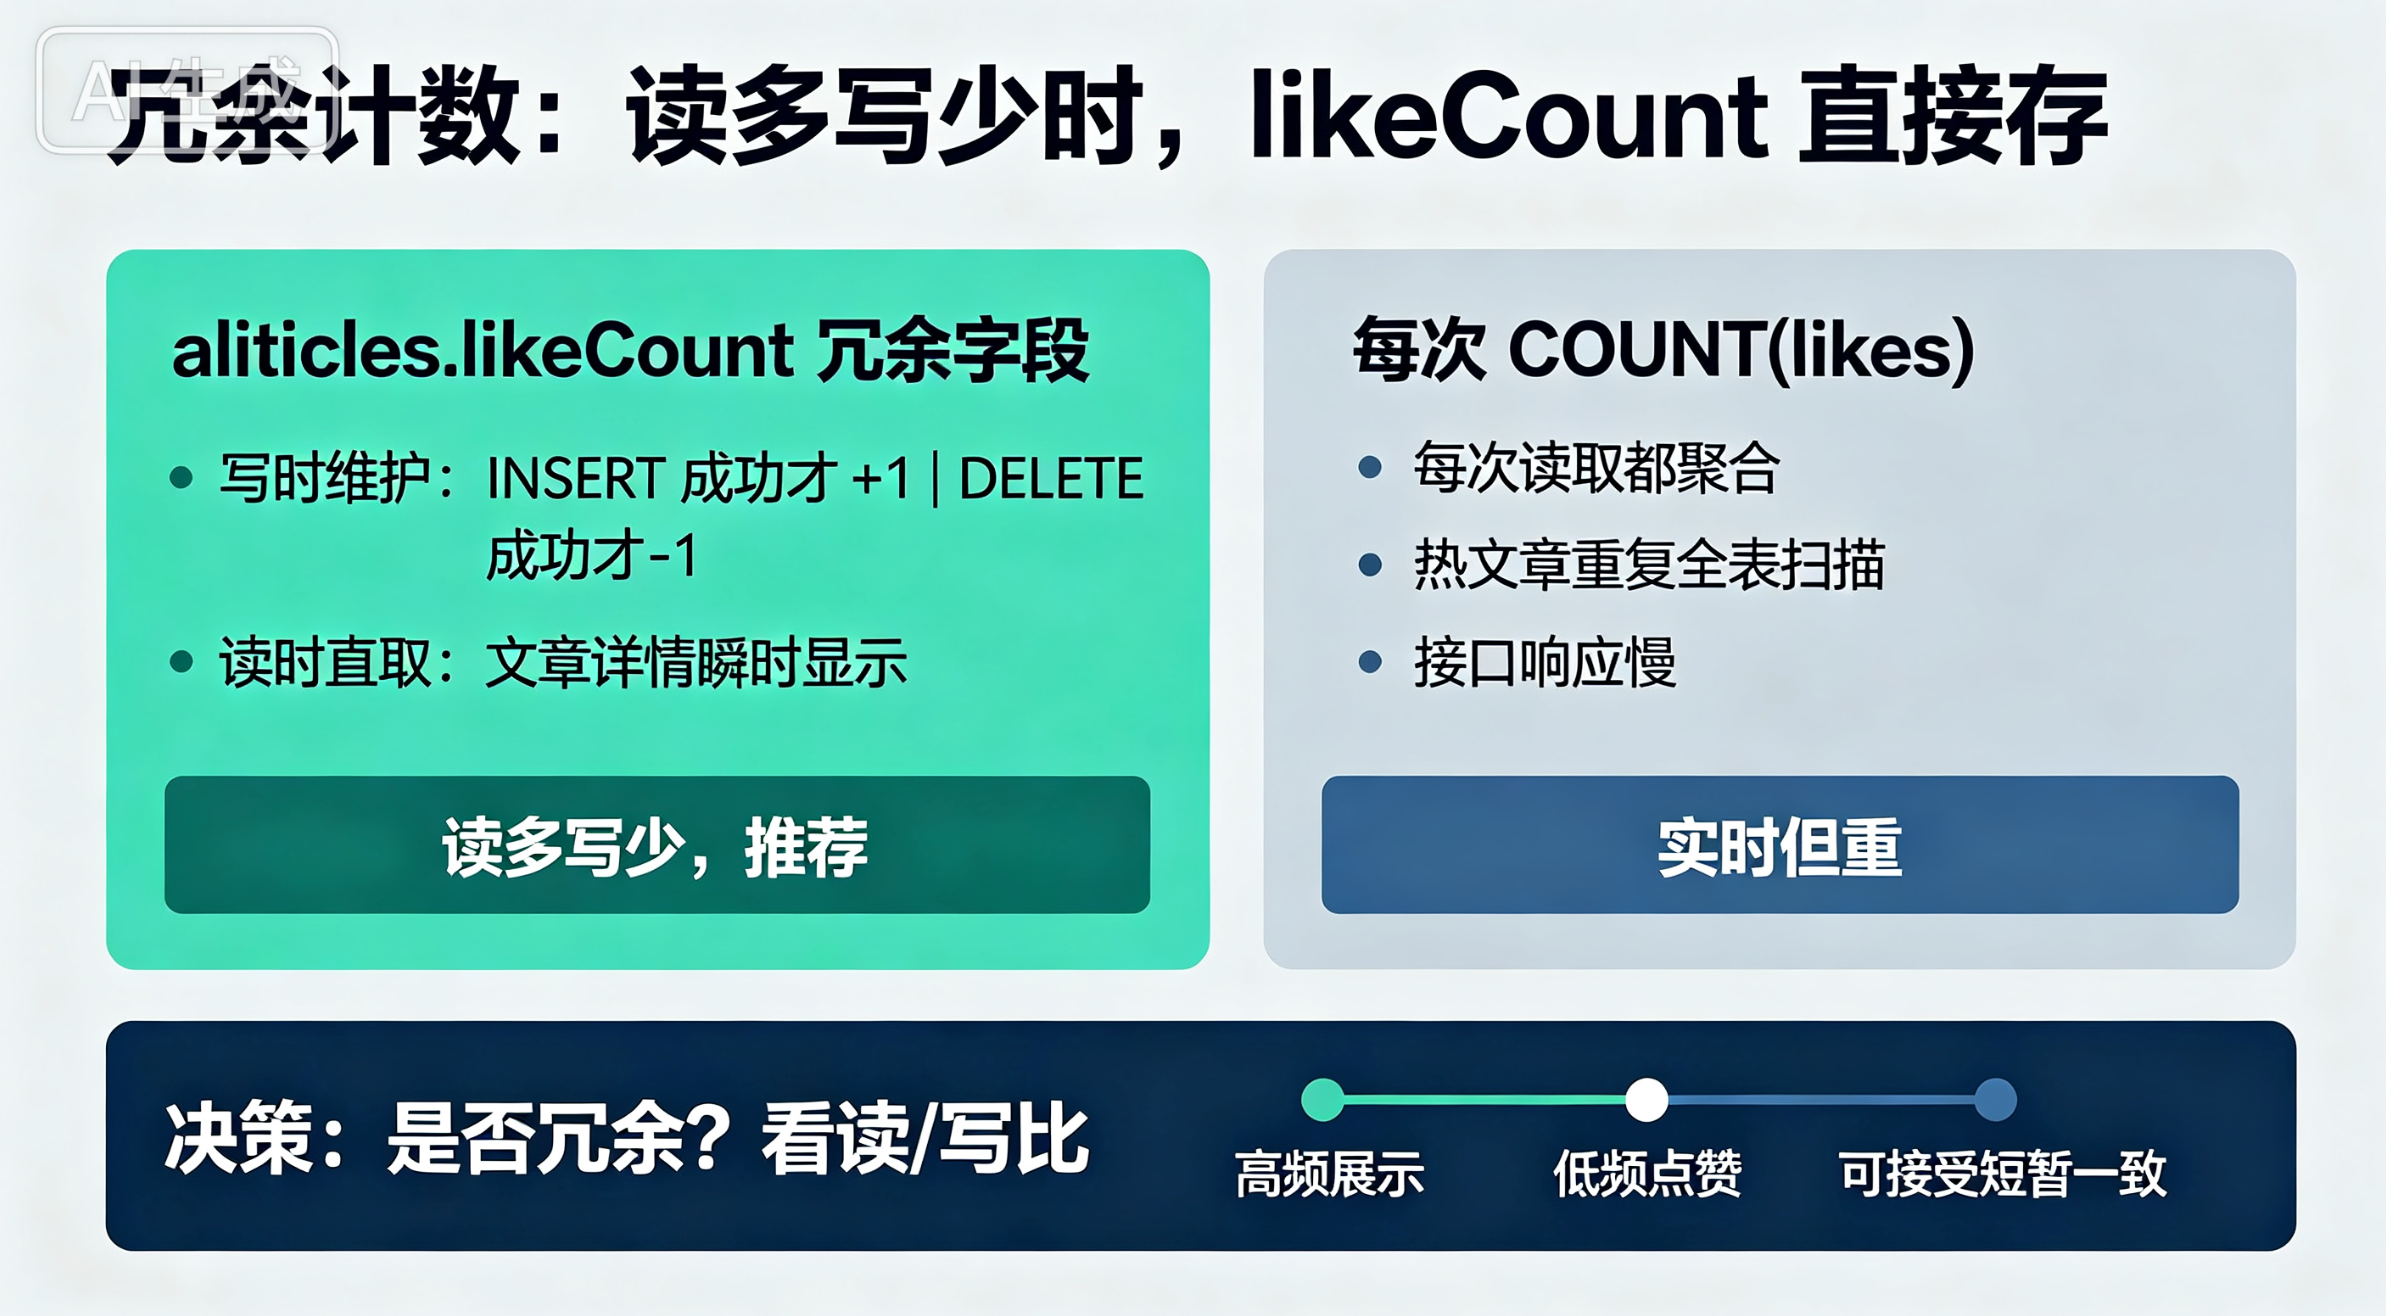
回到 articles.likeCount 这个冗余字段。它明显违反了"别冗余存储可计算数据"的朴素教条,但我们故意这么干,理由(P-49)很实在:
- 读多写少 :文章详情页每次都要显示赞数,是高频读;点赞/取消是低频写。如果每次读都
SELECT COUNT(*) FROM likes WHERE articleId=?,热文(几万赞)每次渲染都做一次全表聚合,纯属浪费。 - 冗余计数把"写时的一次小开销"换成"读时的零开销" :点赞时多维护一个
like_count字段,换来所有读者瞬时拿到赞数。对内容产品,这个 tradeoff 几乎总是划算的。 - 何时不冗余 :如果某业务点赞极少被展示、或需要"实时精确跨维度统计",那就别冗余,老老实实聚合。是否冗余,取决于读/写比------这正是 P-49 想传达的"规模与访问模式意识"。
顺带,这和阅读量:时间桶去重与原子计数的阅读量 viewCount 是同一个思路:把"高频展示的聚合值"冗余成一个字段,写时维护,读时直取。两处设计同源,可见"冗余计数"是本项目的通用手艺。
六、点赞态查询与"我的点赞"
除了点赞/取消,还有两个读端点:
GET /articles/:id/like/status(公开,optionalAuthMiddleware):返回{ liked, likeCount }。匿名用户liked=false,但likeCount照样给(公开信息);登录用户则查likes表里有没有自己的行,决定liked真假。前端据此切换"已赞/未赞"高亮,不用维护本地状态。GET /me/likes(需登录):返回"我点赞过的文章"列表,按点赞时间倒序,且只列published(已软删/未发布的赞过的文章不出现)。注意它返回的是ArticleSummary[]裸数组 (契约规定data为裸数组,不是带list/total的分页信封)------这是少数几个刻意不走标准分页信封的端点之一,路由层注释专门标注了这点,提醒别套错结构。
七、薄路由:登录才能赞,状态可匿名看
routes/likes.ts 把鉴权收在路由层,干干净净:
ts
likesRoute.post('/articles/:id/like', authMiddleware, ...);        // 必须登录
likesRoute.delete('/articles/:id/like', authMiddleware, ...);      // 必须登录
likesRoute.get('/articles/:id/like/status', optionalAuthMiddleware, ...); // 可匿名
likesRoute.get('/me/likes', authMiddleware, ...); // 必须登录点赞/取消/我的列表都要求登录(authMiddleware)------匿名不能点赞,这是内容互动的常识闸。唯独"点赞态"用 optionalAuthMiddleware:匿名也允许查(只是 liked=false),前端无需为"看一眼赞数"而强制登录。路由层只做"鉴权 + 取参",所有幂等/原子逻辑在 services/likes.ts,完全符合薄路由纪律。
八、和点赞与阅读量防刷的对比
把点赞和阅读量:时间桶去重与原子计数的阅读量放一起看,能看清两种"防作弊"思路的差异:
| 阅读量 viewCount | 点赞 likeCount | |
|---|---|---|
| 防重复手段 | 24h 时间桶去重(同一身份同天一次) | 关联表唯一约束(同一身份永远一次) |
| 语义 | 热度可多次累计(隔天再计) | 二元态(赞过/没赞过) |
| 计数维护 | 去重记录插成功才 +1 | INSERT 成功(changes>0)才 +1 / DELETE 成功才 -1 |
| 并发 | 唯一索引兜底不重复 +1、不 500 | ON CONFLICT DO NOTHING 不重复、不 500 |
两者都用了"数据库唯一约束当锁 + 靠 changes/冲突判断是否真改动 "这个核心套路,只是阅读量允许"时间窗口后重计"、点赞是"终身一次"。底层哲学一致:让数据库告诉你"这次到底改了没",而不是应用层自己猜,计数就永远不会漂。
十、重试与并发下的真实时序
把上面逻辑放进两个具体场景,幂等的价值就一目了然。
场景|用户连点两下赞(或前端重试发两次 POST /like):
- 请求 1:
INSERT likes(userId, articleId)→ 唯一索引放行,changes=1→like_count由 0 变 1 → 返回{ liked:true, likeCount:1 }。 - 请求 2:
INSERT同一行 →ON CONFLICT DO NOTHING静默忽略,changes=0→ 不 +1 → 返回{ liked:true, likeCount:1 }。
两次都成功,但赞数只 +1。对照"如果没做幂等"(先查有没有、没有再插、再 +1):两次请求可能都查到"还没赞",都插入、都 +1,赞数变成 2------这就是典型的重复计数 bug。幂等把"用户意图"和"数据库事实"对齐:你点了几次不重要,数据库里"有没有这行"才是唯一真相。
场景|取消再取消:
- 第一次取消:
existing存在 → 删行 +CASE把like_count1→0 →{ liked:false, likeCount:0 }。 - 第二次取消:
existing不存在 → 直接返回{ liked:false, likeCount:0 },赞数纹丝不动、永不为负。
无论用户怎么乱点,"赞数 ≥ 0"和"每人每篇至多一赞"这两条不变量都焊死在 SQL 里,应用层再怎么抖都不破。
十一、为什么 /me/likes 返回裸数组
前面提过 GET /me/likes 返回的是 ArticleSummary[]裸数组 ,不走标准分页信封(没有 list/total 包裹)。这不是疏忽,是契约的刻意约定:会员中心的"我的点赞"是一个不定长收藏夹式列表 ,前端通常整页拉取、本地做无限滚动或简单渲染,不需要后端强加分页结构。路由注释里专门标注"契约 data 为裸数组",就是提醒实现者和后续维护者:这个端点故意打破标准信封,别为了"统一"而强行套分页壳 ------统一的代价若是制造无意义的空 total 字段,那就不该统一。这也是一种纪律:结构服务于消费方,而非反过来。
十二、小结
点赞系统是把"二元态 + 高频计数"做对的范例:
- 两张表协作 :
likes关联表(唯一索引防重复、可查态)+articles.likeCount冗余计数(读快)。 - P-44 幂等点赞 :
ON CONFLICT DO NOTHING+changes>0才原子+1;并发双发仅 +1、不 500、不竞态漂移。 - P-44 幂等取消 :先查
existing再删;CASE WHEN like_count>0 THEN -1 ELSE 0下限夹 0,永不为负。 - P-49 冗余计数 :读多写少场景下,冗余
likeCount换读时零聚合;访问模式决定要不要冗余。 - 读端点 :
/like/status公开(匿名liked=false),/me/likes只列 published、返回裸数组。 - 薄路由 :点赞/取消/我的列表
authMiddleware;状态查询optionalAuthMiddleware。 - 与阅读量同源:都用"唯一约束当锁 + 靠 changes 判真改动",只是点赞是终身一次、阅读量按天重计。
下一篇({{LINK:M1-30}})我们聊"通知系统":文章发布、评论通过这类事件,怎么变成用户收得到的站内信,以及通知和前面点赞/评论的联动。
如果这篇文章对你有帮助,欢迎订阅我的 CSDN 专栏 「成为全栈」:
🔗 专栏地址:https://blog.csdn.net/fungleo/category_13204651.html
📦 本系列配套代码仓库:https://github.com/fengcms/become-a-full-stack-developer