接口签名校验失败、文件秒传对不上、两边日志里的 MD5 怎么看都不一样,这类问题我前后排过不下十次。最后发现,哈希算法本身从来没错过,错的都是「喂进去的字节」和「吐出来的格式」。
下面八个原因按我碰到的频率排,每个都在 Node 25.8 上实跑过,输出原样贴出来,你可以直接复制去对。
先记住一句话:哈希算的是字节,不是字符串。字符串到字节之间的每一步转换,都是一个对不上的机会。
1. 字符编码:同一个「你好」,三种 MD5
JS 里的字符串是 UTF-16,Java 的 getBytes() 不传参数时用平台默认编码,PHP 拿到的是什么取决于文件和请求本身的编码。只要两边不是同一种编码,结果就不一样。
js
import { createHash } from 'node:crypto';
const md5 = (data) => createHash('md5').update(data).digest('hex');

md5('你好');                                // 字符串默认按 UTF-8
md5(Buffer.from('你好', 'latin1'));        // 被当成 latin1 截断
md5(Buffer.from('你好', 'utf16le'));       // UTF-16 小端
输出:
7eca689f0d3389d9dea66ae112e5cfd7   UTF-8
52a90a58a24523da1b9d09124b1f3861   latin1
bda2556346d512a3d529d0e88725cff5   UTF-16LE
终端里 printf '你好' | md5 得到的也是 7eca689f...,和 UTF-8 那行一致。约定很简单:两边都显式转成 UTF-8 字节再算 。Java 写 getBytes(StandardCharsets.UTF_8),浏览器用 new TextEncoder().encode(s)。
2. 结尾多了一个换行
这是命令行验证时最常见的坑。echo 默认在末尾加 \n:
bash
echo -n abc | shasum -a 256
# ba7816bf8f01cfea414140de5dae2223b00361a396177a9cb410ff61f20015ad
echo abc | shasum -a 256
# edeaaff3f1774ad2888673770c6d64097e391bc362d7d6fb34982ddf0efd18cb
第一行才是 sha256("abc") 的标准值。从文件读密钥、从配置读盐值的时候也一样,编辑器保存时自动补的末尾换行会悄悄混进去。读出来先 trim(),或者干脆约定不允许首尾空白。
3. Windows 换行 CRLF
同一段多行文本,在 Windows 上编辑过一次,\n 就可能变成 \r\n:
js
md5('a\nb');    // 8cdeb44417f3c26826595d5820cf5700
md5('a\r\nb');  // 65d5f03c46e62e3f2babbe712d2ce464
Git 的 core.autocrlf 也会干这件事:仓库里是 LF,Windows 同事检出来是 CRLF,同一个文件两边算出的哈希不同。对文本做签名时,先统一 s.replace(/\r\n/g, '\n')。
4. 看不见的 BOM
有些编辑器保存 UTF-8 文件时会在开头加 EF BB BF 三个字节(BOM),读进 JS 后是一个 字符,打印出来什么都看不到:
js
md5('abc');  // 53a492debae1c7abf6615813b4b5ca99
md5('abc');        // 900150983cd24fb0d6963f7d28e17f72
日志里两边的字符串看起来一模一样,长度却差 1。排查时先打 s.length 和 Buffer.from(s).toString('hex'),比肉眼对字符可靠得多。
5. 输出格式:hex、大小写、Base64、Base64URL
算法和输入都对了,最后一步「怎么把 32 个字节写成文本」还能再错一次:
js
const sha = createHash('sha256').update('abc');
sha.copy().digest('hex');        // ba7816bf8f01cfea...f20015ad
sha.copy().digest('base64');     // ungWv48Bz+pBQUDeXa4iI7ADYaOWF3qctBD/YfIAFa0=
sha.copy().digest('base64url');  // ungWv48Bz-pBQUDeXa4iI7ADYaOWF3qctBD_YfIAFa0
几个常见的不一致:
| 现象 | 原因 |
|---|---|
| 一边全小写一边全大写 | hex 大小写约定不同,比较前统一 toLowerCase() |
| 一边 64 位一边 44 位 | 一边 hex 一边 Base64 |
只差 + / = 这几个字符 |
一边是 Base64,一边是 Base64URL |
Base64 里的 + 变成了空格 |
放进 URL 查询参数时没编码 |
最后一条在签名放进 query string 的场景下特别多,服务端拿到的已经不是原来那串了。
6. HMAC 不是「把密钥拼在前面再哈希」
接口签名文档写的是 HMAC-SHA256,有人实现成 sha256(key + data),结果当然对不上:
js
import { createHmac } from 'node:crypto';
createHmac('sha256', 'key').update('abc').digest('hex');
// 9c196e32dc0175f86f4b1cb89289d6619de6bee699e4c378e68309ed97a1a6ab
createHash('sha256').update('key' + 'abc').digest('hex');
// 1141e2212b08bb07b3c9558bb7a90f4a99b1c6f0c97e970c279df64e7f0875ed
HMAC 内部要对密钥做两次填充、算两轮哈希,和简单拼接是两回事。拼接写法还有长度扩展攻击的问题,签名场景别用。
7. JSON 字段顺序
对一个对象签名,最省事的写法是 md5(JSON.stringify(obj)),但字段顺序一变,字符串就变了:
js
md5(JSON.stringify({ a: 1, b: 2 }));  // {"a":1,"b":2} → 608de49a4600dbb5b173492759792e4a
md5(JSON.stringify({ b: 2, a: 1 }));  // {"b":2,"a":1} → 9915965eb40d343a8fe26e4e341d1a05
后端用 Go 的 map 序列化会按 key 排序,用 Java 的 HashMap 顺序不保证,前端对象按插入顺序。数字也有坑:JSON.stringify({p: 1.10}) 输出 {"p":1.1},另一边如果按字符串 "1.10" 拼就对不上。
签名要定一个规范化 规则:参数按 key 字典序排好,用 k=v&k=v 拼起来,数字按约定格式转字符串,再去算。各家支付平台的签名文档都是这么规定的,原因就在这。
8. Unicode 规范化:看起来一样的 é
é 可以是一个码点(U+00E9),也可以是 e 加一个组合重音符(U+0065 U+0301)。macOS 文件系统、部分输入法会产生后一种:
js
const nfc = 'é'.normalize('NFC');  // length 1
const nfd = 'é'.normalize('NFD');  // length 2
md5(nfc);  // 66ddcd97cfdeabb2f6fb8a999b4bc76f
md5(nfd);  // 5526861fbb1e71a1bda6ac364310a807
用户名、文件名参与签名时偶尔会撞到。两边都先 normalize('NFC') 再算。
附:浏览器里没有 MD5
浏览器原生的 crypto.subtle.digest 支持 SHA-1、SHA-256、SHA-384、SHA-512,不支持 MD5:
js
await crypto.subtle.digest('SHA-256', new TextEncoder().encode('abc'));
// → ba7816bf...f20015ad,和 Node 一致
await crypto.subtle.digest('MD5', new Uint8Array(1));
// NotSupportedError: Unrecognized algorithm name
前端要算 MD5 只能用 spark-md5、crypto-js 这类库。另外 crypto.subtle 只在 HTTPS 和 localhost 下可用,内网 http 地址上调用会拿到 undefined,这也是「本地好好的,测试环境报错」的常见来源。
排查顺序
我现在遇到哈希对不上,固定按这个顺序查:
- 两边都把输入 打成 hex(
Buffer.from(s).toString('hex')),先比字节,不比哈希。字节不一样,就回去看编码、换行、BOM、规范化、JSON 顺序。 - 字节一样,再比算法:是不是一边 HMAC 一边普通哈希,SHA-256 有没有写成 SHA-1。
- 算法也一样,最后比输出格式:hex 大小写、Base64 还是 Base64URL、URL 里有没有被转义。
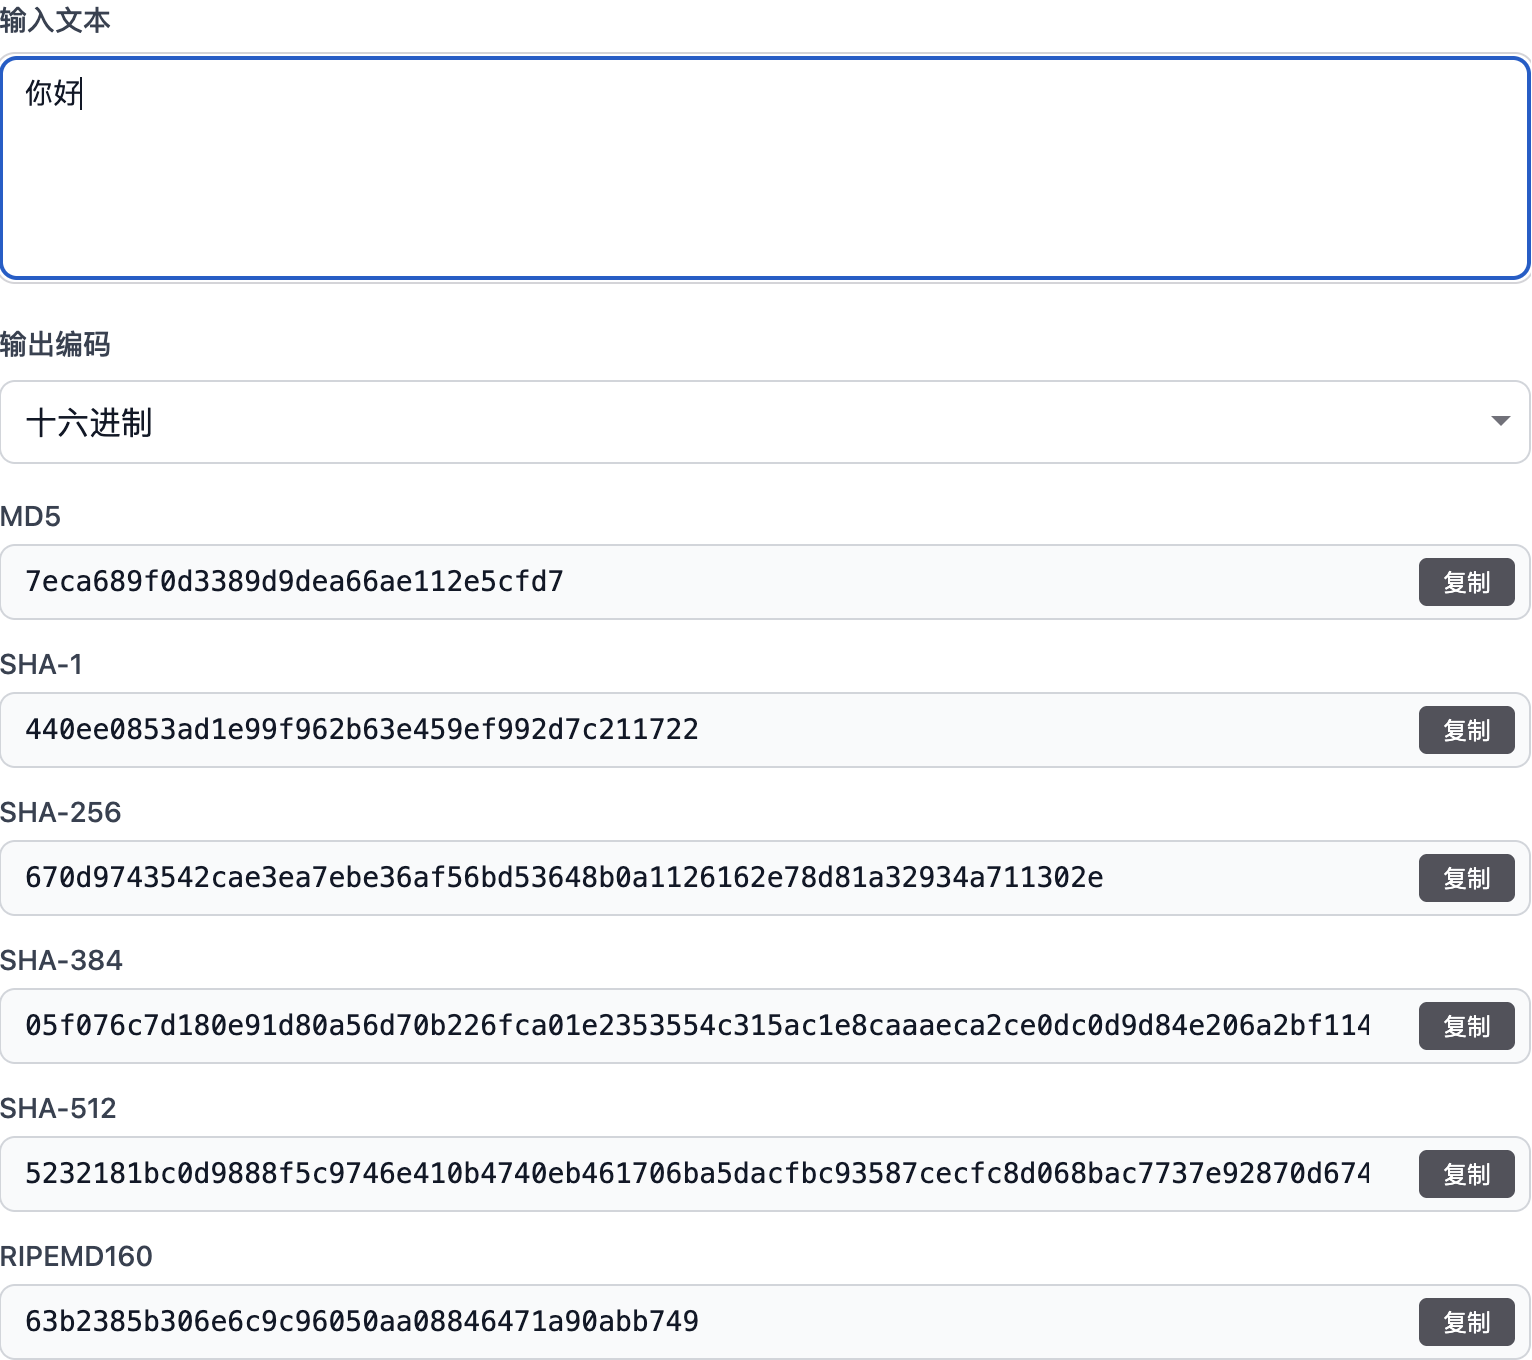
做第一步时需要一个随手能用的对照工具。我平时用自己做的 福兮的哈希计算工具,贴一段文本,MD5、SHA-1、SHA-256、SHA-384、SHA-512、RIPEMD160 六种一起按 UTF-8 算出来,可以切十六进制或 Base64 输出,拿来和代码里的结果对一下很快。比如输入「你好」,MD5 是 7eca689f...,和第 1 节 UTF-8 那一行一致:
它的局限也说清楚:只能算文本 ,不能拖文件进去算文件哈希;HMAC 在站上是另一个工具,这个页面里没有。要核对大文件的哈希,还是用命令行 shasum -a 256 文件名 或者 certutil -hashfile 文件名 SHA256(Windows),这两个读的是原始字节,不会有上面这些编码问题。