高并发系统如何提升吞吐量?从扩容、缓存、异步到数据库优化
摘要:高并发系统不只是"挡住流量"。真正重要的是,在系统保持稳定的前提下,让更多正常请求能够被处理,让单位时间内完成更多业务。本文从 QPS 与吞吐量的区别开始,逐步讲清横向扩容、缓存、异步化、数据库优化,以及为什么系统能力提升之后仍然需要限流保护。
关键词:高并发、吞吐量、QPS、横向扩容、缓存、异步、数据库优化、容量规划
一、先看全局:高并发系统怎样真正提高吞吐量?
前面讲秒杀时,我们重点讨论了:
- 漏桶
- 令牌桶
- 分层限流
- Redis 库存准入
- Kafka / RocketMQ 削峰
这些手段主要是在回答:
流量超过系统能力后,怎样避免系统被打垮?
但如果我们换一个问题:
系统现在只能稳定处理 5,000 QPS,怎样让它稳定处理 20,000、50,000 QPS?
答案就不能只是"继续限流"。
真正提高系统处理能力,一般围绕四个方向:
text
扩容
+
缓存
+
异步
+
优化
最后再给新的系统容量设置:
text
限流
+
熔断
+
降级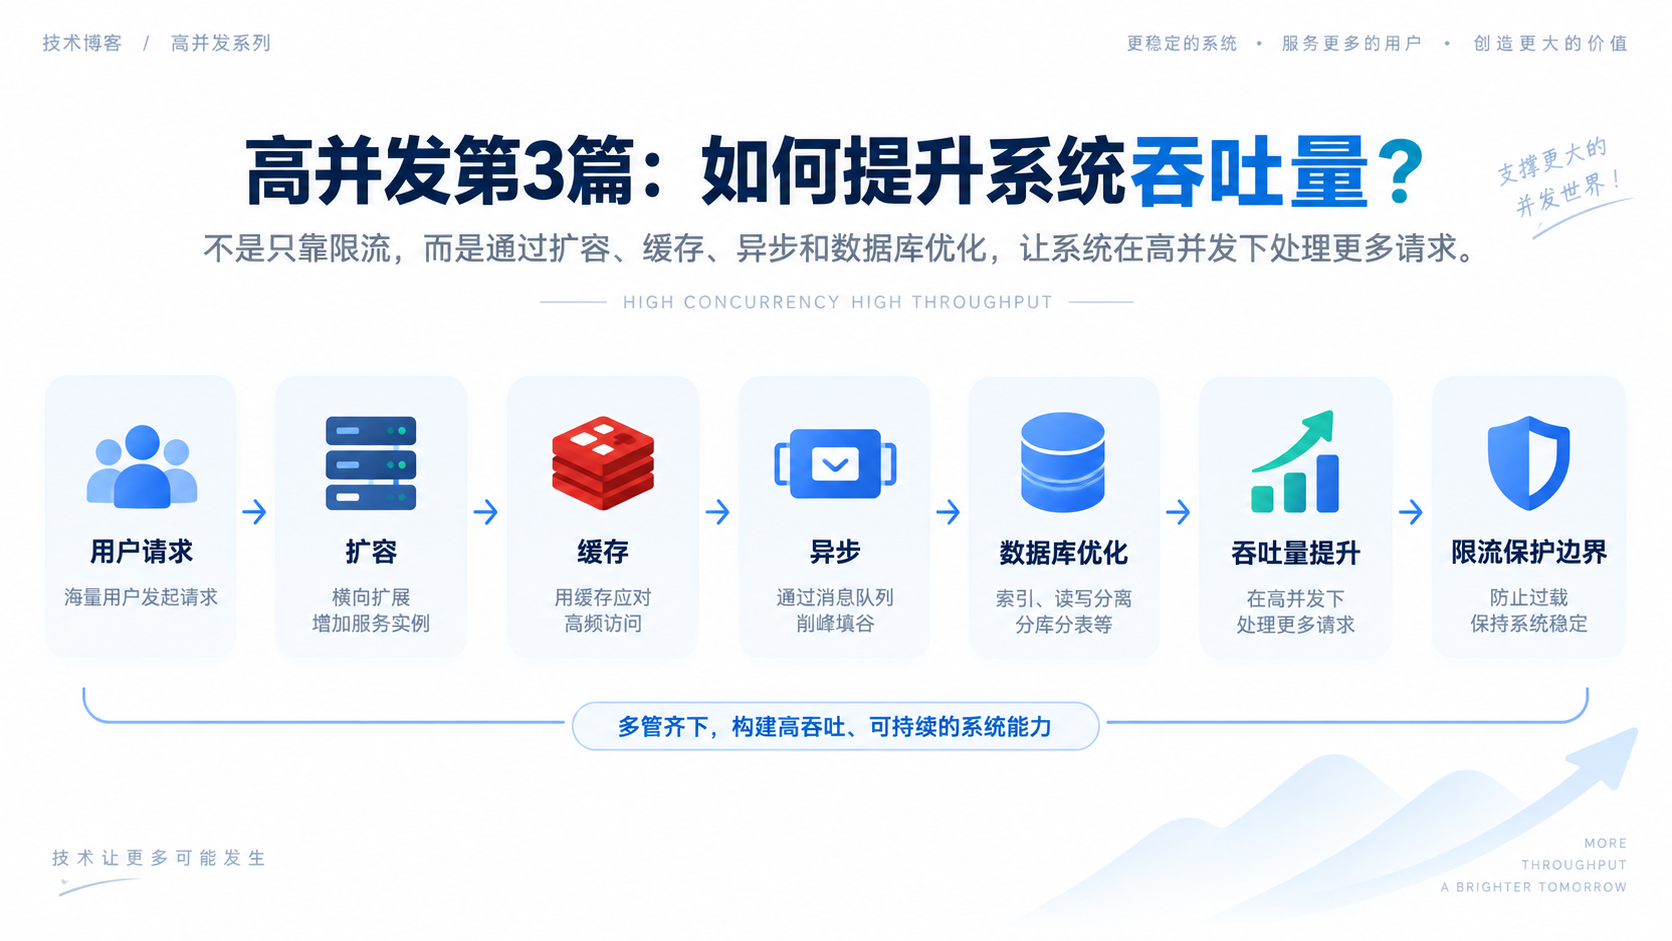
可以把这篇文章先记成一句话:
扩容、缓存、异步、优化是在"提高容量";限流、熔断、降级是在"保护容量"。
二、QPS 和吞吐量是一回事吗?
这是高并发里非常容易混淆的一个概念。
2.1 QPS 是什么?
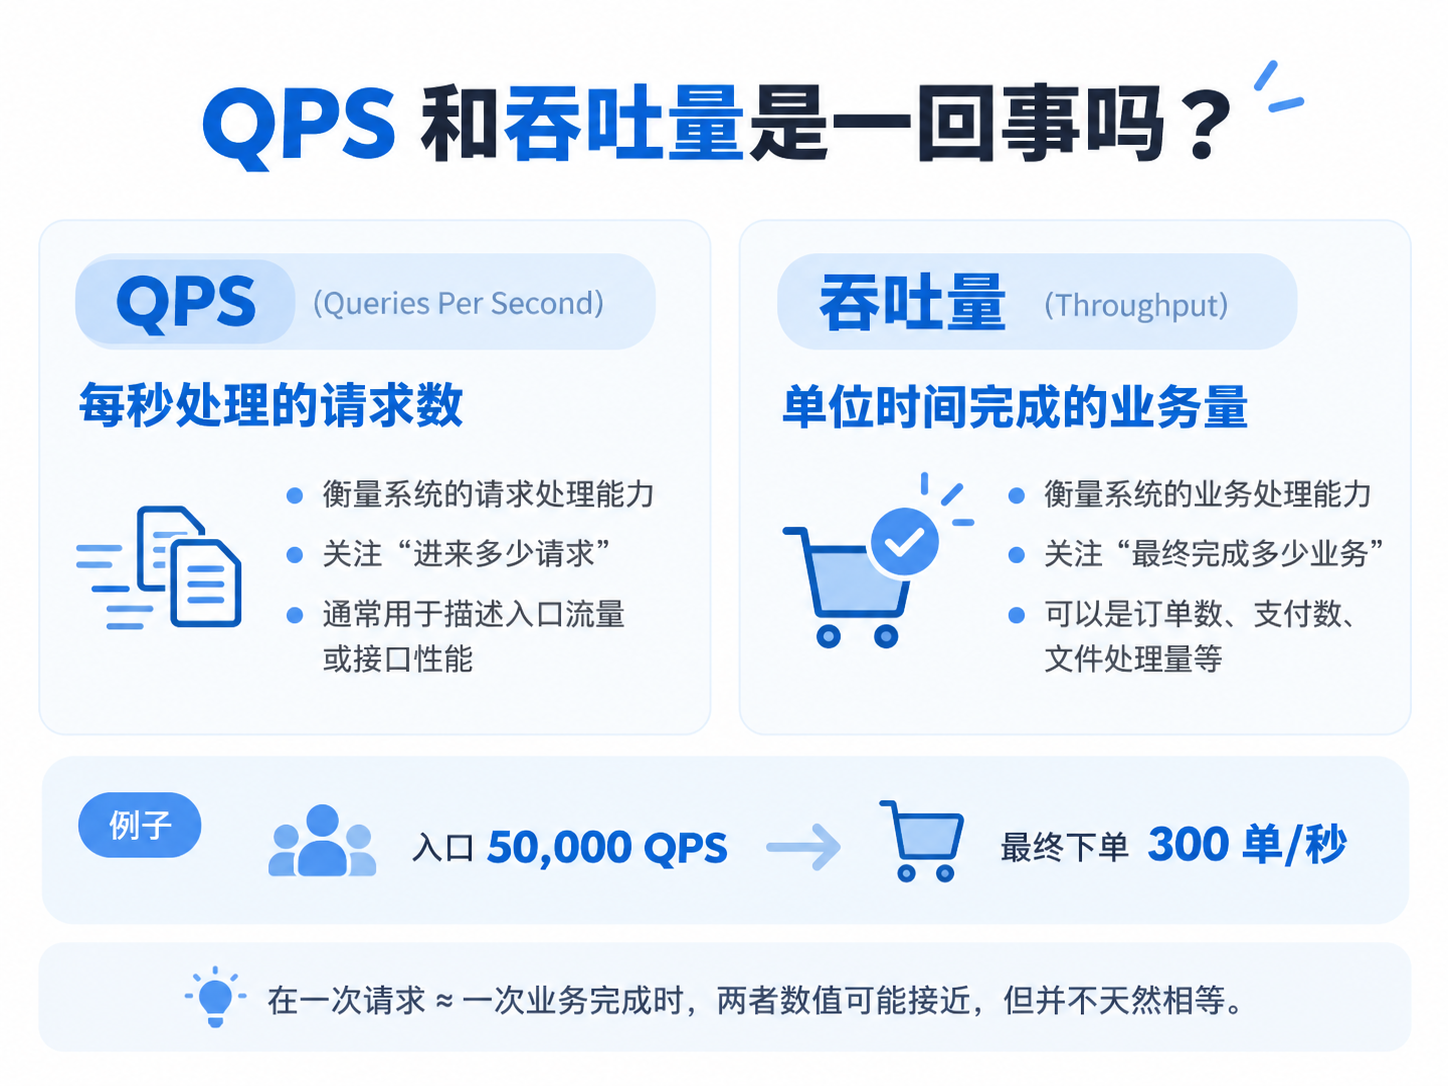
QPS(Queries Per Second)通常表示:
系统每秒处理多少个请求。
例如:
text
某接口 1 秒处理 5,000 个请求

QPS = 5,000
虽然名字是 Queries Per Second,但在 Web 接口、网关、压测场景里,经常直接用它表示"每秒请求数"。
2.2 吞吐量是什么?
吞吐量(Throughput)范围更广:
单位时间内,系统真正完成多少工作。
单位可以是:
text
请求 / 秒
订单 / 秒
消息 / 秒
任务 / 秒
文件 / 分钟
MB / 秒
Token / 分钟
例如:
text
API 每秒处理 5,000 个请求
→ QPS = 5,000

订单系统每秒成功创建 800 个订单
→ 业务吞吐量 = 800 单 / 秒
所以严格来说:
QPS 是吞吐量的一种请求层指标,但吞吐量不只等于 QPS。
2.3 为什么有时候两者看起来相等?
如果:
text
一个请求
=
完成一次完整业务
例如:
text
GET /product/1001

1 个请求
=
完成 1 次商品查询
那么:
text
5,000 QPS
≈
5,000 次查询 / 秒
此时 QPS 和业务吞吐量数值可能接近。
但秒杀就完全不同:
text
入口:50,000 QPS
        ↓
网关准入:5,000 QPS
        ↓
真正抢到库存:1,000 个请求
        ↓
订单消费者:300 单 / 秒
这里:
text
入口 QPS = 50,000

最终订单吞吐量 = 300 单 / 秒
两者显然不是一个概念。
所以面试时比较准确的说法是:
QPS 是请求维度的吞吐指标;吞吐量描述单位时间完成的业务量。在"一次请求对应一次业务完成"的场景下,两者可能接近,但并不天然相等。
三、横向扩容:让更多服务器一起处理请求
提高系统吞吐量最直接的方法之一,就是:
增加计算资源。
假设一台 Spring Boot 服务稳定只能处理:
text
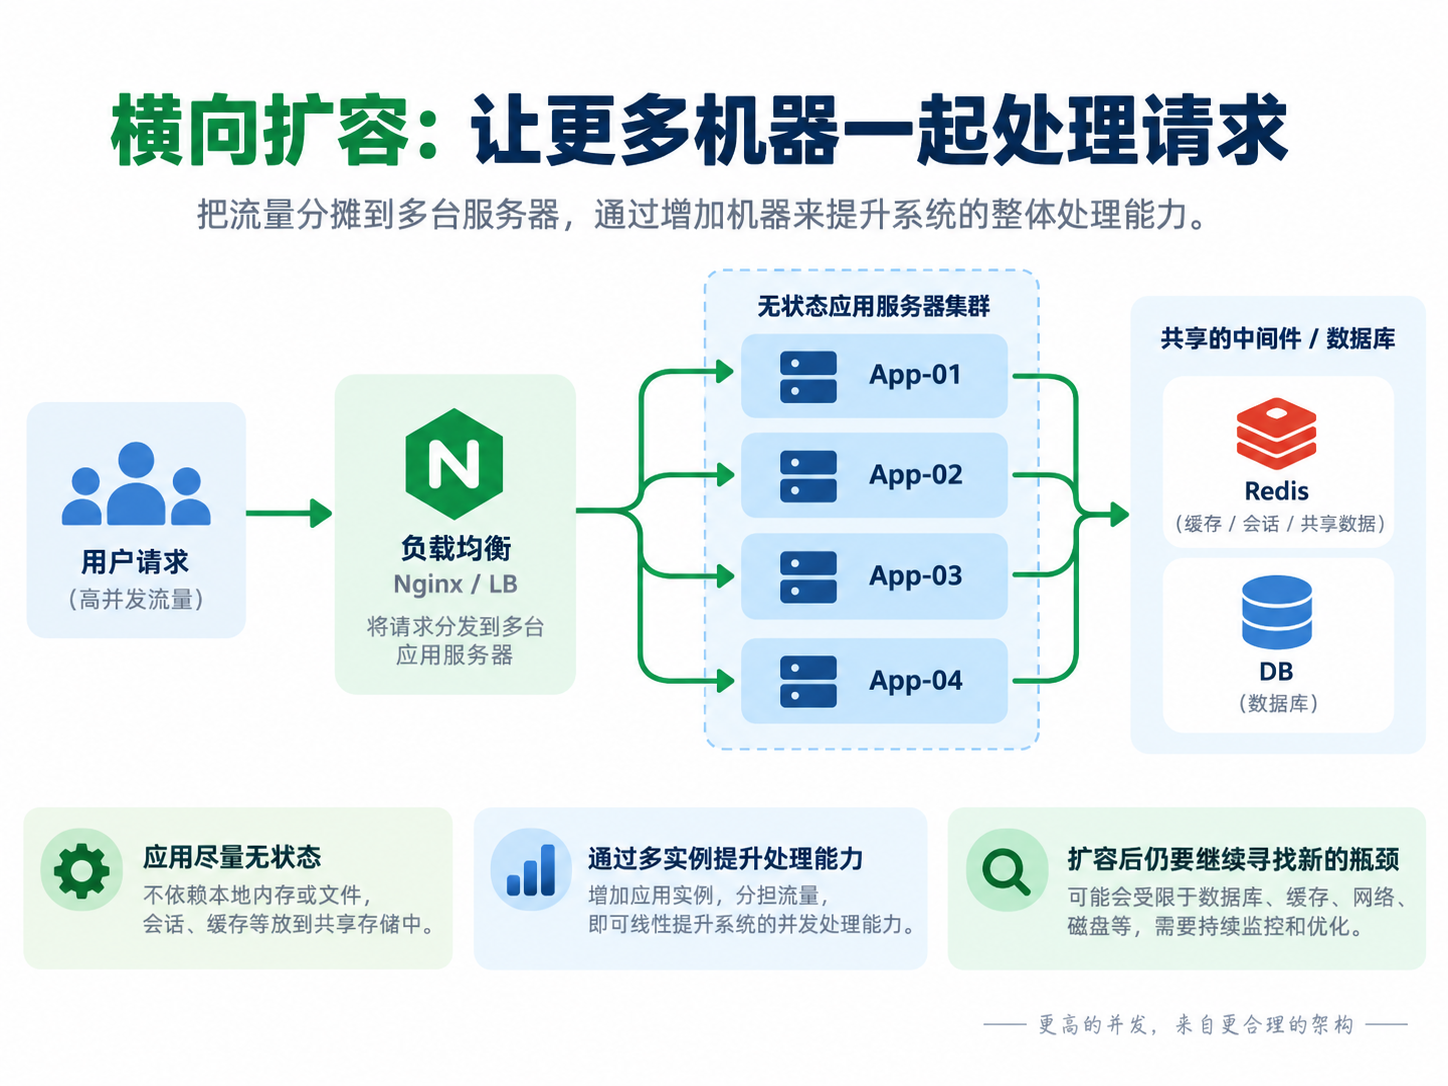
3,000 QPS那么可以通过负载均衡把请求分发到多台应用服务器:
text
                  Nginx / Load Balancer
                          ↓
          ┌───────────────┼───────────────┐
          ↓               ↓               ↓
       App-01          App-02          App-03
      3000 QPS        3000 QPS        3000 QPS
理论上系统整体处理能力就有机会继续提高。
3.1 为什么服务最好设计成无状态?
如果用户 Session 只保存在某一台服务器内存:
text
第一次请求
→ App-01
→ 登录成功

第二次请求
→ App-02
→ 找不到 Session
那么机器越多,问题反而越明显。
所以集群化时通常会:
text
Token / JWT或者:
text
Session
↓
Redis
这样任意一台服务器都可以处理用户请求。
3.2 横向扩容并不是无限有效
如果应用服务器:
text
App × 20 台但最终所有请求还是:
text
↓
同一个 MySQL
那么应用层扩容后,MySQL 很可能成为新的瓶颈。
所以高并发优化永远不是:
"加机器就结束。"
而是:
每提升一层容量,都要继续寻找下一层瓶颈。
四、缓存:让更多请求不用访问数据库
如果一个商品详情接口有:
text
10,000 QPS每个请求都查 MySQL:
text
10,000 QPS
↓
10,000 次数据库查询 / 秒
显然成本非常高。
但很多数据:
- 商品信息
- 活动配置
- 字典数据
- 首页热点
- 排行榜
并不会每毫秒变化。
这时就可以通过缓存让请求提前结束:
text
用户
 ↓
浏览器 / CDN
 ↓
应用本地缓存
 ↓
Redis
 ↓
MySQL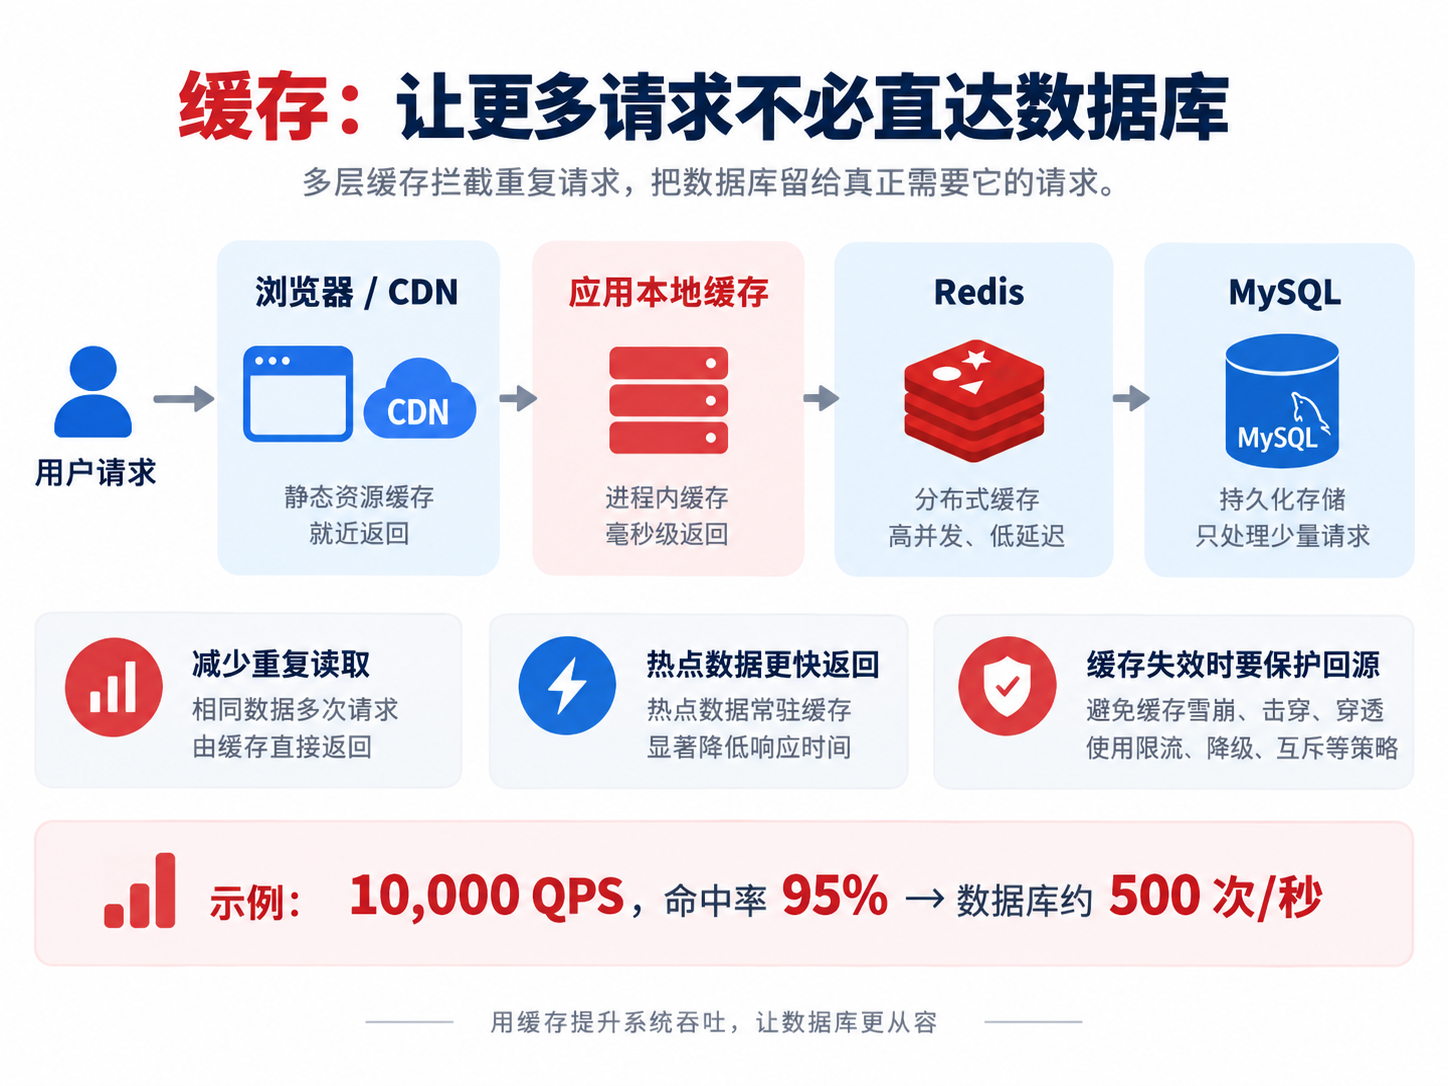
假设:
text
接口 QPS = 10,000
缓存命中率 = 95%
那么访问数据库的大约只有:
text
10,000 × 5%
=
500 次 / 秒
这意味着:
系统不是拒绝了 9,500 个请求,而是让 9,500 个请求用更低成本完成。
这就是缓存提高吞吐量的本质。
4.1 多级缓存为什么有效?
不同缓存距离用户不同:
text
浏览器缓存
→ 几乎不进入服务器

CDN
→ 不回源应用

本地缓存
→ 不访问网络

Redis
→ 不访问数据库

MySQL
→ 最终数据源
越靠前完成,请求成本越低。
4.2 缓存最大的问题不是"有没有",而是"失效时怎么办"
假设某个热点 Key:
text
10,000 QPS突然过期:
text
10,000 请求同时 Cache Miss
↓
一起访问 MySQL
就可能出现缓存击穿。
常见处理方法:
- 热点数据预热
- 过期时间加随机值
- 同 Key 请求合并
- 互斥回源
- 限制回源并发
- 业务允许时返回短时间旧数据
所以:
高性能缓存设计,不只是提高命中率,还要保护缓存失效后的数据库。
五、异步化:缩短核心链路,让请求更快完成
一个订单接口可能最开始写成:
text
用户下单
↓
创建订单
↓
扣库存
↓
发优惠券
↓
增加积分
↓
发送短信
↓
写业务日志
↓
返回用户
假设:
text
核心下单       120ms
积分           80ms
优惠券         120ms
短信           300ms
其他通知       150ms
如果全部同步:
text
总耗时可能达到 700~800ms+请求占着连接、线程和内存,系统自然很难承受更高并发。
更合理的方式是:
text
用户
 ↓
核心事务
订单 + 必要库存处理
 ↓
快速返回
 ↓
Kafka / RocketMQ
 ├→ 积分服务
 ├→ 优惠券服务
 ├→ 短信服务
 └→ 日志 / 通知服务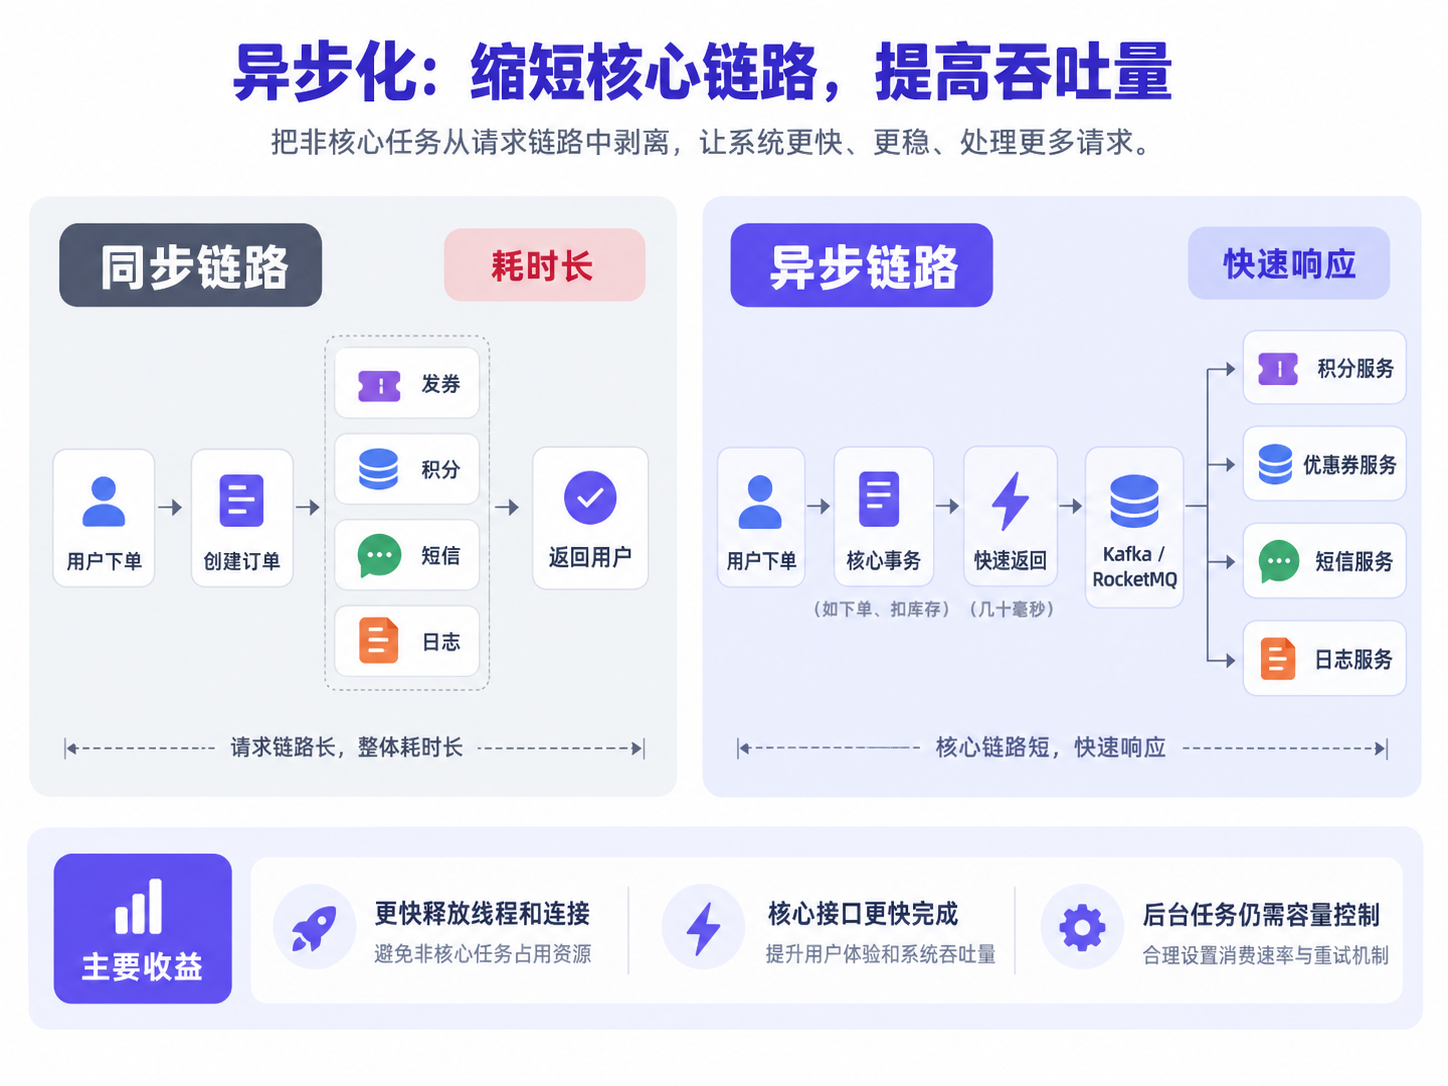
如果核心链路缩短到:
text
150ms而不是:
text
800ms同样的服务器资源,在单位时间内就有机会处理更多请求。
这就是异步化对吞吐量的帮助:
减少在线请求占用资源的时间。
5.1 异步并不是"把工作消灭了"
任务只是:
text
从在线请求
↓
搬到后台消费者
所以消费者仍然需要:
- 并发上限
- 重试
- 幂等
- 消息积压监控
- 数据库容量控制
如果消费者无限开线程:
text
Kafka
↓
1000 个消费者并发
↓
MySQL
数据库依然可能被打垮。
六、数据库优化:高并发系统最后最容易卡住的地方
应用服务可以:
text
App × 2
App × 10
App × 50
但所有请求最终可能仍然进入数据库。
所以很多高并发系统最终真正的瓶颈会变成:
text
数据库连接
SQL
索引
IO
锁竞争
热点行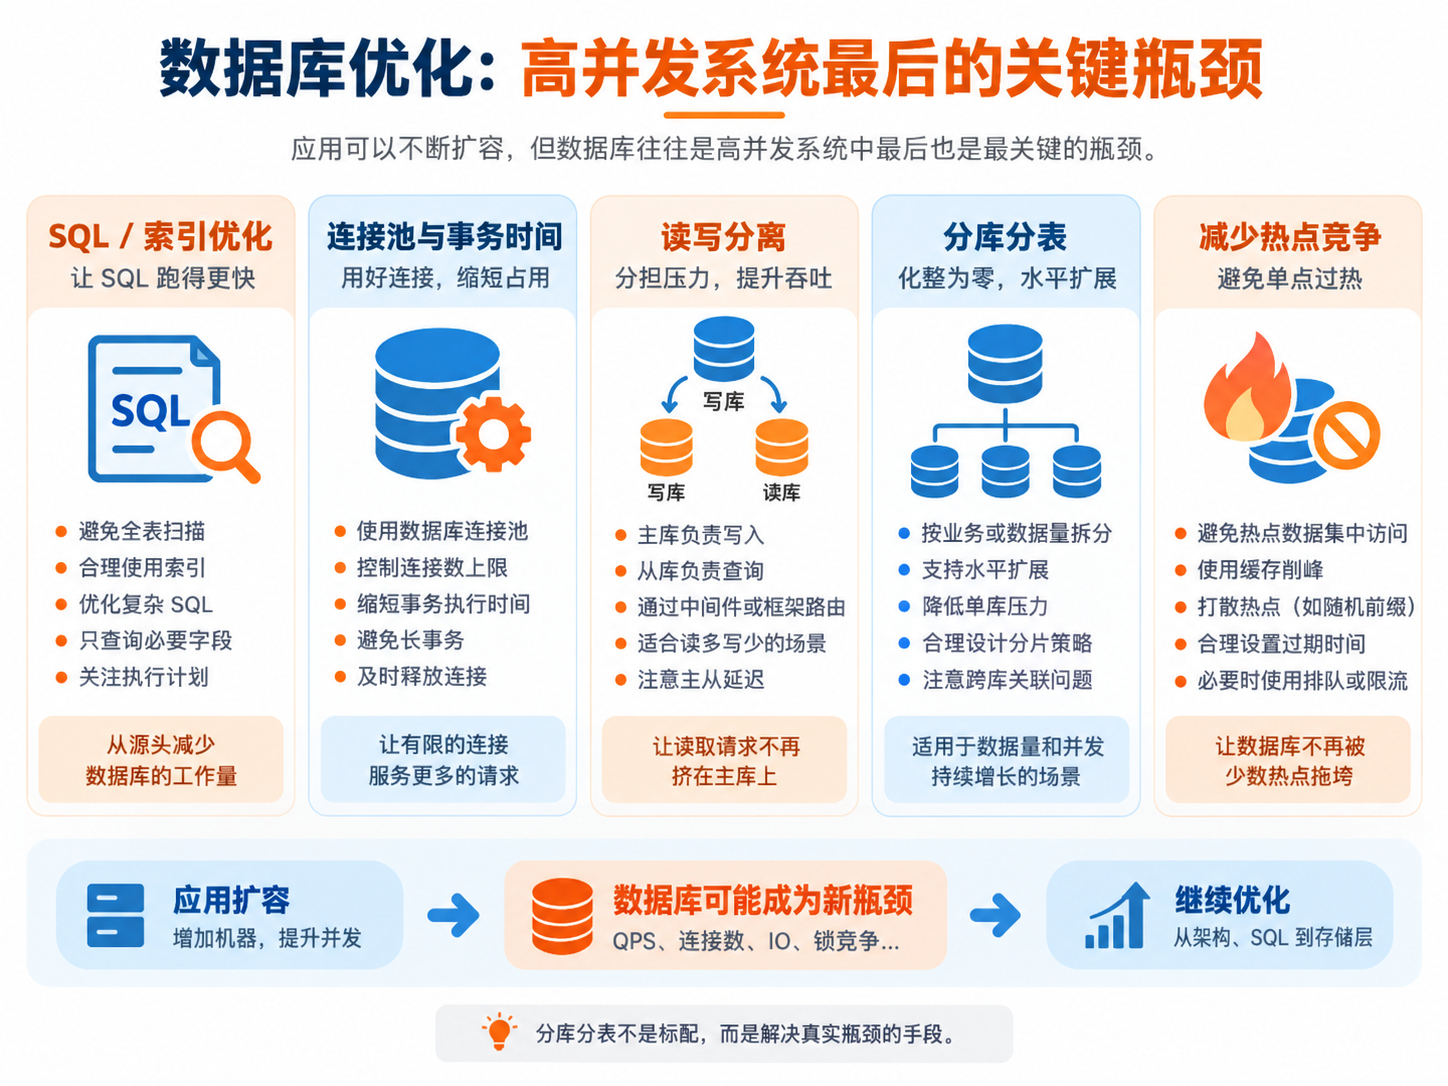
数据库优化一般建议从成本最低的地方开始。
6.1 SQL 与索引优化
例如:
sql
SELECT *
FROM orders
WHERE user_id = ?
ORDER BY create_time DESC;
如果没有合理索引,就可能扫描大量数据。
优化思路包括:
- 合理设计索引
- 看执行计划
- 减少
SELECT * - 避免不必要的全表扫描
- 减少无意义 JOIN
- 控制查询返回量
- 避免在索引列上做导致索引失效的操作
很多时候,一条 SQL 从:
text
500ms优化成:
text
20ms带来的吞吐量提升可能比增加几台应用服务器更明显。
6.2 连接池和事务时间
假设 MySQL 最大稳定连接能力有限,而应用开了大量线程:
text
应用线程:1000
数据库连接:100
那么:
text
900 个线程最终只是排队等待连接。
所以需要:
- 合理连接池大小
- 缩短事务
- 尽快释放连接
- 避免事务中调用慢 HTTP 接口
- 避免长事务持锁
6.3 读写分离
如果系统:
text
90% 查询
10% 写入
可以考虑:
text
写请求
↓
Master
↓
复制
├→ Replica-01
└→ Replica-02
      ↑
     查询
让读取压力分散到多个只读节点。
但要注意:
主从复制存在延迟,强一致读不能机械地全部走从库。
6.4 分库分表
如果单库的数据量和并发确实已经到达瓶颈,可以进一步:
text
按 user_id / order_id
↓
拆分多个数据库 / 多张表
这样实现水平扩展。
但它也会带来:
- 分布式 ID
- 跨库查询
- 跨库分页
- 聚合统计
- 数据迁移
- 跨库事务
所以:
分库分表不是高并发的标配,而是单库真实达到瓶颈后的解决手段。
七、代码层优化:让一次请求本身做得更少、更快
高性能不只是架构问题。
例如一个接口依次调用:
text
查用户      50ms
查商品      50ms
查库存      50ms
查优惠券    50ms
查积分      50ms
如果完全串行:
text
总耗时 ≈ 250ms如果这些调用彼此没有依赖,可以考虑并行:
text
          ┌→ 用户
          ├→ 商品
请求 ─────┼→ 库存
          ├→ 优惠券
          └→ 积分
             ↓
           汇总
Java 中可以考虑:
- CompletableFuture
- Reactor
- 虚拟线程
- 合理线程池
但要特别注意:
并行不是免费的。
如果最终这些请求全部访问同一个数据库,而数据库连接池只有 50 个连接,那么把应用并发调到 1000:
text
应用更并发
↓
数据库连接池更拥堵
↓
接口反而更慢
所以高并发优化必须看:
整条调用链,而不是某一段代码。
八、怎样知道吞吐量真的提高了?靠压测,而不是感觉
系统优化之后,不能只说:
"感觉快了。"
需要用压测证明。
至少关注:
text
QPS
P95
P99
错误率
CPU
内存
GC
线程
数据库连接池
Redis 延迟
Kafka Lag
MySQL TPS
慢 SQL
锁等待
例如:
优化前
text
稳定 QPS:5,000
P99:800ms
CPU:85%
错误率:1%
数据库连接池:经常满
优化后
text
稳定 QPS:20,000
P99:250ms
CPU:65%
错误率:0.05%
数据库连接池:稳定
这才能说明:
系统不仅接收了更多请求,而且仍然保持可接受的延迟和错误率。
真正有意义的"系统支持 2 万 QPS",一定要带上:
text
什么接口?
什么机器配置?
多少实例?
持续多久?
P99 多少?
错误率多少?
数据库状态怎样?
否则单独一个 QPS 数字没有太大意义。
九、吞吐量提高了,为什么最后还是要限流?
假设经过:
text
扩容
+
缓存
+
异步
+
数据库优化
系统从:
text
5,000 QPS提高到了:
text
50,000 QPS是不是就可以把令牌桶、漏桶、熔断全部删除?
还是不行。
因为系统永远存在最终容量。
如果突然来了:
text
300,000 QPS那么仍然需要:
- 令牌桶
- 漏桶
- 并发上限
- 熔断
- 降级
所以最终正确的关系应该是:
text
提高系统能力
    ↓
扩容 / 缓存 / 异步 / 优化
    ↓
新的容量边界
    ↓
限流 / 熔断 / 降级
    ↓
保护新的容量
因此:
高性能不是无限处理,高并发也不是拒绝所有高峰。
真正成熟的系统是:
先尽可能提高处理能力,再清楚知道自己的边界,最后保护这个边界。
十、最后总结:高并发的目标,是在稳定前提下获得更高吞吐量
整篇文章其实可以压缩成这条路线:
text
                高并发请求
                    ↓
              找到当前瓶颈
                    ↓
       ┌────────────┼────────────┐
       ↓            ↓            ↓
     横向扩容       缓存          异步
       ↓            ↓            ↓
   增加处理资源   降低请求成本   缩短核心链路
       └────────────┼────────────┘
                    ↓
                数据库优化
                    ↓
              提高系统吞吐量
                    ↓
               重新进行压测
                    ↓
              找到新的容量边界
                    ↓
          限流 / 熔断 / 降级保护
最后记住四句话:
QPS 是请求层的一种吞吐指标,但 QPS 不完全等于吞吐量。
高并发系统首先要提高处理能力,而不是先想着拒绝更多请求。
扩容、缓存、异步、数据库优化,是提高吞吐量最常见的四条主线。
系统能力提升之后,仍然需要限流、熔断和降级守住最终边界。
理解这四件事情以后,再看到"高并发、高性能"这样的系统设计题,就不会只想到 Redis、Kafka 或令牌桶,而是能够真正从容量、成本、瓶颈和吞吐量的角度分析整个系统。