数据迁移工具 KDMS:把"能不能迁"变成一份可以讨论的评估报告
迁移项目启动的时候,最常见的一句话是什么呢?"这套库应该不难迁。"那问题出在哪呢?这个"不难"通常来自于经验,而不是来自于对象清单。等到真正开始改造了,才发现一个视图引用了十几个函数,一个存储过程依赖特定语法,应用代码里还有运行时拼接出来的 SQL。项目延期这种事,往往仅仅只是因为一开始没把风险量化出来,而不是迁移工具不会搬数据。
我对金仓迁移工具 KDMS 的理解是这样的:它的价值首先不是"一键迁移",而是先生成一份能读的迁移评估报告。源库里有哪些对象,哪些对象可以兼容,哪些对象需要改造,改造工作量集中在哪里,这些都列出来。对项目负责人来说,这份报告比一句"支持 Oracle、SQL Server、DB2、MySQL 迁移"更有决策意义。也就是说,前者是数据,后者只是宣传语。 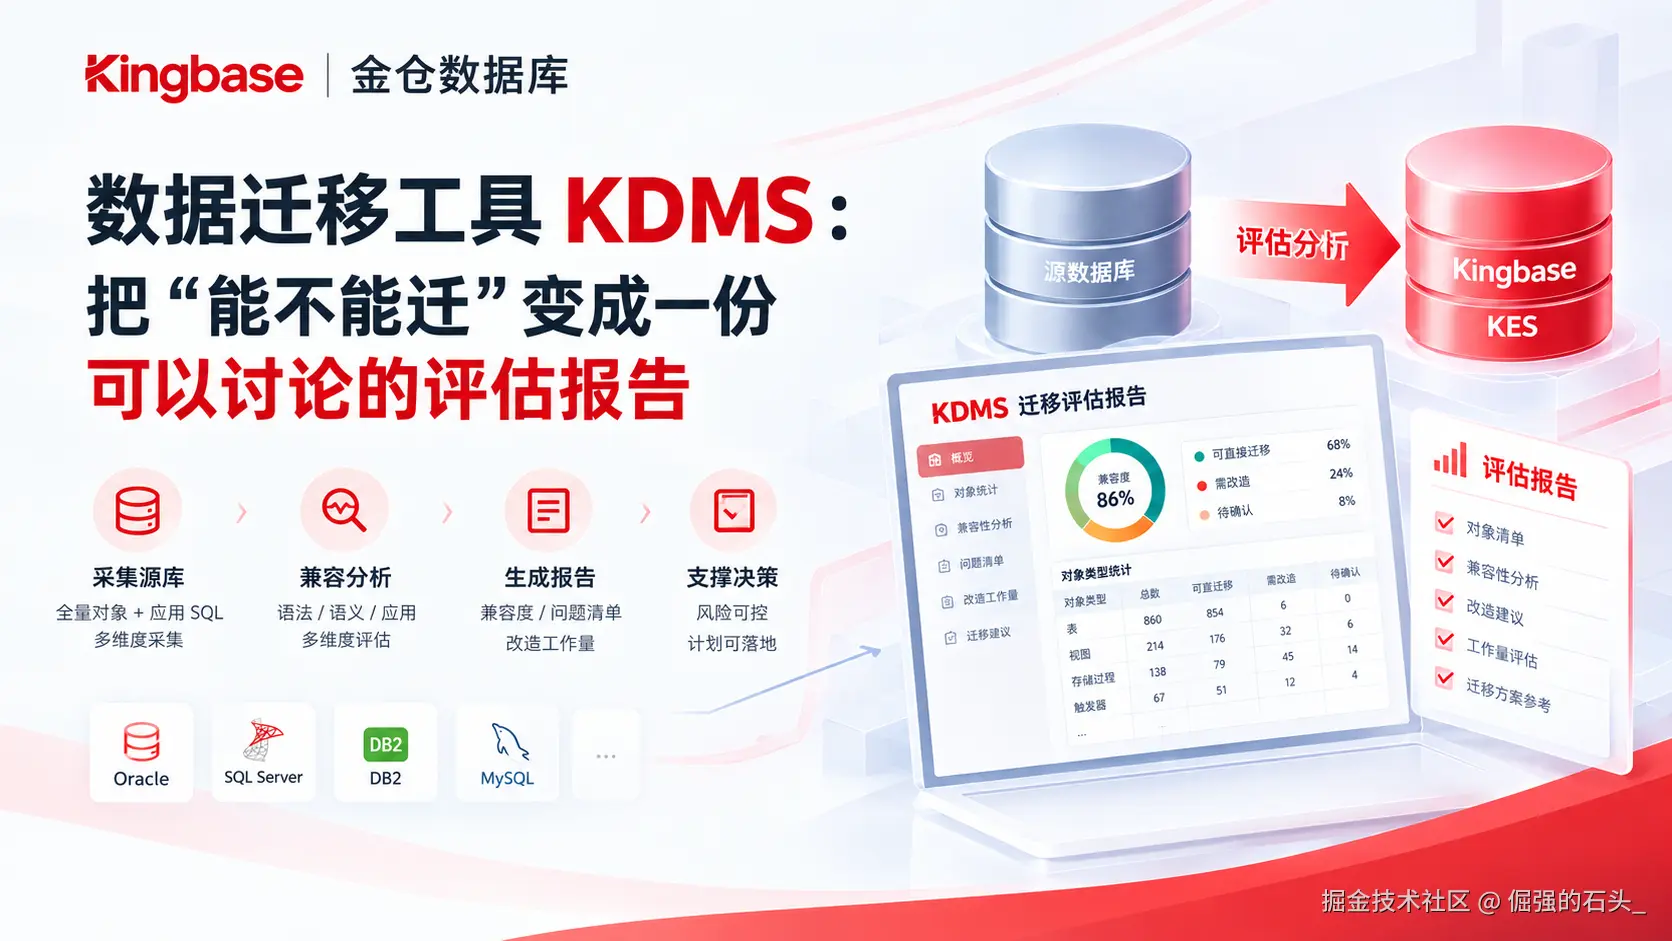
@toc
评估报告解决的三个问题
一份有用的评估报告,至少要回答三个问题:
- 源库到底有多少需要迁移的对象;
- 每类对象的兼容和不兼容情况怎么样;
- 不兼容对象要做什么改造,工作量能不能排期。
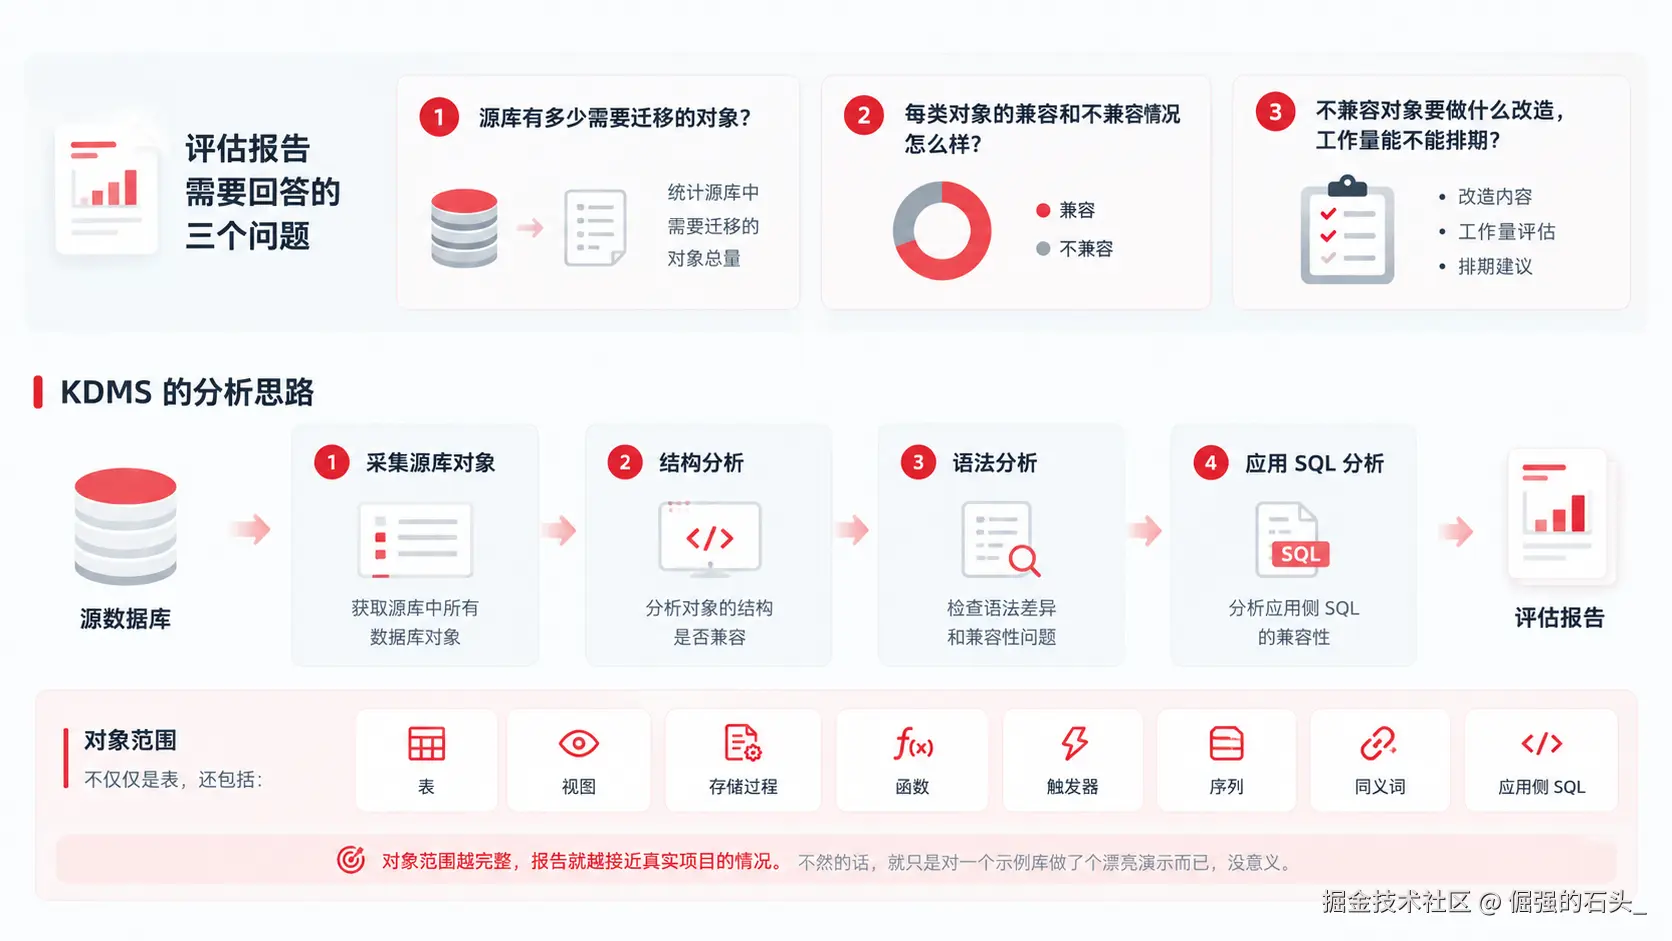
KDMS 的思路呢,是先采集源数据库对象,然后再对结构、语法和应用 SQL 做分析。这里的"对象"不只是表这么简单,还包括视图、存储过程、函数、触发器、序列、同义词,以及应用侧的 SQL。对象范围越完整,报告就越接近真实项目的情况。不然的话,就只是对一个示例库做了个漂亮演示而已,没意义。
从采集开始建立证据
用 KDMS 的时候,第一步是配置源数据库连接和采集账号。不同的数据库需要的权限是不一样的。比如读取系统目录的权限、读对象定义的权限、读运行时 SQL 的权限,这些都要有。采集过程本身呢,是不修改源库结构的,重点是元数据和代码。把它们带回评估环境来分析。
采集结果可以想象成下面这棵树:
text
源数据库
├── 数据库/实例
├── Schema
│   ├── 表、索引、约束
│   ├── 视图
│   ├── 存储过程、函数
│   └── 触发器、序列、同义词
└── 应用 SQL
    ├── Mapper XML
    ├── SQL 脚本
    └── 运行时采集语句
KDMS 用户手册里还提供了 Mapper 文件、SQL 脚本和动态 SQL 的采集方式。这个设计其实挺重要的。为什么呢?因为只分析数据库里的存储过程,是发现不了应用层拼接出来的分页、日期函数和特殊连接语法的。反过来,只采集静态文件,也覆盖不到运行时才出现的 SQL。两类数据结合到一起,评估才不会只看见一半。这个道理很简单,但很多项目就是漏了。
报告中的兼容度如何理解
"兼容"这个东西,不能只给一个总百分比就完事。项目真正关心的是对象类型和问题位置。一份典型的报告,会按表、视图、存储过程、函数、触发器这些类型统计对象数量,然后分别列出兼容的、不兼容的、需要人工确认的。
示意表大概是这样:
| 对象类型 | 总数 | 可直接迁移 | 需改造 | 待确认 |
|---|---|---|---|---|
| 表 | 860 | 854 | 6 | 0 |
| 视图 | 214 | 176 | 32 | 6 |
| 存储过程 | 138 | 79 | 45 | 14 |
| 触发器 | 67 | 51 | 12 | 4 |
这里要说明一下,这些数字只是报告展示格式的示例,实际数量必须由具体源库采集生成,不能照抄。重要的是什么呢?是报告要能展开到对象级别。比如说,能指出某个视图用了不兼容的函数,某个存储过程里有需要改写的语法。而不是停留在"兼容度 86%"这一句结论上,那样的话下面的人还是不知道要干嘛。
改造工作量为什么要单独统计
兼容度高,不代表工作量一定小,这是两回事。表可能全部兼容,但存储过程里有大量动态 SQL。对象数量少的库,也可能有几个核心过程特别复杂。所以报告通常还要给出改造工作量或者复杂度等级,用来辅助排期。
我自己会把问题按三种类型来理解:
- 语法替换:函数名、数据类型、分页写法这些局部调整;
- 逻辑改造:游标、异常处理、临时表或者事务控制方式发生了变化;
- 外围改造:驱动、连接串、认证、作业调度,还有依赖的系统接口。
前两类可以通过脚本和人工审核来估算。第三类呢,就要跟应用团队一起确认了,数据库这边说了不算。KDMS 能把数据库对象的问题集中列出来,但它替代不了对外围系统的盘点。这也是评估报告需要明确写清楚的边界。
SQL 评估比静态对象更接近真实风险
数据库对象是"存进去的代码",应用 SQL 是"真正跑起来的代码"。这两个东西要分开看。KDMS 支持采集 Mapper XML、SQL 文件和运行时 SQL,并且能对这些语句做兼容性分析。举个例子:
sql
SELECT TOP 20
       a.customer_id,
       a.customer_name,
       ROW_NUMBER() OVER (ORDER BY a.created_at DESC) AS rn
FROM dbo.customer a
WHERE a.customer_name LIKE @keyword + '%';
这条 SQL 呢,可能同时涉及分页、窗口函数、字符串拼接和参数占位符。你单看表结构,是判断不出来它在目标库里的行为的。必须把 SQL 本身纳入评估才行。那如果报告能把 SQL 按来源文件、调用模块和问题类型归类的话,开发团队就可以直接回到代码仓库去整改了,不用再到处找。
从报告到迁移决策的四步法
拿到报告之后,我建议不要马上去点"开始迁移"。先按四步来用: 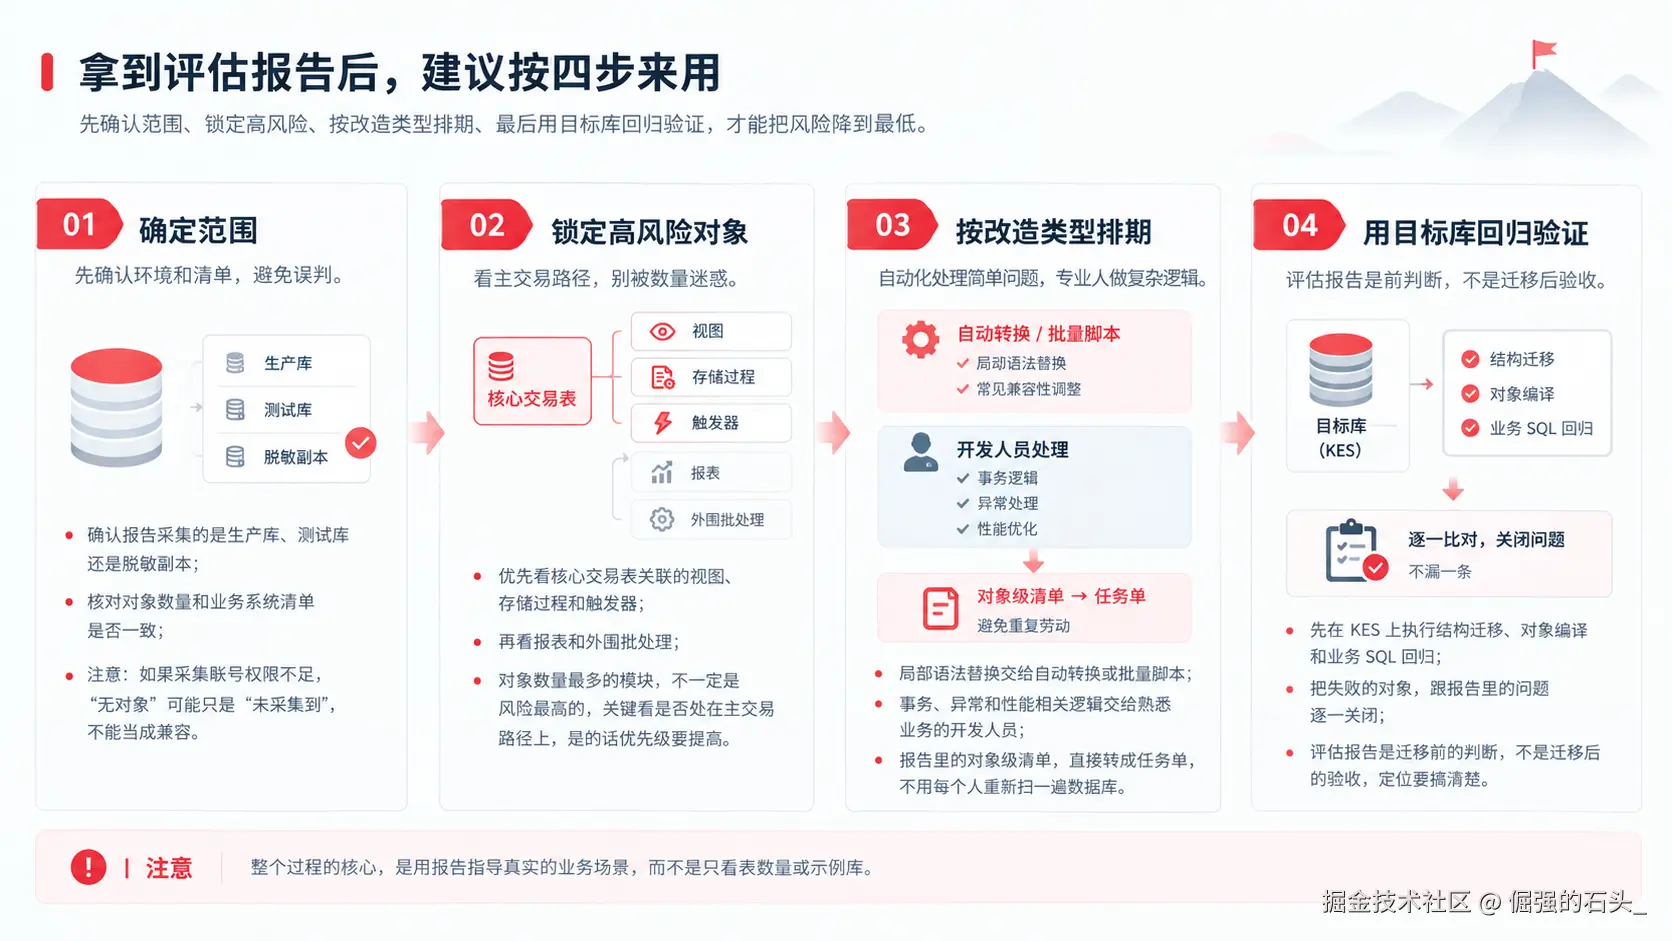
第一步:确定范围
先确认报告采集的是生产库、测试库还是脱敏副本,然后核对对象数量和业务系统清单是否一致。这里有个坑要注意:如果采集账号权限不足,报告里的"无对象"可能仅仅是"未采集到"而已。你不能把它误判成兼容,这是会出大事的。
第二步:锁定高风险对象
优先看核心交易表关联的视图、存储过程和触发器,然后再看报表和外围批处理。要记住一点:对象数量最多的模块,不一定是风险最高的。关键要看它是不是处在主交易路径上。是的话,优先级就得往上提。
第三步:按改造类型排期
把局部语法替换交给自动转换或者批量脚本去处理。事务、异常和性能相关的逻辑呢,留给熟悉业务的开发人员来做。报告里的对象级清单,可以直接转成任务单。这样的话,就不用每个人都重新扫一遍数据库了,省很多重复劳动。
第四步:用目标库回归验证
评估报告是迁移前的判断,不是迁移后的验收,这个定位要搞清楚。改造完成之后,要在 KES 上执行结构迁移、对象编译和业务 SQL 回归,然后把失败的对象,跟报告里的问题逐一关闭。一条条对,别漏。
一个可复用的报告审阅模板
为了让报告真正参与到项目管理里,我会额外维护一张审阅表:
text
对象名 | 对象类型 | 问题描述 | 处理方式 | 负责人 | 验证结果 | 备注比如说:
text
V_ORDER_SUMMARY | 视图 | 使用源库专有日期函数 | 改写函数并核对时区 | 应用组 | 通过 | 已补充回归用例
P_SETTLE_MONTH  | 存储过程 | 异常处理语法差异 | 人工重构事务块     | 数据库组 | 待验证 | 依赖批处理作业
这样做的好处是什么呢?报告不会停在项目启动会的附件里。它会变成一张能持续更新的风险清单。每次重新评估的时候,还可以对比一下,剩余的不兼容对象是不是在下降。数字往下走了,说明工作在推进,这比开会喊口号实在。
KDMS 的优势与使用边界
KDMS 的优势在于,把源库采集、兼容分析、语法转换和目标对象构建放在了一条流程里。迁移人员就不用在好几个工具之间来回切换了,成本降了不少。对于那些要从多种主流数据库迁到 Kingbase 的项目,它尤其适合做前期摸底和任务拆分。
但是它不能替项目团队做业务判断,这个要说在前面。报告没法自动知道某个字段是不是承载着金额语义,也替代不了高并发下的性能测试。运行时拼接、又没被采集到的 SQL,也不可能凭空出现在结果里,对吧。所以报告越详细,越要结合采集范围、账号权限和业务关键路径一起解读,不能光看表面。
如何判断一份报告是否值得相信
我会从四个角度来审阅 KDMS 的输出。第一,看采集覆盖率:报告里的 Schema、对象数和应用清单,跟源库盘点是不是一致的;第二,看问题可追溯性:每一个不兼容结论,能不能落到具体对象、具体语句、具体位置上;第三,看严重程度:语法问题、数据类型问题和事务语义问题,有没有分级;第四,看版本依据:目标 KingbaseES 版本、兼容模式和转换规则,记录得完不完整。
如果一份报告只给一个百分比,却没有对象明细,项目组很难拿它排期的。反过来说,如果列了一大堆"不兼容",却不区分"可以自动转换"和"必须人工重构",开发人员也被迫要重新判断一遍,等于白列了。好的报告应该让人能从总览逐层钻取到对象和 SQL,然后再回到任务清单上,形成闭环。
还要注意重复采集和版本变化的问题。源库在评估期间可能新增对象,目标库的版本或者兼容模式也可能调整。所以正式迁移之前,应该重新采集一次,并且在报告里标注两次评估之间的变化。应用运行时 SQL 的话,最好覆盖一段完整的业务周期。只在测试页面点击几下就下结论,是不靠谱的。
把评估结果转成切换方案
当不兼容对象已经清单化了,迁移计划可以进一步拆成三条线:结构线负责表、索引和约束;代码线负责视图、过程、函数和 SQL;运行线负责驱动、连接池、定时任务和监控。每条线都有自己的验收条件,最后再通过全链路回归汇合到一起。
那一次窗口做不完的项目怎么办呢?可以先迁低风险的 Schema,在双轨运行期间,持续关闭那些高风险对象。KDMS 报告提供的对象级状态,正好可以作为分批迁移的边界。这样的话,数据迁移就不再是一次性的"大爆炸"了,而是多个可以回滚的小批次。出了问题也好撤。
结语
数据迁移工具的价值,不只是把数据和对象搬到目标库去。更重要的是让迁移在开始之前,就变得可以估算。KDMS 通过采集源库对象和应用 SQL,按对象类型统计兼容情况,并且把不兼容项和改造工作量展开到可以执行的清单。这就帮团队把"经验估算"变成了"数据决策"。
我看一份迁移评估报告的时候,最关心的从来不是首页那个总兼容度。而是它最后能不能回答这三个问题:哪些对象会影响核心交易,每个问题由谁来处理,改完之后怎么验证。只要这三个问题有了明确的答案,迁移项目就从模糊的风险讨论,变成了一项可以排期、可以验收的工程工作。这才是评估报告真正该起的作用。