PostgreSQL入门
如果你已经熟练使用 MySQL,想快速上手 PostgreSQL,那么这篇文章就是为你准备的。PostgreSQL 与 MySQL 同属关系型数据库,核心概念(表、行、列、SQL)高度相通,但它在数据类型、模式(Schema)、JSONB、索引与扩展能力上更为强大。
本文的学习路径从安装连接开始,逐步深入到基本结构、表结构定义、单表查询与常用函数,再进阶到多表关系、索引优化、事务与锁,最后介绍全文搜索、地理位置与向量数据库等高级扩展。
读完本文,你将掌握:建库建表、增删改查(CRUD)、多表关系建模、索引设计与优化,以及事务与并发控制等核心能力,足以应对日常开发与面试中的常见场景。
摘要:本文面向有 MySQL 基础、想快速上手 PostgreSQL 的开发者,从安装连接讲起,系统梳理基本结构、表结构定义、单表查询与常用函数,再进阶到多表关系、索引优化、事务与锁,最后介绍全文搜索、地理位置与向量数据库等高级扩展。读完你将掌握建库建表、CRUD、多表关系建模、索引设计与优化,以及事务与并发控制等核心能力,足以应对日常开发与面试中的常见场景。
使用说明
使用 Docker Desktop 连接使用 PostgreSQL
方式一:连接 Docker Desktop 内置终端
步骤:
-
在 Docker Desktop 的 Containers 面板中,找到你运行的 PostgreSQL 容器。
-
点击容器名称,进入详情页面,选择 Exec 标签页。
-
在命令行输入框中,输入
psql命令并连接:bash# 用法:psql -h 主机 -p 端口 -U 用户名 -d 数据库名 psql -h 127.0.0.1 -p 5432 -U 你的用户名 -d 你的数据库名 -
按回车后,系统会提示输入密码,输入你设置的
POSTGRES_PASSWORD即可。
基本结构
核心层级结构
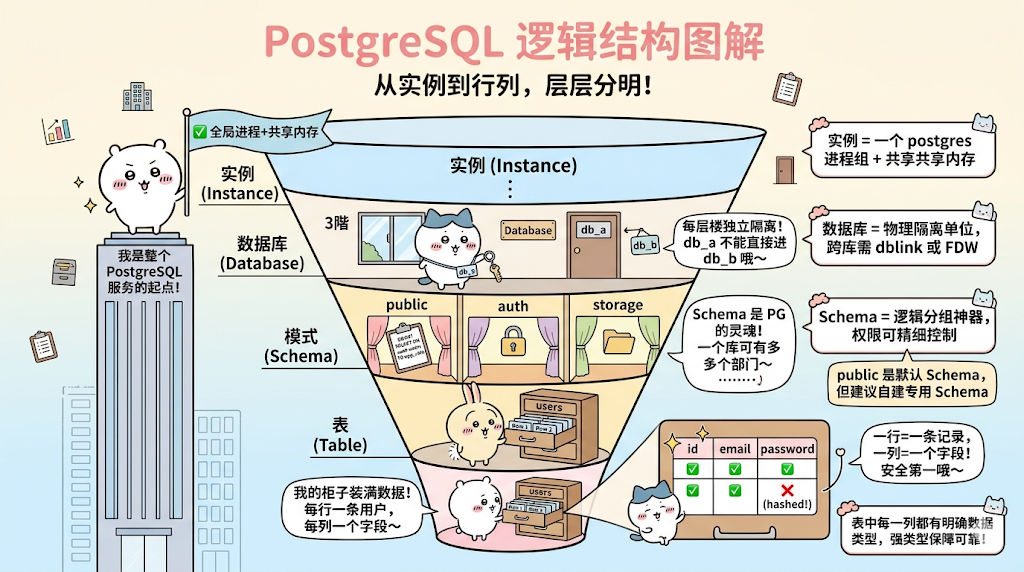
下面是 PostgreSQL 的逻辑层级结构图:
#mermaid-svg-NllPHLzW37KubUxc{font-family:"trebuchet ms",verdana,arial,sans-serif;font-size:16px;fill:#333;}@keyframes edge-animation-frame{from{stroke-dashoffset:0;}}@keyframes dash{to{stroke-dashoffset:0;}}#mermaid-svg-NllPHLzW37KubUxc .edge-animation-slow{stroke-dasharray:9,5!important;stroke-dashoffset:900;animation:dash 50s linear infinite;stroke-linecap:round;}#mermaid-svg-NllPHLzW37KubUxc .edge-animation-fast{stroke-dasharray:9,5!important;stroke-dashoffset:900;animation:dash 20s linear infinite;stroke-linecap:round;}#mermaid-svg-NllPHLzW37KubUxc .error-icon{fill:#552222;}#mermaid-svg-NllPHLzW37KubUxc .error-text{fill:#552222;stroke:#552222;}#mermaid-svg-NllPHLzW37KubUxc .edge-thickness-normal{stroke-width:1px;}#mermaid-svg-NllPHLzW37KubUxc .edge-thickness-thick{stroke-width:3.5px;}#mermaid-svg-NllPHLzW37KubUxc .edge-pattern-solid{stroke-dasharray:0;}#mermaid-svg-NllPHLzW37KubUxc .edge-thickness-invisible{stroke-width:0;fill:none;}#mermaid-svg-NllPHLzW37KubUxc .edge-pattern-dashed{stroke-dasharray:3;}#mermaid-svg-NllPHLzW37KubUxc .edge-pattern-dotted{stroke-dasharray:2;}#mermaid-svg-NllPHLzW37KubUxc .marker{fill:#333333;stroke:#333333;}#mermaid-svg-NllPHLzW37KubUxc .marker.cross{stroke:#333333;}#mermaid-svg-NllPHLzW37KubUxc svg{font-family:"trebuchet ms",verdana,arial,sans-serif;font-size:16px;}#mermaid-svg-NllPHLzW37KubUxc p{margin:0;}#mermaid-svg-NllPHLzW37KubUxc .label{font-family:"trebuchet ms",verdana,arial,sans-serif;color:#333;}#mermaid-svg-NllPHLzW37KubUxc .cluster-label text{fill:#333;}#mermaid-svg-NllPHLzW37KubUxc .cluster-label span{color:#333;}#mermaid-svg-NllPHLzW37KubUxc .cluster-label span p{background-color:transparent;}#mermaid-svg-NllPHLzW37KubUxc .label text,#mermaid-svg-NllPHLzW37KubUxc span{fill:#333;color:#333;}#mermaid-svg-NllPHLzW37KubUxc .node rect,#mermaid-svg-NllPHLzW37KubUxc .node circle,#mermaid-svg-NllPHLzW37KubUxc .node ellipse,#mermaid-svg-NllPHLzW37KubUxc .node polygon,#mermaid-svg-NllPHLzW37KubUxc .node path{fill:#ECECFF;stroke:#9370DB;stroke-width:1px;}#mermaid-svg-NllPHLzW37KubUxc .rough-node .label text,#mermaid-svg-NllPHLzW37KubUxc .node .label text,#mermaid-svg-NllPHLzW37KubUxc .image-shape .label,#mermaid-svg-NllPHLzW37KubUxc .icon-shape .label{text-anchor:middle;}#mermaid-svg-NllPHLzW37KubUxc .node .katex path{fill:#000;stroke:#000;stroke-width:1px;}#mermaid-svg-NllPHLzW37KubUxc .rough-node .label,#mermaid-svg-NllPHLzW37KubUxc .node .label,#mermaid-svg-NllPHLzW37KubUxc .image-shape .label,#mermaid-svg-NllPHLzW37KubUxc .icon-shape .label{text-align:center;}#mermaid-svg-NllPHLzW37KubUxc .node.clickable{cursor:pointer;}#mermaid-svg-NllPHLzW37KubUxc .root .anchor path{fill:#333333!important;stroke-width:0;stroke:#333333;}#mermaid-svg-NllPHLzW37KubUxc .arrowheadPath{fill:#333333;}#mermaid-svg-NllPHLzW37KubUxc .edgePath .path{stroke:#333333;stroke-width:2.0px;}#mermaid-svg-NllPHLzW37KubUxc .flowchart-link{stroke:#333333;fill:none;}#mermaid-svg-NllPHLzW37KubUxc .edgeLabel{background-color:rgba(232,232,232, 0.8);text-align:center;}#mermaid-svg-NllPHLzW37KubUxc .edgeLabel p{background-color:rgba(232,232,232, 0.8);}#mermaid-svg-NllPHLzW37KubUxc .edgeLabel rect{opacity:0.5;background-color:rgba(232,232,232, 0.8);fill:rgba(232,232,232, 0.8);}#mermaid-svg-NllPHLzW37KubUxc .labelBkg{background-color:rgba(232, 232, 232, 0.5);}#mermaid-svg-NllPHLzW37KubUxc .cluster rect{fill:#ffffde;stroke:#aaaa33;stroke-width:1px;}#mermaid-svg-NllPHLzW37KubUxc .cluster text{fill:#333;}#mermaid-svg-NllPHLzW37KubUxc .cluster span{color:#333;}#mermaid-svg-NllPHLzW37KubUxc div.mermaidTooltip{position:absolute;text-align:center;max-width:200px;padding:2px;font-family:"trebuchet ms",verdana,arial,sans-serif;font-size:12px;background:hsl(80, 100%, 96.2745098039%);border:1px solid #aaaa33;border-radius:2px;pointer-events:none;z-index:100;}#mermaid-svg-NllPHLzW37KubUxc .flowchartTitleText{text-anchor:middle;font-size:18px;fill:#333;}#mermaid-svg-NllPHLzW37KubUxc rect.text{fill:none;stroke-width:0;}#mermaid-svg-NllPHLzW37KubUxc .icon-shape,#mermaid-svg-NllPHLzW37KubUxc .image-shape{background-color:rgba(232,232,232, 0.8);text-align:center;}#mermaid-svg-NllPHLzW37KubUxc .icon-shape p,#mermaid-svg-NllPHLzW37KubUxc .image-shape p{background-color:rgba(232,232,232, 0.8);padding:2px;}#mermaid-svg-NllPHLzW37KubUxc .icon-shape .label rect,#mermaid-svg-NllPHLzW37KubUxc .image-shape .label rect{opacity:0.5;background-color:rgba(232,232,232, 0.8);fill:rgba(232,232,232, 0.8);}#mermaid-svg-NllPHLzW37KubUxc .label-icon{display:inline-block;height:1em;overflow:visible;vertical-align:-0.125em;}#mermaid-svg-NllPHLzW37KubUxc .node .label-icon path{fill:currentColor;stroke:revert;stroke-width:revert;}#mermaid-svg-NllPHLzW37KubUxc :root{--mermaid-font-family:"trebuchet ms",verdana,arial,sans-serif;} 实例 Instance
数据库 Database
模式 Schema
表 Table
行与列 Row & Column
PostgreSQL 的逻辑结构从大到小依次排序是:实例(Instance)> 数据库(Database)> 模式(Schema)> 表(Table)> 行与列(Row & Column)。
第一层:数据库(Database)
- 类比:大楼里的某一层楼
- 特点:数据库是物理上的最高隔离级别。通常一个项目会占用一个独立的数据库
- 注意:不同数据库之间的数据默认是不通的,即不能在
db_a里面直接查询db_b的表
第二层:模式(Schema)------这是 PostgreSQL 的灵魂
- 类比:楼层里的各个"部门"或"房间"
- 特点:这是 PostgreSQL 区别于 MySQL 的重要特性。一个数据库下可以有多个 Schema。
- 默认值:默认所有的表都放在名为
public的模式下。 - 用途:你可以创建
auth模式放用户表,storage模式放文件表,从而实现逻辑上的分组和权限控制。
第三层:表(Table)
- 类比:房间里的"文件柜"。
- 特点:这是真正存放数据的地方。
- 结构:每一行(Row)代表一条记录,每一列(Column)代表一个字段。
设计原因?
这是"数据库 > 模式 > 表"的设计方式,能让你在开发大型复杂系统时非常从容。比如,如果你要做多租户系统 (每个客户的逻辑隔离),你可以给每个客户分配一个独立的 schema,但它们共享同一个数据库连接池,这样既安全又省资源。
数据库、模式操作
数据库操作
postgresql
# 创建数据库
create database db_name;
-- 查看数据库
\t -- or
SELECT datname FROM pg_database;
// 接入数据库
\c db_name;
// 删除数据库
drop database db_name; // 需要先切换到其他数据库才能删除,并且不能有会话连接
DROP DATABASE db WITH (FORCE); // 强制删除
模式操作
postgresql
-- 如果不存在,就创建
CREATE SCHEMA IF NOT EXISTS storage;
-- 查看模式
\dn
-- 删除模式
// 只有模式为空时才能删除
DROP SCHEMA IF EXISTS storage;
-- [慎用]级联删除:删除模式以及模式里的所有表、视图、函数等
DROP SCHEMA IF EXISTS storage CASCADE;
表操作
创建表(CREATE TABLE)
建表时,除了字段名和类型,约束(Constraints)是保证数据质量的关键。
postgresql
-- storage.files 这样写表示在storage下创建files表
-- 如果要在public模式下创建files表,直接写files或者public.files
CREATE TABLE IF NOT EXISTS storage.files(
	id BIGINT GENERATED BY DEFAULT AS IDENTITY PRIMARY KEY, -- 自增主键
	file_id UUID DEFAULT gen_random_uuid(), -- uuid
	file_name TEXT NOT NULL, -- 非空
	file_size BIGINT CHECK (file_size >= 0), -- 检查约束;大小不能为负
	is_public BOOLEAN DEFAULT false, -- 默认值false
	tags TEXT[], -- 数组类型(PG特色)
	created_at TIMESTAMPTZ DEFAULT NOW() -- 带时区的时间
);查这个库下的表列表:\d
postgresql
SELECT
	schemaname AS 模式名,
	tablename AS 表名,
	tableowner AS 所有人
FROM pg_tables
WHERE schemaname NOT IN ('pg_catalog','information_schema')
ORDER BY schemaname, tablename;查这个表的表结构:\d 表名或者 \d+ 表名
postgresql
SELECT
	column_name AS 字段名,
	data_type AS 数据类型,
	is_nullable AS 是否允许为空,
	column_default AS 默认值,
	character_maximum_length AS 最大长度
FROM information_schema.columns
WHERE table_name = 'cloud_files' -- 替换成你的表名
ORDER BY ordinal_position; -- 按照表中定义的顺序排列
修改表(ALTER TABLE)
项目需求经常变,你需要修改已经存在的表结构。
-
添加字段
postgresqlALTER TABLE storage.files ADD COLUMN download_count INT DEFAULT 0; -
修改字段类型
postgresqlALTER TABLE storage.files ALTER COLUMN file_name TYPE VARCHAR(255); -
重命名列名
postgresqlALTER TABLE storage.files RENAME COLUMN is_public TO is_shared; -
删除字段
postgresqlALTER TABLE storage.files DROP COLUMN tags;
删除表(DROP TABLE)
删除表要非常谨慎,一旦删除,表内数据将全部丢失。
postgresql
-- 基本删除
DROP TABLE IF EXISTS storage.files;

-- 级联删除(如果这个表被其他表作为外键关联,用CASCADE会连带删除关联)
DROP TABLE storage.files CASCADE;
清空表(TRUNCATE)
如果你只想删除表里所有的数据,但想保留这个表的结构(就像把房子里的家具搬空,但房子不拆),TRUNCATE 比 DELETE 快得多。
postgresql
TRUNCATE TABLE storage.files;
TRUNCATE TABLE storage.files i; // 清空表并且重置自增id
查看表信息(元指令与查询)
在操作表时,你经常需要确认当前的结构。
-
在 psql 命令行中:
\dt:列出当前库所有表。\d storage.files:查看这张表的详细结构(列、类型、索引、约束)。
-
使用 SQL 查询(pgAdmin 常用):
postgresql
SELECT column_name, data_type, is_nullable
FROM information_schema.columns
WHERE table_name = 'files';
特色操作:表继承(Inheritance)
这是 PostgreSQL 的黑科技之一。你可以创建一个"父表",然后让"子表"继承它。
postgresql
-- 父表,定义基础字段
CREATE TABLE content(
	title TEXT,
	author TEXT
);

-- 子表,基础基础字段,并增加自己的字段
CREATE TABLE video(
	duration INT
)INHERITS(content);当查询content表时,会发现它会自动把video表里的数据也查出来。
数据操作
插入
ps:(如果约束失败,自增 ID 也是会消耗的)
postgresql
-- 插入单条记录(注意数组用 ARRAY[...] 或 {'a','b'} 语法)

INSERT INTO files (file_name, file_size, is_public, tags)
VALUES ('课程大纲.pdf', 1024576, true, ARRAY['教育', 'pdf']);

-- 批量插入(PostgreSQL 对批量插入的支持非常高效)
INSERT INTO files (file_name, file_size, tags)
VALUES
	 ('demo.mp4', 50000000, '{"视频", "测试"}'),
    ('config.yaml', 1024, '{"配置"}');
查询
postgresql
-- 基础查询:查看所有公开的大文件
SELECT file_name, file_size, created_id
FROM files
WHERE is_public = true AND file_size > 1000000;

-- 模糊查询
SELECT * FROM files WHERE file_name LIKE '%.pdf';

-- 数组查询(PG特色):查找标签中包含"视频"的文件
SELECT * FROM files WHERE '视频' = ANY(tags);
修改
postgresql
-- 模拟下载次数自增
UPDATE files
SET download_count = download_count + 1
WHERE file_name = 'demo.mp4';

-- 修改多个字段并切换布尔值
UPDATE files
SET is_public = false, tags = array_append(tags, '私有')
WHERE file_id = '某某UUID';
删除
postgresql
-- 删除特定的文件
DELETE FROM files WHERE file_id = '某UUID';

-- 删除所有下载次数为0 的旧配置测试文件
DELETE FROM files
WHERE download_count = 0 AND tags @> ARRAY['测试'::text];
创建+回显
-- 插入并立即返回新创建生成的UUID和创建时间
INSERT INTO files (file_name, file_size)
VALUES ('私课.zip',999)
RETURNING file_id, created_at;
表结构定义
PostgreSQL 里面支持多种数据类型。
核心数据类型(Data Types)
PostgreSQL以其丰富的数据类型著称,以下是开发中最常用的几类:
数值类型
INTEGER/INT:4字节整数。范围约±21亿。BIGINT:8字节整数,用于大ID或大数量计数。NUMERIC(p,s)/DECIMAL:精确的小数,用于金额。p是总位数,s是小数点后的位数。SERIAL/BIGSERIAL:自增整数(实际上是封装了SEQUENCE)。
字符类型
VARCHAR(n):变长字符串,有长度限制。TEXT:变长字符串,无长度限制(PostgreSQL 推荐直接用这个,除非有业务硬性长度约束)。CHAR(n):定长字符串,不足部分补空格。
日期/时间类型
TIMESTAMP:日期和时间TIMESTAMPTZ:带时区的日期和时间(生产环境推荐使用,避免时间混乱)DATE:仅日期INTERVAL:时间间隔(如 1 day 2 hours)tsrange:对应timestamp without time zone的范围tstzrange:对应timestamp with time zone的范围(推荐用于跨时区业务)daterange:对应date的范围
特色/高级类型
BOOLEAN:TRUE、FALSE,或NULLJSONB:禁止存储的JSON数据,支持索引,性能极佳UUID:通用唯一识别码ARRAY:数组类型,例如TEXT[]可以存储标签列表INET:ip类型
列约束(Column Constraints)
约束用于确保数据的准确性和可靠性(实体完整性,参照完整性)。
| 约束类型 | 描述 | 示例 |
|---|---|---|
NOT NULL |
强制列不能包含NULL值 |
name TEXT NOT NULL |
UNIQUE |
确保列中的所有值互不相同 | email TEXT UNIQUE |
PRIMARY KEY |
主键,唯一表示每一行。隐含NOT NULL和UNIQUE |
id SERIAL PRIMARY KEY |
FOREIGN KEY |
外键,建立表与表之间的链接,防止破坏关系 | user_id INT REFERENCES users(id) |
CHECK |
检查值是否满足特定逻辑条件 | age INT CHECK (age >= 18) |
DEFAULT |
如果插入时未指定值,则使用默认值。 | created_at TIMESTAMPTZ DEFAULT NOW() |
示例
postgresql
CREATE TABLE public.file_details(
	-- 1. 自增长整数主键(BIGSERIAL)
	-- 知识点:BIGSERIAL 是8 字节整数,紫河车极大数量级
	-- 适合作为数据库内部的关联外键,性能优于UUID
	id BIGSERIAL PRIMARY KEY,

	-- 2. 现代唯一标识
	-- 知识点:对外暴露的ID,防止业务数据量泄露
	detail_id UUID UNIQUE DEFAULT gen_random_uuid(),

	-- 3. 时间范围类型(TSTZRANGE)
	-- 知识点: 存储文件的"有效期"------起止时间
	-- 例如:'[2023-01-01, 2024-01-01)' 表示从元旦开始,一年内有效
	vaild_period TSTZRANGE NOT NULL DEFAULT tstzrange(now(), NULL, '[)'),

	-- 4. 空间与网络(INET)
	uploader_ip INET NOT NULL,

	-- 5. 集合容器(ARRAY)
	tags TEXT[] DEFAULT '{}',

	-- 6. 半结构化内容(JSONB)
	metadata JSONB DEFAULT '{}',

	-- 基础字段
	file_name TEXT NOT NULL,
	created_at TIMESTAMPTZ DEFAULT NOW()
);
插入数据
postgresql
INSERT INT public.file_details(uploader_ip, tags, metadata, file_name, valid_period)
VALUES
	-- 1. 文档:标准构造函数
	('10.0.0.5', '{"PDF", "文档"}', '{"pages": 45, "author": "Fengfeng"}', 'PostgreSQL手册.pdf',
     tstzrange('2026-01-01 00:00:00Z', '2027-01-01 00:00:00Z', '[)')),

     -- 2. 图片:修正字符串格式(去掉逗号后的空格)
     -- 注意:'[start,]' 表示包含起点,无终点
     ('127.0.0.1', '{"素材", "封面"}', '{"dpi": 300, "color": "RGB"}', 'bilibili横屏封面.png','[2026-04-14 08:00:00+08,]'),

     -- 3. 简单文件:另外一种的写法,使用NULL表示无穷大
     ('172.16.0.100', '{}', '{}', 'test_file.txt',
     tstzrange('2025-01-01', NULL, '[)')),

     -- 4. 视频文件,直接使用DEFAULT
     ('192.168.50.20', '{"视频"}', '{"video": {"resolution": {"width": 1920}}}', 'test_file.mp4',
     DEFAULT);
单表查询
模拟数据
postgresql
INSERT INTO file_details (
    file_name,
    uploader_ip,
    tags,
    metadata,
    created_at
) VALUES
-- 1. 匹配 ILIKE '%.PNG' 和 2026 年时间点
('Logo_Design.png', '192.168.1.5', ARRAY['素材', '封面', '设计'], '{"author": "Fengfeng", "dpi": 300, "color": "RGB"}', '2026-02-15 10:30:00'),

-- 2. 匹配数组重叠 (&&) 和包含 (@>)
('Tutorial_Video.mp4', '172.16.10.1', ARRAY['视频', '素材', '教程'], '{"author": "Zhang", "video": {"resolution": {"width": 1920, "height": 1080}}}', '2026-05-20 14:00:00'),

-- 3. 匹配特定的作者和文本转换
('Annual_Report.pdf', '172.16.20.5', ARRAY['文档', 'PDF'], '{"author": "Fengfeng", "pages": 45}', '2026-08-01 09:15:00'),

-- 4. 匹配 inet 范围 (172.16.0.0/16)
('Backup_Config.txt', '172.16.50.12', ARRAY['文档', '系统'], '{"priority": "high"}', '2025-12-30 23:59:59'),

-- 5. 匹配 JSONB 键值对存在性 (?)
('Thumbnail.PNG', '127.0.0.1', ARRAY['封面'], '{"author": "Li", "color": "CMYK", "dpi": 72}', '2026-01-10 11:00:00'),

-- 6. 聚合统计测试案例 (同一 IP 多次上传)
('Meeting_Notes.docx', '127.0.0.1', ARRAY['文档'], '{"author": "Fengfeng"}', '2026-03-05 16:20:00');
基础匹配和模糊查询
postgresql
-- 查找所有 PNG 图片,忽略大小写
SELECT file_name, uploader_ip
FROM file_details
WHERE file_name ILIKE '%.PNG';

-- 查找 2026 年上传的文件
SELECT * FROM file_details
WHERE created_at >= '2026-01-01' AND created_at < '2027-01-01';
-- 其他写法
SELECT * FROM file_details
WHERE EXTRACT(YEAR FROM created_at) = 2026;
数据类型的深度检索
postgresql
-- 匹配:查找标签中包含"文档"的所有文件
SELECT file_name, tags FROM file_details WHERE '文档' = ANY(tags);

-- 包含:查找同时包含"素材"和"封面"的文件(@> 是包含操作符)
SELECT file_name, tags FROM file_details WHERE tags @> ARRAY['素材','封面'];

-- 重叠:只要包含"PDF"或"视频"中的任意一个就行(&& 是重叠操作符)
SELECT file_name, tags FROM file_details WHERE tags && ARRAY['PDF','视频'];
JSONB 的操作
注意:
->>提取出来的是 text ,->提取出来的是 JSON 对象
postgresql
-- 提取:查找作者是 "Fengfeng" 的文件
SELECT file_name, metadata->>'author' AS author
FROM file_details
WHERE metadata->>'author' = 'Fengfeng';

-- 如果取出来的字段还是一个 JSON,就得用 -> 来提取
SELECT file_name, metadata->'video' AS author
FROM file_details
WHERE (metadata->'video'->'resolution'->>'width')::int = 1920;

-- 嵌套判断:查找 DPI 等于 300 的图片(得 text 转为 int 进行比较)
SELECT file_name, metadata FROM file_details
WHERE (metadata->>'dpi')::int = 300;

-- 键值对存在性判断,查询所有定义了 "color" 属性的文件
SELECT * FROM file_details WHERE metadata ? 'color';
网络地址 INET 的筛选
postgresql
-- 精确匹配IP
SELECT * FROM file_details WHERE uploader_ip = '127.0.0.1';

-- 范围匹配:查找属于 172.16.0.0/16 网段的所有上传记录
SELECT file_name, uploader_ip FROM file_details
WHERE uploader_ip << '172.16.0.0/16';
排序和分页
postgresql
-- 按创建时间倒序排列,取前两条
SELECT file)name, created_at
FROM file_details
ORDER BY created_at DESC
LIMIT 2 OFFSET 0;
聚合统计
postgresql
-- 统计每个IP上传了多少次,并计算每个IP上传文件包含的总标签数
-- 使用unnest把数组展开才能计数
SELECT
	uploader_ip,
	COUNT(*) AS upload_count,
	SUM(array_length(tags,1)) AS total_tags
FROM file_details
GROUP BY uploader_ip;
数据转换与格式化
postgresql
-- 格式化输出:ID 前 8 位 + 文件名 + 简写日期
SELECT
	left(detail_id::text,8) AS short_id,
	file_name,
	to_char(created_at,'YYYY-MM-DD') AS simple_date
FROM file_details;
常用函数
在 PostgreSQL 中,函数就像是内置的小工具,能帮你直接在 SQL 层把原始数据加工成最终需要的格式。
主要可分为四大类:字符串处理 、数值计算 、日期时间 以及集合处理。
字符串处理函数(清洗数据的利器)
当文件路径、用户名格式不统一时,这些函数能帮忙。
-
CONCAT(a,b)/||:拼接字符串 -
UPPER()/LOWER():大小写转换 -
SUBSTR(string, start, len):截取字符串 -
REPLACE(string, from, to):替换内容 -
COALESCE(value, default):如果字段是NULL,就给它一个默认值
数值计算函数
ROUND(numeric, 2):四舍五入CEIL()/FLOOR():向上/向下取整ABS():取绝对值
日期时间函数(时间管理的灵魂)
-
NOW():获取当前完整时间 -
CURRENT_DATE:获取当前日期 -
AGE(timestamp):计算时间差postgresql-- 看看这个文件上传了多久 SET TIME ZONE 'Asia/Shanghai'; SELECT file_name, AGE(created_at) AS active_time FROM file_details; -
EXTRACT(field FROM source):提取年、月、日、小时postgresql-- 统计每个小时的上传量 SELECT EXTRACT(HOUR FROM created_at) AS hour, COUNT(*) FROM file_details GROUP BY hour; -
TO_CHAR():将时间格式化作为字符串postgresql-- 变成指定格式 YYYY-MM-DD HH24:MI:SS SELECT TO_CHAR(created_at, 'YYYY-MM-DD HH24:MI:SS') FROM file_details;
流程控制与聚合函数
-
CASE WHEN:SQL里的if-elsepostgresql-- 给文件分级 SELECT file_name, CASE WHEN file_size > 1024*1024*100 THEN '大文件' WHEN file_size > 1024*1024*10 THEN '中文件' ELSE '小文件' END AS file_level FROM files; -
STRING_AGG(field, delimiter):【PostgreSQL特色】把多行结构合并成一行字符串postgresql-- 把某个用户的所有标签拼成一个逗号分隔的字符串 SELECT uploader_ip, STRING_AGG(tags::text, '|') FROM file_details GROUP BY uploader_ip;或者
postgresqlSELECT uploader_ip, -- 先把所有数组合并成一个大数组,再转为字符串 array_to_string(array_agg(unnest_tags),', ') FROM ( SELECT uploader_ip, unnest(tags) AS unnest_tags FROM file_details ) t GROUP BY uploader_ip;
多表关系
下面是三种常见表关系的示意图:
#mermaid-svg-JhWs6md4BOAlHaJI{font-family:"trebuchet ms",verdana,arial,sans-serif;font-size:16px;fill:#333;}@keyframes edge-animation-frame{from{stroke-dashoffset:0;}}@keyframes dash{to{stroke-dashoffset:0;}}#mermaid-svg-JhWs6md4BOAlHaJI .edge-animation-slow{stroke-dasharray:9,5!important;stroke-dashoffset:900;animation:dash 50s linear infinite;stroke-linecap:round;}#mermaid-svg-JhWs6md4BOAlHaJI .edge-animation-fast{stroke-dasharray:9,5!important;stroke-dashoffset:900;animation:dash 20s linear infinite;stroke-linecap:round;}#mermaid-svg-JhWs6md4BOAlHaJI .error-icon{fill:#552222;}#mermaid-svg-JhWs6md4BOAlHaJI .error-text{fill:#552222;stroke:#552222;}#mermaid-svg-JhWs6md4BOAlHaJI .edge-thickness-normal{stroke-width:1px;}#mermaid-svg-JhWs6md4BOAlHaJI .edge-thickness-thick{stroke-width:3.5px;}#mermaid-svg-JhWs6md4BOAlHaJI .edge-pattern-solid{stroke-dasharray:0;}#mermaid-svg-JhWs6md4BOAlHaJI .edge-thickness-invisible{stroke-width:0;fill:none;}#mermaid-svg-JhWs6md4BOAlHaJI .edge-pattern-dashed{stroke-dasharray:3;}#mermaid-svg-JhWs6md4BOAlHaJI .edge-pattern-dotted{stroke-dasharray:2;}#mermaid-svg-JhWs6md4BOAlHaJI .marker{fill:#333333;stroke:#333333;}#mermaid-svg-JhWs6md4BOAlHaJI .marker.cross{stroke:#333333;}#mermaid-svg-JhWs6md4BOAlHaJI svg{font-family:"trebuchet ms",verdana,arial,sans-serif;font-size:16px;}#mermaid-svg-JhWs6md4BOAlHaJI p{margin:0;}#mermaid-svg-JhWs6md4BOAlHaJI .entityBox{fill:#ECECFF;stroke:#9370DB;}#mermaid-svg-JhWs6md4BOAlHaJI .relationshipLabelBox{fill:hsl(80, 100%, 96.2745098039%);opacity:0.7;background-color:hsl(80, 100%, 96.2745098039%);}#mermaid-svg-JhWs6md4BOAlHaJI .relationshipLabelBox rect{opacity:0.5;}#mermaid-svg-JhWs6md4BOAlHaJI .labelBkg{background-color:rgba(248.6666666666, 255, 235.9999999999, 0.5);}#mermaid-svg-JhWs6md4BOAlHaJI .edgeLabel .label{fill:#9370DB;font-size:14px;}#mermaid-svg-JhWs6md4BOAlHaJI .label{font-family:"trebuchet ms",verdana,arial,sans-serif;color:#333;}#mermaid-svg-JhWs6md4BOAlHaJI .edge-pattern-dashed{stroke-dasharray:8,8;}#mermaid-svg-JhWs6md4BOAlHaJI .node rect,#mermaid-svg-JhWs6md4BOAlHaJI .node circle,#mermaid-svg-JhWs6md4BOAlHaJI .node ellipse,#mermaid-svg-JhWs6md4BOAlHaJI .node polygon{fill:#ECECFF;stroke:#9370DB;stroke-width:1px;}#mermaid-svg-JhWs6md4BOAlHaJI .relationshipLine{stroke:#333333;stroke-width:1;fill:none;}#mermaid-svg-JhWs6md4BOAlHaJI .marker{fill:none!important;stroke:#333333!important;stroke-width:1;}#mermaid-svg-JhWs6md4BOAlHaJI .edgeLabel{background-color:rgba(232,232,232, 0.8);}#mermaid-svg-JhWs6md4BOAlHaJI .edgeLabel .label rect{fill:rgba(232,232,232, 0.8);}#mermaid-svg-JhWs6md4BOAlHaJI .edgeLabel .label text{fill:#333;}#mermaid-svg-JhWs6md4BOAlHaJI :root{--mermaid-font-family:"trebuchet ms",verdana,arial,sans-serif;} 一对一
一对多
多对多
USERS
USER_PROFILES
CLOUD_FILES
STORAGE_NODES
在真实的业务中,业务逻辑往往需要多张表紧密配合,表与表是有关系的
一对一关系
表A的一行只能对应表B的一行。通常用于将"核心高频数据"与"扩展低频数据"分离,提供查询效率
示例:用户(Users)与用户详细信息(User_Profiles)
再用户系统中,用户的账号密码是核心,而个人结构、头像URL、收货地址属于扩展信息。
postgresql
-- 主表:核心用户
CREATE TABLE users(
	id BIGINT GENERATED BY DEFAULT AS IDENTITY PRIMARY KEY,
	username TEXT NOT NULL UNIQUE
);

-- 扩展表:详细资料
CREATE TABLE user_profiles(
	user_id BIGINT PRIMARY KEY, -- 既是主键,也是外键
	avatar_url TEXT,
	bio TEXT,
	CONSTRAINT fk_user FOREIGN KEY (user_id) REFERENCES users(id) OM DELETE CASCADE
);实现要点:在子表中,将外键字段设为PRIMARY KEY或UNIQUE,确保一个用户ID只能在Profile表里出现一次。
ON DELETE CASCADE(定义"连坐"逻辑)------最核心部分
说明:这是定义当主表(users)的数据被删除时,从表(user_profiles)该何去何从
CASCADE(级联):就像多米诺骨牌。如果ID为1的用户被删除了,数据库会自动、静默地把user_profiles里所有user_id = 1的行删除- why:在"一对一"或"一对多"关系中,如果主体(用户)都不存在了,相关的详细资料也就没有存在的意义。使用级联可以防止数据库堆积垃圾数据
另外,处理CASCADE,你有时也会看到这些写法:
| 选项 | 效果 | 适用场景 |
|---|---|---|
RESTRICT(默认) |
如果用户还有资料,就不准删这个用户 | 保护重要数据,防止误删 |
SET NULL |
用户删了,资料表里的user_id |
用户注销了,但你想保留它的痕迹 |
NO ACTION |
与RESTRICT类似,但在事务结束时检查 |
复杂的事务处理 |
插入数据
postgresql
-- 第一步 :插入核心用户
-- 我们利用 RETURNING 直接获取系统生成的自增ID
INSERT INTO users(username)
VALUES ('fengfeng')
RETURNING id;

-- 假设上面返回ID是1
-- 第二步:插入对应的详细资料
INSERT INTO user_profiles(user_id, avatar_url, bio)
VALUES (1, 'https://example.com/avatar.png', '技术教育者,B站UP主');

-- 尝试再次为ID=1的用户输入资料(会报错!)
-- 报错信息:duplicate key value violates unique constraint "user_profiles_pkey"
-- 这正是我们设计成 PRIMARY KEY 的目的,保证了一对一的严格性。
查询数据:正向联查和反向联查
postgresql
-- 正向
select username, avatar_url
from users
join user_profiles up on users.id = up.user_id;

-- 反向
select username, avatar_url
from user_profiles
left join users u on u.id = user_profiles.user_id;
删除数据
设置CASCADE后,删除用户之后,关联的用户详情也会删除
外键:一般业务里面都会去掉外键,使用逻辑外键
一对多关系
概念:表A的一行可以对应表B的多行,但表B的一行只属于表A的一个实体。
示例:女神和舔狗
一位女神可以拥有成千上万名舔狗,但一名舔狗在特定时间内(业务逻辑上)往往只能死心塌地给一位女神跪舔
postgresql
-- 1. 女神表 (一)
CREATE TABLE goddesses(
	id BIGINT GENERATED BY DEFAULT AS IDENITY PRIMARY KEY,
	name TEXT NOT NULL,
	star_sign TEXT -- 星座
);

-- 2. 舔狗表(多)
CREATE TABLE simps(
	id BIGINT GENERATED BY DEFAULT AS IDENTITY PRIMARY KEY,
	target_id BIGINT NOT NULL, -- 目标女神的ID(外键)
	nickname TEXT NOT NULL, -- 昵称
	contributed_amount DECIMAL(10,2) DEFAULT 0, -- 累计金额(打钱)

	-- 外键约束:如果女神号注销了,舔狗记录也级联消失
	CONSTRAINT fk_goddess FOREIGN KEY (target_id) REFERENCES goddesses(id) ON DELETE CASCADE
);- 实现要点:在"多"的一方(simps)添加一个字段存储"一"的一方(goddesses)的主键。
插入数据
postgresql
-- 插入两位女神数据
-- 假设 林青霞 ID=1, 王祖贤 ID=2
INSERT INTO goddesses(name, star_sign)
VALUES ('林青霞', '天蝎座'), ('王祖贤', '水瓶座')
RETURNING id, name;

-- 为 林青霞 (ID: 1) 插入忠实粉丝
INSERT INTO simps (target_id, nickname, contributed_amount) VALUES
(1, '阿强', 520.00),
(1, '小明', 1314.00),
(1, '旺财', 9.90);

-- 为 王祖贤 (ID: 2) 插入忠实粉丝
INSERT INTO simps (target_id, nickname, contributed_amount) VALUES
(2, '大壮', 8888.88),
(2, '铁柱', 0.01);
查询------查看每位舔狗正在追谁
postgresql
SELECT
	s.nickname AS 舔狗,
	g.name AS 女神,
	s.contributed_amount AS 贡献值
FROM simps s
JOIN goddesses g ON s.target_id = g.id
ORDER BY s.contributed_amount DESC;
查询------查看哪位女神收到的"贡献"总额最高
postgresql
SELECT
	g.name AS 女神姓名,
	COUNT(s.id) AS 舔狗总数,
	SUM(s.contributed_amount) AS  收到总贡献
FROM goddesses g
LEFT JOIN simps s ON g.id = s.target_id
GROUP BY g.name
ORDER BY 收到总金额 DESC;
查询------找出贡献金额低于 10 元的舔狗
postgresql
SELECT nickname, contributed_amount
FROM simps
WHERE contributed_amount < 10.00;
多对多关系
概念:表A的一行对应表B的多行,反之亦然
示例:学生(Students)与社团(Clubs)
- 一个学生可以参加多个社团(比如既参加篮球社,又参加IT设)
- 一个社团也可以拥有很多名学生
- 这种关系无法在任何一张表里通过增加一个字段来解决,必须有一个"中间人"来牵线搭桥
postgresql
-- 1. 学生表(核心实体A)
CREATE TABLE students(
	id BIGINT GENERATED BY DEFAULT AS IDENTITY PRIMARY KEY,
	name TEXT NOT NULL
);

-- 2. 社团表
CREATE TABLE clubs(
	id BIGINT GENERATED BY DEFAULT AS IDENTITY PRIMARY KEY,
	club_name TEXT NOT NULL UNIQUE,
	description TEXT
);

-- 3. 成员关系表(中间桥梁)
-- 这张表记录了"谁"参加了"哪个"社团
CREATE TABLE memberships(
	student_id BIGINT REFERENCES students(id) ON DELETE CASCADE,
	club_id BIGINT REFERENCES clubs(id) ON DELETE CASCADE,
	joined_at TIMESTAMPTZ DEFAULT NOW(), -- 记录入社时间
	PRIMARY KEY (student_id, club_id) --联合组件,保证一个学生不会再同一个社团里加两次
);
插入数据
postgresql
-- 插入学生
INSERT INTO students (name) VALUES ('枫枫'), ('小红'), ('老王') RETURNING id;
-- 假设 ID 分别是 1, 2, 3

-- 插入社团
INSERT INTO clubs (club_name, description) VALUES
('Go语言社', '高性能后端开发探讨'),
('篮球社', '只因你太美'),
('钓鱼社', '永不空军')
RETURNING id;
-- 假设 ID 分别是 1, 2, 3

-- 建立关系 (多对多)
INSERT INTO memberships (student_id, club_id) VALUES
(1, 1), -- 枫枫 参加了 Go语言社
(1, 2), -- 枫枫 参加了 篮球社
(2, 2), -- 小红 参加了 篮球社
(3, 1), -- 老王 参加了 Go语言社
(3, 3); -- 老王 参加了 钓鱼社
查询
查成员:想看"Go语言社"里都有哪些大神?
由于信息隔了两层,我们需要两次JOIN跳过去。
postgresql
SELECT
	c.club_name AS 社团名,
	s.name AS 成员名,
	m.joined_at AS 入社时间
FROM clubs c
JOIN memberships m ON c.id = m.club_id
JOIN students s ON m.student_id = s.id
WHERE c.club_name = 'GO语言社';
查轨迹:想看"枫枫"同学一共参加了多少个社团?
postgresql
SELECT
	s.name AS 学生名
	COUNT(m.club_id) AS 参加社团数,
	string_agg(c.club_name, ', ') AS 社团清单 -- 把社团名拼成字符串
FROM student s
LEFT JOIN membership m ON s.id = m.student_id
LEFT JOIN clubs c ON m.club.id = c.id
WHERE s.name = '枫枫'
查热度:哪个社团人最多?
postgresql
SELECT
	c.club_name,
	COUNT(m.student_id) AS 社团人数
FROM clubs c
LEFT JOIN membership m on c.id = c.club_id
GROUP BY c.club_name
ORDER BY 社团人数 DESC;
索引
什么是索引?
小时候我们查字典,如果不知道这个字大概读什么,就需要一页页翻字典
如果知道这个字大概的读音,翻字典的时候就能直接到那一片区域去找
为什么需要索引?
索引实战:从创建到性能对比
下面我们用一个完整的示例,演示如何创建各类索引,并用 EXPLAIN ANALYZE 直观对比索引带来的性能提升。
1. 准备测试数据
postgresql
-- 创建一张用户表
CREATE TABLE users (
    id BIGINT GENERATED BY DEFAULT AS IDENTITY PRIMARY KEY,
    username TEXT NOT NULL,
    email TEXT NOT NULL,
    age INT,
    city TEXT,
    created_at TIMESTAMPTZ DEFAULT NOW()
);

-- 插入 10 万条测试数据(方便观察索引效果)
INSERT INTO users (username, email, age, city)
SELECT
    'user_' || g,
    'user_' || g || '@example.com',
    (random() * 80 + 18)::int,
    (ARRAY['北京', '上海', '广州', '深圳', '杭州'])[1 + (random() * 4)::int]
FROM generate_series(1, 100000) AS g;
2. 创建普通索引(B-Tree)
postgresql
-- 普通索引:加速单列等值/范围查询
CREATE INDEX idx_users_email ON users (email);

-- 查看索引是否生效
\d users
3. 创建唯一索引
postgresql
-- 唯一索引:保证列值唯一,同时加速查询
-- 注意:如果表里已有重复数据,创建会失败
CREATE UNIQUE INDEX idx_users_username ON users (username);
4. 创建复合索引(多列联合)
postgresql
-- 复合索引:加速多条件组合查询
-- 注意最左前缀原则:查询条件必须从最左侧字段开始匹配
CREATE INDEX idx_users_city_age ON users (city, age);

-- 适合以下查询:
-- WHERE city = '北京' AND age > 25
-- WHERE city = '上海'
-- 但不适合:WHERE age > 25(没有从 city 开始)
5. 创建部分索引(Partial Index)
postgresql
-- 部分索引:只对满足条件的行建立索引,节省空间、提升性能
-- 场景:只关心 18-30 岁的年轻用户
CREATE INDEX idx_users_young ON users (age) WHERE age BETWEEN 18 AND 30;

-- 适合查询:
-- WHERE age BETWEEN 20 AND 25
-- 不适合查询:
-- WHERE age BETWEEN 40 AND 50(不在索引范围内)
6. 用 EXPLAIN ANALYZE 对比性能
postgresql
-- 场景一:按 email 精确查询(走普通索引)
EXPLAIN ANALYZE
SELECT * FROM users WHERE email = 'user_50000@example.com';

-- 执行计划(示例输出):
-- Index Scan using idx_users_email on users  (cost=0.42..8.44 rows=1 width=48) (actual time=0.018..0.019 rows=1 loops=1)
-- Planning Time: 0.123 ms
-- Execution Time: 0.035 ms
-- 结论:走了 Index Scan,速度极快

-- 场景二:按 username 精确查询(走唯一索引)
EXPLAIN ANALYZE
SELECT * FROM users WHERE username = 'user_50000';

-- 执行计划(示例输出):
-- Index Scan using idx_users_username on users  (cost=0.42..8.44 rows=1 width=48) (actual time=0.015..0.016 rows=1 loops=1)
-- Planning Time: 0.108 ms
-- Execution Time: 0.028 ms
-- 结论:唯一索引同样走 Index Scan,性能优秀

-- 场景三:复合索引(城市 + 年龄)
EXPLAIN ANALYZE
SELECT * FROM users
WHERE city = '北京' AND age BETWEEN 20 AND 30;

-- 执行计划(示例输出):
-- Bitmap Heap Scan on users  (cost=4.62..12.34 rows=5 width=48) (actual time=0.042..0.045 rows=5 loops=1)
--   Recheck Cond: ((city = '北京'::text) AND (age >= 20) AND (age <= 30))
--   ->  Bitmap Index Scan on idx_users_city_age  (cost=0.00..4.62 rows=5 width=0) (actual time=0.035..0.035 rows=5 loops=1)
-- Planning Time: 0.152 ms
-- Execution Time: 0.062 ms
-- 结论:复合索引生效,使用 Bitmap Index Scan

-- 场景四:部分索引(只覆盖 18-30 岁)
EXPLAIN ANALYZE
SELECT * FROM users WHERE age BETWEEN 20 AND 25;

-- 执行计划(示例输出):
-- Index Scan using idx_users_young on users  (cost=0.29..4.31 rows=2 width=48) (actual time=0.021..0.022 rows=2 loops=1)
-- Planning Time: 0.098 ms
-- Execution Time: 0.031 ms
-- 结论:部分索引精准命中,只扫描符合条件的行

-- 场景五:没有索引的字段(对比效果)
EXPLAIN ANALYZE
SELECT * FROM users WHERE city = '深圳';

-- 执行计划(示例输出):
-- Seq Scan on users  (cost=0.00..1980.00 rows=20000 width=48) (actual time=0.045..12.345 rows=20000 loops=1)
--   Filter: (city = '深圳'::text)
-- Planning Time: 0.089 ms
-- Execution Time: 12.456 ms
-- 结论:没有索引时走 Seq Scan(全表扫描),10 万行数据耗时约 12ms
7. 性能对比小结
| 查询场景 | 索引类型 | 执行方式 | 耗时(10万行) |
|---|---|---|---|
email 精确查询 |
普通索引 | Index Scan | ~0.035 ms |
username 精确查询 |
唯一索引 | Index Scan | ~0.028 ms |
city + age 组合查询 |
复合索引 | Bitmap Index Scan | ~0.062 ms |
age 范围查询(青年) |
部分索引 | Index Scan | ~0.031 ms |
city 无索引查询 |
无 | Seq Scan(全表扫描) | ~12.456 ms |
结论 :合理使用索引,查询性能可提升 200~400 倍 。但索引并非越多越好,每个索引都会占用磁盘空间,并拖慢
INSERT/UPDATE/DELETE的速度,需要根据实际业务权衡。
想象一下,你有一张files表,里面存了1000万行数据。如果执行:SELECT * FROM files WHERE file_name = 'xx文件';如果没有索引,数据库得从第一行扫到第1000万行(全表扫描),你的硬盘灯会闪个不停,用户等到天荒地老。
场景:你的"枫枫网盘"用户量激增,查询文件名变得极慢。
postgresql
-- 1. 创建演示表
CREATE TABLE cloud_files (
    id BIGINT GENERATED BY DEFAULT AS IDENTITY PRIMARY KEY,
    file_name TEXT NOT NULL,
    file_type VARCHAR(20),
    created_at TIMESTAMPTZ DEFAULT NOW()
);

-- 2. 插入 100 万条模拟数据(演示时可以用这个快速生成)
INSERT INTO cloud_files (file_name, file_type)
SELECT
    'file_' || i || '.pdf',
    (ARRAY['video', 'image', 'doc'])[floor(random()*3)+1]
FROM generate_series(1, 1000000) s(i);

-- 3. 【未加索引前】查询耗时
EXPLAIN ANALYZE SELECT * FROM cloud_files WHERE file_name = 'file_999999.pdf';
-- 你会看到 "Seq Scan" (全表扫描),耗时可能在几十毫秒
创建索引
postgresql
-- 给文件名加上 B-Tree 索引(最常用的平衡树索引)
CREATE INDEX idx_file_name ON cloud_files(file_name);

-- 再次查询
EXPLAIN ANALYZE SELECT * FROM cloud_files WHERE file_name = 'file_999999.pdf';
-- 你会发现变成了 "Index Scan",速度提升几百倍!
其他类型的索引
postgresql
-- 显示指定或者默认不写都是 B-Tree
CREATE INDEX idx_file_name ON cloud_files USING btree (file_name);

-- 仅适用于查询
CREATE INDEX idx_file_name ON cloud_files USING hash (file_name);

-- 注意字段顺序:(user_id, file_type)遵循最左匹配原则
CREATE INDEX idx_user_file_type ON cloud_files(user_id, file_type);

-- 如果你的网盘支持"标签查询"或者存数了JSON格式的元数据,GIN索引是神器
-- 假设有一个tags 字段(类型为TEXT[])
CREATE INDEX idx_file_tags ON cloud_files USING gin (tags);

-- 假设有一个meta_data 字段(类型为JSONB)
CREATE INDEX idx_files_meta ON cloud_files USING gin (meta_data jsonb_path_ops);

-- 唯一索引
CREATE UNIQUE INDEX idx_file_md5 ON cloud_file (file_md5);
底层核心
为什么B-Tree这么快?
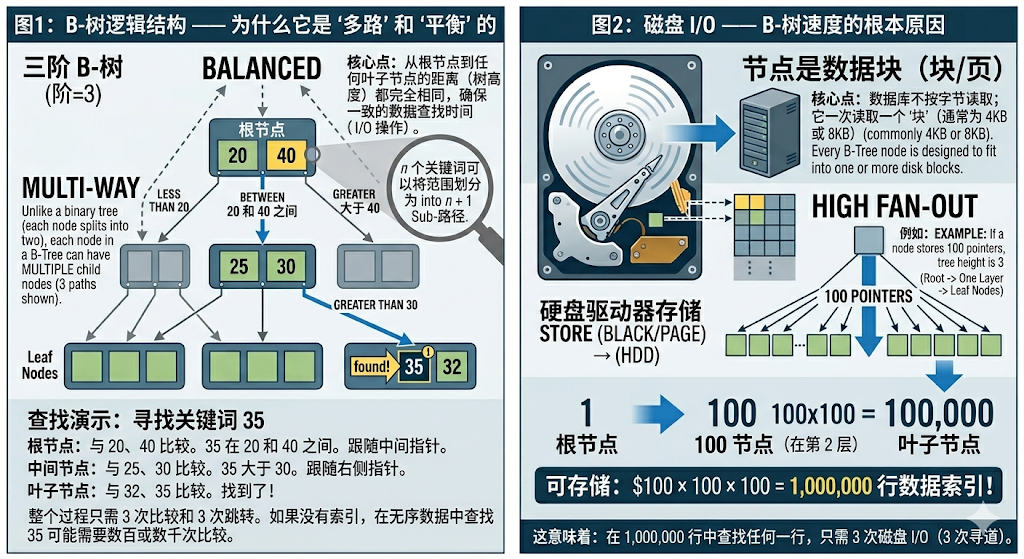
CREATE INDEX通常是B-Tree索引。它的核心逻辑是平衡多路查找树
- 对数级增长:在 1000 万行数据中,全表扫描需要 O(n) 的复杂度(看 1000 万次);而 B-Tree 索引只需要*lo gm (n) 的复杂度
- 实际体感:哪怕数据量翻了 10 倍达到 1 亿行,B-Tree 的树高度可能只增加了 1 层,查询耗时几乎没有明显变化。
索引的"代价":天下没有免费的午餐
索引虽好,但不能全表所有字段都加。每一条索引都会带来以下开销:
- 磁盘空间:索引本身是一棵树,需要占用额外的存储空间
- 写入性能:当你执行**
INSERT、UPDATE或DELETE**时,数据库不仅要改数据,还要同步更新索引树。索引越多,写操作越慢。 - 维护成本:随着数据频繁变动,索引可能会产生碎片,偶尔需要
REINDEX(重建索引)来恢复性能
这些情况下索引会"失效"
很多新手加了索引发现查询还是慢,通常是因为触发了索引失效:
| 场景 | 错误示例 | 正确姿势 |
|---|---|---|
| 模糊查询 | WHERE file_name LIKE '%file_XXX'; |
只有"左前缀"匹配file_XXX才能用索引 |
| 函数操作 | WHERE UPPER(file_name) = 'FILE.PDF'; |
建立函数索引或在查询前处理数据 |
| 类型不匹配 | WHERE id = '123';(id是数字,却传字符串) |
保持类型一致,避免隐式转换 |
| 最左匹配 | 复合索引(a, b)只查b |
复合索引必须从最左侧字段开始匹配 |
事务和锁
事务
下面是事务 ACID 特性的图解:
#mermaid-svg-BC8utO3XxT0ebL4t{font-family:"trebuchet ms",verdana,arial,sans-serif;font-size:16px;fill:#333;}@keyframes edge-animation-frame{from{stroke-dashoffset:0;}}@keyframes dash{to{stroke-dashoffset:0;}}#mermaid-svg-BC8utO3XxT0ebL4t .edge-animation-slow{stroke-dasharray:9,5!important;stroke-dashoffset:900;animation:dash 50s linear infinite;stroke-linecap:round;}#mermaid-svg-BC8utO3XxT0ebL4t .edge-animation-fast{stroke-dasharray:9,5!important;stroke-dashoffset:900;animation:dash 20s linear infinite;stroke-linecap:round;}#mermaid-svg-BC8utO3XxT0ebL4t .error-icon{fill:#552222;}#mermaid-svg-BC8utO3XxT0ebL4t .error-text{fill:#552222;stroke:#552222;}#mermaid-svg-BC8utO3XxT0ebL4t .edge-thickness-normal{stroke-width:1px;}#mermaid-svg-BC8utO3XxT0ebL4t .edge-thickness-thick{stroke-width:3.5px;}#mermaid-svg-BC8utO3XxT0ebL4t .edge-pattern-solid{stroke-dasharray:0;}#mermaid-svg-BC8utO3XxT0ebL4t .edge-thickness-invisible{stroke-width:0;fill:none;}#mermaid-svg-BC8utO3XxT0ebL4t .edge-pattern-dashed{stroke-dasharray:3;}#mermaid-svg-BC8utO3XxT0ebL4t .edge-pattern-dotted{stroke-dasharray:2;}#mermaid-svg-BC8utO3XxT0ebL4t .marker{fill:#333333;stroke:#333333;}#mermaid-svg-BC8utO3XxT0ebL4t .marker.cross{stroke:#333333;}#mermaid-svg-BC8utO3XxT0ebL4t svg{font-family:"trebuchet ms",verdana,arial,sans-serif;font-size:16px;}#mermaid-svg-BC8utO3XxT0ebL4t p{margin:0;}#mermaid-svg-BC8utO3XxT0ebL4t .label{font-family:"trebuchet ms",verdana,arial,sans-serif;color:#333;}#mermaid-svg-BC8utO3XxT0ebL4t .cluster-label text{fill:#333;}#mermaid-svg-BC8utO3XxT0ebL4t .cluster-label span{color:#333;}#mermaid-svg-BC8utO3XxT0ebL4t .cluster-label span p{background-color:transparent;}#mermaid-svg-BC8utO3XxT0ebL4t .label text,#mermaid-svg-BC8utO3XxT0ebL4t span{fill:#333;color:#333;}#mermaid-svg-BC8utO3XxT0ebL4t .node rect,#mermaid-svg-BC8utO3XxT0ebL4t .node circle,#mermaid-svg-BC8utO3XxT0ebL4t .node ellipse,#mermaid-svg-BC8utO3XxT0ebL4t .node polygon,#mermaid-svg-BC8utO3XxT0ebL4t .node path{fill:#ECECFF;stroke:#9370DB;stroke-width:1px;}#mermaid-svg-BC8utO3XxT0ebL4t .rough-node .label text,#mermaid-svg-BC8utO3XxT0ebL4t .node .label text,#mermaid-svg-BC8utO3XxT0ebL4t .image-shape .label,#mermaid-svg-BC8utO3XxT0ebL4t .icon-shape .label{text-anchor:middle;}#mermaid-svg-BC8utO3XxT0ebL4t .node .katex path{fill:#000;stroke:#000;stroke-width:1px;}#mermaid-svg-BC8utO3XxT0ebL4t .rough-node .label,#mermaid-svg-BC8utO3XxT0ebL4t .node .label,#mermaid-svg-BC8utO3XxT0ebL4t .image-shape .label,#mermaid-svg-BC8utO3XxT0ebL4t .icon-shape .label{text-align:center;}#mermaid-svg-BC8utO3XxT0ebL4t .node.clickable{cursor:pointer;}#mermaid-svg-BC8utO3XxT0ebL4t .root .anchor path{fill:#333333!important;stroke-width:0;stroke:#333333;}#mermaid-svg-BC8utO3XxT0ebL4t .arrowheadPath{fill:#333333;}#mermaid-svg-BC8utO3XxT0ebL4t .edgePath .path{stroke:#333333;stroke-width:2.0px;}#mermaid-svg-BC8utO3XxT0ebL4t .flowchart-link{stroke:#333333;fill:none;}#mermaid-svg-BC8utO3XxT0ebL4t .edgeLabel{background-color:rgba(232,232,232, 0.8);text-align:center;}#mermaid-svg-BC8utO3XxT0ebL4t .edgeLabel p{background-color:rgba(232,232,232, 0.8);}#mermaid-svg-BC8utO3XxT0ebL4t .edgeLabel rect{opacity:0.5;background-color:rgba(232,232,232, 0.8);fill:rgba(232,232,232, 0.8);}#mermaid-svg-BC8utO3XxT0ebL4t .labelBkg{background-color:rgba(232, 232, 232, 0.5);}#mermaid-svg-BC8utO3XxT0ebL4t .cluster rect{fill:#ffffde;stroke:#aaaa33;stroke-width:1px;}#mermaid-svg-BC8utO3XxT0ebL4t .cluster text{fill:#333;}#mermaid-svg-BC8utO3XxT0ebL4t .cluster span{color:#333;}#mermaid-svg-BC8utO3XxT0ebL4t div.mermaidTooltip{position:absolute;text-align:center;max-width:200px;padding:2px;font-family:"trebuchet ms",verdana,arial,sans-serif;font-size:12px;background:hsl(80, 100%, 96.2745098039%);border:1px solid #aaaa33;border-radius:2px;pointer-events:none;z-index:100;}#mermaid-svg-BC8utO3XxT0ebL4t .flowchartTitleText{text-anchor:middle;font-size:18px;fill:#333;}#mermaid-svg-BC8utO3XxT0ebL4t rect.text{fill:none;stroke-width:0;}#mermaid-svg-BC8utO3XxT0ebL4t .icon-shape,#mermaid-svg-BC8utO3XxT0ebL4t .image-shape{background-color:rgba(232,232,232, 0.8);text-align:center;}#mermaid-svg-BC8utO3XxT0ebL4t .icon-shape p,#mermaid-svg-BC8utO3XxT0ebL4t .image-shape p{background-color:rgba(232,232,232, 0.8);padding:2px;}#mermaid-svg-BC8utO3XxT0ebL4t .icon-shape .label rect,#mermaid-svg-BC8utO3XxT0ebL4t .image-shape .label rect{opacity:0.5;background-color:rgba(232,232,232, 0.8);fill:rgba(232,232,232, 0.8);}#mermaid-svg-BC8utO3XxT0ebL4t .label-icon{display:inline-block;height:1em;overflow:visible;vertical-align:-0.125em;}#mermaid-svg-BC8utO3XxT0ebL4t .node .label-icon path{fill:currentColor;stroke:revert;stroke-width:revert;}#mermaid-svg-BC8utO3XxT0ebL4t :root{--mermaid-font-family:"trebuchet ms",verdana,arial,sans-serif;} 事务 Transaction
原子性 Atomicity
一致性 Consistency
隔离性 Isolation
持久性 Durability
用最通俗的话说,事务就是:"要么全做完,要么一点都不做,绝不允许停在半路。"
场景:用户花100元买VIP。如果钱扣了,结构数据库断电了,会员没加上
postgresql
-- 准备表
CREATE TABLE accounts (
    username TEXT PRIMARY KEY,
    balance DECIMAL(10, 2)
);

CREATE TABLE members (
    username TEXT PRIMARY KEY,
    expire_date DATE
);

INSERT INTO accounts VALUES ('小红', 150.00);
INSERT INTO members VALUES ('小红', '2026-01-01');
postgresql
BEGIN - 开启事务,立下"生死状"
-- 1. 扣钱
UPDATE account SET balance = balance - 100 WHERE username = '小红';
-- 2. 增加会员时长 (假设这里 SQL 写错了或网络断了)
UPDATE members SET expire_date = expire_date + INTERVAL '1 year' WHERE username = '小红';

-- 检查一下:如果钱扣对了,会员也加了
COMMIT; -- 确认无误,正式写入硬盘
假如中途出错了
postgresql
ROLLBACK; -- 刚才的所有操作全部撤销,钱会回到小红账上,像没发生过一样还可以在中途设置存档点
postgresql
BEGIN;  -- 开启事务
UPDATE ...; -- 执行业务逻辑
SAVEPOINT my_sp; -- (可选) 设置保存点,类似于单机游戏的存档
UPDATE ...;
ROLLBACK TO my_sp; -- (可选) 发现错了,回滚到存档点
COMMIT; -- 提交,所有改动生效
ACID
不管是PG还是其他数据库,实体都必须遵守ACID原则:
- A(Atomicity)原子性:就是所说的"要么全做,要么不做"
- C(Consistency)一致性:数据必须从一个合法状态变到另一个合法状态(比如余额不能变成负值)
- I(Isolation)隔离性:重点!多用户同时操作时,他们直接不能互相干扰
- D(Durability)持久性:只要你点了
COMMIT,就算立马拔掉电源,数据也已经写死再硬盘里了
锁
在PostgreSQL中,锁是确保数据库并发安全(Consistency & Isolation)的核心机制,简单来说,它防止了多个用户同时修改同一条数据而导致的混乱
PostgreSQL的锁体系非常庞大,主要可以分为以下三个层次:
表级锁(Table-Level Locks)
即使你只是对表进行简单的SELECT或UPDATE,PostgreSQL都会自动加上表级锁
常见的锁模式
- Access Share(访问共享锁):
SELECT时自动获取、允许其他事务读写,但不允许修改表结构 - Row Exclusive(行排他锁):
INSERT、UPDATE、DELETE时自动获取 - Share(共享锁):常用于创建索引、允许读,禁止改
- Access Exclusive(访问排它锁):最强锁,
AFTER TABLE、DROP TABLE、TRUNCATE时触发。它会阻塞一切操作(包括SELECT)
行级锁(Row-Level Locks)
行级锁主要用于处理具体的数据记录。它们不在内存中维护列表,二十之间在数据页中标记
- FOR SHARE :保证你读取的行不会被比尔修改或删除,知道你提交事务
- FOR UPDATE:锁定行以进行更新。其他事务无法对这些进行
UPDATE、DETELE、SELECT FOR UPDATE - FOR NO KEY UPDATE / FOR KEY SHARE:更细粒度的锁,主要为了优化外键关联时的并发性能
建议锁(Advisory Locks)
这是PostgreSQL的一大特色。他不是由数据库引擎自动加的,而是由程序员定义的一种逻辑锁。
- 用途:比如你想锁定"发送邮件"这个动作,或者确保某个后台任务在同一时间只能有一个实例在运行,就可以用建议锁
- 特定:它不锁定具体的表或行,只是在内存里占一个"标识位"
如何使用?
自动锁定
绝大多数清空下,是不需要收到加锁的,执行UPDATE users SET name = 'Gemini WHERE id = 1;'时,数据库会自动给该行加排它锁。
手动锁定表
如果你需要进行大面积维护,不希望比尔干扰:
postgresql
BEGIN;
-- 需要把这个锁放到事务里面
LOCK TABLE my_table IN ACCESS EXCLUSIVE MODE; -- 彻底锁死表
-- 执行操作
COMMIT;
手动锁定行
这是处理高并发业务(如扣减库存)时的标准写法:(解决"超卖"等问题)
postgresql
BEGIN;
-- 锁定Id为100的行,别人必须等我处理完
SELECT * FROM products WHERE id = 100 FOR UPDATE;

UPDATE products SET stock = stock - 1 WHERE id = 100;
COMMIT;
别的连接只能进行普通的select查询,不能进行更新或者删除操作
使用建议锁
postgresql
-- 获取一个编号为 12345 的逻辑锁
SELECT pg_advisory_lock(12345);
-- 执行你的业务逻辑...

-- 释放锁
SELECT pg_advisory_unlock(12345);
如何查看当前的锁?
如果发现数据库"卡住了",可以用这张表查谁在锁谁:
postgresql
SELECT * FROM pg_locks 1
JOIN pg_stat_activity a ON l.pid = a.pid;
隔离级别(Isolation Levels)
隔离级别决定了多个并发事务之间互相"可见"的程度。PostgreSQL 默认使用 READ COMMITTED,这也是绝大多数业务场景的最佳选择。
| 隔离级别 | 脏读 | 不可重复读 | 幻读 | 说明 |
|---|---|---|---|---|
READ UNCOMMITTED |
可能 | 可能 | 可能 | PostgreSQL 实际将其当作 READ COMMITTED 处理 |
READ COMMITTED(默认) |
不会 | 可能 | 可能 | 每条 SQL 语句只能看到它开始前已提交的数据 |
REPEATABLE READ |
不会 | 不会 | 可能 | 整个事务内看到的数据快照一致,但可能产生序列化异常 |
SERIALIZABLE |
不会 | 不会 | 不会 | 最强隔离,事务完全串行化,并发冲突时直接报错 |
postgresql
-- 查看当前事务的隔离级别
SHOW transaction_isolation;

-- 在事务内设置隔离级别(必须在 BEGIN 之后、第一条 SQL 之前设置)
BEGIN;
SET TRANSACTION ISOLATION LEVEL REPEATABLE READ;
-- 你的业务 SQL...
COMMIT;
经验之谈 :绝大多数业务用默认的
READ COMMITTED就够了。只有当你需要"同一事务内多次读取结果必须一致"时(比如对账、报表),才考虑REPEATABLE READ。SERIALIZABLE会显著降低并发度,务必谨慎使用。
死锁(Deadlock)与排查
死锁是指两个或多个事务互相持有对方需要的锁,导致彼此永远无法继续执行。PostgreSQL 会自动检测死锁,并强制回滚其中一个事务来打破僵局。
典型死锁场景:
postgresql
-- 事务 A:先锁 id=1,再锁 id=2
BEGIN;
SELECT * FROM products WHERE id = 1 FOR UPDATE;
-- 此时事务 B 已经锁住了 id=2,A 在这里等待 B 释放 id=2...

-- 事务 B:先锁 id=2,再锁 id=1
BEGIN;
SELECT * FROM products WHERE id = 2 FOR UPDATE;
-- 此时事务 A 已经锁住了 id=1,B 在这里等待 A 释放 id=1...
-- 双方互相等待,死锁形成!
排查方法:
postgresql
-- 1. 查看当前所有活动事务及其状态
SELECT pid, state, query, wait_event_type, wait_event
FROM pg_stat_activity
WHERE state = 'active';

-- 2. 查看当前锁的等待关系(谁在等谁)
SELECT
    blocked.pid AS blocked_pid,
    blocking.pid AS blocking_pid,
    blocked.query AS blocked_query,
    blocking.query AS blocking_query
FROM pg_stat_activity blocked
JOIN pg_stat_activity blocking ON blocking.pid = ANY(blocked.pg_blocking_pids())
WHERE blocked.state = 'active';

-- 3. 查看 PostgreSQL 死锁检测日志(在 postgresql.conf 中开启)
-- log_lock_waits = on
-- deadlock_timeout = 1s
预防死锁的常用手段:
- 统一加锁顺序:所有事务都按相同的顺序访问资源(比如先 id 小的,再 id 大的),从根上消除循环等待。
- 缩短事务时间:事务里只放必要的 SQL,避免在事务中做耗时的外部调用(如 HTTP 请求)。
- 使用
SELECT ... FOR UPDATE SKIP LOCKED:跳过已被锁定的行,适合任务队列等场景,避免排队等待。 - 设置合理的
lock_timeout:给锁等待加一个超时上限,超时即放弃,避免无限期挂起。
CTE与视图
CTE
在写sql的时候,如果sql条件有那种嵌套的
postgresql
SELECT * FROM (
	SELECT * FROM (
		SELECT ... -- 这里的代码已经缩进到太平洋了
	) AS inner_data
) AS outer_data;
这个sql看起来就很不直观了,我们可以里面的sql抽离成一个变量
比如枫枫网盘需要统计:"每个用户上传的文件总大小,并筛选出超过 1GB 的土豪用户"。
postgresql
-- 使用CTE 让代码逻辑清晰
WITH user_file_stats AS (
	-- 第一步:先把每个人的总和算出来,起个名字叫作user_file_stats
	SELECT
		u.username,
		SUM(f.file_size) as total_size,
		COUNT(f.id) as file_count
	FROM users u
	LEFT JOIN cloud_file f ON u.id = f.user_id
	GROUP BY u.username
)

-- 第二步:之间想查表一样查这个"变量"
SELECT * FROM user_file_stats
WHERE total_size > 1024*1024*1024; -- 筛选超过1GB的人
视图
视图是一张虚拟表。它不存储实际数据,只存储一条查询语句。当你查询视图时,它会跑一遍背后的SQL。
如果你经常在需要通过JOIN关联用户、文件、存储节点这三张表来查看"文件完整路径",每次写10行SQL很累。
postgresql
-- 1. 创建视图,一次封装,永久受益
CREATE VIEW v_file_detail_full AS
SELECT
	f.id,
	f.file_name,
	u.username AS owner_name,
	n.node_name AS storage_location,
	f.created_at
FROM cloud_files f
JOIN users s ON f.user_id = u.id
JOIN storage_nodes n ON f.node_id = n.id;

-- 2. 以后查起来就像查表单一样
SELECT * FROM v_file_detail_full WHERE owner_name = 'fengfeng';
怎么选择:视图vsCTE
| 特性 | CTE(WITH) | 视图(View) |
|---|---|---|
| 生命周期 | 只在当前这条SQL里有效 | 永久保存在数据库里 |
| 类比 | 局部变量 | 全局公共函数 |
| 使用场景 | 仅仅为了让这一行长查询变好看 | 经常要用的复杂擦互相、报表统计 |
| 权限控制 | 无 | 非常强大(可以给用户看视图,但不给它看原表) |
用户与角色
作为一个"最先进"的数据库,PostgreSQL的用户与权限系统(Role&Privilege)是它安全性的护城河
目前我们一直使用超级管理员postgres裸奔,这在生产环境里简直是"自杀"行为。
场景:你现在是DBA,你要给前端开发人员创建一个账号,只能看数据,不能删库
postgresql
-- 1. 创建一个组(不准登录)
CREATE ROLE managers;

-- 2. 创建一个用户(准许登录)
CREATE USER fengfeng WITH PASSWORD 'fengfeng';

-- 3. 让用户加入组
GRANT managers TO fengfeng;
查看我有哪些角色 :\dn
postgresql
SELECT
	rolname AS 角色名,
	rolcanlogin AS 能否登录,
	rolsuper AS 是否超级管理员,
	rolcreatedb AS 能否建库
FROM pg_roles
WHERE rolename NOT LIKE 'pg_%'; -- 过滤掉所有以 pg_ 开头的系统角色
现在这个用户,可以登录,可以看到有哪些库,有哪些表,但是不能创建库,创建表,查询表数据
示例1:给用户设置某一个库的只读权限
postgresql
-- 1. 创建用户
CREATE USER reader_user WITH PASSWORD 'fengfeng';

-- 2. 基础进门权
GRANT CONNECT ON DATABASE db TO reader_user; -- 可以进入db这个库
GRANT USAGE ON SCHEMA public TO reader_user; -- 可以进入public这个模式

-- 3. 核心只读权限(现在的表+序列)
GRANT SELECT ON ALL TABLES IN SCHEMA public TO reader_user;
GRANT SELECT ON ALL SEQUENCES IN SHCEMA public TO reader_user;

-- 4. 自动化(未来的表)
ALTER DEFAULT PRIVILEGES IN SCHEMA piblic;
GRANT SELECT ON TABLES TO reader_user;
示例2:给用户设置一个库的增删改查权限
postgresql
GREATE USER feng_all WITH PASSWORD 'fengfeng';

GRANT CONNTECT ON DATABASE fengfeng_db TO feng_all;
GRANT USAGE ON SCHEMA public TO feng_all;

-- 1. 针对表:赋予全部增删改查权限
GRANT SELECT, INSERT, DELETE, UPDATE ON ALL TABLES IN SCHEMA public TO feng_all;

-- 2. 针对序列:必须给权限!否则无法执行自增 ID 的插入
GRANT USAGE INSERT, UPDATE ON ALL SEQUENCES IN SCHEMA public TO feng_all;

-- 后续新创建的表也拥有权限
ALTER DEFAULT PRIVILEGES IN SCHEMA public;
GRANT SELECT, INSERT, UPDATE, DELETE ON TABLES TO feng_all;

ALTER DEFUALT PRIVILEGES IN SCHEMA public;
GRANT USAGE, SELECT, UPDATE ON SEQUENCES TO feng_all;
备份与恢复
下面是备份策略选择的流程图:
#mermaid-svg-3c8LLaxsXMjIsMud{font-family:"trebuchet ms",verdana,arial,sans-serif;font-size:16px;fill:#333;}@keyframes edge-animation-frame{from{stroke-dashoffset:0;}}@keyframes dash{to{stroke-dashoffset:0;}}#mermaid-svg-3c8LLaxsXMjIsMud .edge-animation-slow{stroke-dasharray:9,5!important;stroke-dashoffset:900;animation:dash 50s linear infinite;stroke-linecap:round;}#mermaid-svg-3c8LLaxsXMjIsMud .edge-animation-fast{stroke-dasharray:9,5!important;stroke-dashoffset:900;animation:dash 20s linear infinite;stroke-linecap:round;}#mermaid-svg-3c8LLaxsXMjIsMud .error-icon{fill:#552222;}#mermaid-svg-3c8LLaxsXMjIsMud .error-text{fill:#552222;stroke:#552222;}#mermaid-svg-3c8LLaxsXMjIsMud .edge-thickness-normal{stroke-width:1px;}#mermaid-svg-3c8LLaxsXMjIsMud .edge-thickness-thick{stroke-width:3.5px;}#mermaid-svg-3c8LLaxsXMjIsMud .edge-pattern-solid{stroke-dasharray:0;}#mermaid-svg-3c8LLaxsXMjIsMud .edge-thickness-invisible{stroke-width:0;fill:none;}#mermaid-svg-3c8LLaxsXMjIsMud .edge-pattern-dashed{stroke-dasharray:3;}#mermaid-svg-3c8LLaxsXMjIsMud .edge-pattern-dotted{stroke-dasharray:2;}#mermaid-svg-3c8LLaxsXMjIsMud .marker{fill:#333333;stroke:#333333;}#mermaid-svg-3c8LLaxsXMjIsMud .marker.cross{stroke:#333333;}#mermaid-svg-3c8LLaxsXMjIsMud svg{font-family:"trebuchet ms",verdana,arial,sans-serif;font-size:16px;}#mermaid-svg-3c8LLaxsXMjIsMud p{margin:0;}#mermaid-svg-3c8LLaxsXMjIsMud .label{font-family:"trebuchet ms",verdana,arial,sans-serif;color:#333;}#mermaid-svg-3c8LLaxsXMjIsMud .cluster-label text{fill:#333;}#mermaid-svg-3c8LLaxsXMjIsMud .cluster-label span{color:#333;}#mermaid-svg-3c8LLaxsXMjIsMud .cluster-label span p{background-color:transparent;}#mermaid-svg-3c8LLaxsXMjIsMud .label text,#mermaid-svg-3c8LLaxsXMjIsMud span{fill:#333;color:#333;}#mermaid-svg-3c8LLaxsXMjIsMud .node rect,#mermaid-svg-3c8LLaxsXMjIsMud .node circle,#mermaid-svg-3c8LLaxsXMjIsMud .node ellipse,#mermaid-svg-3c8LLaxsXMjIsMud .node polygon,#mermaid-svg-3c8LLaxsXMjIsMud .node path{fill:#ECECFF;stroke:#9370DB;stroke-width:1px;}#mermaid-svg-3c8LLaxsXMjIsMud .rough-node .label text,#mermaid-svg-3c8LLaxsXMjIsMud .node .label text,#mermaid-svg-3c8LLaxsXMjIsMud .image-shape .label,#mermaid-svg-3c8LLaxsXMjIsMud .icon-shape .label{text-anchor:middle;}#mermaid-svg-3c8LLaxsXMjIsMud .node .katex path{fill:#000;stroke:#000;stroke-width:1px;}#mermaid-svg-3c8LLaxsXMjIsMud .rough-node .label,#mermaid-svg-3c8LLaxsXMjIsMud .node .label,#mermaid-svg-3c8LLaxsXMjIsMud .image-shape .label,#mermaid-svg-3c8LLaxsXMjIsMud .icon-shape .label{text-align:center;}#mermaid-svg-3c8LLaxsXMjIsMud .node.clickable{cursor:pointer;}#mermaid-svg-3c8LLaxsXMjIsMud .root .anchor path{fill:#333333!important;stroke-width:0;stroke:#333333;}#mermaid-svg-3c8LLaxsXMjIsMud .arrowheadPath{fill:#333333;}#mermaid-svg-3c8LLaxsXMjIsMud .edgePath .path{stroke:#333333;stroke-width:2.0px;}#mermaid-svg-3c8LLaxsXMjIsMud .flowchart-link{stroke:#333333;fill:none;}#mermaid-svg-3c8LLaxsXMjIsMud .edgeLabel{background-color:rgba(232,232,232, 0.8);text-align:center;}#mermaid-svg-3c8LLaxsXMjIsMud .edgeLabel p{background-color:rgba(232,232,232, 0.8);}#mermaid-svg-3c8LLaxsXMjIsMud .edgeLabel rect{opacity:0.5;background-color:rgba(232,232,232, 0.8);fill:rgba(232,232,232, 0.8);}#mermaid-svg-3c8LLaxsXMjIsMud .labelBkg{background-color:rgba(232, 232, 232, 0.5);}#mermaid-svg-3c8LLaxsXMjIsMud .cluster rect{fill:#ffffde;stroke:#aaaa33;stroke-width:1px;}#mermaid-svg-3c8LLaxsXMjIsMud .cluster text{fill:#333;}#mermaid-svg-3c8LLaxsXMjIsMud .cluster span{color:#333;}#mermaid-svg-3c8LLaxsXMjIsMud div.mermaidTooltip{position:absolute;text-align:center;max-width:200px;padding:2px;font-family:"trebuchet ms",verdana,arial,sans-serif;font-size:12px;background:hsl(80, 100%, 96.2745098039%);border:1px solid #aaaa33;border-radius:2px;pointer-events:none;z-index:100;}#mermaid-svg-3c8LLaxsXMjIsMud .flowchartTitleText{text-anchor:middle;font-size:18px;fill:#333;}#mermaid-svg-3c8LLaxsXMjIsMud rect.text{fill:none;stroke-width:0;}#mermaid-svg-3c8LLaxsXMjIsMud .icon-shape,#mermaid-svg-3c8LLaxsXMjIsMud .image-shape{background-color:rgba(232,232,232, 0.8);text-align:center;}#mermaid-svg-3c8LLaxsXMjIsMud .icon-shape p,#mermaid-svg-3c8LLaxsXMjIsMud .image-shape p{background-color:rgba(232,232,232, 0.8);padding:2px;}#mermaid-svg-3c8LLaxsXMjIsMud .icon-shape .label rect,#mermaid-svg-3c8LLaxsXMjIsMud .image-shape .label rect{opacity:0.5;background-color:rgba(232,232,232, 0.8);fill:rgba(232,232,232, 0.8);}#mermaid-svg-3c8LLaxsXMjIsMud .label-icon{display:inline-block;height:1em;overflow:visible;vertical-align:-0.125em;}#mermaid-svg-3c8LLaxsXMjIsMud .node .label-icon path{fill:currentColor;stroke:revert;stroke-width:revert;}#mermaid-svg-3c8LLaxsXMjIsMud :root{--mermaid-font-family:"trebuchet ms",verdana,arial,sans-serif;} 单个数据库
整个实例
纯文本 SQL
自定义压缩格式
需要备份
备份范围?
pg_dump
pg_dumpall
备份格式?
psql 恢复
pg_restore 恢复
在postgreSQL中,备份主要分为两种:逻辑备份 (导出的SQL文件,易读。跨版本好用)和物理备份(直接拷贝底层文件,快但不易读)
pg_dump单库备份
pg_dump是一个命令行工具,它会把数据库里的表结构、数据、序列、权限等全部变成一段长长的SQL脚本。
打开你电脑的终端(CMD 或 PowerShell),不需要进入 psql。
postgresql
# 格式: pg_dump -U [用户名] -D [数据库名] > [备份文件名.sql]
pg_dump -U postgres -d db > db_XXX.sql
参数说明:
-U:指定用户名(通常用超级用户postgres)-t:只备份某张表(例如:-t cloud_files)-n:只备份某个模式(例如:-n storage)-F:指定格式。另外-Fc会生成自定义二进制压缩格式,体积更小,且支持并行恢复(推荐!)
postgresql
# 备份为验收的二进制格式
pg_dump -U postgres -F c -d db > db_0926.bak
另外,该备份处理的文件大小差距还是很大的
恢复
恢复的方式取决于你备份时的格式。
-
恢复纯文本SQL备份
如果你备份的是
.sql文件,直接用psql运行它即可:postgresql# 格式: psql -U [用户名] -d [目标数据库] < [备份文件] psql -U postgres -d db1 < db_xxx.sql; # 这个库要先创建好 -
恢复二进制备份(pg_restore)
如果你用了
-Fc压缩格式,必须用专属的pg_restore工具:postgresql# -c 代表先清理(删除)旧表再恢复,防止冲突 pg_restore -U postgres -d db2 -c db_0926.bak
pg_dumpall全库备份
如果你想把整个PostgreSQL实例的所有数据库 、所有的用户和权限一次性全部带走,就要用这个:
postgresql
set PGPASSWORD = root # 不然就会导致一个数据库输一次密码
pg_dumpall -U postgres > all_databases_backup.sql

# 格式: psql -U [用户名] -f [备份文件路径] [数据库名]
psql -U postgres -f all_databases_backup.sql postgres
参数说明:
-f:代表file,即制定要运行的SQL脚本文件postgres(最后的参数):这是连接的初始数据库。因为pg_dumpall脚本内部包含了CREATE DATABASE和\c(切换库)的命令,所以你只需要先连上一个默认存在的库(比如postgres),它会自动帮你创建并切换到其他的库。
安全建议
以上就是pgsql的基础知识,关于数据库的安全,需要单独讲一下
- 在云服务器上的数据库,一定不能开发端口,在上面的数据库只能云服务器上的服务本机连
- 一定不要设置弱密码,尽量复杂一点
- 改下云服务器默认的22ssh端口,比如改成10022、11222这些,可以有效的防止端口扫描
- 养成备份的好习惯,最好备份在其他地方
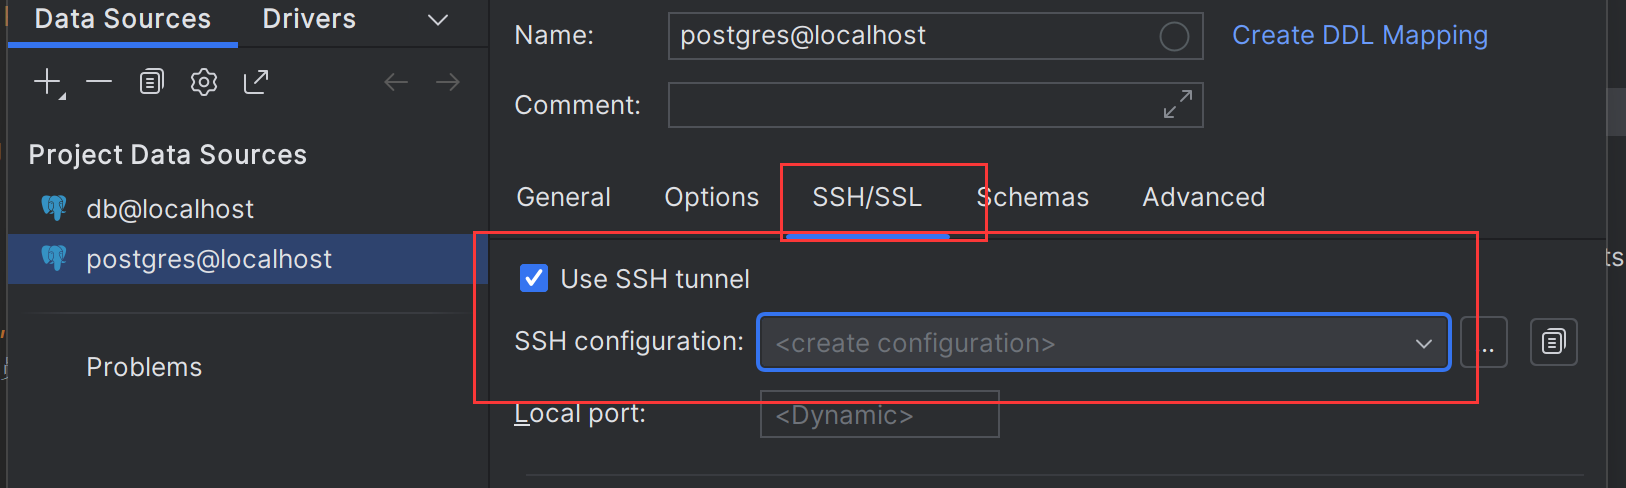
如果你本机想连远程的数据库,可以使用ssh隧道
扩展
全文搜素
查询扩展的相关语句
postgresql
# 查看pgsql一共有哪些扩展
SELECT * FROM pg_available_extensions;

# 查看我安装了哪些扩展
SELECT * FROM pg_extension;
很多时候,你的项目并不需要为了几十万条数据专门去维护一个笨重的 ES 集群。PG 内置的 tsvector 和 tsquery 就能实现专业的全文搜索。
核心原理:
tsvector:将文本分词并转换成"搜素向量"tsquery:你的搜素关键词
基础搜素示例
-- 创建文章表
CREATE TABLE posts (
    id SERIAL PRIMARY KEY,
    title TEXT NOT NULL,
    content TEXT
);

-- 插入一些演示数据(包含英文和中文,方便对比)
INSERT INTO posts (title, content) VALUES
('PostgreSQL Tutorial', 'This is a comprehensive guide to PostgreSQL full-text search.'),
('Go Language Web Framework', 'Learn how to build high-performance web apps with Go and Gin.'),
('枫枫老师的数据库课', 'PostgreSQL 是一款功能强大的开源关系型数据库。'),
('枫枫网盘项目实战', '手把手教你用 Go 语言和 MinIO 实现分布式网盘。');-
中文搜素:默认的PG不支持中文分词,通常我们会安装
zhparser插件。这样它就能像ES一样,把"枫枫网盘项目"切分成"枫枫"、"网盘"、"项目"来进行匹配。 -
why use it?
-
事务一致性:数据更新后,搜索索引立刻生效,不会像ES那样有同步延迟
-
省钱省资源:一个数据库干两份活,,不用额外开内存给 Java 虚拟机(ES)
-
英文全文检索示例
postgresql
-- 场景:搜索包含 "PostgreSQL" 或 "Guide" 的文章
-- 使用 'english' 分词配置
SELECT title, content
FROM posts
WHERE to_tsvector('english', title || ' ' || content) @@ to_tsquery('english','PostgreSQL | Guide');原理说明:
to_tsvector:它会把一段话拆成一个个"词元",并去掉"the"、"is"这种没意义的虚词@@:这是全文搜素的操作符,表示"匹配"&(与)、|(或)、!(非):可以在查询中使用逻辑判断。
预分词:是在查询的时候去分词然后去查询,数据量大的会性能很差,所以正常情况下都是预分词
中文全文检索示例
pgsql默认只支持英文分词,中文分词需要编译扩展,建议直接用对应的docker镜像
dockerfile
# 这里推荐使用社区预集成好的镜像,省去手动编译的痛苦
docker pull zhparser/zhparser:alpine-16
docker run -d --name pg-chinese -p 5432:5432 -e POSTGRES_PASSWORD=root zhparser/zhparser:alpine-16
在库中初始化配置(只需执行一次):
postgresql
CREATE EXTENSION IF NOT EXISTS zhparser;
CREATE TEXT SEARCH CONFIGURATION chinese (PARSER = zhparser);
ALTER TEXT SEARCH CONFIGURATION chinese ADD MAPPING FOR n,v,a,i,e,l WITH simple;
如何检查有没有安装成功
postgresql
SELECT to ('chinese','枫枫老师的GO语音教程');
-- 看看这个能不能正常输出
-- 'go':4 '教程':6 '枫':1,2 '老师':3 '语言':5
分词示例
postgresql
CREATE TABLE posts(
 	id SERIAL PRIMARY KEY,
    title TEXT NOT NULL,
    content TEXT,
    -- 定义一个自动生成的列,专门用于搜素
    -- STORED 关键字表示这个结构会物理存储在硬盘上,而不是查询 时才计算
    searchable_index_col tsvector GENERATED ALWAYS AS (
    	to_tsvector('chinese', title || ' ' || content)
    ) STORED
);

-- 建完表后,紧接着给这个预处理好的列加上GIN索引
CREATE INDEX idx_posts_search ON posts USING GIN (searchable_index_col);

-- 插入时,不需要管 searchable_index_col,数据库会自动生成它
INSERT INTO posts (title, content)
VALUES ('枫枫老师的pgsql视频教程', '这是一门非常有趣的数据库教程');

INSERT INTO posts (title, content)
VALUES ('刘波的mysql教程', '是一门有趣的数据库教程');

-- 查询
SELECT title, searchable_index_col FROM posts;

SELECT title, content
FROM posts
WHERE searchable_index_col @@ to_tsquery('chinese', '枫枫 | 数据库');

SELECT * FROM posts
WHERE searchable_index_col @@ to_tsquery('chinese', 'mysql');
完整示例:从建表到按相关性排序
下面是一个完整的「建表 → 建索引 → 查询 → 排序」流程,可直接复制运行:
postgresql
-- 1. 创建文章表(含自动生成的 tsvector 列)
CREATE TABLE posts (
    id SERIAL PRIMARY KEY,
    title TEXT NOT NULL,
    content TEXT,
    searchable_index_col tsvector GENERATED ALWAYS AS (
        to_tsvector('chinese', title || ' ' || content)
    ) STORED
);

-- 2. 创建 GIN 索引(加速全文检索)
CREATE INDEX idx_posts_search ON posts USING GIN (searchable_index_col);

-- 3. 插入演示数据
INSERT INTO posts (title, content) VALUES
('枫枫老师的pgsql视频教程', '这是一门非常有趣的数据库教程,深入浅出。'),
('刘波的mysql教程', '是一门有趣的数据库教程,适合入门。'),
('PostgreSQL 全文搜索实战', '本文介绍如何使用 tsvector 和 tsquery 实现高效检索。'),
('Go 语言 Web 开发', '使用 Go 和 Gin 构建高性能的 Web 应用。');

-- 4. 执行 to_tsquery 查询(支持 & 与、| 或、! 非)
SELECT title, content
FROM posts
WHERE searchable_index_col @@ to_tsquery('chinese', '数据库 & 教程');

-- 5. 按相关性排序(ts_rank 计算匹配度,越高越相关)
SELECT
    title,
    ts_rank(searchable_index_col, to_tsquery('chinese', '数据库 | 教程')) AS relevance
FROM posts
WHERE searchable_index_col @@ to_tsquery('chinese', '数据库 | 教程')
ORDER BY relevance DESC;
全文搜索 vs LIKE 模糊查询:性能对比
LIKE '%关键词%' 无法利用普通 B-Tree 索引,必须全表扫描;而全文搜索配合 GIN 索引,可以走索引快速定位。下面用 EXPLAIN ANALYZE 直观对比:
postgresql
-- 准备 10 万条测试数据
INSERT INTO posts (title, content)
SELECT
    '文章标题_' || i,
    '这是一段用于测试全文搜索性能的正文内容,包含数据库、教程、PostgreSQL 等关键词。'
FROM generate_series(1, 100000) AS i;

-- 方式一:LIKE 模糊查询(全表扫描,慢)
EXPLAIN ANALYZE
SELECT * FROM posts
WHERE title LIKE '%数据库%' OR content LIKE '%数据库%';

-- 方式二:全文搜索(走 GIN 索引,快)
EXPLAIN ANALYZE
SELECT * FROM posts
WHERE searchable_index_col @@ to_tsquery('chinese', '数据库');对比结论:
| 对比项 | LIKE 模糊查询 | 全文搜索(tsvector + GIN) |
|---|---|---|
| 索引利用 | 无法利用普通索引,全表扫描 | 走 GIN 索引,快速定位 |
| 大数据量性能 | 数据量越大越慢(O(n)) | 基本不受数据量影响(O(log n)) |
| 相关性排序 | 不支持 | 支持 ts_rank 按匹配度排序 |
| 分词能力 | 无,只能整串匹配 | 支持中文分词(zhparser) |
| 逻辑组合 | 需手写多个 OR/AND |
原生支持 &、` |
经验之谈 :当数据量在几千条以内,
LIKE和全文搜索的差距不明显;一旦数据量达到十万、百万级,全文搜索的优势会呈指数级放大。如果你的业务需要「搜索 + 排序 + 高并发」,强烈建议直接用 PG 内置的全文搜索,而不是引入 ES 集群。
PostgreSQL 地理位置:PostGIS 与 earthdistance 详解
在地理信息系统(GIS)领域,PostgreSQL的PostGIS插件时绝对的行业霸主
但是pgsql里面没有,我们可以用自带的earthdistance
postgresql
CREATE EXTENSION cube; -- earthdistance 依赖它
CREATE EXTENSION earthdistance;
postgresql
-- 计算 (经度1, 纬度1) 到 (经度2, 纬度2) 的距离
SELECT earth_distance(
	ll_to_earth(23.45, 113.12),
	ll_to_earth(23.50, 113.15)
) AS distance_meters;
示例
postgresql
CREATE TABLE file_location(
	id SERIAL PRIMARY kEY,
	file_name TEXT NOT NULL,
	lng DOUBLE PRECISION, -- 经度
	lat DOUBLE PRECISION, -- 纬度
);

-- 插入一些演示数据(以长沙市几个坐标为例)
INSERT INTO file_locations (file_name, lng, lat) VALUES
('项目文档.pdf', 112.937, 28.228),    -- 岳麓山附近
('假期照片.zip', 112.971, 28.191),    -- 五一广场附近
('代码备份.tar.gz', 113.007, 28.224); -- 长沙火车站附近
可以用百度地图的坐标拾取系统
https://lbs.baidu.com/maptool/getpoint
计算两点间的距离
假设你当前的位置是(112.94, 28.23),我们要看看这些文件离你有多远。
postgresql
-- earth_distance 函数返回的结果单位是"米"
SELECT
	file_name,
	earth_distance(
		ll_to_earth(28.23, 112.94), -- 当前位置 (纬度, 经度)
        ll_to_earth(lat, lng)       -- 目标位置 (纬度, 经度)
	) AS distance_meters
FROM file_location;
查找 5 公里范围内的文件
postgresql
-- 搜索 5000 米范围内的文件,并按距离从近到远排序
SELECT
	file_name,
	earth_distance(ll_to_earth(28.23, 112.94), ll_to_earth(lat, lng)) / 1000 AS distance_km
FROM file_location
WHERE earth_box(ll_to_earth(28.23, 112.94), 5000) @> ll_to_earth(lat, lng)
ORDER BY distance_km ASC;如果说earthdistance是只能算距离的"皮尺",那么PostGIS 就是一套完整的"卫星测绘系统"。
它最特别的地方在于,它让数据库真正理解了空间几何关系,而不仅仅是存两个数字(经纬度)。
PostGIS 的四大核心"超能力"
丰富的空间几何类型
除了"点"(Point),它还支持复杂的图形:
- 线(LineString):比如存储一段航线、公路
- 面(Polygon):比如存储一个学校、一个行政区、甚至是一个不规则的湖泊
- 集合(Multi-Geometry):比他存储由多个岛屿组成的群岛
强大的空间关系判断
这是PostGIS最牛的地方,不仅仅是距离,它还可以回答各种复杂的逻辑问题:
- 包含关系(ST_Contains):这个文件上传的左边,是在"北京市"这个多边形范围内吗?
- 相交/重叠(ST_Intersects):这两条航线是否由交叉点
- 接触(ST_Touches):这两个地块是紧邻吗
几何计算与加工
它能在数据库里直接生成新的图形:
- 缓冲区(ST_Buffer):以这条公里为中心,左右扩展500米,生成一个"拆迁补偿区"的多边形
- 合并/差异(ST_Union/ST_Difference):把两个相邻的校区合并成一个大校区,或者算出两个地块重叠的部分
坐标系转换
解决"地图偏移"神器,地图界有个很头疼的问题:GPS 坐标(WGS84)、高德/腾讯坐标(GCJ-02)、百度坐标(BD-09)是有偏移的。
- PostGIS 内置了全球几千种坐标系(SRID)
- 它可以一行代码完成转换:
ST_Transform(geometry, 4326)
PostgreSQL 向量数据库:pgvector 与 RAG 应用
由于插件pgvector的存在,它以及成为目前**RAG(检索增强生成)**架构中最主流的选择之一。也不需要为了向量检索专门去买 Pinecone 或 Milvus,用 PG 就能实现"一库多用"。
dockerfile
docker pull pgvector/pgvector:pg16

docker run -d  --name pg-vector  -e POSTGRES_PASSWORD=root -p 15432:5432  pgvector/pgvector:pg16
示例
postgresql
-- 1. 开启扩展
CREATE EXTENSION IF NOT EXISTS vector;

-- 2. 验证:尝试创建一个三维向量字段
CREATE TABLE test_vector(
	id serial PRIMARY KEY,
	embedding vector(3)
);

-- 3. 插入一个向量数据
INSERT INTO test_vector (embedding) VALUES ('[1, 2, 3]'), ('[4, 5, 6]');

-- 4. 计算余弦值相似度擦查询
SELECT
	id, embedding, 1 - (embedding <=> '[0,2,1]') AS similarity_score
FROM test_vector
ORDER BY similarity_score DESC;-- 相似度越高,排在越前面
三大核心操作符
| 操作符 | 计算方式 | 使用场景 |
|---|---|---|
<=> |
余弦距离(Cosine) | RAG常用。只关注方向,不关注长度(适合文本语义匹配) |
<-> |
L2距离(欧氏距离) | 适合图像检索或需要考虑数值绝对大小的场景 |
<#> |
内积(Inner Product) | 适合推荐系统,或者Embedding 已经过归一化的场景 |
etry):比他存储由多个岛屿组成的群岛
强大的空间关系判断
这是PostGIS最牛的地方,不仅仅是距离,它还可以回答各种复杂的逻辑问题:
- 包含关系(ST_Contains):这个文件上传的左边,是在"北京市"这个多边形范围内吗?
- 相交/重叠(ST_Intersects):这两条航线是否由交叉点
- 接触(ST_Touches):这两个地块是紧邻吗
几何计算与加工
它能在数据库里直接生成新的图形:
- 缓冲区(ST_Buffer):以这条公里为中心,左右扩展500米,生成一个"拆迁补偿区"的多边形
- 合并/差异(ST_Union/ST_Difference):把两个相邻的校区合并成一个大校区,或者算出两个地块重叠的部分
坐标系转换
解决"地图偏移"神器,地图界有个很头疼的问题:GPS 坐标(WGS84)、高德/腾讯坐标(GCJ-02)、百度坐标(BD-09)是有偏移的。
- PostGIS 内置了全球几千种坐标系(SRID)
- 它可以一行代码完成转换:
ST_Transform(geometry, 4326)
向量数据库
由于插件pgvector的存在,它以及成为目前**RAG(检索增强生成)**架构中最主流的选择之一。也不需要为了向量检索专门去买 Pinecone 或 Milvus,用 PG 就能实现"一库多用"。
dockerfile
docker pull pgvector/pgvector:pg16

docker run -d  --name pg-vector  -e POSTGRES_PASSWORD=root -p 15432:5432  pgvector/pgvector:pg16
示例
postgresql
-- 1. 开启扩展
CREATE EXTENSION IF NOT EXISTS vector;

-- 2. 验证:尝试创建一个三维向量字段
CREATE TABLE test_vector(
	id serial PRIMARY KEY,
	embedding vector(3)
);

-- 3. 插入一个向量数据
INSERT INTO test_vector (embedding) VALUES ('[1, 2, 3]'), ('[4, 5, 6]');

-- 4. 计算余弦值相似度擦查询
SELECT
	id, embedding, 1 - (embedding <=> '[0,2,1]') AS similarity_score
FROM test_vector
ORDER BY similarity_score DESC;-- 相似度越高,排在越前面
三大核心操作符
| 操作符 | 计算方式 | 使用场景 |
|---|---|---|
<=> |
余弦距离(Cosine) | RAG常用。只关注方向,不关注长度(适合文本语义匹配) |
<-> |
L2距离(欧氏距离) | 适合图像检索或需要考虑数值绝对大小的场景 |
<#> |
内积(Inner Product) | 适合推荐系统,或者Embedding 已经过归一化的场景 |
常见问题(FAQ)
PostgreSQL 和 MySQL 有什么区别?
PostgreSQL 在数据类型(JSONB、数组、范围类型)、模式(Schema)管理、全文搜索、地理位置(PostGIS)和向量检索(pgvector)方面更为强大;MySQL 则在简单场景下更易上手,生态成熟。对于复杂查询、高并发写入和需要扩展能力的场景,PostgreSQL 更具优势。
PostgreSQL 支持中文全文搜索吗?
原生不支持,需要安装 zhparser 扩展。本文提供了完整的 Docker 镜像方案和配置步骤,详见「全文搜索」章节。
PostgreSQL 如何实现地理位置查询?
可以使用内置的 earthdistance 扩展计算两点距离,或安装 PostGIS 实现复杂的空间关系判断(包含、相交、缓冲区等)。详见「地理位置」章节。
PostgreSQL 能替代 Elasticsearch 做搜索吗?
对于几十万条数据的中小规模场景,PostgreSQL 内置的全文搜索(tsvector + GIN 索引)完全够用,且无需额外维护 ES 集群。数据量达到百万级以上或需要复杂聚合分析时,才建议引入 ES。
PostgreSQL 支持向量检索吗?
支持。通过 pgvector 扩展,PostgreSQL 可以实现余弦距离、欧氏距离和内积三种向量检索,是 RAG 架构的主流选择之一。
如何从 MySQL 迁移到 PostgreSQL?
核心步骤:1)使用 pgloader 或手动导出/导入数据;2)调整数据类型(如 MySQL 的 AUTO_INCREMENT 改为 GENERATED BY DEFAULT AS IDENTITY);3)注意 SQL 语法差异(如 LIMIT 与 OFFSET 用法相同,但字符串函数不同);4)利用本文的 Schema 设计优化表结构。
参考链接
本文内容整理自枫枫知道平台的专题文章,原文出处:https://www.fengfengzhidao.com/special/12/123,欢迎前往查看更详细的讲解与配套资源。
常见错误与排查
新手在使用 PostgreSQL 时,最容易踩的坑往往集中在字段引用、类型转换、约束冲突和并发控制上。下面列出 5 个高频错误,每个都给出错误信息示例、原因分析和解决方案,并附上可直接运行的修正 SQL。
错误 1:字段不存在(column does not exist)
错误信息示例
text
ERROR:  column "created_id" does not exist
LINE 1: SELECT file_name, file_size, created_id FROM files;
原因分析
写 SQL 时把字段名拼错了,或者记错了表结构。比如把 created_at 写成 created_id,PostgreSQL 对列名是大小写敏感的(未加引号时会被折叠为小写),一旦拼写不一致就会直接报错。
解决方案
先用 \d 表名 或查询 information_schema.columns 确认真实的字段名,再修正 SQL。
postgresql
-- 1. 查看表结构,确认字段名
\d files

-- 2. 修正后的查询
SELECT file_name, file_size, created_at FROM files;
错误 2:类型不匹配(column is of type but expression is of type)
错误信息示例
text
ERROR:  column "file_size" is of type bigint but expression is of type text
LINE 1: INSERT INTO files (file_name, file_size) VALUES ('demo.mp4', '1024');
原因分析
插入或比较时,传入的数据类型与列定义不一致。比如 file_size 是 BIGINT,却传入了字符串 '1024';或者把字符串和整数直接比较。PostgreSQL 的类型系统比 MySQL 严格,不会自动做隐式转换。
解决方案
使用正确的字面量,或显式用 ::type 做类型转换。
postgresql
-- 1. 修正:数字不要加引号
INSERT INTO files (file_name, file_size) VALUES ('demo.mp4', 1024);

-- 2. 如果确实需要转换,用 :: 显式转换
SELECT * FROM files WHERE file_size = '1024'::bigint;
错误 3:外键约束失败(foreign key constraint failed)
错误信息示例
text
ERROR:  insert or update on table "user_profiles" violates foreign key constraint "fk_user"
DETAIL:  Key (user_id)=(99) is not present in table "users".
原因分析
往子表插入数据时,外键指向的主表里并不存在对应的主键记录。常见于:先插子表后插主表、主表数据被删除、或 user_id 传错。
解决方案
先确认主表里存在对应的记录,再插入子表;或者调整插入顺序。
postgresql
-- 1. 先插入主表,拿到自增 ID
INSERT INTO users (username) VALUES ('fengfeng') RETURNING id;

-- 2. 再用返回的 ID 插入子表
INSERT INTO user_profiles (user_id, avatar_url, bio)
VALUES (1, 'https://example.com/avatar.png', '技术教育者');

-- 3. 排查:查看主表里到底有哪些 ID
SELECT id FROM users;
错误 4:死锁(deadlock detected)
错误信息示例
text
ERROR:  deadlock detected
DETAIL:  Process 1234 waits for ShareLock on transaction 5678; blocked by process 5678.
原因分析
两个事务各自持有一把锁,又都在等待对方释放锁,形成循环等待。比如事务 A 先更新 files 再更新 users,事务 B 先更新 users 再更新 files,两者就会互相卡死。
解决方案
让所有事务按相同的顺序访问资源;同时把事务尽量缩短,减少锁持有时间。
postgresql
-- 1. 统一加锁顺序:先 users 后 files(两个事务都按这个顺序)
BEGIN;
UPDATE users SET username = 'fengfeng' WHERE id = 1;
UPDATE files SET download_count = download_count + 1 WHERE file_id = '某UUID';
COMMIT;

-- 2. 排查当前是否有锁等待
SELECT pid, state, query FROM pg_stat_activity WHERE state = 'active';
错误 5:权限不足(permission denied)
错误信息示例
text
ERROR: permission denied for table files原因分析
当前用户没有对目标表(或模式、数据库)的相应权限。常见于:用普通用户登录却想操作 public 模式下的表,而该用户只被授予了 CONNECT 权限。
解决方案
用超级管理员给用户授予对应权限,或改用有权限的账号。
postgresql
-- 1. 授予只读权限
GRANT CONNECT ON DATABASE db TO reader_user;
GRANT USAGE ON SCHEMA public TO reader_user;
GRANT SELECT ON ALL TABLES IN SCHEMA public TO reader_user;

-- 2. 授予增删改查权限
GRANT SELECT, INSERT, UPDATE, DELETE ON ALL TABLES IN SCHEMA public TO feng_all;

-- 3. 别忘了序列权限,否则自增 ID 无法插入
GRANT USAGE, SELECT ON ALL SEQUENCES IN SCHEMA public TO feng_all;
小结 :这 5 个错误覆盖了 PostgreSQL 新手最常遇到的字段引用、类型转换、约束、并发和权限问题。遇到报错时,先读错误信息里的
DETAIL和LINE提示,再对照上面的方案排查,基本都能快速定位。
参考链接
- 本文内容整理自枫枫知道平台的专题文章,原文出处:https://www.fengfengzhidao.com/special/12/123
- PostgreSQL 官方文档:https://www.postgresql.org/docs/
- PostgreSQL 中文社区:http://www.postgres.cn/
- PostGIS 官方文档:https://postgis.net/documentation/
- pgvector 项目主页:https://github.com/pgvector/pgvector
跑通 CRUD 和查询
- 性能调优:使用
EXPLAIN ANALYZE分析你的慢查询,尝试创建合适的索引 - 深入扩展:尝试用
zhparser实现中文全文搜索,或用pgvector搭建一个简单的 RAG 应用 - 迁移实战:将一个小型 MySQL 项目迁移到 PostgreSQL,体会两者的差异