写在前面 :本文来自真实项目实战------这套骨架已在真实项目中落地,承担「调远程接口 → 生成 HTML 报告」的实际需求。下文把它抽象成通用形态来讲,剥离了业务细节,但每一处设计取舍都对应实战中踩过的坑。
定位:通用骨架 拆解------只讲这套骨架是怎么搭起来的、各层权责如何切分、如何复用到新场景;不绑定任何具体业务。
0. 一句话结论
这套骨架只做一件事------「调远程接口 → 按模版生成静态 HTML 报告」,骨架本体由四层构成(另加用户请求与产物交付两端上下文,见第 2 章):
- 入口层
SKILL.md:只做前置检查 + 路由 + 公共约定,不承载任何执行细节; - 能力层
scripts/:零 npm 依赖的 CLI + 代理 + 端点声明,把「怎么调接口」固化成可复用设施; - 呈现层
references/:视觉壳、视觉规范、图表模版、环境预检四件公共资产; - 子技能层
modules/:每个业务能力一个目录(复杂能力 =index.md+ 若干按功能命名的子文件,简单能力可为单文件),入口只编排、细节下沉。
其设计内核只有两句话:「可复用设施下沉、跨技能约定上提、业务细节留在子技能层」与「每个结论只有一个权威出处」。
1. 它要解决什么问题
1.1 一个很常见的场景
你说:「帮我调几个接口,出一份带数据的 HTML 报告。」
AI 照做了。然后你依次收到四个惊喜:
- 它猜了一个接口地址 ------ 跑不通,而你看不出是地址错、参数错还是没权限;
- 换台机器直接报错 ------ 环境里没有
node_modules; - 报告出来了,可和上次长得完全不一样 ------ 配色、类名、排版全漂了;
- 数字看着挺像样,但你分不清哪个来自接口、哪个是它编的;离线打开图表还是空白一片。
这不是模型能力问题,而是缺一层「设施」:取数、校验、呈现、落盘这几件事,全被交给了模型的即兴发挥。
1.2 四个坑
| 坑 | 现象 | 骨架的应对 |
|---|---|---|
| 能力不可控 | AI 直接 fetch 一个 URL,参数拼错、路径猜错、超时挂死,无从排查 |
把接口调用收进 CLI :--list 可知有哪些端点、--describe 可查参数表、调用有参数校验 |
| 环境不可控 | 沙箱/别的机器没有 node_modules,脚本一跑就 MODULE_NOT_FOUND |
零 npm 依赖 :只用 Node ≥ 18 内置的 fetch / AbortController |
| 样式不可控 | 每次生成的报告版式、配色、类名都不一样,视觉漂移 | 把壳抽成唯一权威,子技能只准引用、不准自造 |
| 数值不可信 | AI 用示例数字凑版面,或运行时请求接口导致离线打不开 | 双层信封校验 + 数据内嵌,产物自包含、可离线打开 |
1.3 这套方案能解决什么
| 你遇到的事 | 它给出的机制 | 你得到什么 |
|---|---|---|
| 「这接口到底怎么调、有哪些参数」 | 端点声明成表 :--list 列端点、--describe 给参数表 |
取数从猜 变成查表;未知端点、必填缺失当场拦下 |
| 「换台机器就跑不起来」 | 零 npm 依赖 + Node ≥ 18 前置检查 + 冒烟 | 环境问题在第一步暴露,而不是中途崩 |
| 「这次是对的还是蒙的」 | 双层信封 :CLI 层 ok + 业务层 code,两者都过才算成功 |
成功/失败有唯一判据;失败原因分门别类,不盲目重试 |
| 「报告长什么样全看运气」 | 壳、图表、内容三权分立,各自只有一个权威 | 视觉不漂移;改样式只改一处 |
| 「数从哪来、对不对」 | 数据单一落点内嵌 + 对账关系 + 产物离线可打开 | 数字可追溯、可核查;改数只改一处 |
| 「想加个新能力」 | 入口加一行路由 + 新建子技能目录(端点同理,加一行声明) | 扩展不动老代码,也不污染既有文档 |
| 「AI 到底干了啥」 | 流程被切成「读文档 → 查表调用 → 按模版组装」 | 每一步都有可检查的中间产物(JSON 信封、拼接产物),行为可复盘 |
一句话:这套骨架不是为了「让 AI 写得更快」,而是为了让 AI 写出来的东西「可核查、可复现、可离线」。
1.4 它不解决什么(先说边界)
先把话说清楚,省得误会:
- 不提供数据源:它只解决「怎么调、怎么用」,数据来自你接入的接口;接口没有的字段,它不会变出来;
- 不保证上游正确:上游返回什么就是什么(连非 2xx 都不改语义),业务层是否成功要自己判(这正是双层信封第二层的职责);
- 不替代业务判断 :报告只能基于返回字段做客观归纳,不输出投资建议之类的结论;
- 不是通用报表引擎 :没有多数据源聚合、没有权限体系、没有定时调度------它就是一个「取数 → 渲染」的薄骨架,薄是刻意设计。
2. 分层总览
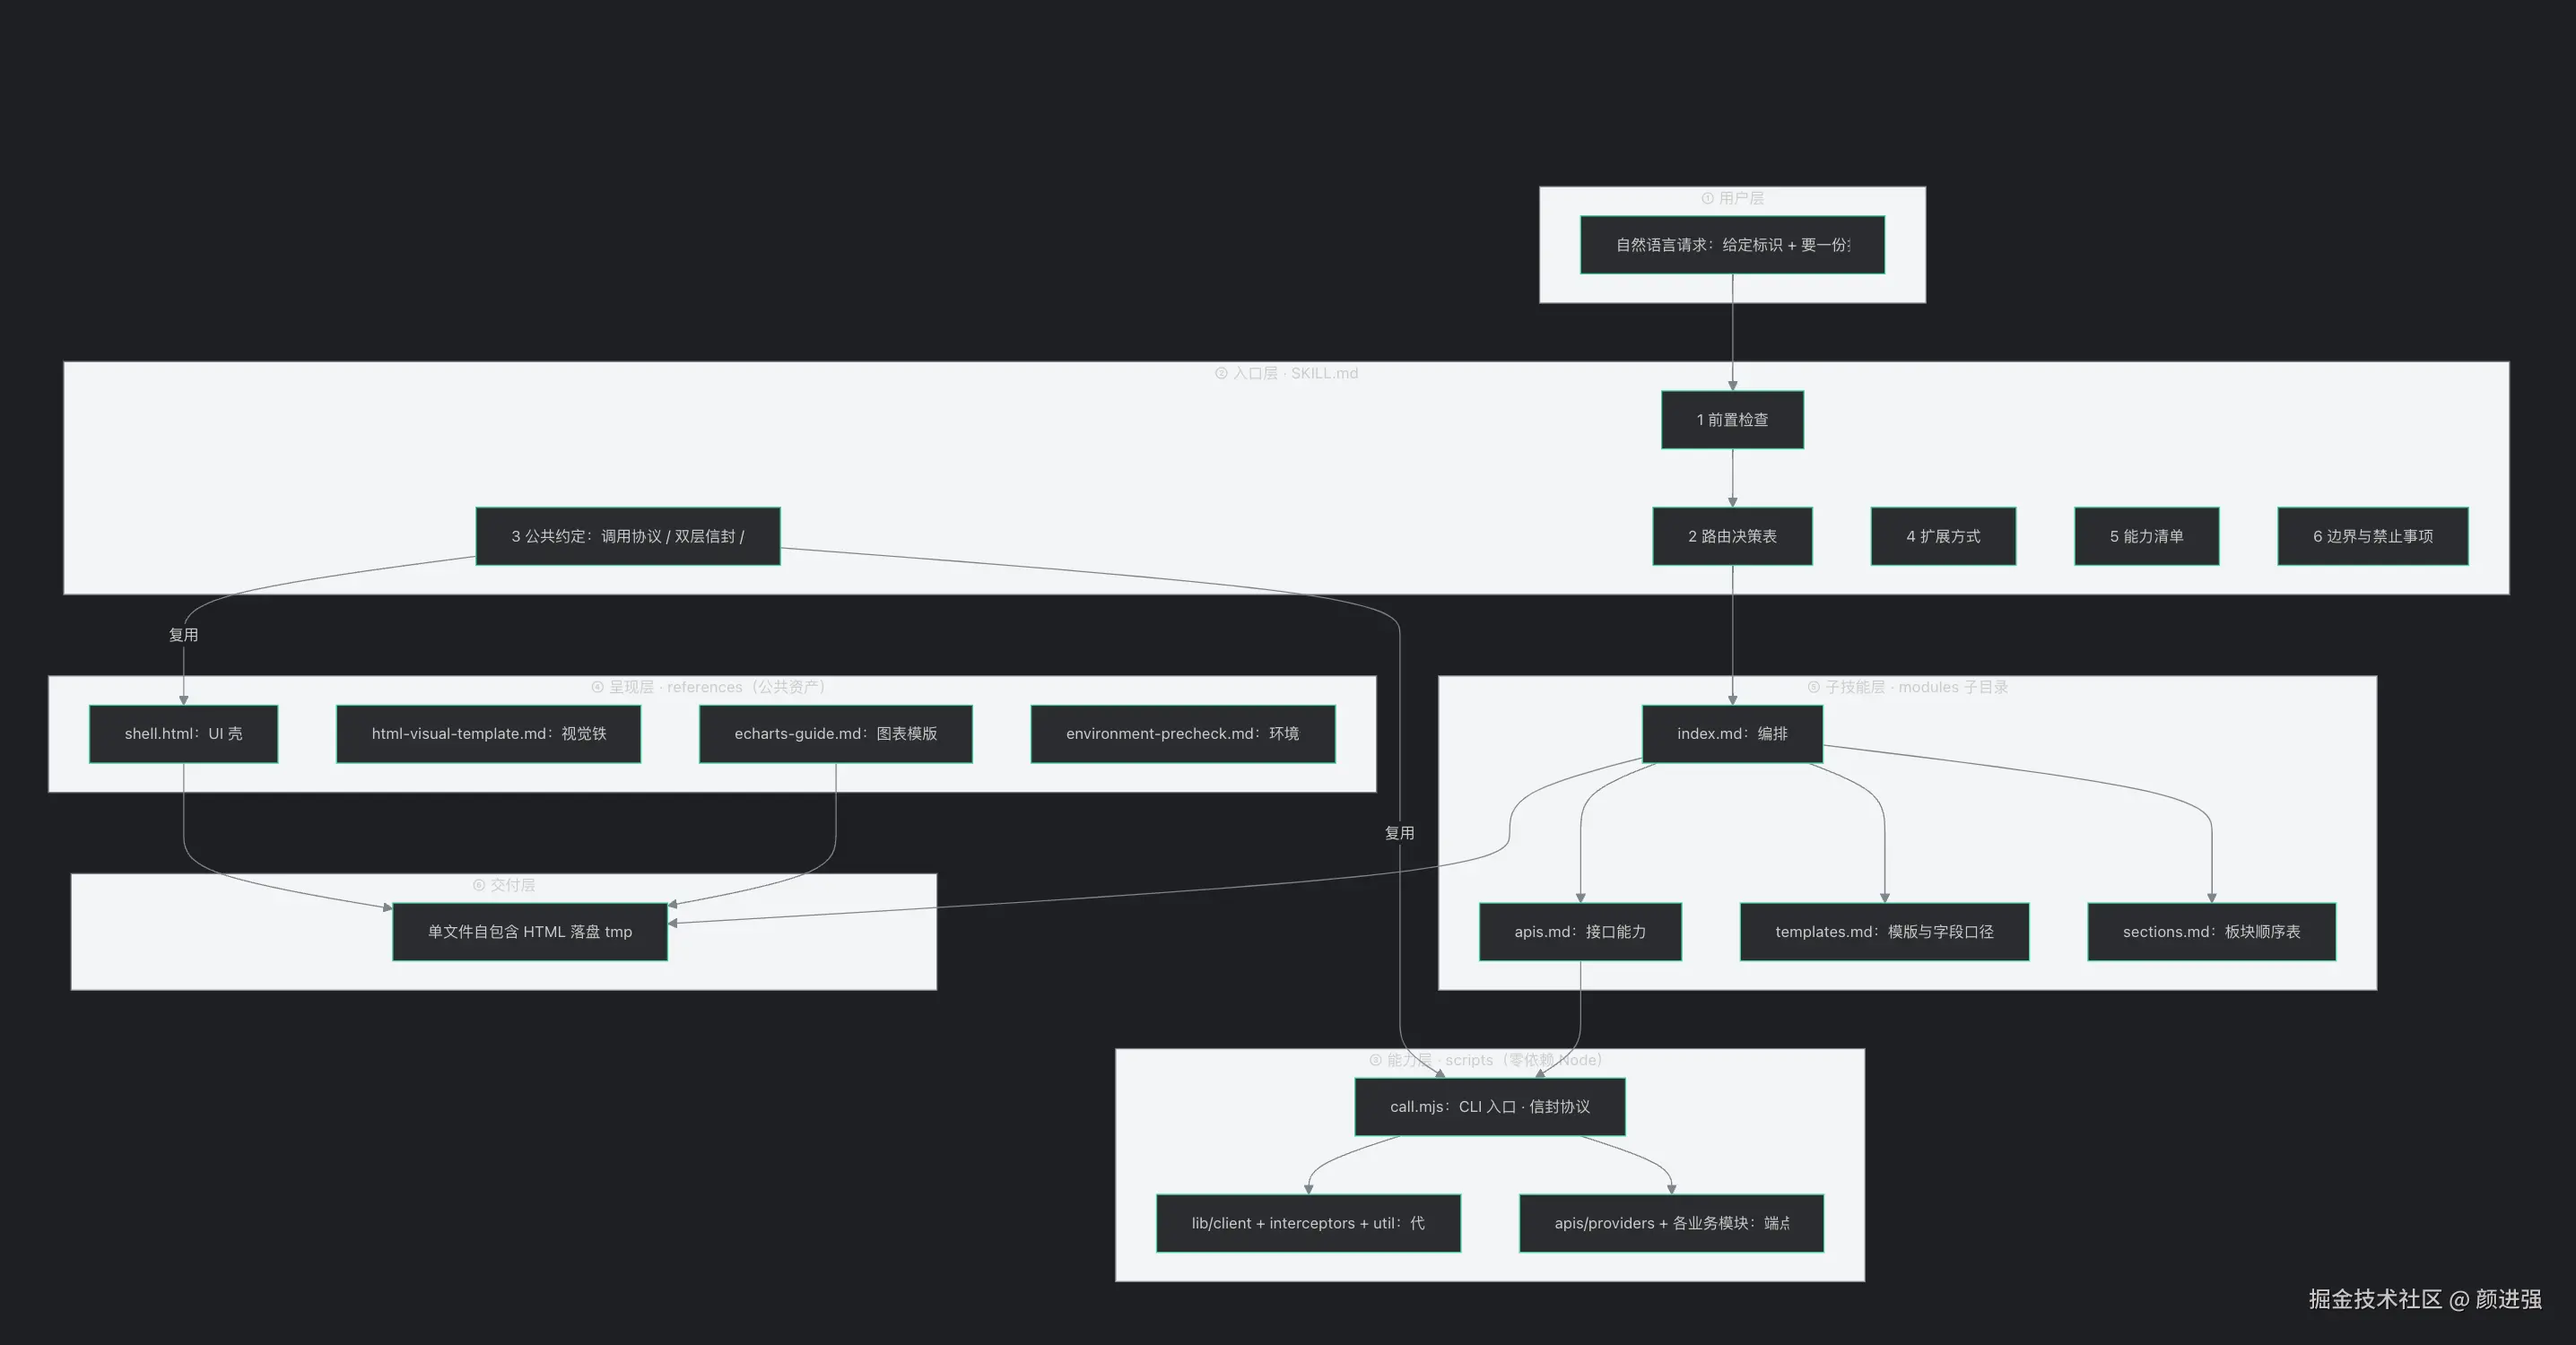
读图要点 :图中 ①用户层 与 ⑥交付层 是骨架的上下游上下文,骨架本体即 ②入口层 / ③能力层 / ④呈现层 / ⑤子技能层四层 (对应第 3--6 章)。SKILL.md 不直接产出任何东西,它只负责「把人送进门 + 把公共资产指出来」;真正的执行发生在子技能层,而子技能又把「取数」外包给能力层、「长什么样」外包给呈现层。
3. 入口层:SKILL.md 的六节结构
入口文档刻意写得很薄,六节各司其职:
| 节 | 职责 | 关键设计 |
|---|---|---|
| 1 前置检查 | Node 是否安装 / 版本 ≥ 18 / 冒烟 | 指向 references/environment-precheck.md,不内联细节 |
| 2 路由决策表 | 用户意图 → 目标子技能文档 | 只有一张表,加一行即新增路由 |
| 3 公共约定 | 调用协议 / 双层信封判定 / 视觉壳 / 产物落盘 | 跨子技能复用、写死,子技能不重复定义 |
| 4 扩展方式 | 新增能力的两步法 | 明确两种子技能形态、命名规则与禁用项 |
| 5 能力清单 | 子技能 → 能力 → 依赖端点 → 产物 | 一屏看清「现在有什么」 |
| 6 边界与禁止事项 | 4 条红线 | 不调远程 Skill、未读文档不得出 HTML、数值须 100% 来自接口、不得改 scripts/ 的公共设施(lib/ / call.mjs / apis/providers.mjs) |
这里最值得抄的一条是 「公共约定」这一节的定位 :任何跨子技能重复出现 的规则,都必须上提到入口层,子技能里只能引用 ,不能复述。理由很实际------一旦同一句话出现在两个文件里,改一处漏一处就是必然。
入口层的「扩展方式」那一节,是这套骨架可复用性最强的地方------加能力只加文件,不改老文件:
text
新增一项能力 = 两步:
1. 在路由决策表加一行(用户意图 → 目标文档);
2. 新建子技能:
   - 简单能力 → 单文件 modules/<名>.md
   - 复杂能力 → 文件夹 modules/<名>/index.md(入口名固定),
     细节再下沉为 apis.md / templates.md / sections.md 等子文件
⚠️ 两种形态都适用:子文件不得命名为 SKILL.md,否则会被识别成独立顶层 skill
4. 能力层:scripts/ ------ 零依赖的「axios 平替」
4.1 目录结构
ruby
scripts/
├── call.mjs                 # CLI 入口:参数解析 / 参数校验 / 信封输出
├── lib/
│   ├── client.mjs           # 代理层:create() + 请求调度 + 超时
│   ├── interceptors.mjs     # 拦截器管理(对齐 axios 遍历顺序)
│   └── util.mjs             # 纯函数:argv / URL / header / 参数校验
└── apis/
    ├── providers.mjs        # 提供方连接配置(baseURL / timeout / headers)
    ├── <module>.mjs         # 业务模块端点声明(method / path / summary / body)
    └── index.mjs            # 两级组装 → ENDPOINT_MAP
4.2 两个关键决策
决策一:不用真 axios。
沙箱环境没有 node_modules,import axios from 'axios' 必然 MODULE_NOT_FOUND。于是用 Node ≥ 18 内置 fetch + AbortController 复刻 axios 的心智模型 ------create(config) / 实例方法 / interceptors.request|response.use() / timeout / baseURL / params / data 一个不少,但零依赖。
js
// lib/client.mjs 节选:复刻 axios 的 Promise 链编排
function request(config) {
    const merged = mergeConfig(defaults, config);
    let chain = Promise.resolve(merged);

    // 请求拦截器可改写 config,后注册的先执行(对齐 axios)
    interceptors.request.forEachReverse(({ onFulfilled, onRejected }) => {
        chain = chain.then(onFulfilled, onRejected);
    });

    chain = chain.then((resolvedConfig) => dispatchRequest(resolvedConfig));

    // 响应拦截器可改写 response,先注册的先执行(对齐 axios)
    interceptors.response.forEach(({ onFulfilled, onRejected }) => {
        chain = chain.then(onFulfilled, onRejected);
    });

    return chain;
}
超时靠 AbortController 补上------fetch 没有原生 timeout 选项:
js
// lib/client.mjs 节选
const controller = new AbortController();
if (config.timeout != null && config.timeout > 0) {
    timer = setTimeout(() => controller.abort(), config.timeout);
}
决策二:统一 .mjs。
.js 下用 export 依赖 Node ≥ 22 的语法探测,Node 18 会直接 SyntaxError;.mjs 则任何 18+ 都按 ESM 解析 。为了「跨环境一次写对」,全目录统一 .mjs。
4.3 响应不做加工(反直觉但关键)
很多 HTTP 封装会「帮」你判定状态码、包装错误。这套骨架刻意不做:
js
// lib/client.mjs 节选
try {
    const res = await fetch(url, { method, headers, body, signal: controller.signal, redirect: 'follow' });
    // 不做状态码判定、不包装错误:非 2xx 原样返回,fetch 抛出的异常直接冒泡
    return {
        data: await parseBody(res, config.responseType),
        status: res.status,
        statusText: res.statusText,
        headers: normalizeHeaders(res.headers),
        config,
        request: { url, method },
    };
} finally {
    if (timer) clearTimeout(timer);
}好处是调用方拿到的东西 = 上游返回的东西 ,没有任何中间层篡改语义。代价是调用方要自己判断「成功与否」------这个责任被交给了下一节的双层信封。
4.4 端点声明:两级组装
端点不是硬编码在 CLI 里的,而是两级声明、一次组装:
js
// apis/providers.mjs ------ 只描述「连哪里、怎么连」,不含业务语义
export default {
    exampleApi: {
        baseURL: 'https://api.example.com',   // 默认指向的生产环境;切换环境用 --base-url 覆盖
        timeout: 15000,
        headers: { accept: 'application/json' },
    },
};
js
// apis/<module>.mjs ------ 业务模块端点表,通过 provider 字段引用提供方
export default {
    module: 'example',
    provider: 'exampleApi',
    endpoints: {
        someEndpoint: {
            method: 'POST',
            path: '/v1/<module>/<action>',
            summary: '<一句话说明用途>',
            body: {
                itemId:     { type: 'string', required: true,  desc: '业务标识,如 600000' },
                extraFlags: { type: 'array',  required: false, desc: '附加返回项,逗号分隔' },
            },
        },
        // 新增端点 = 在此加一条
    },
};
apis/index.mjs 把两者拼成索引,供 CLI 查表:
js
const ENDPOINT_MAP = new Map();
for (const mod of MODULES) {
    const defaults = providers[mod.provider];
    if (!defaults) {
        throw new Error(`模块 ${mod.module} 引用了未声明的 provider: ${mod.provider}`);
    }
    for (const [endpoint, def] of Object.entries(mod.endpoints || {})) {
        ENDPOINT_MAP.set(`${mod.module}.${endpoint}`, { module: mod.module, endpoint, def, defaults });
    }
}
这样分层的收益 :新增业务模块 → 建一个 <module>.mjs 并加进 MODULES,baseURL 不用重写;新增提供方 → providers.mjs 加一条,已有模块可复用。端点 ID 形如 <module>.<endpoint>,命名空间天然隔离。
4.5 CLI:单段 JSON 信封协议
call.mjs 对外只有四种用法:
bash
node scripts/call.mjs --list                                 # 列出全部端点
node scripts/call.mjs --describe <module>.<endpoint>         # 查看端点参数表
node scripts/call.mjs <module>.<endpoint> [--param k=v ...]  # 调用
node scripts/call.mjs <module>.<endpoint> --json '{...}' # 用 JSON 传参(覆盖同名 --param)输出协议(这是与使用方约定的契约):
- stdout 恒为单段 JSON ,信封形状
{ ok, message, ...payload }; ok: true成功、ok: false失败,失败原因只在message;- 诊断信息(耗时、堆栈)一律走 stderr ,保证 stdout 可被稳定
JSON.parse; - 进程退出码恒为 0 ,不承载语义------语义已全放信封
ok+message,stdout 只要保持「一段可稳定JSON.parse的 JSON」即可,无需再借退出码分流(早期版本曾用0/1/2/4/5编码退出码,后整体废弃,见第 8 章)。
输出形状(--list):
json
{
  "ok": true,
  "message": "共 N 个端点:\n  <module>.<endpoint>  [POST /v1/...]  <summary>",
  "endpoints": [ { "id": "<module>.<endpoint>", "method": "POST", "path": "/v1/...", "summary": "..." } ]
}
4.6 参数校验:一次收全、未声明只警告
js
// call.mjs 节选
const pathResult  = validateParams(def.pathParams, params, 'pathParams');
const queryResult = validateParams(def.query,      params, 'query');
const bodyResult  = validateParams(def.body,       params, 'body');
const errors = [...pathResult.errors, ...queryResult.errors, ...bodyResult.errors];
if (errors.length) {
    out(false, `参数错误:\n  - ${errors.join('\n  - ')}`);
}

// 未声明的参数只警告不阻断
const unknown = Object.keys(params).filter((name) => !declared.has(name));
if (unknown.length) {
    warnings.push(`以下参数未在端点声明中,已忽略: ${unknown.join(', ')}`);
}
三条原则值得抄:
- 一次收集全部错误,不遇错即返回------用户改一轮就够,不用「改一个跑一次」;
- 必填缺失 = 阻断,未声明参数 = 只警告------前者是明确的错误,后者可能只是版本差异,不该因此挂掉;
- 类型转换按声明走 ------
string/number/boolean/array,其中array类型支持--param a=1,2逗号切分、--json传数组原样保留。
4.7 CLI 层的错误收敛
main() 的兜底只留两条分支:
js
main().catch((error) => {
    // 可预期的输入问题:直接把 message 作为失败原因输出
    if (error instanceof ParamError || error instanceof UsageError) out(false, error.message);
    // 其余为内部崩溃:堆栈走 stderr,stdout 仍给单段 JSON
    const stack = error && error.stack ? error.stack : String(error);
    process.stderr.write(`[skill 骨架] 内部错误: ${stack}\n`);
    out(false, `内部错误: ${error && error.message ? error.message : String(error)}`);
});
而请求异常只剩两种可能:
js
// 只剩两种可能:连接失败(TypeError)/ 超时(AbortError)
const reason = error.name === 'AbortError' ? `超时(> ${timeout}ms)` : error.message;
out(false, `请求未完成: ${reason}`, { request: {...}, error: {...} });
难点在于「知道剩下哪些可能」 ------因为没有状态码判定、没有错误包装,fetch 能抛出的就只有网络错误与 abort,「超时」便能被无歧义地识别为 AbortError。
注:超时的异常名取决于实现方式------
AbortController.abort()抛AbortError(本骨架采用),而附录 A 的 MVP 用AbortSignal.timeout()则抛TimeoutError。两者是同一件事的两种写法,判据取各自实际抛出的error.name即可(见附录 A.7)。
5. 呈现层:references/ ------ 四件公共资产
| 文件 | 定位 | 权责 |
|---|---|---|
shell.html(壳文件) |
UI 壳(布局、CSS 变量、class、主题切换、水印) | 壳层 DOM / class / 色值的唯一权威 |
html-visual-template.md |
视觉铁律 + 操作清单 | 规定「必读顺序」与「禁止事项」 |
echarts-guide.md |
图表代码模版 | 图内 option / 主题联动 / 尺寸自适应的唯一权威 |
environment-precheck.md |
环境前置检查工作流 | Node ≥ 18 判定,macOS / Windows 双写法 |
5.1 权责三分(骨架里最重要的一条约定)
text
视觉壳以壳文件为准、图表代码以 echarts-guide 为准、内容与板块以子技能文档为准。三者互不越界 :壳文件不规定写什么内容,echarts-guide 不规定容器长什么样,子技能不规定页面长什么样。任何一层都不允许「转述」另一层的细节------因为转述就是漂移的开始(这条在第 6 章还会再提一次)。
5.2 壳文件(shell.html):固定模版的三部分
壳文件是模版------只提供「长什么样」,不提供「写什么」。头部注释把结构写死为三部分:
- ① 设计令牌 :
:root下的 CSS 变量(主色、涨跌色、页面/面板/文字/边框/阴影、圆角、图表系列色);深色模式由[data-color-mode="dark"]整段覆盖; - ② 壳层结构 :顶栏(标题 + 主题切换)、水印、页脚、图区等固定外框,类名固定;
- ③ 可复用板块类 :徽标、指标卡、表格、图表等供拼接复用的样式类。
具体有哪些类名,以壳文件本身为准,本文不复述------复述就是漂移的开始(见 6.4 节)。
主题切换本身极简------只切 <html> 上的属性,配色由 CSS 变量自动跟随:
js
document.querySelector('.themeToggle').addEventListener('click', function () {
    var target = root.dataset.colorMode === 'dark' ? 'light' : 'dark';
    root.dataset.colorMode = target;
    iconEl.textContent = NEXT[target].icon;
    textEl.textContent = NEXT[target].text;
});
这里有个漂亮的副作用 :因为主题切换只是「改一个 DOM 属性」,图表不需要壳配合------它可以用 MutationObserver 从外部感知(见 5.3)。
5.3 echarts-guide.md:把「机制」固化成骨架
这份文件的价值不在图型多,而在把三件容易漏的事固化进了骨架:
| 机制 | 做法 | 不做会怎样 |
|---|---|---|
| 主题联动 | MutationObserver 监听 data-color-mode → dispose() 重建 |
切深色后图表仍是浅色配色 |
| 尺寸自适应 | ResizeObserver + window.resize 双保险 |
移动端 / 栅格断点切换后图表变形、留白 |
| 配色接入 | 读宿主 --series-* 令牌,缺任一即返回 null 交给 ECharts 内置色板 |
与报告壳配色脱节,或宿主无令牌时图表无色 |
js
// 通用接入段节选:主题联动 + 尺寸自适应
new MutationObserver(render).observe(root, {
    attributes: true, attributeFilter: ['data-color-mode']
});

var resize = function () { chart && chart.resize(); };
if (window.ResizeObserver) {
    new ResizeObserver(resize).observe(dom);
}
window.addEventListener('resize', resize);
注意 readSeriesColors 的优雅降级设计:
js
function readSeriesColors(count) {
    var out = [];
    for (var i = 0; i < count; i++) {
        var c = token('--series-' + (i + 1));
        if (!c) { return null; }   // 缺任一 → 整组放弃,交给 ECharts 内置色板
        out.push(c);
    }
    return out;
}宁可回退到通用色板,也不拼一个半品牌半默认的杂色组合------这是「中立自带默认 + 令牌优先」原则的具体落地,也让这份模版能脱离本壳、被别的报告复用。
5.4 数据内嵌:静态产物的自包含
壳模版本身不含数据 ------数据只活在产物里:报告的全部真实数值整体内嵌为一段 JSON,随 HTML 一同落盘:
html
<!-- ① 数据(必须放在图表 <script> 之前)-->
<script type="application/json" id="report-data">
{
  "meta": { "title": "报告标题", "date": "YYYY-MM-DD" },
  "charts": {
    "main": {
      "categories": ["类目 A", "类目 B"],
      "series": [
        { "name": "系列一", "data": [1.2, -0.8] },
        { "name": "系列二", "data": [0.9, -0.3] }
      ]
    }
  }
}
</script>

<!-- ② 容器(必须有确定高度;下列 class 一律照抄壳文件对应段,此处以占位名示层级)-->
<div class="{壳·面板类}">
  <div class="{壳·板块标题类}">图区标题</div>
  <div class="{壳·图区容器类}">
    <div class="{壳·图题类}">图题(按业务填写)</div>
    <div id="chart-main" class="{壳·图表画布类}"></div>
  </div>
</div>

<!-- ③ 图表脚本:整体照抄骨架,buildOption 从 DATA 取数 -->
三条硬规则:
- 禁止接口依赖 :不得
fetch/ XHR,产物必须离线可打开; - 数据单一落点 :图表数据整体写进
report-data,不得散落在 option 字面量里(正文展示值由拼接写入 DOM,见 A.6); - JSON 必须合法 :无尾逗号、无注释,
NaN/Infinity一律写null;字符串内如需</script>必须写成<\/script>防提前闭合。
顺带一个工程细节:多图 = 一图一段独立 IIFE 。因为 dispose() / resize() 是按实例绑定的,合写会导致切主题时漏重建。
5.5 environment-precheck.md:把「环境」也当作流程
Node ≥ 18 是硬门槛(18 起 fetch 才默认可用),于是前置检查被写成一份跨平台工作流 :判断是否安装 → 判断主版本 → 引导安装/升级 → 冒烟。每一步都给 macOS / Windows 两套写法 ,并要求:涉及改动用户本机环境必须先征得同意 ,且不得为绕开版本检查而改 scripts/。
6. 子技能层:modules/ 的分层范式
这一层是骨架最值得复用的部分 ------它解决的是一类通用问题:一个业务能力,文档该怎么切?
6.1 形态选择:文件夹 + index.md
| 形态 | 结构 | 适用 |
|---|---|---|
| 单文件 | modules/<名>.md |
能力简单、一屏说清 |
| 文件夹 | modules/<名>/index.md + 同目录子文件 |
能力复杂,需按职责拆 |
两条硬约束:
- 入口文件名固定为
index.md(<名>只用于目录名); - 子文件不得命名为
SKILL.md------ 否则可能被识别为独立顶层 skill,脱离路由表被「野生调用」。
6.2 四文件职责切分
以落入该骨架的首个子技能为例(业务细节从略,只看职责边界):
| 文件 | 承载 | 何时读 | 一句话定位 |
|---|---|---|---|
index.md |
调用意图 / 接口调用 / 选择模版输出 / 输出规范 / 边界 | 每次执行 | 纯编排------只做「第一步调什么、然后读哪个文件」 |
apis.md |
端点能力表 / 调用命令 / 双层校验 | 取数前 | 能力层------「能调到什么」 |
templates.md |
模版总表 / 模版定义(含取值字段)/ 字段口径与陷阱 | 组装前 | 呈现层------「取到的数据怎么摆」 |
sections.md |
板块顺序表 / 裁剪总则 | 组装前 | 结构层------「报告由哪些板块、按什么顺序」 |
index.md 开头是一张资源索引表,直接回答「什么时候读哪个文件」:
markdown
| 文件 | 承载 | 何时读 |
|---|---|---|
| **本文件** | 调用意图 / 接口调用 / 选择模版输出 / 输出规范 / 边界 | 每次执行 |
| apis.md | 接口能力:端点能力表 / 调用命令 / 双层校验 | 取数前 |
| templates.md | 模版:模版总表 / 模版定义(含取值字段)/ 字段口径与陷阱 | 组装前 |
| sections.md | 板块顺序表(按序组装,缺一不可)/ 裁剪总则 | 组装前 |
| references/* | 视觉壳 / 视觉铁律 / 图表模版 | 产出 HTML 前(必读) |这张表才是分层文档的「路由表」------它把「渐进披露」落到实处:AI 不必一次吞下全部文档,而是按阶段取用。
6.3 命名规则:内容本体词
子文件按功能命名,只允许「内容本体词」:
text
允许:apis / templates / sections / fields / shell
禁用:-catalog / -order / -dictionary / -spec 等容器词后缀区别在哪?sections.md 说的是「这个文件本身是 什么内容」(板块集合);sections-catalog.md 说的是「这个文件装着 某类内容」(一个目录)------后者是容器词,等于给文件加了一层没有信息量的包装。
6.4 单一权威归属(防漂移的核心)
四个文件之间不可避免会「说同一件事」,骨架的做法是为每个结论指定唯一权威,其他位置只留指针:
| 结论 | 唯一权威 | 其他位置 |
|---|---|---|
| 缺失字段 / 空列 / 空块怎么裁 | sections.md 的「裁剪总则」 |
index.md 只留指针 |
| 「本端点没有哪些数据、因而不得产出什么」 | templates.md 的「范围与边界」 |
板块表下只留指针 |
| 双层校验判据与失败处理 | apis.md 的「双层校验」 |
index.md 只留「两条都过才继续」一句话 |
| 字段单位 / 格式 / 易错点 | templates.md 的「字段口径」 |
各模版内联「含义」,不重复格式规则 |
配套还有一条**「零 class / 零 CSS 令牌」口径**:
text
templates.md、sections.md、apis.md 均不复述 DOM 结构与类名;
class / DOM / 色值令牌的唯一权威 = 壳文件(shell.html)------html-visual-template.md 只规定必读顺序与操作清单,同样不复述类名清单。理由是这条链上曾经反复出偏差:文档一旦转述了壳的类名清单,壳改一次类名,就要在所有转述处同步一次------而「唯一权威」把同步点收敛回一处 。子技能里只保留「模版名即结构语义」(如「指标表」= 横向表格),真正要写 DOM 时去壳文件里找同形态示例段照抄。
6.5 模版编号与板块顺序的一致性
子技能内部还有一个小而关键的设计:模版 ID 按「报告输出顺序」编号,使「序 = 输出序 = 模版编号」三者恒等。
这样一张「模版总表」可以同时表达形态与承载板块:
markdown
| 序 | 模版 ID | 模版名 | 形态 | 承载板块 |
| - | ----- | ------- | ---------- | -------------- |
| 1 | MT-1  | KPI 卡片组 | 卡片网格 | <板块 A> |
| 2 | MT-2  | 评估条目    | 逐行段落,无表格 | <板块 B> |
| 3 | MT-3  | 排名表     | 横向表格,一行一区间 | <板块 C> |
| ... | ... | ... | ... | ... |而板块顺序表则按板块 逐行(含非取数段落)。两者同源 :一张按模版去重、一张按板块展开;不一致时以板块顺序表为准。
反面教材:早期版本存在两套独立序列 (模版编号按形态归类、输出位置另有一套序号),而某个模版被两个板块复用 → 输出位置数 ≠ 模版数,「序 ≡ 编号」在数学上就不可能成立。最终解法是按输出序重编模版 ID ,并把两张表合并去重------能用一个不变量表达的约束,不要用两个序列去维护。
7. 端到端业务流转
把上面各层串起来,一次完整执行的链路是:
7.1 双层信封校验
这是取数环节的唯一成功判据,一次调用有两层:
| 层 | 位置 | 成功判据 | 失败处理 |
|---|---|---|---|
| ① CLI 层 | stdout 信封 ok |
=== true |
读 message 区分:网络/超时 = 接口不可用、参数写错 = 改参数,不要盲目重试 |
| ② 业务层 | data.code |
=== 0(成功码以接口约定为准) |
取 data.msg 说明原因,终止生成 |
业务信封的字段名与成功码取值都取决于接入方接口 ,上表用最常见的一组(
code数值、0为成功)示意;换接口时只改这一处判据,骨架其余部分不动。
业务字段路径是 <stdout>.data.data.*:stdout 信封 → HTTP body → 业务字段容器。
这里踩过一个坑:曾用
"data" in j.data判断「单层还是双层」,结果是所有端点都被判成同一层 。根因是判据选错了------业务字段里恰好没有名为data的键时,这个判断恒为同一结果。正确判据是看body.data是否为业务字段容器 (与已知端点的Object.keys对照)。
7.2 依赖链驱动取数顺序
子技能的编排逻辑不是「把端点全调一遍」,而是按依赖链决定顺序:
text
1. 调主数据端点(必调,先跑);
2. 从主数据返回中取 <依赖字段 A>(供端点 B 入参)、推 <依赖字段 B>(作端点 C 的区间上界);
3. 与主数据无依赖的端点:顺序不限;
4. 依赖上一步结果的端点:入参必须取自返回,不得写死。
**「不得写死入参」**是一条硬规则------凡是需要从上游返回推导的参数,写死就意味着换一只产品就会静默出错。
7.3 组装与交付
text
逐行读板块顺序表 → 取该行「使用模版」的模版 ID → 到模版定义取「形态/取值字段/裁剪规则」
→ 按裁剪规则处理空列/空块 → 字段单位与格式统一按「字段口径」处理
→ 成品:单文件自包含 HTML(<!DOCTYPE html> → </html>)
→ 落盘:tmp/<模块>-<标识>-<日期>.html
→ 交付:向用户给出产物绝对路径
8. 设计取舍与踩坑清单
| 决策 / 坑 | 结论 | 理由 |
|---|---|---|
| 用真 axios 还是复刻 | 复刻 | 沙箱无 node_modules,import axios 必 MODULE_NOT_FOUND;Node ≥ 18 内置 fetch 够用 |
.js 还是 .mjs |
统一 .mjs |
.js + export 靠 Node ≥ 22 语法探测,Node 18 会 SyntaxError |
| 退出码承载语义 | 废弃,恒为 0 | 语义全放信封 ok + message,stdout 保持「一段可 JSON.parse 的 JSON」 |
| 非 2xx 算不算失败 | 不算 | 「接口返回什么就返回什么」,不做状态码判定、不包装错误,语义不被中间层篡改 |
| 超时怎么识别 | 按 AbortError |
无状态码判定后,fetch 只剩连接失败与 abort 两种异常,超时来源唯一 |
| 未声明参数 | 只警告不阻断 | 阻断的应是「明确的错误」,版本差异不该挂掉调用 |
| 必填缺失 | 一次列全所有错误 | 用户改一轮就够,避免「改一个跑一次」 |
| 图表主题联动 | MutationObserver 外部感知 |
零侵入壳文件(原方案是给壳的主题开关加钩子,已废弃);切换后 dispose() 重建 |
| 图表配色来源 | 令牌优先,缺任一即整体回退 | 不硬编码品牌色,也不产出「半品牌半默认」的杂色 |
| 报告数据怎么落 | 内嵌 <script type="application/json"> |
离线可打开、数据单一落点、更新只改一处 |
| 图表用几个 IIFE | 一图一段 | dispose() / resize() 按实例绑定,合写会漏重建 |
| 子技能单文件还是文件夹 | 文件夹 + 固定 index.md |
规避未来递归扫描风险;子文件禁名 SKILL.md(会被识别为独立顶层 skill) |
| 同一结论写在几处 | 只有一处 | 每个结论指定唯一权威,其余位置只留指针------转述即漂移 |
| 模版编号按什么排 | 按输出序 | 使「序 = 输出序 = 模版编号」恒等;避免两套序列并存导致约束不可满足 |
| 文档里要不要写 DOM 类名 | 不写 | class / DOM / 色值令牌唯一权威 = 壳文件;子技能只写「模版名 = 结构语义」 |
| 用测量值当真值判「是否就绪」 | 禁止 | 合法测量值可能为 0(某些端侧按设计就返回 0 高度),if (height) 会把「已就绪」误判成「未就绪」,异步轮询永不通过、Promise 永不 settle,页面卡在空白;「就绪」标记必须与测量值解耦,不可共用同一个变量 |
9. 如何复用到新场景
9.1 新增一个端点(不动骨架)
text
1. 在 scripts/apis/<module>.mjs 的 endpoints 中加一条声明(method / path / summary / body);
2. 在对应子技能的 `apis.md` 端点能力表加一行。
❌ 不得为适配单个子技能而修改 scripts/lib/(代理层)、scripts/call.mjs(CLI)或 scripts/apis/providers.mjs(连接配置)。
9.2 新增一个子技能
text
1. 在 SKILL.md 的路由决策表加一行(用户意图 → 目标文档);
2. modules/ 下新建(单文件 modules/<名>.md 或文件夹 modules/<名>/index.md),
   入口按「调用意图 / 接口调用 / 选择模版输出 / 输出规范 / 边界」编排(详见 6.2 节);
3. 复杂能力按 6.2 节的职责切分,把细节下沉为 apis / templates / sections 等子文件。
9.3 三条不可让步的边界
text
❌ 不得调用任何远程 Skill(如 remote-skill enter)或远程任务资源;一切在本地完成。
❌ 未读目标子技能文档 + 壳文件全文,不得直接产出 HTML。
❌ 报告数值必须 100% 来自本次接口返回;禁止臆造、推测、照抄壳文件里的占位内容。
(第 4 条红线「不得改 scripts/ 公共设施」见 9.1 节。)
10. 总结:这套骨架真正固化了什么
- 能力可发现 :端点声明成表,
--list/--describe让「有什么、怎么调」可查而非可猜; - 环境可预期:零 npm 依赖 + Node ≥ 18 前置检查,把「跑不起来」挡在执行之前;
- 语义不被篡改 :代理层不判定状态码、不包装错误,成功判据上收到双层信封,一次调用两层都过才算数;
- 视觉不漂移 :壳、图内配置、内容板块三权分立,每一层都不转述另一层;
- 结论单一权威 :同一个结论只允许有一个出处,其余位置只留指针------这是文档能长期演进而不变形的唯一办法;
- 数值可核查:数据内嵌 + 单一落点 + 对账关系,产物离线可打开,改数只改一处。
如果只带走一句话:把「容易漏、容易漂」的东西固化成骨架,把「每个场景不一样」的东西留给子技能。 骨架的成败不在功能多,而在边界清。
附录 A:最小可跑案例(MVP)
前面十章讲的是设计 ,这一节给一份可以直接照抄跑通 的最小实现:4 个文件、约 190 行(其中
apis21 行 +call58 行 +shell73 行),跑完「调接口 → JSON 信封 → 单文件报告」全链路。示例接口用公开测试服务
jsonplaceholder(无需鉴权、无需注册),因此不依赖任何内部环境。
A.1 目录结构
text
mini-report-skill/
├── SKILL.md                  # 入口:前置检查 / 路由 / 约定 / 编排 / 边界
├── scripts/
│   ├── apis.mjs              # 端点声明表(1 条)
│   └── call.mjs              # CLI:参数解析 → 校验 → 请求 → 单段信封
└── references/
    └── shell.html            # 固定壳模版:令牌 + 壳层 + 板块类(不含数据)
MVP 有意的取舍 :子技能编排内联进 SKILL.md (不建 modules/),代理层压成一个文件 (不拆 lib/)。什么时候该拆,见 A.7。
A.2 文件 1:scripts/apis.mjs ------ 端点声明(21 行)
js
/**
 * 端点声明表(MVP:只有 1 条)
 * 生产骨架会拆成 providers.mjs(连接配置)+ <module>.mjs(业务端点)两张表
 */
export default {
    module: 'example',
    provider: {
        baseURL: 'https://jsonplaceholder.typicode.com',
        timeout: 10000,
    },
    endpoints: {
        getUser: {
            method: 'GET',
            path: '/users/{id}',
            summary: '查询用户详情',
            pathParams: {
                id: { type: 'string', required: true, desc: '用户 ID,如 1' },
            },
        },
    },
};
要点 :端点不是硬编码在 CLI 里的,而是声明 出来的--------list 能列、未知端点能拦、必填缺失能报。这是「能力可发现」的最小实现。
A.3 文件 2:scripts/call.mjs ------ CLI(58 行)
js
#!/usr/bin/env node
/**
 * 极简 CLI:node call.mjs <module>.<endpoint> [--param k=v ...]
 * 输出协议:stdout 恒为单段 JSON { ok, message, ...payload }
 */
import apis from './apis.mjs';

const [target, ...rest] = process.argv.slice(2);

function out(ok, message, payload = {}) {
    process.stdout.write(JSON.stringify({ ok, message, ...payload }, null, 2) + '\n');
    process.exit(0);
}

// --param k=v → { k: v }
const params = {};
for (let i = 0; i < rest.length; i++) {
    if (rest[i] === '--param' && rest[i + 1] !== undefined) {
        const at = rest[i + 1].indexOf('=');
        params[rest[i + 1].slice(0, at)] = rest[i + 1].slice(at + 1);
        i += 1;
    }
}

// --list:列出全部端点
if (target === '--list') {
    const lines = Object.entries(apis.endpoints)
        .map(([name, def]) => `  ${apis.module}.${name}  [${def.method} ${def.path}]  ${def.summary}`);
    out(true, `共 ${lines.length} 个端点:\n${lines.join('\n')}`);
}

// 查端点
const endpoint = String(target || '').split('.')[1];
const def = apis.endpoints[endpoint];
if (!def) out(false, `未知端点: ${target}`);

// 校验必填 + 替换路径占位
let path = def.path;
for (const [key, spec] of Object.entries(def.pathParams || {})) {
    const value = params[key];
    if (spec.required && (value === undefined || value === '')) {
        out(false, `参数错误:pathParams.${key} 为必填(${spec.desc})`);
    }
    path = path.replace(`{${key}}`, encodeURIComponent(value));
}

// 请求 + 单段信封
const url = apis.provider.baseURL + path;
try {
    const res = await fetch(url, {
        method: def.method,
        signal: AbortSignal.timeout(apis.provider.timeout),
    });
    out(true, `${def.method} ${url} 成功 (${res.status})`, { data: await res.json() });
} catch (error) {
    const reason = error.name === 'TimeoutError' ? `超时(> ${apis.provider.timeout}ms)` : error.message;
    out(false, `请求未完成: ${reason}`);
}
要点 :顶层 await + AbortSignal.timeout() 都是 Node ≥ 18 的内置能力,零依赖 。超时不靠外部库,一个 signal 参数搞定。
A.4 跑起来(以下为实测输出)
bash
$ node scripts/call.mjs --list
{
  "ok": true,
  "message": "共 1 个端点:\n  example.getUser  [GET /users/{id}]  查询用户详情"
}
bash
$ node scripts/call.mjs example.getUser --param id=1
{
  "ok": true,
  "message": "GET https://jsonplaceholder.typicode.com/users/1 成功 (200)",
  "data": {
    "id": 1,
    "name": "Leanne Graham",
    "username": "Bret",
    "email": "Sincere@april.biz",
    "address": { "street": "Kulas Light", "suite": "Apt. 556", "city": "Gwenborough", "zipcode": "92998-3874" },
    "phone": "1-770-736-8031 x56442",
    "website": "hildegard.org",
    "company": { "name": "Romaguera-Crona", "catchPhrase": "...", "bs": "..." }
  }
}
上例
data中company的两条长文本为节省篇幅用...代替,其余字段均为真实返回。
失败分支同样只有一段 JSON,原因全在 message:
bash
$ node scripts/call.mjs example.getUser          # 必填缺失
{
  "ok": false,
  "message": "参数错误:pathParams.id 为必填(用户 ID,如 1)"
}

$ node scripts/call.mjs example.nope --param id=1   # 未知端点
{
  "ok": false,
  "message": "未知端点: example.nope"
}还有一个容易被忽略但很关键 的行为------上游 404 时信封仍是 ok: true:
bash
$ node scripts/call.mjs example.getUser --param id=abc
# → ok: true, message: "... 成功 (404)", data: {}
这正是 4.3 节「响应不做加工」的直接体现:CLI 层只对「请求有没有跑完」负责,不对「上游业务是否成功」下判断。判断业务成败是使用方的事(生产骨架里由「双层信封」的第二层承担,见 7.1 节)。
A.5 文件 3:SKILL.md ------ 入口 + 编排(MVP 内联)
markdown
---
name: mini-report
description: 调接口生成单页报告的最小骨架示例。
---

# mini-report(MVP)

## 1. 前置检查

Node ≥ 18(脚本用内置 `fetch` 与顶层 `await`,零 npm 依赖)。

## 2. 路由

| 用户意图 | 进入子技能 |
|---|---|
| 给定用户 ID,要「用户详情报告 / 生成 HTML」 | 本文件(MVP 内联,见 4 节) |

## 3. 公共约定

node scripts/call.mjs --list                              # 列出端点
node scripts/call.mjs example.getUser --param id=1           # 调用

- stdout 恒为单段 JSON `{ ok, message, ...payload }`,诊断走 stderr;
- `ok === true` 才算取数成功,失败原因见 `message`。

## 4. 生成报告(编排)

1. 调 `example.getUser` 取数,确认信封 `ok === true`;
2. 照 `references/shell.html` 拼接报告:壳层照抄、板块按序、真实值写入对应元素(模版本身不含数据);
3. 落盘为 `tmp/mini-user-<用户 ID>-<YYYYMMDD>.html`;
4. 向用户给出产物绝对路径。

## 5. 边界

- ❌ 不得请求任何远程 Skill;数据只来自本次调用;
- ❌ 不得把示例用户「Leanne Graham」等占位数据写进产物。
要点 :SKILL.md 里没有一句代码 ------它只回答「先做什么、再做什么、不许做什么」。MVP 因为只有一个能力,编排三行就够,所以不建 modules/;一旦能力变多或板块变复杂,再按第 6 章拆。
A.6 文件 4:references/shell.html ------ 固定壳模版(73 行)
先纠正一个最容易搞反的点:shell.html 是模版,不是产物。
它只回答「报告长什么样」------设计令牌、壳层结构、类名、样式;不含任何数据、不含渲染脚本 ,换一份报告它也不用改。报告是 AI 读它之后拼接出来的:壳层照抄 → 板块按子技能顺序组装 → 真实值写入对应元素。
html
<!DOCTYPE html>
<html lang="zh-CN" data-color-mode="light">
<head>
<meta charset="UTF-8" />
<meta name="viewport" content="width=device-width, initial-scale=1.0" />
<title>报告标题(占位,拼接时替换)</title>
<style>
    /* ① 设计令牌:改配色只改这里 */
    :root {
        --accentPrimary: #FC6047;    /* 品牌主色 */
        --textPrimary: #1D2129;
        --textMuted: #86909C;
        --bgPage: #F7F8FA;
        --bgCard: #FFFFFF;
        --borderBase: #E5E6EB;
        --radiusCard: 12px;
    }
    [data-color-mode="dark"] {       /* 深色:只整段覆盖令牌,其余样式不动 */
        --textPrimary: #F2F3F5;
        --bgPage: #17171A;
        --bgCard: #232324;
        --borderBase: #333335;
    }
    /* ② 壳层样式 */
    body { margin: 0; padding: 24px; background: var(--bgPage); color: var(--textPrimary);
           font-family: -apple-system, 'PingFang SC', 'Microsoft YaHei', sans-serif; }
    .reportTopbar { max-width: 640px; margin: 0 auto 12px; display: flex;
                    justify-content: space-between; align-items: flex-start; }
    .reportTitle { margin: 0; font-size: 20px; font-weight: 700; }
    .reportSubtitle { margin: 4px 0 0; font-size: 13px; color: var(--textMuted); }
    .themeToggle { padding: 4px 10px; font-size: 12px; border-radius: 999px; cursor: pointer;
                   border: 1px solid var(--borderBase); background: var(--bgCard); color: var(--textMuted); }
    /* ③ 可复用板块类:AI 拼接时只允许用这些 */
    .panel { max-width: 640px; margin: 0 auto; background: var(--bgCard);
             border: 1px solid var(--borderBase); border-radius: var(--radiusCard);
             padding: 20px 24px; }
    .fieldGrid { display: grid; grid-template-columns: 1fr 1fr; gap: 12px; }
    .fieldCell { padding: 10px 12px; background: var(--bgPage); border-radius: 8px; }
    .fieldLabel { font-size: 12px; color: var(--textMuted); }
    .fieldValue { font-size: 15px; font-weight: 600; word-break: break-all; }
</style>
</head>
<body>
<!-- ④ 壳层结构:类名固定,AI 只在此骨架上「长」出板块 -->
<div class="reportTopbar">
    <div>
        <h1 class="reportTitle">报告标题</h1>
        <p class="reportSubtitle">副标题</p>
    </div>
    <button class="themeToggle" type="button">深色</button>
</div>
<div class="panel">
    <!-- 板块槽:AI 按编排的板块顺序在此拼接,例如:
         <div class="fieldGrid">
             <div class="fieldCell">
                 <div class="fieldLabel">用户 ID</div>
                 <div class="fieldValue">1</div>      ← 真实值,拼接时写入
             </div>
         </div>
         产物若含图表或需可核查,再按 5.4 节内嵌 report-data 数据块 -->
</div>

<!-- ⑤ 壳行为:只切一个属性,与数据无关 -->
<script>
document.querySelector('.themeToggle').addEventListener('click', function () {
    var root = document.documentElement;
    var dark = root.dataset.colorMode === 'dark';
    root.dataset.colorMode = dark ? 'light' : 'dark';
    this.textContent = dark ? '深色' : '浅色';
});
</script>
</body>
</html>要点:
- AI 自动拼接 :模版固定不动(壳层、类名、令牌、样式),报告由 AI 按子技能编排的板块顺序逐段拼接 生成;模版里的「报告标题 / 副标题」是占位,拼接时必须替换为真实值,不得原样进产物;
- 类名即契约 :AI 拼板块时只允许复用模版已定义的 class,禁止自造新类名------「视觉不漂移」就靠这条落地;
- 数据内嵌属产物 :模版永远不带数据块;产物若含图表 / 需可核查,再按 5.4 节内嵌
report-data,保证离线可打开; - 深浅色是壳的事 :主题切换只改
<html data-color-mode>,配色由令牌跟随,图表从外部感知(5.3 节)。
完整链路(AI 执行的顺序):
text
node scripts/call.mjs example.getUser --param id=1     # ① 取数,确认 ok === true
  → 读 references/shell.html(固定壳模版,唯一权威)    # ② 照壳:结构 / 类名 / 令牌
  → 按编排的板块顺序拼接 DOM,真实值写入对应元素         # ③ 拼接(模版不含数据)
  → 存为 tmp/mini-user-1-20260916.html               # ④ 落盘(必要时内嵌数据块)
  → 告诉用户绝对路径                                   # ⑤ 交付
A.7 从 MVP 到生产骨架:缺什么
MVP 故意省掉了生产骨架的大部分设施。什么时候该补哪一块,按痛点对照即可:
| 痛点出现时 | 补什么 | 对应章节 |
|---|---|---|
端点从 1 个变成十几个,apis.mjs 越来越长 |
拆成 providers.mjs(连接配置)+ <module>.mjs(业务端点),由 index.mjs 两级组装 |
4.4 节 |
| 想在调用前先查端点有哪些参数 | CLI 加 --describe <module>.<endpoint> 分支,打印参数表 |
4.5 节 |
| 需要在发请求前后统一改 config / response | 引入拦截器与 lib/ 代理层 |
4.2 节 |
| 接口有 POST body、参数有数字/布尔/数组类型 | 参数声明加 type,CLI 做类型转换与「一次收全」的校验 |
4.6 节 |
| 写了参数名却拼错、或传了不存在的参数 | 未声明参数「只警告不阻断」 | 4.6 节 |
| 上游有业务错误码(HTTP 200 但业务失败) | 加双层信封 :CLI 层 ok + 业务层 data.code |
7.1 节 |
| 报错后不知道是网络问题还是参数问题 | 失败分类收敛:超时(AbortError/TimeoutError)vs 其余 |
4.7 节 |
| 一个能力文档超过一屏,AI 开始漏读 | 拆 modules/<名>/:index.md 编排 + apis.md / templates.md / sections.md |
第 6 章 |
| 报告有多个板块、多张图、多套表格 | 引入 sections.md(板块顺序)+ templates.md(模版与字段口径) |
6.2 / 6.5 节 |
| 报告样式每次都不一样 | 抽壳文件 + 视觉规范,明确「壳是唯一权威」 | 5.1 / 5.2 节 |
| 报告要带图表、且要跟随深浅色主题 | 引入图表模版(Observer 联动 + 令牌回退) | 5.3 节 |
| 换台机器跑不起来 | 加环境预检(Node 版本 + 冒烟) | 5.5 节 |
| 多个子技能要共用同一套约定 | 把约定上提到入口 SKILL.md,子技能只引用不复述 |
第 3 章 |
一句话 :MVP 只保留「能跑通」的最小闭环,生产骨架补齐的是**「跑得久、跑得稳、跑得可核查」**的那部分。先跑通,再按痛点加层------不要一上来就照着生产骨架铺齐所有目录。