9月12日晚,山景城(Mountain View)谷歌总部,一间本该摆着咖啡和零食的茶水间,被谢尔盖·布林改成了"战时指挥室"。这位Google联合创始人已经连续数月把算力和人力往一个方向加码:RSI(Recursive Self-Improvement,递归式自我改进)。路透社的报道和X用户的爆料,把这件事再次摆到了产业桌面上:Google DeepMind可能已经在内部跑通了RSI,而Gemini 4.0被认为是这条路上长出来的第一个产物。社区在代码仓库里发现了一个内部代号rsi-model-liverl-le,1M上下文、启用思考;一张截图在X上传开后,引发了整个硅谷的讨论。
目前,Google官方还未确认消息。同一天,Anthropic CEO达里奥·阿莫迪(Dario Amodei)发表《我们必须放缓前沿的步伐》(We Must Pace the Frontier),他的判断有一个直接触发因素:从今年夏天起,递归自我改进(RSI)明显加速。随后几个小时,平时互怼的行业领袖罕见地站在同一条战线:OpenAI CEO山姆·奥尔特曼(Sam Altman)转发达里奥的推文,埃隆·马斯克(Elon Musk)表态称"达里奥说得对"。
同一时间,北京东三环的金泰国际大厦,消防控制室里没有人讨论"AI会不会自迭代"。他们讨论的是:昨天凌晨的那条烟感告警,是真告警还是误报?误报的话下次怎么改?
这条告警在安心系统里被标记为"待确认"。值班员调出监控录像、通知到楼层、物业巡检完回传评价。系统把这个评价写回模型,之后再遇到类似的烟雾特征,告警策略自动收紧。
这就是安心系列的递归自我改进------在不容错的真实场景里,把"评价+验证+写回"做成日常运营。
如何把"AI自己改自己"这件事一步一步落地完成,用一条更加稳健的、工程化的路径指向RSI?
面向RSI的三个工程层面
把RSI描述成"AI觉醒、接管自己",这种叙事容易被理解,但工程上并不准确。面向RSI的持续改进,可以从模型、Harness(脚手架)和Agent(智能体)三个工程层面展开:
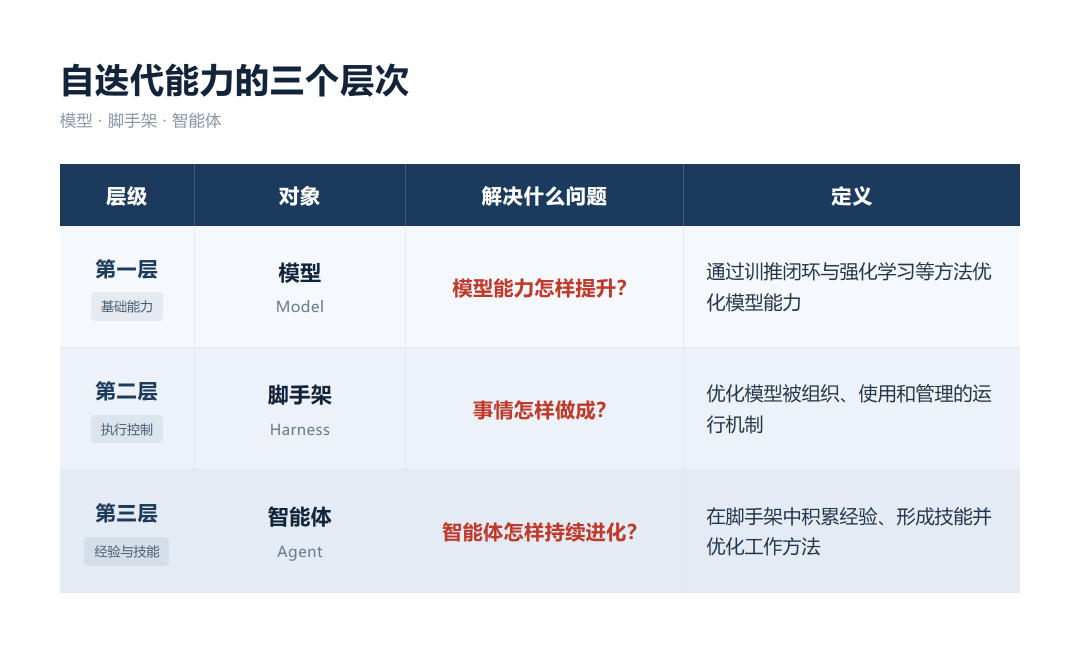
这是三个相互支撑的工程层面:
-
第一层解决"模型能力怎样提升":通过训推闭环,将经过筛选和验证的业务反馈用于强化学习、微调等模型更新。
-
第二层解决"事情做得成做不成":优化的是模型之外的东西,例如怎么组织Prompt(提示词)、怎么用工具、怎么调度智能体、怎么记住历史、怎么验证结果。模型不变,把"脚手架"升级,效果可以提升1.8倍(HarnessOpt-Bench 实测)。
-
第三层解决"智能体怎样持续进化":让任务经验被写回智能体的记忆、技能和工作方法,在后续任务中复用并验证。这一层可以在模型参数和Harness脚手架核心机制不变的情况下开展。
贯穿三层的是同一个机制"评价+验证+写回",也是面向RSI持续改进的基础;仅有反馈写回,并不等于实现递归自我改进。
评价决定"改什么",写回决定"改了能不能留"。没有评价,AI自改进是赌博;没有写回,AI自改进是一次性的。
这三层一旦形成闭环,就有机会积累持续改进的收益:第一层提升模型能力;第二层改进任务执行与验证机制;第三层积累智能体的经验与技能,其运行轨迹又可用于优化脚手架和训练模型。
模型层:"安心"大模型,在真实场景里跑通"评价+验证+写回"
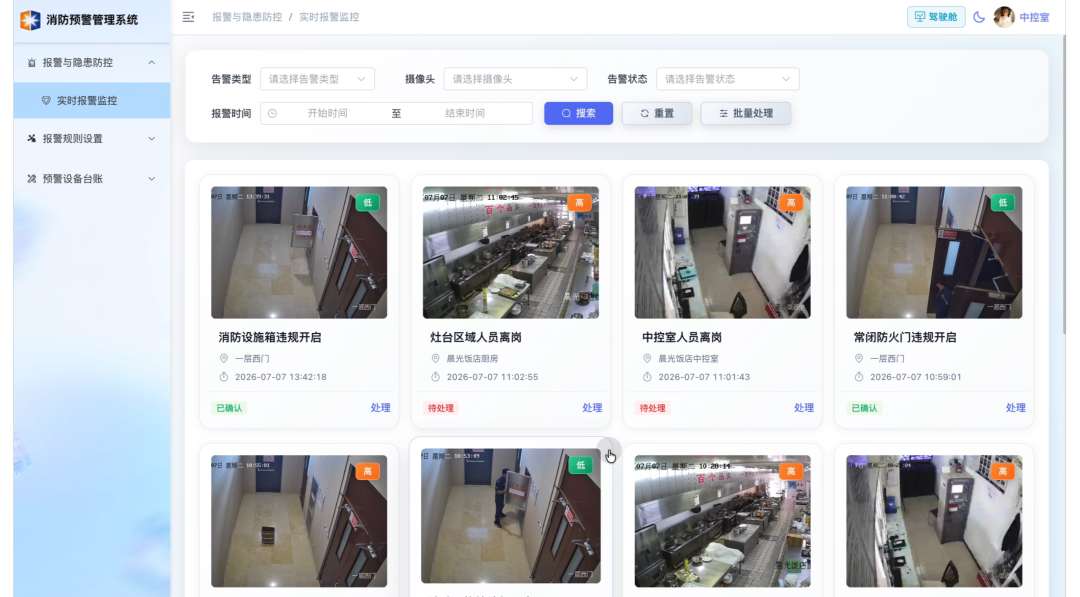
北京金泰国际大厦。"安心"消防安全大模型在这里跑了200多天,处理了10,162起真实预警,电梯机房的烟火告警、楼道间的常闭防火门开启、配电室的异常读数等,每一条告警都会被送到消防控制室。值班员要做两件事:
第一,判定真假:调监控和去现场物业巡检同事确认。
第二,把判定结果写回:这个判定是评价,下次类似场景要用到。
这是一种"生产反馈支持训练"的机制。它的背后,靠的是"训推一体+强化学习+反馈闭环"实现。
-
训推一体:衔接业务数据、模型训练、评测与推理部署,支撑模型持续更新。
-
强化学习:业务回执(人复核、专家审批、维护工单的实际处置)经筛选和奖励设计后,可用作训练的奖励信号。
-
反馈闭环:现场处置---评价---数据整理---训练---验证---再次部署,循环往复。
这一层的核心壁垒是评价基础设施。谁来评价、按照什么标准评价、评价结论写到哪里,这三件事形成了一个完整的"运营SOP(标准作业程序)"。因此,决定模型在规则密集、容错率低、反馈频繁的场景里的能力的,是评价密度。
但这一层只解决了"结果准不准"的问题,面对现场不断出现新事件,例如工厂要跑长流程任务、要并行处理、要跨班次记忆等,这时候光靠"再训一遍模型"已经不行,因为新场景每天都在出现,训练速度跟不上。这就到了第二层。
脚手架层:帮手平台,把每一次任务变成可学习的"数据单元"
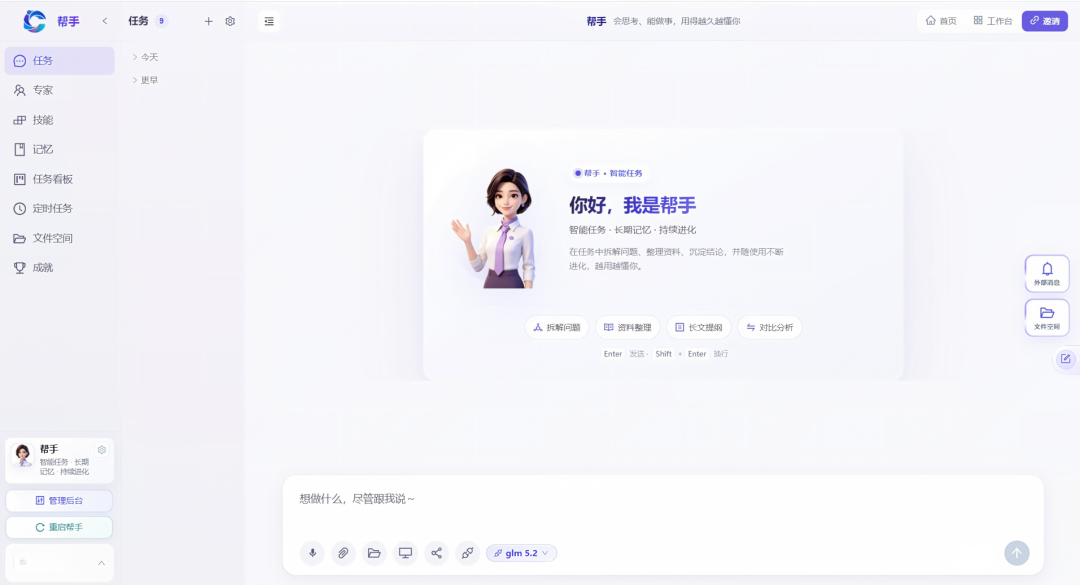
在RSI语境里,Harness脚手架工程是模型进入企业的执行控制面。它负责工具调用、上下文管理、记忆保存、任务分配、权限控制和结果检查。
当AI发现自己总是忘记实验条件,可以改进记录方式;发现某种工具反复出错,可以修正接口;发现研究流程效率低下,可以重写任务调度代码。
这些变化未必直接修改模型权重,却可明显提升整个系统的工作能力。
帮手平台把企业AI系统的"脚手架"做成了结构化、可学习、可评价的产品。具体在四件事上结构化:
-
意图结构化------把"用户到底想做什么"从临时上下文里抽出来,作为持久化的"意图对象"。意图里有目标、约束、完成标准、子任务、依赖、评价标准。
-
记忆结构化------从会话存档升级为"用户记忆/组织记忆/任务记忆/智能体记忆"。每一类记忆都是可检索、可调用、可校对的"长期表征"。
-
任务轨迹结构化------"Agent A→Agent B→工具调用→外部 API→结果"的整条链路被完整记录,谁成功、谁失败、谁犹豫、可视化可审计。
-
A2A推理轨迹结构化------多个智能体协同时,意图如何拆分、任务如何路由、结果如何聚合。这一层容易被忽略,却是"评价"最容易发生的地方。
把以上四件事结构化之后,每一次任务都成为可学习的数据单元,这是RSI第二层的核心壁垒。
第二层的"评价密度",比第一层更高、更细、更结构化。
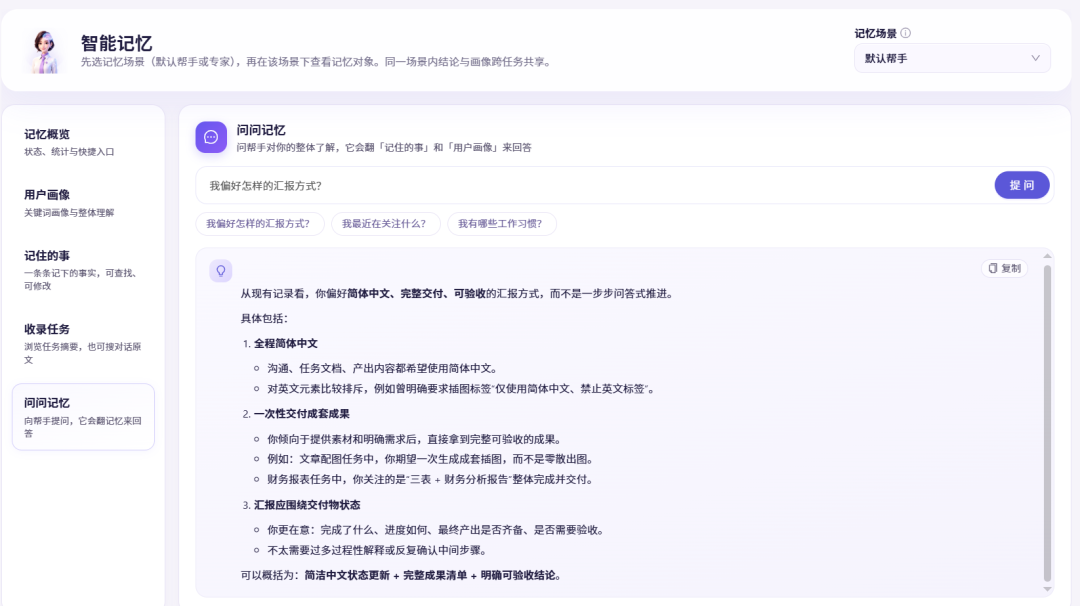
与此同时,这一层的"写回"主要面向脚手架的运行机制,例如上下文管理、记忆读写、调度与验证策略;具体智能体的经验、技能和工作方法,则归入第三层。
模型不变,Harness脚手架一变,效果立刻变。这就是帮手的"第二层深耕",把通用底座转化为金融、能源、工业等业务领域的垂直脚手架。
智能体层:智能体在脚手架中积累经验与技能
第三层的关键问题是"智能体如何从任务实践中持续改进"。智能体在Harness中执行任务,根据反馈复盘,将经过验证的经验沉淀为记忆、技能和工作方法,并在后续任务中复用。跨智能体协作与工具接入,可由以下两个协议提供支撑:
- A2A协议(Agent-to-Agent)
协议核心:每个智能体发布一个Agent Card(智能体名片),描述自己能做什么、怎么认证、接什么格式。
协作方式:发现其他智能体的能力→ 派活 → 对方接受/拒绝 → 流转状态 → 完成回执。
截至2026年4月,A2A已获得150+组织支持。
- MCP(Model Context Protocol)
与A2A互补:A2A处理"智能体之间怎么协作";MCP处理"智能体怎么接工具"。
在帮手平台,天云数据把A2A/Agent Registry/Agent Card做成可托管的"智能体生态运营层"。
工业上智能体持续进化跑得困难,主要原因有三个:
-
数据不是单家能搞定的------A2A让智能体互相发现,但每个智能体内部的数据是隐私。
-
评价基础设施不全------第三层需要对新增经验、技能和策略进行独立验证,但行业里往往缺少相应条件。
-
护栏要求最高------智能体间互发现能力时,谁有能力调用谁、谁能审计谁,谁约束权限,这是企业级AI最难的治理问题。
三层协同的工程逻辑,形成持续改进闭环
三层通过运行反馈相互支撑,智能体经验也可反向用于优化Harness脚手架和训练模型。
天云数据的RSI三层按以下路径形成闭环:
-
第一层:靠高质量数据和评价机制,通过训推闭环持续改进模型能力。
-
第二层:靠结构化任务轨迹和Harness脚手架机制优化,提升任务执行与验证效率。
-
第三层:靠智能体经验、技能和工作方法的积累,提升后续任务的完成质量与复用效率。
这是RSI在企业级AI里的"复杂地形走法"。
面对RSI的快速发展,Anthropic喊"该减速",天云数据的回答是把"评价基础设施"做到极致,让RSI在不允许出错的场景里也能被治理。不用喊停,装好工程约束。