《三年面试五年模拟》AIGC / LLM / AI Agent 算法工程师与开发工程师求职面试秘籍,独家资源见 WeThinkIn/AIGC-Interview-Book,欢迎 Star!
AIGC / LLM / AI Agent 算法岗与开发岗求职面试内推学习社群,涵盖 AIGC、LLM 大模型、AI Agent、传统深度学习、自动驾驶、机器学习、计算机视觉、自然语言处理、强化学习、大数据挖掘、具身智能、元宇宙、AGI 等方向的最新面试干货与核心知识,欢迎加入(https://t.zsxq.com/33pJ0)
目录
本文要点
(1)SenseNova-U1.5是商汤2026年9月发布的8B原生统一多模态模型,不带视觉编码器和VAE,理解、生成、编辑共用一套权重,原生分辨率到4096。
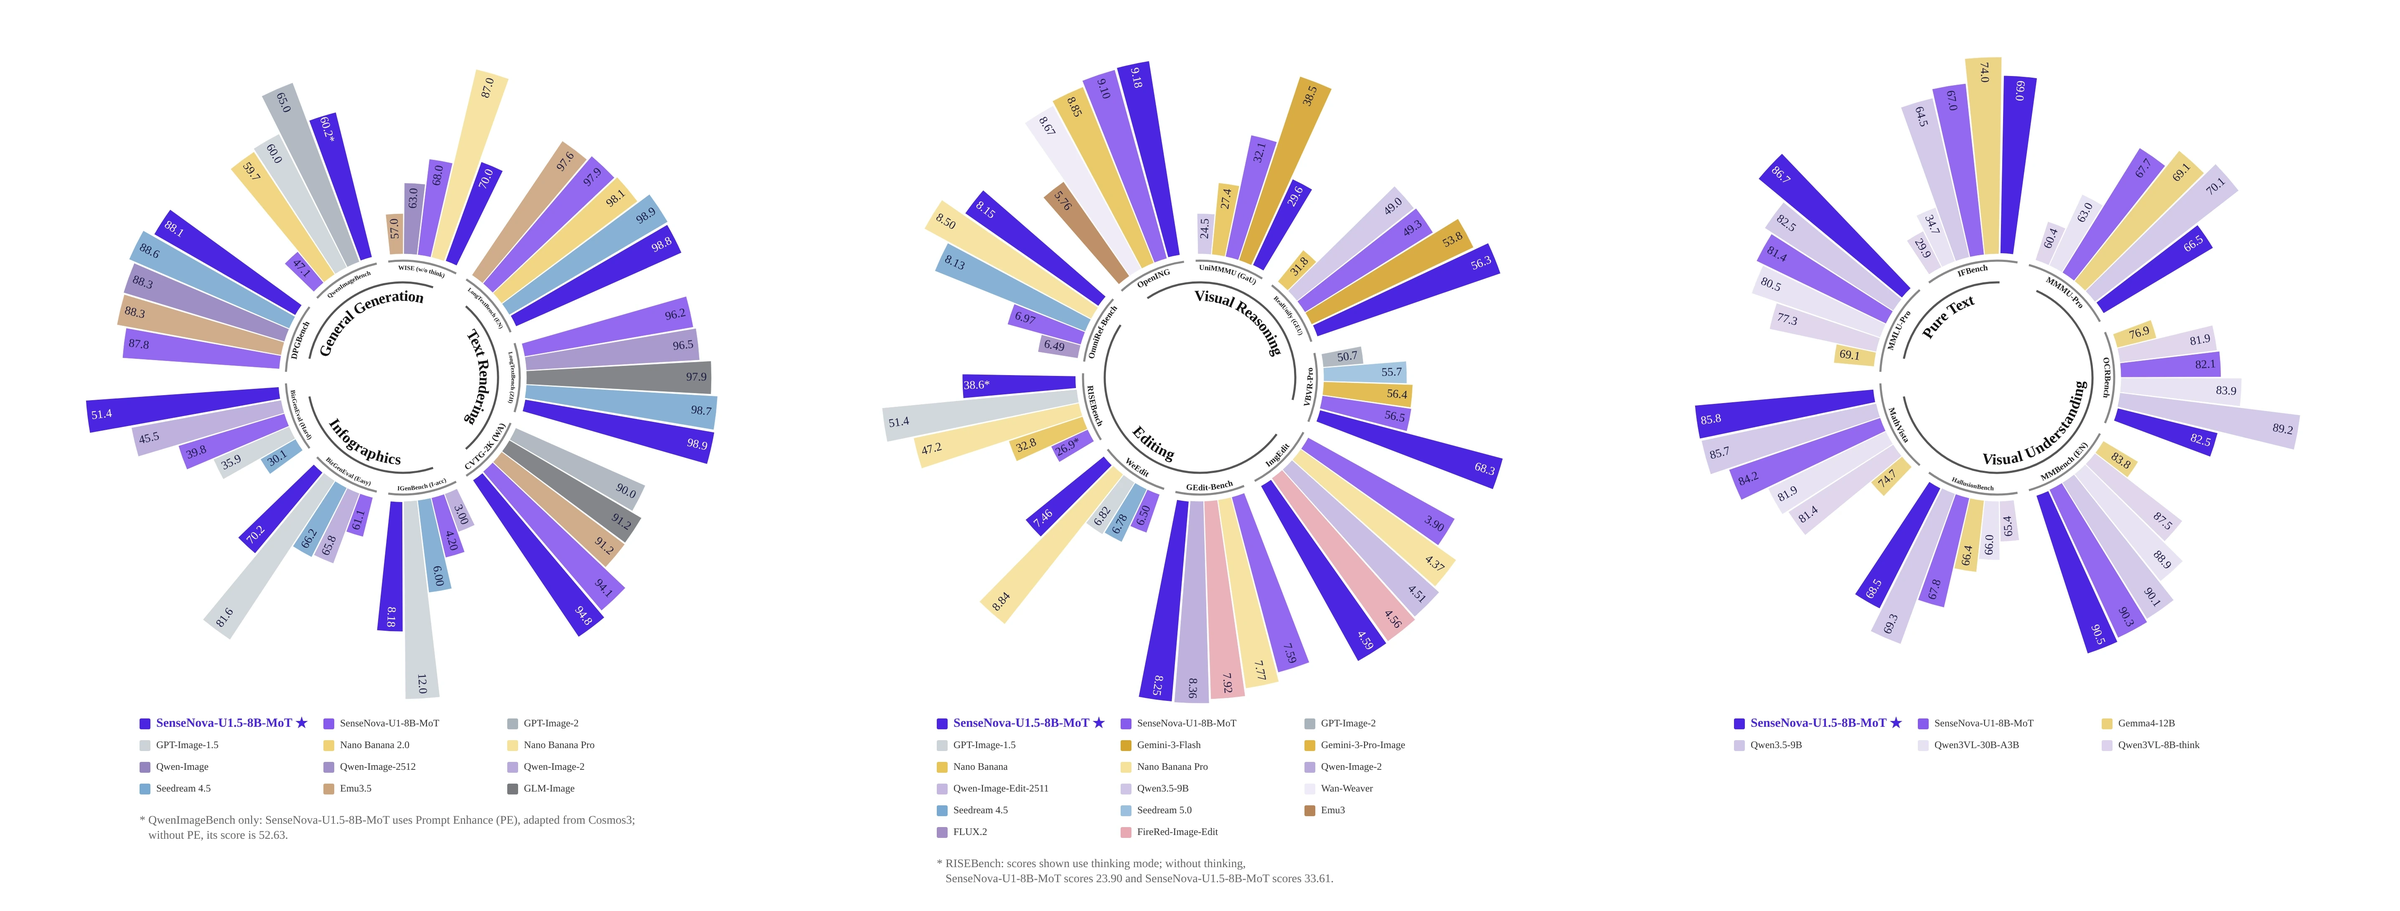
(2)文字渲染和编辑是长项,CVTG-2K平均0.948 、ImgEdit 4.59 ,两项在报告所列模型里都是第一,编辑比U1高出0.69。
(3)后训练把美学、文字、信息图、编辑拆成四个RL专家分别训练,再沿着学生自己的采样轨迹做速度场蒸馏,合回一个模型。
(4)短板在翻译类和推理类编辑,WeEdit上这两项的指令遵循只有2.19和1.84,理解基准比U1略有回落。
(5)文末附GitHub仓库的官方推理命令和参数对照。
商汤在2026年9月10日把SenseNova-U1.5的技术报告挂上arXiv。U1报告5月就出了,NEO-unify架构在CSDN上已经有人拆过,这篇不再复述。我把两份报告对着读了一遍,力气花在两件事上,后训练那套多专家on-policy蒸馏怎么做,以及一个没有VAE的模型凭什么能在4K上稳住。
模型还是8B的MoT,也就是Mixture-of-Transformers,理解和生成各8.2B参数,共用注意力,每层按token类型分开走各自的FFN和归一化。每个32×32像素区域压成一个视觉token,从头到尾没有视觉编码器,也没有VAE。
对照U1报告,改了哪几处
先从U1报告的Stage 5说起。那里有一段话,说RL阶段要冻住生成分支的MLP头来压网格伪影,原因是最后一层FFN和MLP头各自独立预测互不相干的32×32像素块,并且明确写了下一步打算换成PixelShuffle加两层卷积。U1.5做的第一件事就是这个。
分辨率是另一处。U1生成预训练的第二阶段把大图缩到2048×2048为止,噪声尺度归一化的参考分辨率也是2048。U1.5把两个上限都提到4096×4096,并且专门开了一个原生4K训练阶段。
训练量也涨了。生成预训练三个阶段的步数从U1的120K、60K、120K变成180K、100K、185K,第三阶段起加了权重0.1的LPIPS感知损失,一直保留到SFT。
后训练思路的变化最大,也是本文的重点。U1用一个策略同时吃两组奖励,一组是OCR加风格判别,一组是HPSv3美学分,逐epoch交替。U1.5改成先分头训四个专家,再蒸回一个模型。
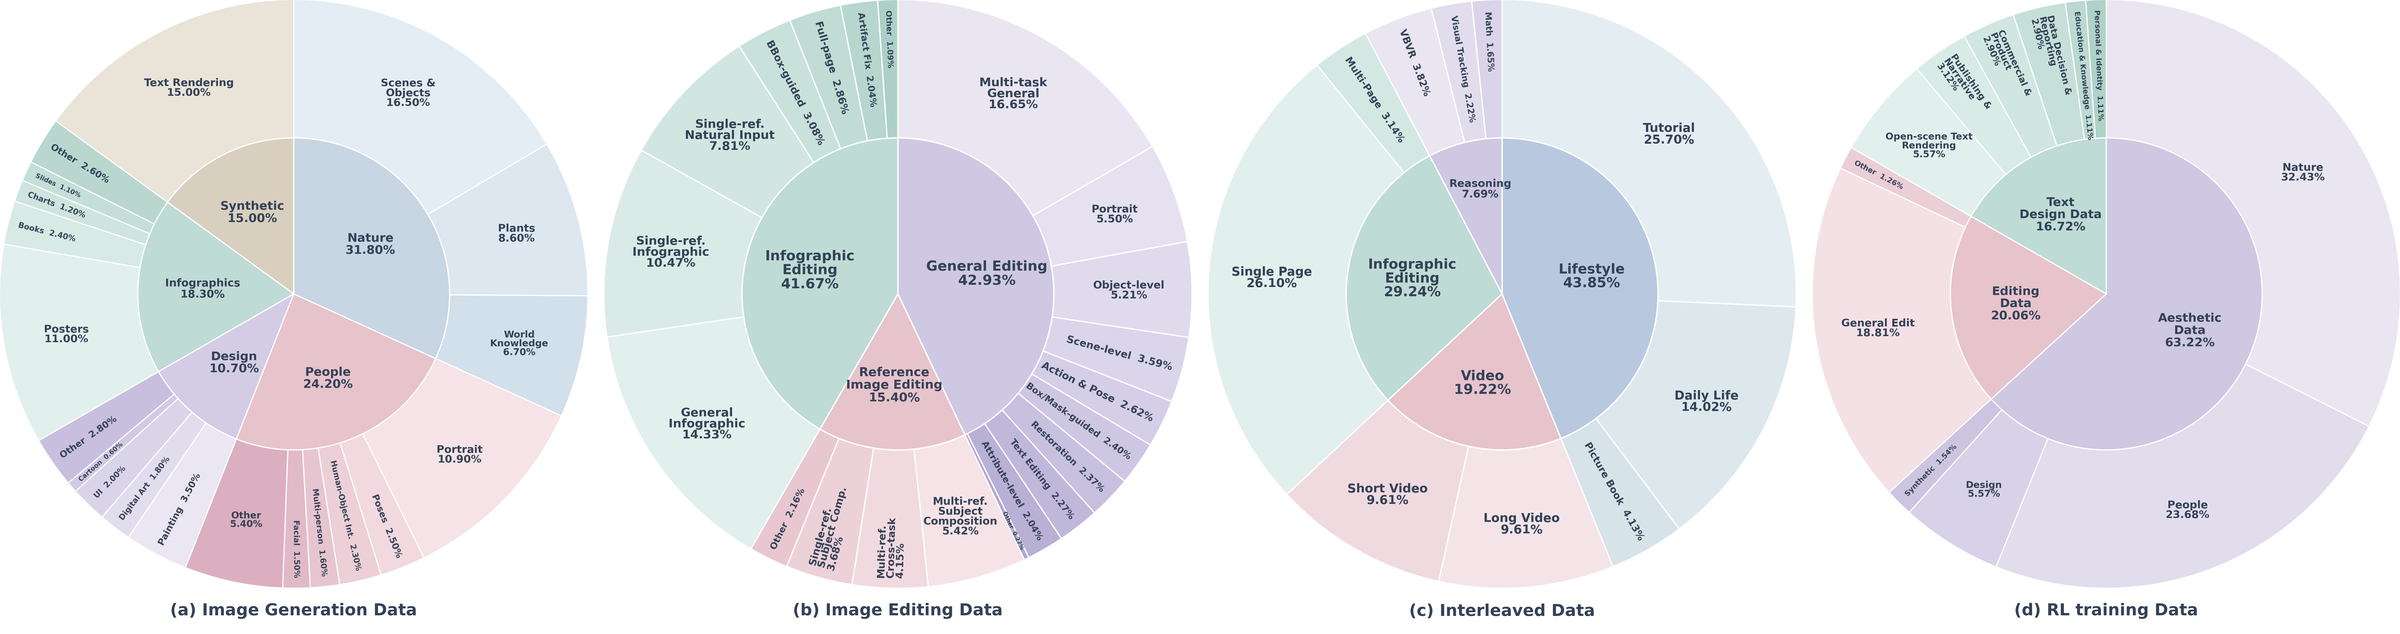
数据同样扩了。文生图新增约59M图文对,来自78个来源,其中超过1024²的样本占有效训练量的88.2%,超过2048²的占64.4%。编辑数据约38M条,其中约42%是带空间控制的信息图编辑。
无VAE的模型怎么在4K上稳住
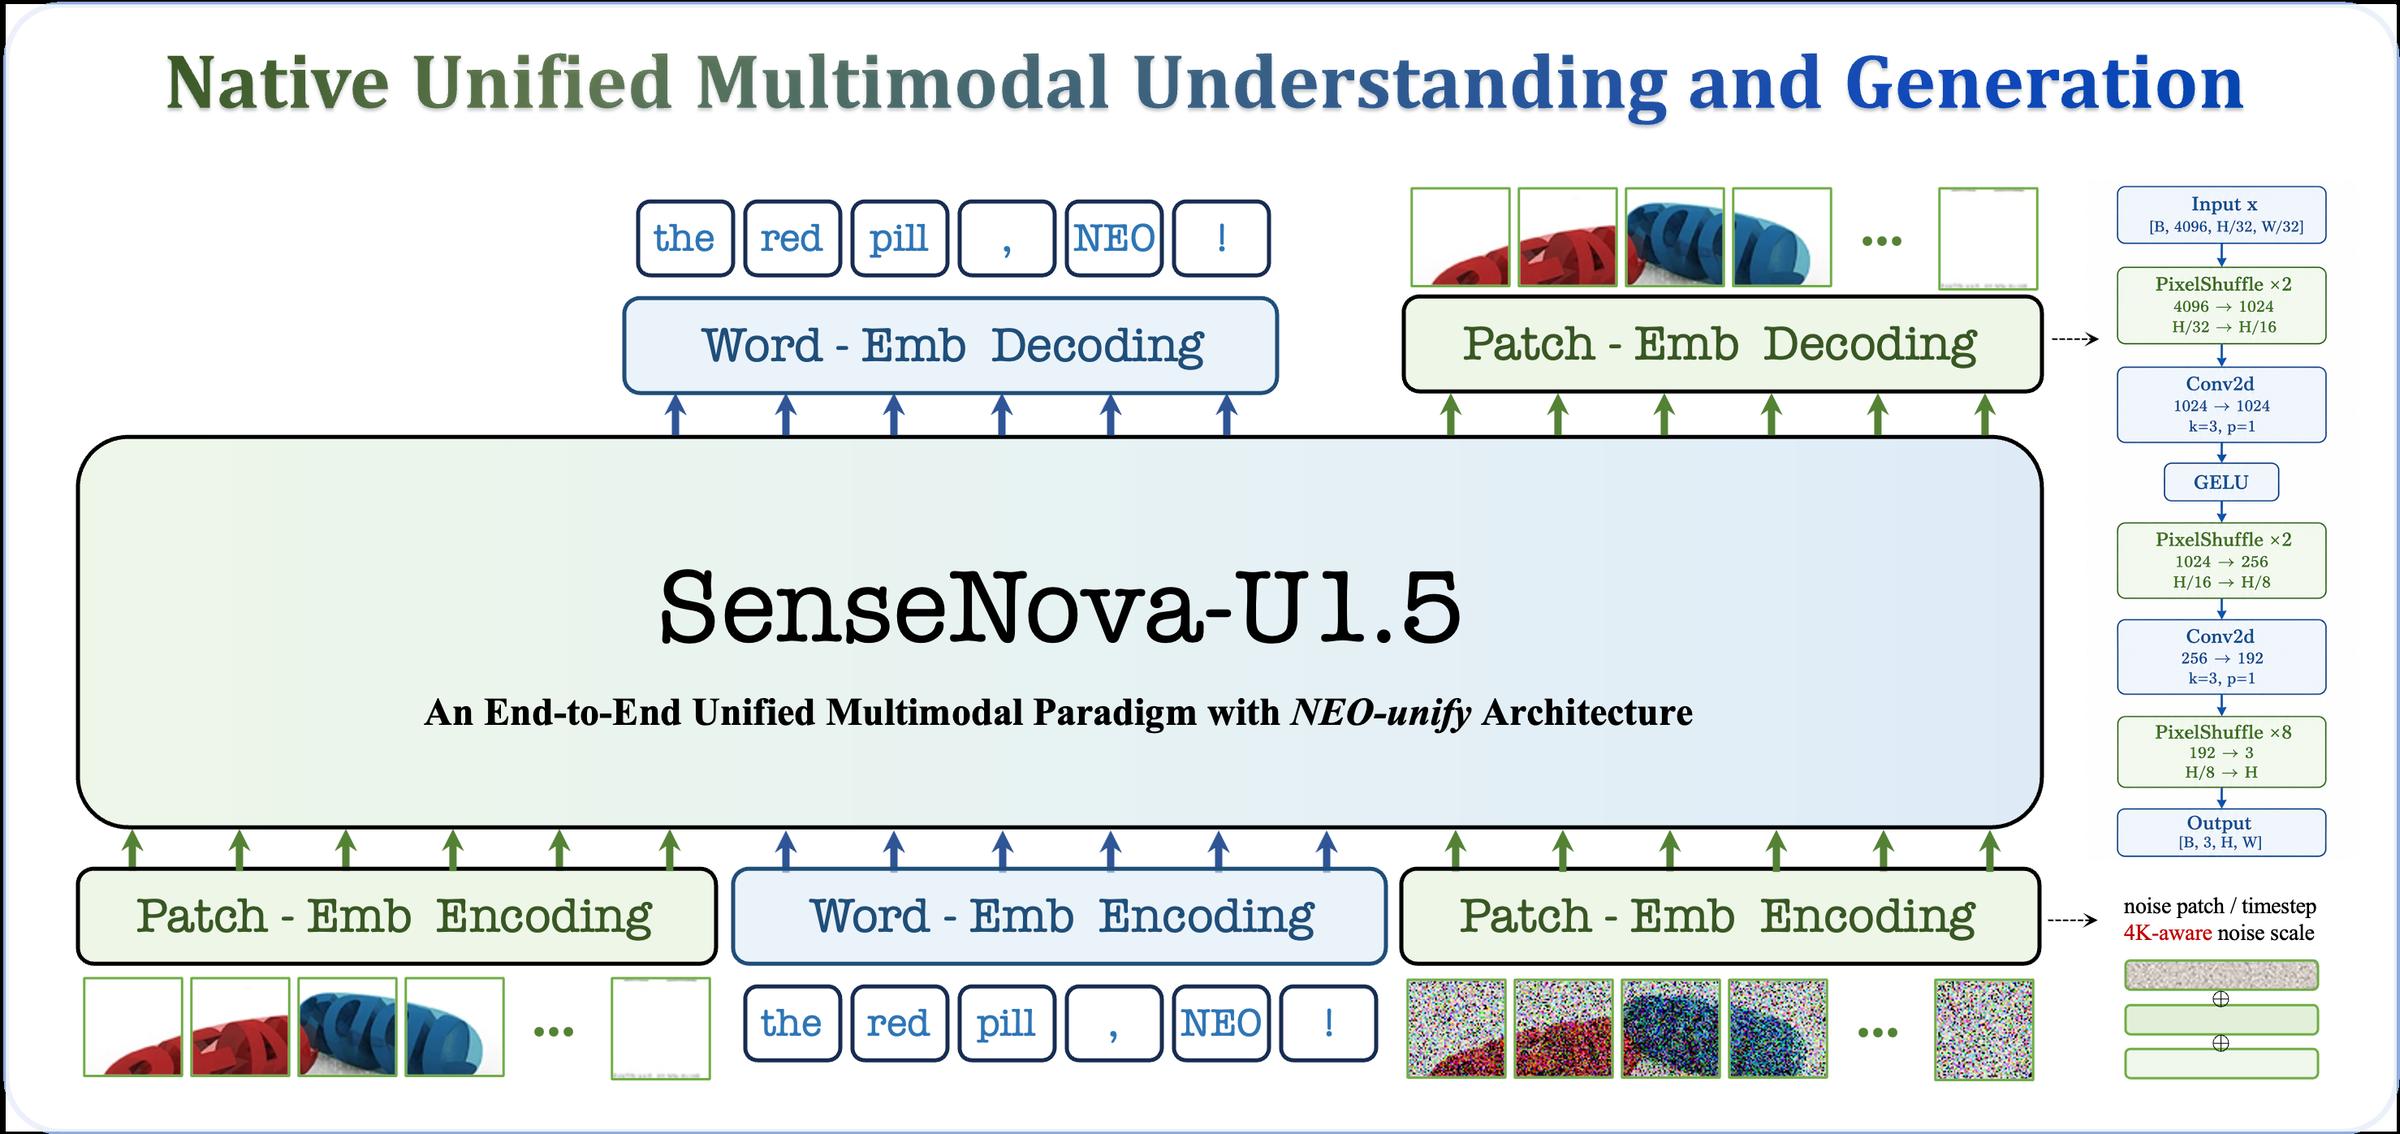
没有VAE意味着模型要直接吐像素。U1的做法是每个视觉token过一个MLP,独立还原自己那32×32的块。低分辨率还好,图一大,块与块的接缝、纹理断裂、几何错位就都出来了,报告在引言里承认了这一点。
U1.5换成一个轻量的空间解码头。先把token序列恢复成二维特征图,再经过三级Pixel Shuffle上采样,放大倍数依次是2、2、8,每两级之间夹一层3×3卷积。相邻token区域在像素定型之前先交换一次信息,边界处的像素由两边共同决定。
分辨率相关的噪声尺度是第二个支撑。像素空间做流匹配,同样的噪声强度在512的图和4096的图上效果差很远。模型把当前分辨率对应的噪声尺度除以4096参考值,过一个正弦MLP编进时间步嵌入,让去噪器知道自己在处理多大的图。
剩下的靠数据和训练阶段。高分辨率样本的占比前面说过,再加上专门的512²到4096²阶段,序列长度从8196拉到20480。三件事凑齐,无编码器路线才敢把原生分辨率写到4K。
四个专家各练各的
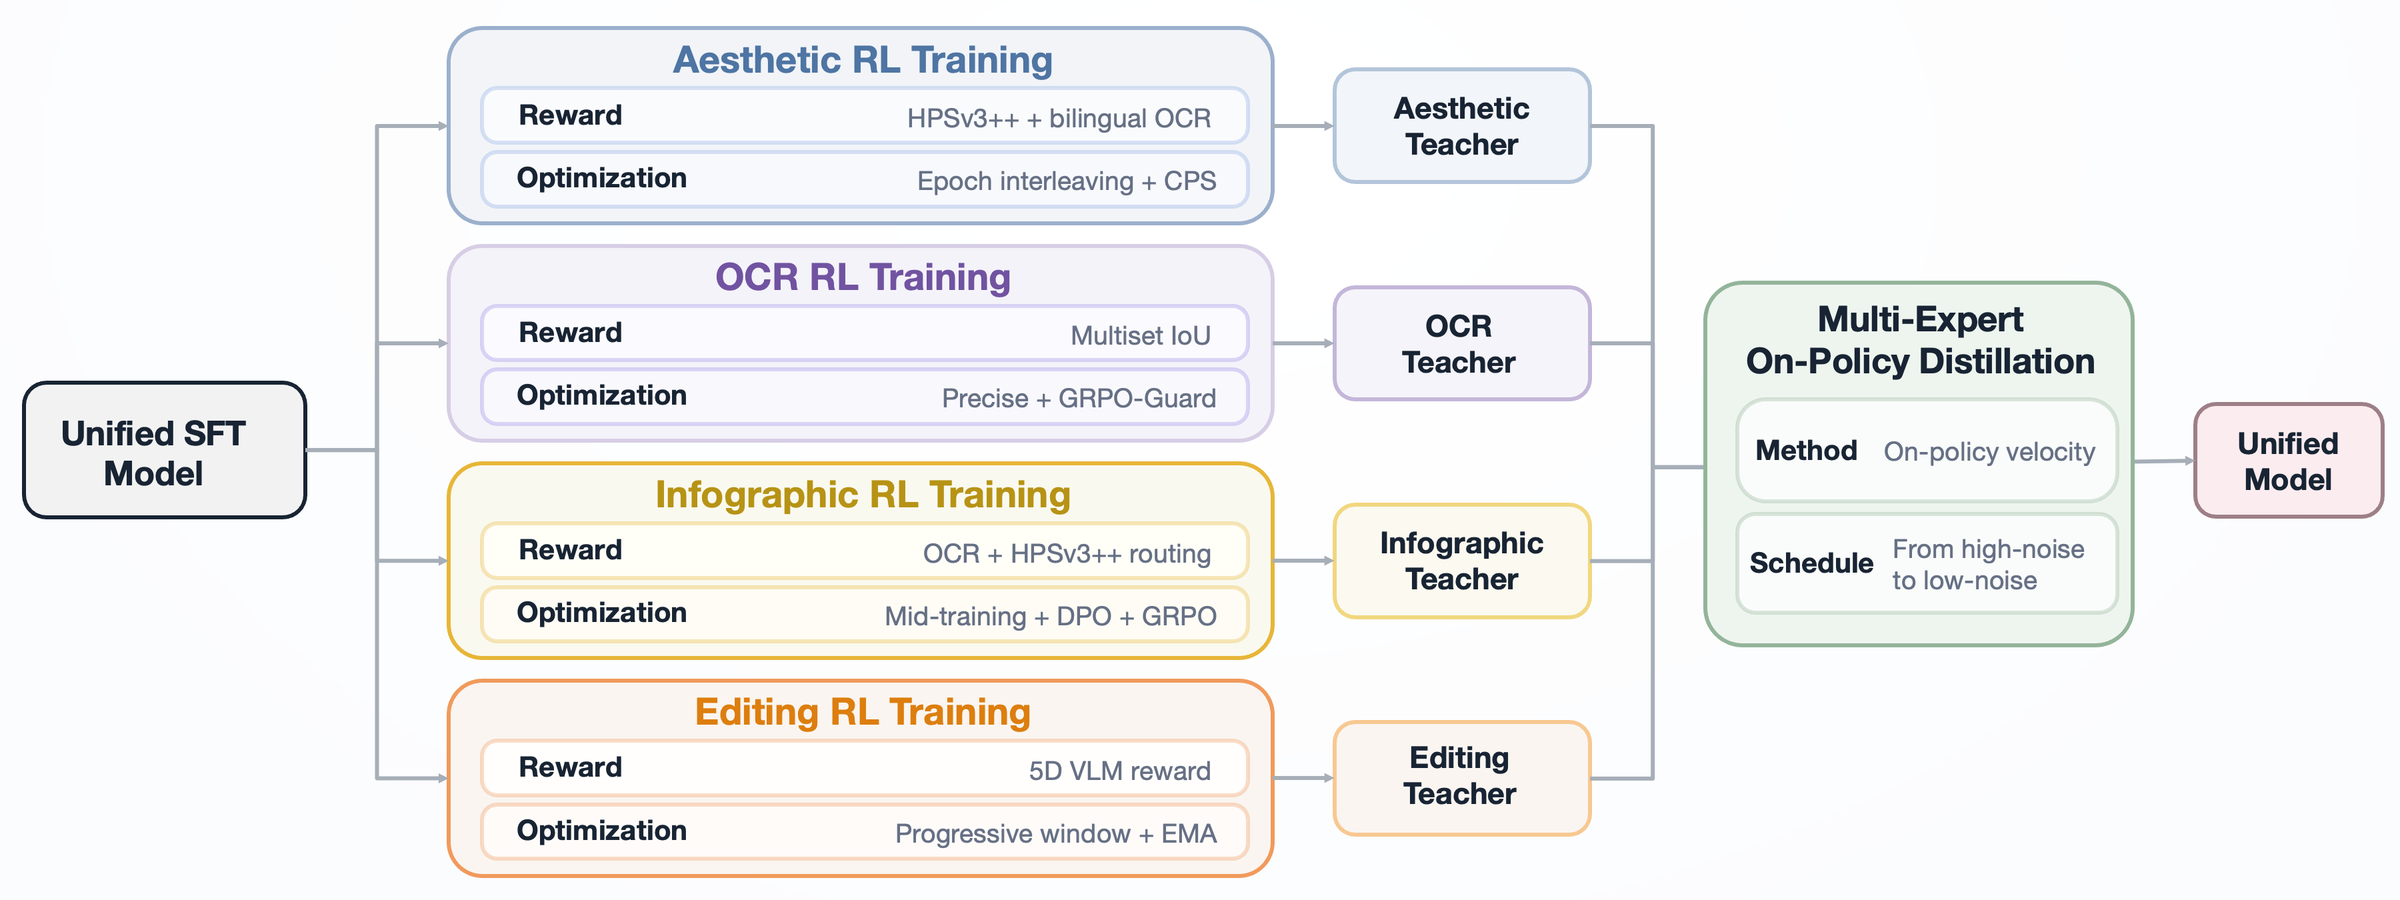
Stage 4训四个专家,美学、OCR文字渲染、信息图、编辑,起点都是同一个SFT模型,各有各的数据、奖励、采样器和正则。
美学专家用HPSv3++ 做偏好奖励。只优化偏好会把文字画糊,所以它的数据里逐epoch交替插入排版数据,排版样本走PaddleOCR奖励。每个prompt采16张,30步轨迹,引导系数4.0,用CPS采样引入随机性,每次更新只从前十步里取连续五步算梯度。
OCR专家的奖励是多重集IoU。把prompt里指定的文字和PaddleOCR识别出来的文字都拆成token,英文按词,中文按字,交集数量除以并集数量。漏字、多字、重复字都扣分,识别顺序乱了不受影响。它用Precise采样,η取1.5,再加GRPO-Guard压住稀疏高奖励下的过优化。
编辑专家的奖励是五个维度取最小值。指令完成度、编辑区域质量、整体画质、未编辑区域保持,涉及文字时再加一项文字编辑质量。哪一项最差,哪一项就决定这次采样的分数,一个维度做得好补不了另一个维度的洞。它不用SDE采样,rollout取24,学习率4e-5,带EMA。
信息图专家路子最长。先做一轮信息图定向的中期训练,然后三段后训练,第一段用OCR奖励热身,第二段拿约120K偏好对做DPO,第三段交替OCR数据和美学数据,分别路由到各自的奖励。两个分数始终不相加,也不做归一化。
四个专家在RL阶段都冻住生成分支最后一个Transformer块、流匹配输出头和输出归一化层。报告说这是为了压住奖励驱动的漂移。
把四个专家蒸回一个模型
Stage 5是这套配方的收口。四个专家全部冻住当老师。每条训练样本按能力类型硬路由到对应的那一个专家,一个epoch只跑一类数据,四类按固定顺序轮转。
蒸馏目标写出来很简单。学生先用自己的30步确定性ODE采一条轨迹,在轨迹上挑一个时间步,学生和老师在同一个状态、同一个时间步、同一个条件下各算一次速度场,两者的均方误差就是损失。轨迹本身加了stop-gradient,梯度不往回穿整条采样过程。
这就是on-policy的意思。老师在学生自己会走到的状态上给指导,不在老师自己的数据分布上。学生跑歪的地方恰好是老师能纠正的地方。
时间步怎么挑有讲究。第n个epoch从Beta(2+3n/N, 5-3n/N)里采查询位置,训练初期偏高噪声段,管全局结构,训练后期滑向低噪声段,管细节和文字。美学、OCR、信息图三个专家的速度场在CFG系数4下算,编辑专家用1,和推理时的设置对齐。
训练量不大。800个优化步,全局batch 128,每个领域25,600个样本,学习率2e-5。理解分支、生成分支最后三层和输出头冻住。轨迹算到被查询的那一步就停,后面用不到的部分不算。
成绩单,先看和U1的差
先把几个关键基准放在一起。GenEval考基础组合能力,CVTG-2K考多区域文字渲染,LongText-Bench考长文本,ImgEdit和GEdit-Bench考编辑,后者取英文赛道总分G_O。
| 模型 | 参数量 | GenEval | CVTG-2K平均 | LongText-Bench-ZH | ImgEdit | GEdit-Bench-EN G_O |
|---|---|---|---|---|---|---|
| SenseNova-U1.5 | 8B | 0.92 | 0.948 | 0.989 | 4.59 | 8.26 |
| SenseNova-U1 | 8B | 0.91 | 0.940 | 0.962 | 3.90 | 7.47 |
| Emu3.5 | 32B | 未报告 | 0.912 | 0.928 | 4.41 | 7.59 |
| Qwen-Image | 20B | 0.87 | 0.829 | 0.946 | 未报告 | 未报告 |
| Nano-Banana-Pro | 未公开 | 未报告 | 0.779 | 0.949 | 4.37 | 7.54 |
| GPT-Image-2 | 未公开 | 0.89 | 未报告 | 0.983 | 未报告 | 8.73 |
生成这边,U1到U1.5的提升不算大。GenEval从0.91到0.92,CVTG-2K从0.940到0.948,LongText中文从0.962到0.989。这几个榜U1本来就在前排,涨的空间不多。
编辑这边差距就明显了。ImgEdit从3.90到4.59,超过20B的FireRed-Image-Edit和Qwen-Image-Edit-2511。GEdit-Bench英文总分从7.47到8.26,语义一致性G_SC拿到9.15,开源里最高。编辑专家那套取最小值的奖励看起来起了作用。
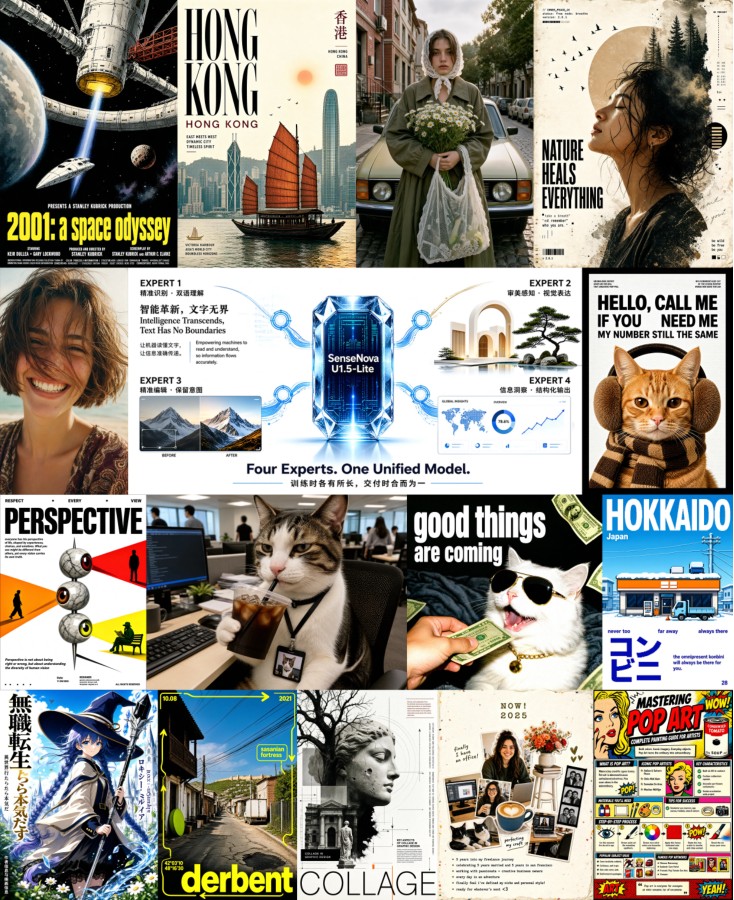
带提示增强的数字要单独看。Qwen-Image-Bench英文子集不带PE是52.82,带PE到60.22。BizGenEval困难集平均从51.4涨到72.2,其中知识维度从4.8涨到72.0。这个跳变说明信息图里的知识部分主要靠理解分支在前面做规划,生成分支自己没记住多少。
理解能力这边,报告说基本持平,我对了表3,几个主要项确实小幅回落。MMMU从74.78到73.86,MMMU-Pro从67.69到66.47,OCRBench-v2从61.30到59.07。语言侧倒是涨了,MMLU-Pro从81.44到86.67,IFEval从91.13到93.35。
输掉的项目
WeEdit上有两项很难看。翻译类编辑的指令遵循只有2.19 ,推理类编辑1.84,同一张表里Gemini-3-Pro-Image分别是8.08和4.91。报告自己承认,需要更深语言理解和上下文推理的编辑还差一截。
GEdit-Bench的画质分G_PQ是7.79,低于FireRed-Image-Edit的8.25和GPT-Image-2的8.31。指令执行得准,画面质感还没跟上。
Uni-MMMU的生成辅助理解平均分从U1-SFT的35.0降到29.6,迷宫任务从28.6掉到17.3。RL和蒸馏把生成质量推上去了,用生成中间图辅助推理这块反而退了。
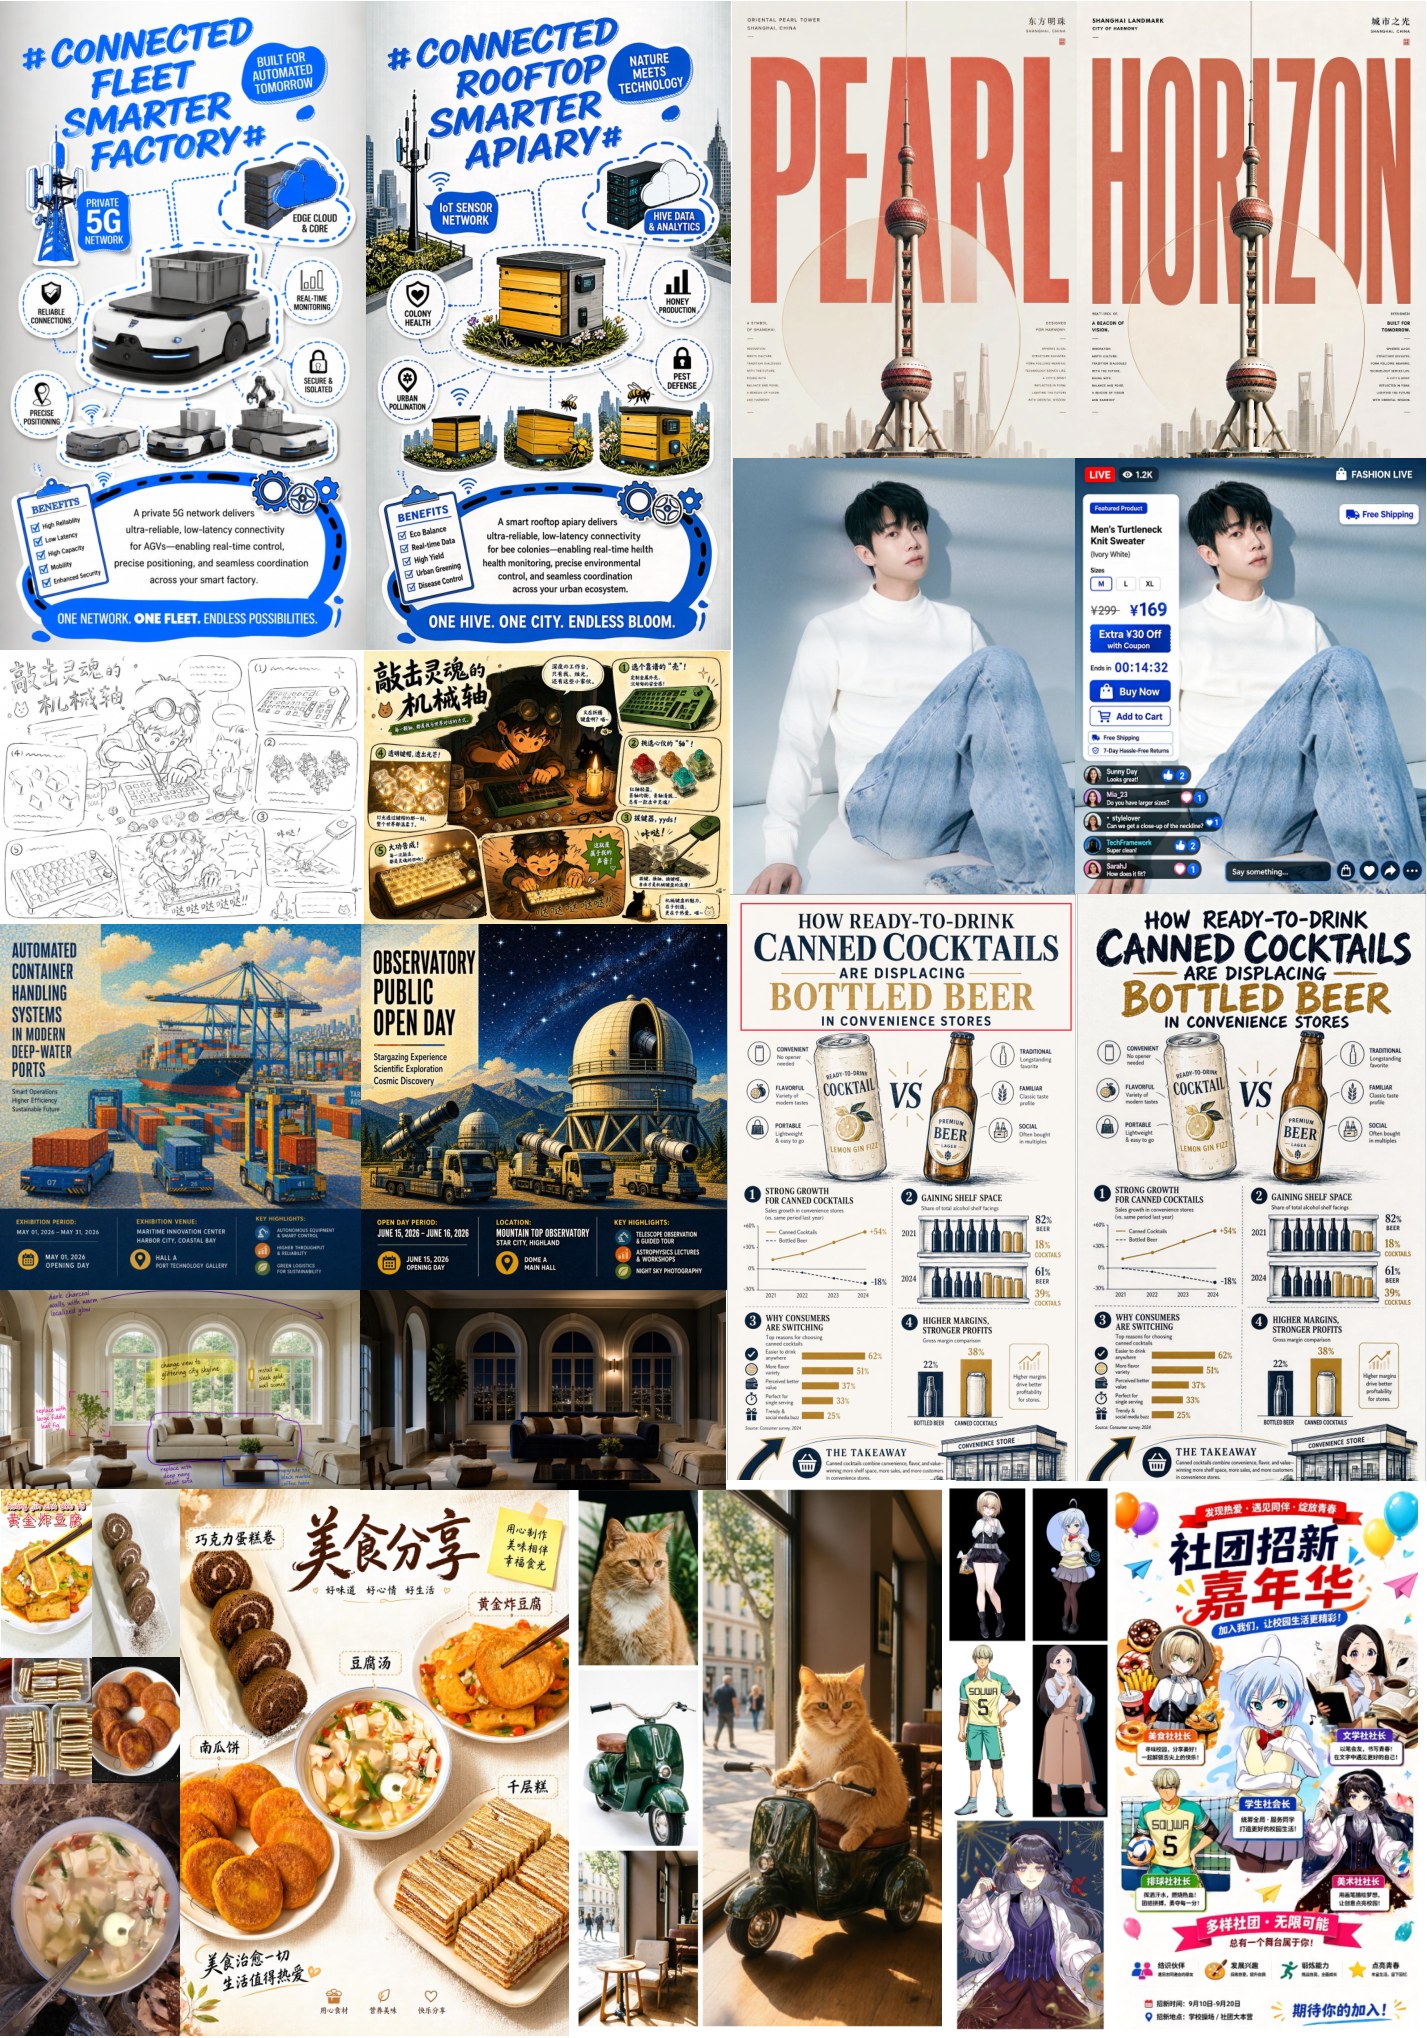
模型卡的已知问题栏也写得直接。高频细节和色彩会过饱和,建议调低cfg_scale。密集小字和中英混排仍会出错,小脸和手部不稳,多轮多参考编辑会漂。
本地跑一遍
权重在Hugging Face,Apache 2.0协议。我没有在自己机器上跑过这个模型,下面是GitHub仓库README和HF模型卡给的示例,显存和耗时不编。
bash
git clone https://github.com/OpenSenseNova/SenseNova-U1.git
cd SenseNova-U1
uv sync
source .venv/bin/activate
仓库环境是Python 3.11、PyTorch 2.8、CUDA 12.8。文生图和编辑各一条命令,来自HF模型卡。
bash
python examples/t2i/inference.py \
  --model_path sensenova/SenseNova-U1.5-8B-MoT \
  --prompt "A cinematic mountain lake at sunrise, realistic photography." \
  --width 2048 --height 2048 \
  --device_map auto \
  --output output.png

python examples/editing/inference.py \
  --model_path sensenova/SenseNova-U1.5-8B-MoT \
  --image input.png \
  --prompt "Change the jacket to cobalt blue. Preserve the face, pose, background, lighting, and framing." \
--output edited.pngREADME里U1的完整参数示例给了几个默认值可以对照,--cfg_scale 4.0、--timestep_shift 3.0、--num_steps 50,编辑还多一个--img_cfg_scale 1.0。引导系数4.0和时间步偏移3与论文RL阶段用的一致,推理和训练是对齐的。
默认分辨率2048×2048,宽高都要是32的倍数,可用的分辨率桶列在examples/README.md。编辑任务README建议先把输入图缩放到2048左右再喂进去。仓库另外放了一个8步LoRA,用法见docs/base_vs_distill.md,拿速度换质量。
几点看法
先分头训专家再蒸回来,这套配方对所有做多任务生成模型的人都有参考价值。四类任务的奖励尺度、采样器、正则都不一样,硬揉进一个策略里,最直接的后果就是某一项奖励把别的压掉。U1报告提到美学奖励偏爱深色背景,对OCR帮助有限,这就是奖励打架的证据。
蒸馏这一步的代价很低,800步、每个领域25,600个样本,比起四个专家各自的RL几乎可以忽略。它能省事的前提是专家和学生同构,速度场可以逐点对齐。换成别的架构,这个前提不一定成立。
4K这件事,我更倾向于把功劳记在解码头上。噪声尺度和4K数据U1时代就能加,接缝问题是结构性的,不换头解决不了。U1报告自己在Stage 5写了这个方向,U1.5兑现了,从这一点看两份报告是连着的。
短板也清楚。理解基准小幅回落,Uni-MMMU的生成辅助理解掉得不少,说明冻住理解分支只能保住理解本身,保不住理解和生成之间的配合。翻译和推理类编辑离闭源模型还有一大截,报告没说打算怎么补。
报告说训练代码会开源,含SFT、RL和OPD,兑现的话四专家蒸馏的复现门槛会低很多。
参考链接
- 技术报告原文 arXiv 2609.11929 v1,2026年9月
- 上一代报告 SenseNova-U1,arXiv 2605.12500,2026年5月
- 代码与推理示例 OpenSenseNova/SenseNova-U1
- 模型权重 sensenova/SenseNova-U1.5-8B-MoT,模型合集
- 架构博客 NEO-unify,2026年3月
- 对比方案 Qwen-Image、Emu3.5
- 基准 GenEval、ImgEdit、GEdit-Bench