把 Agent 从 demo 变成常驻服务,出事最多的地方在运行时和部署这一层。本地跑得好好的 demo 推到线上,并发一上来内存往上顶、请求开始排队,日志里冒出来的却是运行期才发现的参数解析错误。到了这一步,问题大多不在模型。
我最近在挑 Agent 的运行时,翻到了 ADK-Rust。文档从头读了一遍,读到后面发现它正好压在我这几个条件上。
一、Python 的 Agent 一上生产就难受在哪
我最早的想法很粗糙,Python 慢。真去拆开看,这五点里只有一条跟 CPU 速度有关,而且都是我和同行碰过的通用机制,不是哪一家的实测数据。
先说最容易撞上的那条,内存。demo 阶段感觉不到它,是因为进程活得不长。CPython 解释器自己有内存底噪,依赖树里挂着一堆对象缓存,每轮请求还要复制临时数据。一个上午跑下来没什么感觉,挂成常驻服务,内存曲线就压不平了。
紧接着是请求排队,也就是常说的并发弱。CPU 密集的编排、序列化、解析都卡在 GIL 上,并行不起来,Agent 一多只能横向加机器,机器加完成本就上去了。
这两条最后会转成同一个问题,长驻进程的稳定性、扩缩容、故障恢复都得自己补工程。这就是「不适应常驻服务」的由来,它是前面几条叠出来的结果,不是单独的一条毛病。
还有一条藏在交付物里。虚拟环境、依赖锁文件、镜像分层,最后交出去的是一棵依赖树,环境差异经常拖到上线当天才露出来。部署重,重在这里。
最坑的是运行时报错。动态类型没有编译期约束,工具参数写错、事件字段改了名,本地跑不出来的问题,只有真实请求走到那一行才会炸。前面几条是花钱,这条是半夜被叫起来。
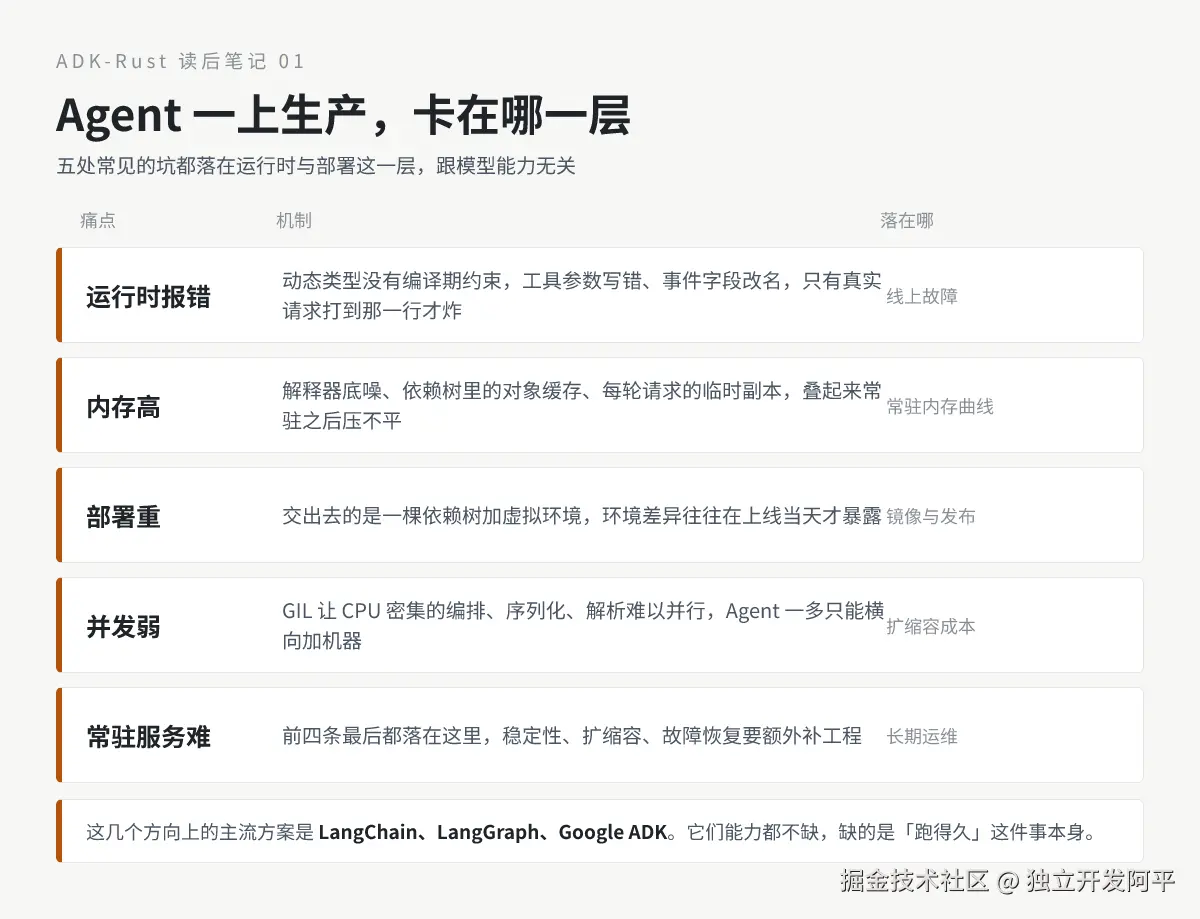
这个方向上主流的方案是 LangChain、LangGraph、Google ADK,能力都不缺。缺的是「跑得久」这件事本身。那 Python 就不该写 Agent 吗?原型阶段它还是最省事的选择,变的是评价标准,从能不能跑通,变成崩溃率高不高、内存稳不稳、部署烦不烦。
那为什么现在值得看 Rust 这边?我不太信别人给的数字,只看能自己打开链接核对的信号。协议在标准化,MCP(来源 modelcontextprotocol.io)把工具接入统一成一套,A2A 管智能体之间的通信。托管式平台陆续出现,需求从「有没有」转向「能不能运维」。部署形态也在变,Agent 的交付物越来越多是常驻服务和容器。
我把它写成一版零基础向的读法,先把概念讲清,再盘核心能力、架构分层、适用场景,最后和 Python 主流框架做一次对比。
二、关键科普,ADK-Rust 到底是什么
项目自述写的是 a production-ready Rust framework for building AI agents。这句话很顺,顺到每个词都能被误读,我逐个核了一遍。
Rust 原生,说的是核心就是 Rust,中间没有跨语言桥接层。模块化,43 个可发布 crate 按职责拆开,用哪块引哪块。生产级,我的理解是可编译、可部署、可观测地跑常驻服务,跟功能多是两回事。模型无关,README 写的是 model-agnostic,模型客户端可以换,换 provider 不用改 Agent 和工具。部署无关,写的是 deployment-agnostic,产物是二进制,不绑任何托管平台。类型安全,模型调用、工具入参、状态流转、事件结构都有类型约束。异步,跑在 tokio 上。
按需引入的粒度有 minimal / standard / enterprise / full 四档,最小那档只有 Agent、Runner 和会话,最大那档带实时语音、浏览器、RAG、支付、AWP。四档只是起点,任意一档上都能再单独加能力,README 举的例子就是 minimal 配 audio。
那它跟 Google 是什么关系?这里最容易误会。它不是 Google 官方项目。Google ADK 是 Google 自己的东西,ADK-Rust 由社区组织 zavora-ai 维护并独立发布,README 里只把 Google 的 ADK 放在 Related 一栏,两者没有隶属关系。
把 Agent 从动态脚本变成可编译、可审计、可高性能部署的工程系统,是它跟 Python 系框架最实的一处差别。差别先出在错误暴露的时机上,动态脚本要等运行期请求打到才炸,这边编译期就会拦下类型和字段不匹配。其次是状态看得见多少。那边靠散落的日志和 print,这边跑出来的是一条条事件,能回放也能追踪。交付物差得更远,那边要带解释器和依赖树,这边 cargo 编出来一个单二进制就能跑。
成熟度我会先看有没有跨过从工具库到运行时的那条线。官方在 v2.0 的里程碑里给过一组数字,42 个 crate,4,300+ 测试,104 个可运行示例。当前稳定版是 v2.2.0,README 说这是一次 API 兼容的小版本,补齐了 Gemini Enterprise Agent Platform 的消费路径,包括评测服务桥接、Vertex RAG 检索、Agent Registry 发现、远程 ReasoningEngine 当子 Agent 调用,全部按需开启。从 1.x 过来有六个 API 改了形状,配了迁移指南,看得出 v2 不是改个版本号。
「完整的 Agent 运行时」这个说法是我读完 crate 列表后的判断。
三、类型安全到底拦得住什么
强类型这四个字最容易写成空话,我花在这上面的时间最多。
核下来有三处落点。模型调用这一层,请求和响应都是 Rust 类型,不再是随手拼的字典。工具入参这一层,#[tool] 从函数签名推导 JSON Schema,README 的原话是 derives the JSON schema from your argument type。状态和事件这一层,会话状态、事件载荷都是类型化结构。
类型安全拦的是结构不匹配这类错误,业务逻辑错误和模型幻觉它一样拦不住。
模块化又拆到什么粒度?翻完 crate 表,我看到的是两层。第一层是 crate,43 个可发布 crate 各管一段,adk-core 放基础 trait 和类型,adk-runner 管上下文管理、事件流、会话生命周期和回调,adk-model 管 provider 接入,adk-graph 管图编排。第二层是 feature,minimal / standard / enterprise / full 四档之上还能叠单个能力。
toml
[dependencies]
adk-rust = { version = "2.2.0", features = ["minimal", "audio"] }
只引需要的能力,编出来的东西才可能一直很小,这对常驻服务很关键。
事件驱动听起来空,我去看了事件里到底装了些什么。README 提到 runtime UI 会展示事件时间线、状态、artifact 和 telemetry,adk-telemetry 负责 OpenTelemetry 追踪。一次运行里跑的东西,大致是模型请求、工具调用、状态变更、多智能体协作这几类。回放能力在实验性的 adk-managed 里,属于实验特性,我没把它算进稳定能力。
最后说协议。MCP、A2A、AWP 经常被混着说,我把它们分开核过。MCP 管工具与资源接入,README 写明基于 rmcp 3.1,客户端和服务端都提供。A2A 管智能体间通信,README 里标的是 A2A v1.0.0。AWP 的全称是 Agentic Web Protocol,负责发现、清单、信任级别与同意,这几个词都来自 README。
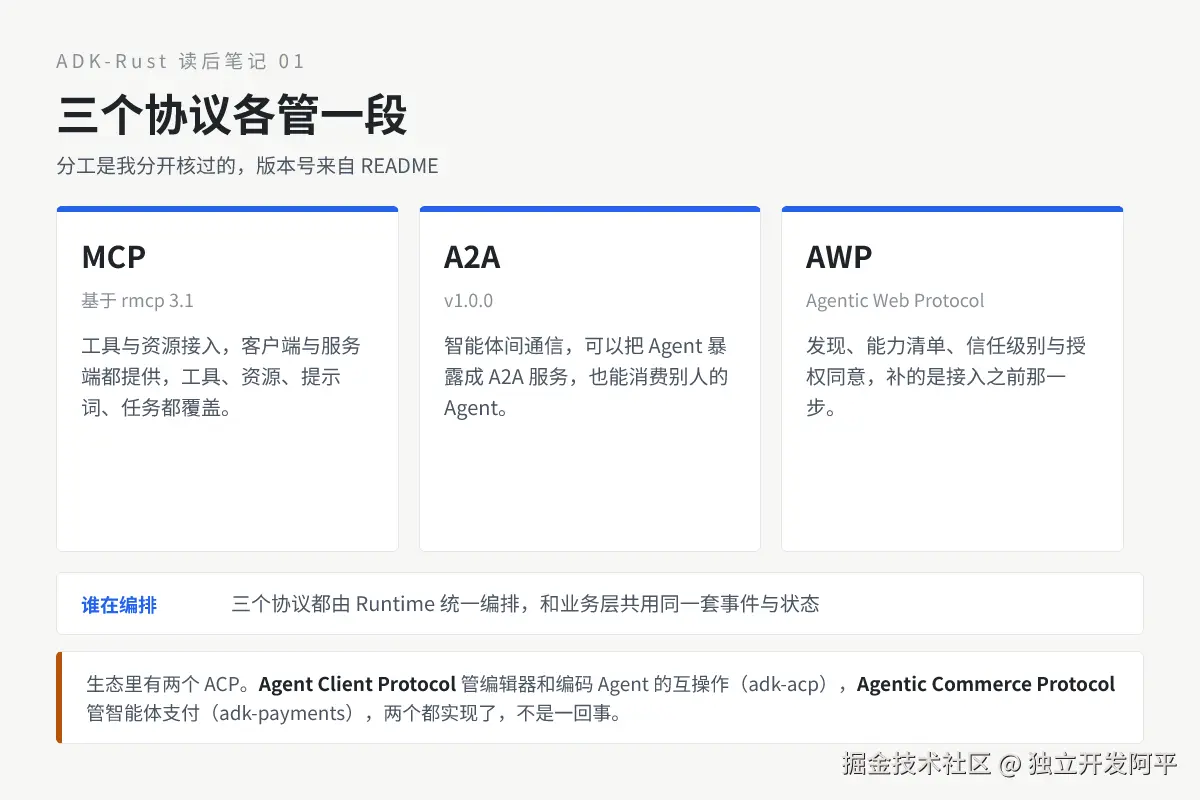
生态里还有两个容易撞到一起的名字。Agent Client Protocol 是编辑器和编码 Agent 的互操作协议,对应 adk-acp。Agentic Commerce Protocol 是智能体支付协议,在 adk-payments 里和 AP2 一起处理。两个都实现了,但完全不是一回事。
四、核心能力里哪些真用得上
我按用法理了一遍。
单 Agent 推理和工具调用用 LlmAgent,README 的示例代码里用 LlmAgentBuilder 组装。工作流就是 Workflow Agent,串行、并行、循环三种编排都是确定性的,走的是固定拓扑。图编排是 Graph Agent,对应 adk-graph,README 的说法是 LangGraph-style orchestration,支持检查点、可恢复、人在回路、子图,下一步可以取决于运行时状态。实时语音是 Realtime Agent,走 adk-realtime,接的是 OpenAI Realtime 与 Gemini Live。多智能体系统用 TeamSpec 和 CompiledTeam 定义可移植团队,这句是 README crate 表里的原话。
工程能力我挑几个关键处看。强类型工具调用,#[tool] 从 Rust 参数类型推导 JSON Schema。持久化状态管理,adk-session 的内置后端有内存、SQL、Redis、MongoDB、Firestore、Neo4j 和 Vertex AI,图编排的检查点支持内存、SQLite 和增量三种,README 说进程重启后可以在新进程里接着跑。边界得说清,README 在成本那一节写了没有自动崩溃恢复,长任务得应用层自己拉起,恢复的前提是状态确实落了盘。插件中间件是 adk-plugin,提供 EnhancedPlugin、优先级管线和 PluginContext,模型与工具的拦截、生命周期钩子都从这里走。可观测由 adk-telemetry 负责,OpenTelemetry 追踪加结构化日志。
部署这块我看得最重。产物是单二进制,不需要 Python 运行时和虚拟环境,进容器和边缘设备都轻。README 的 quickstart 是 cargo run 起来之后用 curl -fsS http://127.0.0.1:8080/api/health 探活,要发布产物就用 cargo build --release。
跨模型兼容我核了 provider 清单。README 内置的是 Gemini、OpenAI(含 Responses API)、Anthropic、DeepSeek、Groq、Ollama、Bedrock、mistral.rs,另有 Fireworks、Together、Mistral、Perplexity、Cerebras、SambaNova、xAI 这些 OpenAI 兼容预设。云端接 API,本地走 Ollama 或 mistral.rs,换 provider 不用改 Agent 和工具的代码。
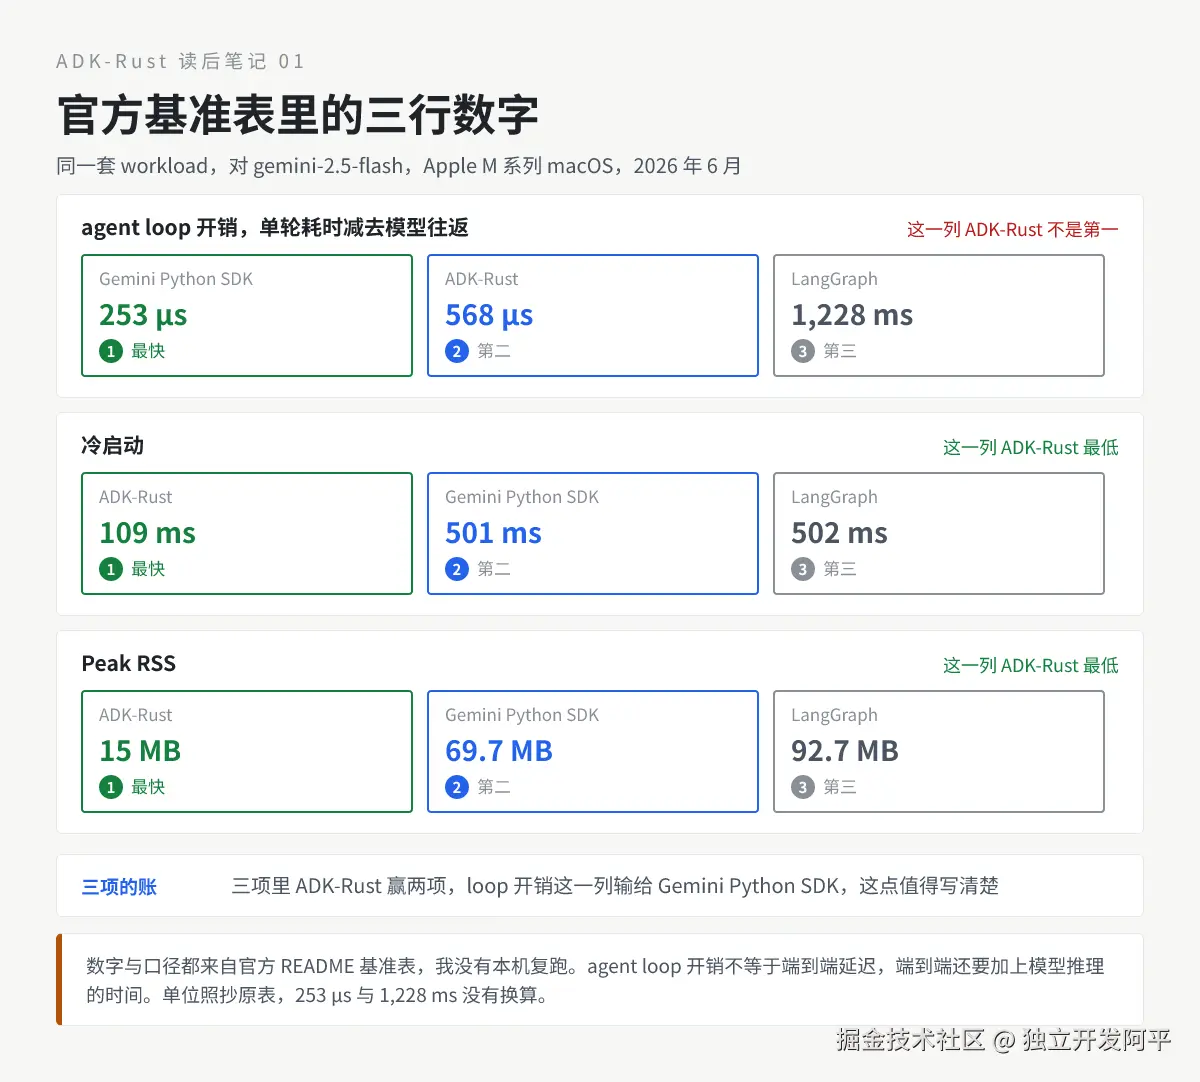
性能上官方给了一张基准表,agent loop 开销 568 μs,冷启动 109 ms,Peak RSS 约 15 MB。
五、五层架构,我自己这么分
这一节是我按 crate 划分整理的读法,不是官方架构图。
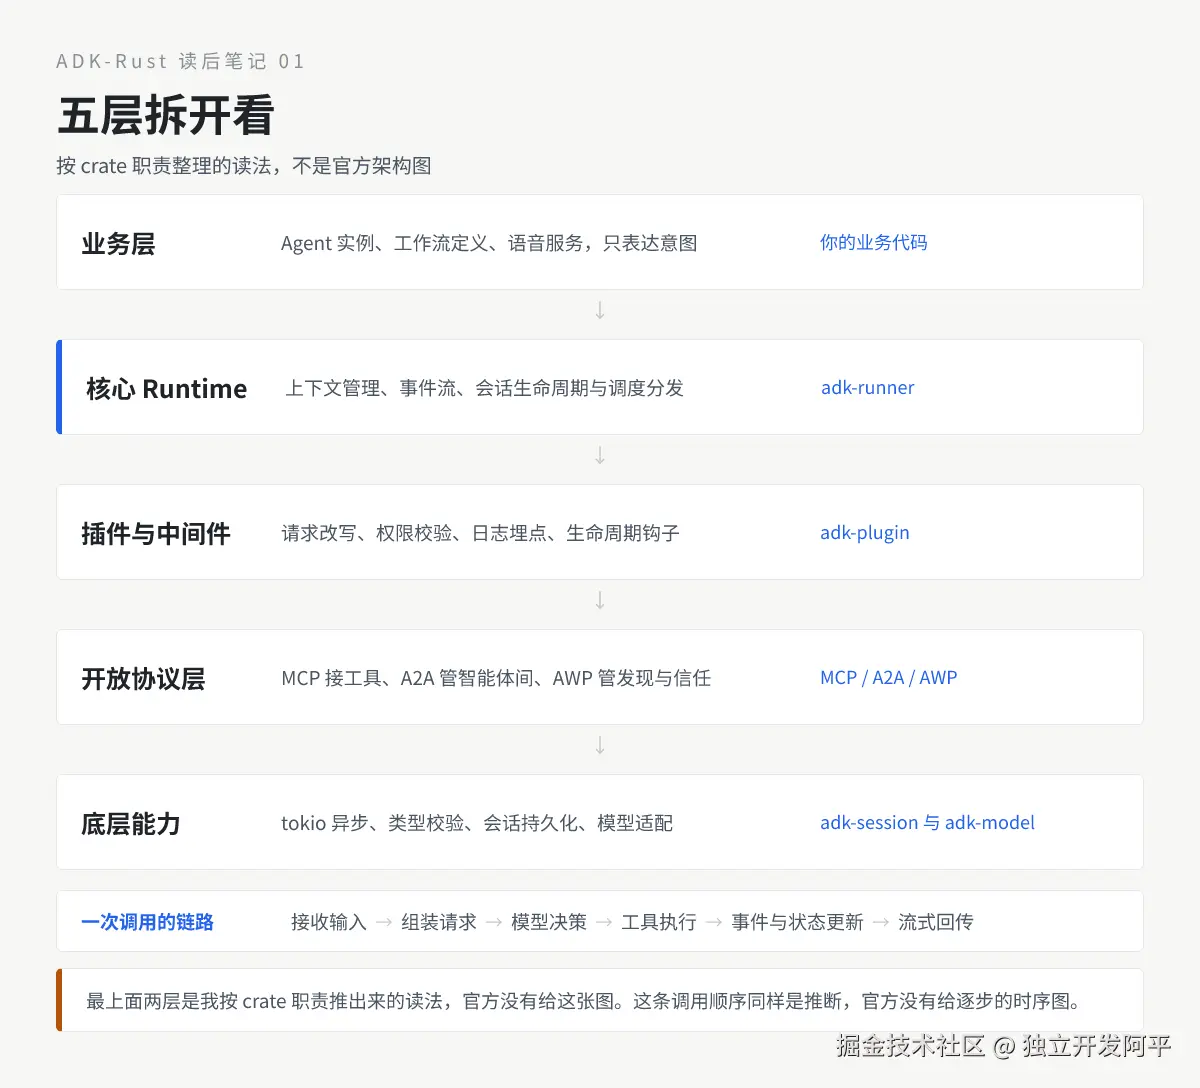
这五层是我把 43 个 crate 压成五格的结果,换个人来分,边界大概会挪。
最上面是业务层,放 Agent 实例、工作流定义、语音服务。它只表达意图,谁来回答、按什么顺序执行、什么时候转人工。模型请求重试和状态存储都不直接归它管,换运行时的时候业务代码不用重写。这一层是我从 crate 职责推出来的。
中间是核心 Runtime,也就是 adk-runner。README 给它的职责是上下文管理、事件流、会话生命周期和回调。一次运行产生的事件流有两个去处,喂给 runtime UI 渲染时间线,也喂给 telemetry 导出追踪。它手里的活我数了五件,模型请求、工具执行、状态管理、事件分发、多 Agent 协调。
一次调用经过哪些环节?按 README 的事件流描述推一遍。先接收输入,接着组装请求,模型决策,工具执行,再落到事件与状态更新,最后流式回传。每一步都产出事件,卡在哪儿是看得见的。这个顺序是推断,官方没给逐步的时序图。
插件与中间件层解决的是不改核心就能加行为。adk-plugin 提供 EnhancedPlugin 和优先级管线,共享 PluginContext,模型与工具的拦截、生命周期钩子都挂在这儿。请求改写、权限校验、日志埋点这些场景,README 没有逐条举例,我只确认了拦截点本身存在。
再往下是开放协议层,MCP 接工具与资源,A2A 把 Agent 暴露出去或者消费别人的 Agent,AWP 管发现与信任。三个接口都由 Runtime 统一编排,和业务层共用同一套事件与状态。
最下面一层撑着前面所有能力。异步调度用 tokio,类型校验贯穿模型、工具、状态和事件,持久化交给 adk-session,模型适配交给 adk-model,安全与鉴权在 adk-auth 里做 RBAC、SSO 和审计日志。
六、和 Python 主流框架对比,差在哪
真到选型那一步,问题会按顺序冒出来。
最容易出事的是崩溃。这一条的份量取决于你的服务多久重启一次。短命进程里,运行期错误顶多让人多翻两眼日志,常驻服务里它就是半夜那通电话。Rust 在编译期就能拦截参数类型不匹配、事件结构缺字段这类问题,Python 要等运行期请求打到才暴露,差别只在错误暴露的时机。业务逻辑错误、模型幻觉、外部 API 抖动,类型系统一样拦不住,别指望换个语言事故就没了。
性能这块,数字要带口径。README 的基准表用的是 agent loop 开销,定义是单轮耗时减去模型往返,测试对象 gemini-2.5-flash,同一套 workload,跑在 Apple M 系列 macOS 上,时间是 2026 年 6 月。ADK-Rust 568 μs,LangGraph 1,228 ms,Gemini Python SDK 253 μs。冷启动分别是 109 ms、502 ms、501 ms,Peak RSS 大约 15 MB、92.7 MB、69.7 MB。三项里 ADK-Rust 赢两项,loop 开销那一项输给 Gemini Python SDK。
568 μs 不等于端到端延迟,端到端还要加上模型推理的时间,这个数字量的是框架自身的开销。内存的优势我理解为没有解释器和依赖树打底,对象生命周期在编译期定下来,异步调度少一层跨语言开销。上线前建议自己跑一遍 bench,README 也给了 cargo adk bench --dry-run 做成本预估。
运维要补多少,看你要的能力是不是原生。状态持久化与恢复靠会话和检查点,可观测靠 OpenTelemetry 追踪加结构化日志,鉴权体系有 RBAC、SSO、审计日志,配 guardrail 做输入输出校验。这些在 README 的 crate 表里都是原生的。Python 侧大多拼得出来,拼装成本和一致性得自己承担。
交付物比的是最后交出去什么。Python 交出去的是代码加虚拟环境加依赖树,镜像里得有解释器。Rust 交出去的是单个二进制,镜像可以不含解释器。构建就是 cargo build --release,运行前把 provider 的 key 配上。
生态方面。Python 生态在第三方集成和人才储备上更广,这是我作为使用者的判断,短期内不会变。ADK-Rust 的优势集中在生产高性能和常驻服务这类场景。选它的理由不该是 Rust 更高级,而是你的场景刚好压在这几个点上。这一点我也未必看得全,两年后回头看可能会改。
七、什么场景适合用
判断依据其实就一条,你的 Agent 是不是要长期在线。
线上常驻的 Agent 服务、高并发接口,收益最直接,单二进制部署、内存占用低,扩缩容的副本成本跟着降。边缘设备和轻量化容器走的是同一个道理,没有解释器和依赖树,镜像能小一圈。对稳定性、内存、安全性要求高的企业级 Agent,看中的是编译期类型约束,加上 RBAC、SSO、审计这些原生能力。要做复杂多智能体编排和任务流转,图编排的检查点、可恢复、人在回路和子图能对上。实时语音、流式交互这类需求,adk-realtime 能接 OpenAI Realtime 与 Gemini Live。
不适合的两个场景也说一下。快速临时 Demo、一次性脚本验证,Rust 的编译和类型成本在一次性场景里收不回来,这是原因。需要极丰富第三方插件生态的快速开发,大概率会碰到 Python 有现成集成、Rust 要自己写的情况。这两条是我的判断,不是官方给的选型建议。这条界限会不会随生态变化而移动,我拿不准。
八、回到开头那五条
这些年 AI Agent 开发从快速原型走向工程化、高性能、可运维,我的观察是评价标准跟着换了。原型阶段比谁先跑通,上了生产比谁更少崩、更好扩展、更好查。
开头疼的那五条,现在逐条有了着落。稳定性上,编译期类型约束把一部分错误从线上挪回构建阶段。性能上,没有解释器开销,内存占用也低,README 的基准表里这两项确实是它领先的地方。生产可用性对应的是状态持久化、可观测、插件与鉴权这些原生能力,衡量的是能不能长期运维。并发弱和部署重会随着交付形态一起缓解,单二进制不需要依赖树,异步调度也不受 GIL 限制。
但换了语言,问题不会消失。业务逻辑、模型幻觉、外部依赖抖动,还是得靠工程手段解决。
下一篇走实战线,用 cargo-adk 脚手架搭一个能跑的类型安全 AI Agent Demo,把 #[tool]、provider 配置、事件流和会话持久化走一遍。那篇以本机真实运行的结果为准,跑不通的地方如实写出来。
我没有本地编译过 ADK-Rust 工作区,也没跑过它的 bench,这篇里的数字全部来自官方 README 与 crates.io 接口,核对时间 2026-09-16。
你现在的 Agent 服务,最卡的是哪一步?评论区聊聊。