导语:持续学习中的灾难性遗忘,是机器人走向长期自主部署的核心障碍。经验回放(Experience Replay)是最常用的缓解手段,但过去大家关注的是"缓冲区多大",而不是"里面装了什么"。斯坦福宋舒然团队的最新工作揭示了一个反直觉的事实:回放缓冲区里极少数"看起来像新任务、动作却完全相反"的旧样本,承担了不成比例的防遗忘作用。排除这些样本,遗忘会放大4.5倍以上;定向增加它们,高冲突任务对的遗忘可降低63%。
一、问题:为什么回放缓冲区"够大"还不够?
一个机器人已经学会逆时针拧开罐子,现在要学顺时针开另一个外形相近的罐子。新任务可以复用"靠近罐盖、夹住、抬起"这些旧经验,但在接触罐盖的那一刻,两个任务要求的动作恰好相反。
顺序训练如果只顾新数据,旧策略就可能被覆盖。这就是灾难性遗忘。
Experience Replay(ER)是最直接的缓解办法:保留一小批历史数据,和新数据一起训练。论文用Negative Backward Transfer(NBT)衡量遗忘------一个任务学会后,随着后续任务加入而损失的平均成功率。NBT越低,旧任务保持得越好。
过去的讨论常围绕"缓冲区要多大"展开。这篇论文把问题推进了一步:容量相同的两个缓冲区,里面装了哪些旧样本,可能同样决定结果。
作者做了两个关键的受控实验:
实验一:对比两种随机回放策略。FixedER按轨迹采样,样本彼此相关;RandER按transition均匀采样,每个新任务前重新抽取。两者平均NBT接近,但RandER在LIBERO四套十任务序列上的任务间遗忘方差低36%,最坏遗忘低25%。
实验二:固定旧策略检查点、训练顺序和新任务,只更换RandER抽到的历史样本。同一个旧任务的最终遗忘幅度仍能相差最多20%。
这说明:随机回放之所以有时稳、有时失手,不只是训练噪声,而是缓冲区有时碰巧覆盖了某些更有约束力的数据。
二、核心发现:遗忘是稀疏的,集中在"表征重叠、动作冲突"的任务对
作者把平均NBT拆解为逐个任务对的交互后,发现遗忘呈现出极强的稀疏性。
在LIBERO-Goal的三种训练顺序中:仅两个旧任务就贡献了超过一半的总负向后向迁移;80个任务交互里,最冲突的5对平均令成功率下降约20%,其余75对平均反而回升约0.1%。
最典型的例子是"把奶油奶酪放进碗里"与"把碗放到盘子上"这对任务。前一个任务学会后,训练后一个任务会让它平均损失24%成功率,约为LIBERO-Goal平均NBT的5倍。失效后的策略会伸手抓碗,而不是抓奶油奶酪。
这对任务为什么冲突?两个条件同时成立:
-
输入表征相近:两个任务的场景、物体和语言都相似,旧策略把部分新任务观测压进了旧任务的潜在空间;
-
输出要求相反:重叠区域里的正确动作并不相同------伸向奶油奶酪还是伸向碗。
输入表征相近、输出要求相反,新任务的梯度就会改写旧任务正在使用的共享参数。
随机缓冲区如果恰好带回冲突区域附近的旧样本,这些样本便会在新任务训练时提供反向约束:这里虽然长得像新任务,旧动作仍必须保留。这就是Memory Anchor中"锚"的具体含义------它锚定的不是整项任务,而是最容易被新任务覆盖的局部决策区域。
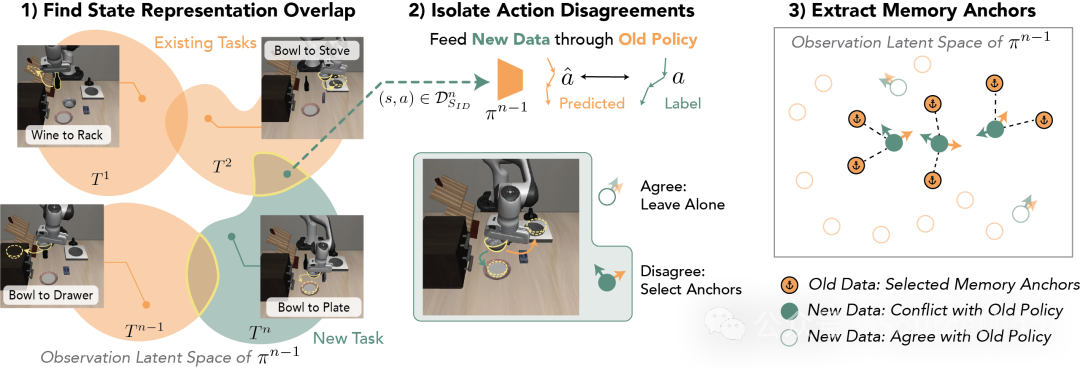
三、技术路线:三步定位Memory Anchors
提取过程发生在学习第n个任务之前。输入包括:历史数据、新任务数据、只学过历史任务的旧策略。输出是从历史数据中挑出的Anchors。
算法不直接用任务名称判断冲突,而是读取旧策略自己的表征和动作预测。
第一步:寻找观测表征重叠
把视觉特征、语言嵌入和本体感知拼成observation latent。对每个新样本,计算它到全部旧样本的最近邻、1%、5%和10%距离统计,形成一个四维向量。
这些向量经过二类KMeans聚类,平均距离更小的一簇被视为落在旧数据流形内的新任务区域。
选聚类而非固定阈值,是因为不同任务之间的天然表征距离并不一致------同一个数值阈值很难同时覆盖同质和异质任务。
第二步:从重叠区域中排除"动作兼容"的样本
这是整个方法最关键的过滤步骤。
对于标签动作a,先加入高斯噪声,再让旧扩散策略从这个带噪动作出发去噪,得到重建动作。从纯噪声重新采样可能把多模态动作误判成冲突;在真实标签附近加噪再去噪,可以保留动作的大方向。
用旧任务验证集估计分歧均值μ与标准差σ,只保留动作分歧超过阈值的新样本。
这一步的意义:如果跳过它,"伸向同一物体"这类新旧任务共有的子轨迹也会被大量检索,缓冲区容量就会浪费在新任务数据本身已经覆盖的区域。
第三步:反向搜索历史数据
对每个旧样本,计算它到新任务高分歧集合的k个最近邻的距离,以中位数作为分数。分数最低的旧样本,就是与即将发生的冲突最接近的Memory Anchors。
选出的不是一般意义上的"最典型旧样本",而是最需要在当前新任务训练中被再次看见的旧样本。
四、AnchorER:只改缓冲区构成,不改回放算法
在普通ER之上,AnchorER只做了一个改动:预留10%或20%容量放入刚提取的Anchors,其余位置仍由旧数据随机填充。
这保留了随机样本带来的状态覆盖,又提高了冲突区域的密度。
这个设计让论文可以做一组对称实验:先拿走Anchors看遗忘是否恶化,再主动加回更多Anchors看遗忘是否缓解。
五、实验验证:从移除到富集
移除实验:这些样本不可替代
保持缓冲区总数1000不变,先禁止随机采样器访问排名最高的1%、5%或10% Anchor候选,再从剩余历史数据中抽满1000个样本。
排除前10%后,四套LIBERO的NBT都明显上升,遗忘增加超过4.5倍。Goal的NBT从0.05升到0.40,Spatial从0.05升到0.33。
缓冲区容量完全相同,Forward Transfer也基本不变,变化集中在旧任务保持上。这说明:不是少放了历史数据,而是切断了最贴近新旧冲突区域的数据来源。
富集实验:定向增加可缓解遗忘
在更紧的1%旧数据预算下,先用RandER找出每套序列最冲突的六个任务对,再比较相同任务对上的RandER与AnchorER。
把10%或20%的缓冲容量留给Anchors后,这些高冲突交互的平均遗忘下降超过63%。在观测最同质的LIBERO-Goal上,10% AnchorER还把整体NBT从0.18降到0.11,降幅37%。
消融:动作分歧过滤是必要的
方法对比显示:AnchorER平均NBT为0.11,低于MIR(0.14)、GSS(0.17)和RandER(0.18)。去掉第二步动作分歧后,NBT回升到0.13。这证明仅靠"表征接近"还不够,动作分歧负责把容量留给真正相反的决策。
六、真机验证:冲突发生在关键决策点
OpenJar:三只罐子的动作冲突
三只罐子形状相同,标签、图标和罐盖纹理不同。第一,只要逆时针转90度再提起;第二,只要顺时针转90度;第三,禁止旋转、需要直接提盖。机器人在每次接近罐盖时都要根据视觉特征决定向哪侧接触。
用UMI采集124条逆时针、120条顺时针和148条直提示范,在ARX机械臂上训练U-Net扩散策略。
AnchorER把回放集中到罐盖接触附近:学习顺时针任务时,动作分歧出现在末端接近罐盖、左右夹爪必须选择相反接触方向的位置;学习直提任务时,分歧更靠近闭合夹爪和抬起阶段。
最终结果:OpenJar总任务成功表现约为RandER的1.7倍,而且第二个任务能在保住第一个任务的同时学会。
失败分析给出了更细的机制证据:RandER学第二个任务时,有15/20次rollout持续执行第一个任务的逆时针行为;AnchorER下只有3/20次出现这一错误。
SweaterFold:折叠方向冲突
使用同一件毛衣和双臂ARX,顺序学习折左袖、折右袖、向上折三种语言条件行为。主要分歧集中在轨迹开头,因此缓冲区只用125个transitions。AnchorER同样比RandER更好地平衡第二项技能的学习与第三项技能加入后的旧任务保持,最终成功率也约为RandER的1.7倍。
两套真机序列把仿真中的潜在空间概念落到了可观察的动作节点:罐盖接触和折叠方向正是错误策略开始分叉的地方。
七、VLA模型上的验证
大型预训练VLA在足够大的回放缓冲区下确实更耐遗忘。论文用pi0.5在LIBERO-Goal上复核:每个旧任务保留1000个样本(约占历史数据的20%)时,平均NBT只有0.02。
但Memory Anchors关注的是另一个条件:预训练数据很大或任务序列变长后,固定数量的记忆在历史集合中只占很小比例。
在总共1000个记忆的设置中,pi0.5的RandER NBT为0.12,排除前5%和前10% Anchors后分别升到0.20与0.35。换到1%回放预算,RandER的NBT达到0.45;预留10%容量给Anchors后降到0.35。
关键变量不是"模型大就一定不忘"或"模型大也一定会忘",而是回放样本能否覆盖历史数据中最容易与当前任务发生冲突的区域。缓冲区足够大时,随机采样自然包含这些区域;预算收紧后,定向分配才开始显示价值。
八、适用边界
作者明确写出了几个限制:
-
需要访问策略潜在空间和过去训练数据,封闭的专有模型未必提供这些条件;
-
每个新任务开始前需计算历史数据表征,历史集合增长时计算成本随之变高;
-
实验序列长度为3至10个任务,未必代表机器人长期连续部署时的完整形态。
九、总结:Memory Anchor改变的是回放预算的分配逻辑
这篇论文没有替换Experience Replay,而是解释了它为何在某些任务边界失手:
遗忘主要由少数"表征重叠、动作冲突"的交互驱动,随机缓冲区只有在碰巧覆盖这些区域时才能给旧策略足够约束。
三步提取把这种冲突变成可计算对象,再把有限容量从平均覆盖的一小部分转向关键决策点。移除实验回答了"这些样本是否不可替代",富集实验回答了"能否利用它们改善结果",动作分歧消融则说明只有观测相似还不够。
当缓冲区相对历史数据越来越小时,知道该保留哪些旧样本和保留多少样本同样重要。
论文信息
标题: Memory Anchors for Continual Robot Learning
作者:Maximilian Du, Zhanyi Sun, Chen Xu, Paarth Shah, Masha Itkina, Shuran Song
机构:斯坦福大学、丰田研究院