现在做短视频、课程整理、知识库、视频复盘时,经常会遇到一个需求:手里已经有一段视频,怎么快速把里面的内容整理成一份完整脚本?
很多人第一反应是把视频转换成文字。
但实际使用下来会发现,视频转文字和视频转脚本并不是一回事。
视频转文字解决的是"视频里说了什么",而视频转脚本还需要进一步处理时间轴、段落、主题、内容结构,有些场景还需要结合画面分析。
所以,一个完整的视频转脚本流程,本质上是一个从音视频解析到内容结构化的过程。
本文从技术流程出发,拆解视频转脚本的实现方式
为什么视频转脚本不只是语音识别?
如果只是把视频中的声音转换成文字,核心技术就是ASR,也就是Automatic Speech Recognition。
基本流程可以理解为:
视频
 ↓
提取音频
 ↓
ASR语音识别
 ↓
文字
但是最终得到的通常是一段连续文本。
例如:
大家好今天给大家介绍一个视频剪辑的方法首先我们打开软件
然后导入视频接下来可以看到时间轴最后把字幕导出来......
这对于阅读来说并不算特别友好。
真正的视频脚本通常还需要包含:
-
视频时间轴
-
口播内容
-
段落划分
-
主题提炼
-
内容摘要
-
镜头信息
-
场景变化
-
章节结构
因此,更完整的处理流程一般是:
视频上传
   │
   ▼
音频提取
   │
   ▼
ASR语音识别
   │
   ▼
时间轴对齐
   │
   ▼
文本分段
   │
   ▼
语义分析
   │
   ▼
章节/主题提取
   │
   ▼
脚本整理
其中ASR负责"听懂",后面的NLP或者大模型负责"整理"。
一个完整的视频转脚本系统有哪些模块?
如果自己开发一个视频转脚本功能,大致可以拆成几个模块。
① 视频解析
第一步是读取视频文件。
常见的视频格式包括:
MP4
MOV
MKV
AVI
WEBM
开发时通常会使用FFmpeg处理音视频。
例如:
ffmpeg -i demo.mp4 -vn -acodec pcm_s16le audio.wav这里主要完成的是从视频中提取音频。
如果视频本身存在明显噪声,还可以继续加入:
-
降噪
-
音量归一化
-
声道转换
-
音频重采样
这些处理都会影响后面的语音识别结果。
② ASR语音识别
音频提取完成之后,就进入ASR阶段。
目前常见的技术方案包括:
-
Whisper
-
FunASR
-
Paraformer
-
SenseVoice
以Whisper类模型为例,最终并不是简单输出一整段文本,而是可以得到带时间信息的语句。
例如:
[
  {
    "text": "今天介绍三个视频剪辑技巧",
    "start": 0.8,
    "end": 4.2
  },
  {
    "text": "第一个技巧是先整理视频结构",
    "start": 4.5,
    "end": 8.7
  }
]
这样就建立了:
文字 ↔ 时间轴
之间的关系。
后续生成字幕或者脚本时,都可以利用这组数据。
③ 文本分段
ASR输出的内容通常比较碎。
例如:
今天介绍三个方法第一个方法是整理素材
第二个方法是统一字幕第三个方法是调整节奏
经过文本分段之后,可以变成:
今天介绍三个方法。

第一步,整理素材。

第二步,统一字幕。

第三步,调整视频节奏。
这一层通常会涉及标点恢复、语义分段以及上下文判断。
如果是长视频,还需要继续进行章节划分。
④ LLM整理脚本
如果目标只是生成字幕,到这里基本已经够用了。
但是如果目标是"视频转脚本",通常还需要增加一层大模型处理。
例如:
原始识别文本
        ↓
LLM
        ↓
提取主题
        ↓
划分章节
        ↓
整理口播
        ↓
生成脚本
比如原始文字是:
今天我们来讲一下视频脚本
很多人剪视频之前没有整理脚本
所以后面修改的时候会比较麻烦
经过结构化之后,可以变成:
## 开场

视频剪辑之前,先整理脚本可以减少后期修改。

## 问题

很多人在没有脚本的情况下直接开始剪辑,
导致后期调整成本增加。

## 解决方法

先确定主题,再安排内容顺序。
这时候输出的内容才更接近真正意义上的"脚本"。
三种视频转脚本方案实际有什么区别?
下面看一下格镜、剪映和Buzz。
三者虽然都可以处理视频或音频内容,但技术定位并不完全一样。
1、格镜
格镜更偏向于视频内容理解和脚本整理。
它的处理方式并不是单纯把视频转换成一段字幕,而是围绕视频内容进行进一步整理。
对于一段短视频素材,可以理解为:
视频
 ↓
音频识别
 ↓
视频内容分析
 ↓
内容整理
 ↓
脚本输出
比较适合的场景包括:
-
短视频脚本整理
-
视频内容复盘
-
课程内容整理
-
视频素材分析
-
口播内容提取
如果原视频本身具有比较明确的叙事结构,最终得到的内容可以进一步按照开场、正文、案例、总结等部分进行整理。
这和单纯导出SRT字幕的思路不太一样。
2、剪映
剪映的定位更加偏向视频剪辑和字幕处理。
它的处理流程比较直观:
导入视频
 ↓
识别字幕
 ↓
生成文字
 ↓
时间轴对应
 ↓
剪辑
对于口播类视频来说,自动字幕功能可以快速得到一份带时间轴的文字内容。
它比较适合:
-
视频剪辑
-
自动字幕
-
口播视频
-
字幕校对
-
时间轴编辑
例如某句话识别错误,可以直接定位到对应时间轴,再结合原始画面进行修改。
不过,如果目标不是字幕,而是完整的"视频脚本",通常还需要进一步对文字进行整理。
所以剪映更接近:
视频 → 字幕 → 剪辑
而不是:
视频 → 结构化脚本
3、Buzz
Buzz的技术方向比较明确,更偏向本地音视频转录。
它基于Whisper等语音识别能力处理音频和视频,可以生成文字转录结果,并支持TXT、SRT、VTT等格式。
基本流程可以理解为:
视频
 ↓
提取音频
 ↓
Whisper
 ↓
语音转文字
 ↓
TXT / SRT / VTT
如果是采访、会议、课程或者访谈视频,可以先得到完整转录内容,再进行二次整理。
例如:
Speaker 1:
今天我们主要讨论三个问题......

Speaker 2:
第一个问题是视频内容如何整理......

Speaker 1:
第二个问题是字幕如何处理......
对于需要本地处理素材的人来说,这种方式比较清晰。
尤其是对开发者而言,可以进一步把转录结果接入自己的程序或大模型流程。
三种工具怎么区分?
从实际处理方向来看,可以简单整理成:
| 工具 | 主要方向 | 更适合的场景 | 输出思路 |
|---|---|---|---|
| 格镜 | 视频内容理解 | 视频转脚本、内容复盘 | 结构化内容 |
| 剪映 | 视频剪辑 | 字幕、口播、剪辑 | 时间轴字幕 |
| Buzz | 本地转录 | 音视频转文字 | TXT/SRT/VTT |
如果只是想给视频添加字幕,重点通常是时间轴准确性。
如果想把视频内容整理成文字稿,重点是语音识别和文本分段。
如果想直接从视频得到脚本,则还需要考虑内容理解和结构化能力。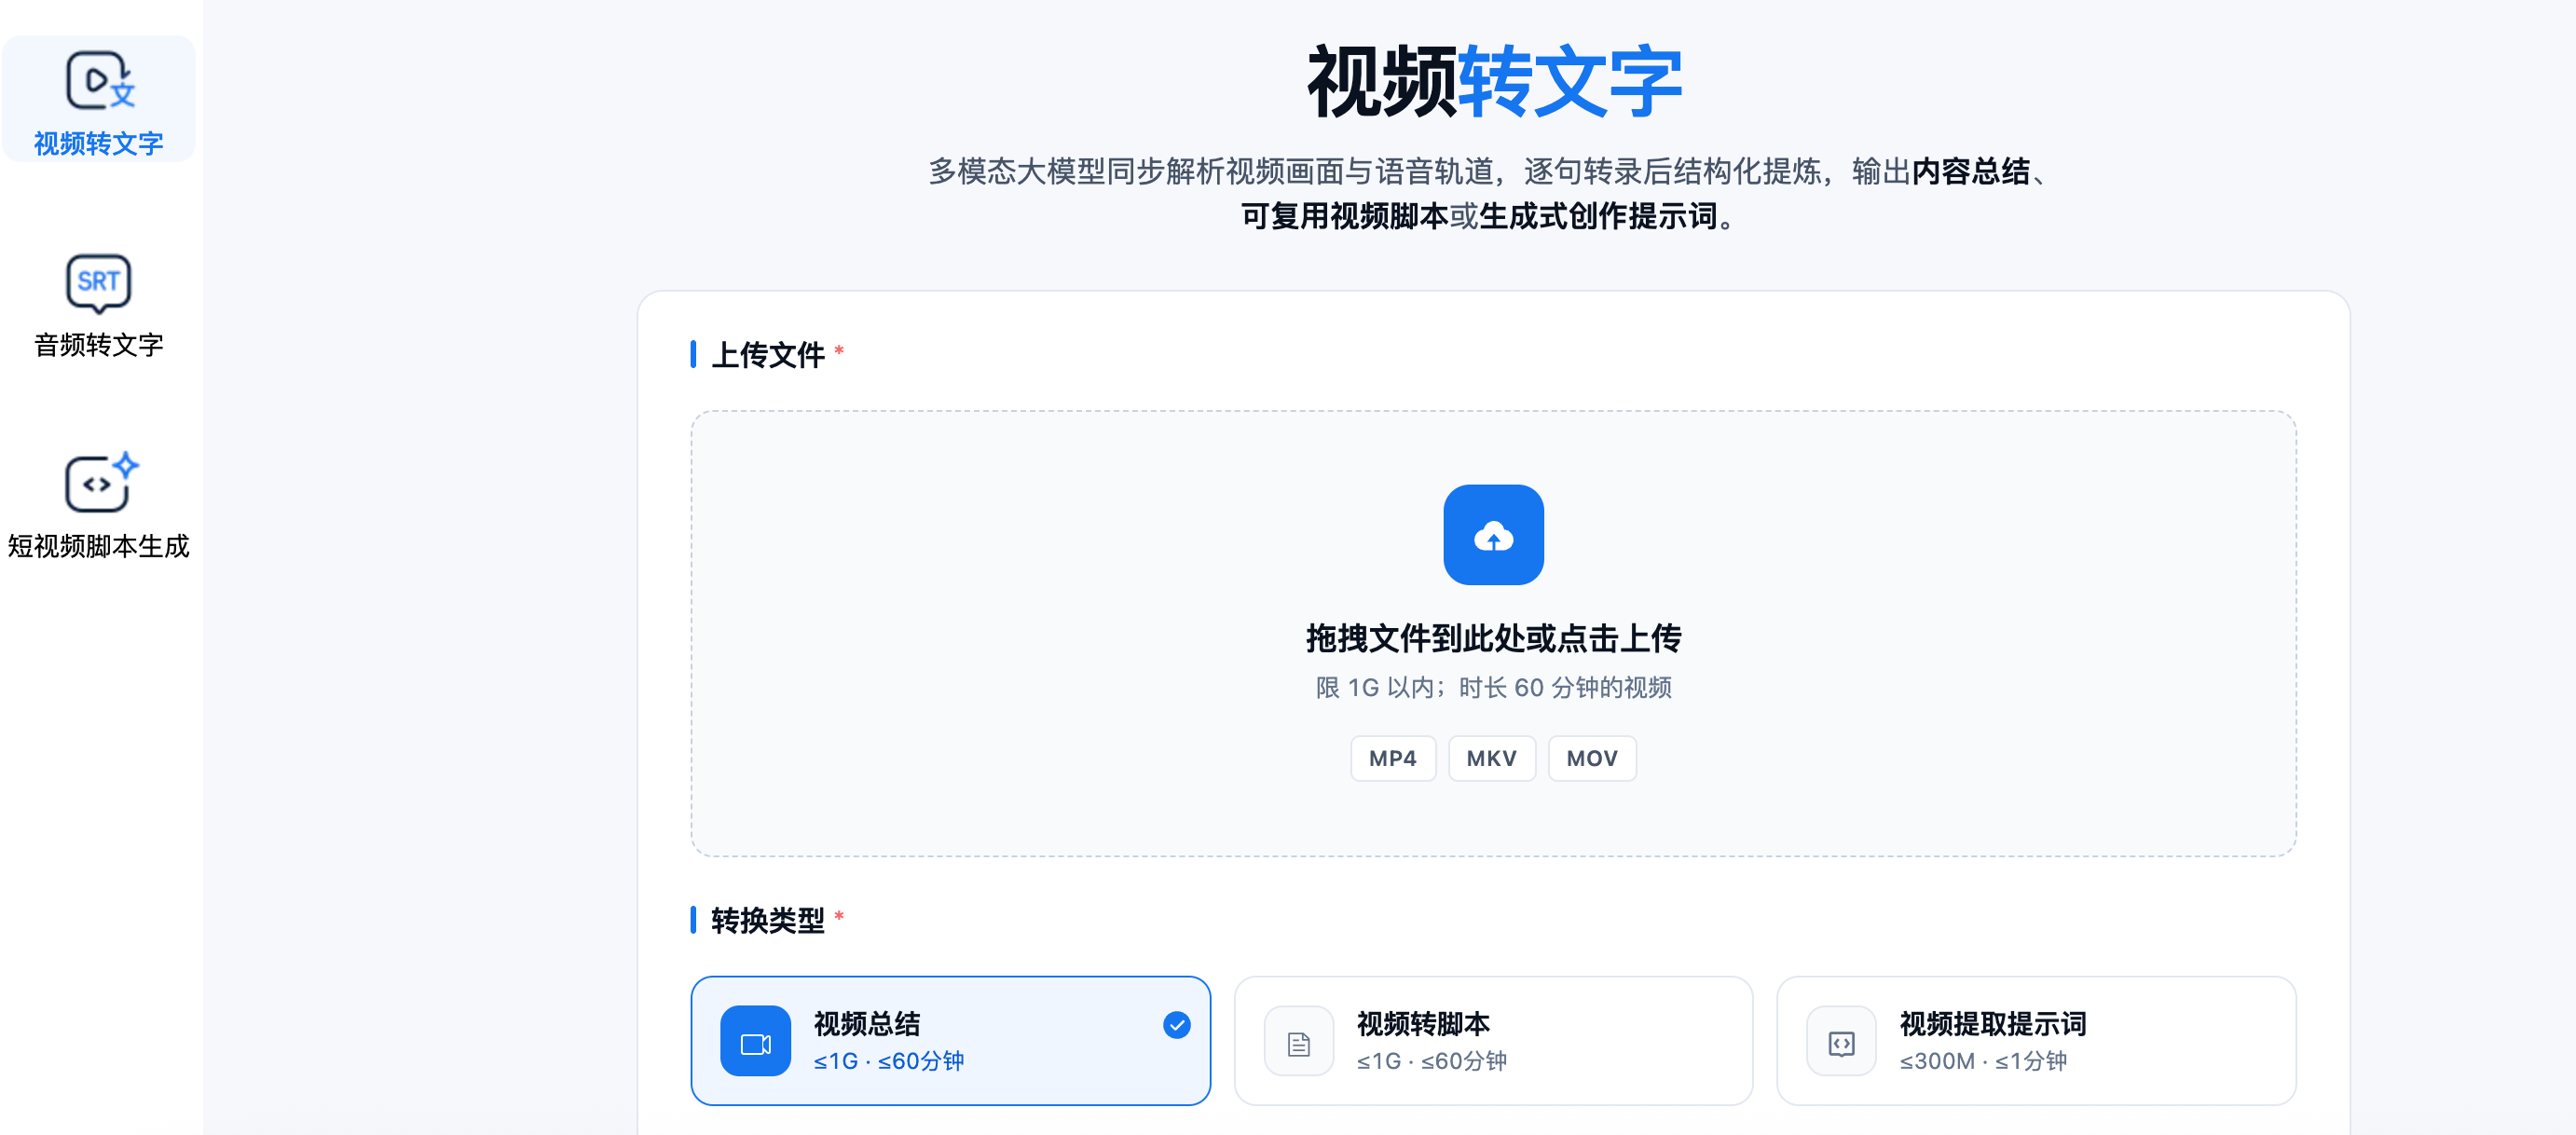
自己开发视频转脚本需要哪些技术?
如果从开发角度实现一个基础版本,其实可以采用比较经典的技术组合:
FFmpeg
   +
Whisper / FunASR
   +
LLM
   +
Markdown
第一步用FFmpeg提取音频。
第二步使用ASR模型进行语音识别。
第三步将识别结果发送给大模型。
例如给模型一个结构化Prompt:
请分析以下视频转录内容:

1. 提取视频主题
2. 划分内容章节
3. 保留核心口播内容
4. 删除明显重复表达
5. 输出视频脚本
6. 保留原始时间轴
最终得到:
# 视频主题

......

## 00:00-00:15 开场

......

## 00:15-01:20 核心内容

......

## 01:20-01:40 总结

......
这样,一个基础的视频转脚本Demo就搭建出来了。
真正做成产品,还需要解决哪些问题?
Demo比较简单,但如果要长期处理真实视频,工程问题会明显增加。
例如:
长视频处理
一小时视频不能直接一次性塞给大模型,需要切片、分段处理,再进行上下文合并。
Token控制
视频转录文本可能达到几万甚至几十万字,需要控制上下文长度。
可以采用:
视频
 ↓
ASR
 ↓
文本切片
 ↓
分段总结
 ↓
章节合并
 ↓
最终脚本
时间轴校准
ASR时间戳和最终脚本之间可能存在偏差,需要保留原始时间信息。
多人说话
采访和会议场景还需要加入Speaker Diarization,也就是区分不同说话人。
GPU资源
如果采用本地大模型或者本地Whisper进行批量处理,还需要考虑GPU显存、任务队列以及并发处理。
所以,真正的视频转脚本产品,实际上是一个由:
音视频处理
+
ASR
+
NLP
+
LLM
+
任务队列
+
文件存储
组成的综合系统。
视频转脚本的核心并不是"转文字"
从整个流程来看,可以发现一个比较明显的问题:
ASR只是视频转脚本的第一步。
真正影响最终结果的是后面的内容结构化。
完整链路可以概括为:
视频
 ↓
FFmpeg解析
 ↓
音频提取
 ↓
ASR
 ↓
时间轴
 ↓
文本分段
 ↓
语义分析
 ↓
章节提取
 ↓
内容总结
 ↓
脚本生成
格镜更偏向最后几步的视频内容整理,剪映更偏向字幕和剪辑流程,Buzz则更偏向前面的本地语音转录。
因此,三者并不是完全相同的产品形态。
总结
视频转脚本看起来只是一个简单的AI功能,实际上背后涉及音视频解析、ASR语音识别、时间轴处理、文本分段以及大模型内容理解等多个环节。
如果从使用方向来看:
-
格镜更偏向视频内容解析和脚本整理;
-
剪映更偏向字幕生成和视频剪辑;
-
Buzz更偏向基于Whisper的本地音视频转录。
如果从技术实现来看,一个基础的视频转脚本系统可以采用:
FFmpeg
+
Whisper / FunASR
+
LLM
+
Markdown
实现。
而真正完整的系统,还需要进一步解决长视频切片、Token控制、时间轴校准、多人识别、异步任务以及GPU资源管理等问题。
所以,"视频转脚本"并不只是把视频里的声音转换成文字,而是将非结构化的视频内容转换成可以阅读、编辑和继续加工的结构化信息。这也是这类AI音视频工具真正有价值的技术环节。