作为支撑每秒百万级吞吐的分布式消息系统,Kafka的高性能离不开一套设计精妙的网络通信架构。很多开发者在日常使用中只关注生产者的send API和消费者的poll方法,却很少深入了解一条消息从网络端口进入Broker后,是如何完成从字节流转业务请求的全流程。本文作为消息写入全链路系列的第一篇,将聚焦Broker端的SocketServer与RequestChannel核心组件,从源码层面拆解Kafka如何基于Reactor模式实现高效的网络请求接收、解析与入队,帮你彻底搞懂Kafka高性能网络层的设计奥秘。
一、Kafka的Reactor多线程网络模型
Kafka摒弃了传统阻塞I/O"一个连接对应一个线程"的低效模式,基于Java NIO实现了经典的主从Reactor多线程架构,也就是社区常说的「1+N+M」模型,这套设计也是它能轻松支撑数万并发连接的核心基础。
整个网络层的核心职责被清晰拆分到三类线程中,职责完全解耦:
- 1个DataPlaneAcceptor线程:作为主Reactor,只负责监听9092端口,接收外部新的TCP连接,完全不参与后续的请求读写处理
- N个Processor线程:作为从Reactor,每个线程持有独立的NIO Selector,负责已建立连接上的所有读写事件处理,默认线程数由
num.network.threads参数控制 - M个KafkaRequestHandler业务线程:不触碰任何网络IO操作,只专注于从队列中取出请求并执行业务逻辑,默认线程数由
num.io.threads参数控制
这种设计的最大优势是完全避免了IO密集型操作阻塞业务处理,也杜绝了高并发场景下的线程爆炸问题,用极少的线程资源就能支撑起十万级别的并发连接。
二、SocketServer:网络层的核心容器
SocketServer是Kafka Broker网络通信层的入口组件,所有Acceptor、Processor线程的生命周期都由它统一管理,从初始化到启动的每一步都藏着很多细节设计。
组件的定义与初始化
在SocketServer的初始化阶段,首先会创建全局共享的RequestChannel实例,同时完成连接数配额、缓冲区参数的配置:
scss
 // SocketServer.scala
class SocketServer(...) {
  //1、数据面Acceptor,接收数据面连接
  private[network] val dataPlaneAcceptors = new ConcurrentHashMap[EndPoint, DataPlaneAcceptor]()
  val dataPlaneRequestChannel = new RequestChannel(maxQueuedRequests, DataPlaneAcceptor.MetricPrefix, time, apiVersionManager.newRequestMetrics)

  //2、处理数据的Processor,根据配置(num.network.threads)生成具体数量
  private[network] val processors = new ArrayBuffer[Processor]()

  addProcessors(configs.get(ServerConfigs. NUM_NETWORK_THREADS_CONFIG).asInstanceOf[Int])

//3、启动Processor和Acceptor
//Acceptor.scala
val thread: KafkaThread = KafkaThread.nonDaemon(
  s" $ {threadPrefix()}-kafka-socket-acceptor- $ {endPoint.listenerName}- $ {endPoint.securityProtocol}- $ {endPoint.port}",
  this)

  def start(): Unit = synchronized {
  try {
  //先启动process,再启动Acceptor,避免出现"连接已经被接收但没有可用Processor处理"的空窗期
    processors.foreach( _.start() )
    thread.start()
  } catch {
  //
  }
}
这里有一个很容易被忽略的细节:Acceptor初始化时不会直接启动,而是先完成所有Processor线程的创建,避免出现"连接已经被接收但没有可用Processor处理"的空窗期。
Acceptor的连接分发逻辑
Acceptor作为专门的连接接收器,它的run方法逻辑非常简洁,全程只做两件事:监听端口接收新连接,并用轮询的方式把连接分配给空闲的Processor;关闭超限的socket;
scala
 // Acceptor.scala
class Acceptor(...) extends Runnable {
  override def run(): Unit = {
  serverChannel.register(nioSelector, SelectionKey.OP_ACCEPT)
    while (shouldRun.get()) {
        //accept 新的连接,并分配给对应processor
        acceptNewConnections()
        //关闭超限socket
        closeThrottledConnections()
    }
  }
}

/**
* Listen for new connections and assign accepted connections to processors using round-robin.
*/
private def acceptNewConnections(): Unit = {
  val ready = nioSelector.select(500)
  if (ready > 0) {
      // 监听端口接收新连接
    val iter = nioSelector.selectedKeys().iterator()
    while (iter.hasNext && shouldRun.get()) {
      try {
        val key = iter.next
        iter.remove()
        if (key.isAcceptable) {
          accept(key).foreach { socketChannel =>
            var retriesLeft = synchronized(processors.length)
            //分配processor
            var processor: Processor = null
            do {
              retriesLeft -= 1
              processor = synchronized {
                currentProcessorIndex = currentProcessorIndex % processors.length
                processors(currentProcessorIndex)
              }
              currentProcessorIndex += 1
            } while (!assignNewConnection(socketChannel, processor, retriesLeft == 0))
          }
        }
      }
    }
  }
}
这种轮询分配的策略能保证所有Processor的连接负载尽可能均衡,不会出现个别线程过载的情况。新连接不会直接注册到Selector,而是先暂存到Processor内部的newConnections队列中,避免在Acceptor线程里执行Selector注册操作,减少多线程锁竞争。
这里的设计非常巧妙:500ms的select超时设置,既不会让线程长时间阻塞无法及时处理新连接,也避免了无意义的空轮询浪费CPU资源。同时每次处理完就绪事件后都会立即清空selectedKeys,防止重复处理已经消费过的事件。
三、Processor:基于NIO Selector的IO事件引擎
如果说Acceptor是网络层的"门卫",那Processor就是真正负责数据搬运的"引擎",每个Processor线程都独立运行,通过单线程轮询自己的Selector,同时处理成百上千个连接的读写事件。
Processor的核心运行流程
Processor的run方法是Kafka网络层最核心的事件驱动循环,整套流程经过精心设计,完全贴合NIO非阻塞特性,最大程度减少了不必要的线程阻塞和锁竞争,保证高并发场景下的IO处理效率。它的完整执行链路按优先级分为5个紧密衔接的步骤:
1、configureNewConnections 批量注册新连接:优先处理Acceptor暂存在newConnections队列中的SocketChannel,批量完成非阻塞配置、TCP参数优化,向当前Processor的Selector注册OP_READ事件,让新连接正式纳入当前线程的IO事件监听体系,避免在Acceptor线程中执行注册操作产生锁竞争。
2、processNewResponses 优先回填待发送响应 先遍历本线程专属的responseQueue,取出所有业务线程处理完成的响应对象,将对应连接的SelectionKey标记为OP_WRITE就绪状态,优先把已完成的结果回写给客户端,避免响应在队列中堆积,减少请求端的等待延迟。
3、selector.poll 轮询就绪IO事件 调用NIO Selector的select方法阻塞等待就绪事件,通过300ms的超时设置平衡CPU占用与响应实时性,一次性获取所有当前可读、可写的Channel,避免频繁空轮询消耗系统资源。
4、processCompletedReceives 解析并提交请求 遍历所有读就绪的Channel,从SocketChannel中读取字节流,按照Kafka自定义协议完成帧解析、反序列化为完整的Request对象,最终封装为RequestChannel.Request提交到全局共享的requestQueue中,交由下游业务线程消费。
5、processCompletedSends 执行响应回写 遍历所有写就绪的Channel,将之前标记好的待发送响应通过SocketChannel写回客户端,完成本次请求的全链路闭环,同时清理临时队列中已发送完成的Response对象,释放内存资源。
这套流程的精妙之处在于严格遵循了"先清存量、再拉新量"的处理顺序:优先把已经生成的响应发出去,再去拉取新的网络数据,避免新老请求在同一个循环里互相阻塞,这也是Kafka网络层能做到低延迟高吞吐的关键细节。
scss
 // Processor.scala
class Processor(...) extends Runnable {
  override def run(): Unit = {
  try {
    while (shouldRun.get()) {
      try {
        // setup any new connections that have been queued up
        configureNewConnections()
        // register any new responses for writing
        processNewResponses()
        poll()
        processCompletedReceives()
        processCompletedSends()
        processDisconnected()
        closeExcessConnections()
      }
    }
  }
}
四、RequestChannel:网络层与业务层的交换枢纽
经过Processor解析完成的请求,并不会直接交给业务线程处理,而是全部通过RequestChannel这个统一的通道完成流转,它是网络IO线程和业务处理线程之间的"缓冲带"。
RequestQueue的设计细节
RequestChannel内部维护了一个全局的请求队列RequestQueue,它的底层是一个有界的ArrayBlockingQueue:
scala
class RequestChannel(...) {
  private val requestQueue = new ArrayBlockingQueue[BaseRequest](queueSize)
  private val processors = new ConcurrentHashMap[Int, Processor]()
  private val callbackQueue = new ArrayBlockingQueue[BaseRequest](queueSize)

def sendRequest(request: RequestChannel.Request): Unit = {
  requestQueue.put(request)
}

def receiveRequest(timeout: Long): RequestChannel.BaseRequest = {
  val callbackRequest = callbackQueue.poll()
  if (callbackRequest != null)
    callbackRequest
  else {
    val request = requestQueue.poll(timeout, TimeUnit.MILLISECONDS)
    request match {
      case WakeupRequest => callbackQueue.poll()
      case _ => request
    }
  }
}
这里采用"单全局请求队列+多独立响应队列"的设计有两个关键优势:
- 全局请求队列可以让M个业务线程公平竞争消费,最大化利用业务线程的处理能力
- 每个Processor独享自己的响应队列,业务线程写入响应时不需要锁竞争,大幅提升响应回写的效率
队列溢出的保护机制
RequestQueue默认最大长度是500,当Broker处理能力跟不上请求速率时,队列会被填满,此时Processor线程的put操作会被阻塞,新的请求无法入队,最终会通过TCP滑动窗口机制反向限流生产者的发送速率。这种设计相当于给Broker加上了一层自我保护,避免请求无限堆积导致内存溢出,这也是Kafka在高压力场景下依然能保持稳定的重要原因。
五、总结
从Acceptor接收TCP连接,到Processor通过NIO Selector完成字节流读取与请求解析,再到最终请求进入RequestQueue等待业务线程消费,这一整套流程就是Kafka Broker处理网络请求的第一道关卡。这套基于Reactor模式的架构,用极小的线程开销实现了极高的并发处理能力,也是Kafka能支撑百万级消息吞吐的重要基石。
下一篇我们将继续深入这条消息写入链路,拆解KafkaRequestHandler线程拿到请求后,如何调用KafkaApis完成ProduceRequest的核心业务处理,带你继续探索Kafka高性能背后的更多源码细节。
六、一图胜千言
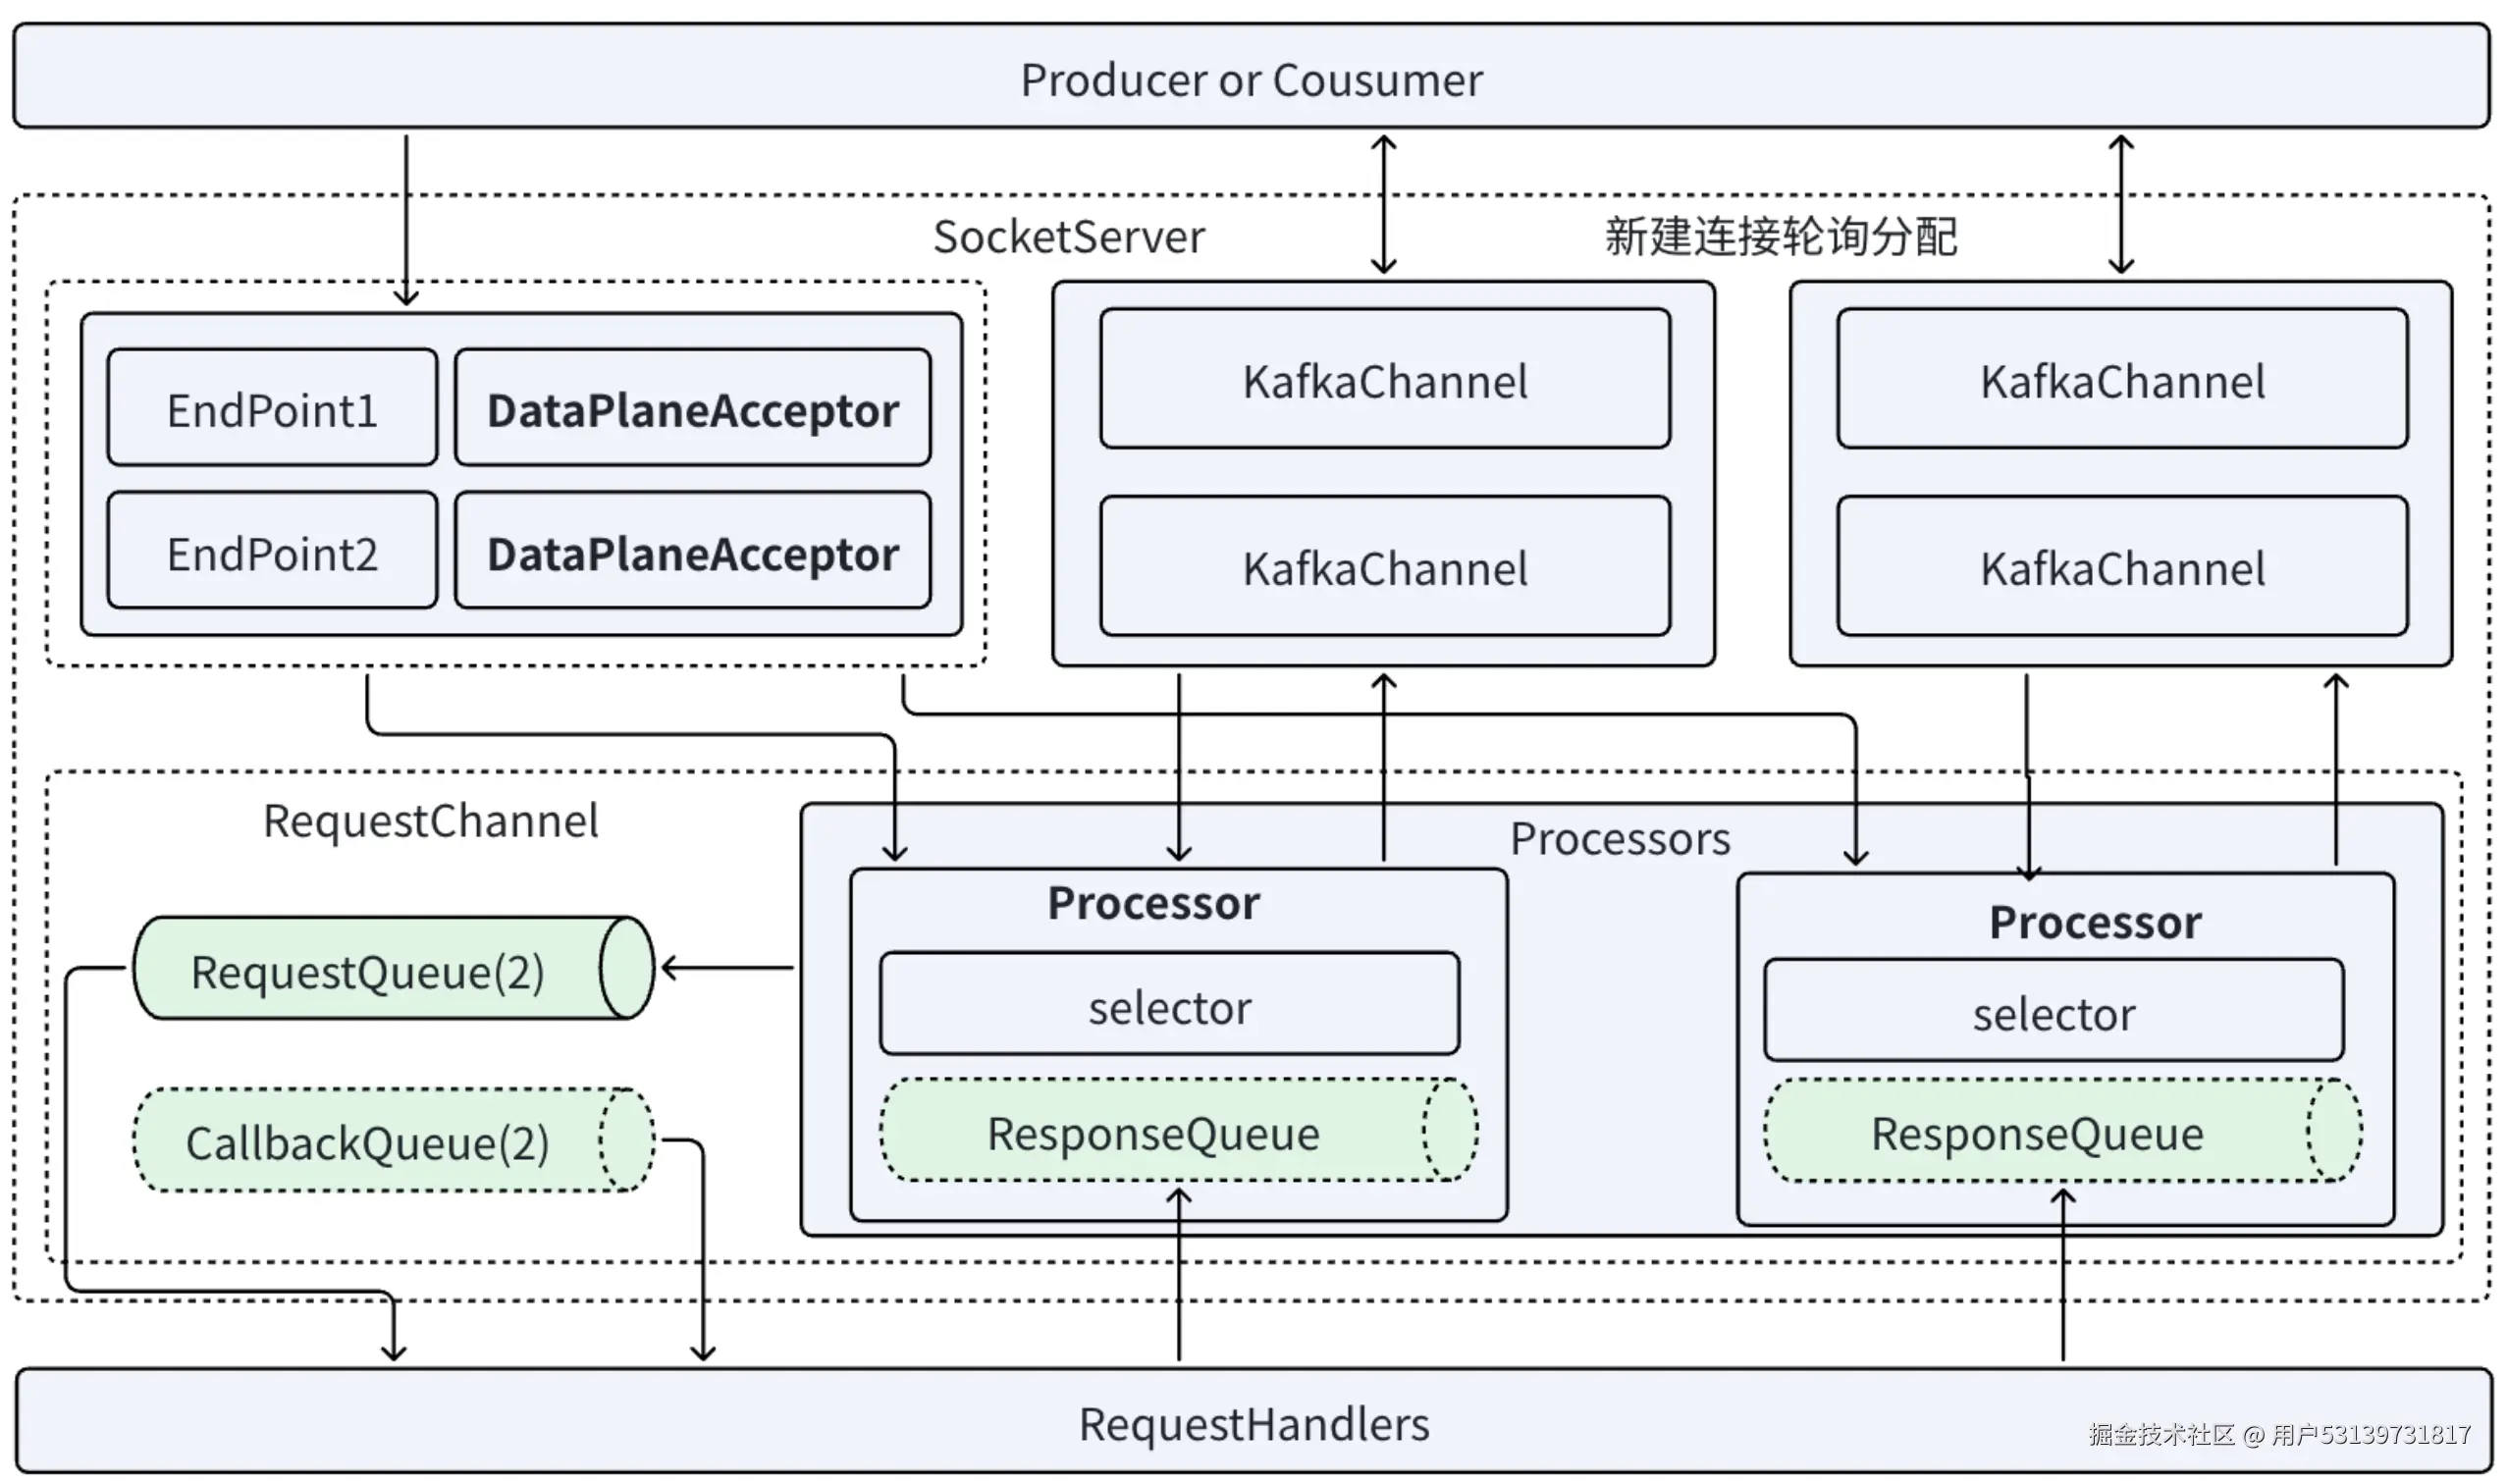
Reactor 模型图:展示 Acceptor 接收连接 -> 分发给 Processor -> Processor 通过 Selector 读取数据 -> 放入 RequestQueue 的流程 -> RequestHandlers处理数据。
互动问题
💡 思考题:Netty是非常成熟的网络模型,Kafka 为什么选择自己实现 Reactor 网络模型,而不是直接使用 Netty?