迁移项目刚启动时,报告首页往往会给人一种很乐观的感觉:对象已经采集完成,总兼容度也有了。真正拿到排期表上,问题马上变了。一个只含几列的普通表,和一个包含动态 SQL、异常分支、游标及多张表依赖的存储过程,不能按"一个对象"算成同样的工作量。总兼容度能回答方向,排期还得回到对象明细。
这也是我看 KDMS 评估结果时最在意的部分。对象数量、兼容结论、命中的问题和预估工作量要能保留下来,后面才能反复核对:首轮评估挑哪些对象做 POC,源库又改了什么,转换后的对象是否真的落到了 KingbaseES。评估报告不替代迁移和回归,但它应当成为后续工作的基准,而不是开完评审会就归档的一份 PDF。
迁移中的评估、转换和验证本来就是前后衔接的几项工作。KDMS 给出的对象和 SQL 评估结果,正好可以用来确定前两轮最该验证什么。
先把一轮评估固定下来
源库运行时间长了,采集范围不能只盯着表。视图里可能藏着查询口径,函数和存储过程中有业务规则,触发器有时还会改写写入行为。评估时把这些对象和应用 SQL 一起采集,报告才有足够的信息量。
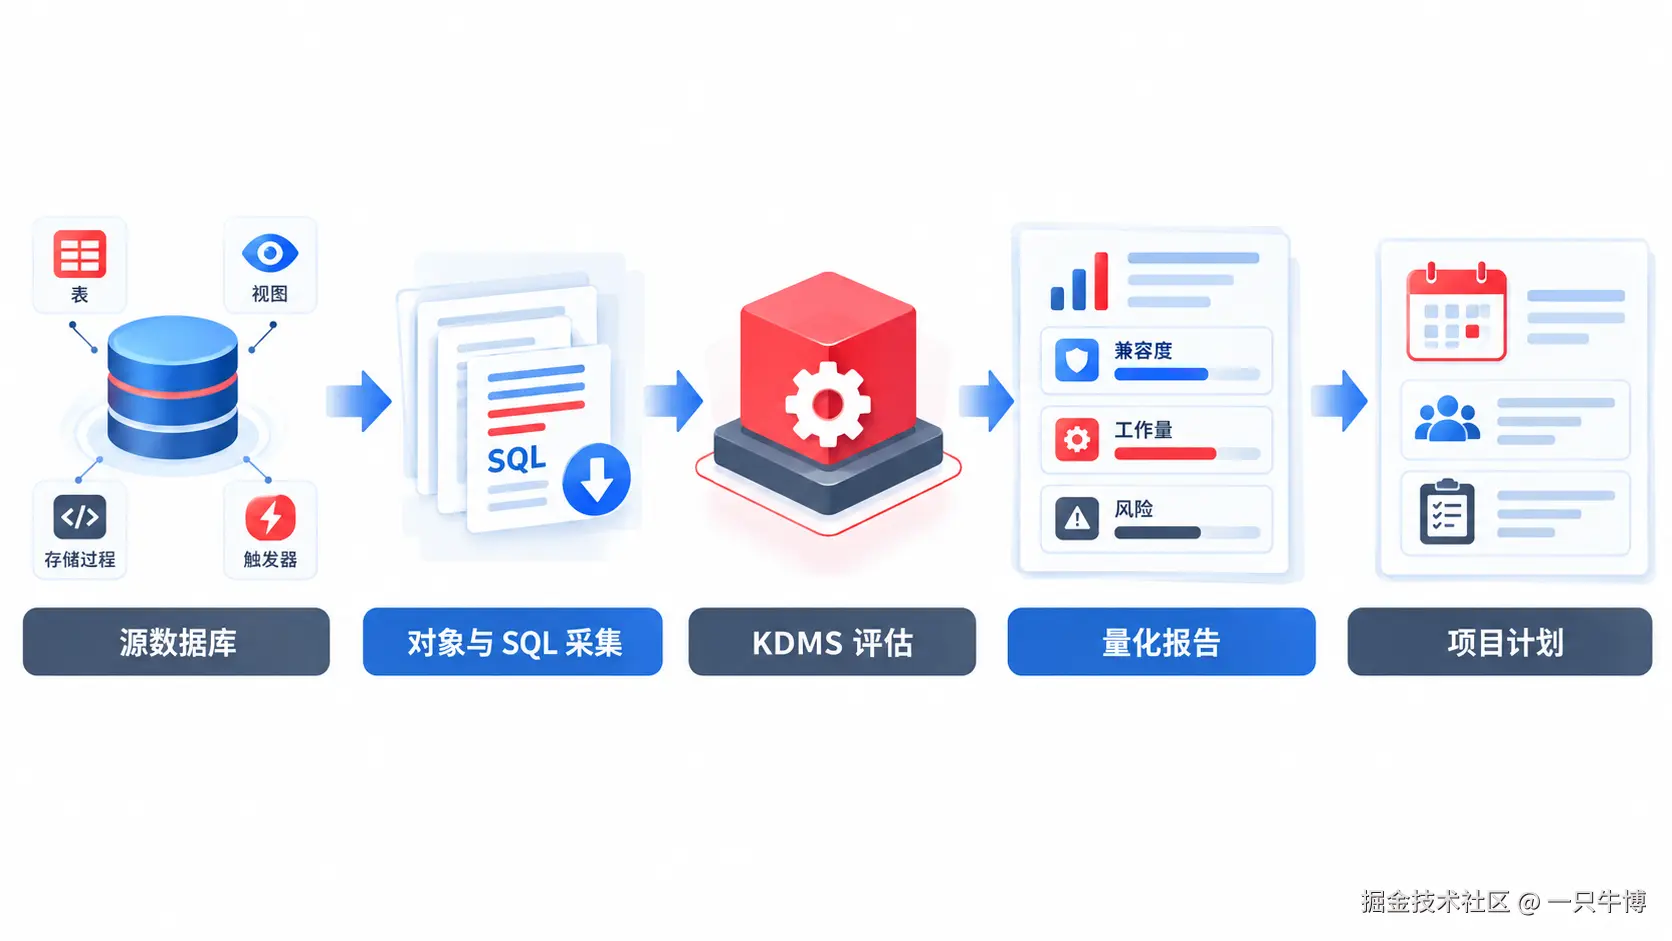
我不会把第二次评估直接覆盖第一次。项目侧需要留一份对象快照,保存从 KDMS 报告导出的明细,字段由项目管理库统一。下面的表不是 KDMS 内部表,也不代表报告固定使用这些列;导入时按实际导出文件映射即可。
sql
CREATE TABLE assessment_object_snapshot (
    batch_id             varchar(64)  NOT NULL,
    schema_name          varchar(128) NOT NULL,
    object_type          varchar(32)  NOT NULL,
    object_name          varchar(256) NOT NULL,
    assessment_result    varchar(32)  NOT NULL,
    issue_count          integer      NOT NULL DEFAULT 0,
    risk_level           varchar(16),
    estimated_workload   numeric(12,2),
    definition_hash      varchar(128),
    target_schema_name   varchar(128),
    target_object_name   varchar(256),
    PRIMARY KEY (batch_id, schema_name, object_type, object_name)
);
batch_id 记录评估批次,definition_hash 保存对象定义的摘要。定义摘要可以在导入环节由项目脚本计算,也可以使用导出文件已有的版本标识。目的很简单:后面重新采集时,要区分"源库对象本来就这样"和"评估以后又被改过"。
先把对象类型和评估结论拆开看。这个统计不需要任何虚构的项目数据,导入某一个实际批次后即可执行:
sql
SELECT object_type,
       assessment_result,
       COUNT(*) AS object_count,
       SUM(issue_count) AS issue_count,
       SUM(estimated_workload) AS estimated_workload
FROM assessment_object_snapshot
WHERE batch_id = 'assessment_202609_a'
GROUP BY object_type, assessment_result
ORDER BY object_type, assessment_result;
输出里如果大量 TABLE 都是可处理状态,而 ROUTINE、TRIGGER 集中在 REVIEW 或 INCOMPATIBLE,排期就不能再按对象总数平均分配。先把复杂对象拿出来验证,普通对象可以留给后续批量转换。
POC 先挑会拖住联调的对象
迁移初期做 POC,不是把所有不兼容项一次做完。更实用的做法是按风险、问题数和预估工作量把候选对象列出来,再结合实际调用链确定范围。高风险的过程、被多个模块引用的视图、依赖触发器的写入链路,通常比一批独立的小表更值得先验证。
sql
SELECT schema_name,
       object_type,
       object_name,
       assessment_result,
       issue_count,
       risk_level,
       estimated_workload
FROM assessment_object_snapshot
WHERE batch_id = 'assessment_202609_a'
  AND assessment_result IN ('REVIEW', 'INCOMPATIBLE')
ORDER BY CASE risk_level
             WHEN 'HIGH' THEN 1
             WHEN 'MEDIUM' THEN 2
             ELSE 3
         END,
         estimated_workload DESC NULLS LAST,
         issue_count DESC,
         object_type,
         object_name;
这份结果适合和应用负责人一起过一遍。评估报告能指出 SQL 或对象定义中的兼容点,是否会挡住首个业务模块,仍要结合调用位置判断。比如某个高风险函数只被历史归档任务使用,未必需要和支付主链路放在同一个 POC;反过来,一个问题数不多的触发器若参与订单落库,也不应等到割接前才处理。
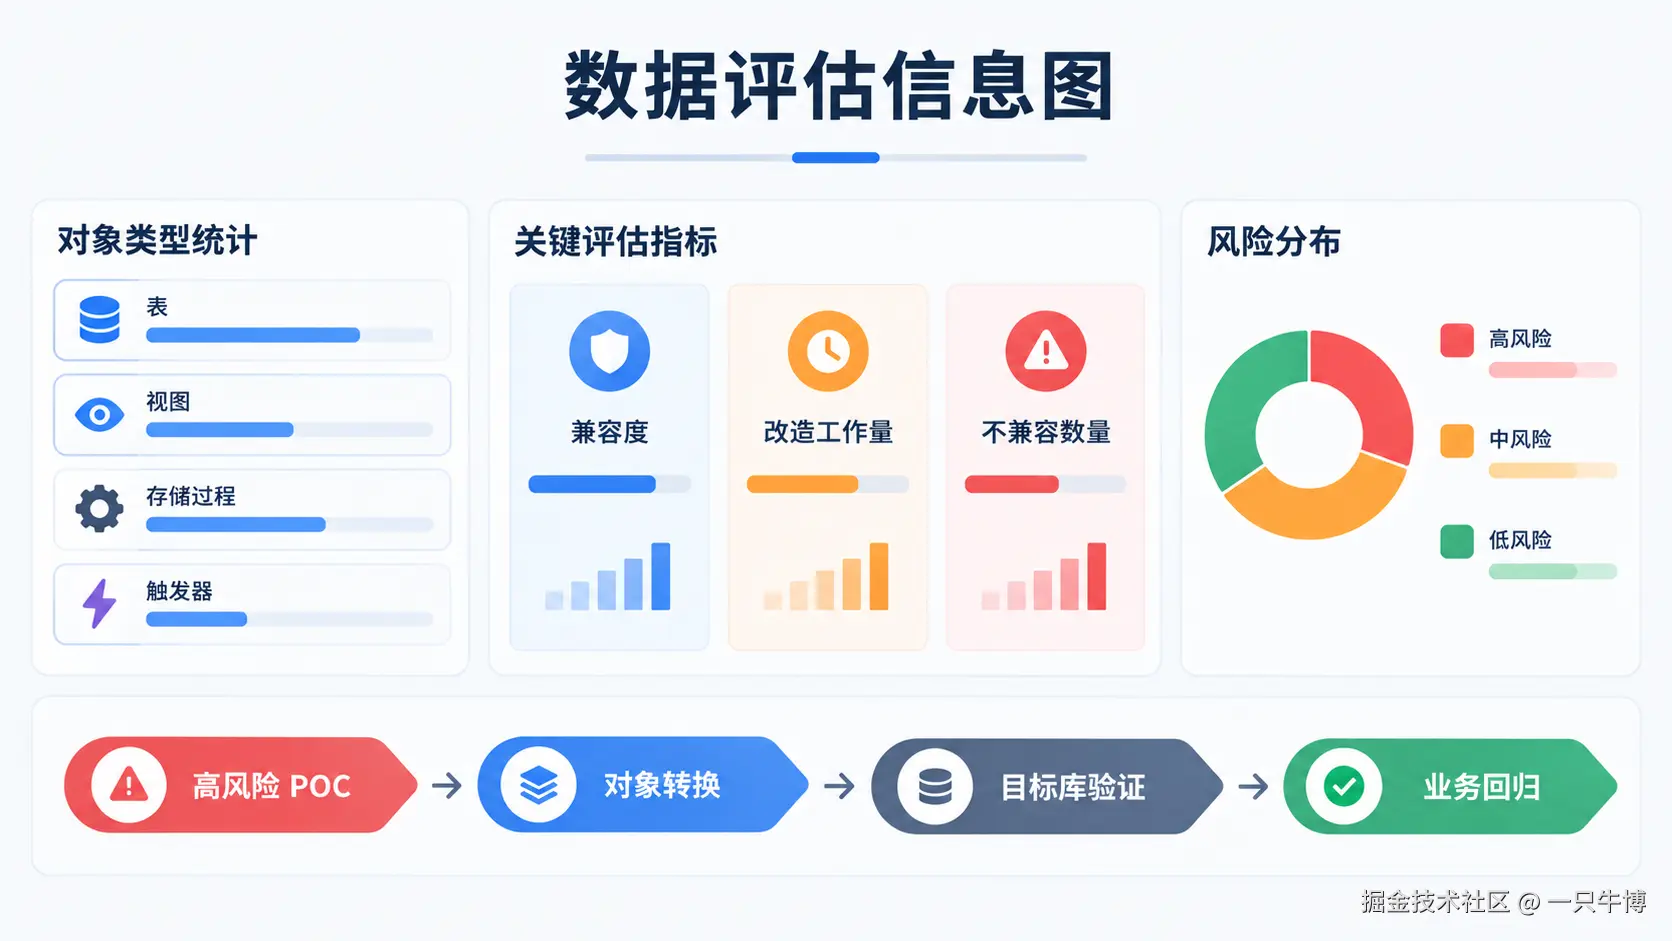
报告里的兼容度、改造工作量和风险分布在这里有了具体去处:高风险对象进入 POC,能够批量处理的对象进入转换计划,仍需确认的项目保留在评估清单中。没有这一步,报告里的数字很容易只停留在汇报页。
源库还在变,第二次报告不能盖掉第一次
评估完成到正式切换之间,源库通常不会静止。开发可能增加视图,修复存储过程,也可能把原有 SQL 改成另一种写法。第二轮采集前后的变化要单独列出来,否则项目组很难判断新增工作来自哪里。
下面的 SQL 比较两个评估批次,分别标记新出现、已经删除、对象定义变化以及评估结论变化的对象。IS DISTINCT FROM 能正确处理空值,不会因为摘要或结论为空而漏掉差异。
sql
WITH previous_batch AS (
    SELECT schema_name,
           object_type,
           object_name,
           definition_hash,
           assessment_result
    FROM assessment_object_snapshot
    WHERE batch_id = 'assessment_202609_a'
),
current_batch AS (
    SELECT schema_name,
           object_type,
           object_name,
           definition_hash,
           assessment_result
    FROM assessment_object_snapshot
    WHERE batch_id = 'assessment_202609_b'
)
SELECT COALESCE(c.schema_name, p.schema_name) AS schema_name,
       COALESCE(c.object_type, p.object_type) AS object_type,
       COALESCE(c.object_name, p.object_name) AS object_name,
       CASE
           WHEN p.object_name IS NULL THEN 'ADDED'
           WHEN c.object_name IS NULL THEN 'REMOVED'
           WHEN p.definition_hash IS DISTINCT FROM c.definition_hash
             THEN 'CHANGED'
           WHEN p.assessment_result IS DISTINCT FROM c.assessment_result
             THEN 'REASSESSED'
       END AS change_type,
       p.assessment_result AS previous_result,
       c.assessment_result AS current_result
FROM previous_batch AS p
FULL JOIN current_batch AS c
  ON c.schema_name = p.schema_name
 AND c.object_type = p.object_type
 AND c.object_name = p.object_name
WHERE p.object_name IS NULL
   OR c.object_name IS NULL
   OR p.definition_hash IS DISTINCT FROM c.definition_hash
   OR p.assessment_result IS DISTINCT FROM c.assessment_result
ORDER BY schema_name, object_type, object_name;这条清单可以直接作为下一轮评估会议的输入。ADDED 对象需要补进转换和测试范围;CHANGED 对象应重新确认已经完成的改造是否仍可用;REASSESSED 则提示同一个对象在新一轮评估中得到了不同结论。这样一来,原先的工作量估算也有据可查,不会因为一份新报告出现而失去前后的对照。
模拟建库后,到目标库点一次名
评估结果显示可处理,不等于对象已经在目标库创建成功。模拟建库或转换脚本执行后,我会先从 KingbaseES 的元数据视图读取已有的表、视图、序列、函数和触发器。这个检查只核对对象是否落库,不替代数据核验和业务回归。
sql
WITH target_object AS (
    SELECT table_schema AS schema_name,
           CASE table_type
               WHEN 'BASE TABLE' THEN 'TABLE'
               WHEN 'VIEW' THEN 'VIEW'
           END AS object_type,
           table_name AS object_name
    FROM information_schema.tables
    WHERE table_type IN ('BASE TABLE', 'VIEW')

    UNION ALL

    SELECT sequence_schema,
           'SEQUENCE',
           sequence_name
    FROM information_schema.sequences

    UNION ALL

    SELECT routine_schema,
           'ROUTINE',
           routine_name
    FROM information_schema.routines

    UNION ALL

    SELECT trigger_schema,
           'TRIGGER',
           trigger_name
    FROM information_schema.triggers
)
SELECT schema_name,
       object_type,
       object_name
FROM target_object
WHERE schema_name = 'app_schema'
ORDER BY object_type, object_name;
实际核对时,把这个目标对象清单和评估快照关联起来,就能找出"评估中已标记可转换,但目标库仍没有对象"的记录。函数或过程可能存在同名重载,具体项目还应将参数类型一并纳入对象标识;上面的查询先用于对象层面的盘点。
sql
WITH target_object AS (
    SELECT table_schema AS schema_name,
           CASE table_type
               WHEN 'BASE TABLE' THEN 'TABLE'
               WHEN 'VIEW' THEN 'VIEW'
           END AS object_type,
           table_name AS object_name
    FROM information_schema.tables
    WHERE table_type IN ('BASE TABLE', 'VIEW')

    UNION ALL

    SELECT sequence_schema, 'SEQUENCE', sequence_name
    FROM information_schema.sequences

    UNION ALL

    SELECT routine_schema, 'ROUTINE', routine_name
    FROM information_schema.routines

    UNION ALL

    SELECT trigger_schema, 'TRIGGER', trigger_name
    FROM information_schema.triggers
)
SELECT s.schema_name,
       s.object_type,
       s.object_name,
       s.assessment_result
FROM assessment_object_snapshot AS s
LEFT JOIN target_object AS t
  ON t.schema_name = s.target_schema_name
 AND t.object_type = s.object_type
 AND t.object_name = s.target_object_name
WHERE s.batch_id = 'assessment_202609_a'
  AND s.assessment_result IN ('COMPATIBLE', 'CONVERTED')
  AND t.object_name IS NULL
ORDER BY s.schema_name, s.object_type, s.object_name;
表、视图、过程都创建出来之后,约束也值得单独看一遍。主键、唯一约束和外键不会证明业务已经回归通过,但能较早发现结构迁移不完整的情况。
sql
SELECT table_schema AS schema_name,
       table_name,
       constraint_name,
       constraint_type
FROM information_schema.table_constraints
WHERE table_schema = 'app_schema'
  AND constraint_type IN ('PRIMARY KEY', 'UNIQUE', 'FOREIGN KEY')
ORDER BY table_name, constraint_type, constraint_name;
让评估结果跟着项目往前走
一轮评估结束前,项目至少要能说清四件事:本批次覆盖了哪些对象,哪些对象要先做 POC,源库后来改了什么,转换后的对象有没有落到 KingbaseES。其余工作仍要交给转换脚本、数据校验、性能测试和业务回归,但输入已经不再只是一个兼容度百分比。
KDMS 的报告适合从这里开始发挥作用。把评估批次保存下来,把高风险对象拉进前置验证,把两轮采集做差异比对,再到目标库核对对象清单。迁移排期不会因此自动完成,不过每一次调整都有具体对象和 SQL 可以追溯,周会里也不用反复讨论"这批改造大概还有多少"。