近日,九章云极DataCanvas自主研发的九章智算云平台Alaya NeW Cloud宣布开源分布式KV Cache 系统DingoCache(项目名 dfkv)。该系统将大模型的KV Cache从单个推理实例扩展到共享存储池,使兼容的请求能够复用已有计算结果,从而减少长上下文与多轮交互场景中的重复Prefill。项目采用Apache 2.0许可开放,支持免费商用、修改与再分发。
重复计算从何而来
大模型处理输入的过程称为Prefill,该阶段会产生供后续计算使用的Key/Value 状态,即KV Cache。恢复可复用前缀的 KV,即可跳过相应部分的重复计算。
问题在于,现有前缀缓存大多局限于单个实例内部:请求一旦更换实例,或本地缓存被淘汰,原计算结果便无法继续使用。以"一份报告依次完成总结、风险分析与行动项提取"为例,材料本身并未变化,但每次仍需重新处理整份报告,由此产生的不只是等待时间,还有重复的算力开销。
九章智算云DingoCache 将这份计算状态从单台机器扩展至共享缓存池,供后续请求直接取用。需要说明的是,系统缓存的是计算状态而非最终答案------同一份材料仍可继续回答不同问题。
受益场景主要有三类:长文档问答,材料不变、问题追加;多轮Agent,复用稳定的系统提示、工具定义与追加式任务历史;多实例服务,请求更换实例后仍可尝试从共享池恢复兼容状态。系统不替代显存与主机内存中的近端缓存,而是扩大可保存、可复用的范围。
如何实现:三层分工与三项技术难点
九章智算云DingoCache将推理适配、数据存储与成员管理三个层面分离:连接器负责解析推理引擎的数据布局,客户端决定数据落点,缓存节点管理本地 NVMe 与可选的 RAM 热层。
成员管理由 MDS 配合 etcd 完成,负责成员发现、节点注册与租约;KV 大数据则由客户端直接读写缓存节点,不经过 MDS 中转。客户端通过一致性哈希计算目标节点,再发起批量读写,将访问压力分散至不同节点。该设计使缓存服务既可与推理服务混部,也具备独立的目录与资源预算;推理实例重建时,缓存池无需同步重建。
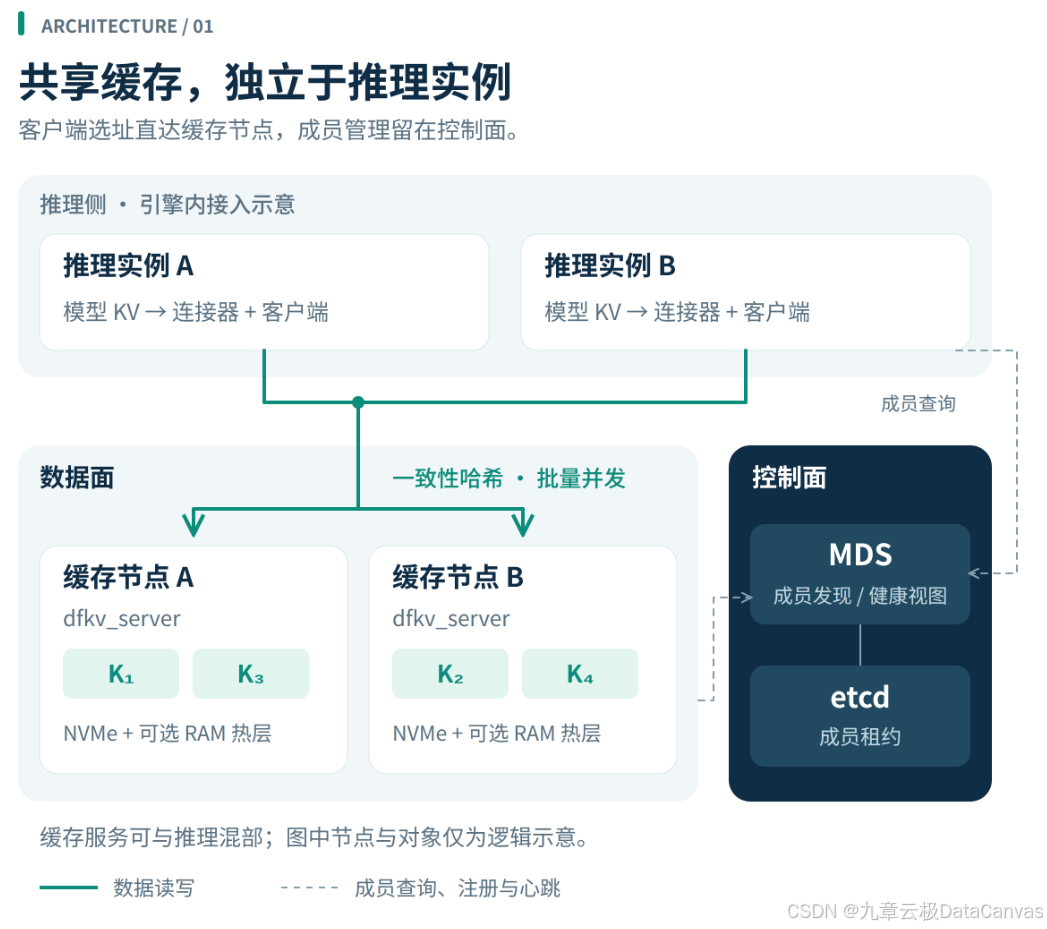
图1:实线表示缓存数据,虚线表示成员管理。数据线表达按对象访问的关系,不代表存在中心转发服务;节点与对象数量仅为示意。
一致性方面存在一处取舍:九章智算云DingoCache采用"可重算缓存语义",不为每个对象维护冗余副本,以减少复制与协调开销;相应地,节点变化可能造成未命中与重新Prefill,因此系统不承担业务数据唯一副本的职责。
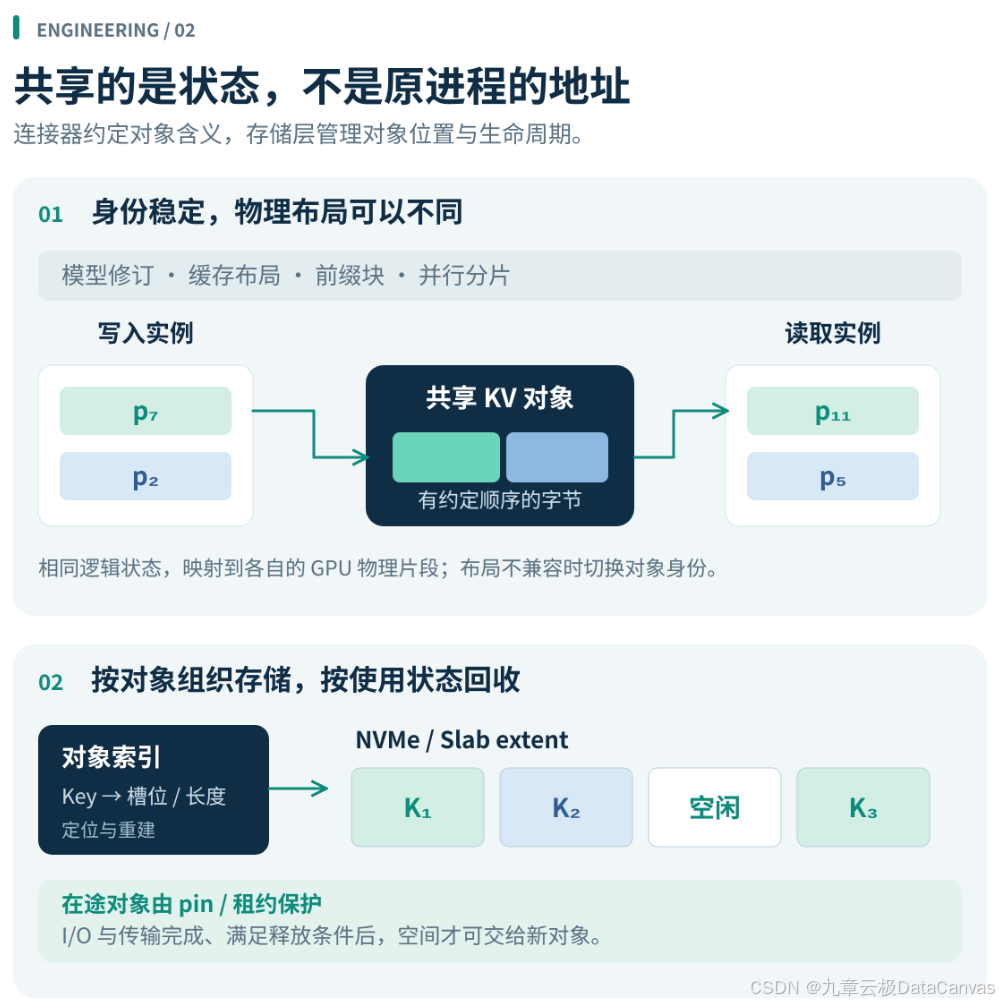
图 2:上半部分展示稳定对象身份与不同物理布局的关系,下半部分展示索引、磁盘槽位和回收约束。物理片段、对象与槽位均为示意。
将数据移至外部存储只是起点,跨实例复用还需解决三项技术难点。
其一,理解状态,才能共享状态。 同一段输入在不同模型修订、缓存精度或并行配置下,可能对应不同的KV------仅凭键存在、长度一致,不能证明恢复后可用。九章智算云DingoCache由连接器构造稳定的对象身份:命名空间描述模型与布局的兼容范围,对象键标识前缀块、缓存组件与并行分片。写入与读取实例的GPU地址可以不同,但逻辑含义与字节排列约定必须一致。目前系统已提供SGLang HiCache、vLLM 直连与 LMCache 三条适配路径,各连接器处理框架差异,底层共享存储、路由与传输能力。
其二,面向 KV 对象进行管理,而非以文件为单位。 九章智算云DingoCache默认采用 Slab 后端:预分配空间按对象大小类别划分为槽位,索引记录位置与长度,以减少逐对象文件操作带来的元数据开销。批量 I/O、淘汰与索引重建围绕同一套布局工作;在途数据通过 pin、延迟回收等机制保护,避免在淘汰发生时提前释放仍在使用的空间。
其三,提升传输效率的同时约束内存占用。 KV 数据面采用原生 RDMA,减少 CPU 参与数据搬运的开销;在硬件、驱动与连接器条件满足时,GPU 直连路径支持 GPUDirect RDMA。此处 RDMA 指 KV 数据面,成员管理与连接协商仍使用 TCP。可选 RAM 热层使热点读取避开磁盘,条件满足时冷数据可直接读入最终热层槽位,减少中转拷贝。此外,操作级租约与动态读取缓冲使部分大对象内存随在途操作管理,并纳入进程级硬预算。
实测:同前缀重放,耗时缩短约 83.5%
在一组历史专项测试中,同一模型处理约百万 Token的合成长前缀,输出长度固定为 8 Token。首次请求执行冷计算;随后,另一本地前缀缓存为空的实例从 dfkv 读取共享 KV 并重放相同输入。以冷计算的请求完成耗时为 100,共享重放约为 16.5,耗时缩短约 83.5%;两次请求均成功完成,访问记录确认发生了共享 KV 读取。
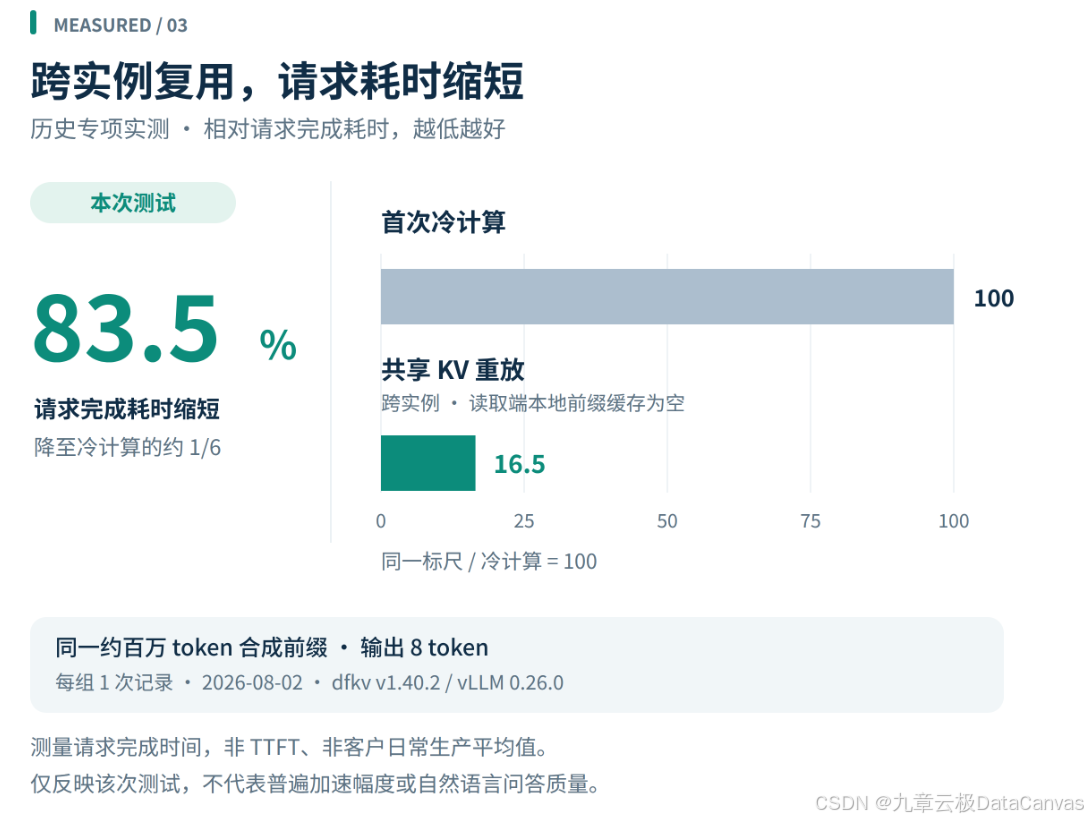
图 3:2026-08-02,dfkv v1.40.2 / vLLM 0.26.0,同一合成前缀、每组一次记录。测量请求完成耗时,非 TTFT、非客户日常生产统计,不代表自然语言问答质量或普遍加速幅度。
这组记录展示的是共享复用的机会:长前缀已经算过,可以在另一个实例上用读取和恢复代替重复 Prefill。实际收益仍要结合自己的文档、任务和并发负载验证;缓存恢复成本高于重算时,命中也未必带来加速。
在降低投入方面,九章智算云DingoCache 的设计指向三条路径:软件许可,Apache 2.0 开源、免费商用,企业可自主部署、审阅与定制;存储设备,可将 GPU 服务器上可分配的 NVMe SSD 容量组织为共享缓存池,在已有容量、内存与网络满足要求时无需另购专用存储设备;重复计算,通过前缀复用减少重复 Prefill。官方同时说明:免费开源不等于零运维成本,实际节省幅度仍取决于资源余量、网络条件、SSD 寿命与业务负载。
从工程角度看,九章智算云DingoCache 将引擎状态、分布式存储与底层传输置于同一条优化链路:连接器定义对象,客户端组织访问,存储与网络共同缩短恢复路径。这与九章云极以"AI工厂"为战略主线、持续推进算力降本的技术方向一致------在推理成为算力消耗主体的背景下,减少重复计算是降低单位 Token 成本的重要环节。
九章智算云DingoCache 以 Apache 2.0 开放技术,以面向推理的设计缩短数据路径,使已有 SSD 与已有计算继续发挥作用。九章云极表示,希望将投入更多转化为有效推理,而非重复建设与重复计算。