文章目录
- 一、引入
- 二、浮点精度格式
-
- [2.1 float32](#2.1 float32)
- [2.2 float16 与 bfloat16](#2.2 float16 与 bfloat16)
- [2.3 混合精度训练](#2.3 混合精度训练)
- [2.4 fp8 与 fp4](#2.4 fp8 与 fp4)
- [2.4 内存计算基础](#2.4 内存计算基础)
- 三、einops:命名维度张量操作
-
- [3.1 动机](#3.1 动机)
- [3.2 核心操作](#3.2 核心操作)
- [四、FLOPs 计算](#四、FLOPs 计算)
-
- [4.1 FLOP 与 FLOP/s 的区分](#4.1 FLOP 与 FLOP/s 的区分)
- [4.2 矩阵乘法的 FLOPs](#4.2 矩阵乘法的 FLOPs)
- [4.3 训练 FLOPs 与 6ND 公式](#4.3 训练 FLOPs 与 6ND 公式)
- [五、硬件性能与 MFU](#五、硬件性能与 MFU)
-
- [5.1 规格表与实际性能](#5.1 规格表与实际性能)
- [5.2 模型 FLOPs 利用率(MFU)](#5.2 模型 FLOPs 利用率(MFU))
- [六、算术强度与 Roofline 模型](#六、算术强度与 Roofline 模型)
-
- [6.1 硬件示意图](#6.1 硬件示意图)
- [6.2 关键比量](#6.2 关键比量)
- [6.3 Roofline 图](#6.3 Roofline 图)
- 七、内存核算与优化技术
-
- [7.1 训练中的内存组成](#7.1 训练中的内存组成)
- [7.2 内存的双重作用](#7.2 内存的双重作用)
- [7.3 内存优化技术](#7.3 内存优化技术)
-
- [7.3.1 梯度累计(Gradient Accumulation)](#7.3.1 梯度累计(Gradient Accumulation))
- [7.3.2 激活检查点(Activation Checkpointing)](#7.3.2 激活检查点(Activation Checkpointing))
- 八、总结
一、引入
我们的核心目标是在给定有限资源(算力、内存、数据)的情况下训练出最好的模型,数据在本课程中不是真正的瓶颈,目标是最大化训练的计算效率 。在优化计算效率之前,我们需要理解某一个具体计算的效率,因此,需要理解其计算特性 和内存特性 。
问题 1:在 1024 张 H100 上训练一个 700 亿参数、1.5 万亿 token 的模型需要多长时间?
python
params = 70e9
tokens = 1.5e12
flops = 6 * params * tokens  # 前向传播 2(一次乘法一次加法) + 反向传播 4(权重的梯度和输入的梯度,每次为2,和前向传播类似)

h100_peak_bf16_dense = 989e12  # H100 的 bf16 峰值算力为 1979 TFLOP/s(稀疏),稠密需除以 2 得到约 989 TFLOP/s
mfu = 0.5  # 模型 FLOPs 利用率
num_gpus = 1024

seconds = flops / (h100_peak_bf16_dense * mfu * num_gpus)
days = seconds / 86400
print(days)  # 约 143 天
问题 2:在 8 张 H100 上用 AdamW 优化器能训练的最大模型是多大?
python
h100_bytes = 80e9
bytes_per_parameter = 2 + 2 + (4 + 4) # parameters (2), gradients (2), optimizer state (4 + 4)
num_parameters = (h100_bytes * 8) / bytes_per_parameter  # 约 530 亿
H100 每张卡有 80GB HBM,混合精度训练中,每个参数需要 2(bf16 权重)+ 2(bf16 梯度)+ 4(fp32 一阶矩)+ 4(fp32 二阶矩)= 16 字节。这里没有计算激活值,实际值会更小,且取决于 batch size 和序列长度。
二、浮点精度格式
2.1 float32
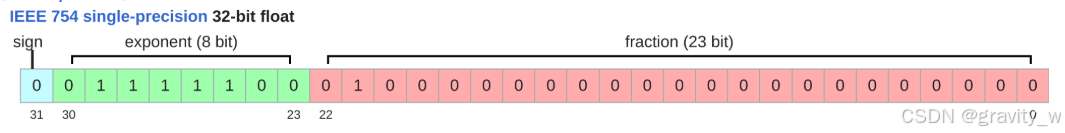
float32 是最基本的浮点格式,共 32 位:1 位符号位、8 位指数位(决定动态范围)、23 位尾数位(决定精度)。
在科学计算中,float 默认指 float32(单精度或 fp32),如果想要更高精度可以用双精度 float64,但在深度学习中,32 位往往太多了,我们想要的计算类型不需要那么高的精度。
python
x = torch.zeros(4, 8)
assert x.dtype == torch.float32 # Default type
assert x.numel() == 4 * 8
assert x.element_size() == 4 # Float is 4 bytes
assert get_memory_usage(x) == 4 * 8 * 4 # 128 bytes
GPT-3 中的一个前馈层矩阵大约占用了2.3 GB,因此张量真的非常大。
python
assert get_memory_usage(torch.empty(12288 * 4, 12288)) == 2304 * 1024 * 1024 # 2.3 GB2.2 float16 与 bfloat16
既然关心效率,我们通常会想减少存储量,降低精度实际上就在节省内存和时间。处理 16 位数据会更快,比如说快一倍(不总是这样,要看情况),另外减少内存其实也能节省时间。
-
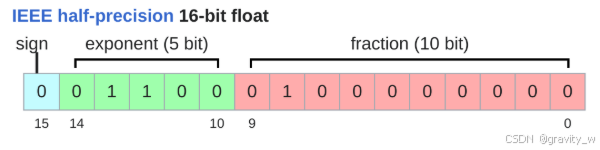
float16 的构成:1 位符号位、5 位指数位、10 位尾数位。它的问题是动态范围太差 ,无法表示非常小或非常大的数(例如 1e-8 会直接变成 0)。用 fp16 训练会出现下溢、上溢和 NaN,非常不稳定。
-
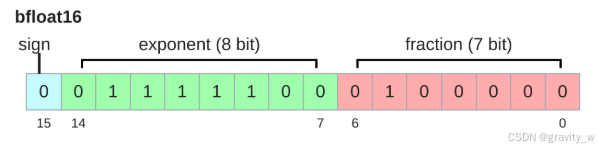
bfloat16 于 2018 年开发,同样 16 位,但将更多的位分配给了指数位:1 位符号位、8 位指数位、7 位尾数位。它的动态范围与 float32 完全相同 ,代价是尾数精度更低。
实验证明,在很多深度学习应用中,动态范围比分辨率更重要,需要保证不上溢或者下溢,因为数据本身就比较粗糙,且有随机性,所以不需要那么高的分辨率,这个权衡非常值得。
-
这对训练意味着什么?
如果训练小模型,直接用 float32 就完全没问题,但每个参数需要 4 字节,会占用很多内存。如果用 float16 训练,风险太大,所以 bf16 是个最佳平衡点,但 bf16 也可能有风险,需要注意。
现在普遍采用的一种做法是混合精度训练。
2.3 混合精度训练
混合精度训练是指某些计算使用一种精度,另一些使用另一种精度。
通用规则:bf16 用于参数、激活值和梯度,fp32 用于优化器状态 。
PyTorch 提供 AMP 库自动处理,在安全处(如矩阵乘法)使用低精度 bf16,在危险处(如指数运算)保持 fp32。
2.4 fp8 与 fp4
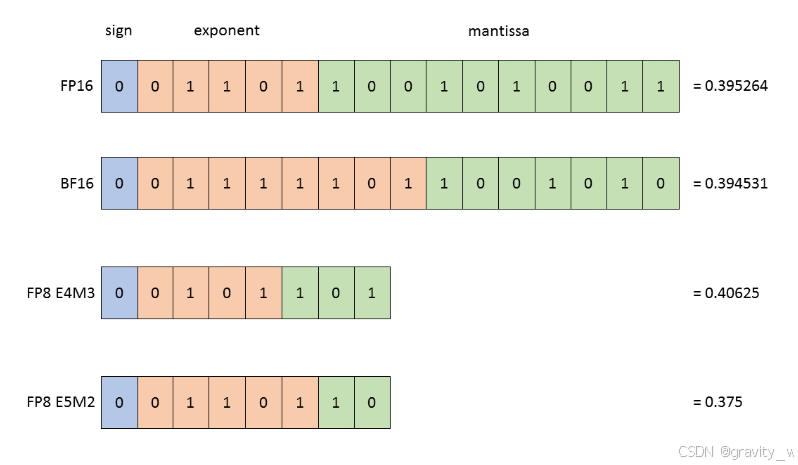
- fp8 有 E4M3 和 E5M2 两种版本,取决于需要更大的动态范围还是更高的分辨率。NVIDIA Transformer Engine 支持 fp8。
- fp4(NVFP4)每个值只有 4 比特,精度非常有限。
Values: -6, -4, -3, -2, -1.5, -1.0, -0.5, 0.0, 0.5, 1.0, 1.5, 2, 3, 4, 6
通过分块缩放 (block scaling)可以在一定程度上扩展可表示的数值范围,即每个块可以整体放大或缩小,有全局缩放因子和块缩放因子,所有值同时除以(全局×局部),让最大值映射到6。Nemotron 3 Super 就是用 fp4 训练的。
需要区分:训练和推理对低比特的要求不同。训练一个 1 比特模型非常困难,但将训练好的 bf16 模型量化到 1 比特或 2 比特则相对容易。
2.4 内存计算基础
内存占用 = 元素个数 × 每元素字节数
关键操作 :PyTorch 默认张量在 CPU 上,需要显式 .to(device) 移到 GPU。
python
device = cuda_if_available()
# 将 x 移动到GPU上
x = x.to(device)
# 或者直接将张量创建在 GPU 上
with torch.device(device):
	x = torch.zeros(32, 32)
	assert x.device == device
三、einops:命名维度张量操作
3.1 动机
传统的 PyTorch 张量操作如 transpose(-2, -1) 使用索引而非名称,容易混淆维度。einops 库受爱因斯坦求和约定启发,使用命名维度替代索引,代码更清晰、不易出错,语法糖,性能一样。
3.2 核心操作
- einsum:广义矩阵乘法。指定输入和输出的维度名称,未出现在输出中的维度会被自动求和。
python
x = torch.ones(3, 4) # seq1 hidden
y = torch.ones(4, 3) # hidden seq2
# old way
z = x @ y
# hidden 维度被求和消掉
z = einsum(x, y, "seq1 hidden, hidden seq2 -> seq1 seq2")

# 三维度例子
x = torch.ones(2, 3, 4) # batch seq1 hidden
y = torch.ones(2, 3, 4) # batch seq2 hidden
# Old way
z = x @ y.transpose(-2, -1) # batch seq1 seq2
# New (einops) way 直接通过命名实现了转置
z = einsum(x, y, "batch seq1 hidden, batch seq2 hidden -> batch seq1 seq2")
# Or can use `...` to represent broadcasting over any number of dimensions 前面的维度都可以用省略号,只需要管后面需要乘的部分
z = einsum(x, y, "... seq1 hidden, ... seq2 hidden -> ... seq1 seq2")- reduce :sum/mean/max/min 的推广。
...代表任意数量的批量维度,右侧未出现的维度被聚合。
python
# 对输入 x 的最后一维 hidden 做 sum 求和,保留前面的维度不变
x = torch.ones(2, 3, 4) # batch seq hidden
# Old way
y = x.sum(dim=-1)
# New (einops) way 原本的维度是... hidden,sum之后变成了...,hidden维度消失了,所以是对hidden维度求sum
y = reduce(x, "... hidden -> ...", "sum")- rearrange:拆分与合并维度。括号表示维度的合并或分解,分解时需指定其中一个维度的值。
python
x = torch.ones(3, 8) # seq total_hidden
w = torch.ones(4, 4) # hidden1 hidden2
# 将 total_hidden 分解为 heads × hidden1,变成了 3 * 2 * 4
x = rearrange(x, "... (heads hidden1) -> ... heads hidden1", heads=2)
# Perform the transformation by w,...代表 3 * 2,所以最后是 3 * 2 * 4
x = einsum(x, w, "... hidden1, hidden1 hidden2 -> ... hidden2")
# 处理后合并
x = rearrange(x, "... heads hidden2 -> ... (heads hidden2)")- einops 让我们以不同的方式思考张量操作,通过形状匹配确定索引顺序,维度推导变得清晰,所有转置和归约都变得流畅且不易出错。
四、FLOPs 计算
4.1 FLOP 与 FLOP/s 的区分
- FLOPs (小写 s):浮点运算的次数,衡量已完成的计算量
- FLOP/s (FLOPS) :每秒浮点运算次数,衡量硬件速度
- 例如:"GPT-3 花了 3.14e23 FLOPs" vs "H100 有 989 TFLOP/s"。
注意 H100 规格表中 bf16 的 1979 teraFLOP/s 包含稀疏性(sparsity),稠密计算需除以 2。
4.2 矩阵乘法的 FLOPs
对于 B×D 与 D×K 的矩阵乘法:
python
# B 是输入的点数,D 是维度,K 是输出的点数
FLOPs = 2 × B × D × K
原因:对每个 (i, j, k) 三元组,做一次乘法和一次加法(从硬件构建的角度看,加法和乘法的计算开销是一样的)。
直观理解:B 是数据点数量,D×K 是参数量,所以做一次线性前向传播,线性层 FLOPs = 2 × token数 × 参数量,这正是 Transformer 6ND 公式的雏形。
- 逐元素操作(如加法):FLOPs = 矩阵大小
- 对于足够大的矩阵,矩阵乘法主导所有其他操作
4.3 训练 FLOPs 与 6ND 公式
对于一个深层网络:
- 前向传播:2 × 数据点数量 × 参数量
- 反向传播 :需要计算两个梯度,对输入的梯度和对参数的梯度,因此是前向的 2 倍,即 4 × 数据点数量 × 参数量
- 总计的FLOPs :6 × 数据点数量 × 参数量,即 6ND
对于 Transformer,只要上下文长度不太大,这也是一个很好的近似,如果上下文长度太大,会出现上下文长度的平方项,增加额外的 FLOPs。
五、硬件性能与 MFU
5.1 规格表与实际性能
- 在硬件上运行实际需要多长时间?
一种方法是直接计时,但在 GPU 上,必须调用 cuda synchronize 来确保正确性,因为 GPU 是异步执行的,如果像下面那样直接计时会出错,CPU 只是把 kernel 提交到 GPU 队列,然后就立刻返回了,测到的只是 CPU 提交任务的时间,而不是 GPU 执行完的时间。
python
torch.cuda.synchronize()  # ① 执行前同步:清空 GPU 队列,确保之前任务都完成
start = time.time()
x @ w
torch.cuda.synchronize()  # ② 执行后同步:等当前操作真正跑完
end = time.time()
实际的 FLOP/s 是:
python
actual_flop_per_sec = actual_num_flops / actual_time每个 GPU 都有不同的理论峰值,根据输入的数据类型,在规格表中查这个 GPU 在该精度下的理论峰值。
python
promised_flop_per_sec = get_promised_flop_per_sec(x.dtype)5.2 模型 FLOPs 利用率(MFU)
MFU = 实际 FLOP/s ÷ 硬件标称 FLOP/s(忽略通信和其他开销)
python
mfu = actual_flop_per_sec / promised_flop_per_sec if promised_flop_per_sec else None对于现代模型,MFU ≥ 0.5 是良好水平,纯矩阵乘法可能达到 0.8,但如果 MFU 只有 0.1,说明存在严重的瓶颈。
MFU 低的一个主要原因是内存瓶颈,GPU 的计算单元不一定总有数据可算,需要等待数据从内存中传输过来。
六、算术强度与 Roofline 模型
6.1 硬件示意图
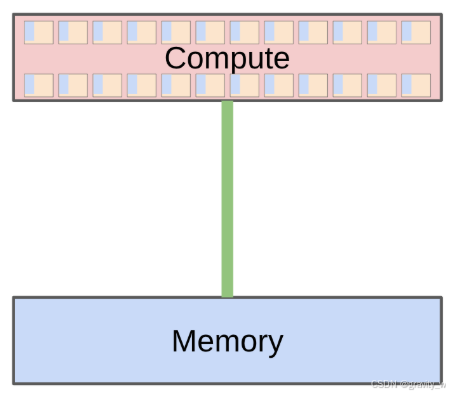
典型的 GPU 硬件有 HBM(高带宽内存)和计算核心所在的加速器芯片。计算时,需要将张量从 HBM 发送到加速器,计算后再将结果发送回去。
因此总时间取决于计算速度 FLOP/s 和内存带宽 bytes/s 两者中的瓶颈。
6.2 关键比量
- 简单比较,直接比较时间
我们需要移动字节,同时需要计算,假设通信时间和计算时间是重叠进行的,那么总时间是两者的最大值。
python
communication_time = bytes / h100_bytes_per_sec # 通信时间
computation_time = flops / h100_flop_per_sec # 计算时间
total_time = max(communication_time, computation_time)
实际上不可能做到完美重叠,当通信时间大于计算时间时,是内存受限,大部分时间都花在等待数据传过来。当计算时间大于通信时间时,是计算受限,瓶颈实际上在计算。
- 另一种理解方式,关于强度
加速器强度 = 每秒 FLOPs ÷ 每秒字节数,即每传输一字节可以做多少运算。
python
# 每移动一个字节,H100 能执行约 295 次浮点运算
h100_accelerator_intensity = h100_flop_per_sec / h100_bytes_per_sec
H100: 1979e12/2 FLOP/s ÷ 3.35e12 bytes/s ≈ 295 FLOPs/byte
算术强度 = 工作负载的 FLOPs ÷ 算法移动的字节数,即每传输1字节实际做了多少次运算
python
arithmetic_intensity = flops / bytes # ~1/4判断标准:
- 算术强度 < 加速器强度 → 内存受限(memory-bound)
- 算术强度 > 加速器强度 → 计算受限 (compute-bound)
各操作算术强度分析: - ReLU :移动 4n 字节(读 2n + 写 2n),FLOPs = n,算术强度 = 0.25 → 内存受限
python
n = 1024 * 1024
x = torch.ones(n, dtype=torch.bfloat16, device=cuda_if_available())
y = torch.relu(x)
bytes = (2 * n) + (2 * n) # Read x, write y (bf16 is 2 bytes/float)
flops = n # n comparisons,每个数和 0 比较- GELU :移动 4n 字节,FLOPs ≈ 20n,算术强度 ≈ 5 → 仍然内存受限(5 << 295)
- 点积 :移动约 4n 字节,FLOPs = 2n-1,算术强度 ≈ 0.5 → 内存受限
python
n = 1024 * 1024
x = torch.ones(n, dtype=torch.bfloat16, device=cuda_if_available())
w = torch.ones(n, dtype=torch.bfloat16, device=cuda_if_available())
y = x @ w
bytes = (2 * n) + (2 * n) + 2 # Read x, read w, write y
flops = 2 * n - 1 # n multiplications, n-1 additions
arithmetic_intensity = flops / bytes # ~1/2
h100_accelerator_intensity = h100_flop_per_sec / h100_bytes_per_sec
assert arithmetic_intensity < h100_accelerator_intensity- 矩阵乘法 (n×n 矩阵):移动约 6n² 字节,FLOPs = n² × n = n³,算术强度 ≈ n/3
python
# 矩阵向量乘法,内存瓶颈
n = 1024
x = torch.ones(n, dtype=torch.bfloat16, device=cuda_if_available())
w = torch.ones(n, n, dtype=torch.bfloat16, device=cuda_if_available())
y = x @ w
bytes = (2 * n) + (2 * n * n) + (2 * n) # Read x, read w, write y
flops = n * (2 * n - 1) # n dot-products
arithmetic_intensity = flops / bytes # ~1
h100_accelerator_intensity = h100_flop_per_sec / h100_bytes_per_sec
assert arithmetic_intensity < h100_accelerator_intensity

# 矩阵乘法,算数瓶颈
n = 1024
x = torch.ones(n, n, dtype=torch.bfloat16, device=cuda_if_available())
w = torch.ones(n, n, dtype=torch.bfloat16, device=cuda_if_available())
y = x @ w
bytes = (2 * n * n) + (2 * n * n) + (2 * n * n) # Read x, read w, write y
flops = n * n * (2 * n - 1) # n^2 dot products
arithmetic_intensity = flops / bytes # ~n/3
h100_accelerator_intensity = h100_flop_per_sec / h100_bytes_per_sec
assert arithmetic_intensity > h100_accelerator_intensity关键洞察:
- ReLU 和 GELU 的隔离性能相同,因为瓶颈在内存,不在计算
- 矩阵乘法因数据量 O(n²) 但计算量 O(n³),具有高算术强度
- Transformer 设计即保证大矩阵乘法主导,这是刻意的架构选择
推理 vs 训练: - 推理逐 token 生成 = 矩阵-向量乘 → 内存受限
- 训练处理整个序列 = 矩阵-矩阵乘 → 计算受限
6.3 Roofline 图
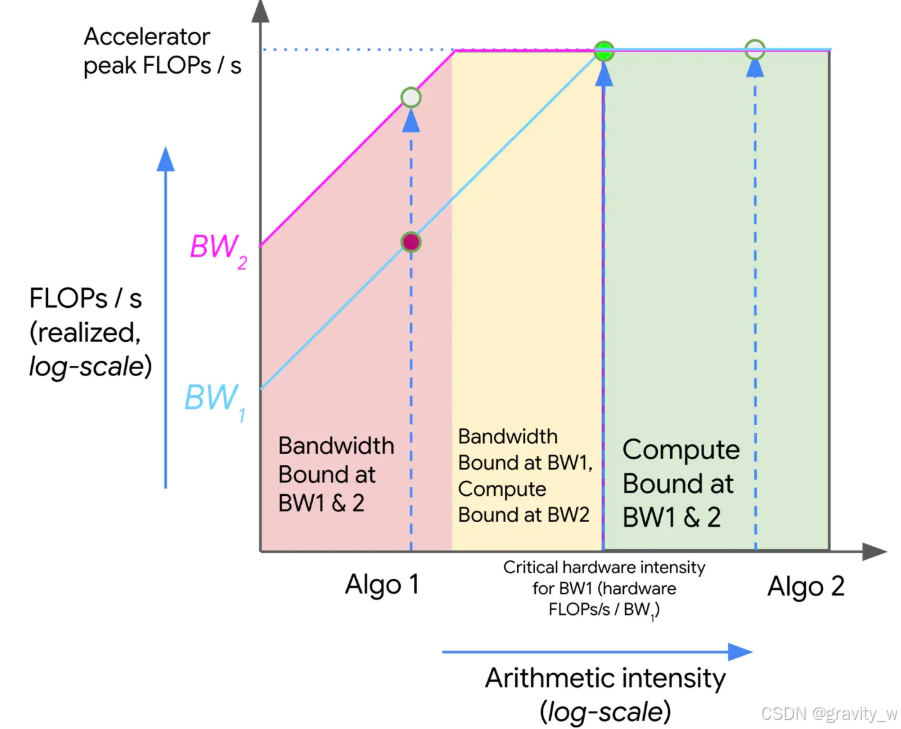
横轴是算术强度,纵轴是实际达到的 FLOP/s,每条线对应一种硬件。转折点就是加速器强度,从 memory-bound 过渡到 compute-bound 的位置。算术强度低时,实际 FLOP/s 远低于峰值;算术强度提高后,逐渐饱和直到计算受限。
七、内存核算与优化技术
7.1 训练中的内存组成
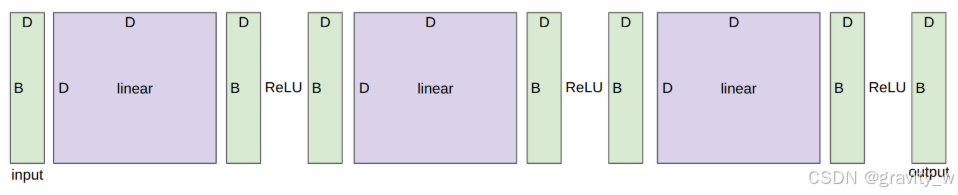
对于一个 L 层、D 维的深层网络,下面几个部分占用的内存分别为:
- 参数:每层是一个 D × D 的矩阵乘法,后面接逐元素 ReLU,D² × L,bf16 = 2 字节/参数
- 梯度:与参数量相同,bf16 = 2 字节/参数
- 优化器状态 :
- AdaGrad 需要需要为每个参数存储梯度平方的累积和,这是一个与参数同形状的张量,如果用 fp 32 存储,那么就是 4 字节/参数(梯度平方和)。
- Adam 需要存储一阶矩(动量)和二阶矩(梯度平方的指数移动平均),两个张量, 8 字节/参数,通常使用 fp32 存储以保证稳定性。
- AdamW 混合精度训练总计约 16-18 字节/参数(不含激活值),其中优化器状态就占了 8 字节。
- 优化器状态的内存开销常常比参数本身还大 ,但优化器状态不是计算瓶颈。它占的是内存容量,影响的是能不能把模型放进 GPU,而不是训练速度有多快。所以优化器状态的大小主要影响的是模型规模的上限,而不是计算效率。
- 激活值 (深度网络在前向传播过程中,每一层产生的中间输出张量,它们是反向传播时计算梯度所必需的,所以训练时必须存在内存里):B × D × L × 2 字节(bf16)
这个和 6DN 公式是两个不同的维度。6DN 公式是计算量,这个公式是训练时存储中间激活的内存。D 代表的也不同,一个是数据点数量,一个是 D h i d d e n D_{hidden} Dhidden 表示隐藏维度。
所以在简单网络里,如果输入是 B × D h i d d e n B × D_{hidden} B×Dhidden,那么
- 参数量 N = D h i d d e n 2 × L N=D^2_{hidden} × L N=Dhidden2×L
- 数据点数量 = B B B(如果一次处理一个 batch)
代入 6ND:
F L O P s = 6 × N × D d a t a = 6 × ( D h i d d e n 2 × L ) × B = 6 B D h i d d e n 2 L FLOPs=6×N×D_{data}=6×(D^2_{hidden}×L)×B=6BD^2_{hidden}L FLOPs=6×N×Ddata=6×(Dhidden2×L)×B=6BDhidden2L
而激活内存:
内存 = 2 B D h i d d e n L 字节 内存=2BD_{hidden}L 字节 内存=2BDhiddenL字节
7.2 内存的双重作用
- 容量限制:决定能否容纳大模型。
- 速度影响:数据传输耗时,优化器状态虽不主导计算,但影响能加载的模型大小。
7.3 内存优化技术
7.3.1 梯度累计(Gradient Accumulation)
问题:大 batch 提高训练稳定性,但激活内存随 batch 线性增长。
方法:
- 将大 batch 拆分为微批次,在微批次上计算梯度并累积(不调 zero_grad)
- 每 batch_size/micro_batch_size 步更新参数并清零梯度
激活内存降为 2 × micro_batch_size × D × L
7.3.2 激活检查点(Activation Checkpointing)
思想 :训练需要存储所有层激活值(内存 O(L),当层数 L 增大时,训练所需存储的激活内存会大致与 L 成正比 ,也就是线性增长),推理不需梯度仅存当前层,以计算换内存 。
实现 :在前向传播时,只存储部分层的激活值作为检查点。反向传播时,对于两个检查点之间的层,从上一个检查点重新做一次前向计算,来恢复中间激活值。
- 不用检查点,全部存储:内存 O(L),无需重算
- 完全不存储:内存 O(1),计算 O(L²),每层都从头算,相当于从 1 到 L 全部重算,从第一层重新开始做一次前向传播,一直算到 L - 1 层,然后才能计算 L 层的梯度。
- 平衡方案 :每 √L 层存一个检查点(检查点的数量是 √L) → 内存可从 O(L) 降低至 O(√L),重计算开销为 O(√L)
PyTorch 提供了torch.utils.checkpoint工具,训练速度通常会慢约 20%,但激活内存大幅降低。
八、总结
- 所有操作都作用于张量:参数、梯度、激活值、优化器状态和数据本质上都是张量。
- einops 提供了一种基于命名维度的张量操作方式,比基于索引的方式更清晰、更不易出错。
- 6ND 公式(FLOPs ≈ 6 × 数据点数量 × 参数量)是估算训练计算量的基础,来源于前向 2ND + 反向 4ND。
- 算术强度 和 Roofline 分析 使我们能够判断一个计算是内存受限还是计算受限。矩阵乘法是计算受限的,其他操作大多是内存受限的。
- MFU 是衡量硬件利用效率的核心指标,0.5 左右是比较好的水平。
- 梯度累积 和激活检查点是两种减少内存使用的标准技术,通过减少内存使用,可以使用更大的 batch size。