金仓、MySQL、PostgreSQL 用什么管理工具?DBeaver、Navicat、KStudio 我都试了一遍
去年做一个数据中台项目的时候,手里同时有 MySQL、Oracle 和 KingbaseES。
一开始我没想太多,直接装了 DBeaver。 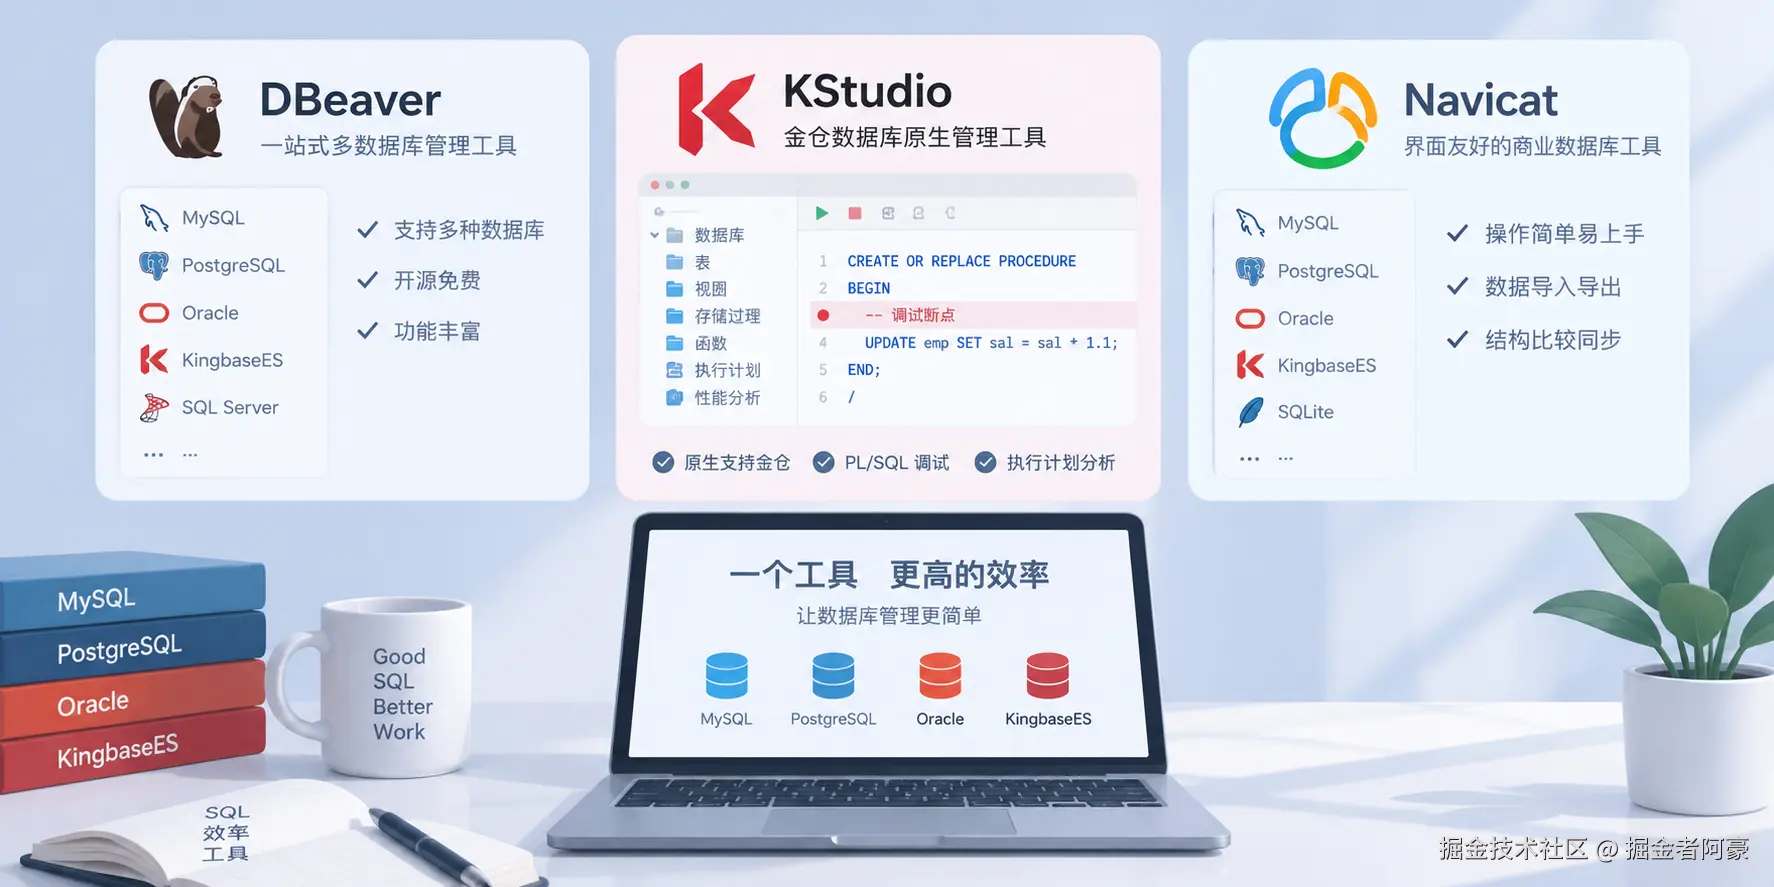
原因也简单:以前 MySQL、PostgreSQL 基本都能用它,一个工具把几个数据库都管了,不用来回切。
MySQL 很快就连上了,结果到了金仓这里卡住了。
连接信息填完,测试连接直接报 JDBC 驱动相关错误。于是开始找驱动、配 Driver Class、改 URL,折腾了半天还是没弄好。
后来同事看见了,问了一句:
你主要是连金仓的话,为什么不用 KStudio?
装上以后,新建连接,填 IP、端口、数据库、用户名密码,直接就进去了。
这件小事后来让我发现,数据库管理工具其实没必要只留一个。
DBeaver、Navicat 这种通用工具解决的是"我有很多种数据库";KStudio 这种原生工具解决的是"我要把金仓用得更深入"。
两者并不冲突。
KStudio,我现在连金仓基本先开它
如果项目主要用 KingbaseES,我现在通常直接用 KStudio。
最直观的原因就是省事。
不用先研究 JDBC 驱动放在哪里,也不用确认 Driver Class。正常安装完成以后,直接创建 KingbaseES 连接即可。
但如果只是为了省一个驱动配置,我觉得还不足以让我专门留一个客户端。
真正有区别的是后面的开发和排查。
比如存储过程。
做数据库迁移的时候,经常会碰到 Oracle PL/SQL、存储过程、函数这些东西。普通 SQL 出问题还比较容易查,存储过程一旦逻辑复杂,光靠:
sql
RAISE NOTICE或者各种日志输出去找问题,效率比较低。
KStudio 里可以直接做图形化调试。
断点、单步、变量查看这些操作和 IDE 调 Java 有点像。
对于平时只写:
sql
SELECT *
FROM user;
的人来说,这个功能可能一年都用不到。
但如果正在做 Oracle 到 KingbaseES 的迁移,或者项目本身有大量存储过程,它就很有用了。
查慢 SQL,我也更愿意回到原生工具
还有一个比较明显的区别是执行计划。
日常开发时,我在 DBeaver 里也会看执行计划。
但真正碰到线上慢 SQL,还是习惯用数据库自己的工具再确认一遍。
例如一条报表 SQL:
sql
SELECT
    department_id,
    COUNT(*),
    SUM(amount)
FROM orders
WHERE create_time >= '2026-01-01'
GROUP BY department_id;
慢的时候不能只看 SQL 本身。
通常还要继续确认:
text
走了什么索引?
估算多少行?
实际扫描多少行?
Join 顺序是什么?
有没有全表扫描?
排序有没有落盘?
KStudio 对 KingbaseES 自己的对象和执行计划展示会更贴近数据库本身。
需要继续做性能分析时,也可以结合金仓自己的性能诊断工具。
所以我的使用习惯慢慢变成:
写普通 SQL,哪个工具顺手用哪个;真正开始查数据库自己的问题,就回原生工具。
但 DBeaver 我一直没卸
虽然现在连金仓会用 KStudio,但 DBeaver 我还是每天开。
原因只有一个:
它管的数据库多。
这点在实际项目里特别方便。
比如做迁移数据核对的时候,我经常是:
text
左边:MySQL
右边:KingbaseES
同一个窗口里查:
sql
SELECT COUNT(*) FROM orders;再抽几条核心数据:
sql
SELECT *
FROM orders
WHERE id IN (...);
不用两个客户端来回切。
项目再复杂一点,还可能同时出现:
text
MySQL
PostgreSQL
Oracle
KingbaseES
SQL Server
这时候 DBeaver 的优势就很明显了。
它不一定是每一种数据库最好用的客户端,但能把很多数据库放到同一个工作台里。
对于开发人员来说,这就已经很值了。
DBeaver 最大的问题,也恰恰来自"什么都能做"
DBeaver 功能非常多。
代价就是菜单也很多。
有时候只是想改一个连接属性,都要在好几层配置里找。
更明显的问题是:
支持某个数据库,和真正理解这个数据库,是两回事。
通过 JDBC,很多数据库都可以接进来。
查询表、修改数据、执行 SQL、看基本对象,这些一般没问题。
但到了数据库自己的高级能力,例如:
text
存储过程调试
数据库特有对象
性能诊断
集群管理
专有参数
通用工具通常就没有原生客户端那么深入了。
这其实也正常。
DBeaver 要兼顾几十种数据库,不可能把每个数据库自己的东西全部做到最深。
所以我现在不会纠结:
KStudio 和 DBeaver 到底留哪个?
两个都留。
硬盘又不差这点空间。
Navicat 是另外一种思路
Navicat 我也用了很多年。
如果单纯说操作体验,我觉得它确实比较容易上手。
特别是第一次接触数据库客户端的人,创建连接、建表、导入 Excel、导出数据、同步结构,基本跟着界面走就能完成。
例如测试库和正式库需要比较表结构。
这类事情用图形化 Schema Compare 做会很舒服:
text
测试库
   ↓
比较
   ↓
正式库
   ↓
生成差异 SQL
不用自己一张表一张表执行 SHOW CREATE TABLE 再对。
所以团队如果本来就购买了 Navicat Premium,而且主要使用 MySQL、PostgreSQL、Oracle 这些数据库,继续用完全没问题。
国产数据库方面,这几年 Navicat 也在不断增加支持。
不过如果工作内容已经深入到 KingbaseES 自身的开发、调试和性能分析,我个人还是会把 KStudio 留着。
有些事情其实不应该让数据库客户端做
这个边界挺重要。
比如从 Oracle 或 MySQL 往 KingbaseES 迁移。
很多人第一反应是:
Navicat 不是有数据传输吗?
少量表当然可以。
测试环境搬十几张表,我自己也会这么干。
但如果变成:
text
几百张表
几十 GB / 几百 GB 数据
存储过程
视图
函数
触发器
增量数据
正式割接
就已经不是"导入导出"这么简单了。
这时候应该把工作拆开。
数据库客户端负责:
text
查数据
写 SQL
管理对象
开发调试
迁移工具负责:
text
兼容性评估
对象转换
全量迁移
增量同步
数据校验
例如金仓自己的 KDMS、KDTS、KFS,解决的就是后一类问题。
之前做迁移项目时,我也越来越明显地感觉到:
不要拿一个好用的数据库客户端,硬做专业迁移工具该做的事。
数据量小的时候感觉不出来。
等正式割接的时候就知道区别了。
还有个小坑:JDBC 驱动
如果用 DBeaver 或其他通用 JDBC 工具连接 KingbaseES,驱动问题还是值得单独记一下。
以前手动配置时,我用过的连接形式类似:
text
jdbc:kingbase8://host:port/databaseDriver Class 则要根据实际使用的 KingbaseES JDBC 驱动确认。
这里我建议不要直接从网上随便找一个 jar。
最稳妥的办法还是:
数据库是什么版本,就优先使用该版本官方提供或明确兼容的 JDBC 驱动。
因为很多时候最难查的不是"完全连不上"。
而是:
text
能连接
能查数据
但某些类型映射不正常
或者:
text
开发环境正常
生产环境某个 JDBC 行为不一样
这种问题比直接报错更折腾。
所以数据库客户端能自动管理驱动当然方便,但生产项目最好还是把 JDBC 驱动版本也纳入项目版本管理。
最后,我现在电脑上三个都留着
折腾一圈以后,我反而没有选出所谓"唯一最好用"的数据库工具。
我的使用方式很简单。
日常 Java 开发、多数据库查询、数据核对,我一般直接开 DBeaver。
需要做 KingbaseES 的存储过程开发、对象管理、执行计划或者深入排查,我会切到 KStudio。
团队已经买了 Navicat,或者临时做数据导入导出、结构比较,我也会继续用。
如果只让我给一个原则,那就是:
不要为了"统一工具"而统一工具。
数据库客户端本来就是提高效率的。
哪个场景哪个工具少折腾,就用哪个。
尤其项目同时存在 MySQL、PostgreSQL、Oracle、KingbaseES 的时候,通用工具和原生工具一起装,往往比强行只用一个舒服得多。
我现在判断一个数据库工具好不好用,也不太看它功能列表有多长。
而是看出问题的时候,我脑子里想的是:
"这条 SQL 为什么没走索引?"
还是:
"这个客户端到底要去哪里配驱动?"
如果是前者,说明工具基本已经做到它该做的事情了。