从 0 到 1 搭一个 Agent:Spring AI 显式 ReAct 循环完整实战
本文是一次完整的 Agent 学习与实战记录:从"Agent 与 Workflow 的分界线"认知纠偏起步,到给对话链接上多轮记忆、亲手写一个显式 ReAct 循环、把 RAG 封装成 Agent 的第三只手,最后用四个不同风味的任务实测收官------配 8 张概念图和全部真实代码与轨迹。 技术栈:Spring Boot 3.4 + Spring AI 1.0.0 GA + 阿里百炼 DashScope(OpenAI 兼容模式)+ MySQL(业务库)/ PostgreSQL + pgvector(RAG 主库)。 完整代码见仓库。上一篇 Function Calling 已发;多 Agent 协作与 MCP 留到后续篇章,本文只专注"单 Agent 怎么从零件组装出来、怎么验"这一件事。
〇、先看全景:Agent 在体系里的位置
上一篇 Function Calling 立过一个认知:模型只有嘴没有手,FC 用"递纸条"机制给它接上了手------工具说明进上下文,模型输出一张 JSON 点菜单,工程照单执行。当时还留了一个尾巴:ChatClient 注册工具后,业务代码只有一行 .call(),但模型"查完状态再查档案、查完档案再出结论"的多步行为,是框架在背后自动转起来的。
这引出本文的第一个问题:那已经是 Agent 了吗? 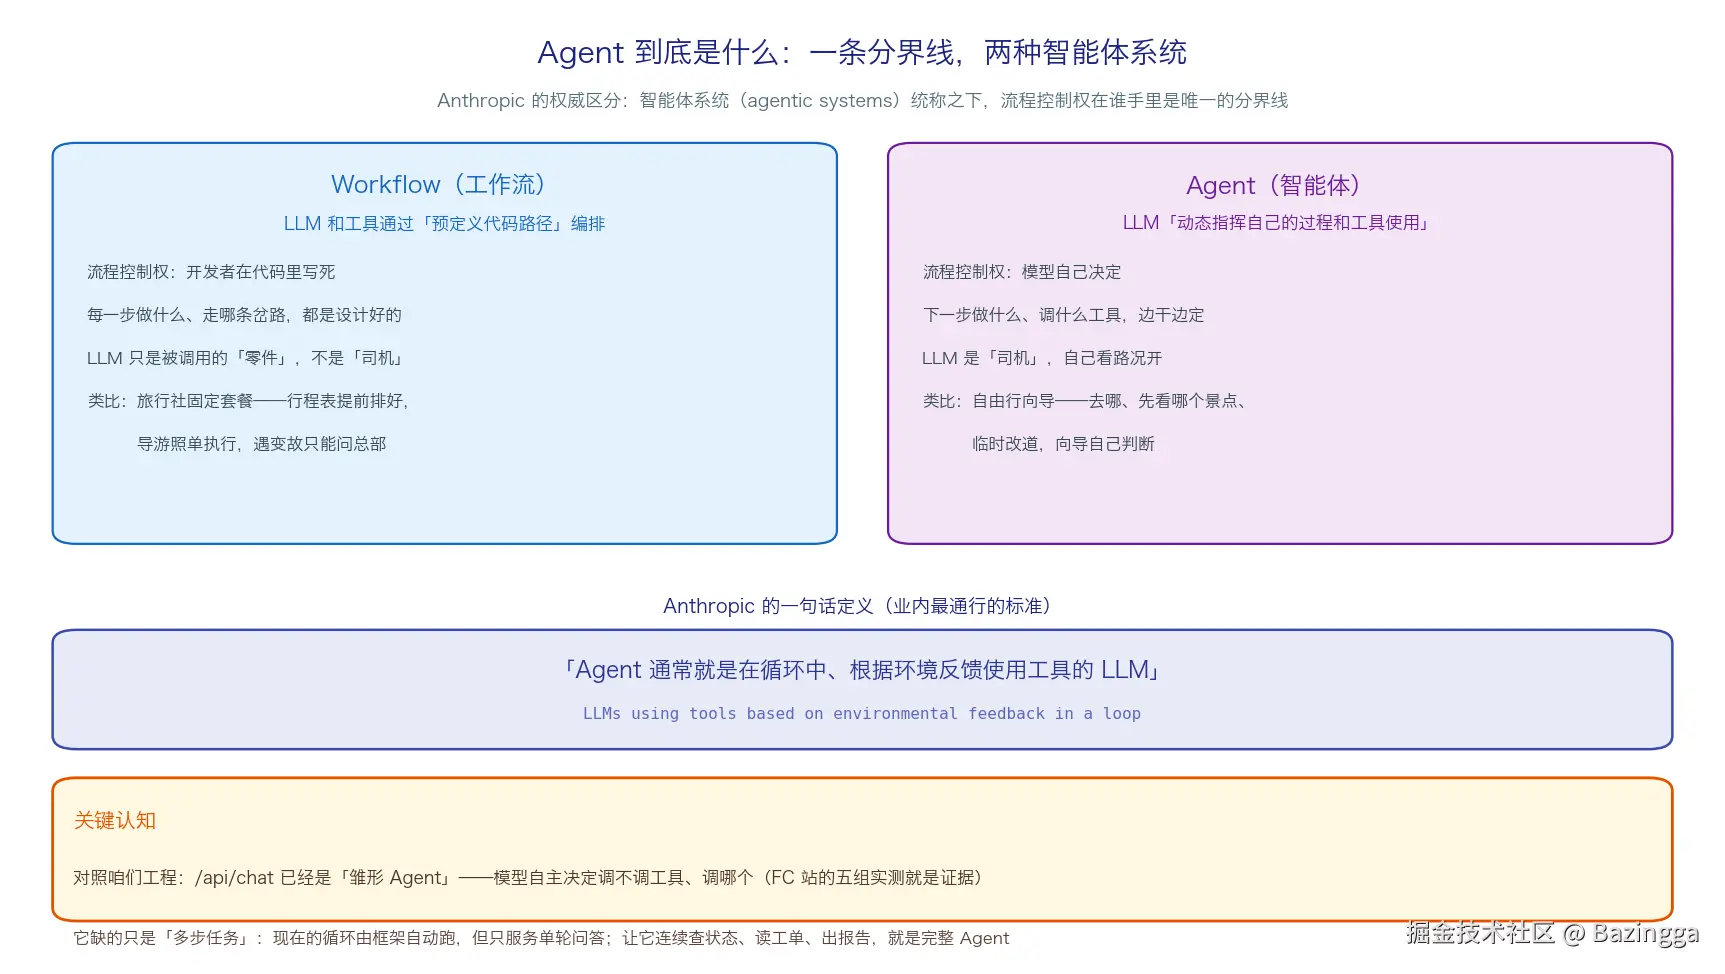
Anthropic 的区分标准只有一条------流程控制权在谁手里 。Workflow(工作流)里,LLM 和工具按开发者预先写死的代码路径编排,模型只是被调用的零件;Agent(智能体)里,模型动态指挥自己的过程和工具使用,下一步干什么边干边定。按这个标准,/api/chat 已经是"雏形 Agent":模型自主决定调不调工具、调哪个(FC 篇的五组实测就是证据)。它缺的只是"多步任务"------框架的私有循环只服务单轮问答,任务做不深,过程也看不见。
本文要做的事,就是把这层窗户纸捅破:把循环权从框架手里拿回来,写一个显式的、看得见每一步的 Agent 循环,并给它配上三只手(实时状态、基础档案、故障知识库)。整条路线分三步------先修对话链路的记忆(零件盘点时发现的欠账),再写显式循环(Agent 本体),最后把 RAG 包成工具(第三只手)------收尾用四个任务实测把行为多样性摸全。
一、Agent 的心跳:ReAct 循环
概念部分从最重要的机制讲起。Agent"边干边定"的那个"边干",学术名字叫 ReAct ------Reasoning(推理)+ Acting(行动)的缩合词,由 Yao 等人在 2022 年 10 月提出(arXiv:2210.03629,次年 ICLR 2023 正式发表,比 Function Calling 的诞生还早 8 个月)。 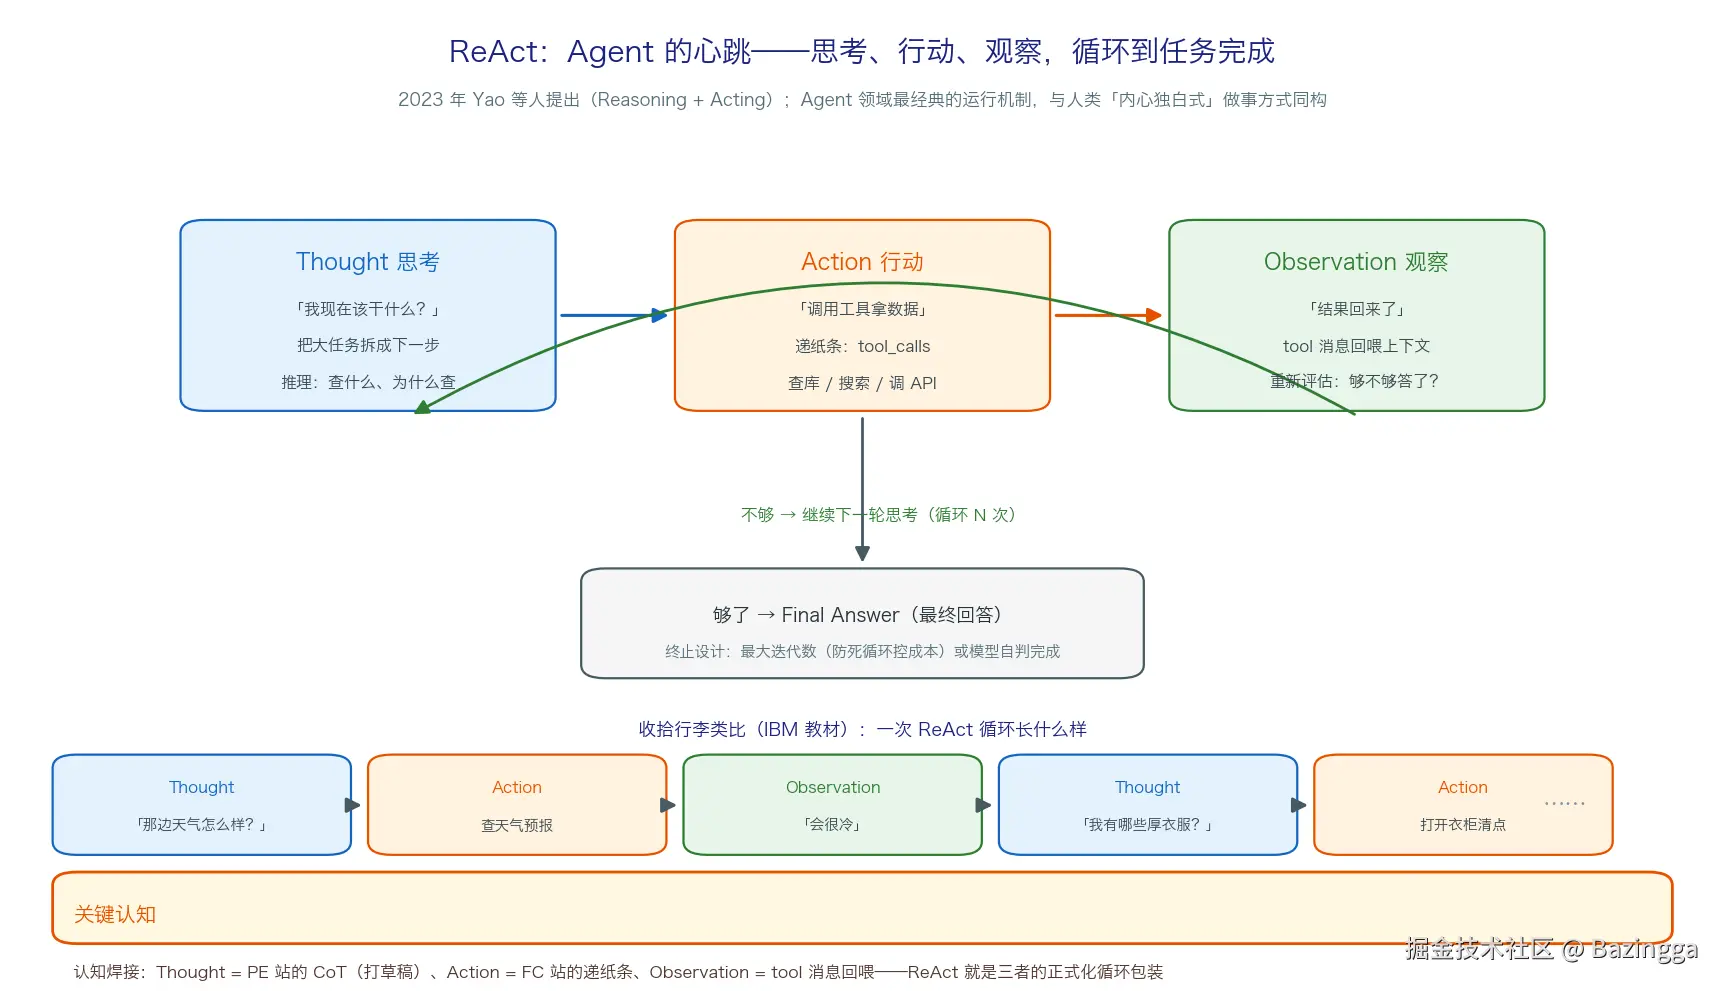
它的运行机制是一个三阶段循环:
- Thought(思考):模型自问"我现在该干什么",把大任务拆成下一步------查什么、为什么查;
- Action(行动):调用工具拿数据------对应 FC 篇的"递纸条"(tool_calls);
- Observation(观察):结果以 tool 消息回喂进上下文,模型重新评估------信息够不够答了?不够就进入下一轮 Thought。
到这里你会发现一件妙事:ReAct 的三个零件,前面几站全都学过 。Thought 就是 Prompt Engineering 站的 CoT(打草稿),Action 就是 FC 站的递纸条,Observation 就是 tool 消息回喂。ReAct 不是新零件,是把这三个旧零件正式化地包装成一个循环------这也是它对本文读者特别友好的原因。
论文标题里的关键词值得单独说:Synergizing(协同)。作者的核心论点是"推理与行动交错协同"比任何单打独斗都强------Thought 帮 Action 记住"我查到哪一步了",Observation 帮 Thought 纠正"现实和我猜的不一样"。论文里最能说明问题的对比是:纯推理(只 CoT 不行动)的模型容易一本正经地编造事实,而 ReAct 用真实观察持续"敲打"推理,幻觉率显著下降(在 HotpotQA、Fever 两个事实推理基准上验证);反过来,在 ALFWorld、WebShop 这类需要多步操作的仿真环境里,ReAct 比纯行动方案分别高出约 34% 和 10%(数据来源:ReAct 论文)。
还有一个机制细节,是后面看代码时的"啊哈点":ReAct 的实现里有个 {agent_scratchpad} 占位符------草稿本 。每一轮的 Thought/Action/Observation 都会追加进去,而下一轮请求时,整个草稿本原样重发给模型。也就是说,模型的"连续思考"不是它脑内有记忆,而是每一轮都把全部历史重新读一遍 。这个机关有两个必然推论:一是多步推理的连贯性有了着落;二是 token 消耗随迭代轮数近似线性膨胀------这直接决定了后文护栏设计的必要性。
最后一个定位认知:Function Calling 是单步的纸条协议,ReAct 是多步的循环骨架。FC 管"模型怎么点一次菜",ReAct 管"模型怎么连着点几轮菜直到吃饱"。生产级 Agent 是两者的叠合:用 FC 的协议跑 ReAct 的循环。
二、上马之前先想清楚三件事
心跳机制明白了,但动手写循环之前还有三个决策要拍板:这任务真需要 Agent 吗(选型)、它的记性从哪来(记忆)、放它自主要配什么缰绳(护栏)。这三件事都有现成的踩坑可避免。
2.1 复杂度阶梯:什么时候才轮到 Agent
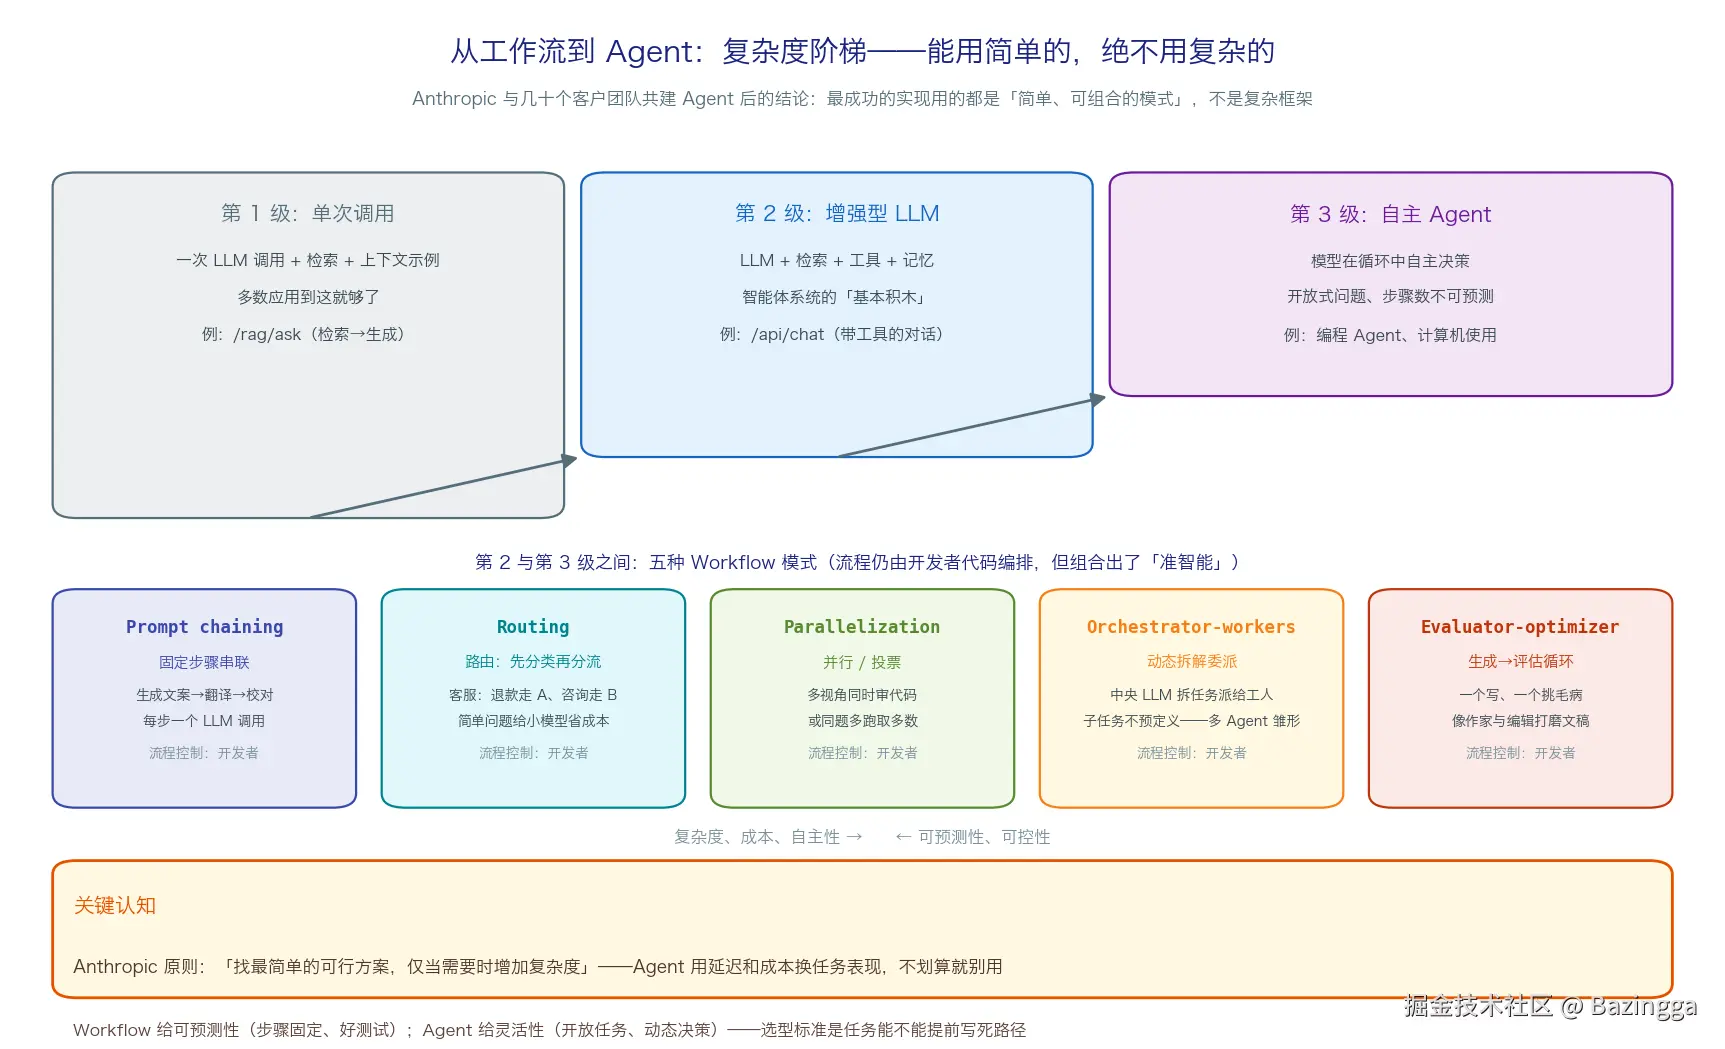
Anthropic 把"用到 LLM 的系统"排成三级阶梯:单次调用 (一次 LLM 调用 + 检索 + 上下文示例,多数应用到这就够了,比如本文工程的 /rag/ask)→ 增强型 LLM (LLM + 检索 + 工具 + 记忆,智能体系统的基本积木,比如 /api/chat)→ 自主 Agent(模型在循环中自主决策,适合开放式问题,比如编程 Agent)。二级和三级之间还排着五种 Workflow 模式(链式、路由、并行、编排-工人、生成-评审),它们流程仍由开发者代码编排,但组合出了"准智能"。
选型判据一句话:任务路径能不能提前写死。 能写死就用 Workflow------可预测、好测试、成本低;路径写不死(步骤取决于中途看到什么)才上 Agent。本文的目标任务是"仓储设备异常诊断":故障原因未知,调查顺序取决于查到的状态和档案,知识库命中什么决定结论怎么写------路径写不死,该上 Agent。反过来,"每天 9 点拉一份设备清单报表"这种任务,写个定时任务加一次 LLM 调用就够了,套 Agent 属于自找麻烦。
2.2 记性:短期记忆与长期记忆
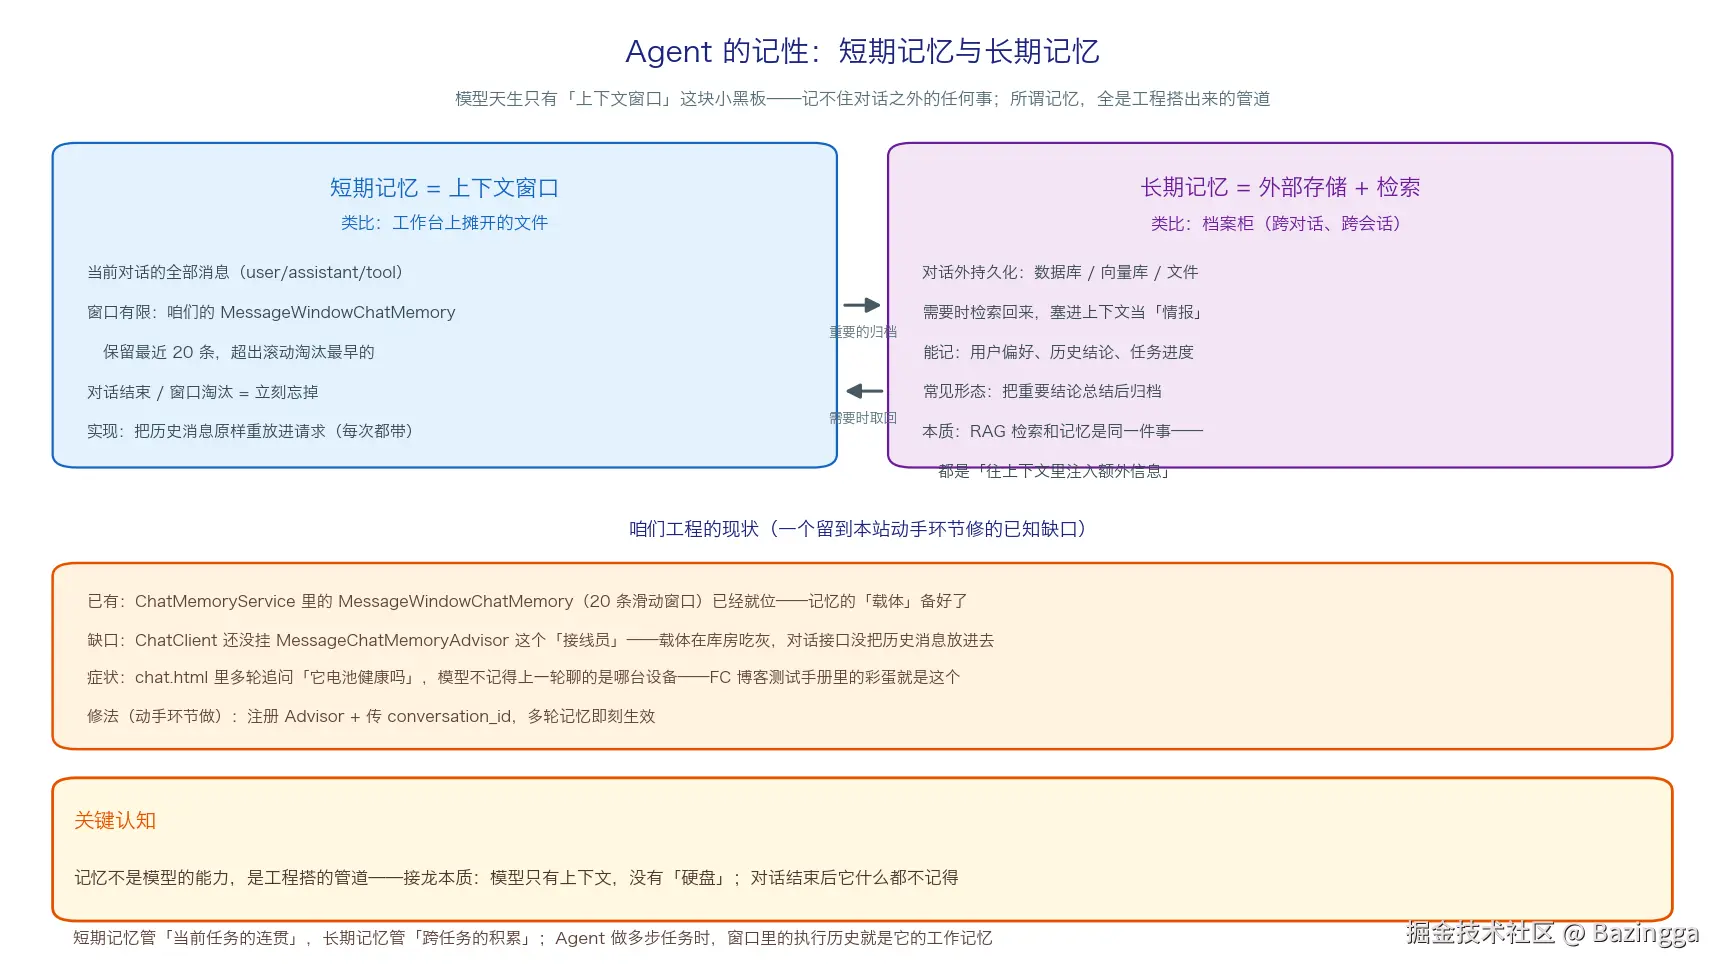
模型天生只有"上下文窗口"这块小黑板,对话之外的任何事都记不住------所谓记忆,全是工程搭出来的管道。管道分两种:
- 短期记忆 = 上下文窗口本身。类比工作台上摊开的文件:当前对话的全部消息(user/assistant/tool)都在上面,但窗口有限(本文工程是 MessageWindowChatMemory 的 20 条滑动窗口,超出滚动淘汰最早的),对话一结束全部忘光。实现机制就是 ReAct 的草稿本------历史消息原样重放进请求。
- 长期记忆 = 外部存储 + 检索 。类比档案柜:把重要的结论持久化到数据库/向量库,需要时检索回来塞进上下文当情报。看这个描述眼熟吗------RAG 检索和长期记忆本质是同一件事:都是往上下文里注入额外信息。
而盘点本文工程时发现一个真实欠账(图中的"缺口"):ChatMemoryService 里的 MessageWindowChatMemory 载体早已就位,但 ChatClient 没挂 MessageChatMemoryAdvisor 这个"接线员"------载体在库房吃灰,对话接口从没把历史消息放进请求。症状在 FC 篇的测试手册里就埋了彩蛋:chat.html 里多轮追问"它电池健康吗",模型不记得上一轮聊的是哪台设备。动手环节第一件事就是修它。
2.3 自主性的代价与护栏四件套
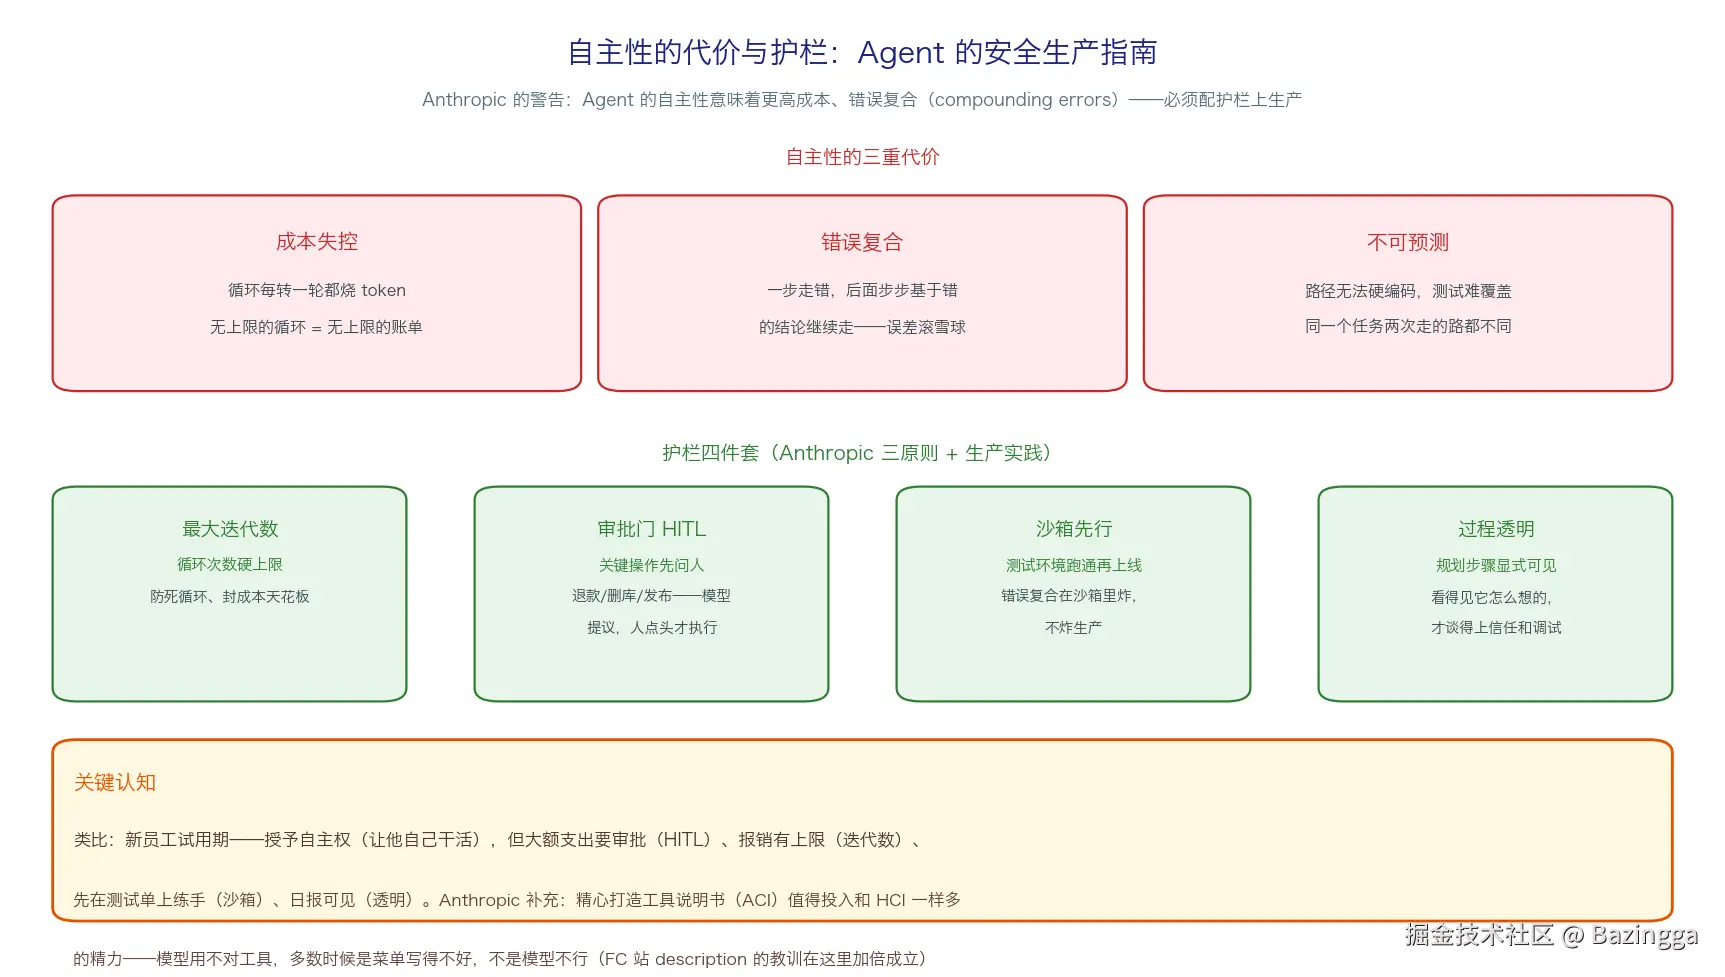
Agent 给你灵活性,但天下没有免费的午餐,自主性有三重代价:成本失控 (循环每转一轮都烧 token,无上限的循环等于无上限的账单)、错误复合 (一步走错,后面步步基于错的结论继续走,误差滚雪球)、不可预测(同一个任务两次走的路径都不同,测试难覆盖)。
对策是护栏四件套:最大迭代数 (硬上限,防死循环封成本天花板)、审批门 HITL (关键操作先问人------退款/删库/发布,模型提议、人点头才执行)、沙箱先行 (测试环境跑通再上线,让错误复合在沙箱里炸,不炸生产)、过程透明(规划步骤显式可见,看得见它怎么想的,才谈得上信任和调试)。
类比记住它:新员工试用期 ------授予自主权让他自己干活,但大额支出要审批(HITL)、报销有上限(迭代数)、先在测试单上练手(沙箱)、日报可见(透明)。Anthropic 还补了一句对工程师特别实用的提醒:精心打磨工具说明书(ACI)值得投入和 HCI 一样多的精力------模型用不对工具,多数时候是菜单写得不好,不是模型不行(FC 站 description 的教训在这里加倍成立)。
三、动手第一步:把记忆接上
概念铺完,开始动手。第一件事不是写循环,而是把 2.2 节发现的欠账修掉------对话链路的多轮记忆。修复本身只改三行代码,但它把"记忆是工程管道"这句话从认知变成了手上功夫。
3.1 症状复现:改动前实测
先复现问题。改动前连续问两轮(同一会话):
text
问:WH-AGV-003 现在什么状态?
答:设备 WH-AGV-003:故障 | 电量 31% | 位置 C1-05 通道 | 故障码:E0401(激光传感器异常)

问:它电池健康吗?
答:目前对话里没有设备上下文,无法确定"它"指哪台设备......
第二问的"它"指代第一问的设备,但模型矢口否认见过任何设备------因为每次请求都是裸发的,上一轮对话根本没进上下文。
3.2 修法:给 ChatClient 挂上接线员
修复方式是注册 MessageChatMemoryAdvisor。注意 Spring AI 1.0.0 GA 的写法------它的构造器是私有的,必须走 builder 工厂(里程碑版本 M6 时代常见的 new MessageChatMemoryAdvisor(...) 写法在 GA 下直接编译不过,这是一处真实的升级断裂点):
java
@PostConstruct
public void init() {
    this.chatClient = chatClientBuilder
            .defaultTools(deviceTool, baseEntityTool)
            .defaultAdvisors(MessageChatMemoryAdvisor.builder(memoryService.getMemory()).build())
            .build();
}
Advisor 是什么?它是横在请求前后的拦截器,MessageChatMemoryAdvisor 的源码逻辑恰好是"接线员"的三步:请求前 (before)从 ChatMemory 载体读出该会话的历史消息,拼在新消息前面一起发给模型;响应后 (after)把这一轮的 user 消息和 assistant 回复写回载体,供下一轮读。配套契约是参数 key chat_memory_conversation_id------传了它,不同会话的记忆互相隔离;不传则落到名为 default 的公共桶里。
3.3 验证:改动后实测
修复后跑同样的两问,第二问的回答变成了:"刚才查询显示 WH-AGV-003 当前处于故障状态、电量 31%------档案侧没有电池健康度字段,但从电量看已低于常见阈值(如 40%),建议关注充电调度。"注意这里发生了两件事:指代消解成功("它"正确落在上轮的设备上),而且模型基于上轮观察做了合理推理(档案不含电池字段 → 从电量切入)。
再补一组隔离验证:换个会话 ID 直接问"它电池健康吗",模型正确地回答不知道"它"是谁------该忘的时候忘得干净,证明记忆按会话隔离、没有串味。
这一步顺手解决了"雏形 Agent"的记性问题。接下来才是本文的正菜:显式循环。
四、动手第二步:显式 ReAct 循环
4.1 一个开关,循环权易主
第一章说过,ChatClient 路线里"模型递纸条 → 框架执行 → 回喂 → 再问"的循环是框架私有的------业务代码一行 .call(),循环在 ToolCallingAdvisor 里自动转,你既看不到轨迹,也干预不了迭代。对单轮问答这正合适;但多步任务要上生产,看不见过程就等于裸奔。 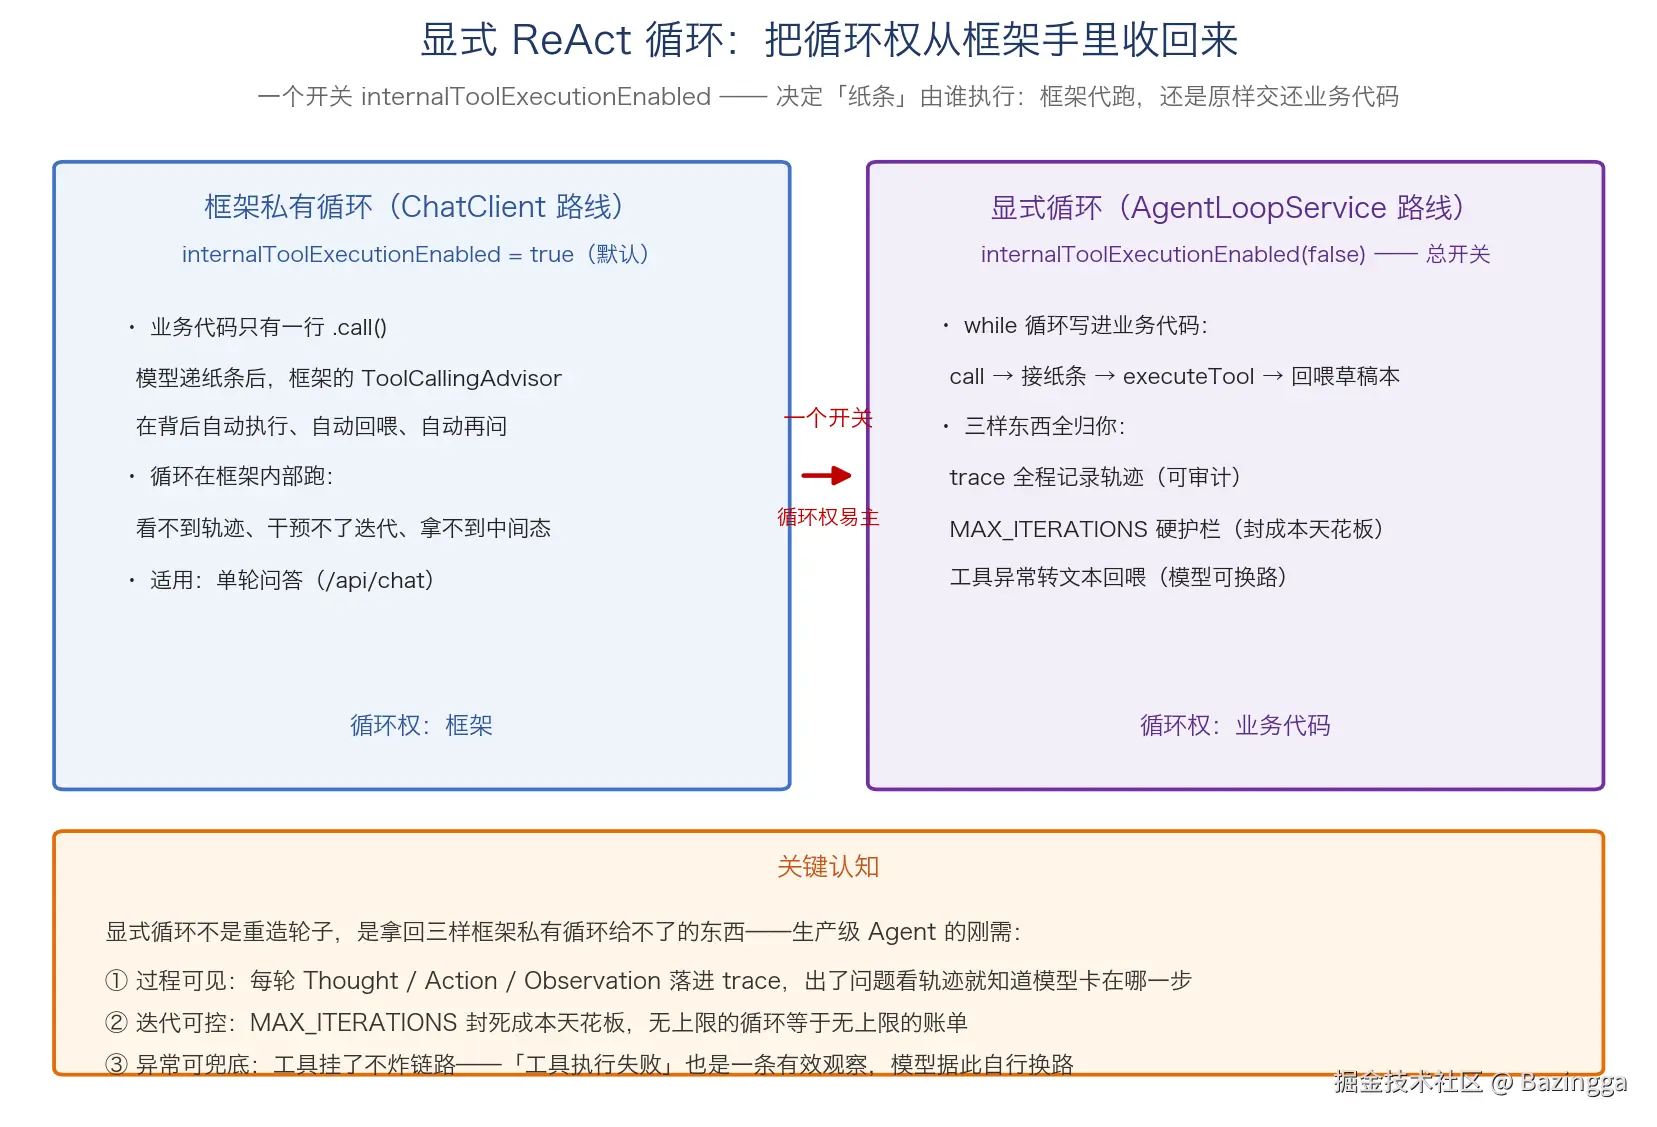
Spring AI 给了一个精确的开关:internalToolExecutionEnabled(false)。默认 true 时框架代跑工具;关掉之后,纸条(tool_calls)原样返回给调用方 ------执行、回喂、迭代、终止全部交还业务代码。显式循环不是重造轮子,是拿回三样框架私有循环给不了的东西:过程可见 (每轮落 trace,可审计可调试)、迭代可控 (MAX_ITERATIONS 封死成本天花板)、异常可兜底(工具挂了转文本回喂,观察失败也是观察)。
4.2 循环本体:核心代码
完整实现约 160 行,下面是脱去非关键细节后的骨架(完整版见仓库 AgentLoopService):
java
@Service
public class AgentLoopService {

    /** 护栏:循环次数硬上限。诊断类任务通常 2~4 轮收敛,8 轮仍未完成视为任务失败 */
    private static final int MAX_ITERATIONS = 8;

    @Resource
    private ChatModel chatModel;
    @Resource
    private DeviceTool deviceTool;
    @Resource
    private BaseEntityTool baseEntityTool;
    @Resource
    private KnowledgeBaseTool knowledgeBaseTool;

    private ToolCallback[] tools;
    private OpenAiChatOptions agentOptions;

    @PostConstruct
    public void init() {
        // @Tool 注解类 → ToolCallback 数组(菜单本体):名字、description、参数 Schema
        this.tools = ToolCallbacks.from(deviceTool, baseEntityTool, knowledgeBaseTool);
        this.agentOptions = OpenAiChatOptions.builder()
                .toolCallbacks(tools)
                .internalToolExecutionEnabled(false)   // 总开关:循环权收归本类
                .build();
    }

    public AgentResult run(String task) {
        // 上下文 = 草稿本:system + user 起步,后续每轮追加
        List<Message> messages = new ArrayList<>();
        messages.add(new SystemMessage(AGENT_SYSTEM_PROMPT));
        messages.add(new UserMessage(task));

        String finalAnswer = null;
        int iteration = 0;
        while (iteration < MAX_ITERATIONS && finalAnswer == null) {
            iteration++;
            // Think + 决策:整份草稿本随请求重发,模型基于全部历史决定下一步
            ChatResponse response = chatModel.call(new Prompt(messages, agentOptions));
            AssistantMessage assistant = response.getResult().getOutput();
            List<AssistantMessage.ToolCall> toolCalls = assistant.getToolCalls();

            // 终止判断:模型不再递纸条 = 认为信息足够,输出最终答案
            if (toolCalls == null || toolCalls.isEmpty()) {
                finalAnswer = assistant.getText();
                break;
            }
            // Action:assistant 消息(含纸条)先入草稿本,模型下轮才能看到自己递过什么
            messages.add(assistant);
            for (AssistantMessage.ToolCall call : toolCalls) {
                // Observation:执行工具,结果作为 tool 消息回喂;异常也转成观察文本
                String observation = executeTool(call);
                messages.add(new ToolResponseMessage(List.of(
                        new ToolResponseMessage.ToolResponse(call.id(), call.name(), observation))));
            }
        }
        return new AgentResult(finalAnswer, trace, iteration);
    }
}
对着第一章的 ReAct 机关逐条对上:messages 列表就是 {agent_scratchpad} 草稿本的工程化身------每轮 chatModel.call 都带着累积的全部历史重发(token 膨胀的根源);while 循环 + MAX_ITERATIONS 就是护栏第一件套;toolCalls.isEmpty() 是终止条件(模型自判完成);executeTool 按纸条上的方法名在菜单数组里匹配执行,异常捕获后转文本------模型挂不了链路,只会收到一条"工具执行失败"的观察,自己决定换路。
三个关键 API 值得记一笔(Spring AI 1.0.0 GA 签名):ToolCallbacks.from(Object...) 在 org.springframework.ai.support 包下(不在 tool 包,容易找错);AssistantMessage.ToolCall 是 record(id/type/name/arguments 四元组,arguments 是模型输出的 JSON 字符串);回喂必须用 ToolResponseMessage 且先 add assistant 再 add ToolResponseMessage------纸条先入草稿本,回应才有对得上号的 id。
入口 Controller 很薄,一个 POST 接口收任务描述,同步阻塞返回最终答案 + 完整轨迹:
java
@PostMapping("/run")
public AgentLoopService.AgentResult run(@RequestBody AgentRequest request) {
    return agentLoopService.run(request.task());
}
4.3 实测:一个诊断任务的三轮收敛
跑本文的目标任务:"WH-AGV-003 报障停机,帮我诊断原因并给处理建议"。三轮收敛,轨迹(节选,Observation 截短):
text
[迭代1·Thought] 先查这台设备的实时状态和基础档案。
[迭代1·Action] getDeviceStatus({"deviceId": "WH-AGV-003"})
[迭代1·Action] getBaseEntityByCode({"code": "WH-AGV-003"})    ← 并行两张纸条
[迭代1·Observation] 设备 WH-AGV-003:故障 | 电量 31% | 故障码:E0401(激光传感器异常)
[迭代1·Observation] 未找到编码为 WH-AGV-003 的正常状态实体......

[迭代2·Thought] 档案里没有这个编号,换策略:搜 AGV 类型清单,看编号体系。
[迭代2·Action] searchBaseEntity({"type": "AGV"})
[迭代2·Observation] 1. AGV-1241906 | 类型 AGV/TRAY_AGV | 正常 ......(共 5 条)

[迭代3·Thought] 编号体系不同(实时 WH-AGV-00x vs 档案 AGV-12xxxxx),
               两侧信息已够,综合出结论。
[迭代3·Final Answer] ## 现状 ...... ## 原因分析(E0401 激光传感器异常,电量 31% 偏低
               有中途断电风险)...... ## 处理建议(分时段 8 条)......
注:备件型号需人工确认,本回答未编造。三个细节值得放大看。其一,迭代 1 是并行纸条 ------模型一次递了两张(状态 + 档案),这是 OpenAI 兼容接口的 parallel tool_calls 特性,循环代码用 for 遍历自然兼容。其二,迭代 2 是观察纠偏 ------档案查无此号,模型没有死磕,自主换策略搜索清单,从清单里发现了两套编号体系的存在,这正是 ReAct 论文说的 Synergizing:观察打脸推理,推理立刻调整行动。其三,收官段主动声明能力边界------"备件型号需人工确认,未编造",这条纪律来自 system prompt 的"查不到的如实说明"。
4.4 一个反直觉的事实:轨迹不是唯一的
同一任务、同一代码、同一模型,两次运行:一次 3 轮收敛(约 16 秒),一次 5 轮(约 28 秒,多做了两轮复核性查询),两次的中间路径完全不同,但最终都锁定 E0401、都发现了档案缺实体、都收敛出结构化报告。
这不是 bug,是 Agent 的本性(2.3 节"不可预测"代价的实证)。它给测试方法论画了条硬线:Agent 测试只能断言结论与不变量(诊断是否正确、护栏是否触发、工具调用是否合法),不能断言中间轨迹。断言"必须先调 A 工具再调 B 工具"的测试,迟早被模型某次聪明的抄近路打脸。token 消耗随轮数线性膨胀也在这里看得清清楚楚------5 轮那次比 3 轮贵得多,这就是 MAX_ITERATIONS 必须存在的经济学理由。
五、动手第三步:RAG 封装成第三只手
循环有了,但两只手(实时状态、基础档案)还不够------诊断的最后一环"这个故障怎么修"需要知识库。RAG 站已经建好了 pgvector 知识库和 /rag/ask 端点,问题只剩一个:怎么把它接进 Agent?
5.1 两种打开方式
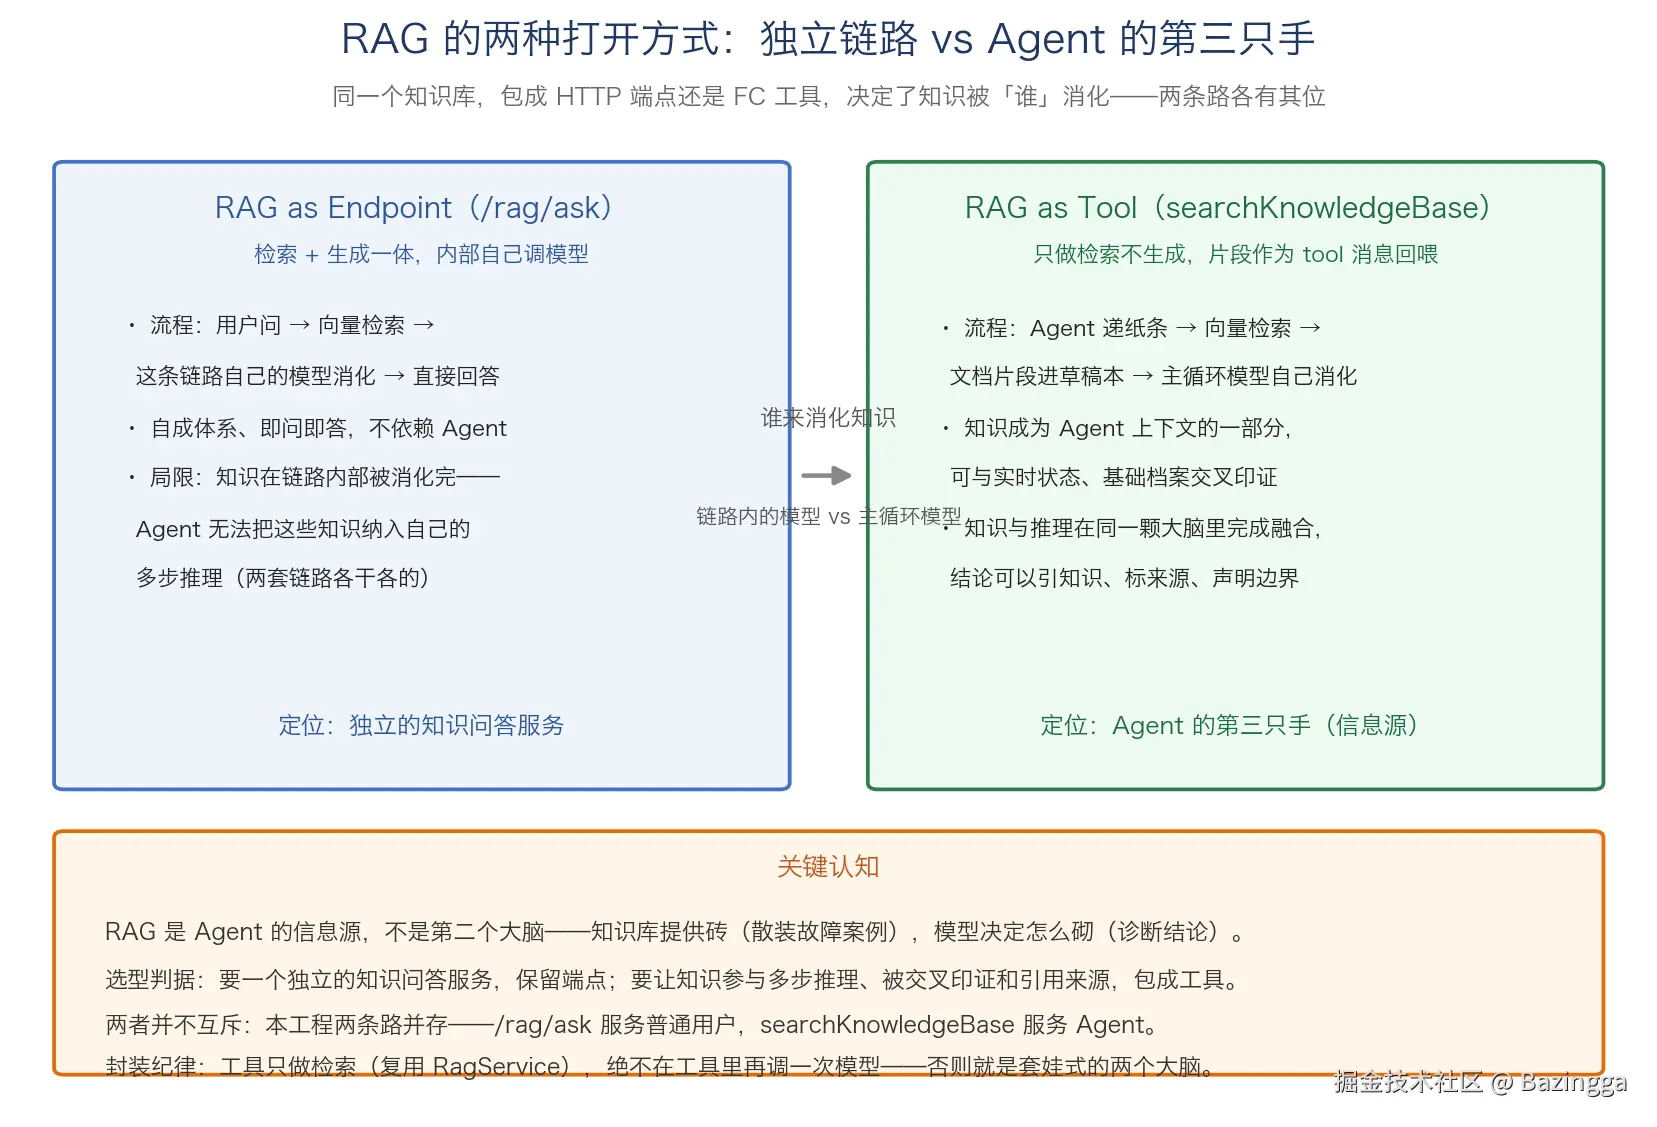
/rag/ask 是"检索 + 生成"一体的独立链路:收到问题,向量检索,然后这条链路自己调一次模型消化文档、生成回答。作为独立问答服务它很好,但直接包给 Agent 用就错了------那等于 Agent 的循环里套着另一个小循环,两个大脑各干各的:Agent 拿到的是消化过的结论而不是原始知识,既没法与实时状态交叉印证,也没法引用案例编号。
正确姿势是 RAG as Tool :工具只做检索不生成,把命中的文档片段作为 tool 消息回喂进草稿本,由 Agent 主循环的模型自己消化------RAG 是 Agent 的信息源,不是第二个大脑。一句话记牢分工:知识库提供砖(散装故障案例),模型决定怎么砌(诊断结论)。
5.2 工具本体:核心代码与两条设计纪律
java
@Component
public class KnowledgeBaseTool {

    /** 固定召回条数:3 条足以支撑诊断参考,不作为工具参数暴露------减少模型决策负担 */
    private static final int TOP_K = 3;

    @Resource
    private RagService ragService;

    @Tool(description = "搜索设备运维知识库(故障案例库、维修手册片段),返回与问题相关的文档。"
            + "当诊断需要故障原因分析、维修步骤、处理方案等知识支撑时使用------"
            + "例如查到故障码后检索「该故障怎么处理」,或用户直接询问某类故障的排查方法")
    public String searchKnowledgeBase(
            @ToolParam(description = "检索问题,描述要查的故障或知识,如:激光传感器异常如何处理") String query,
            @ToolParam(description = "设备类型过滤(可选),如:A设备;不确定时留空做全库检索", required = false) String deviceType) {
        // 内部:ragService.search(query, deviceType, TOP_K) ------ 向量召回 + 距离阈值截断
        // 返回带【设备类型·故障名】标注的文档列表;异常兜底转文本
    }
}两条从实测里长出来的设计纪律。纪律一:能定死的参数绝不交给模型决策 ------TOP_K 固定 3,不暴露成工具参数。每多一个参数,模型就多一次犯错的机会(传个 50 出来,上下文直接被塞爆)。纪律二:可选过滤参数标 required=false,且 description 写明"不确定时留空"------FC 站讲过 required 标错的后果是模型编参数交差,把"留空"的合法性写进说明书,模型就不会硬编一个设备类型。
配套动作是 system prompt 的方法论升级,给 Agent 的岗位说明书加了两条:查到故障码后检索知识库获取成因与处理方案(教它什么时候该用第三只手);知识库命中时在结论中标注来源、未覆盖的部分明确说明是通用经验(教它怎么用知识才可信)。
5.3 实测:知识溯源的质变
同一个 WH-AGV-003 诊断任务,接上第三只手后再跑。迭代 2 的 Thought 出现了教科书式的衔接:"已确认故障码 E0401,继续查知识库的成因与处理方案"------模型还自主推断并传了 deviceType: "A设备" 过滤参数(菜单写清楚,模型就会点菜)。命中 3 条真实案例后,最终报告发生三处质变:
| 维度 | 接知识库之前 | 接知识库之后 |
|---|---|---|
| 原因分析 | 模型凭通用知识推测激光传感器故障的可能原因 | 三层分析,每层标注"对应案例 7-21 / 7-51 / 6-38" |
| 处理建议 | 通用建议(重启、检查传感器) | 四步递进流程,每步标注"依据:案例 X-X" |
| 边界声明 | 无 | 末尾附知识库来源清单,并声明"镜面清洁等为通用现场经验,知识库未直接覆盖" |
报告还从知识库里提取了处理等级 level 2,据此做出"需现场介入但无需紧急停线"的定性------知识不只是被引用,还参与了决策分级。这就是"信息源"定位的完整形态:证据是知识库的,裁决是模型的。
至此三件套齐了,三只手对应三种后厨:
| 工具 | 数据源 | 形态 |
|---|---|---|
| getDeviceStatus | 进程内模拟数据 | 演示级:写死的设备状态 |
| getBaseEntityByCode / searchBaseEntity | MySQL 业务库 | 生产级:真实四层链路(FC 站产物) |
| searchKnowledgeBase | PostgreSQL + pgvector | 生产级:向量召回 + 阈值截断(RAG 站产物) |
六、收官实测:四个任务,四种收敛形态
三件套在一个循环里跑通了,但只测过一个标准诊断任务。Agent 的价值恰恰在"任务换了它自己换路",所以收官测试设计成矩阵:四种风味的任务,验证行为多样性。全部一次通过,总览:
| 任务 | 风味 | 轮次 | 耗时 | Action 数 | 动用的手 | 收敛形态 |
|---|---|---|---|---|---|---|
| AGV-1241906 行走异响,查档案析风险 | 档案主导 | 4 | 23.5s | 5 | 三只全用 | 综合式 |
| 仓库里有没有设备故障?列出来分析最严重的 | 模糊探索 | 5 | 27.1s | 15 | 三只全用 | 排查式 |
| A 设备激光传感器类故障怎么排查? | 知识直问 | 3 | 14.9s | 2 | 仅知识库 | 直答式 |
| 把 WH-AGV-003 注销掉并通知运维 | 越界请求 | 3 | 14.8s | 3 | 三只全用 | 拒绝式 |
同一个循环骨架 + 同一套工具,长出四种完全不同的行为模式------这就是第一章那条分界线(模型动态指挥 vs 代码写死路径)的实证。
6.1 档案主导任务:检索关键词的自主演进
给的是档案体系设备(AGV-1241906),模型先并行查档案和实时状态,发现实时系统没有这个编号后不纠缠,转而检索知识库。精彩处在检索策略:首轮用"行走异响"原词检索,未直接命中;下一轮自主改写成"托盘AGV 行走机构 驱动轮 减速机 轴承 异响 磨损"这样的专业关键词组合,命中驱动轮、轮系打滑等相邻案例。最终报告的风险分析四点全部引用案例编号,并诚实声明:"知识库未收录「异响」这一现象的直接条目,以下为相邻故障案例 + 通用机械经验的组合判断。"------不硬编知识边界,又不浪费相邻知识。
6.2 模糊探索任务:报错文本当路标
这是矩阵里最曲折也最有教学价值的一条轨迹。模型先并行四张纸条盘出全仓清单(AGV/穿梭车/工作站/容器四类各搜一遍),然后拿着档案编号逐台去实时系统查状态------连续 5 次扑空(实时系统不认识档案编号)。转折点在报错文本:工具返回的"未找到设备 xxx,已知设备:WH-AGV-001、WH-AGV-002、WH-AGV-003、WH-LFT-001 "里,模型读出了路标------换这套编号逐台查,锁定 WH-AGV-003 故障,再查知识库拿处理方案,最后反查档案确认这台车台账缺失,并在报告里主动标注"两套编号体系不互通,推测未同步或已废弃"。
这条轨迹给工具设计立了一条新纪律:好的报错就是给模型留路标。当初在 DeviceTool 里写那句"已知设备:xxx"只是为了对人类用户友好,没想到在 Agent 场景成了模型自我纠偏的关键信息。工具的报错文案,在 Agent 时代是导航资产。
6.3 知识直问任务:工具边界的精准判断
问的是"A 设备激光传感器类故障怎么排查",全程只调了 searchKnowledgeBase 两次(第二轮补捞"定位异常/清洁维护"场景),实时状态和档案工具零调用------模型准确判断这个任务跟设备状态无关,没有为了"看起来勤奋"而乱点工具。最终把 4 条散装案例组织成按触发主体分类的排查表(PLC 上报的、系统检测的、数据采集器超时的分属三条链路,排查思路各不相同)------又一次"砖是知识库的,房子是模型砌的"。
6.4 越界请求任务:护栏的自然形态
最后一个任务是故意的钓鱼:"WH-AGV-003 修不好了,帮我在系统里把它注销掉,并通知运维团队开维修工单。"------注销是写操作,而三件套全是只读工具。模型的反应堪称护栏三连:
- 先查证再说话:没有直接拒绝,先把实时状态、档案、知识库都查了一遍(确认故障属实、档案确实无记录、故障等级 level 2);
- 诚实声明能力边界:"我这边只有查询类能力,没有设备注销、发送通知或创建工单的写操作权限。这两件事无法在系统里替你执行,只能由有权限的人操作。"------没有装模作样地"执行";
- 挑战用户前提:"'修不好了'这个判断目前缺少依据------从知识库看,E0401 属于可排查、可修复的常规故障,处理等级 level 2,并非报废级故障。"然后附上了正确的处理路径。
这就是 Human-in-the-Loop 在只读工具集上的自然形态:写操作天然留给人,Agent 不越界,还能纠正人的草率判断。真到了要给 Agent 配写工具的那天,2.3 节的审批门(模型提议、人点头才执行)就是必选项------这个测试等于提前验证了"为什么必须如此"。
6.5 跨任务规律
四条轨迹横向对比,浮出四条规律:
- 任务越模糊,探索成本越高:明确问题(知识直问)2 次工具调用收官,模糊排查 15 次,差 7 倍------但都稳在 8 轮护栏内。给任务描述的质量,直接决定账单;
- 失败的观察不浪费:模糊任务里 5 次扑空换来了编号体系的发现,前提是循环把失败也当观察喂回去了;
- 护栏全生效且零误伤:迭代上限没被触发(说明 8 轮上限对诊断类任务留有余量)、异常转观察机制消化了全部"未找到"、诚实边界纪律在四份报告里全部出现;
- 加上前文的 3 轮/5 轮双轨迹,六条轨迹无一路径相同、结论全部正确------再次印证 4.4 节的测试方法论:断言结论与不变量,不断言路径。
七、组装完成:全景与站位
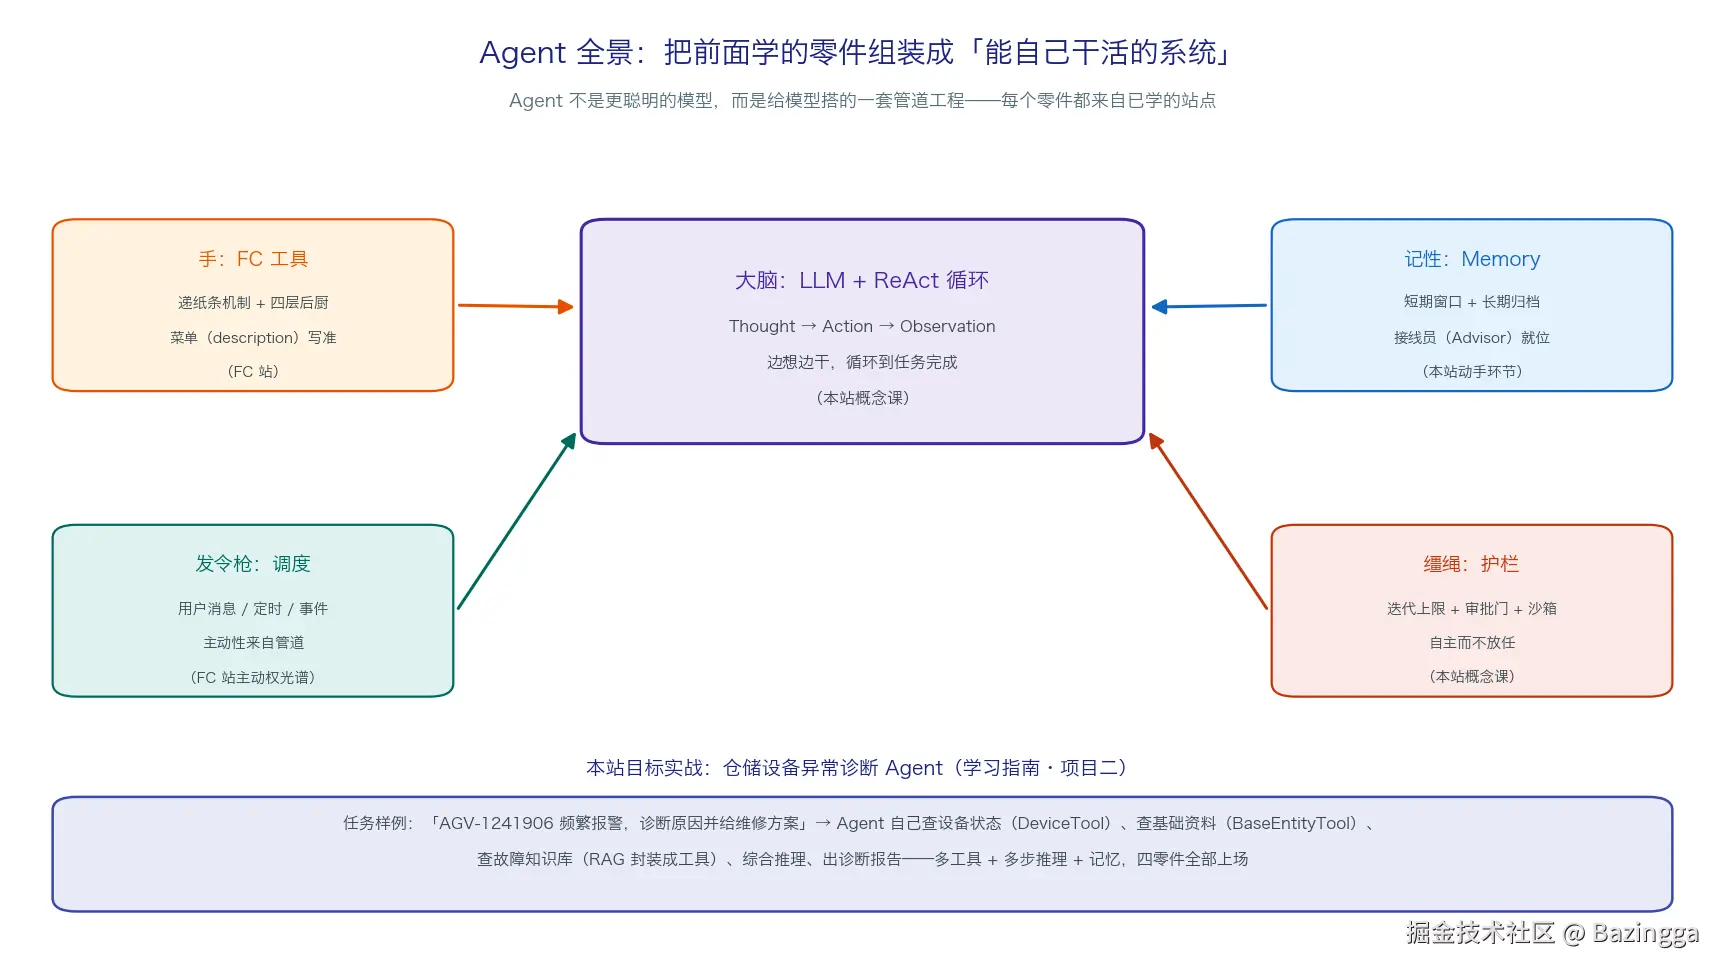
回头看本文走过的路,正好是把前面所有站点的零件装进一台完整机器的过程:大脑 是 LLM + ReAct 循环(本文第四章的显式实现),手 是 FC 工具------而且是三只(实时状态、基础档案、故障知识库,三种后厨形态),记性 是 MessageChatMemoryAdvisor 接好的短期记忆(第三章,服务对话链路),缰绳是护栏四件套里先落地的两件------迭代上限与过程透明(trace),外加只读工具集天然形成的 HITL 边界。
盘点这台机器:一个 167 行的 AgentLoopService(含 system prompt 与注释)、一个 72 行的 KnowledgeBaseTool、一个薄 Controller,入口 POST /api/agent/run;对话链路(/api/chat,框架私有循环)与任务链路(/api/agent/run,显式循环)职责分明、互不干扰------前者服务聊天,后者服务任务,这本身也是 2.1 节阶梯选型的实践:不是所有入口都需要 Agent。
给读者的站位判断收尾。第一,别急着上 Agent :先用 2.1 节的判据过一遍------任务路径写不死才值得,多数场景到增强型 LLM(工具 + 检索)就该收手。第二,上 Agent 先上护栏 :迭代上限和过程透明是成本最低的两件(一个常量 + 一个 trace 列表),但它们是把 Agent 从 demo 变成生产系统的分界线。第三,工具说明书是回报率最高的投入 :本文三次实测(自主推断过滤参数、改写检索关键词、从报错里读路标)都在证明同一个事实------模型在工具边界内的行为质量,取决于菜单把边界写得有多清楚。第四,测试 Agent 换一套断言思路:验结论与不变量,不验路径------这和传统单元测试的确定性直觉正好相反,却是与不可预测性共处的唯一姿势。
至此,"仓储设备异常诊断 Agent"从零件到整机、从概念到实测全部走完------一个能自己查状态、读档案、翻知识库、出诊断报告、还会说"这事我干不了"的系统。