你用 RFPeptide 或 GenKIC 生成了一堆环肽骨架,却卡在序列设计这步------通用 ProteinMPNN 的训练集几乎全是球蛋白,给短环肽配的序列折叠成功率不高;本文给你俄勒冈大学团队 2026 年推出的 CyclicMPNN:在环肽专用数据上微调 ProteinMPNN,架构零改动,8 残基环肽的中位骨架 RMSD 从 1.55 Å 降到 1.13 Å,motif inpainting 稳定序列数量约翻倍;本文附本地实测:纯 CPU 0.35 秒出 8 条序列,多样性优势当场复现(成对差异 42.9% vs 22.6%),外加参数名、jsonl 格式 3 个 README 没写的坑;你能直接 clone 仓库加载官方权重,串起"骨架生成 → 序列设计 → HighFold 验证"的闭环。
关键字:CyclicMPNN;环肽序列设计;逆折叠;ProteinMPNN;微调;motif inpainting;HighFold;序列多样性
骨架生成模型越来越快,序列设计却还压在环肽设计管线的瓶颈上------CyclicMPNN 的答案很朴素:不换架构,换训练分布。
论文 : Powers AC, Janthana Y, Hosseinzadeh P. CyclicMPNN: Stable cyclic peptide sequence generation. Digital Discovery (2026). doi:10.1039/d6dd00083e(preprint: bioRxiv 2026.01.31.702993, doi:10.64898/2026.01.31.702993)
GitHub : ParisaH-Lab/CyclicMPNN ⭐51(2026-09 实测)| MIT | 训练数据: Zenodo 20839855
相关教程与核心文献
| 资源 | 类型 | 与本文关系 |
|---|---|---|
| GitHub README | 官方文档 | 安装、权重、代码组织,本文第四节命令全部来自这里 |
Google Colab 笔记本(仓库 colab_notebooks/) |
官方教程 | 免本地环境快速上手 |
| Tamarind Bio 在线版 | Web 服务 | no-code 跑 CyclicMPNN,免装环境 |
| 文献 | 为什么值得先读 |
|---|---|
| Dauparas J, et al. Science 378, 49--56 (2022). doi:10.1126/science.add2187 | ProteinMPNN 原始论文------CyclicMPNN 的基座,本系列第 11 篇已介绍 |
| Hosseinzadeh P, et al. Nucleic Acids Res (2024). HighFold------环肽结构预测,本文所有折叠验证都用它,本系列第 15 篇已介绍 | 理解闭环验证的关键 |
| Rosetta Commons 报道(2026-02-25)链接 | 训练细节的第三方解读,200 epochs / 最低 perplexity checkpoint 等细节出处 |
一、解决什么问题
环肽序列设计的标准流程是三段式:骨架生成 → 序列设计 → 折叠验证。骨架生成这端,RFPeptide、CyclicCAE 这类扩散/生成模型已经把速度提上来了;验证这端有 HighFold(环肽版 AlphaFold2,见本系列第 15 篇)。中间的序列设计,多数人直接拿 ProteinMPNN 凑合------问题就出在这。
ProteinMPNN 的训练数据来自 PDB,而 PDB 里占绝对主导的是大球蛋白。环肽是另一个结构世界:
球蛋白:   几百残基、有二级结构、疏水核心
环肽:     6-14 残基、头尾共价成环、无核心可言
模型没见过足够多的"成环约束下的残基环境",给环肽骨架配出来的序列折叠成功率自然打折扣。更麻烦的是短序列的构象熵惩罚------一条 8 残基的线性肽要稳定折叠已经不容易,头尾锁死后对序列的"能量合理性"要求反而更高:序列和骨架只要有一点不匹配,整个环张力就顶在那里,没有球蛋白那种局部容忍度。
作者的判断很直接:这不是架构问题,是训练分布问题。所以 CyclicMPNN 不改 ProteinMPNN 的任何网络结构,只是把训练数据换成环肽富集的数据集重新微调------和 ThermoMPNN(耐热)、SolubleMPNN(可溶性)、LigandMPNN(配体感知)是同一个套路:基座不动,领域适配。
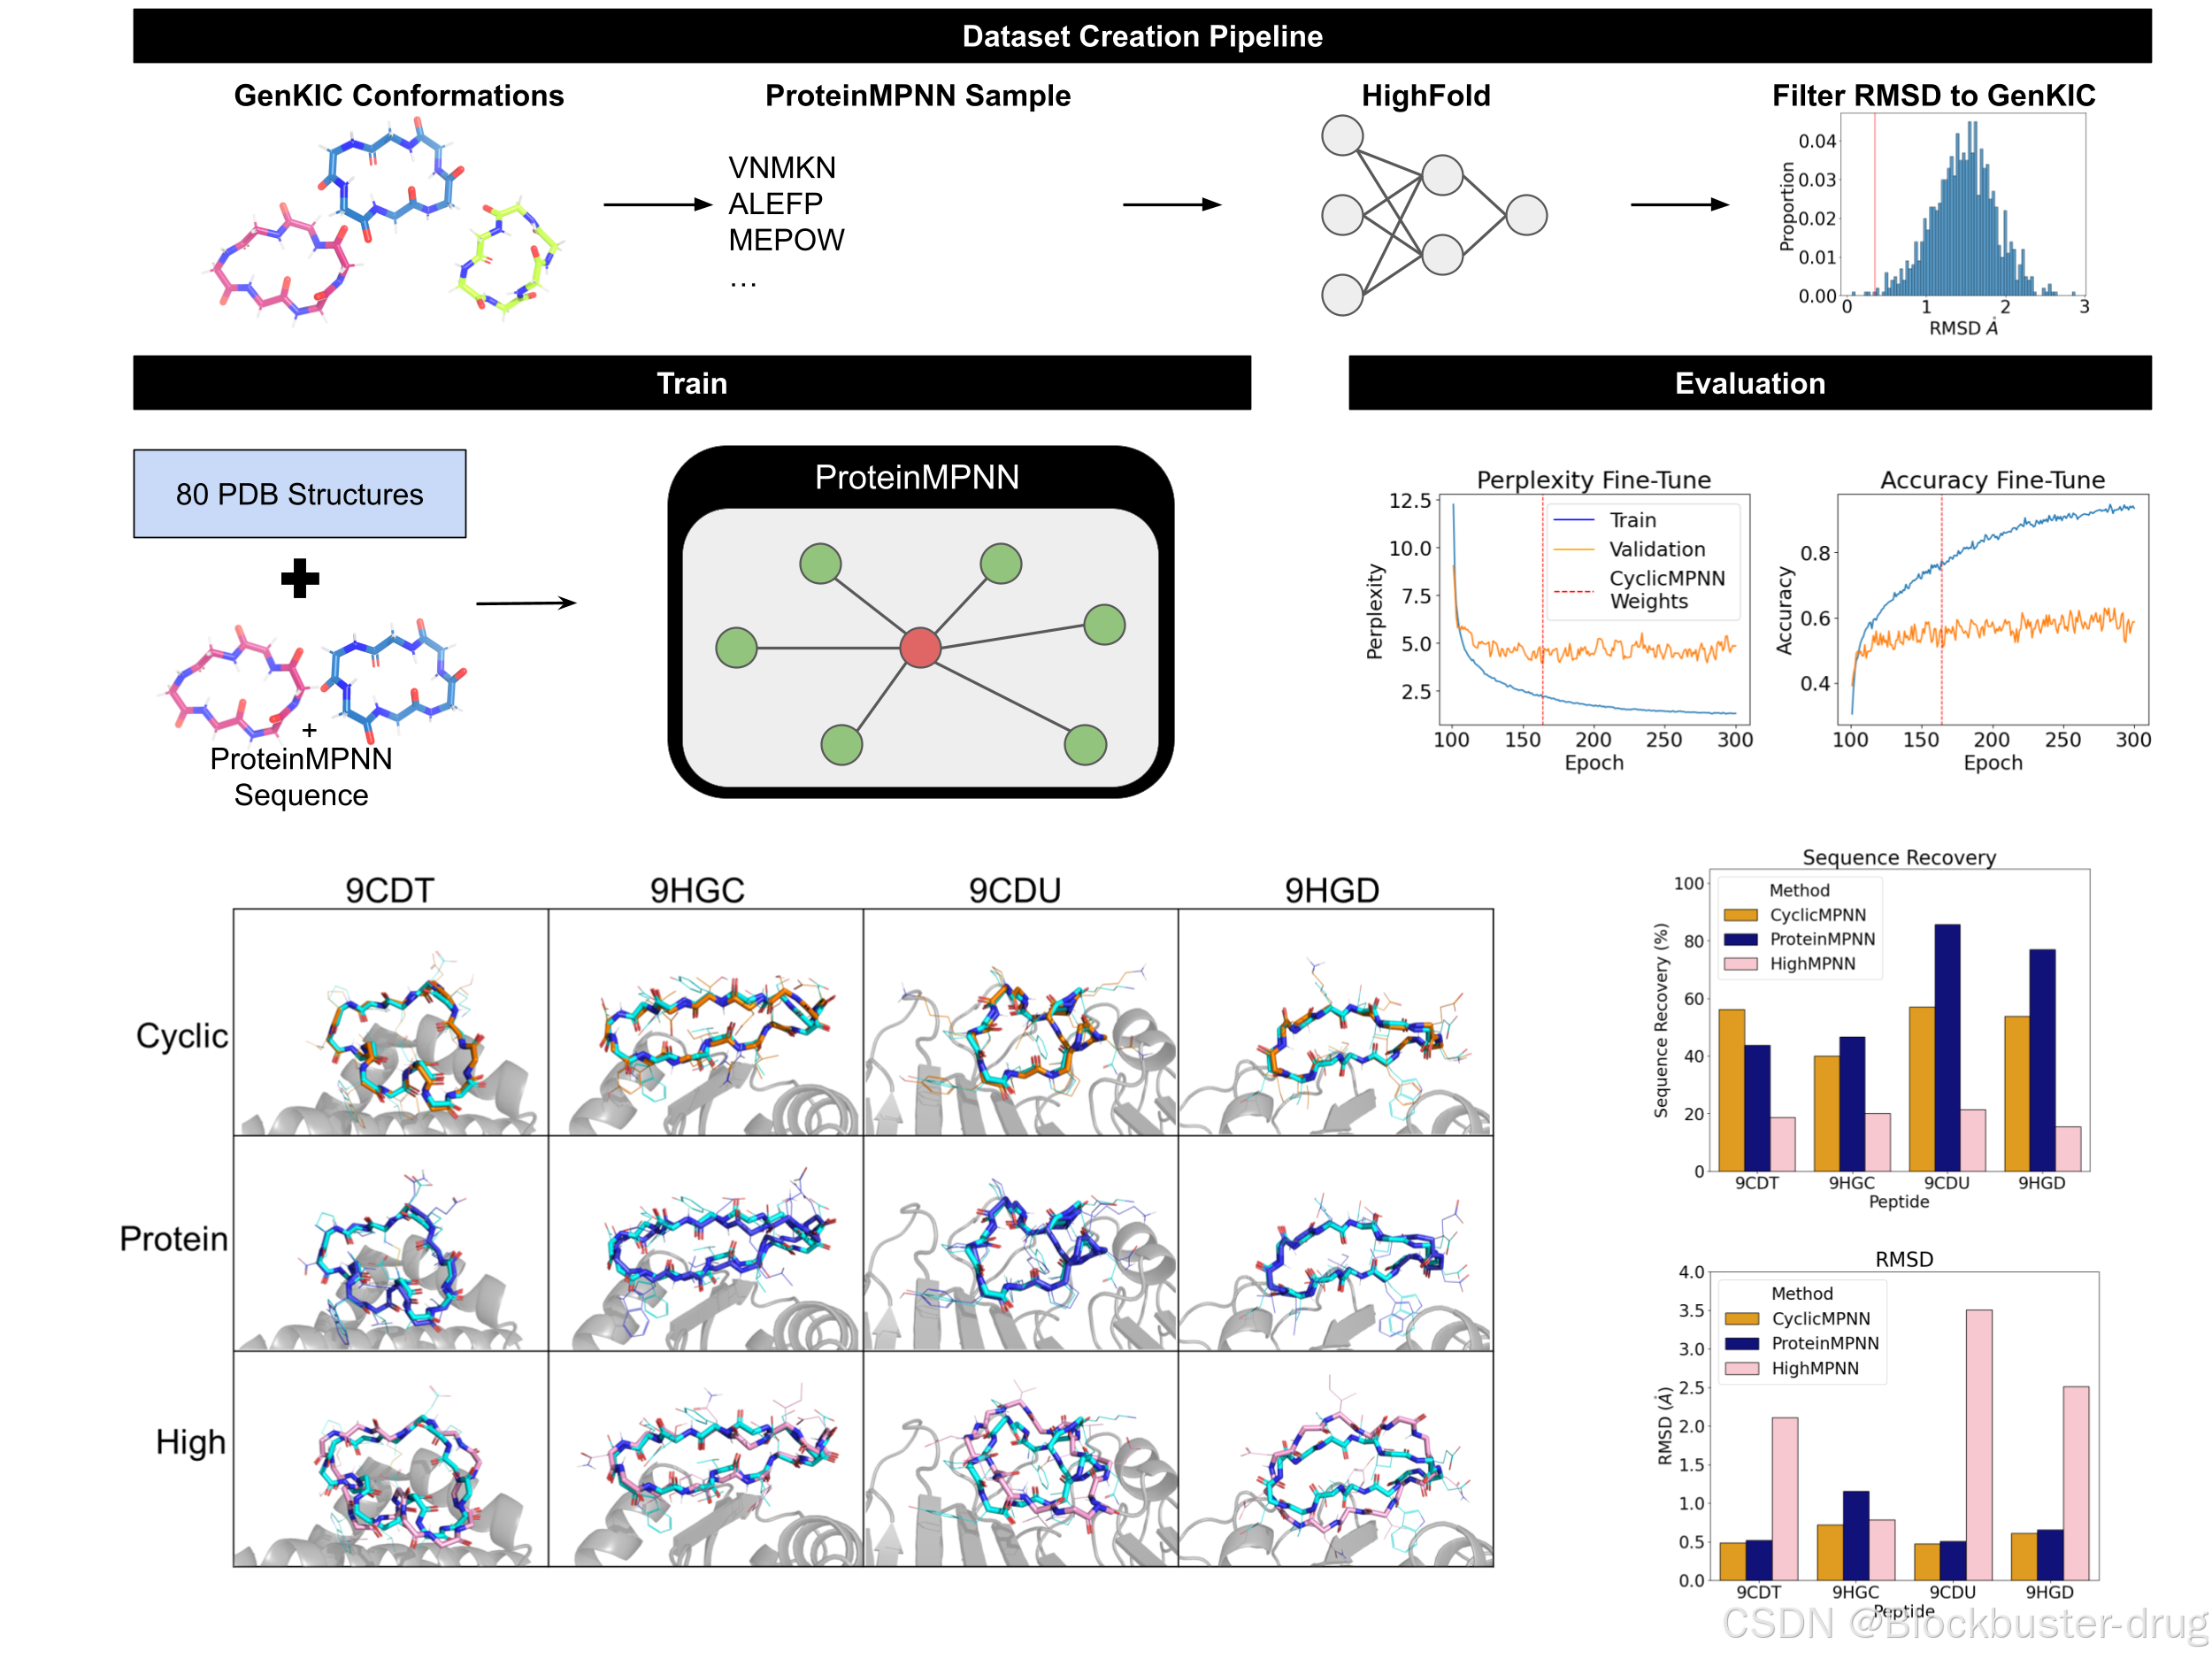
二、论文核心数据
2.1 晶体结构重设计:4 个 X-ray 环肽
论文选了 4 个实验解析的环肽晶体结构(PDB: 9CDT、9HGC、9CDU、9HGD)做重设计测试。这 4 个肽当初就是用 ProteinMPNN 迭代设计出来的,按理说 ProteinMPNN 有"主场优势"。结果:
| 指标 | CyclicMPNN | ProteinMPNN | HighMPNN |
|---|---|---|---|
| 序列恢复率 | 50%(56/40/57/54%),四个结构表现一致 | 波动较大 | 部分靶点落后 |
| 预测结构 vs 晶体骨架 RMSD | 全部 ≤ 1.0 Å(0.5/0.7/0.5/0.6 Å) | 多数持平或略差 | 若干靶点落后 |
这里有个值得注意的细节:序列恢复率高不稀奇,稀奇的是稳------四个结构上都在 50% 上下,而 ProteinMPNN 在不同靶点间波动明显。对设计管线来说,稳定性比峰值更重要。
2.2 De novo 骨架配序列:全长度碾压
在合成骨架系综上(GenKIC 生成 + RFPeptide 14 聚体,共 10,000 个预测结构做统计),CyclicMPNN 在测试的全部长度(6、8、10、14 残基)上 RMSD 和 pLDDT 都优于 ProteinMPNN。最典型的 8 残基环肽:
8-residue 环肽, 中位骨架 RMSD:
ProteinMPNN    1.55 Å
CyclicMPNN     1.13 Å   ← 降低 27%
2.3 Motif inpainting:稳定序列数量翻倍
Motif inpainting 是保留功能片段(比如 Nrf2 的 hot loop)、只设计周围支架的策略。这是药化最常用的玩法------活性 motif 固定,环肽只是递呈构象的载体。结果 CyclicMPNN 产出的含目标 motif 的稳定环肽数量约为 ProteinMPNN 的 2 倍 (稳定性用 Rosetta simple_cycpep_predict 的 P_Near 指标评估)。
2.4 序列多样性
嵌入空间投影显示,CyclicMPNN 在 6-mer 和 8-mer 上探索的序列空间更宽、重复序列更少。这对下游是实打实的好处------同一骨架拿到一组更多样的候选,挑成药性更好那条的概率更高。
三、方法原理:一条"数据生产线"撑起来的微调
整个方法学就是造数据。架构上 ProteinMPNN 一行没动,作者把功夫全花在环肽训练集的构建上,流程是一条闭环生产线:
poly-Ala 环肽构象系综 (PyRosetta GenKIC)
        ↓
ProteinMPNN 设计序列
        ↓
HighFold 折叠预测
        ↓
预测结构 vs 目标骨架 RMSD 筛选 (只留低 RMSD 的)
        ↓
聚类去冗余
        ↓
+ PDB 实验环肽结构
        ↓
微调 ProteinMPNN (200 epochs, 取最低 perplexity checkpoint)这套"生成-验证-过滤"的自我蒸馏思路值得记住:用结构预测器当裁判,只让"序列能折叠回目标骨架"的样本进训练集 。数据创建脚本(datacreation_scripts/insolution_genkic.py)在仓库里开源,意味着你可以照着这条生产线给自己的结构类型(比如 D-氨基酸骨架、非天然残基)造专属数据集------这是比模型本身更有长期价值的部分。
药物化学视角多说一句:环肽好做在哪?三个字------刚性、透膜、抗酶解。头尾成环+构象受限让熵惩罚提前付清,结合亲和力不用靠大分子量硬堆;分子量 500-1000 Da 的环肽依然可能口服(环孢素是老祖宗案例);暴露的末端氨基羧基没了,蛋白酶没了下口。这些性质让环肽成为少数能碰"蛋白-蛋白界面平坦口袋"的小分子格式。
四、怎么跑
4.1 本地部署(实测通过)
依赖确实只要三样(Python + PyTorch + Numpy),拿任一现成 torch 环境即可。权重分两处放:cyclicmpnn_weights/cyclicmpnn_48_010.pt(环肽版,20 MB)和 vanilla_model_weights/v_48_010.pt(原版对照,6.7 MB),全套脚本就 protein_mpnn_run.py + protein_mpnn_utils.py 两个文件。
实测踩坑(照抄可少走弯路):
- README 没写运行命令,直接套 ProteinMPNN 老参数名会报错------实际参数是
--pdb_path(不是--pdb_inputs)+--path_to_model_weights+--model_name; --model_name传cyclicmpnn_48_010(不带 .pt 后缀 ,代码自动补,带了会找xxx.pt.pt);--fixed_positions_jsonl的格式坑最多:key 必须是 PDB 文件名(去扩展名);每条链都必须声明 (B 链全设计要显式给空数组"B": [],缺了直接 KeyError);位置必须是整数数组(写"1-119"字符串报 UFunc 类型错)。
一条实测可跑的完整命令(蛋白链 A 固定、环肽链 B 设计):
# assigned.jsonl: {"9HGC_AB": ["A", "B"]}
# fixed.jsonl:   {"9HGC_AB": {"A": [1,...,119], "B": []}}
python protein_mpnn_run.py \
    --pdb_path inputs/9HGC_AB.pdb \
    --out_folder outputs_cyclic \
    --path_to_model_weights cyclicmpnn_weights/ \
    --model_name cyclicmpnn_48_010 \
    --chain_id_jsonl assigned.jsonl \
    --fixed_positions_jsonl fixed.jsonl \
    --sampling_temp 0.1 --num_seq_per_target 8
输出 FASTA 带 score 和 seq_recovery;纯 CPU 8 条序列 0.35 秒,笔记本无压力。
4.2 实测对比:同一环肽两个模型
拿论文 4 个测试结构之一的 9HGC(GABARAPL1 蛋白 + 15 残基环肽 GAB_D8 共晶),A 链固定、B 链设计,同温度 T=0.1 各采 8 条:
| 指标 | CyclicMPNN | vanilla ProteinMPNN |
|---|---|---|
| 序列恢复率(对 WT) | 0.358 ± 0.087 | 0.467 ± 0.036 |
| 唯一序列 | 8/8 | 6/8 |
| 序列间平均成对差异 | 42.9% | 22.6% |
| 平均 score(负对数概率) | 1.052 | 1.049 |
两个诚实的解读:
- 多样性优势当场复现------CyclicMPNN 8 条全不重样、彼此差异 42.9%,vanilla 一半序列近乎复读(22.6%)。这正是论文 §Sequence Space Exploration 的结论,而且对你下游是真金白银:同样采 8 条,候选池的实际宽度差了近一倍。
- 单点恢复率 vanilla 反而更高 ------这跟论文不矛盾但值得说透:9HGC 这类晶体结构当初就是 ProteinMPNN 迭代设计出来的,属于它的"主场";论文的核心指标也不是 recovery,而是设计序列经 HighFold 折叠后与目标骨架的 RMSD(这一步需要 HighFold 环境,本次未跑)。所以这个单点对比只说明"两个模型给出的序列风格不同",不代表设计成功率高下------要下那个结论,得把两个模型的序列都送进 HighFold 折叠再量 RMSD。
4.3 不想装环境?
Tamarind Bio 提供在线版,浏览器里传 PDB 就能出序列,适合先试效果再决定要不要本地化。
训练/测试数据在 Zenodo 20839855(2026-01-31, v1.0),复现训练走仓库 training/ 目录。
五、与同类工具对比
| 工具 | 定位 | 与 CyclicMPNN 关系 |
|---|---|---|
| ProteinMPNN | 通用逆折叠基座 | CyclicMPNN 的起点与主要对比对象 |
| HighMPNN | ProteinMPNN + 环肽增强模块 | 改架构路线;CyclicMPNN 在多数环肽指标上不输或更优,且序列恢复更稳 |
| RFPeptide / CyclicCAE | 环肽骨架生成 | 上游搭档------它们出骨架,CyclicMPNN 配序列 |
| HighFold | 环肽结构预测 | 下游验证器,也是本文训练数据的裁判 |
Rosetta simple_cycpep_predict |
物理方法折叠+稳定性评估 | P_Near 打分用;慢但对,适合终选 |
选型逻辑一句话:骨架用 RFPeptide 生成、序列用 CyclicMPNN 设计、HighFold 快筛、simple_cycpep_predict 终选------四件套各管一段,这也是当前环肽计算设计的主流管线形态。
六、局限与展望
- 只支持 20 种天然 L-氨基酸 ------这是对药化人最痛的限制。上市环肽(环孢素、万古霉素、达托霉素)几乎没有不含 D-氨基酸或非天然残基的,D-AA 正是抗酶解和调构象的关键手段。CyclicMPNN 目前覆盖不了这块,需要等作者的后续工作或自己照
datacreation_scripts/生产线造非天然残基数据集。 - 依赖骨架质量------逆折叠模型不生产骨架,骨架本身不合理,序列再好也白搭。
- 训练集含"自我蒸馏"成分------ProteinMPNN 参与造数据、再微调 ProteinMPNN,模型偏见可能被继承(论文用 HighFold 独立验证做了部分对冲)。
- 未做湿实验验证------目前全部证据是计算指标(RMSD/pLDDT/P_Near),实验验证是这篇工作最明显的下一步。
待追踪锚点:非天然残基扩展、湿实验数据、与 RFdiffusion 类环肽骨架生成器的端到端整合。
七、选型决策
| 场景 | 推荐 |
|---|---|
| 环肽骨架已定,配序列 | CyclicMPNN |
| 大蛋白/抗体设计 | ProteinMPNN 原版 |
| 含配体/金属的口袋设计 | LigandMPNN |
| 环肽从头全流程 | RFPeptide → CyclicMPNN → HighFold |
| 终选前物理复核 | simple_cycpep_predict (P_Near) |
参考来源
- Powers AC, Janthana Y, Hosseinzadeh P. CyclicMPNN: stable cyclic peptide sequence generation. Digital Discovery (2026). doi:10.1039/d6dd00083e | PMID 41659625
- Preprint: bioRxiv 2026.01.31.702993. doi:10.64898/2026.01.31.702993
- GitHub: GitHub - ParisaH-Lab/CyclicMPNN: A fine-tuned version of ProteinMPNN for generating stable cyclic peptide sequences · GitHub (MIT, 51★/2026-09 实测)
- 训练数据: https://zenodo.org/records/20839855
- Dauparas J, et al. Science 378, 49--56 (2022). doi:10.1126/science.add2187
- Rosetta Commons: CyclicMPNN adapts sequence design to cyclic backbones (2026-02-25)
- Tamarind Bio 在线版: CyclicMPNN Online | Robust sequence generation for stable cyclic peptides
我的专栏链接
| 蛋白 / 多肽 | 分子模拟 / 动力学 | 分子对接 / CADD / 工具 | agent / 核酸 / 药物 |
|---|---|---|---|
| 开源蛋白结构推理 | 分子模拟基础 | UCSF DOCK系列 | agent智能体系列 |
| 开源蛋白生成实践 | 分子动力学模拟-Amber | rDock系列教程 | 化学大模型介绍 |
| 蛋白设计原理案例 | 分子动力学模拟-Gromacs | LeDock系列教程 | 我胡师兄说药 |
| 多肽设计模型实践 | 开源結合自由能计算 | CADD中的机器学习模型 | siRNA药物设计模型 |
| 开源多肽性质预测 | 高效计算基本配置 | 小分子药物设计案例 | ASO药物设计模型 |
| 多肽设计原理案例 | 靶向DNA/RNA药物设计 | 开源小分子生成和设计实践 | 开源药代动力学软件教程 |