一、数据背景
经过7年的发展与沉淀,目前阿里音乐拥有数百万的曲库资源,每天千万的用户活跃在平台上,拥有数亿人次的用户试听、收藏等行为。在原创艺人和作品方面,更是拥有数万的独立音乐人,每月上传上万个原创作品,形成超过几十万首曲目的原创作品库,如此庞大的数据资源库对于音乐流行趋势的把握有着极为重要的指引作用。
本次大赛以阿里音乐用户的历史播放数据为基础,期望研究人员可以通过对阿里音乐平台上每个阶段艺人的试听量的预测,挖掘出即将成为潮流的艺人,从而实现对一个时间段内音乐流行趋势的准确把控。
二、模型介绍
矩阵分解算法
矩阵分解的核心思想是将用户和项目映射到同一个低维隐空间中,通过隐向量的内积来刻画用户对项目的潜在偏好。这种隐语义模型假设,用户对艺人的喜爱程度并非由某个显式特征直接决定,而是受到若干隐含因子的共同影响,例如音乐风格、演唱方式、情感表达等。
传统协同过滤算法(基准模型)
基于用户的协同过滤(UserCF)是最早被广泛应用的推荐算法之一,其基本假设是:具有相似试听历史的用户会对未来听到的艺人表现出相似的偏好。具体地,对于目标用户u,算法首先计算用户u与其他所有用户在用户-艺人交互矩阵上的相似度,常用的相似度度量有余弦相似度和皮尔逊相关系数。
评估函数
本次实验用了RMSE、MAE。
三、实验过程
1.前期导入库
import warnings
import time
import pandas as pd
import numpy as np
import matplotlib.pyplot as plt
from scipy.spatial.distance import cosine
from sklearn.preprocessing import MinMaxScaler
from sklearn.metrics import mean_squared_error, mean_absolute_error

warnings.filterwarnings("ignore")
plt.rcParams["font.family"] = ["SimHei"]
plt.rcParams["axes.unicode_minus"] = False

DATA_PATH = r" "   # 请修改为你的实际路径
CF_K = 30
PMF_D_LIST = [10, 20, 30]
TRAIN_MONTH = 6
TEST_MONTH = 1
NDCG_K1 = 10
NDCG_K2 = 20
RANDOM_SEED = 42
np.random.seed(RANDOM_SEED)
建议用镜像源安装。
2.数据清洗
# 读取无表头的Excel,手动赋予列名
df = pd.read_excel(DATA_PATH, header=None)
df.columns = ['user_id', 'song_id', 'gmt_create', 'action_type', 'Ds']
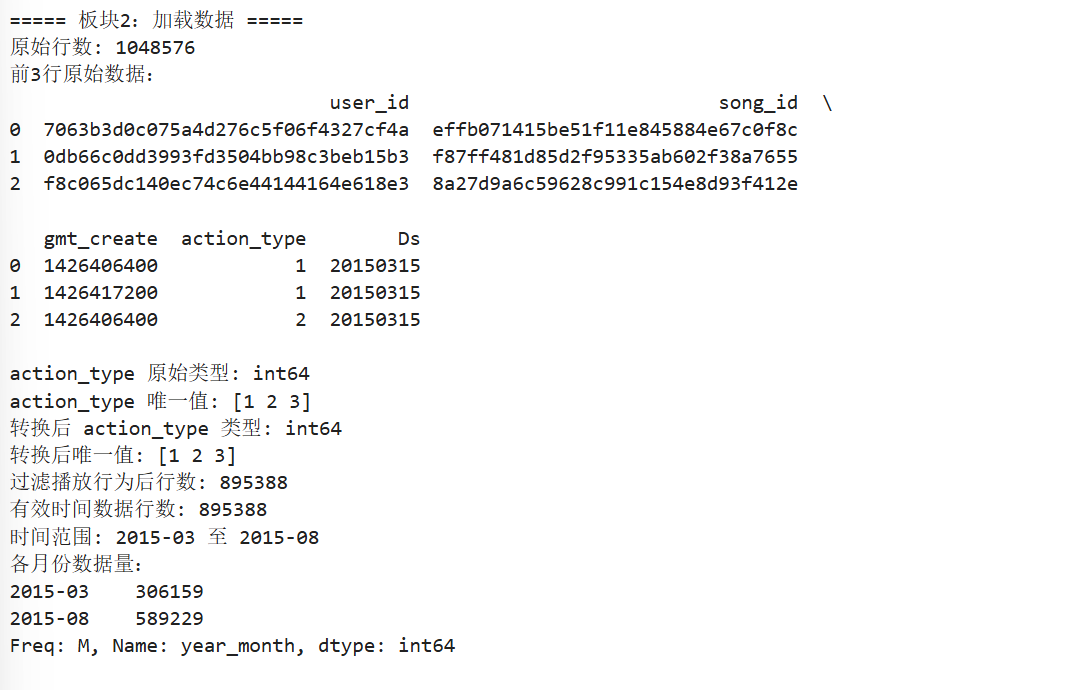
print(f"原始行数: {len(df)}")
print("前3行原始数据:")
print(df.head(3))

# 重命名 song_id -> artist_id
df.rename(columns={'song_id': 'artist_id'}, inplace=True)

print("\naction_type 原始类型:", df['action_type'].dtype)
print("action_type 唯一值:", df['action_type'].unique()[:10])
# 强制转换为整数(如果是字符串则转换)
df['action_type'] = pd.to_numeric(df['action_type'], errors='coerce')
print("转换后 action_type 类型:", df['action_type'].dtype)
print("转换后唯一值:", df['action_type'].unique()[:10])

# 只保留播放行为(action_type == 1)
df = df[df['action_type'] == 1].copy()
print(f"过滤播放行为后行数: {len(df)}")

if len(df) == 0:
    raise Exception("错误:没有播放行为数据,请检查 action_type 列的值")

# 添加播放次数
df['play_count'] = 1

# 时间转换
df['action_time'] = pd.to_datetime(df['gmt_create'], unit='s')
invalid_time = df['action_time'].isna().sum()
if invalid_time > 0:
    print(f"警告:有 {invalid_time} 行时间戳无效,将被丢弃")
    df = df.dropna(subset=['action_time'])

print(f"有效时间数据行数: {len(df)}")

# 提取年月
df['year_month'] = df['action_time'].dt.to_period('M')
print(f"时间范围: {df['year_month'].min()} 至 {df['year_month'].max()}")
print("各月份数据量:")
print(df['year_month'].value_counts().sort_index())这里要注意确保 action_type 是整数类型
3.过滤低频交互
user_counts = df.groupby('user_id')['play_count'].sum()
artist_counts = df.groupby('artist_id')['play_count'].sum()

min_user_plays = 5
min_artist_plays = 5

keep_users = user_counts[user_counts >= min_user_plays].index
keep_artists = artist_counts[artist_counts >= min_artist_plays].index

before = len(df)
df = df[df['user_id'].isin(keep_users) & df['artist_id'].isin(keep_artists)]
print(f"过滤后剩余行数: {len(df)} (原{before}行)")
print(f"剩余用户数: {df['user_id'].nunique()}")
print(f"剩余物品数: {df['artist_id'].nunique()}")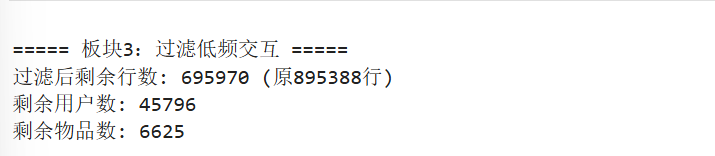
4.时间窗口划分
print("\n===== 板块4:时间窗口划分 =====")
df = df.sort_values('action_time').reset_index(drop=True)
all_months = sorted(df['year_month'].unique())
print("数据中的所有月份:", all_months)
print(f"总月份数: {len(all_months)}")

if len(all_months) < TRAIN_MONTH + TEST_MONTH:
    print(f"警告:总月份数 {len(all_months)} 不足 {TRAIN_MONTH+TEST_MONTH},将调整训练集月份数")
    if len(all_months) <= TEST_MONTH:
        raise Exception("错误:数据月份数不足,无法分出测试集,请检查时间转换或使用更多数据。")
    TRAIN_MONTH = len(all_months) - TEST_MONTH
    print(f"调整后训练月份数: {TRAIN_MONTH}")

train_months = all_months[:TRAIN_MONTH]
test_months = all_months[TRAIN_MONTH:TRAIN_MONTH+TEST_MONTH]

df_train = df[df['year_month'].isin(train_months)]
df_test = df[df['year_month'].isin(test_months)]

print(f"训练集月份: {train_months}, 样本数: {len(df_train)}")
print(f"测试集月份: {test_months}, 样本数: {len(df_test)}")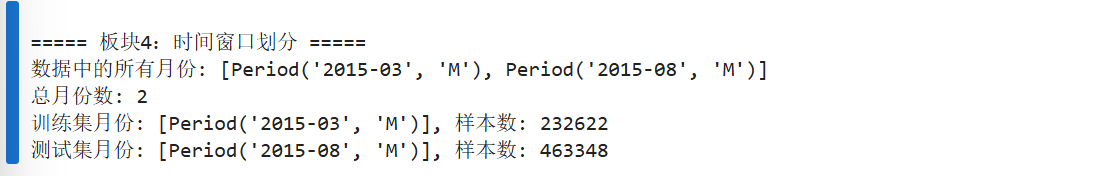
5.构建交互矩阵
def build_interaction_matrix(df, user2idx=None, artist2idx=None):
    if user2idx is None:
        users = df['user_id'].unique()
        artists = df['artist_id'].unique()
        user2idx = {u: i for i, u in enumerate(users)}
        artist2idx = {a: i for i, a in enumerate(artists)}
        R = np.zeros((len(users), len(artists)), dtype=np.float32)
    else:
        R = np.zeros((len(user2idx), len(artist2idx)), dtype=np.float32)
    grouped = df.groupby(['user_id', 'artist_id'])['play_count'].sum()
    for (u, a), val in grouped.items():
        if u in user2idx and a in artist2idx:
            R[user2idx[u], artist2idx[a]] = val
    return R, user2idx, artist2idx

print("\n===== 板块5:构建训练矩阵 =====")
R_train_raw, user2idx, artist2idx = build_interaction_matrix(df_train)
print(f"训练矩阵形状: {R_train_raw.shape}")
print(f"非零元素数: {np.count_nonzero(R_train_raw)}")

# 对数变换 + 归一化
R_log = np.log1p(R_train_raw)
scaler = MinMaxScaler()
R_train = scaler.fit_transform(R_log)
sparsity = (1 - np.count_nonzero(R_train) / R_train.size) * 100
print(f"训练矩阵稀疏度: {sparsity:.2f}%")
print(f"矩阵内存占用: {R_train.nbytes / 1024**2:.2f} MB")

print("\n构建测试矩阵(使用训练集的索引)")
R_test_raw, _, _ = build_interaction_matrix(df_test, user2idx, artist2idx)
R_test_log = np.log1p(R_test_raw)
R_test = scaler.transform(R_test_log)
print(f"测试矩阵形状: {R_test.shape}")
print(f"测试集非零元素数: {np.count_nonzero(R_test_raw)}")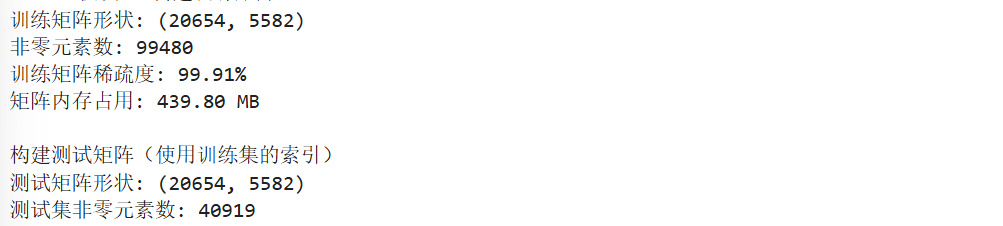
6.评估指标函数
def calc_rmse(y_true, y_pred):
    return np.sqrt(mean_squared_error(y_true, y_pred))

def calc_mae(y_true, y_pred):
    return mean_absolute_error(y_true, y_pred)

def calc_ndcg(rank_list, k):
    if len(rank_list) == 0:
        return 0.0
    rank_list = np.array(rank_list)[:k]
    dcg = np.sum(rank_list / np.log2(np.arange(2, len(rank_list)+2)))
    idcg = np.sum(np.sort(rank_list)[::-1] / np.log2(np.arange(2, len(rank_list)+2)))
    return dcg / idcg if idcg != 0 else 0.0

def evaluate_model(pred_mat, true_mat):
    mask = true_mat > 0
    if not np.any(mask):
        return {"RMSE": 0.0, "MAE": 0.0, "NDCG@10": 0.0, "NDCG@20": 0.0}
    y_true = true_mat[mask]
    y_pred = pred_mat[mask]
    rmse = calc_rmse(y_true, y_pred)
    mae = calc_mae(y_true, y_pred)

    ndcg10_list = []
    ndcg20_list = []
    n_items = true_mat.shape[1]
    for a in range(n_items):
        pred_rank = pred_mat[:, a]
        ndcg10_list.append(calc_ndcg(pred_rank, NDCG_K1))
        ndcg20_list.append(calc_ndcg(pred_rank, NDCG_K2))
    return {
        "RMSE": rmse,
        "MAE": mae,
        "NDCG@10": np.mean(ndcg10_list),
        "NDCG@20": np.mean(ndcg20_list)
    }
7:协同过滤模型
class UserCF:
    def __init__(self, R, k):
        self.R = R
        self.k = k
        self.n_user = R.shape[0]
        self.sim = self._calc_user_similarity()
    def _calc_user_similarity(self):
        sim = np.zeros((self.n_user, self.n_user))
        for i in range(self.n_user):
            for j in range(i+1, self.n_user):
                s = 1 - cosine(self.R[i], self.R[j])
                sim[i, j] = sim[j, i] = s
        return sim
    def predict(self):
        pred = np.zeros_like(self.R)
        for u in range(self.n_user):
            neighbors = np.argsort(self.sim[u])[::-1][1:self.k+1]
            if len(neighbors) > 0:
                pred[u] = np.mean(self.R[neighbors], axis=0)
        return pred

class ItemCF:
    def __init__(self, R, k):
        self.R = R
        self.k = k
        self.n_item = R.shape[1]
        self.sim = self._calc_item_similarity()
    def _calc_item_similarity(self):
        sim = np.zeros((self.n_item, self.n_item))
        for i in range(self.n_item):
            for j in range(i+1, self.n_item):
                s = 1 - cosine(self.R[:, i], self.R[:, j])
                sim[i, j] = sim[j, i] = s
        return sim
    def predict(self):
        pred = np.zeros_like(self.R)
        for a in range(self.n_item):
            neighbors = np.argsort(self.sim[a])[::-1][1:self.k+1]
            if len(neighbors) > 0:
                pred[:, a] = np.mean(self.R[:, neighbors], axis=1)
        return pred
8:概率矩阵分解 PMF
class PMF:
    def __init__(self, R, latent_dim, lr=0.01, reg=0.01, epochs=30):
        self.R = R
        self.n_user, self.n_item = R.shape
        self.d = latent_dim
        self.lr = lr
        self.reg = reg
        self.epochs = epochs
        self.U = np.random.normal(0, 0.1, (self.n_user, self.d))
        self.V = np.random.normal(0, 0.1, (self.n_item, self.d))
    def train(self, verbose=True):
        for epoch in range(self.epochs):
            pred = self.U @ self.V.T
            grad_U = -2 * (self.R - pred) @ self.V + 2 * self.reg * self.U
            grad_V = -2 * (self.R - pred).T @ self.U + 2 * self.reg * self.V
            self.U -= self.lr * grad_U
            self.V -= self.lr * grad_V
            if verbose and (epoch+1) % 10 == 0:
                loss = np.sum((self.R - pred)**2) + self.reg*(np.sum(self.U**2)+np.sum(self.V**2))
                print(f"  PMF d={self.d}, epoch {epoch+1}/{self.epochs}, loss={loss:.2f}")
    def predict(self):
        return self.U @ self.V.T
9:训练 UserCF、ItemCF 和 PMF 网格搜索
t0 = time.time()
usercf = UserCF(R_train, CF_K)
pred_usercf = usercf.predict()
time_usercf = time.time() - t0
res_usercf = evaluate_model(pred_usercf, R_test)
print(f"UserCF 耗时 {time_usercf:.2f}s, RMSE={res_usercf['RMSE']:.4f}")

print("\n===== 训练 ItemCF =====")
t0 = time.time()
itemcf = ItemCF(R_train, CF_K)
pred_itemcf = itemcf.predict()
time_itemcf = time.time() - t0
res_itemcf = evaluate_model(pred_itemcf, R_test)
print(f"ItemCF 耗时 {time_itemcf:.2f}s, RMSE={res_itemcf['RMSE']:.4f}")

print("\n===== 训练 PMF 并搜索最佳维度 =====")
best_res = None
best_pred = None
best_d = None
pmf_results = {}
for d in PMF_D_LIST:
    t0 = time.time()
    pmf = PMF(R_train, d, epochs=30)
    pmf.train()
    pred = pmf.predict()
    cost = time.time() - t0
    res = evaluate_model(pred, R_test)
    pmf_results[d] = (res, cost, pred)
    print(f"d={d} 完成, RMSE={res['RMSE']:.4f}, 耗时{cost:.2f}s")
    if best_res is None or res['RMSE'] < best_res['RMSE']:
        best_res = res
        best_pred = pred
        best_d = d
10:结果
result_df = pd.DataFrame({
    "模型": ["UserCF", "ItemCF", f"PMF(d={best_d})"],
    "RMSE": [res_usercf["RMSE"], res_itemcf["RMSE"], best_res["RMSE"]],
    "MAE": [res_usercf["MAE"], res_itemcf["MAE"], best_res["MAE"]],
    "NDCG@10": [res_usercf["NDCG@10"], res_itemcf["NDCG@10"], best_res["NDCG@10"]],
    "NDCG@20": [res_usercf["NDCG@20"], res_itemcf["NDCG@20"], best_res["NDCG@20"]],
    "耗时(s)": [time_usercf, time_itemcf, pmf_results[best_d][1]]
})
print(result_df.round(4))
11:可视化
# PMF 参数影响图
d_vals = list(pmf_results.keys())
rmse_vals = [pmf_results[d][0]['RMSE'] for d in d_vals]
ndcg_vals = [pmf_results[d][0]['NDCG@10'] for d in d_vals]

fig, axes = plt.subplots(1, 2, figsize=(12, 4))
axes[0].plot(d_vals, rmse_vals, 'o-', color='red')
axes[0].set_xlabel('Latent Dimension d')
axes[0].set_ylabel('RMSE')
axes[0].set_title('PMF RMSE vs d')
axes[0].grid(True)

axes[1].plot(d_vals, ndcg_vals, 's-', color='blue')
axes[1].set_xlabel('Latent Dimension d')
axes[1].set_ylabel('NDCG@10')
axes[1].set_title('PMF NDCG@10 vs d')
axes[1].grid(True)
plt.tight_layout()
plt.show()

# 模型对比柱状图
models = ['UserCF', 'ItemCF', f'PMF(d={best_d})']
rmse_all = [res_usercf['RMSE'], res_itemcf['RMSE'], best_res['RMSE']]
ndcg_all = [res_usercf['NDCG@10'], res_itemcf['NDCG@10'], best_res['NDCG@10']]

fig, axes = plt.subplots(1, 2, figsize=(12, 4))
axes[0].bar(models, rmse_all, color=['#1f77b4', '#ff7f0e', '#2ca02c'])
axes[0].set_ylabel('RMSE (lower better)')
axes[0].set_title('模型 RMSE 对比')

axes[1].bar(models, ndcg_all, color=['#1f77b4', '#ff7f0e', '#2ca02c'])
axes[1].set_ylabel('NDCG@10 (higher better)')
axes[1].set_title('模型 NDCG@10 对比')
plt.tight_layout()
plt.show()