Redis Big Key 系列 · 第 2 篇。上一篇我们埋了四颗"内存炸弹"、用
--bigkeys抓到了每种类型最大的 key,但 50 万 field 的user:profile:10087在报告里完全隐身(没看过的建议先读:《Big Key 排查入门:Docker 搭环境亲手埋四颗"内存炸弹",10 分钟抓到第一个 Big Key》)。冠军只有一个,漏网之鱼才是线上常态------这篇上三板斧,把所有 Big Key 一个不漏地扫出来,排成一份《清除优先级清单》。 本文同步发布于我的个人博客 :在个人站阅读体验更佳,欢迎收藏关注。
前言:从「抓到冠军」到「一个不漏」
上篇结尾,--bigkeys 交出了冠军榜,但我们都看到了它的天花板:每种类型只报一个冠军 。实验库里还藏着一颗 50 万 field 的 user:profile:10087,报告里连个影子都没有。
线上的情况只会更糟:
- 同类型的 key 成百上千------"用户画像"这种 key 人人都大,冠军只有一个,亚军季军全是定时炸弹;
- 扫出来的 key 有大有小,先清哪个?总不能抓到谁算谁;
- 线上主线程金贵,扫一遍全库再温柔也是 CPU 开销------能不能不碰线上,离线扫?
好在这是个已经被解决得很成熟的问题。本篇三步法:

读完这篇,拿到任何一个 Redis 实例,你都能在 10 分钟内给出一份有依据的「清除优先级清单」。环境沿用上篇(Docker + Redis 8.2,容器 redis8,4+1 颗炸弹 + 10 万 session 小 key),所有命令可直接复制复现。
工具选型:四件套对比
四个工具都学,分工不同:
| 维度 | --bigkeys |
--memkeys |
SCAN 脚本 | RDB 离线分析 |
|---|---|---|---|---|
| 来源 | redis-cli 自带 | redis-cli 自带(6.0+) | 自己写,几十行 | redis-rdb-tools,需安装 |
| 统计口径 | String 按字节,集合按元素个数 | 一律按内存字节 | 自定义(两者都要) | 内存字节 + 元素个数 |
| 报告范围 | 每类一个冠军 | 每类一个冠军 | 全量,超阈值全报 | 全量,随便排序过滤 |
| 线上影响 | 不阻塞,但吃 CPU | 同左 | 同左,可控速 | 零(拷到分析机扫) |
| 适合场景 | 30 秒快扫建直觉 | 按内存找冠军 | 出正式清单 | 线上零打扰 / 超大实例 |
我的习惯:先用 --bigkeys / --memkeys 建立直觉,再用 SCAN 脚本出正式清单,线上敏感就走 RDB 离线分析。下面按这个顺序来。
第 0 步:再埋五颗"中号炸弹"
上篇的库里只有一颗漏网的 10087,太单薄,练不了"清单"的手。真实生产是"用户画像这类 key 普遍偏大"------再埋五颗 10 万 field 的中号 Hash,模拟这个场面:
bash
for id in 10088 10089 10090 10091 10092; do python -c "for i in range(100000): print(f'HSET user:profile:$id field:{i} value:{i}')" | docker exec -i redis8 redis-cli --pipe; done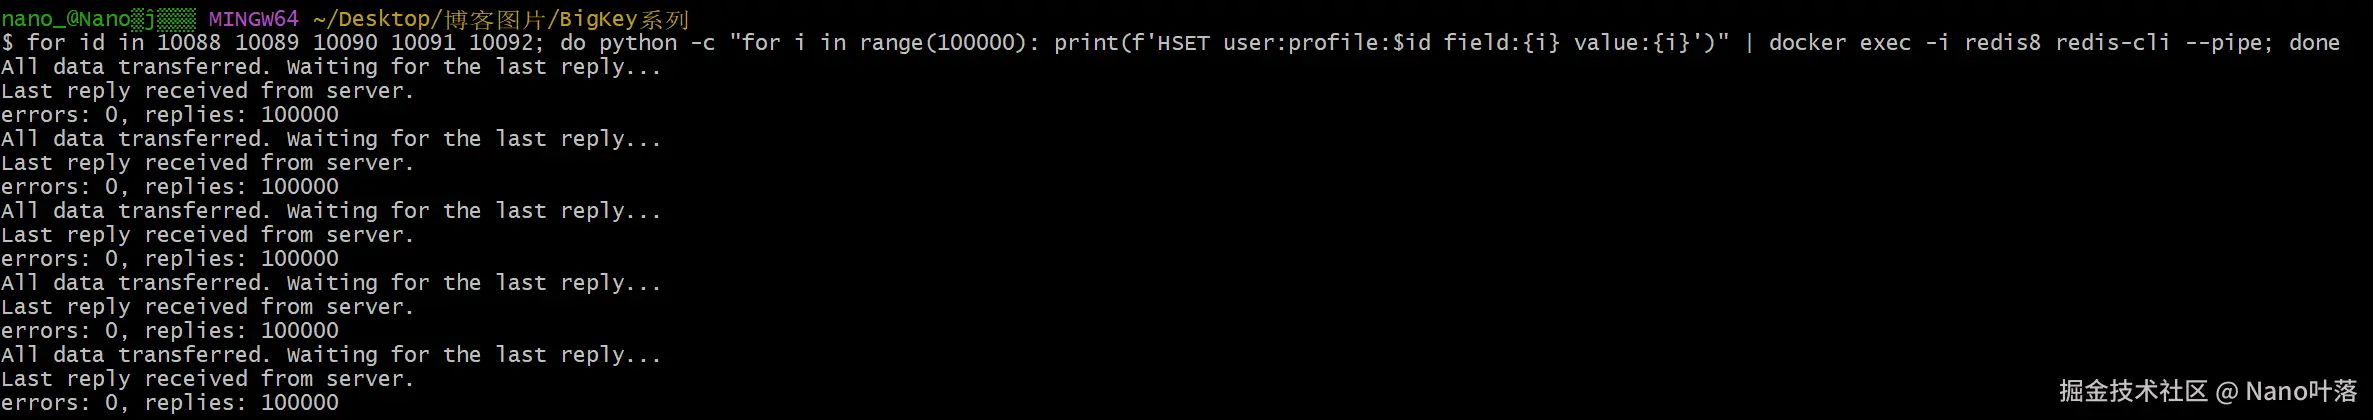
验证一下家底:
bash
docker exec -i redis8 redis-cli DBSIZE
# (integer) 100010
现在库里的局面:2 颗百万级(user:profile:10086、rank:global)、1 颗 50 万级(user:profile:10087)、1 颗 50 万元素的 List(queue:msg)、5 颗 10 万级中号炸弹、1 颗 2MB 的大 String,外加 10 万噪音 key。大海捞针的"海",成型了。
第一步:粗扫 ------ --bigkeys 与 --memkeys 双口径
--memkeys 初体验
--bigkeys 上篇已经玩过,它的孪生兄弟 --memkeys 换个口径------按内存字节找冠军:
bash
docker exec -i redis8 redis-cli --memkeys输出(数字因环境而异,重点看结构):
plain
# Scanning the entire keyspace to find biggest keys as well as
# average sizes per key type.  You can use -i 0.1 to sleep 0.1 sec
# per 100 SCAN commands (not usually needed).

[00.00%] Biggest string found so far "session:51992" with 48 bytes
[06.49%] Biggest hash   found so far "user:profile:10086" with 64388704 bytes
[24.11%] Biggest zset   found so far "rank:global" with 91589384 bytes
[82.65%] Biggest string found so far "product:detail:1001" with 2621480 bytes
[82.89%] Biggest list   found so far "queue:msg" with 6860072 bytes

-------- summary -------

Sampled 100010 keys in the keyspace!
Total key length in bytes is 1289055 (avg len 12.89)

Biggest   list found "queue:msg" has 6860072 bytes
Biggest   hash found "user:profile:10086" has 64388704 bytes
Biggest string found "product:detail:1001" has 2621480 bytes
Biggest   zset found "rank:global" has 91589384 bytes

1 lists with 6860072 bytes (00.00% of keys, avg size 6860072.00)
7 hashs with 130088608 bytes (00.01% of keys, avg size 18584086.86)
0 streams with 0 bytes (00.00% of keys, avg size 0.00)
100001 strings with 7421400 bytes (99.99% of keys, avg size 74.21)
0 sets with 0 bytes (00.00% of keys, avg size 0.00)
1 zsets with 91589384 bytes (00.00% of keys, avg size 91589384.00)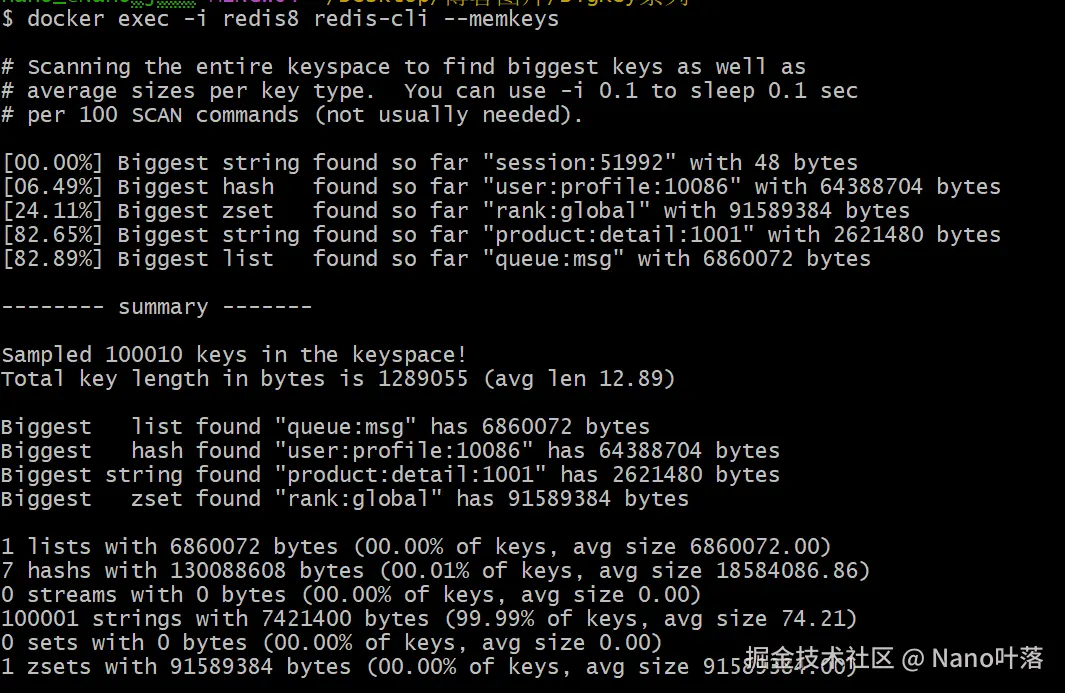
先注意开头一行:扫描刚起步时,String 冠军还是个 48 字节的 session:51992------冠军是边扫边刷新的,直到 82% 进度才被真命天子取代。这就是上篇说的 found so far 语义。
再注意一个细节:product:detail:1001 的 STRLEN 明明是 1080056 字节(约 1MB),这里怎么称出 2621480 字节(2.5MB) ?多出来的 1.5MB 是 jemalloc 内存分配器的档位取整 ------分配内存按规格档位向上取整,1MB 的 value 实际占了 2.5MB 的档。--memkeys(以及 MEMORY USAGE)称的是"分配出去的内存",不是数据本身的大小。这也是为什么清单要看量级、别抠字节。
对照实验:口径不同,冠军易位
把两个工具的报告摆在一起,一个有意思的现象出现了:
| 类型 | --bigkeys 的冠军 |
--memkeys 的冠军 |
|---|---|---|
| String | product:detail:1001(1080056 bytes) | product:detail:1001(约 2.5 MB) |
| Hash | user:profile:10086(1000000 fields) | user:profile:10086(约 61.4 MB) |
| ZSet | rank:global(1000000 members) | rank:global(约 87.3 MB) |
看出门道了吗:--bigkeys 对集合报的是元素个数,--memkeys 报的是内存字节 。本例里两个冠军恰好是同一批 key,但只要换一批数据------比如一个 100 万 field 但每个 field 只有几个字节的 Hash,和一个 10 万 field 但每个 field 几 KB 的 Hash------两个工具的答案就会分道扬镳。一个数"个数",一个称"体重",别拿 A 的报告回答 B 的问题([坑 1](#坑 1 "#%E5%9D%91-1%EF%BC%9A-bigkeys-%E5%92%8C-memkeys-%E5%8F%A3%E5%BE%84%E4%B8%8D%E5%90%8C%EF%BC%8C%E5%88%AB%E6%B7%B7%E7%94%A8%E7%BB%93%E8%AE%BA") 还会回来算这笔账)。 另外别忘了 -i 参数:redis-cli --bigkeys -i 0.1 表示每 100 次 SCAN 睡 0.1 秒,线上怕影响就加上,代价是扫得慢一些。
结论不变:兄弟俩都只报冠军,建直觉够用,出清单不行。上脚本。
第二步:全扫 ------ SCAN + MEMORY USAGE 脚本出清单
几十行脚本,一个不漏
思路就是上篇说的 --bigkeys 底层原理,但我们不要冠军,要全部 :SCAN 分批拉 key → TYPE 判类型 → String 量字节(STRLEN)、集合数元素(HLEN / LLEN / SCARD / ZCARD)、顺手 MEMORY USAGE 称体重 → 按阈值过滤。
先装依赖:
bash
pip install redis把下面保存为 scan_bigkeys.py:
python
import redis

r = redis.Redis(host='localhost', port=6379, decode_responses=True)

BIG_STRING = 10 * 1024     # String 阈值:10KB
BIG_COLLECTION = 5000      # 集合阈值:5000 个元素
COUNT = 500                # 每批 SCAN 拉 500 个 key

len_of = {'string': 'strlen', 'hash': 'hlen', 'list': 'llen',
          'set': 'scard', 'zset': 'zcard'}

big_keys = []
cursor = 0
while True:
    cursor, keys = r.scan(cursor=cursor, count=COUNT)

    # 第一批 pipeline:问每个 key 的类型
    pipe = r.pipeline()
    for k in keys:
        pipe.type(k)
    types = pipe.execute()

    # 第二批 pipeline:量尺寸 + 称体重
    pipe = r.pipeline()
    targets = []
    for k, t in zip(keys, types):
        if t in len_of:
            targets.append((k, t))
            getattr(pipe, len_of[t])(k)
            pipe.memory_usage(k)
    res = pipe.execute()

    for i, (k, t) in enumerate(targets):
        n, mem = res[2 * i], res[2 * i + 1]
        if (t == 'string' and n > BIG_STRING) or \
           (t != 'string' and n > BIG_COLLECTION):
            big_keys.append((k, t, n, mem))

    if cursor == 0:        # 游标归 0 才算扫完(上篇坑 3 的约定)
        break

big_keys.sort(key=lambda x: x[3], reverse=True)
print(f'{"TYPE":8s} {"ELEMS/BYTES":>15s} {"MEMORY":>10s}  KEY')
for k, t, n, mem in big_keys:
    print(f'{t:8s} {n:>15,d} {mem/1024/1024:>8.2f}MB  {k}')
一个细节呼应上篇:这里又用了 pipeline。10 万个 key 逐个问类型、量尺寸,裸发就是 30 万次网络往返;按批打包后只剩几百个来回------上篇灌数省 RTT,这篇扫描还是省 RTT。
跑起来:
bash
python scan_bigkeys.py
plain
TYPE     ELEMS/BYTES     MEMORY  KEY
TYPE         ELEMS/BYTES     MEMORY  KEY
zset           1,000,000    87.35MB  rank:global
hash           1,000,000    61.41MB  user:profile:10086
hash             500,000    30.70MB  user:profile:10087
hash             100,000     6.84MB  user:profile:10091
hash             100,000     6.84MB  user:profile:10092
hash             100,000     6.84MB  user:profile:10090
list             500,000     6.54MB  queue:msg
hash             100,000     5.84MB  user:profile:10089
hash             100,000     5.59MB  user:profile:10088
string         2,160,076     2.50MB  product:detail:1001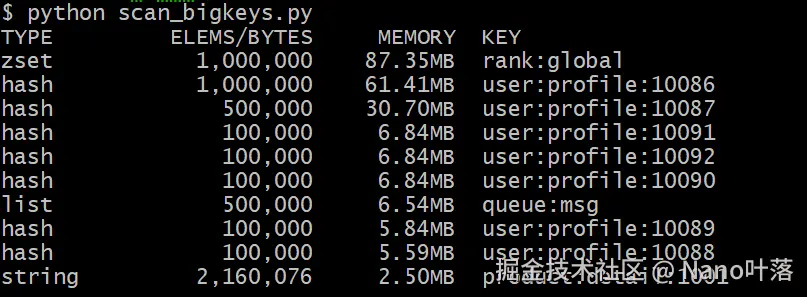
战果:10087 落网
数一下:10 颗炸弹,一个不漏------包括上篇隐身的 user:profile:10087,悬案告破。全库扫一遍,实验环境几秒搞定;10 万噪音 key 全部被阈值过滤掉,一个没冤枉。
再注意一个细节:五颗同规格的中号炸弹(各 10 万 field),体重却从 5.59MB 到 6.84MB 不等------Hash 底层数组按 2 的幂扩容,同样的元素个数落在不同档位,体重自然有差。"别抠字节"再添一证。
线上使用三条纪律:
- 低峰执行:SCAN 不阻塞主线程,但 CPU 开销实打实;
- 限速 :在 while 循环里加一句
time.sleep(0.01),或者把 COUNT 调小,让主线程随时能插进来干活; - 别抠数字 :
MEMORY USAGE是估算(集合类型按内部编码推算),清单看量级就够。
第三步:离线扫 ------ RDB 分析,线上零影响
SCAN 脚本再温柔,也是在生产库上跑。有没有完全不碰线上的办法?有------RDB 是快照文件,拷出来随便折腾。
拿快照
bash
# 触发一次后台落盘
docker exec -i redis8 redis-cli BGSAVE

# 确认落盘完成(看到 ok 即可)
docker exec -i redis8 redis-cli LASTSAVE

# 把快照拷到宿主机当前目录
docker cp redis8:/data/dump.rdb ./dump.rdb
工具选型翻车记:rdbtools 已死,RDR 当立
离线分析的第一反应自然是祖师爷 redis-rdb-tools------离线内存分析这个品类就是它开创的。但实测在 Redis 8.2 + Windows 上,它给了我四连翻:
| 尝试 | 死法 | 根因 |
|---|---|---|
| pip 直连装包 | Read timed out 五连,No matching distribution found |
pypi.org 直连超时,换国内镜像可解 |
| 容器里跑 | FileNotFoundError: 'dump.rdb' |
dump.rdb 不在挂载目录 |
| Python 3.12 跑 | No module named 'distutils' |
3.12 删了 distutils,rdbtools 还在 import 它 |
| Python 3.13 跑 | Invalid RDB version number 12 |
rdbtools 只认 RDB v1~v9(Redis 5/6 时代) |
| 顺手装 python-lzf 加速 | 要 gcc / MSVC 编译环境 | C 扩展,没编译器免谈 |
前三个坑都能 workaround,最后一个是绝症:我们的 dump.rdb 是 Redis 8.2 写的 RDB v12,而 rdbtools 多年没更新,格式支持停在 Redis 6 时代。不是姿势不对,是时代变了。
换还在维护的 Go 工具 RDR(redis data Reveal) :单文件 exe 免安装、支持 Redis 7 / 8 的 RDB 格式、解析飞快(官方口径 10GB 约 30 秒),还自带网页版报告。GitHub 搜 919927181/rdr,releases 里下载 rdr-win64.exe(GitHub 慢就套一层 ghproxy 镜像)。
RDR 出清单
把 rdr-win64.exe 和 dump.rdb 放同一目录,一条命令导出全部 key 的元信息:
bash
.\rdr-win64.exe keys dump.rdb
# 生成 rdb-all-keys-xxx.txt,每行一个 key:
# key,类型,编码,字节数,人类可读大小,元素个数,过期时间,过期秒数,lru空闲,lfu频率,db
按内存排序取 Top 10(size 是第 4 列):
bash
head -1 rdb-all-keys-*.txt && tail -n +2 rdb-all-keys-*.txt | sort -t, -k4,4 -nr | head -10
plain
key,type,encoding,size,humanizeSize,numOfElem,expiration,expire_seconds,lruIdle,lfuFreq,db
rank:global, sortedset, skiplist, 105928324, 106 MB, 1000000, , -1, 0, 0, 0
user:profile:10086, hash, hashtable, 68583068, 69 MB, 1000000, , -1, 0, 0, 0
user:profile:10087, hash, hashtable, 34291612, 34 MB, 500000, , -1, 0, 0, 0
queue:msg, list, quicklist2, 7934341, 7.9 MB, 500000, , -1, 0, 0, 0
user:profile:10092, hash, hashtable, 7173020, 7.2 MB, 100000, , -1, 0, 0, 0
user:profile:10091, hash, hashtable, 7173020, 7.2 MB, 100000, , -1, 0, 0, 0
user:profile:10090, hash, hashtable, 7173020, 7.2 MB, 100000, , -1, 0, 0, 0
user:profile:10089, hash, hashtable, 7173020, 7.2 MB, 100000, , -1, 0, 0, 0
user:profile:10088, hash, hashtable, 7173020, 7.2 MB, 100000, , -1, 0, 0, 0
product:detail:1001, string, string, 2621504, 2.6 MB, 2160076, , -1, 0, 0, 0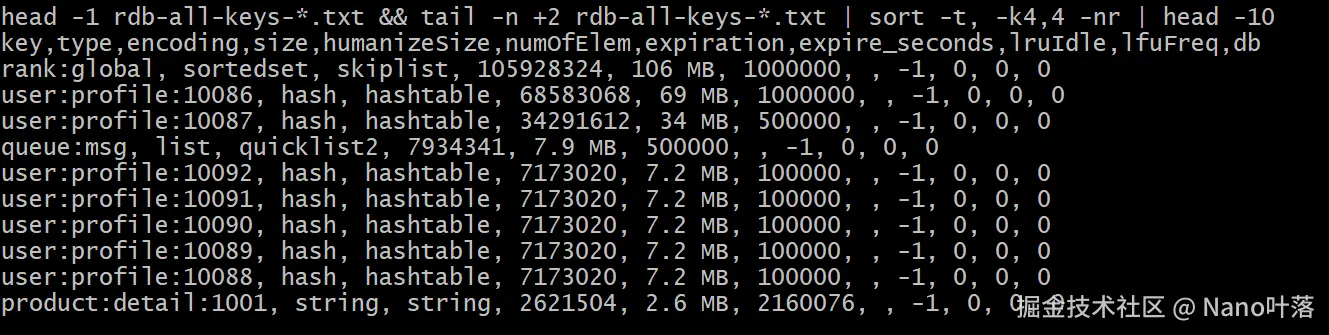
想要更直观的,还有网页版报告:
bash
.\rdr-win64.exe show -p 8099 dump.rdb
# 浏览器打开 http://localhost:8099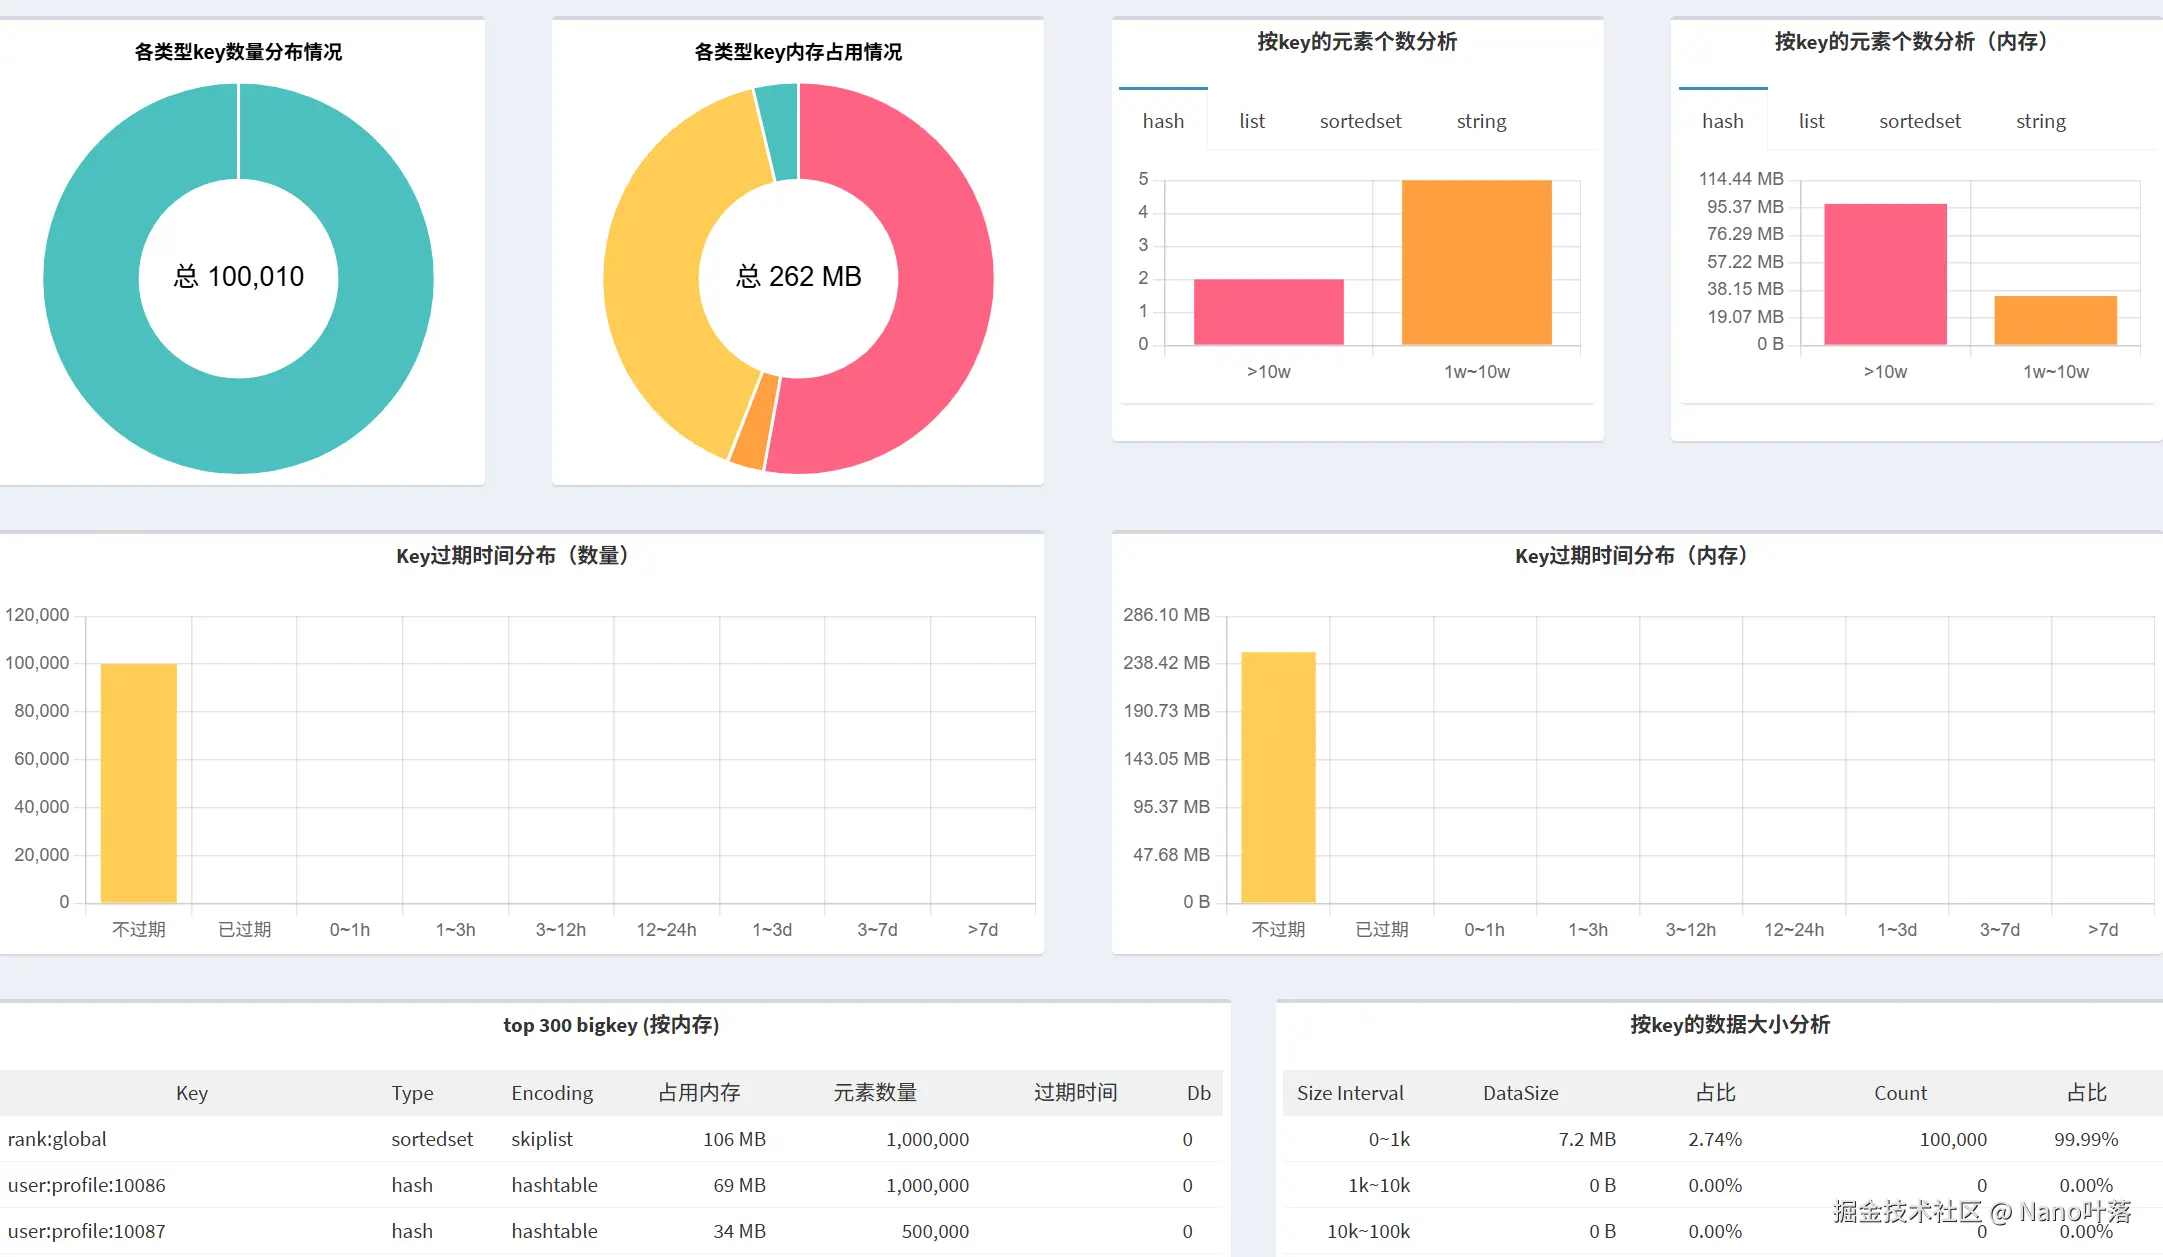
Top 大 key 榜、key 前缀分布、内存区间分布、过期时间分布,全带图表------这份报告截个图,够直接贴进故障复盘文档里。
对账
把 RDR 的 Top 榜和第二步 SCAN 脚本的清单摆在一起------key 名、类型、元素数、内存量级,完全吻合。两条独立路线互相印证,这份清单可以拿去汇报了。
RDR 是 Go 写的,性能余量很大:官方口径 10GB 的 RDB 约 30 秒解析完,我们这两百多 MB 的实验库秒出。从实验环境到生产大实例,一把工具够打全场。
产出:清除优先级清单
三板斧走完,是时候把散点收拢成清单了。这就是本篇的核心交付物,第 3、4 篇都围着它转:
| 排名 | key | 类型 | 元素数/字节 | 内存 | 预估 DEL 耗时 | 优先级 |
|---|---|---|---|---|---|---|
| 1 | rank:global | ZSet | 100 万成员 | ~87MB | ~0.1s | P0 |
| 2 | user:profile:10086 | Hash | 100 万 field | ~61MB | ~0.11s | P0 |
| 3 | user:profile:10087 | Hash | 50 万 field | ~31MB | ~55ms | P1 |
| 4 | queue:msg | List | 50 万元素 | ~6.5MB | ~50ms | P1 |
| 5 | user:profile:10088~10092 | Hash ×5 | 各 10 万 field | 5.6~6.8MB × 5 | ~10ms | P2 |
| 6 | product:detail:1001 | String | 2MB | ~2.5MB | 微秒级 | P3 |
(预估耗时以上篇实测推算:100 万 field 的 Hash 删一次 0.11 秒,元素减半耗时大致减半。)
排优先级就两条逻辑:
- 元素个数决定删除阻塞时长------P0 两颗百万级,删一颗主线程就停摆 0.1 秒,必须先处理;
- 访问频率决定紧急度------榜单里没有频率数据,这是要去业务侧核实的:一颗每天读一次的 P1,可能比一颗每秒读一万次的 P3 更不着急。
眼尖的读者会发现一个反常:product:detail:1001 贵为 String 冠军,优先级却排在所有集合后面垫底。因为它删起来是微秒级------它的危害不在"删",在"读":每秒几千次 GET 各拖走 2MB,网卡和带宽先顶不住。删除阻塞和网络风暴,到底各自是怎么回事?这正是下篇要解剖的。
三个必踩的坑
坑 1:--bigkeys 和 --memkeys 口径不同,别混用结论
--bigkeys 对集合报元素个数 ,--memkeys 报内存字节 。一个 100 万 field 但每个 field 只有几个字节的 Hash,是 --bigkeys 眼里的冠军,却可能在 --memkeys 榜上输给一个 10 万 field 的大字段 Hash。排查前先想清楚:你要防的是"删除阻塞"(看个数)还是"内存膨胀"(看字节)------两个问题,两把尺子。
坑 2:SCAN 过程中有写入,可能重复也可能漏
SCAN 的游标遍历不保证一致性:扫描过程中新增、删除、rehash 的 key,可能被重复返回,也可能被漏掉。实验库静态无所谓;线上边扫边写,清单可能有零星误差。所以 SCAN 清单用于"找嫌疑犯"没问题,用于"对账分钱"不行------后者请走 RDB 快照,那一刻的数据是 frozen 的。
坑 3:RDB 是快照,BGSAVE 的 fork 也有成本
离线分析不等于零成本,两笔账要算:
- 时效性 :RDB 是过去某一时刻的快照。刚写进去的新 Big Key,快照里没有;分析结果反映的是"BGSAVE 那一刻"的库。
- fork 开销 :
BGSAVE会 fork 子进程,大内存实例上 fork 本身就有一次几十到几百毫秒的阻塞,页表复制还吃内存(Copy-on-Write)。内存特别大、写入特别猛的实例,BGSAVE 要挑低峰,或者干脆从从库上拿 RDB。
小结
本篇的三板斧,一句话:
--bigkeys / --memkeys 粗扫建直觉(注意口径)→ SCAN + MEMORY USAGE 脚本全量出清单(低峰 + 限速)→ RDB 离线分析对账(线上零影响)→ 产出《清除优先级清单》。
清单到手,但它只回答了"多大",回答不了"为什么危险"------为什么 0.11 秒的 DEL 能让整个 Redis 停摆?为什么说那颗 2MB 的 String 危害在"读"不在"删"?过期大 key 被自动清理时为什么连慢日志都不留痕迹?下一篇解剖台见:《一个 DEL 卡了 1 秒:Big Key 危害的解剖报告------单线程阻塞、过期隐形删除与数据倾斜》。