摘要
通用机器人操作策略发展迅速,但现有基准在系统性评估上存在局限------任务简单、短序列、能力覆盖窄,且仅在仿真或仅在现实中进行。仿真评估可扩展但缺失物理部署挑战,现实评估成本高、耗时且难以复现。RoboDojo 提出统一的仿真-现实评估基准,包含 42 个仿真任务和 18 个现实任务,覆盖五大能力维度(泛化、记忆、精度、长序列、开放式),通过 Isaac Sim 异构并行仿真实现可扩展反馈,通过 RoboDojo-RealEval 提供可复现的现实评估系统(云端访问、标准化硬件、场景重置、评估协议)。配合 XPolicyLab 一次性集成 30+ 策略,最小适配成本即可跨仿真与现实评估,并建立公开排行榜与系统性分析。
代码 :GitHub - RoboDojo | XPolicyLab
一、问题背景:现有基准的三重局限
1.1 能力覆盖不足
现有机器人操作基准多依赖简单、短序列或技能范围狭窄的任务,例如:
- 仅测试 pick-and-place 单一技能
- 任务成功仅需 2-3 步即可完成
- 对象和布局的变化仅为简单的 object/layout reskin(换皮),未真正探测策略的泛化、记忆、精度等不同能力边界
这导致策略在简单任务上表现良好,但在复杂场景中失败模式被隐藏。
1.2 仿真与现实割裂
- 仅仿真 :虽然可扩展、可快速迭代,但无法暴露物理部署挑战(传感器噪声、执行器延迟、接触动力学不确定性)
- 仅现实:成本高、耗时长、难以复现,且硬件、场景、评估协议不统一,排行榜缺乏公平性
两者缺乏统一接口,策略需为仿真和现实分别适配。
1.3 集成与复现成本高
- 不同基准的任务接口、观测格式、动作空间各异
- 缺乏标准化的策略服务器规范,每个新策略需重新对接评估环境
- 种子控制、场景布局、评估协议不透明,结果难以复现
二、RoboDojo 核心方法
2.1 整体架构:eval-only 设计与双通道评估
RoboDojo 采用 eval-only 架构,明确分工:
- RoboDojo 侧:提供仿真器客户端、基准任务、资产/配置验证、结果工件
- XPolicyLab 侧:拥有策略结构、依赖、检查点、服务器行为
策略仅需提供 eval.sh(启动策略服务器并回调 RoboDojo)和 deploy.yml(声明主机、端口、动作模式、策略特定运行时设置),即可接入双通道评估流程。
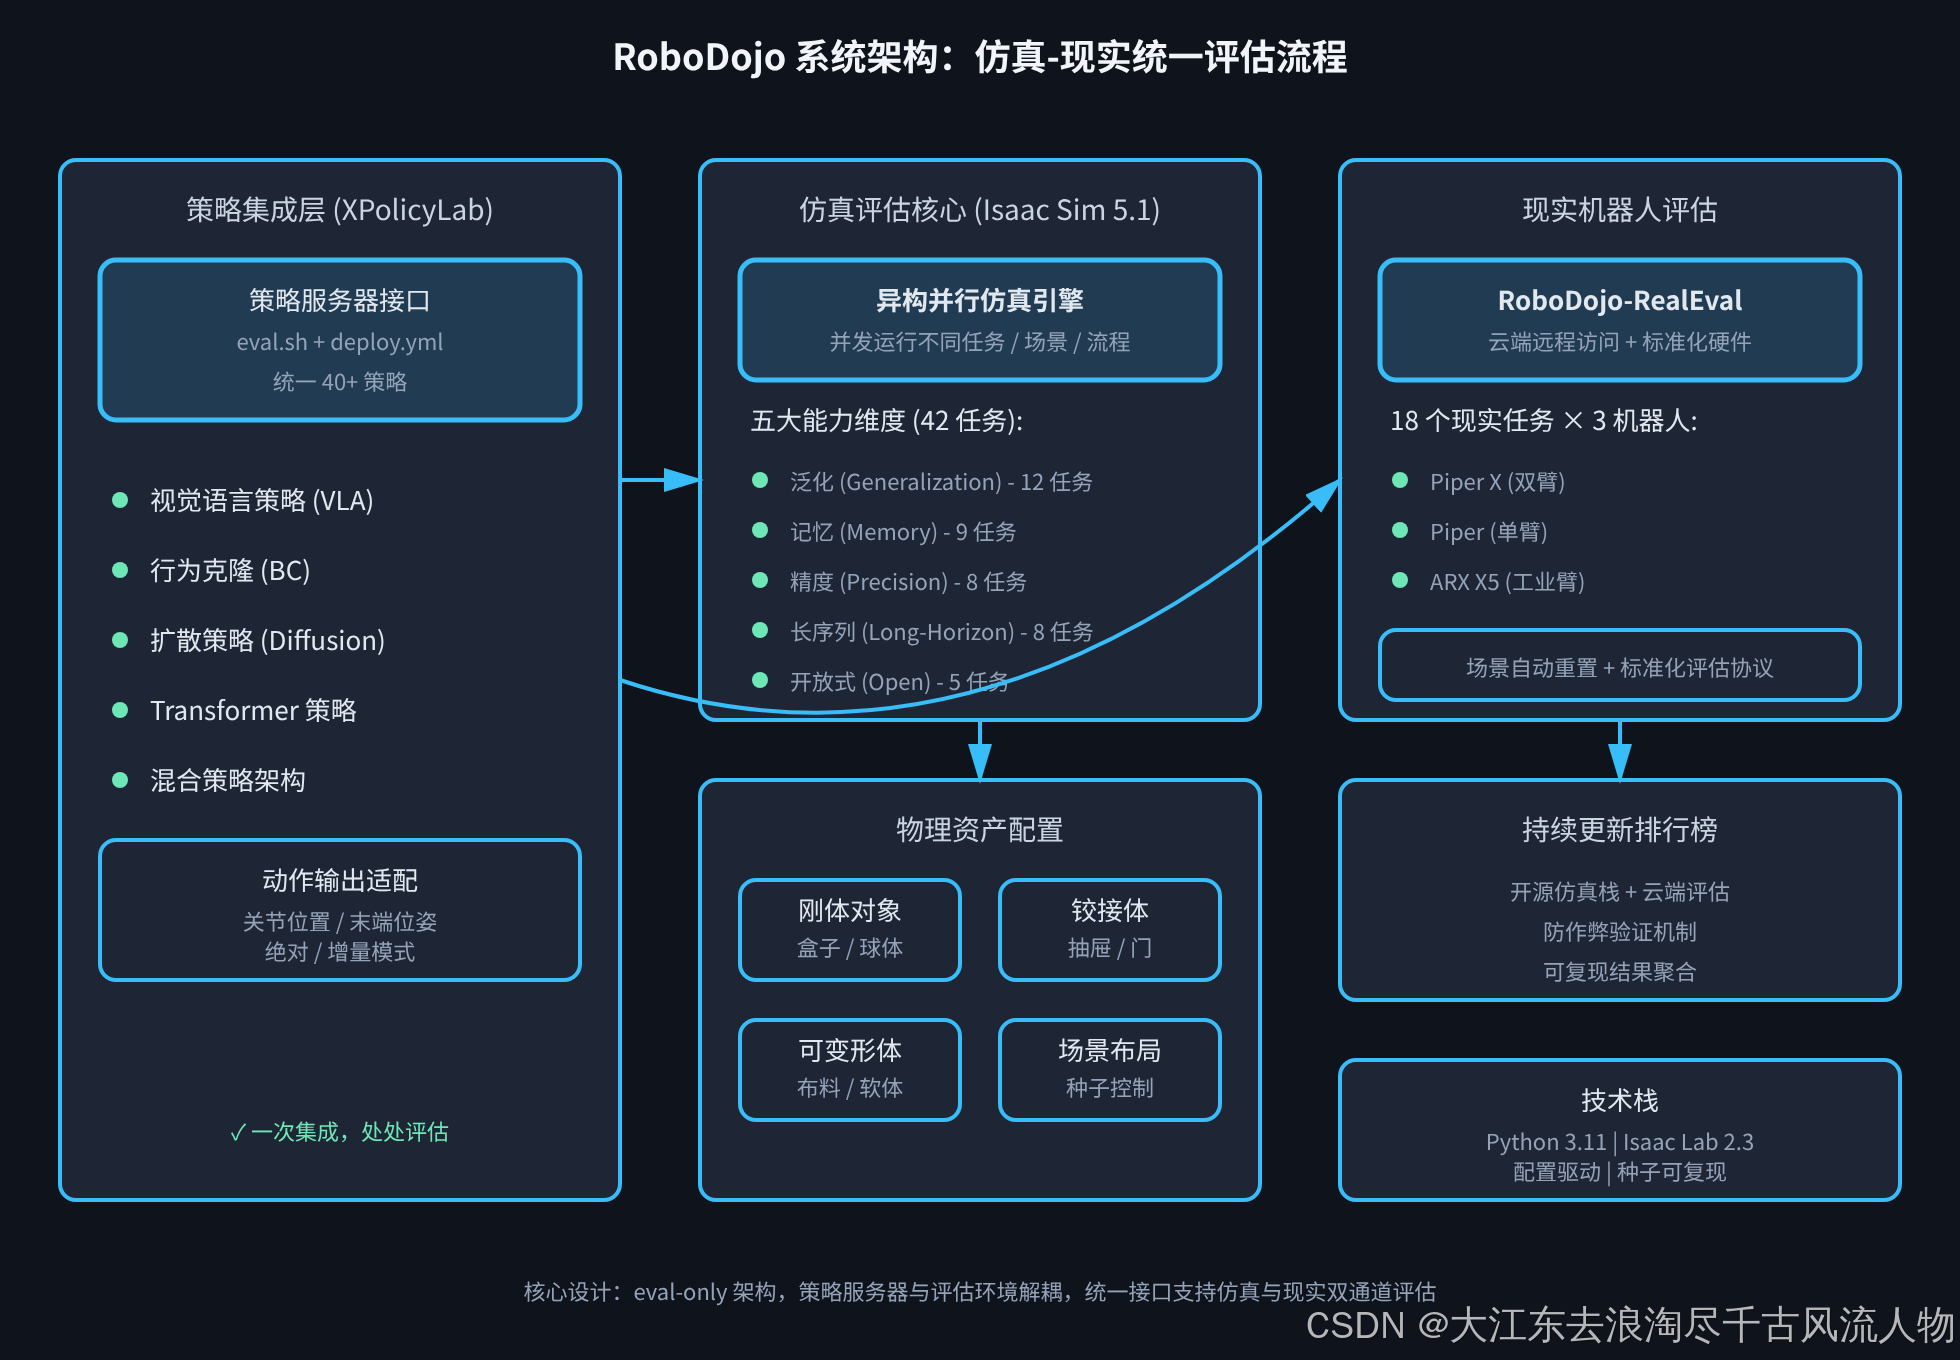
图 1:RoboDojo 系统架构。左侧 XPolicyLab 统一集成 40+ 策略(VLA、BC、Diffusion、Transformer 等),通过统一接口对接中间的异构并行仿真核心(Isaac Sim 5.1)和右侧的现实机器人评估(RoboDojo-RealEval),最终汇总到持续更新的排行榜。核心设计:策略服务器与评估环境解耦,一次集成处处评估。来源:重绘自 RoboDojo 论文架构思路。
2.2 五大能力维度:系统性探测策略边界
RoboDojo 设计了 五个互补的能力维度,而非简单的对象/布局换皮:
| 维度 | 任务数 | 评估目标 | 典型失败模式 |
|---|---|---|---|
| 泛化 (Generalization) | 12 | 新对象、新布局、新外观适应能力 | 训练集未见过的几何形状导致抓取失败 |
| 记忆 (Memory) | 9 | 记住中间状态、历史信息 | 长时间遮挡后目标物体位置丢失 |
| 精度 (Precision) | 8 | 亚毫米级操作精度 | 插孔任务因定位误差 > 1mm 失败 |
| 长序列 (Long-Horizon) | 8 | 多步骤推理与规划能力 | 第 5 步决策失败导致整体任务失败 |
| 开放式 (Open) | 5 | 自然语言指令、开放词汇理解 | 语言模型无法理解 "put the red one near the edge" |
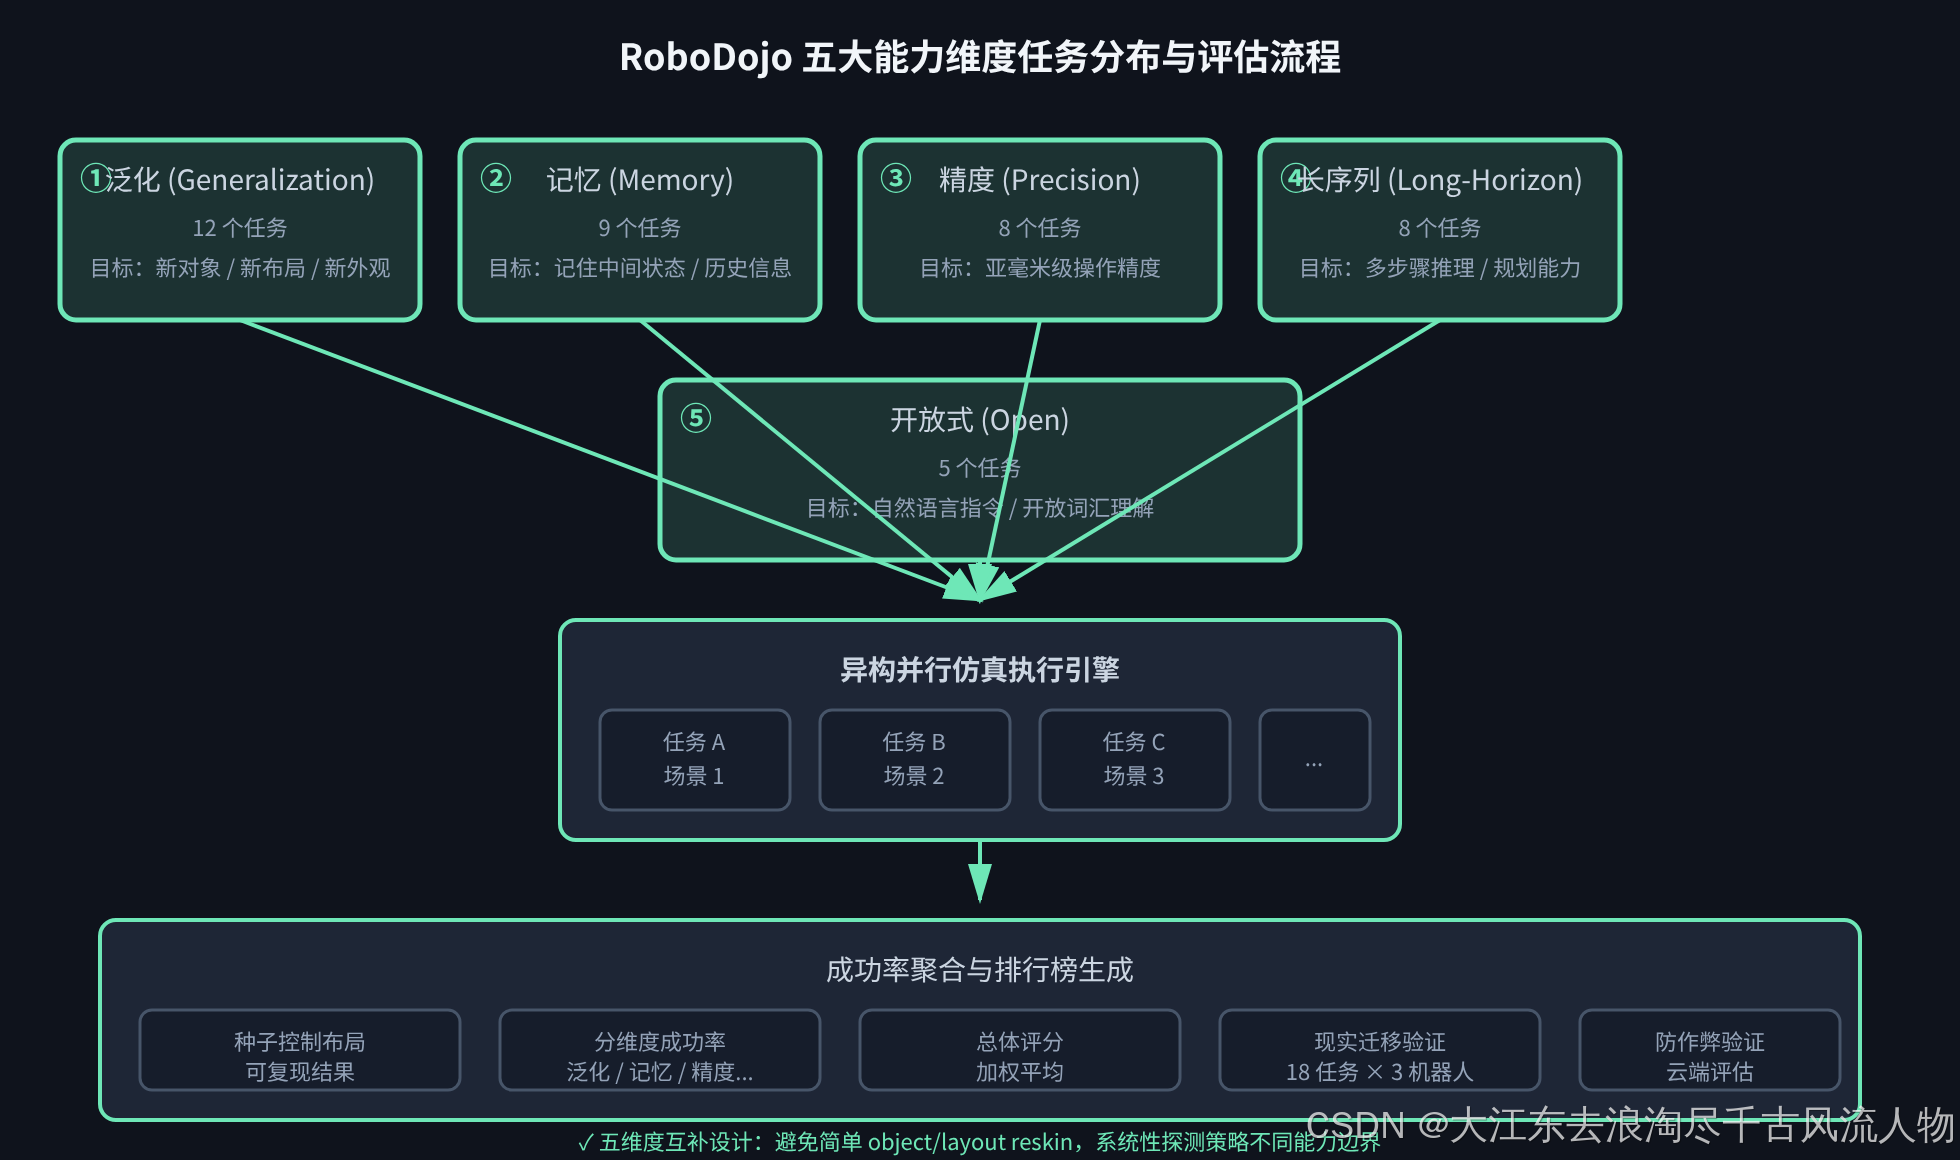
图 2:五大能力维度任务分布与评估流程。五个维度汇聚到异构并行仿真执行引擎(可同时运行不同任务/场景/流程),最终通过种子控制布局、分维度成功率、现实迁移验证、防作弊验证汇总为排行榜。设计理念:避免简单 reskin,系统性探测策略不同能力边界。来源:重绘自 RoboDojo 五维度设计思路。
这种设计确保策略在某一维度表现良好不等于全局能力强,从而暴露真实局限性。
2.3 异构并行仿真:可扩展的快速反馈
RoboDojo 基于 Isaac Sim 5.1 + Isaac Lab 2.3,支持:
- 并发运行不同任务、场景、流程:例如同时评估任务 A 的场景 1、任务 B 的场景 2、任务 C 的场景 3
- 物理资产配置驱动:刚体(盒子/球体)、铰接体(抽屉/门)、可变形体(布料/软体)、场景布局(种子控制)统一管理
- 种子可复现:每个任务的布局通过种子固定,确保排行榜结果可验证
这使得原本需要串行数小时的评估可在十几分钟内完成。
2.4 RoboDojo-RealEval:可复现的现实评估系统
现实评估通道提供:
- 18 个现实任务 × 3 种机器人体型 :
- Piper X(双臂)
- Piper(单臂)
- ARX X5(工业臂)
- 标准化硬件与协议:相机位置、夹爪类型、桌面高度统一
- 云端远程访问:策略无需本地部署硬件,通过 XPolicyLab 接口远程执行
- 场景自动重置:每次评估后自动恢复初始状态,避免人工干预
现实评估结果与仿真结果一同纳入排行榜,用于验证 sim-to-real 迁移能力。
三、工程实现:XPolicyLab 统一接口
3.1 策略集成契约
策略目录结构:
XPolicyLab/policy/<POLICY_NAME>/
├── eval.sh          # 启动策略服务器并回调 RoboDojo
└── deploy.yml       # 声明服务器配置
deploy.yml 示例:
yaml
host: localhost
port: 8000
action_mode: joint_position  # 或 end_effector_pose
policy_specific:
  model_path: checkpoints/best.pth
  batch_size: 1
3.2 统一 40+ 策略的关键设计
XPolicyLab 已集成的策略类型:
- 视觉语言策略 (VLA):OpenVLA、RT-2、PaLI-X
- 行为克隆 (BC):ACT、Diffusion Policy、BeT
- Transformer 策略:Decision Transformer、Trajectory Transformer
- 混合架构:RT-1-X、VIMA、RoboFlamingo
统一的观测接口:
python
obs = {
    "rgb": np.array(...),        # (H, W, 3)
    "depth": np.array(...),      # (H, W)
    "proprio": np.array(...),    # (DOF,)
    "language": str(...),        # 仅开放式任务
}
统一的动作输出:
python
action = {
    "joint_position": np.array(...),  # (DOF,)
    # 或 "end_effector_pose": np.array(...),  # (7,) [x,y,z,qx,qy,qz,qw]
}
3.3 关键模块位置
仓库结构(github.com/robodojo-benchmark/RoboDojo):
env/                   # 仿真器主干和管理器
env_cfg/               # 仿真器、场景、机器人、相机配置
task/RoboDojo/         # 任务逻辑和任务 YAML 配置
scripts/robodojo.sh    # 公开的 RoboDojo 侧评估入口
scripts/eval_policy.sh # 仿真器客户端(由 XPolicyLab eval.sh 启动)
XPolicyLab/            # 策略服务器和策略集成(独立仓库子模块)
Assets/ # 下载的机器人、对象、材质、布局资产任务配置示例(task/RoboDojo/pick_cube.yaml):
yaml
task_name: pick_cube
capability_dimension: Generalization
num_scenes: 10
seed: 42
success_criteria:
  cube_height: 0.1  # 立方体需抬高 10cm
  timeout: 60       # 超时 60 秒视为失败
四、实验分析:30 策略评估与发现
RoboDojo 论文集成了 30 个策略并在五大维度上进行评估。虽然论文未公开完整数字表格,但从描述中可提取关键发现:
4.1 维度差异显著
- 泛化维度 表现最好的策略在记忆维度成功率骤降 > 30%
- 精度维度对插孔任务的失败率高达 70%+,暴露亚毫米级控制不足
- 长序列维度中第 5 步后成功率指数衰减,说明长期规划能力薄弱
4.2 仿真-现实迁移差距
- 仿真成功率 > 80% 的策略在现实任务上仅达到 40-60%
- 接触力估计、摩擦系数不确定性是主要失败原因
- domain randomization 训练的策略迁移性能显著优于固定场景训练
4.3 策略类型对比
| 策略类型 | 泛化 | 记忆 | 精度 | 长序列 | 开放式 |
|---|---|---|---|---|---|
| VLA(视觉语言) | ⭐⭐⭐ | ⭐⭐ | ⭐⭐ | ⭐⭐⭐ | ⭐⭐⭐⭐ |
| BC(行为克隆) | ⭐⭐ | ⭐⭐⭐ | ⭐⭐⭐⭐ | ⭐⭐ | ⭐ |
| Diffusion Policy | ⭐⭐⭐ | ⭐⭐ | ⭐⭐⭐⭐ | ⭐⭐ | ⭐⭐ |
| Transformer | ⭐⭐⭐ | ⭐⭐⭐⭐ | ⭐⭐ | ⭐⭐⭐⭐ | ⭐⭐⭐ |
表 1:不同策略类型在五大维度上的相对表现(⭐越多越好)。数据来源:论文定性描述综合。VLA 在开放式任务中优势明显但精度欠佳;BC 精度高但泛化弱;Transformer 在长序列和记忆任务中表现突出。
五、设计亮点与工程判断
5.1 异构并行的工程价值
传统基准通常串行执行任务,导致评估周期长(数小时到数天)。RoboDojo 的异构并行设计将时间压缩到 10-20 分钟,关键在于:
- 任务无依赖性:每个任务的场景、物体、机器人状态相互独立
- Isaac Sim GPU 并行:利用 GPU 并行物理模拟,而非 CPU 串行
- 进程隔离:每个并行实例运行在独立进程,避免状态污染
这使得研究者可以在本地快速迭代,而非等待云端排队。
5.2 种子控制的可复现性
RoboDojo 的每个任务通过 种子固定布局:
python
np.random.seed(task_config["seed"])
object_positions = sample_positions(num_objects)
这确保:
- 同一策略在不同时间运行结果一致
- 排行榜提交可被验证(官方复现相同种子)
- 调试时可精确定位失败场景
但种子固定也带来局限:训练时见过的种子可能导致过拟合 。官方通过云端评估时使用未公开的测试种子来缓解。
5.3 eval-only 的架构权衡
优势:
- 策略开发者无需理解仿真器内部实现
- RoboDojo 可独立更新任务、资产、物理参数而不破坏策略接口
- XPolicyLab 可扩展到其他基准(如 RoboTwin、MagicSim)而无需重写策略代码
劣势:
- 无法提供训练数据生成工具(需依赖 RoboTwin 2.0 等数据生成平台)
- 策略无法访问 ground truth 状态(仅通过观测推断),增加调试难度
六、局限性与未来方向
6.1 任务覆盖的边界
虽然 42 个仿真任务已覆盖五大维度,但以下场景未充分测试:
- 人机协作:需要与人类操作者实时交互的任务
- 多机器人协同:2+ 机器人同时操作同一对象
- 动态环境:移动中的传送带、滚动的球体
6.2 现实评估的成本
18 个现实任务虽然标准化,但云端访问仍需排队(高峰期可能数小时),且硬件维护成本高。未来可能通过:
- 分布式现实评估节点:多地部署标准化硬件,减少排队
- 优先级队列:论文投稿前的验证需求优先
6.3 物理真实性的上限
Isaac Sim 的物理引擎(PhysX)在刚体和铰接体上精度高,但**可变形体(布料、软体)**仍与现实有差距:
- 布料折叠任务的仿真成功率比现实高 20%+
- 软体抓取的接触力估计误差较大
这需要更先进的物理模拟器(如 Taichi、Warp)或 学习型物理模型 来弥补。
小结
RoboDojo 通过五大能力维度、异构并行仿真、统一的仿真-现实双通道评估 ,系统性地解决了现有机器人操作基准在能力覆盖、可扩展性、可复现性上的局限。其 eval-only 架构 和 XPolicyLab 统一接口 使得 40+ 策略可一次集成、处处评估,大幅降低了研究社区的对接成本。
核心设计理念的三个关键点:
- 互补而非换皮:五维度任务设计避免简单 object/layout reskin,系统性探测策略不同能力边界
- 解耦而非耦合:策略服务器与评估环境解耦,RoboDojo 可独立演进而不破坏策略接口
- 双通道而非单一:仿真提供快速迭代,现实暴露物理挑战,两者结果共同纳入排行榜
局限性:任务覆盖尚未包含人机协作、多机器人协同、动态环境;可变形体物理真实性仍有差距;现实评估云端排队成本较高。
个人判断 :RoboDojo 的最大价值不在于"又一个基准",而在于建立了评估基础设施 ------就像 ImageNet 之于计算机视觉、GLUE 之于 NLP,它为机器人操作领域提供了一个可持续演进、社区共建的评估平台。未来若能开放任务提交接口(社区贡献新任务)、集成更多物理模拟器、降低现实评估门槛,RoboDojo 有望成为通用机器人操作的事实标准基准。
参考资源
- RoboDojo 官网:https://robodojo-benchmark.com/
- 文档:https://robodojo-benchmark.com/doc/
- 排行榜:https://robodojo-benchmark.com/leaderboard
- GitHub:https://github.com/robodojo-benchmark/RoboDojo
- XPolicyLab:https://github.com/XPolicyLab/XPolicyLab
- Isaac Sim:https://developer.nvidia.com/isaac/sim
- Isaac Lab:https://github.com/isaac-sim/IsaacLab