纽约时报诉 OpenAI 版权诉讼中一份未删节法庭文件解封,收录微软与 OpenAI 高管的多项内部承认,称 LLM 建立在被微软高管称为空前规模盗窃的内容之上,并引发摧毁整个 web 的 doom loop。
这锅 AI 公司背了
这份由《纽约时报》律师团队提交的动议,核心是用被告自己的话反击被告。微软应用科学部门主管 Brent Hecht 在内部文件里直言,将新闻内容用于 AI 训练是「前所未有的大规模盗窃」,甚至称其可能是「人类历史上规模最大的劳动力盗窃」。OpenAI ChatGPT 负责人 Nick Turley 也在内部消息中警告,出版商将面临「存在性威胁」。
Doom Loop 的机制拆解
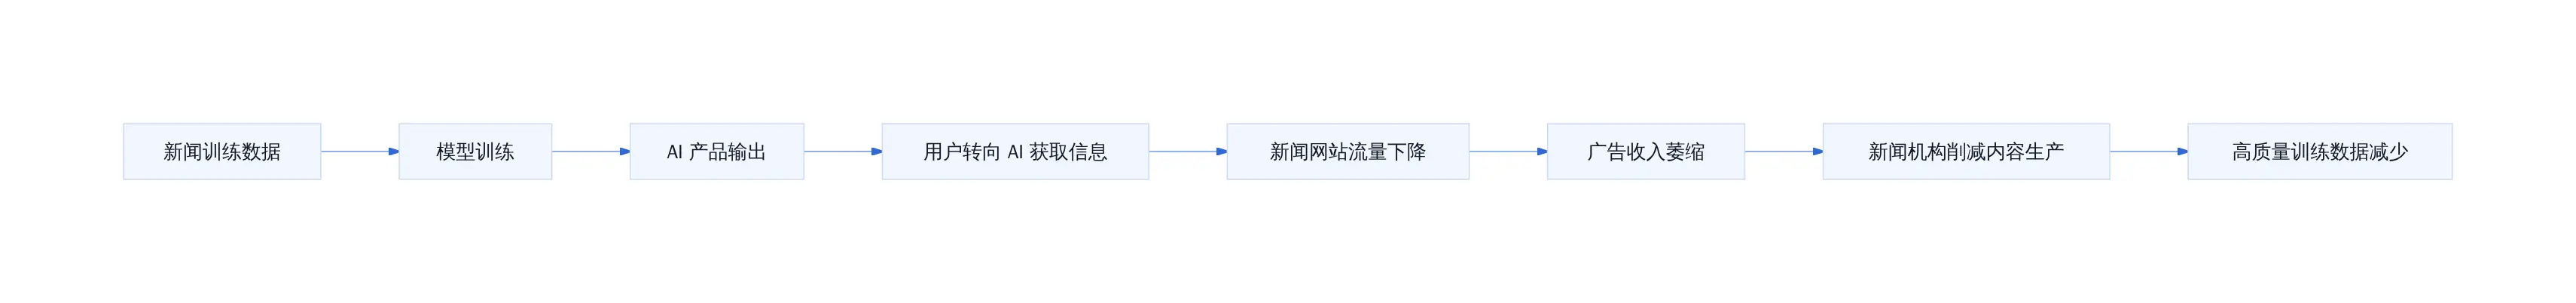
Doom Loop 的逻辑链条很直接:AI 产品以新闻内容训练模型,产出可替代新闻的服务,用户转向 AI 获取信息,新闻网站流量和广告收入随之萎缩,新闻机构被迫削减内容生产,而 AI 模型失去高质量训练数据,表现下滑。
微软内部数据显示,部分涉诉新闻机构的 Bing 点击率下降了 83% 至 93%,另一些机构则下降了 51% 至更高区间。这不是预测,是已经发生的量化结果。
Doom Loop 闭环机制
这个闭环的问题在于,它把生产优质内容的机构当成了原材料供应商,最终又把供应商的市场消灭掉。微软高管后来也承认,「一个终产品威胁到其关键供应商的经济基础,是非常不寻常的情况。」
##DoomLoop的机制拆解D
诉讼进展与合理使用的博弈
案件的核心争议落在合理使用原则的边界上。OpenAI 和微软主张,将新闻内容用于训练属于「转换性使用」,具有创造性潜力和公共利益,应受合理使用保护。美国司法部在 2026 年 9 月提交的利益声明中明确支持这一立场,认为若版权规则显著增加开发大语言模型的成本,将损害美国 AI 产业竞争力。
但纽约时报的抗辩同样具体。诉状指出,OpenAI 在训练过程中使用了其数千篇文章,且 ChatGPT 能够通过极少量的提示词逐字输出受版权保护的内容。法院引用的证据显示,《纽约时报》一篇历经 18 个月调查、600 场访谈的普利策奖作品,在 GPT-4 中几乎可以被完整复现。
证据链摆在桌上
更关键的是,纽约时报在诉讼中揭露,OpenAI 曾通过技术手段绕过其付费墙获取内容。这一细节直接削弱了被告「仅使用公开数据」的主张。这里需要区分两种情况:第一种是爬虫通过技术手段绕过了付费墙,这在技术上可行,在法律上构成未经授权访问。第二种是 OpenAI 通过合作或授权获得了部分内容,但在未授权的部分上仍然大规模使用------这种情况下的法律争议焦点就转移到了「使用了多少」和「是否属于合理使用」。
工程侧的现实冲击
对实际做 AI 产品的团队而言,这个案件的信号很明确。数据合规成本正在从隐性风险转为显性支出。
业内常见的做法有三种路径。第一种是建立授权数据采购流程,与出版商签署训练数据许可协议,按使用量或固定费用结算。第二种是构建过滤管道,在数据采集阶段识别并排除受版权保护的内容源。第三种是参与开源数据集建设,使用经清洗的公共语料,降低直接使用商业内容的法律敞口。
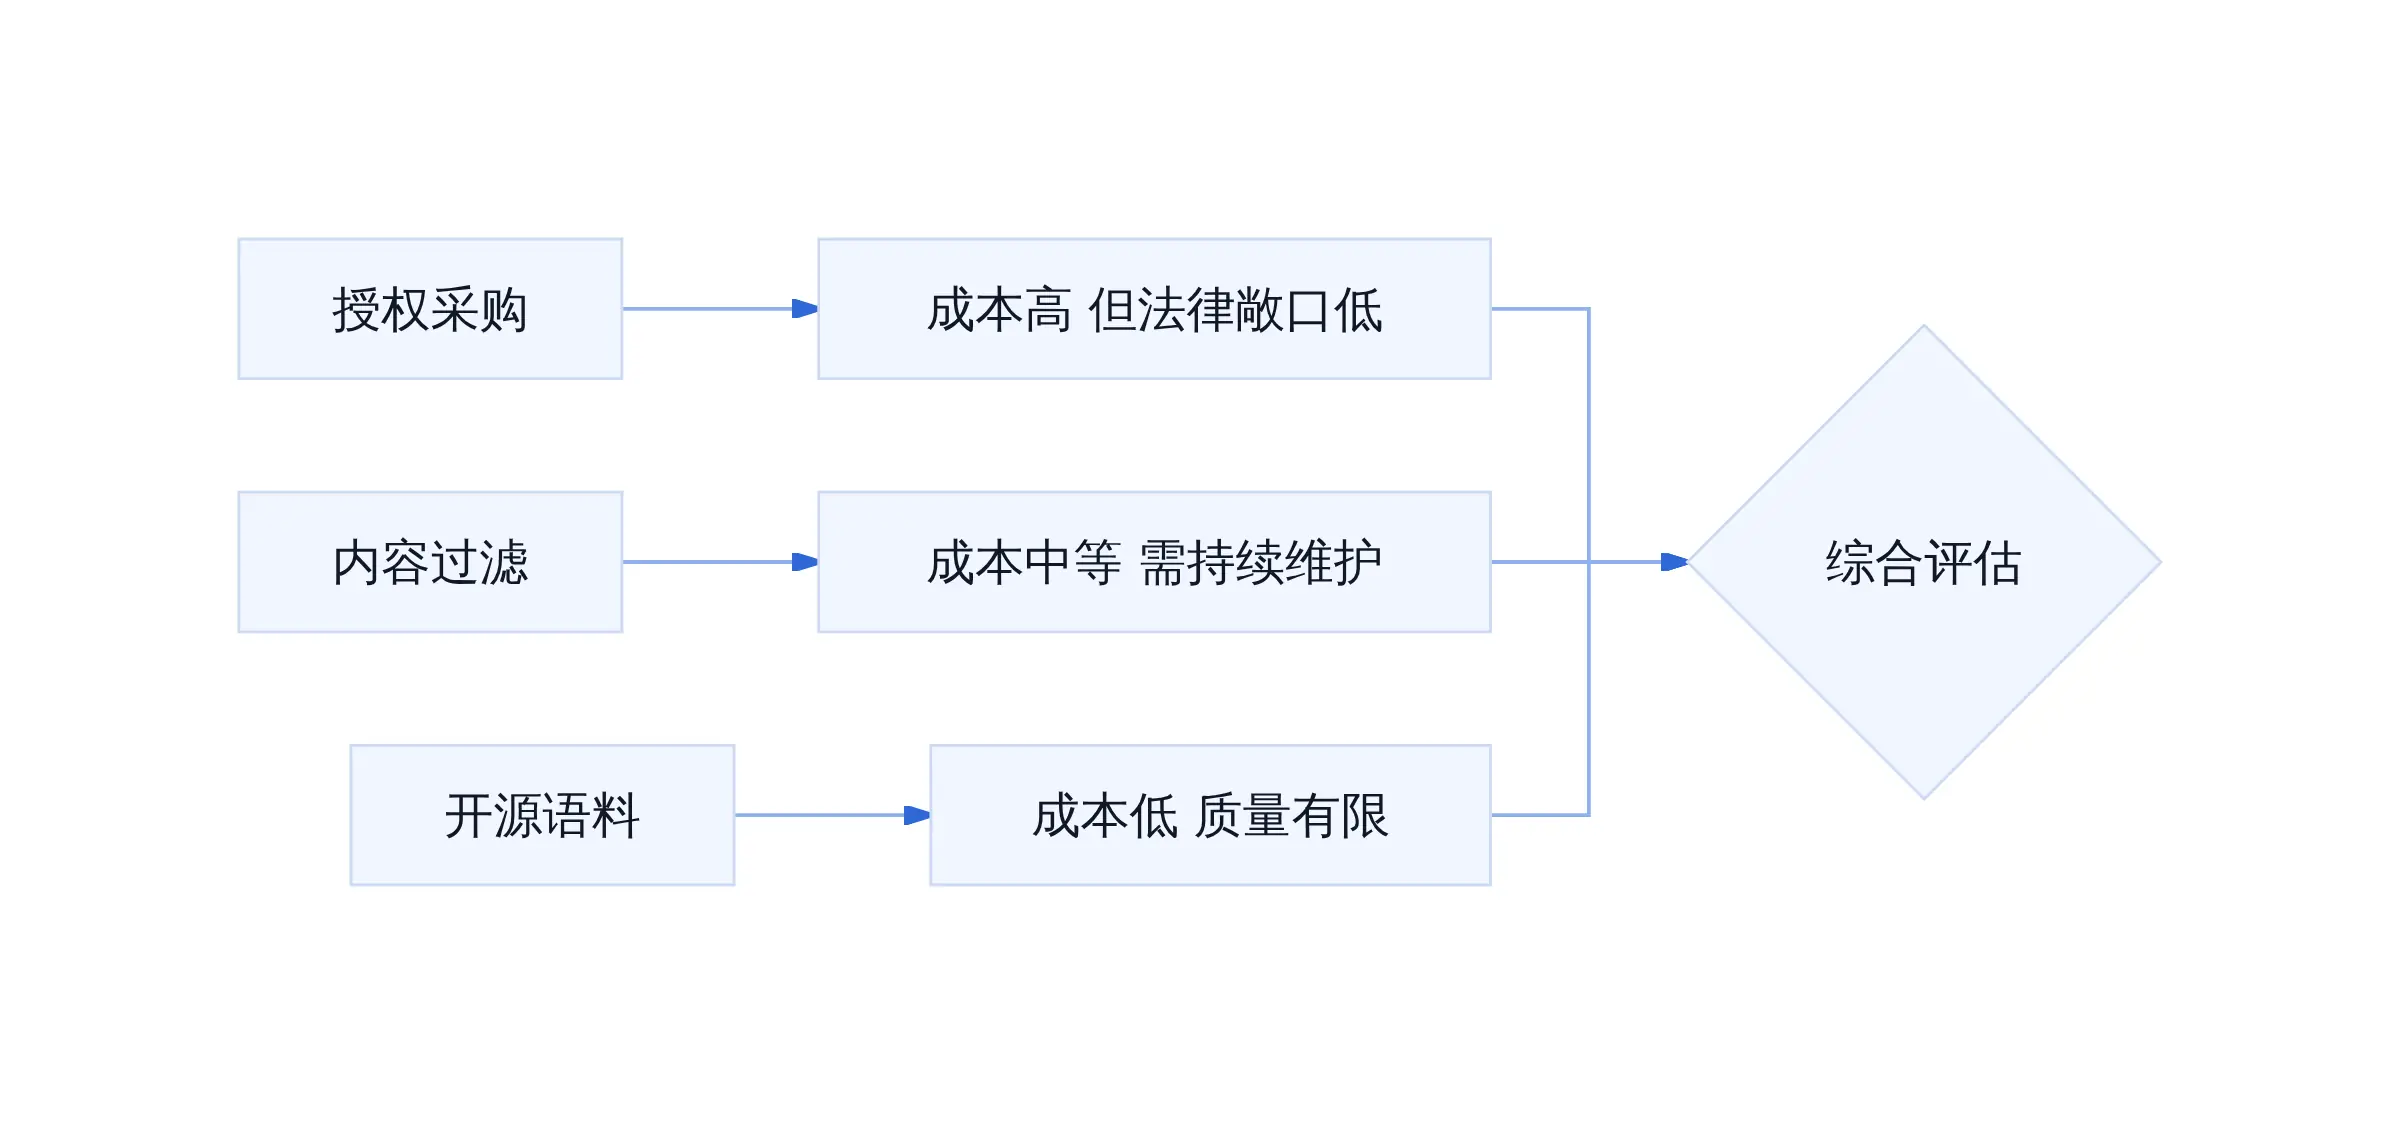
训练数据合规路径对比
选择哪种路径取决于产品定位。面向企业客户、追求高可靠性的系统,授权采购是必要的投入。面向研究或实验性项目,开源语料配合内容过滤可以平衡成本与合规。完全依赖未经清洗的公开爬取数据,正在成为法律层面的高风险行为。
纽约时报诉 OpenAI 案的进展,不只是新闻业与 AI 公司的博弈,也是整个行业在重新定义数据获取边界的标志。
新解封文件的三个核心指控
这份由《纽约时报》律师团队在动议摘要中整理提交的文件,核心内容可以归纳为三条。
第一条是微软应用科学部门主管 Brent Hecht 的内部警告。他在文件中将新闻内容用于 AI 训练称为「前所未有的大规模盗窃」,并进一步形容这是「人类历史上规模最大的劳动力盗窃」。
第二条来自 OpenAI 内部。ChatGPT 负责人 Nick Turley 在内部通信中写道,出版商正面临「存在性威胁」------商业化产品已经可以用新闻内容直接替代新闻供应商的功能。
第三条是微软提出的「毁灭循环」概念。其逻辑链条很简单:AI 产品减少新闻网站流量和收入 → 新闻机构削减内容生产预算 → AI 模型失去高质量信息来源 → 模型质量下降 → 用户进一步流失。这不是推测,微软内部数据已经观察到趋势。
微软内部的「毁灭循环」诊断
Doom Loop 的实质是一个负反馈环路,其中系统的每一个环节都在加速自我削弱。
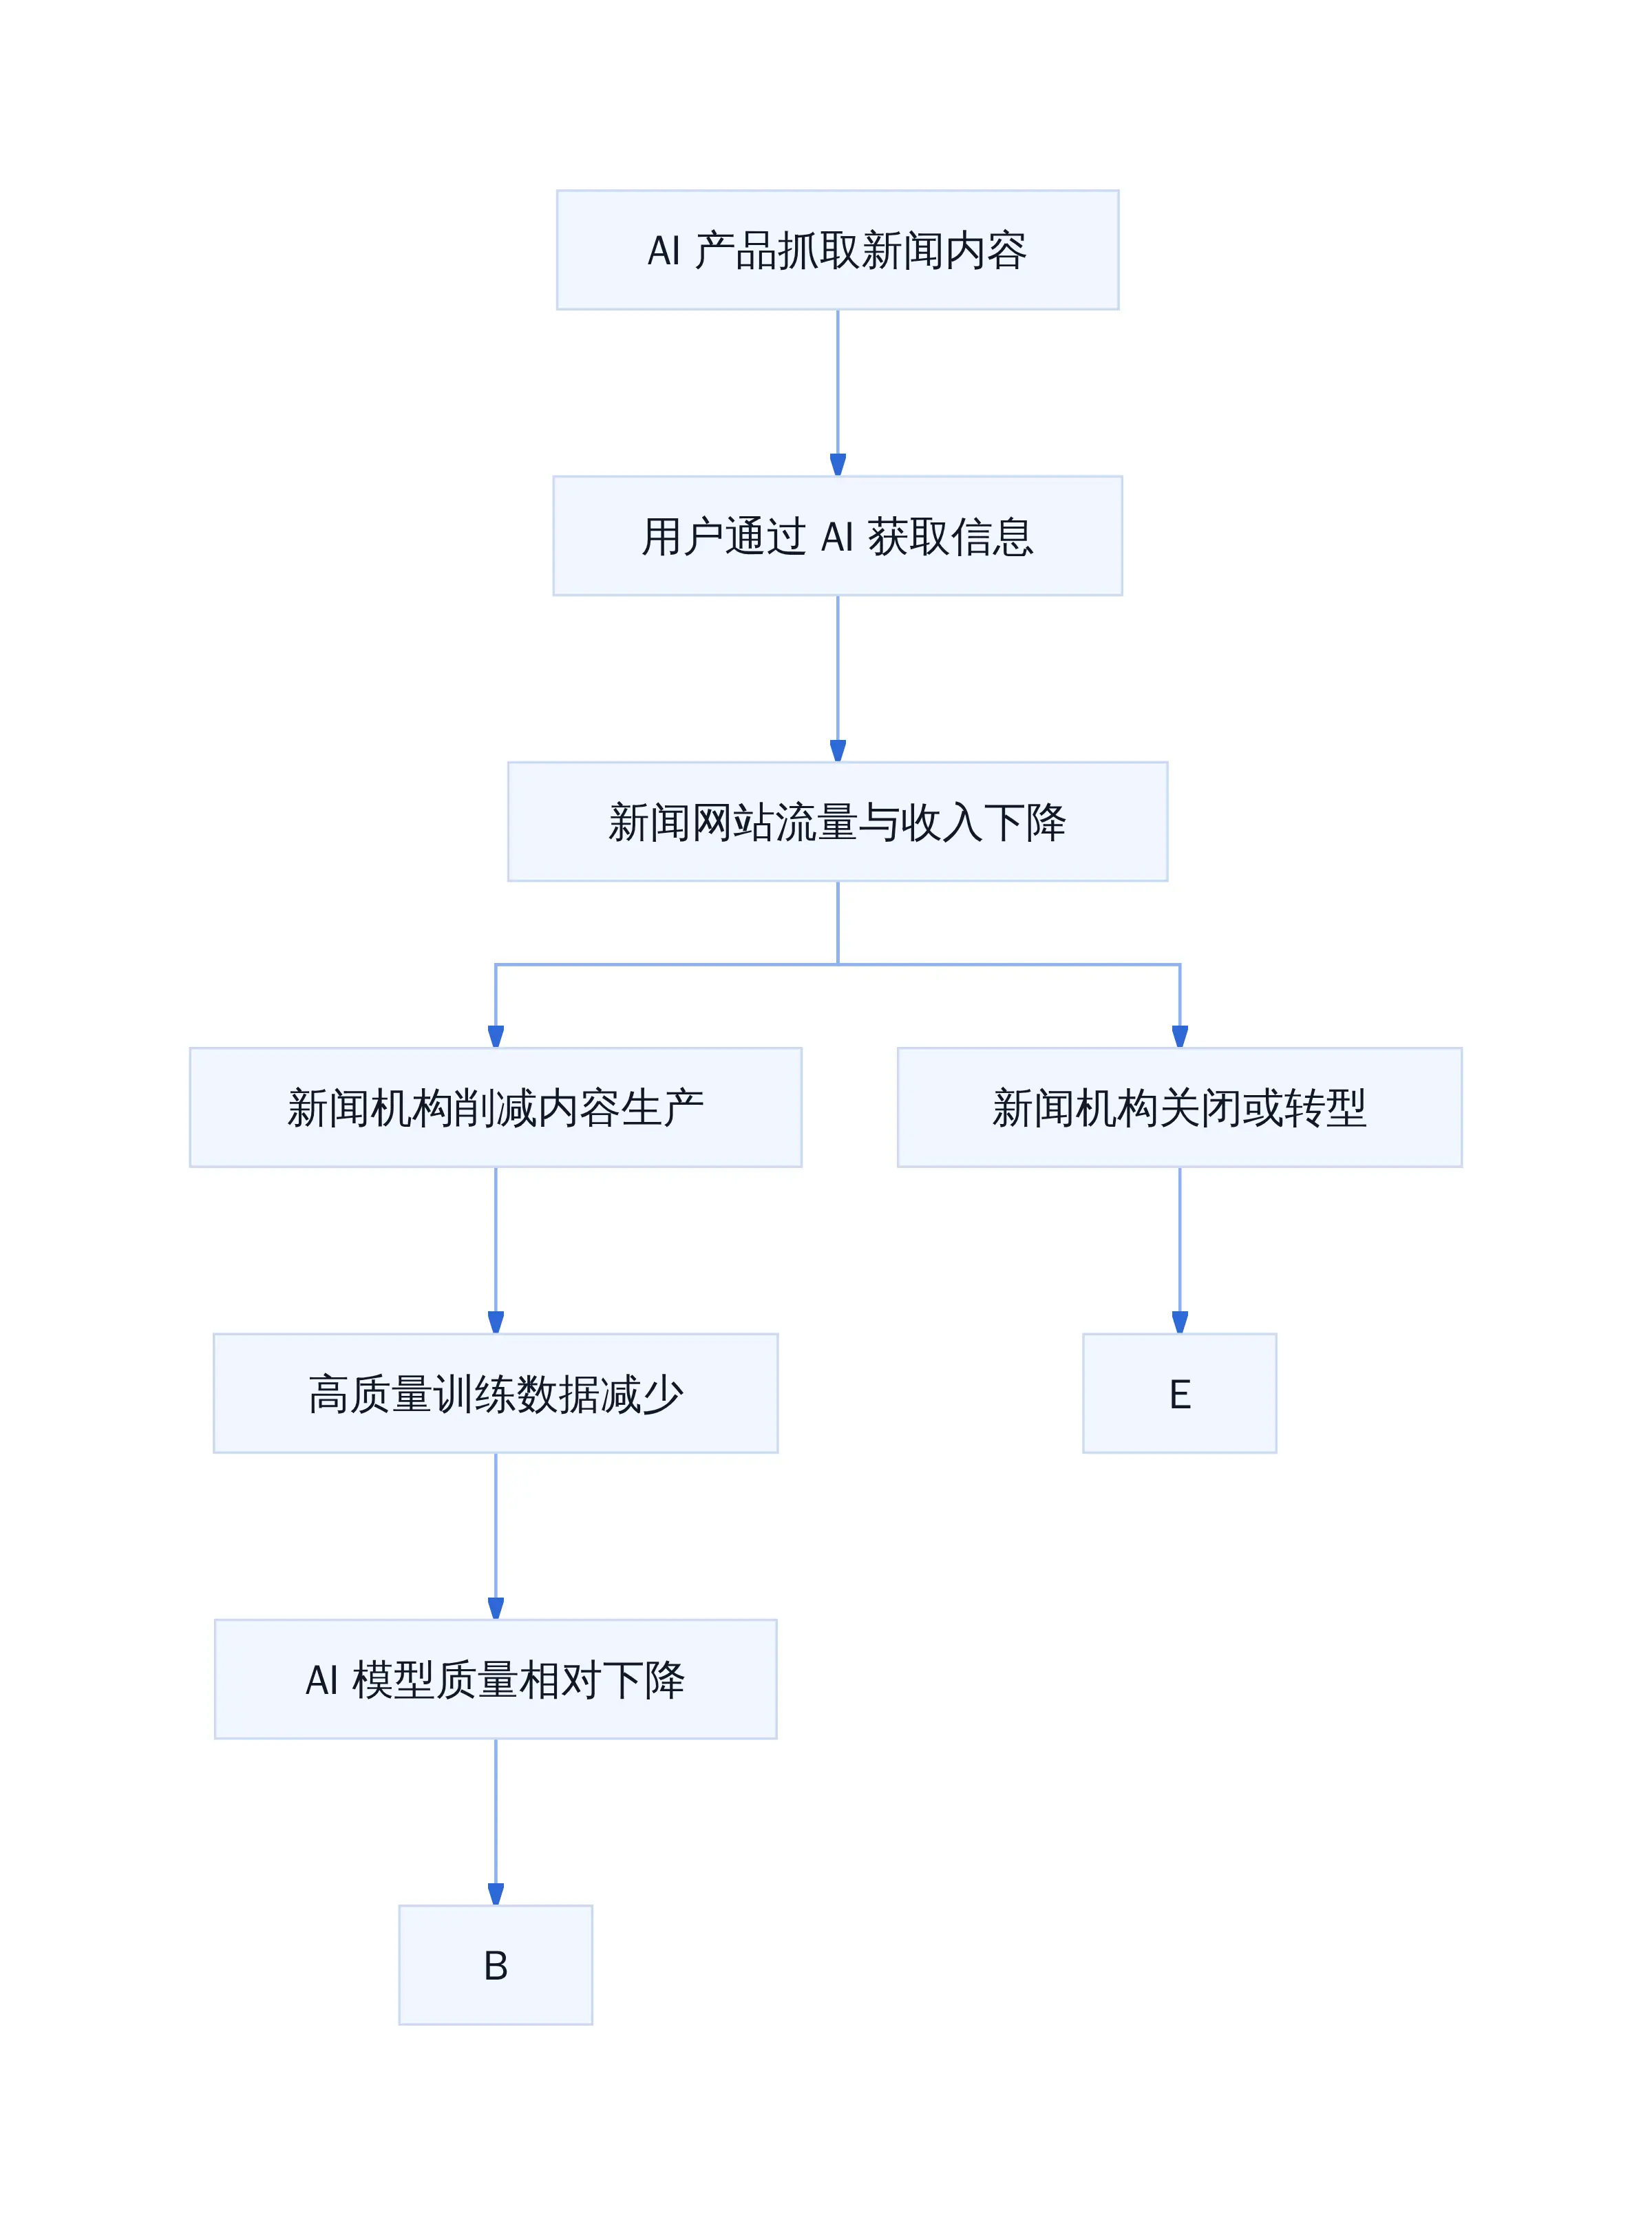
Doom Loop 负反馈机制
这个循环的关键节点是第 3 步和第 4 步之间的时间差。新闻内容的生产成本高、周期长,而 AI 模型的消耗速度远快于内容生产的更新速度。当循环启动后,没有外部干预的话,它是一个收敛到零的序列。
司法部以国家安全名义介入
2026 年 9 月 3 日,美国司法部向纽约南区联邦地区法院提交了一份「利益声明」,公开支持 OpenAI 的立场。副司法部长斯坦利·伍德沃德签署的文件中,核心论证路径如下:
大语言模型训练对版权作品的使用具有「转换性」目的,符合合理使用标准;训练带来的创造性潜力和公共利益,远远超过任何竞争损害。司法部进一步将这个问题上升到国家安全层面,声称如果版权规则显著增加在美国开发 LLM 的难度,可能损害美国 AI 产业竞争力,给不受此类束缚的外国对手带来优势。
这种论证策略在版权诉讼史上并不常见。政府以国家安全为由介入私人版权纠纷,本质上是在重新划定合理使用的边界------不是基于法律先例,而是基于产业竞争叙事。《纽约时报》回应称,政府「正在站在少数几家价值数万亿美元的人工智能公司一边,却以牺牲无数美国创作者的利益为代价」。
合理使用的争论边界在哪
合理使用(Fair Use)是本案的法律核心,也是所有争议的分水岭。美国版权法第 107 条规定了合理使用的四项判断标准:使用的目的和性质、版权作品的性质、使用部分相对于整体的比例、使用对原作品市场价值的影响。
OpenAI 和微软的论证主线集中在第一项:训练 LLM 是一种「转换性使用」,因为模型学习的是模式和结构,而非复制具体表达。司法部支持这一观点,认为这种转换性带来的公共利益远超竞争损害。
《纽约时报》的反驳则集中在第四项:AI 产品直接替代了新闻内容的消费场景,对原作品的市场价值造成了实质性损害。
这个争论的真正难点在于:法院没有一个现成的判例可以直接套用到「用数百万篇文章训练一个通用语言模型」的场景上。合理使用的四项标准诞生于印刷时代,而 LLM 的训练过程在规模、速度和自动化程度上都超出了这个框架的设计预期。
证据开示争议:OpenAI 被指控销毁数十亿条对话记录
证据开示(discovery)阶段往往是版权诉讼的真正战场。文件显示,《纽约时报》《纽约每日新闻》等多家新闻机构于 2026 年 7 月向纽约南区联邦法院提交动议,请求对 OpenAI 实施制裁。理由指向两项核心指控。
第一项是就检索训练数据的能力向法院作出虚假陈述。原告方认为,OpenAI 在证据开示过程中对其技术能力进行了选择性描述,隐瞒了模型训练中实际获取和使用受版权保护材料的方式。第二项更为直接:删除数十亿条相关 ChatGPT 对话记录。
法官 Ona T. Wang 负责证据开示争议,主审法官 Sidney H. Stein 则把握案件实体走向。多家新闻机构联合申请制裁的请求,将案件从版权争议推向了证据开示不当行为的审查维度。一旦法院认定销毁行为成立,可能触发证据罚则、不利推断,甚至更高的赔偿额度。
坦白讲,这类指控在技术公司的证据管理中并不罕见,但涉及数十亿条对话记录时,规模本身就构成了独立的争议焦点。OpenAI 方面尚未公开回应具体销毁范围,案件正处于证据保全动议阶段。
诉讼还在继续,司法部也提出了上诉。但无论判决结果如何,Doom Loop 的第一圈已经转完了------新闻机构的收入在下降,AI 公司的数据来源在收紧,双方的谈判桌正在从法庭延伸到商业合约。
参考文献
- 404 Media, 'Doom Loop': OpenAI and Microsoft Admits LLMs Are Destroying the Web and Built on Theft, www.404media.co/doom-loop-o...
- IT之家, 微软及 OpenAI 内部文件曝光:高管曾警告 AI 可能对新闻机构产生「毁灭性影响」, www.ithome.com/1/003/908.h...
- Ars Technica, Microsoft exec called AI scraping the 'largest theft of labor in human history', arstechnica.com/tech-policy...
- IT之家, 纽约时报诉 OpenAI 案升级:美国司法部首次就 AI 版权问题公开表态, www.ithome.com/0/997/732.h...
- 财联社, 纽约时报诉 OpenAI 案生变:美国政府公开站队 力挺 AI 训练属合理使用, m.cls.cn/detail/2473...
- Getech Law Firm, 《纽约时报》诉 OpenAI 版权案升级:多家新闻机构申请法院制裁,指控隐匿销毁证据, www.getechlaw.com.cn/blog/nyt-op...
- OpenAI, 关于《纽约时报》诉讼的事实声明, openai.com/zh-Hans-CN/...