问题描述
某库表的 ProductionLine_Number 是分组字段,组内按 date_Time 排序。需要在每组中搜索 Cardboard_Number 等于指定字符串的所有记录,取出每条命中记录前后指定偏移量范围内的记录,合并并去除重复后输出。例如搜索 spL1ml82N4o、偏移量为 2 时,结果 ID 为 2,4,5,6,9,10,11,12。
源数据
|----|------------------|---------------------|-----------------------|
| id | Cardboard_Number | date_Time | ProductionLine_Number |
| 2 | WDL-005943998-1 | 2024-02-29 17:13:50 | 1 |
| 4 | spL1ml82N4o | 2024-02-29 17:13:54 | 1 |
| 5 | WDL-005943998-1 | 2024-03-01 09:44:42 | 1 |
| 6 | WDL-005943998-1 | 2024-03-01 10:34:57 | 1 |
| 7 | 950024027237 | 2024-03-01 10:44:57 | 1 |
| 8 | 950024027237 | 2024-03-01 10:52:57 | 1 |
| 9 | WDL-005943998-1 | 2024-03-01 13:58:43 | 2 |
| 10 | WDL-005943998-1 | 2024-03-01 13:58:46 | 2 |
| 11 | spL1ml82N4o | 2024-03-01 14:09:43 | 2 |
| 12 | WDL-005943998-1 | 2024-03-12 15:48:36 | 2 |
期望结果
|----|------------------|---------------------|-----------------------|
| id | Cardboard_Number | date_Time | ProductionLine_Number |
| 2 | WDL-005943998-1 | 2024-02-29 17:13:50 | 1 |
| 4 | spL1ml82N4o | 2024-02-29 17:13:54 | 1 |
| 5 | WDL-005943998-1 | 2024-03-01 09:44:42 | 1 |
| 6 | WDL-005943998-1 | 2024-03-01 10:34:57 | 1 |
| 9 | WDL-005943998-1 | 2024-03-01 13:58:43 | 2 |
| 10 | WDL-005943998-1 | 2024-03-01 13:58:46 | 2 |
| 11 | spL1ml82N4o | 2024-03-01 14:09:43 | 2 |
| 12 | WDL-005943998-1 | 2024-03-12 15:48:36 | 2 |
ProductionLine_Number=1 的组内按时间排序为 id 2,4,5,6,7,8,其中命中 spL1ml82N4o 的是 id=4。取 id=4 前后各 2 行,得到 id 2,4,5,6。
ProductionLine_Number=2 的组内按时间排序为 id 9,10,11,12,其中命中 spL1ml82N4o 的是 id=11。取 id=11 前后各 2 行,得到 id 9,10,11,12。
两组结果合并去重后为 2,4,5,6,9,10,11,12。注意 id=7、id=8 与命中行 id=4 的距离超过偏移量 2,因此不在结果中。
SQLazy 分步实现
**核心思路:**按分组字段和组内时间排序后,先用 compute 在每组内把命中目标值的行标记出来,再用相对位置区间语法 flag-2:2 取当前行前后各 2 行的窗口,判断窗口内是否包含命中行。若包含,则当前行属于结果范围。最后过滤并去重。
|------|--------|---------------------------------------------------------------------------------------------------|
| Name | Anchor | Statement |
| t1 | table1 | sort ProductionLine_Number, date_Time asc |
| t2 | t1 | compute (if (Cardboard_Number = "spL1ml82N4o" then 1)) , as flag; partition ProductionLine_Number |
| t3 | t2 | compute flag-2:2 , max , as in_range; partition ProductionLine_Number |
| t4 | t3 | filter in_range = 1 |
| t5 | t4 | distinct id |
下面逐一解释这些步骤。
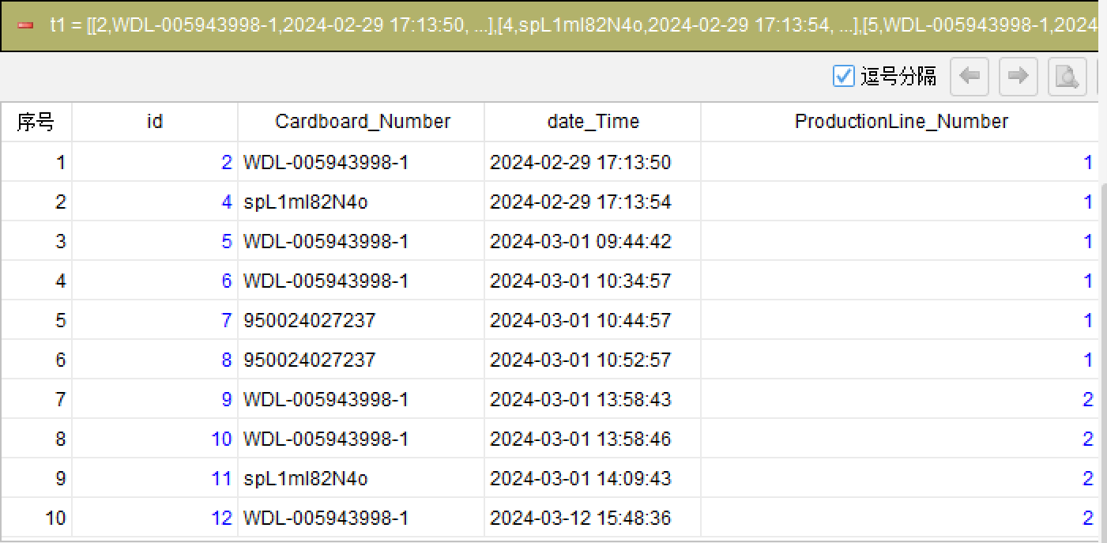
第 1 步:按分组字段和组内时间排序
sort ProductionLine_Number, date_Time asc
将数据按 ProductionLine_Number 分组,组内按 date_Time 升序排列,保证后续的相对位置计算以正确的时间顺序进行。
第 2 步:标记命中目标值的行
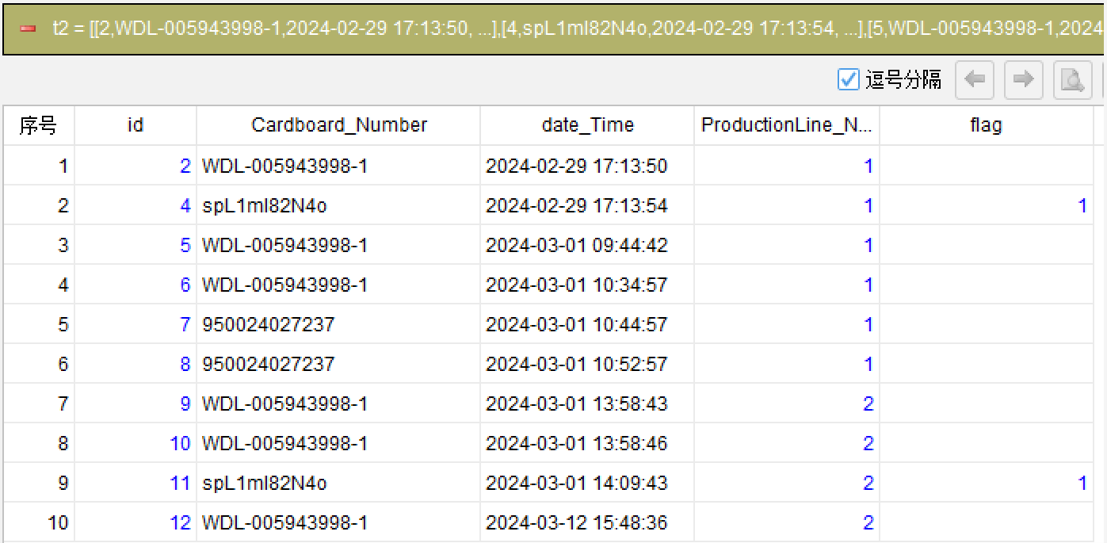
compute (if (Cardboard_Number = "spL1ml82N4o" then 1)) , as flag; partition ProductionLine_Number
在每个 ProductionLine_Number 分组内,将 Cardboard_Number 等于目标字符串 spL1ml82N4o 的行标记为 1,其余行为空。partition 限定标记计算在各组内独立进行。
第 3 步:用区间语法判断窗口内是否命中(核心)
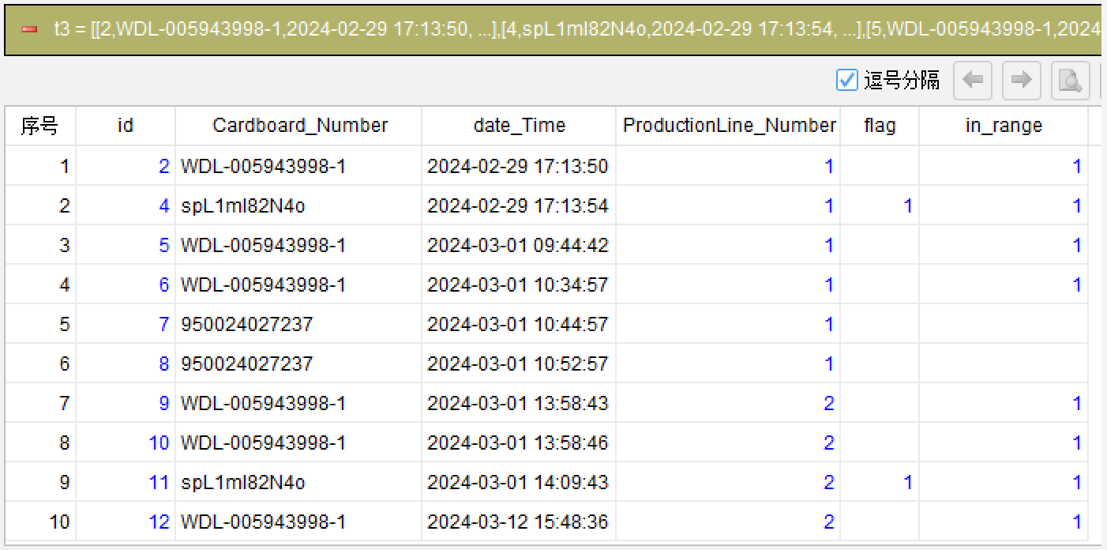
compute flag-2:2 , max , as in_range; partition ProductionLine_Number
这是最关键的一步,使用了 SQLazy 的相对位置区间语法。flag-2:2 表示取当前行之前 2 行到之后 2 行这个窗口内的 flag 值,再用 max 聚合:只要窗口内存在命中行(flag=1),当前行的 in_range 就为 1。这样,每条命中行前后偏移 2 行范围内的所有记录都被覆盖到。
第 4 步:过滤出范围内的记录
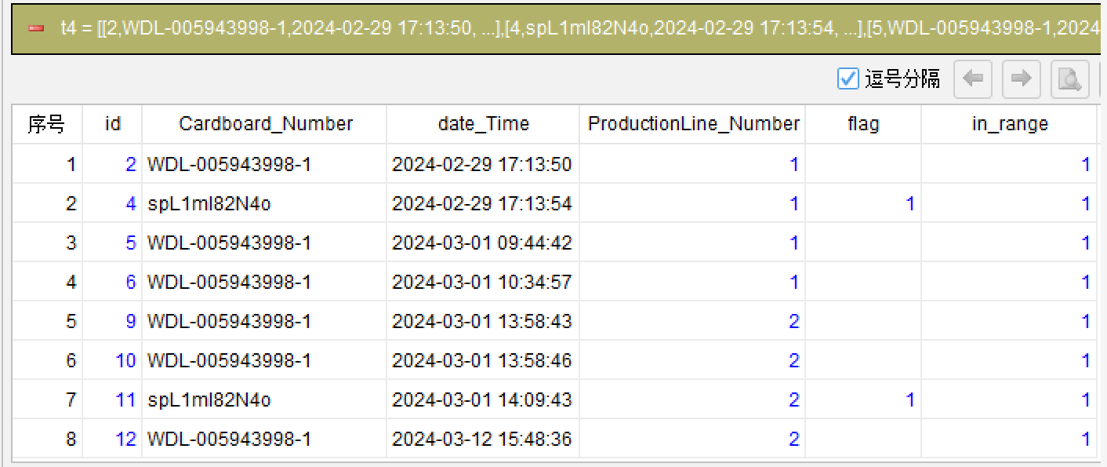
filter in_range = 1
只保留 in_range 为 1 的行,即落在某条命中行前后偏移范围内的记录。
第 5 步:去除重复记录
distinct id
当多条命中行的偏移范围重叠时,同一行可能被多次选中,用 distinct id 去重,输出最终结果。
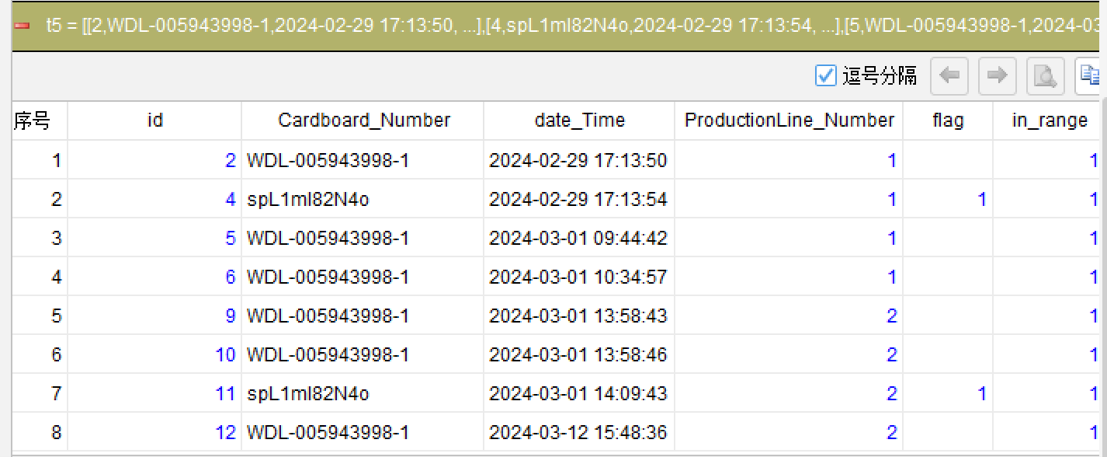
编译生成 SQL
确认上述步骤后,SQLazy 编译器自动生成原生 SQL(MySQL 语法):
WITH t2 AS (
    SELECT id, Cardboard_Number, date_Time, ProductionLine_Number
        , CASE
            WHEN Cardboard_Number = 'spL1ml82N4o' THEN 1
            ELSE NULL
        END AS flag
    FROM table1
),
t3 AS (
    SELECT id, Cardboard_Number, date_Time, ProductionLine_Number, flag
        , MAX(flag) OVER (PARTITION BY ProductionLine_Number ORDER BY CASE
            WHEN ProductionLine_Number IS NULL THEN 1
            ELSE 0
        END, ProductionLine_Number ASC, CASE
            WHEN date_Time IS NULL THEN 1
            ELSE 0
        END, date_Time ASC ROWS BETWEEN 2 PRECEDING AND 2 FOLLOWING) AS in_range
    FROM t2
),
t4 AS (
    SELECT id, Cardboard_Number, date_Time, ProductionLine_Number, flag
        , in_range
    FROM t3
    WHERE in_range = 1
)
SELECT id, Cardboard_Number, date_Time, ProductionLine_Number, flag
    , in_range
FROM t4
GROUP BY id
SQLazy 让你用业务语言描述逻辑,而不是用 SQL 语法写嵌套查询。这个在分组内搜索指定偏移量相邻记录的例子,核心亮点是相对位置区间语法:flag-2:2 直接用下标区间表达前后各 2 行的窗口,对应 SQL 中冗长的 ROWS BETWEEN 2 PRECEDING AND 2 FOLLOWING。配合 compute 的 max 聚合,一句代码就完成了窗口中是否存在命中行的判断。partition 子句让所有计算在分组内独立进行,天然符合按组处理的需求;分步计算让排序、标记、区间判断、过滤、去重每一步都可独立验证中间结果,降低了复杂逻辑的出错概率。