第一章 机器学习概述
人工智能三大概念
学习目标:
1.知道AL,ML,DL是什么?
2.了解AL、ML、DL之间的关系
3.知道自动学习 和规则编程的区别
【知道】人工智能
-
Artificial Intelligence 人工智能
-
AI is the field that studies the synthesis and analysis of computational agents that act intelligently
-
AI is to use computers to analog and instead of human brain
-
释义 - 仿智; 像人一样机器智能的综合与分析;机器模拟人类
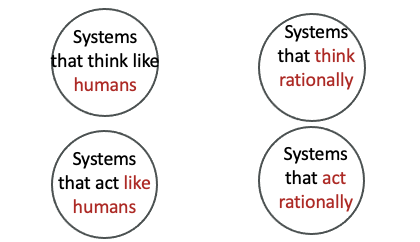
-
释义:是一个系统,像人那样思考 像人那样理性思考
-
释义:是一个系统,像人那样活动 像人那样合理系统
【知道】机器学习
-
Machine Learning 释义:机器学习
-
Field of study that gives computers the ability to learn without being explicitly programmed
-
释义:让机器自动学习,而不是基于规则的编程(不依赖特定规则编程)
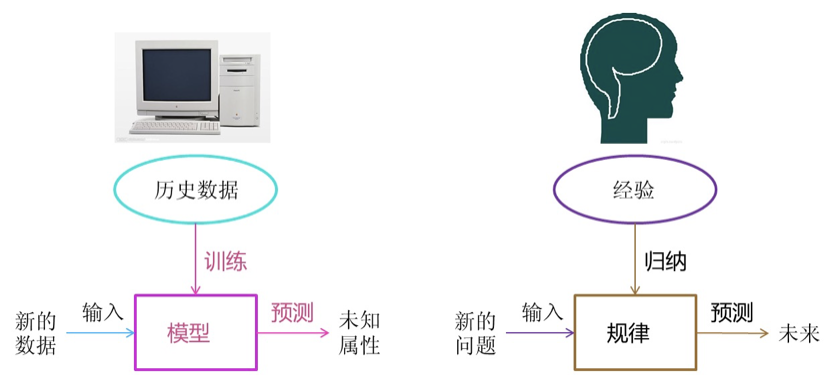
-
人类识别车:根据车的特征归纳出车的规律;来了一个新的图片,判断预测是否是车
-
机器学习识别车: 从数据中获取规律;来了一个新的数据,产生一个新的预测
【知道】深度学习
深度学习(DL, Deep Learning) : ,也叫深度神经网络,大脑仿生,设计一层一层的神经元 模拟万事万物
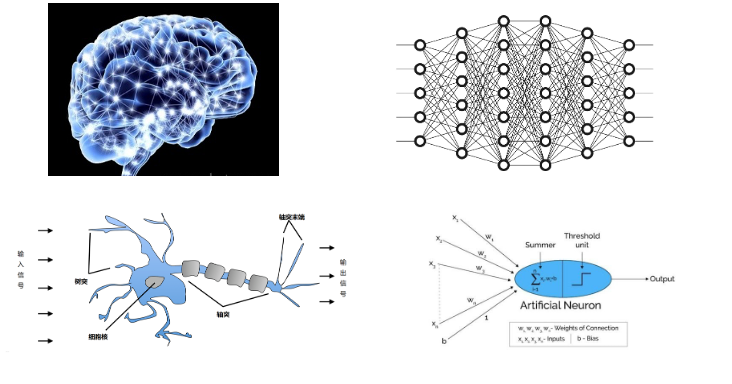
【知道】三者之间的关系
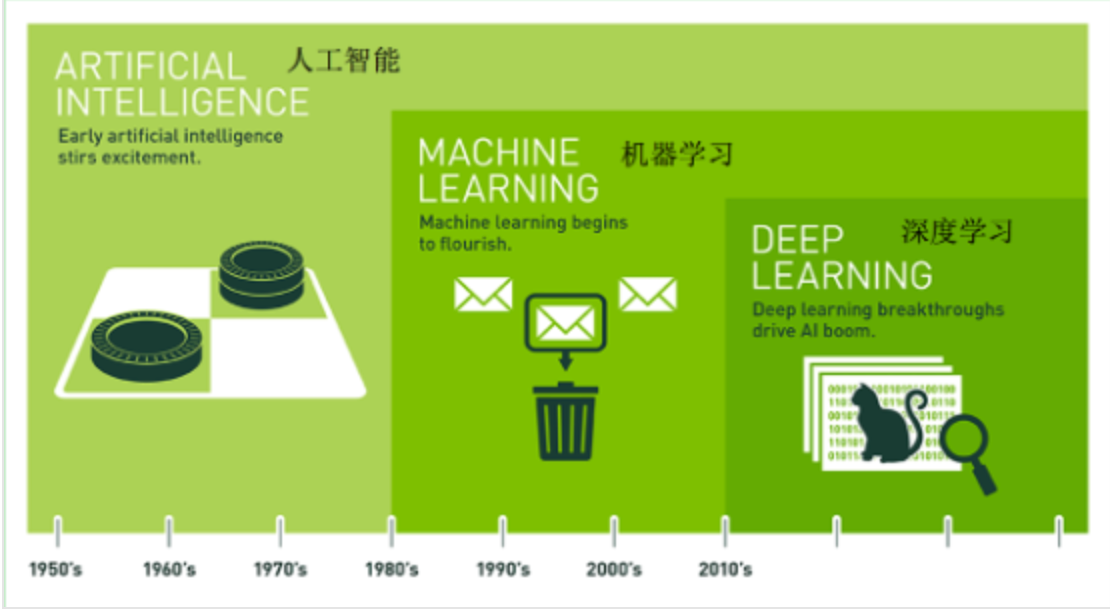
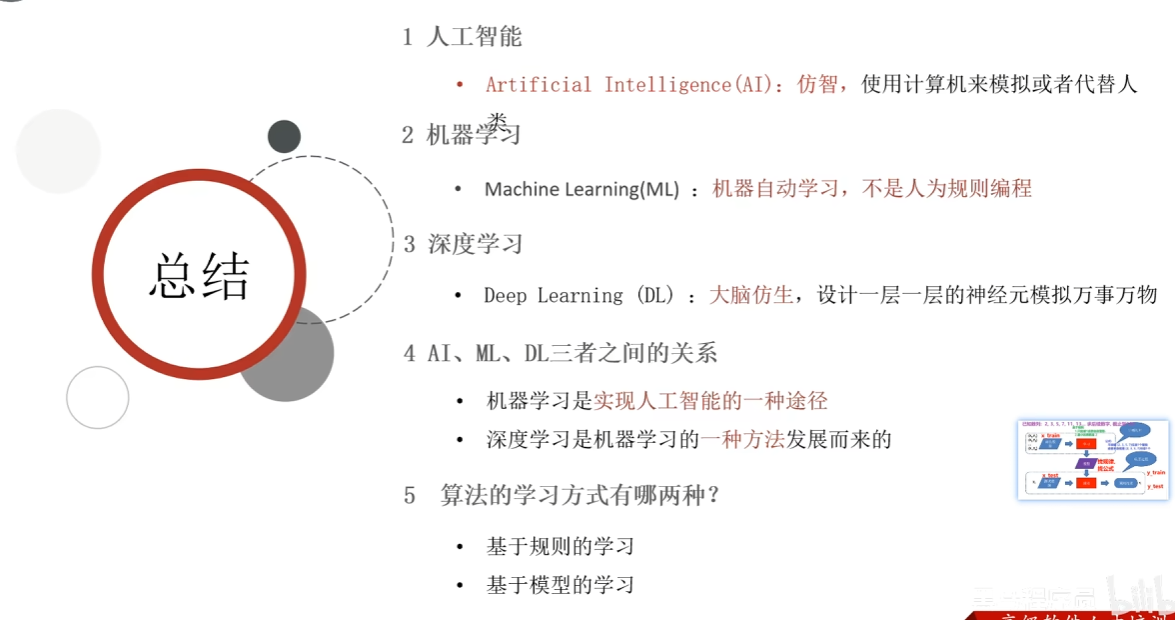
机器学习是实现人工智能的一种途径
深度学习是机器学习的一种方法
【了解】学习方式
【了解】基于规则的学习
•基于规则的预测 : 程序员根据经验利用手工的if-else方式进行预测
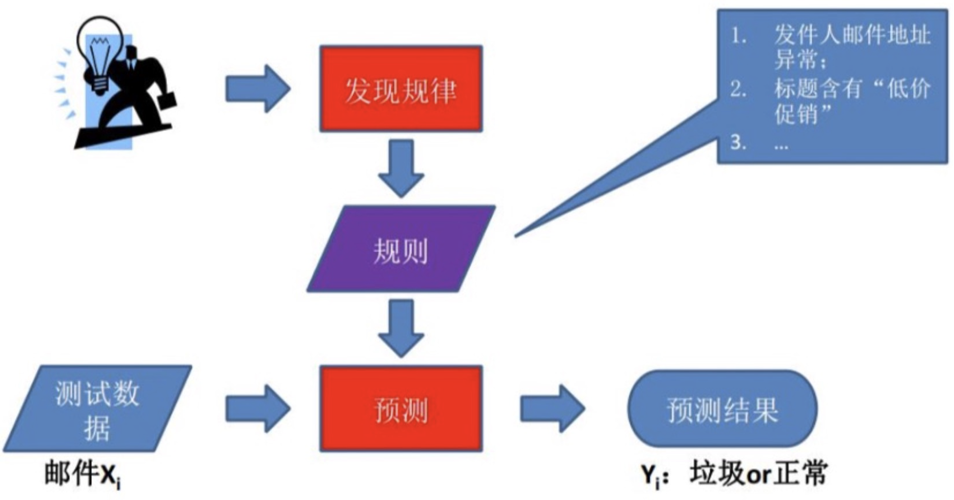
但是有好多问题, 无法明确的写下规则,此时我们无法使用规则学习的方式来解决这一类问题,比如:
- 图像和语音识别
- 自然语言处理
举例:我们尝试通过基于规则的学习方式让计算机识别大象,下图中的大象千差万别, 有的是实物,有的是雕塑,有的是画,我们无法通过创建一套规则的方式让计算机准确识别下面每一头大象, 此时我们需要一种新的方法来解决这类问题。
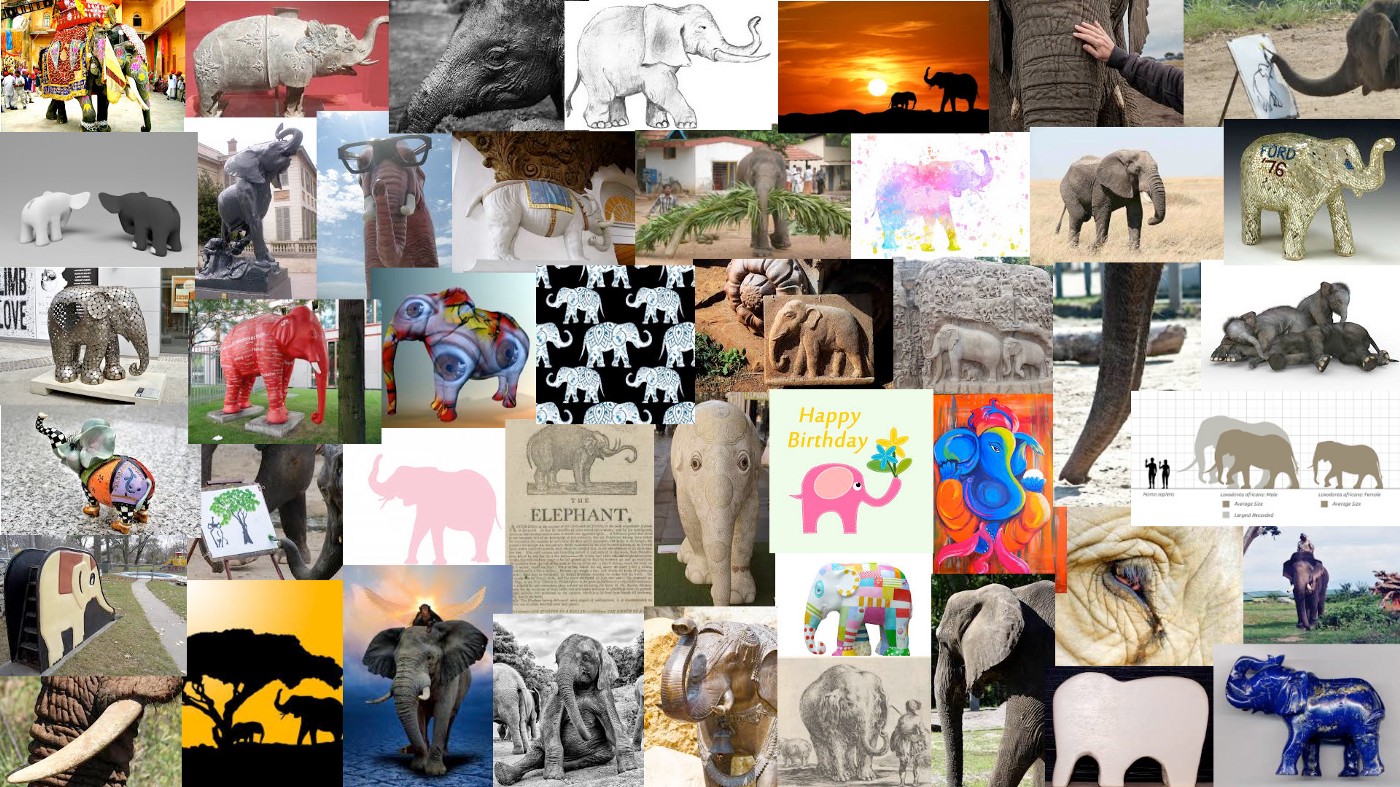
同样是判断大象:
基于规则:根据自己的判断,然后写ifelse
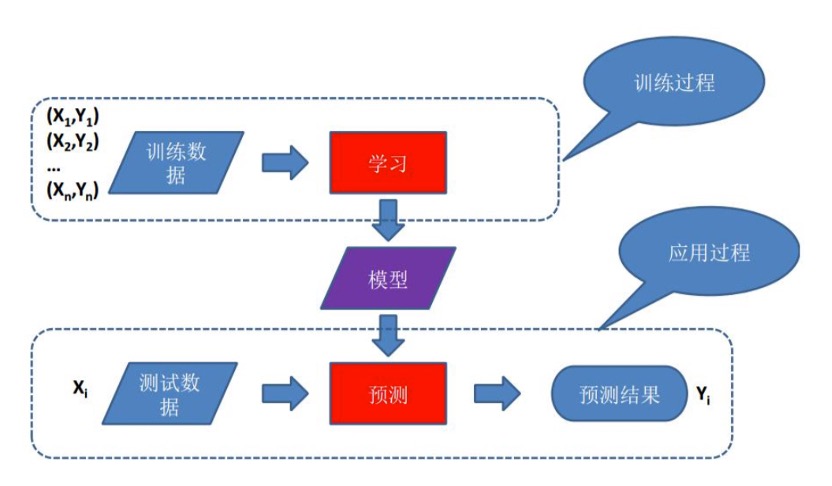
基于模型的学习:让机器自己学习,形成一个判断的模型
【了解】基于模型的学习
基于模型的学习就是通过编写机器学习算法,让机器自己学习从历史数据中获得经验、训练模型:
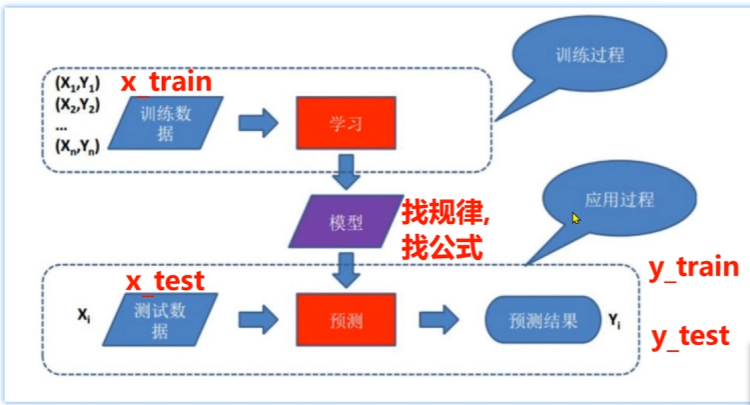
案例巩固
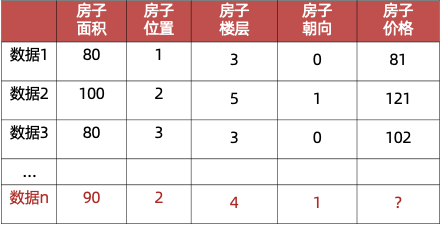
比如房价预测,数据如下图
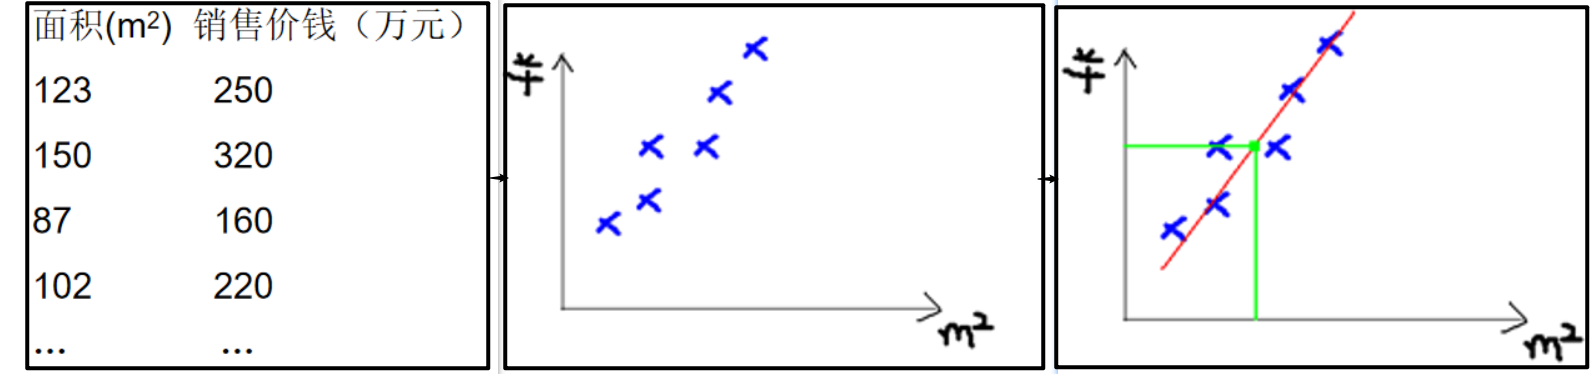
- 我们可以使用一条直线尽可能多的通过这些点,不通过的点尽量分布在直线的两侧,利用这条直线所表示的线性关系,我们就可以预测房价。
- 直线可以写成y=ax+b,若a,b已知,我们就能够预测房价。机器学习中a,b称为 参数 ,y=ax+b称为 模型 。通常a,b未知,是我们需要求解的量。
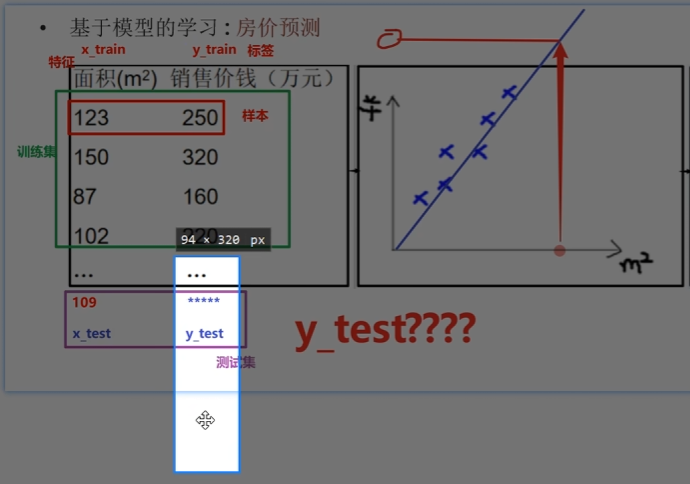
一般都是算y_test
人工智能应用领域和发展史
(了解即可)
学习目标:
1.了解机器学习的应用领域
2.了解机器学习的发展史
【了解】应用领域
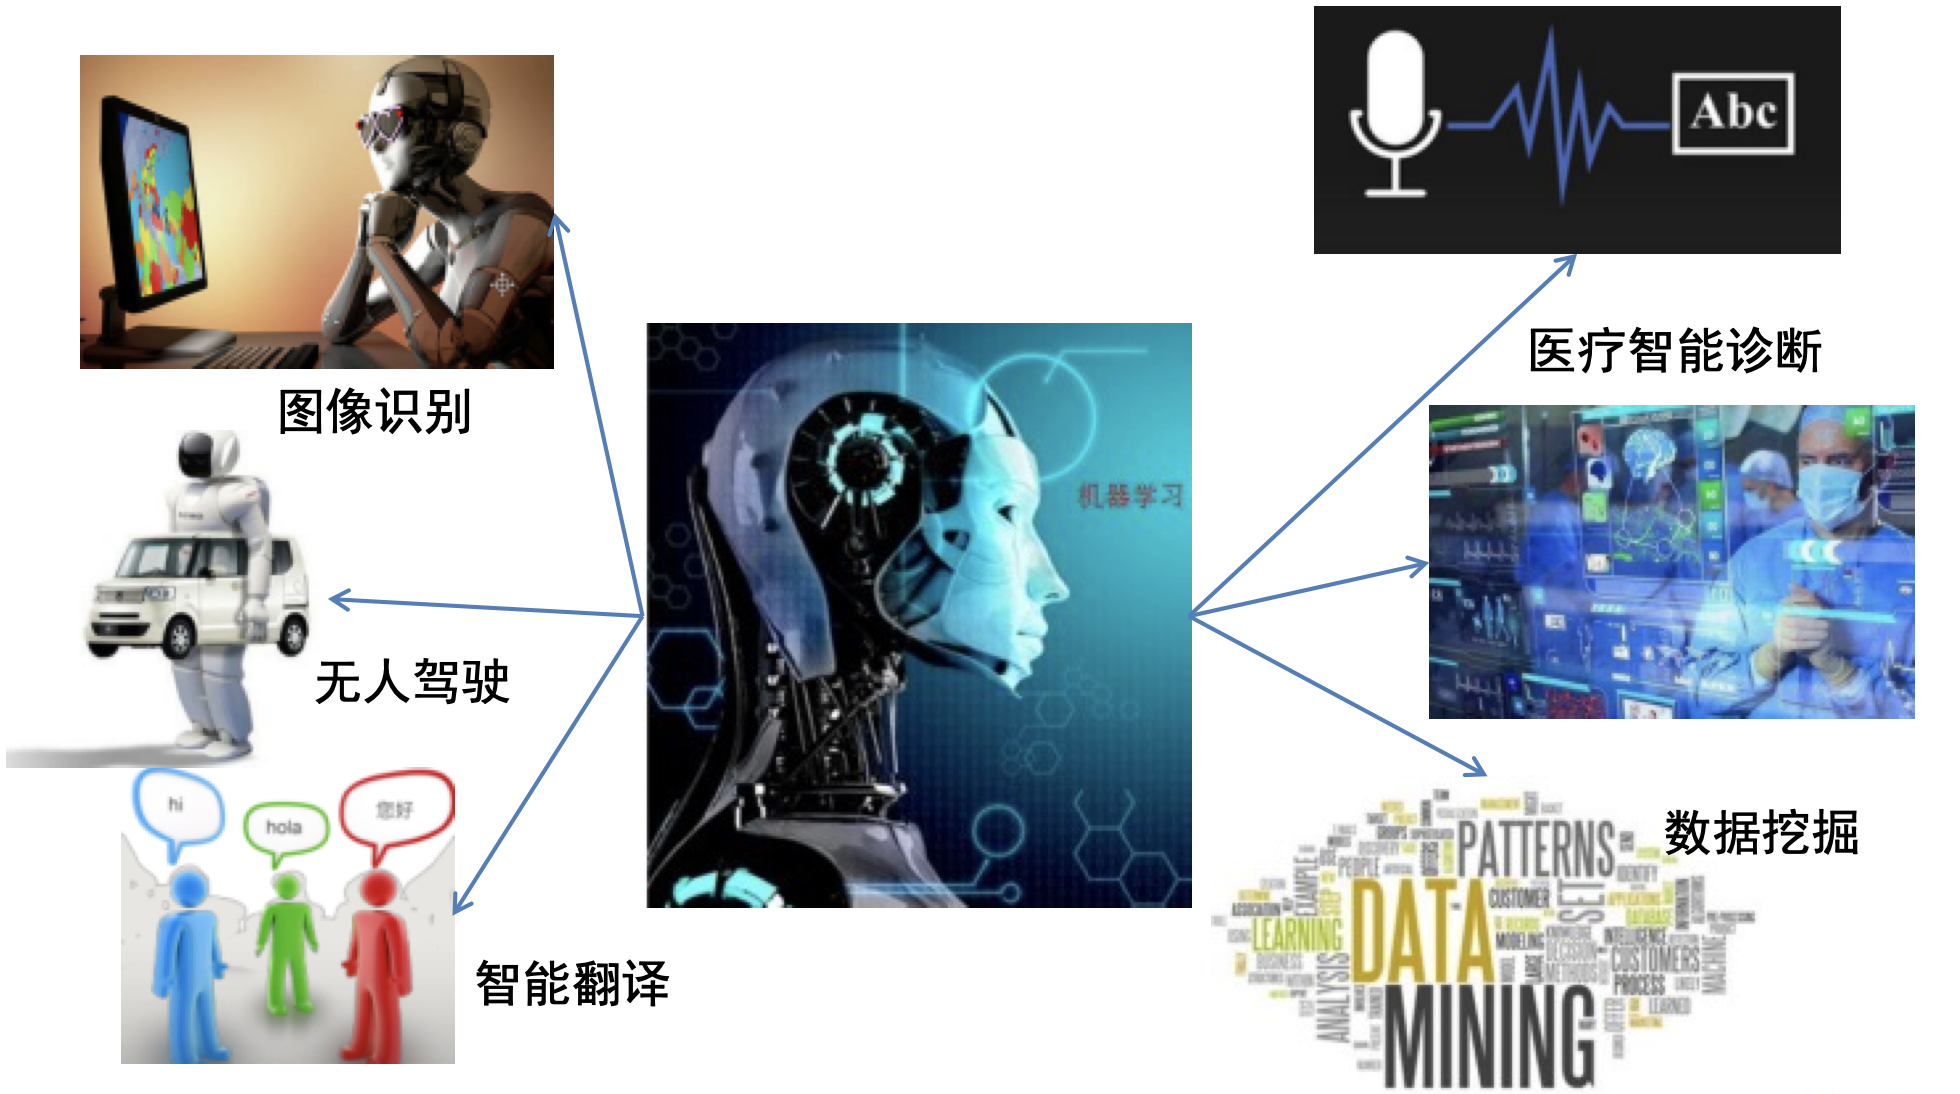
用户分析:社交网络、影评、商品评论
搜素引擎:网页、图片、规频、新闻、学术、地图
信息推荐:新闻、商品、游戏、书籍
图片识别:人像、用品、劢物、交通工具
机器翻译、摘要生成 ... ...
生物信息学习 ... ... 多模态 AR/VR
【了解】发展史
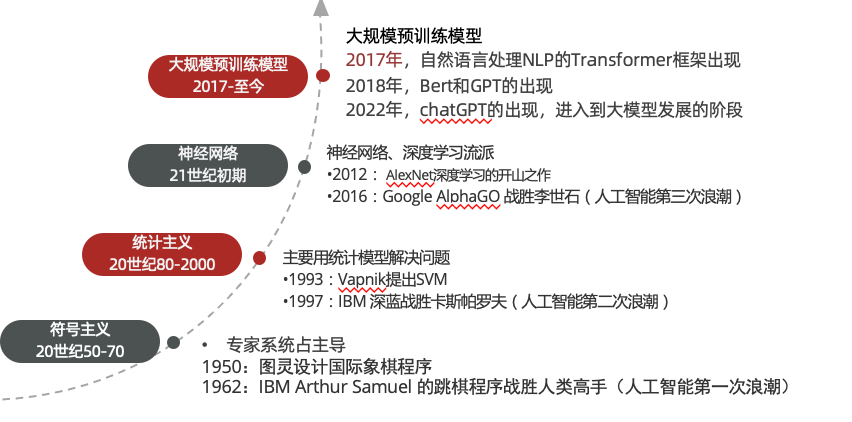
956年夏季,以麦卡赛、明斯基、罗切斯特和申农等为首的一批有远见卓识的年轻科学家在一起聚会,共同研究和探讨用机器模拟智能的一系列有关问题,并首次提出了"人工智能"这一术语,它标志着"人工智能"这门新兴学科的正式诞生。
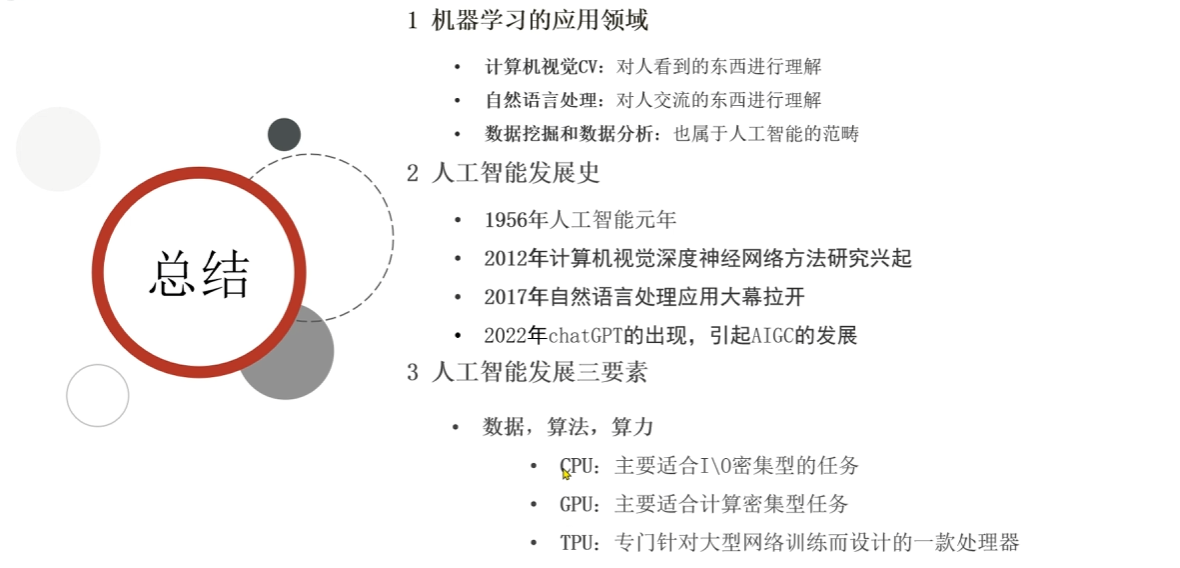
1956 年被认为是人工智能元年
1950-1970
符号主义流派:专家系统占主导地位
1950:图灵设计国际象棋程序
1962:IBM Arthur Samuel 的跳棋程序战胜人类高手(人工智能第一次浪潮)
1980-2000
统计主义流派:主要用统计模型解决问题
1993:Vapnik提出SVM
1997:IBM 深蓝战胜卡斯帕罗夫(人工智能第二次浪潮)
2010-2017
神经网络、深度学习流派
2012:AlexNet深度学习的开山之作
2016:Google AlphaGO 战胜李世石(人工智能第三次浪潮)
2017-至今
大规模预训练模型
2017年,自然语言处理NLP的Transformer框架出现
2018年,Bert和GPT的出现
2022年,chatGPT的出现,进入到大规模模型AIGC发展的阶段
【知道】机器学习发展三要素
- 数据、算法、算力三要素相互作用,是AI发展的基石
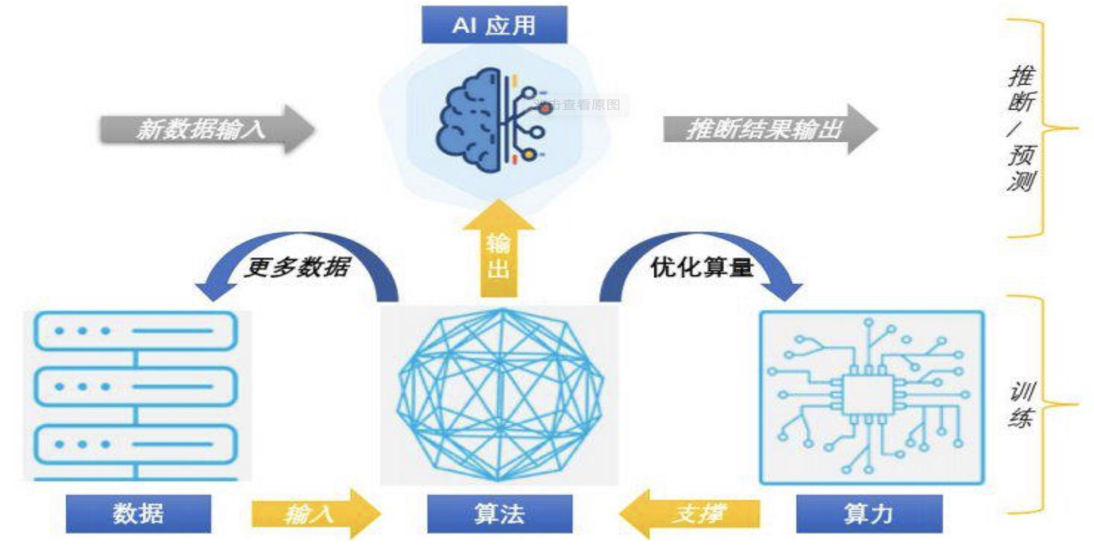
- CPU:负责调度任务、计算任务等;主要适合I\O密集型的任务
- GPU:更加适合矩阵运算;主要适合计算密集型任务
- TPU:Tensor,专门针对神经网络训练设计一款处理器
常见术语
这部分是要被背和要记的。
学习目标:
1.知道样本是什么?
2.知道特征是什么?
3.知道标签/目标值是什么?
4.理解数据集划分的方法
【掌握】样本,特征,标签/目标值
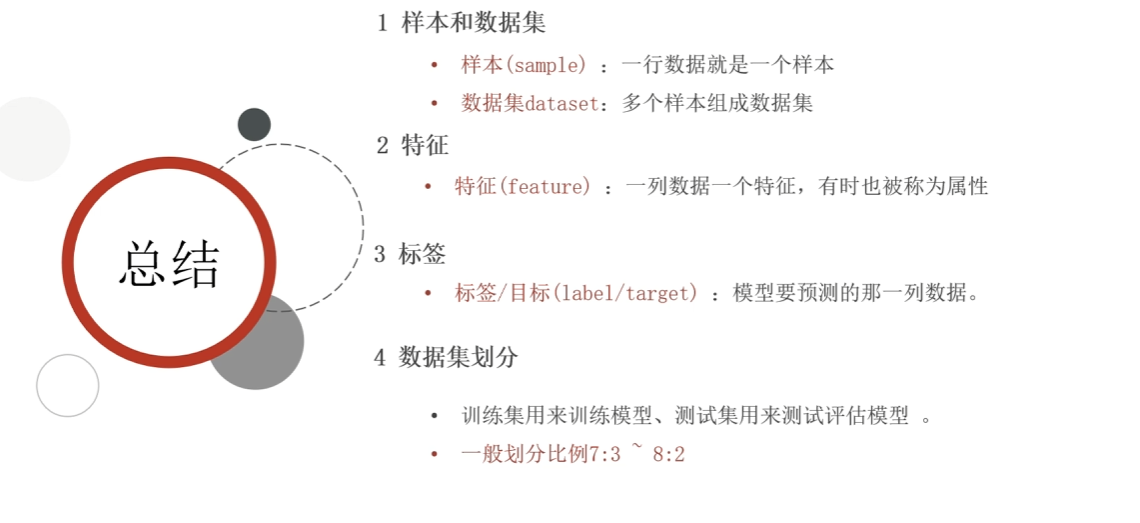
样本(sample) :一行数据就是一个样本;多个样本组成数据集;有时一条样本被叫成一条记录
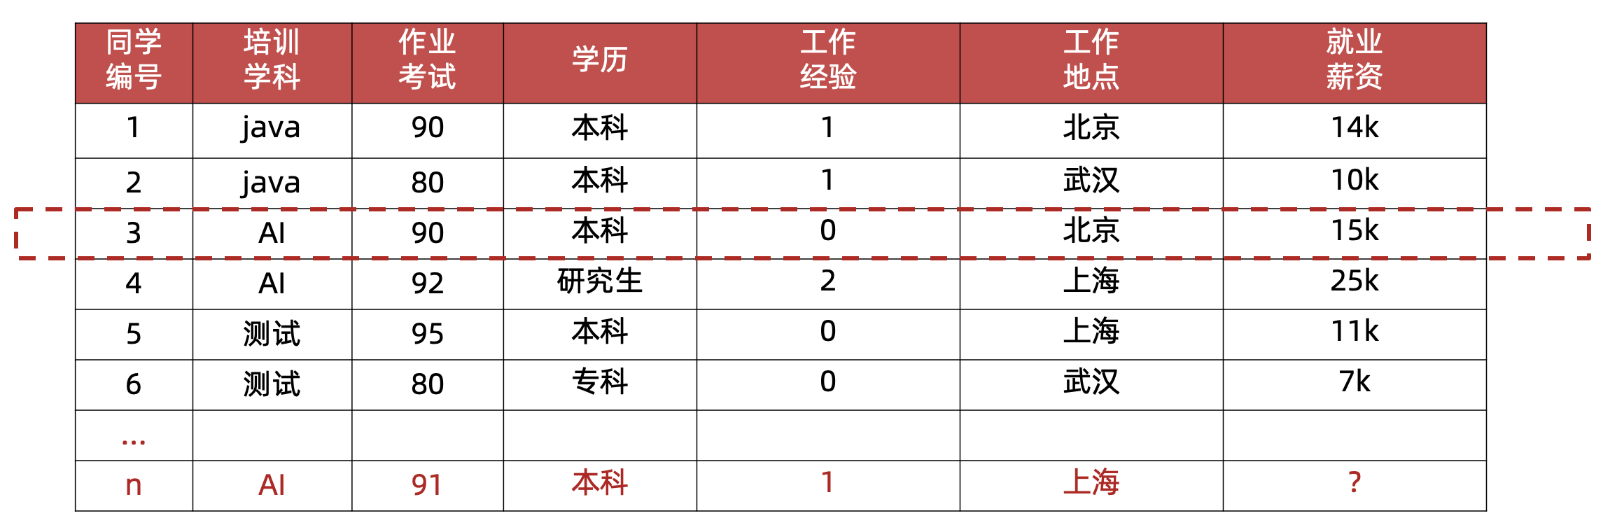
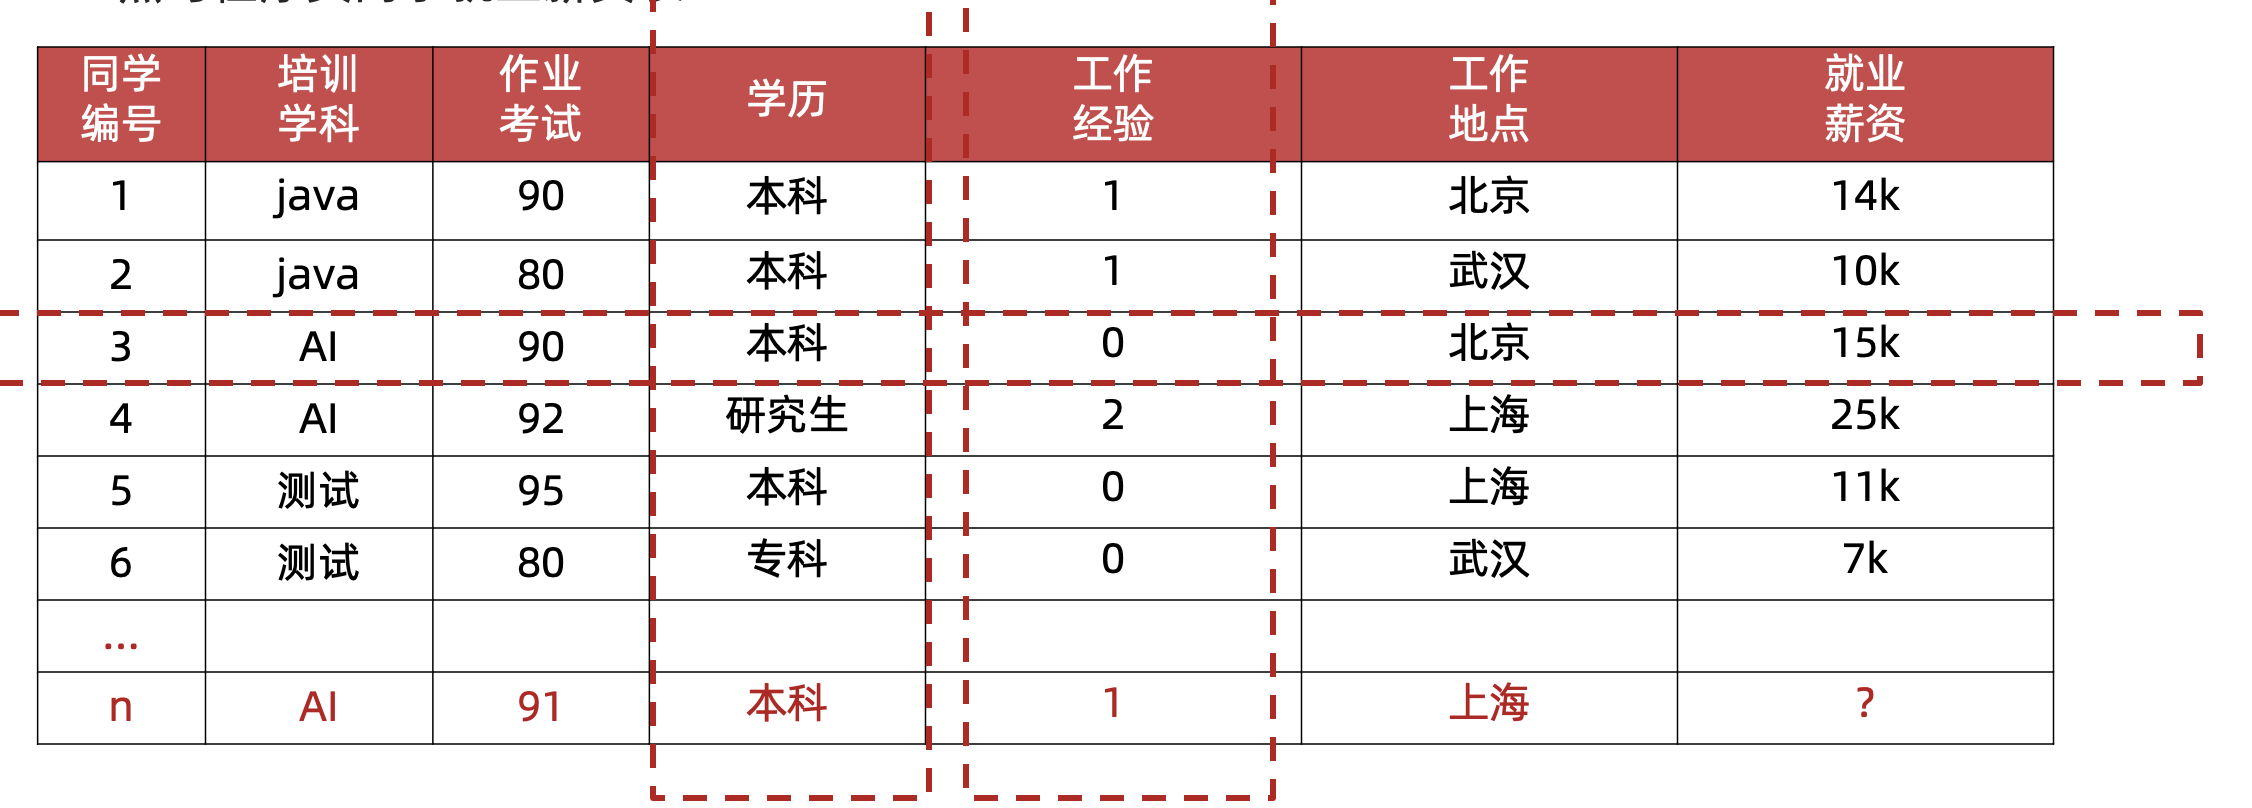
特征(feature) :一列数据一个特征,有时也被称为属性
标签/目标(label/target) :模型要预测的那一列数据。本场景是就业薪资
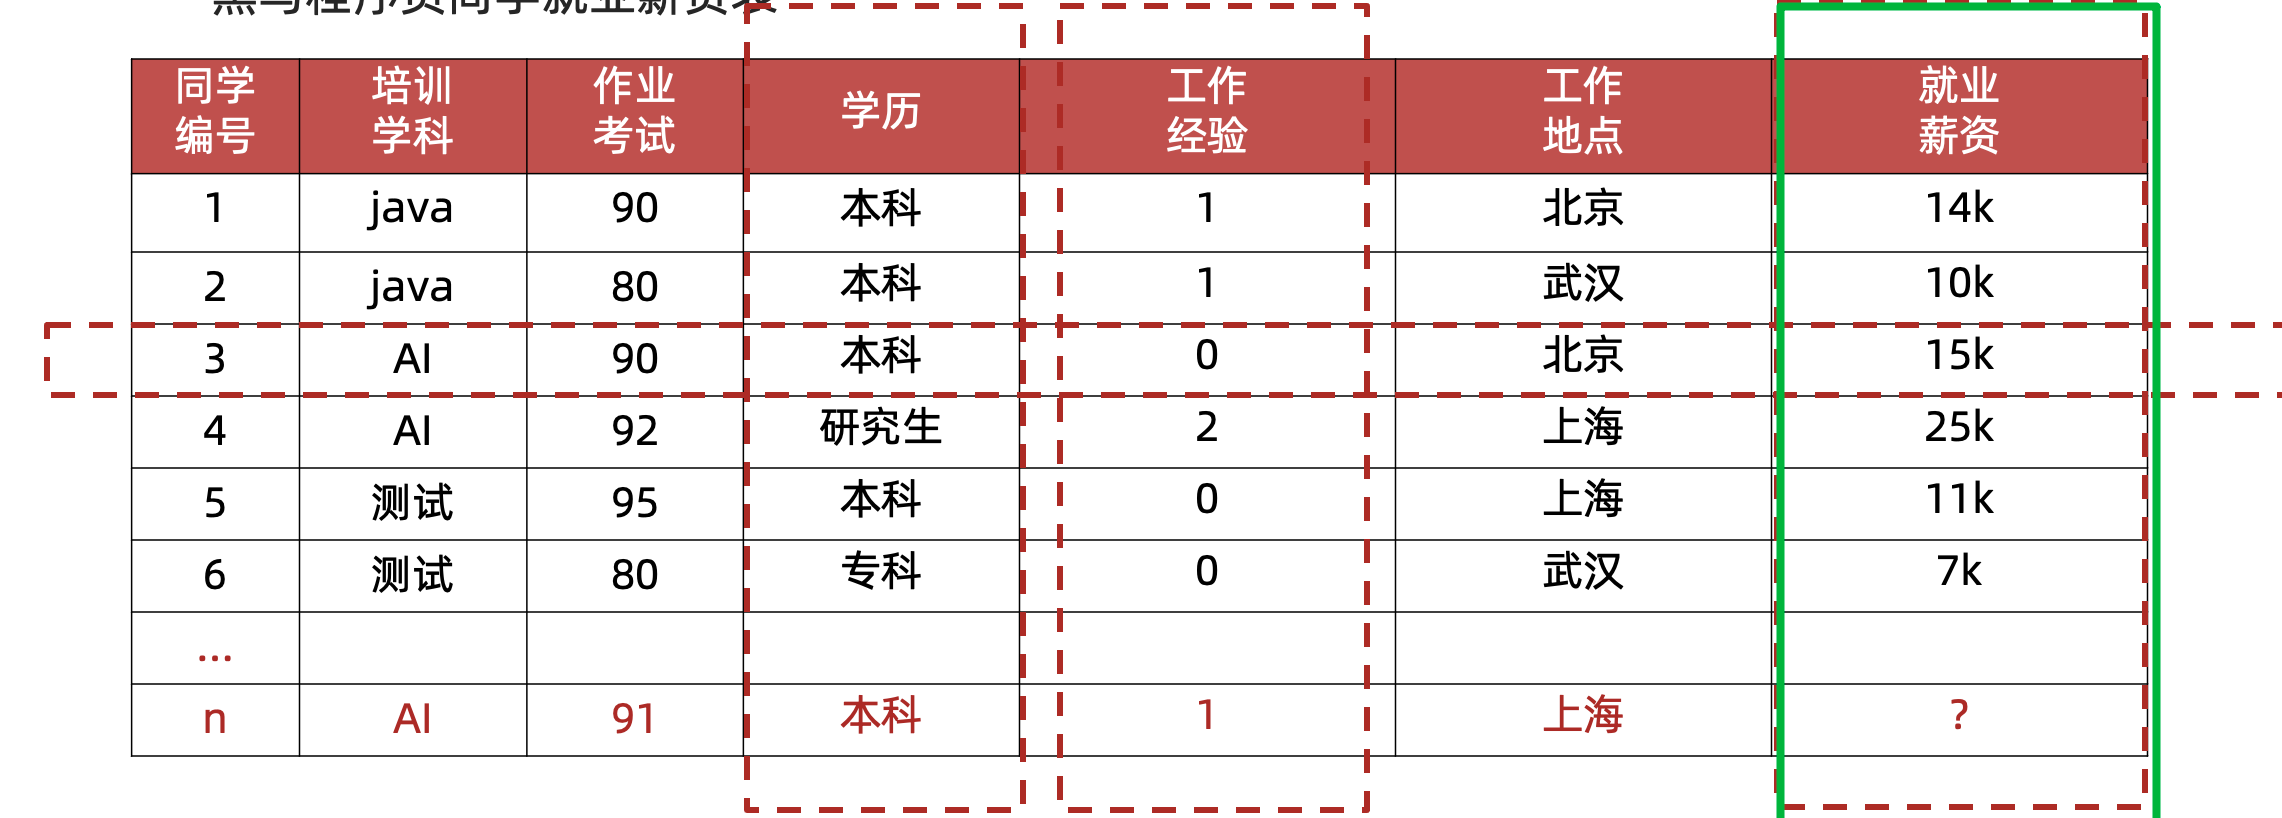
就业薪资 与 培训学科、作业考试、学历、工作经验、工作地点 5个特征有关系
特征如何理解(重点):特征是从数据中抽取出来的,对结果预测有用的信息 eg:房价预测、车图片识别
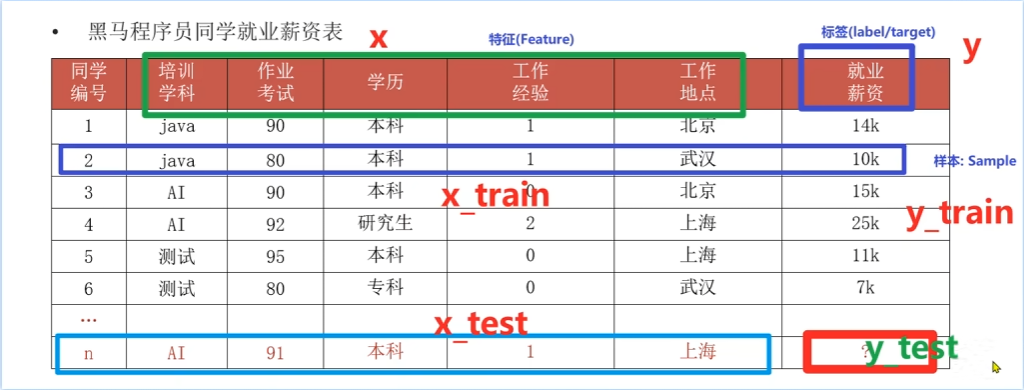
x、y:特征 还是 标签
train、test:训练 还是 测试
eg:
x_train的意思就是:训练集的特征
【掌握】数据集划分
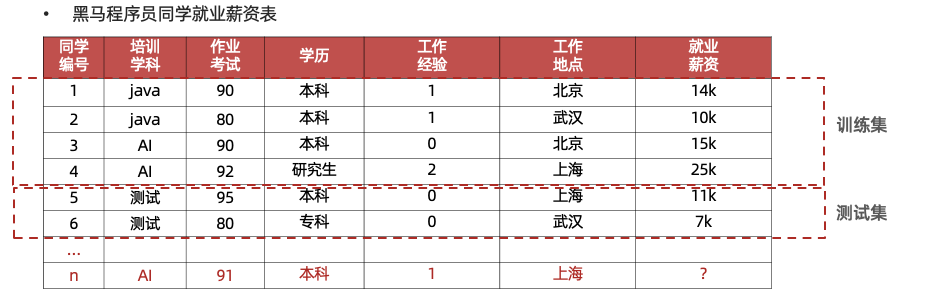
数据集可划分两部分:训练集、测试集 比例:8 : 2,7 : 3
训练集(training set) :用来训练模型(model)的数据集
测试集(testing set):用来测试模型的数据集
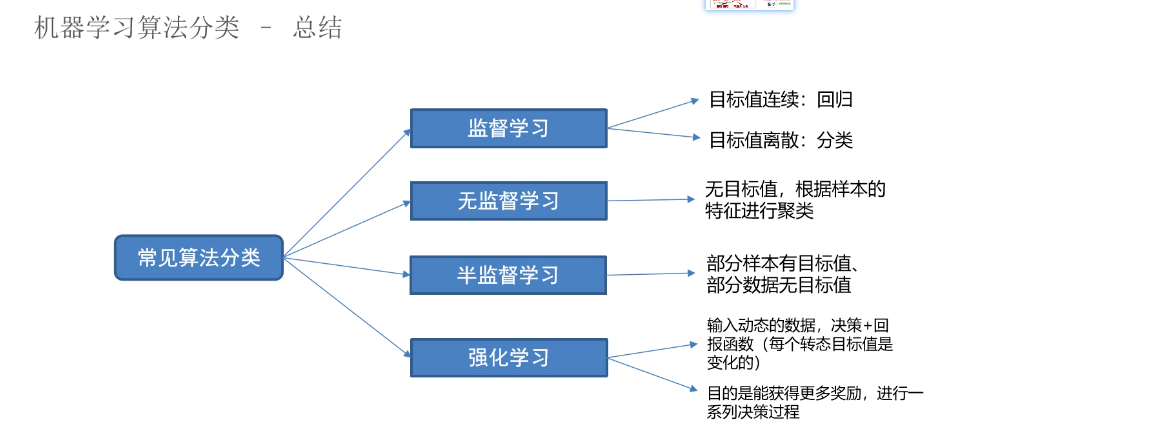
算法分类
学习目标
1.知道有监督学习是什么?
2.知道无监督学习是什么?
3.知道半监督学习是什么?
4.了解强化学习是什么?
5.能掌握监督学习、无监督学习的数学表示
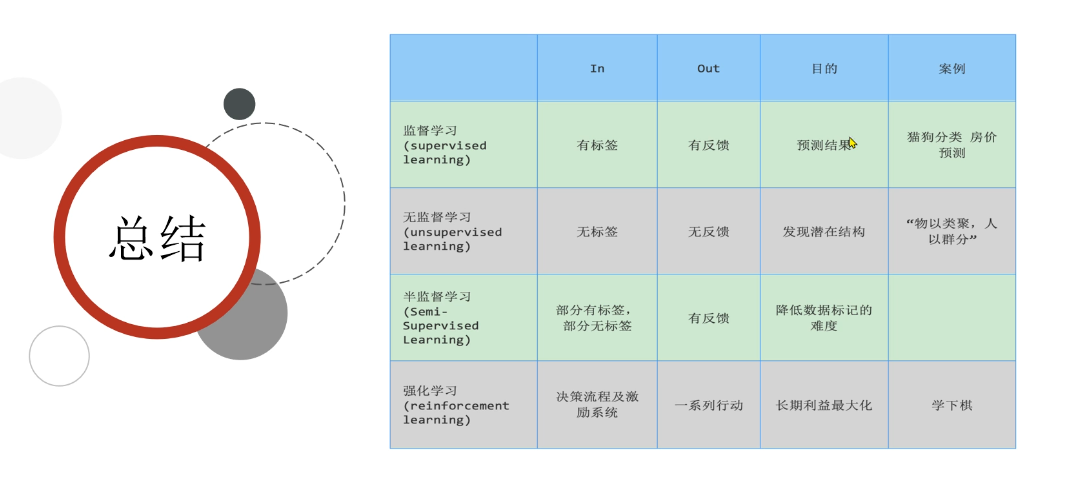
【掌握】有监督学习
-
定义:输入数据是由输入特征值和目标值所组成,即输入的训练数据有标签的
-
数据集:需要人工标注数据
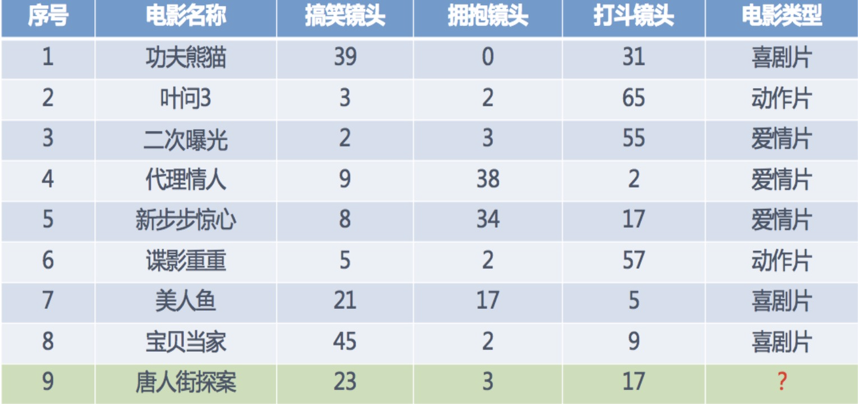
【掌握】分类
-
目标值(标签值)是不连续的
-
分类种类:二分类、多分类任务、
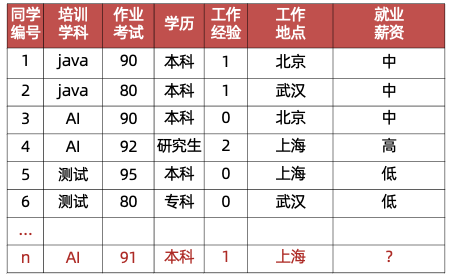
【掌握】回归
目标值(标签值)是连续的
【熟悉】无监督学习
-
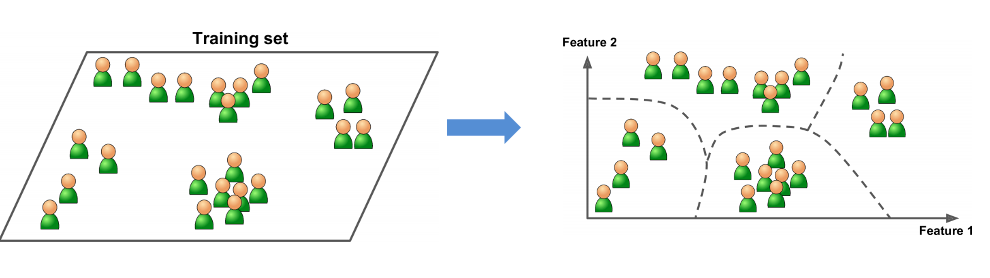
定义:输入数据没有被标记,即样本数据类别未知,没有标签,根据样本间的相似性,对样本集聚类,以发现事物内部 结构及相互关系。
-
数据集:不需要标注数据
-
无监督学习特点:
1 训练数据无标签
2 根据样本间的相似性对样本集进行聚类,发现事物内部结构及相互关系
📚
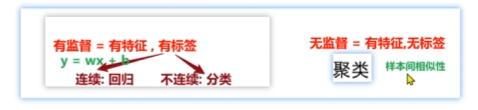
- 有监督:有特征,有标签
- 标签连续:回归问题
- 标签不连续:分类问题
- 无监督:有特征,无标签
- 聚类问题
【了解】半监督学习
工作原理:
1 让专家标注少量数据,利用已经标记的数据(也就
是带有类标签)训练出一个模型
2 再利用该模型去套用未标记的数据
3 通过询问领域专家分类结果与模型分类结果做对比,
从而对模型做进一步改善和提高
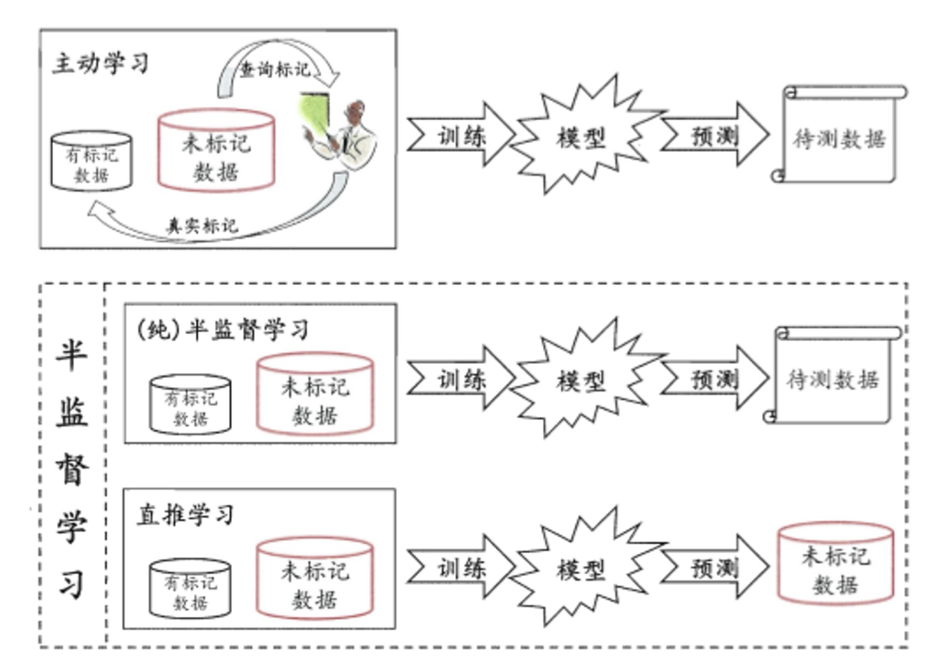
半监督学习方式可大幅降低标记成本
总之就是人工标注成本高,所以用一部分训练,剩下的标注由这个模型生成,然后再置信度高的加入训练集,置信度低的直接丢弃,节省成本。
【了解】强化学习
1 强化学习(Reinforcement Learning):机器学习的一个重要分支
2 应用场景:里程碑AlphaGo围棋、各类游戏、对抗比赛、无人驾驶场景
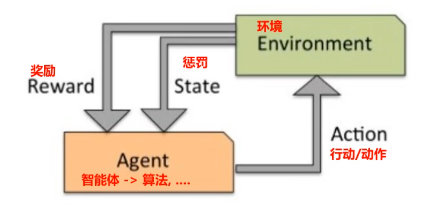
3 基本原理:基本原理:通过构建四个要素:agent,环境状态,行动,奖励,
agent根据环境状态进行行动获得最多的累计奖励。
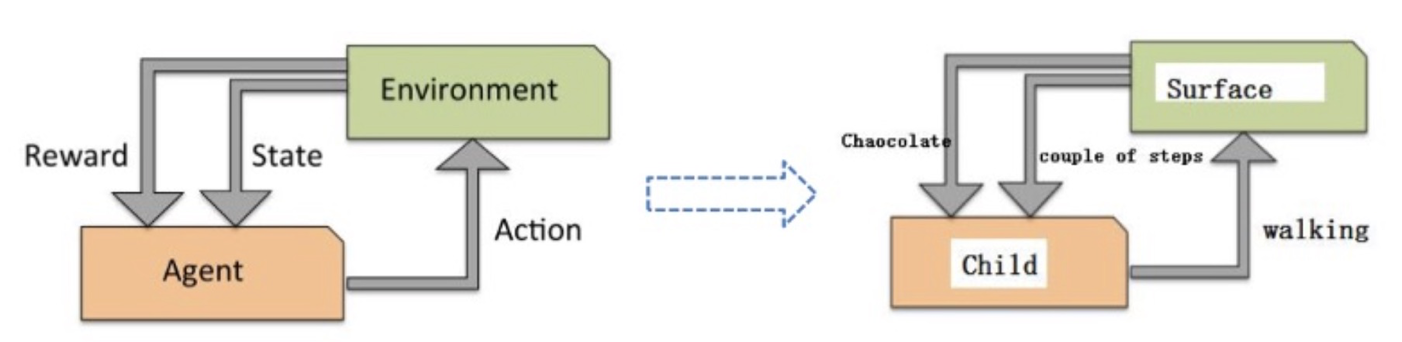
小孩子学走路:
(1) 小孩就是 agent ,他试图通过采取行 (即行走)来操纵环境(地面),
(2) 并且从一个状态转变到另一个状态(即他走的每一步),
(3) 当他完成任务的子任务(即走了几步)时,孩子得到奖励(给巧克力吃),
(4) 并且当他不能走路时,就不会给巧克力。
总之就是是智能体在环境中通过试错来学习,做得好给奖励、做得差给惩罚
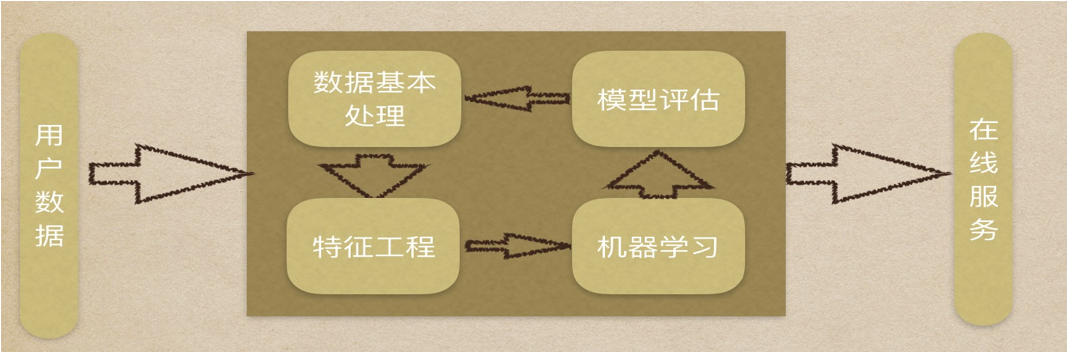
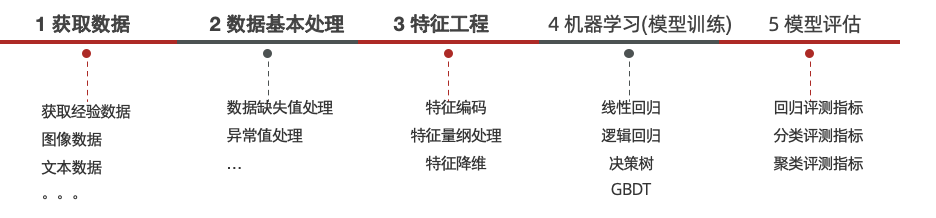
【知道】机器学习的建模流程
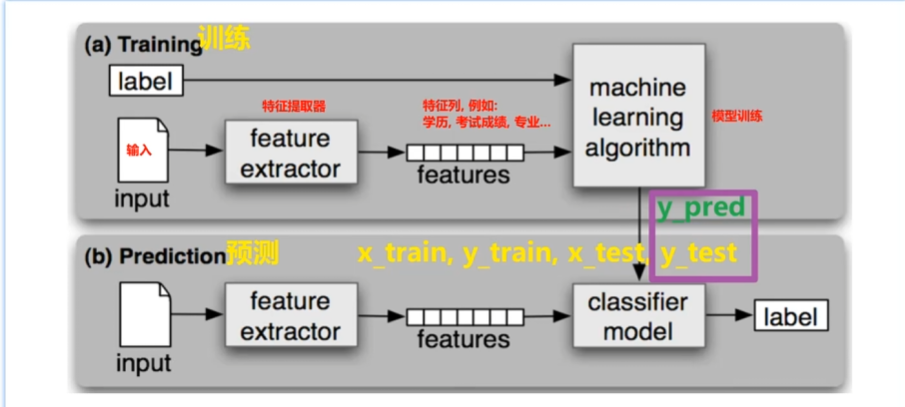
有监督学习模型训练和模型预测
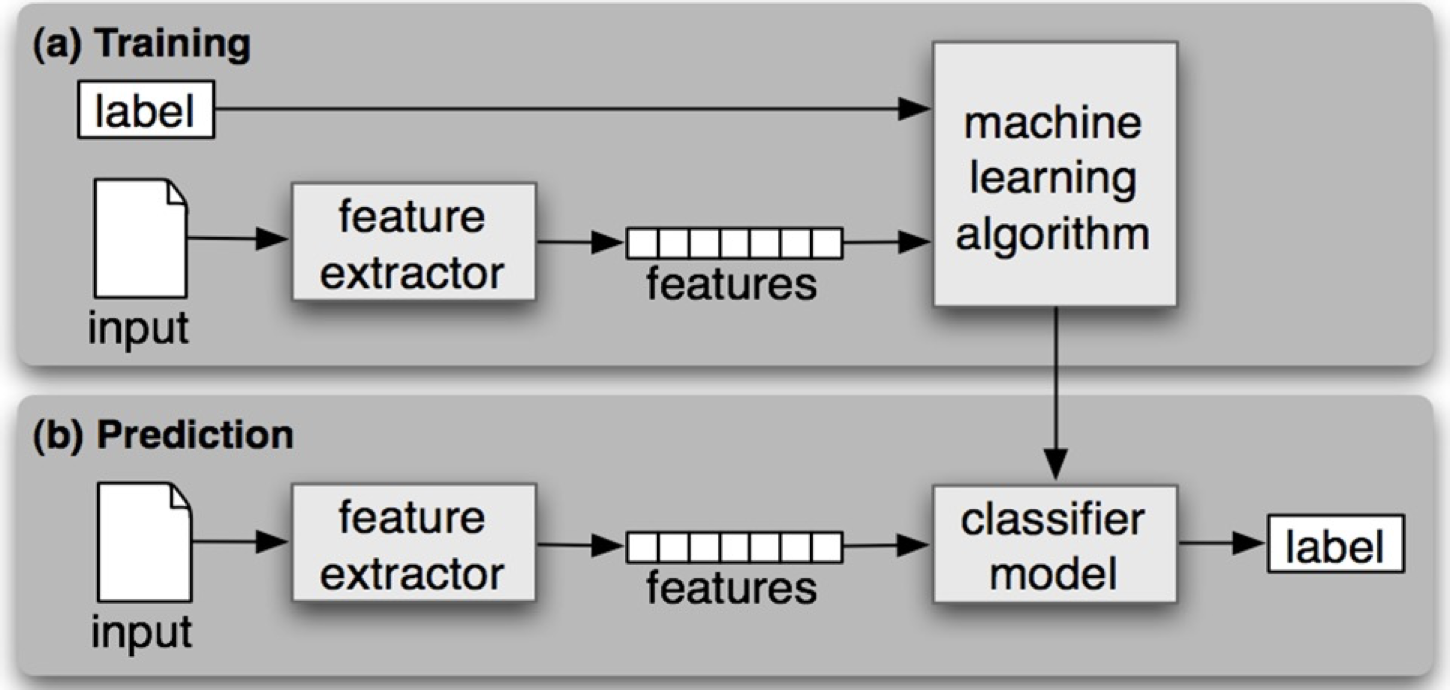
可以拿预测值和测试值对比,评估模型效果
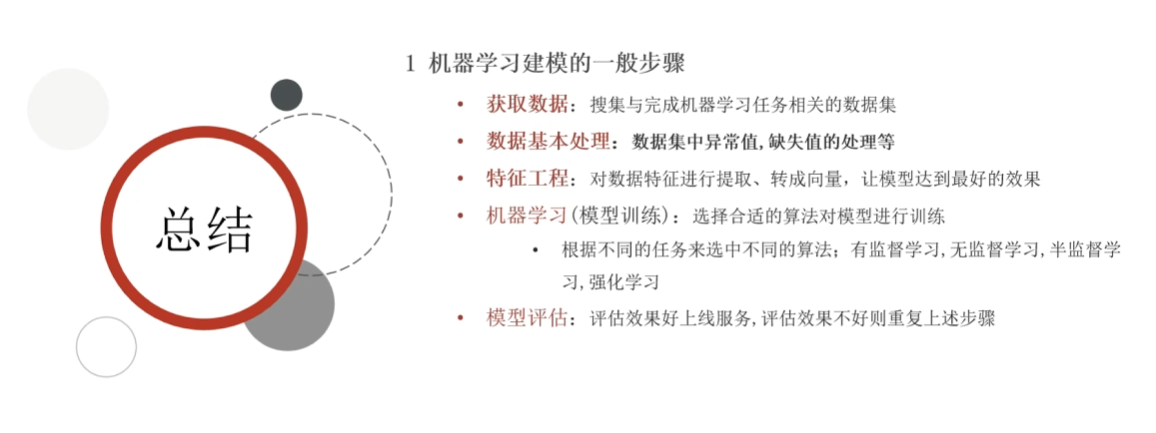
特征工程
学习目标:
1.知道特征工程是什么?
2.理解特征提取的作用
3.理解特征预处理的作用
4.了解特征降维、特征选择、特征组合
【知道】特征工程
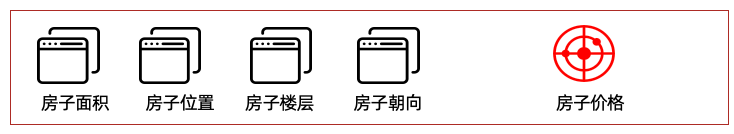
从数据集角度来看: 一列一列的数据为特征。
从模型训练角度来看: 对预测结果有用的属性为特征
特征工程是:利用专业背景知识和技巧处理数据,让机器学习算法效果最好。这个过程就是特征工程
Coming up with features is difficult, time-consuming, requires expert knowledge. "Applied machine learning" is basically feature engineering. "
释义:特征工程是困难、耗时、需要专业知识。应用机器学习基础就是特征工程
【理解】数据和特征决定了机器学习的上限,而模型和算法只是逼近这个上限而已。
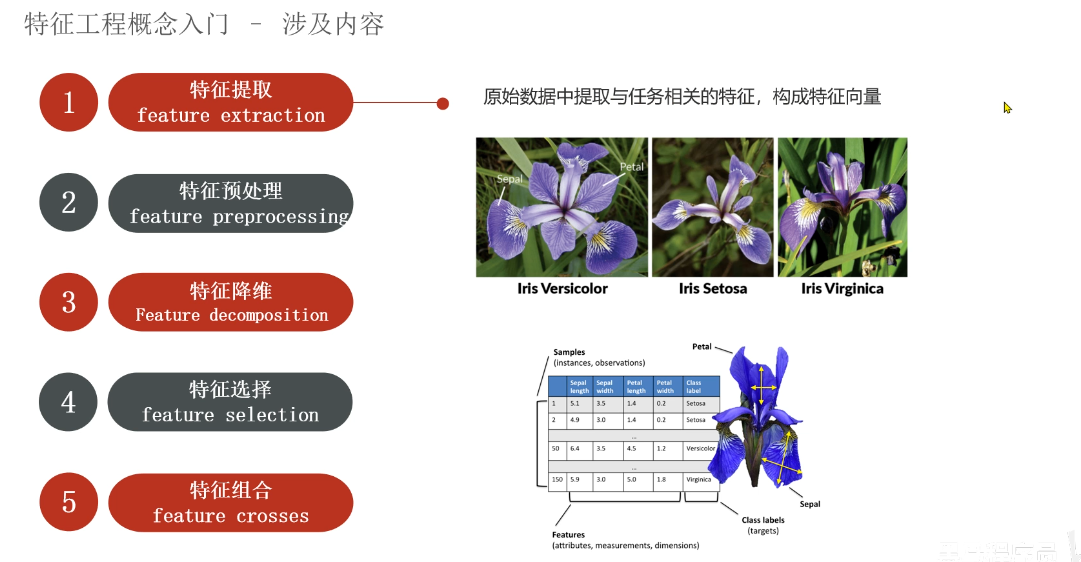
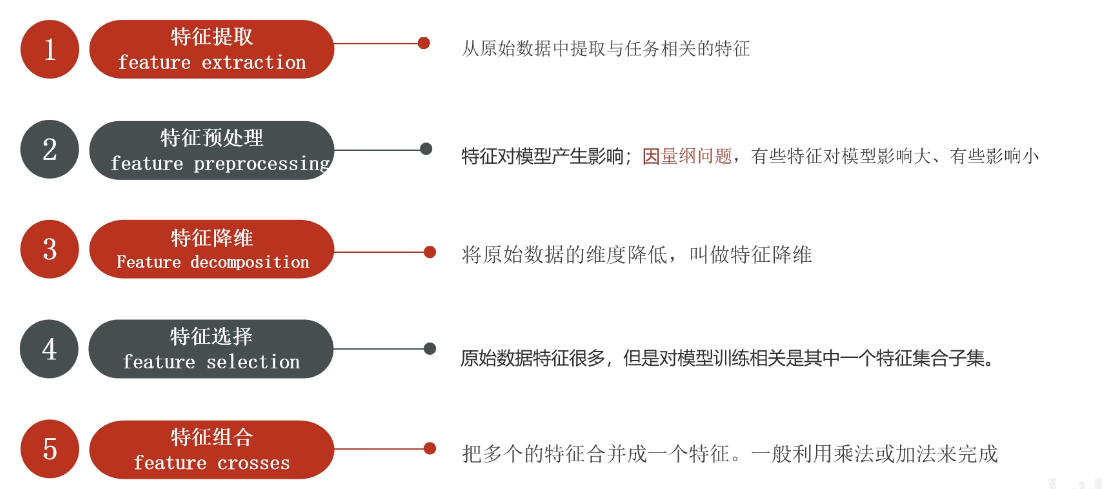
【理解】特征提取
从原始数据中提取与任务相关的特征,构成特征向量
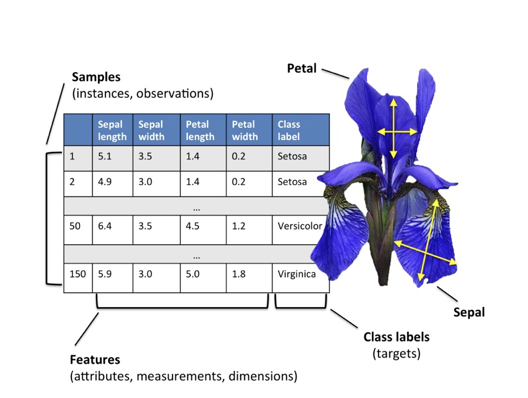
对于文本、图片这种非行列形式的数据行列形式转换,
一旦转换成行列形式一列就是特征
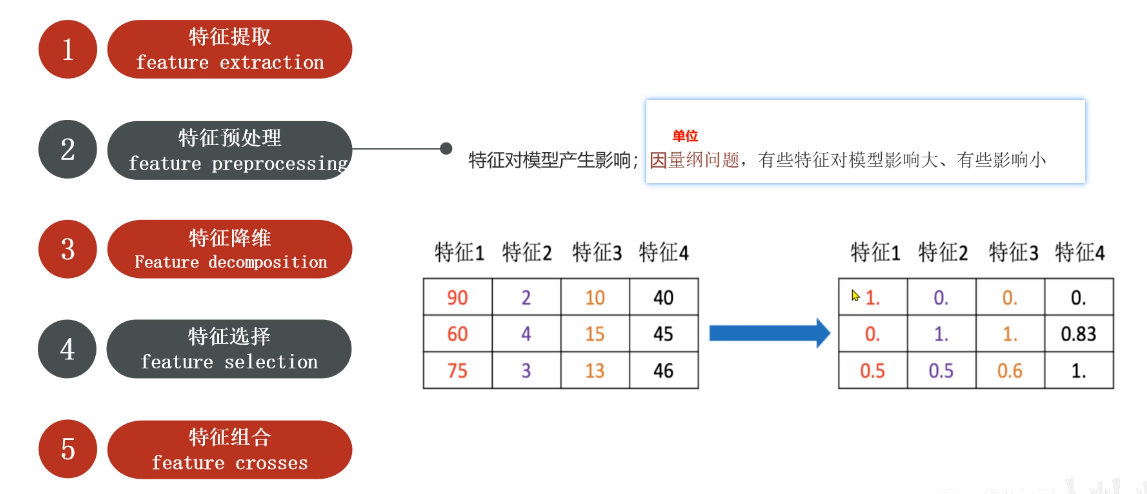
【理解】特征预处理
特征对模型产生影响;因量纲问题,有些特征对模型影响大、有些影响小
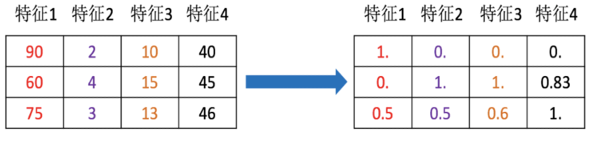
将不同的单位的特征数据转换成同一个范围内
使训练数据中不同特征对模型产生较为一致的影响
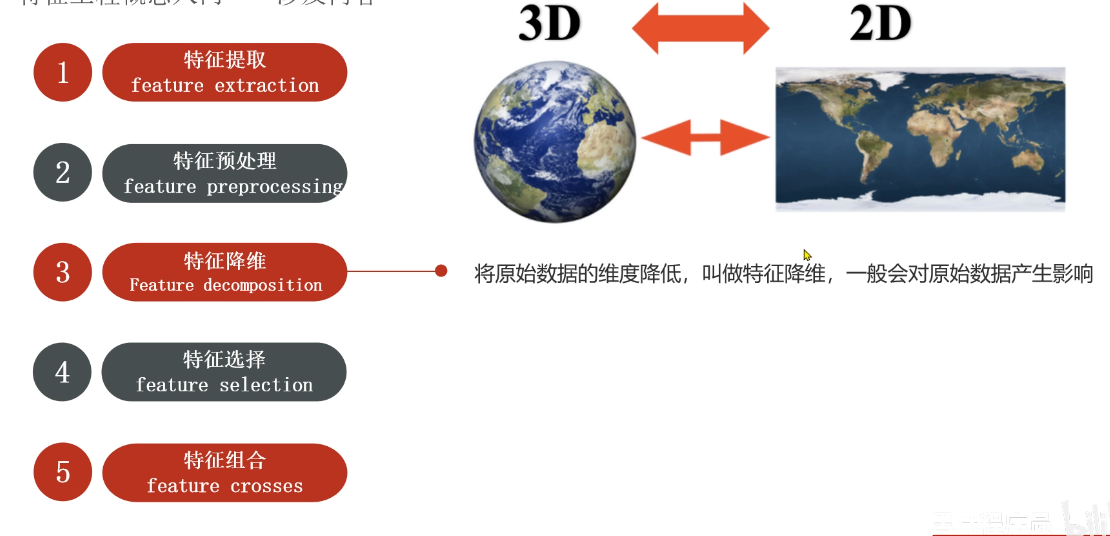
【了解】特征降维
将原始数据的维度降低,叫做特征降维
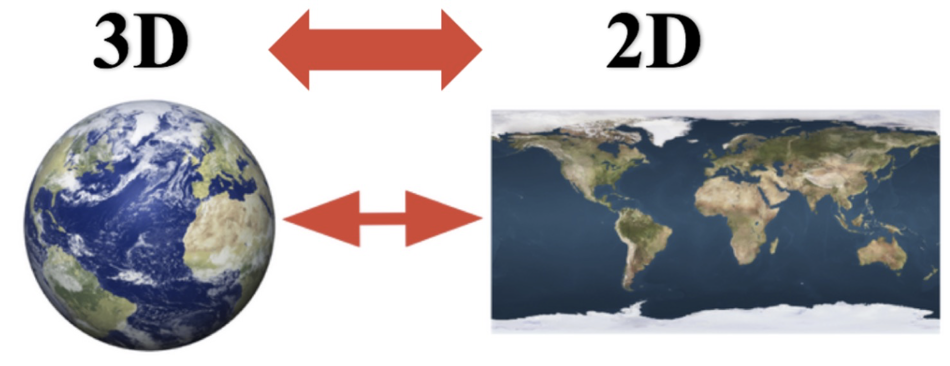
会丢失部分信息。降维就需要保证数据的主要信息要保留下来
原始数据会发生变化,不需要了解数据本身是什么含义,它保留了最主要的信息
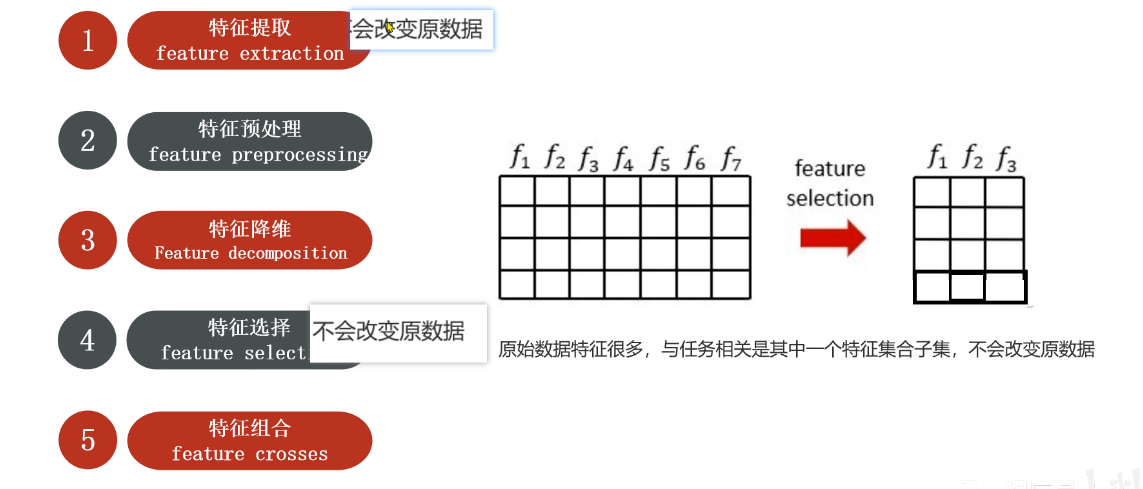
【了解】特征选择
原始数据特征很多,但是对任务相关是其中一个特征集合子集。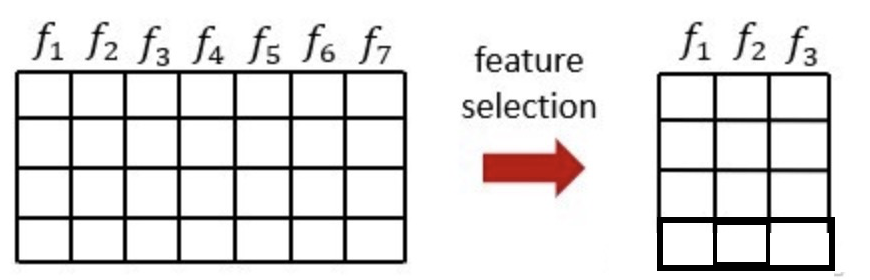
从特征中选择出一些重要特征(选择就需要根据一些指标来选择)
特征选择不会改变原来的数据
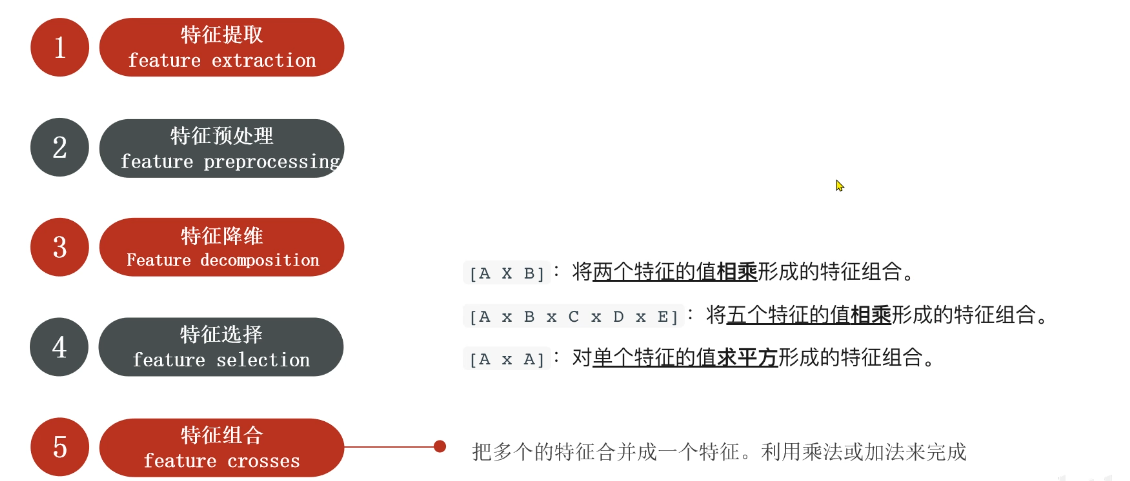
【了解】特征组合
把多个的特征合并成一个特征。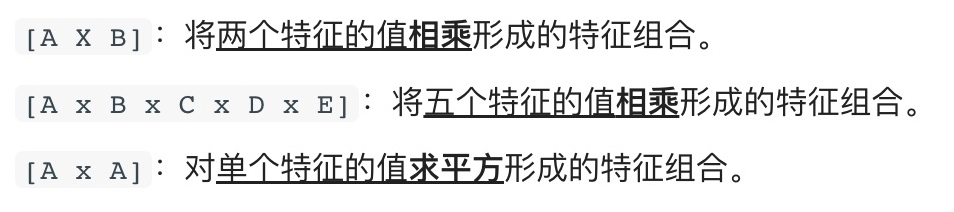
通过加法、乘法等方法将特征值合并
🤖意义:把原有特征做交叉组合,构造出新特征,挖掘单特征看不出来的非线性关联,提升模型表达能力。
📚以后用的最多的是 特征提取 和 特征预处理
📚
特征预处理和数据基本处理的区别:
- 数据基本处理:处理原始数据本身,解决 "数据脏、缺、错";
- 特征预处理:对已经干净的数据做变换,把数据变成模型能用好的特征。
【掌握】模型拟合问题
学习目标:
1.知道拟合是什么?
2.理解过拟合、欠拟合是什么?
3.知道过拟合、欠拟合出现的原因
4.理解泛化是什么?
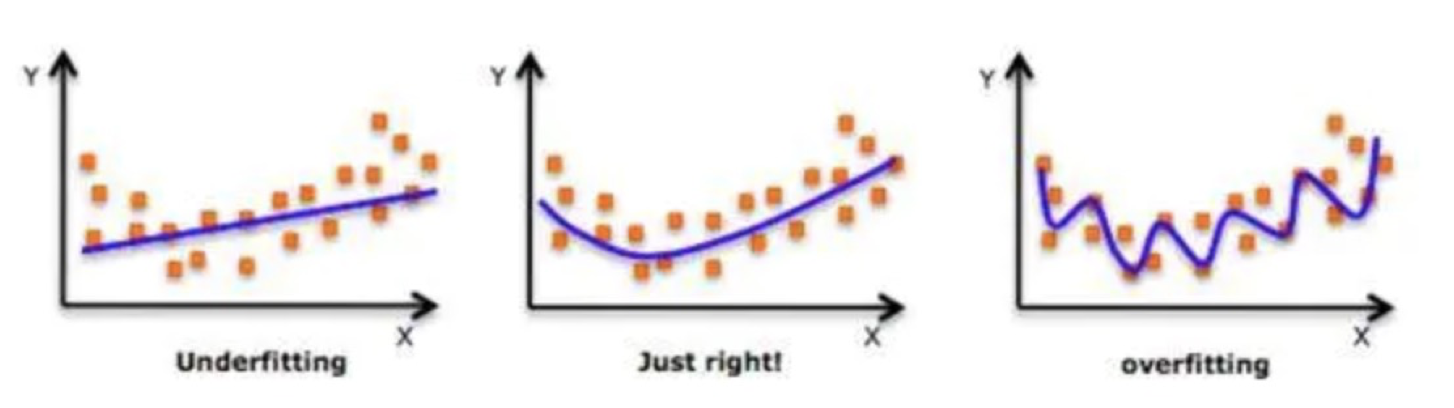
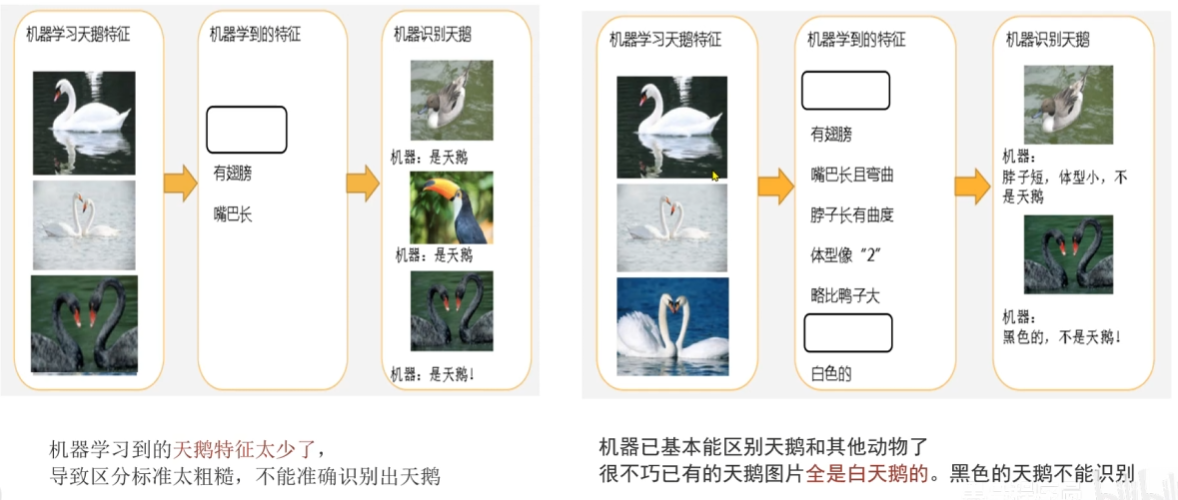
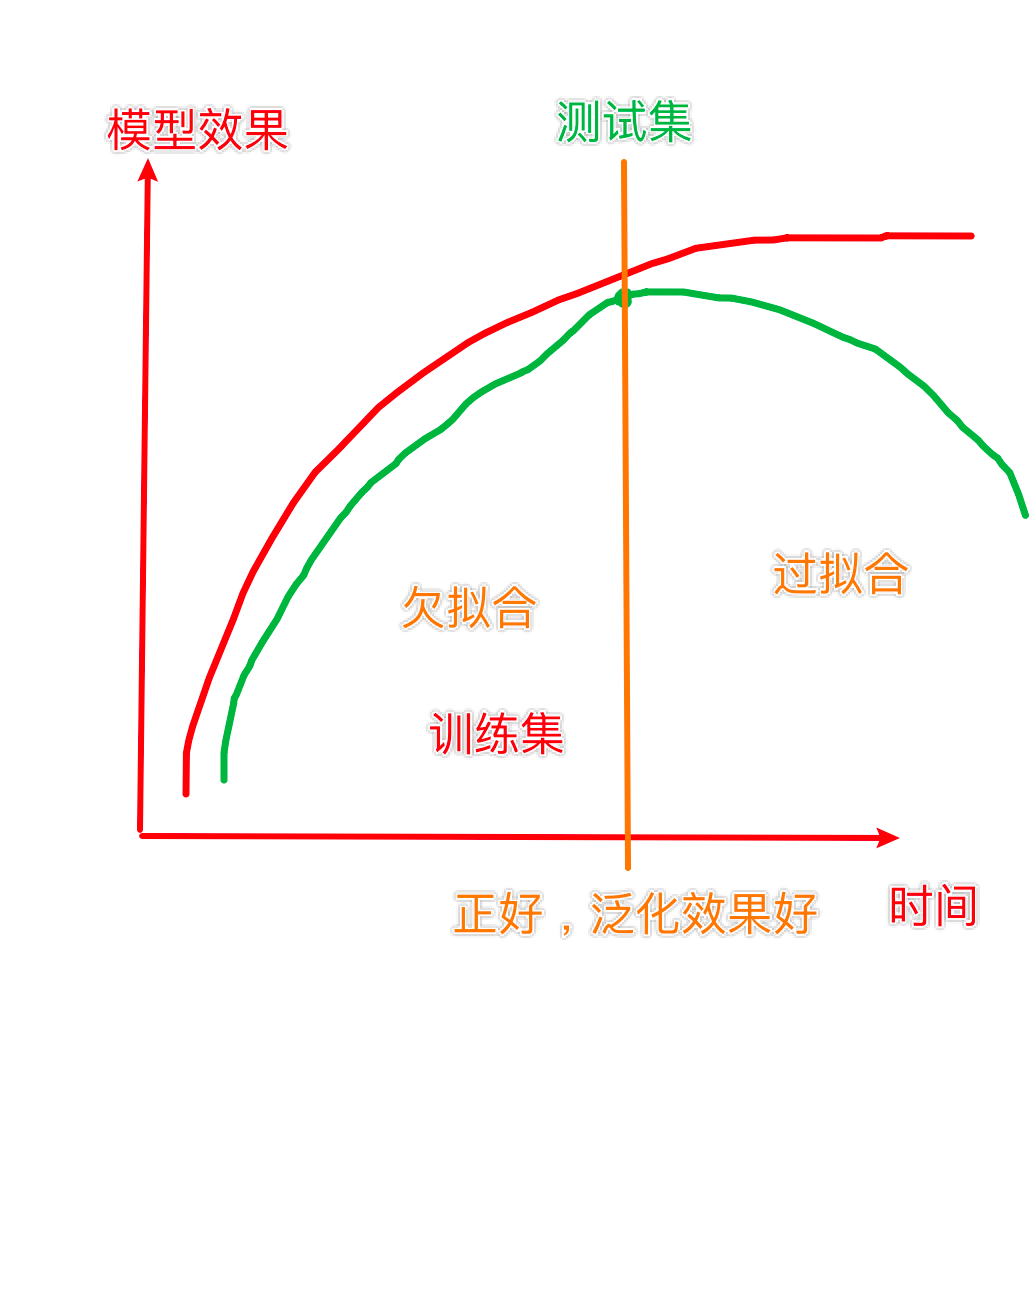
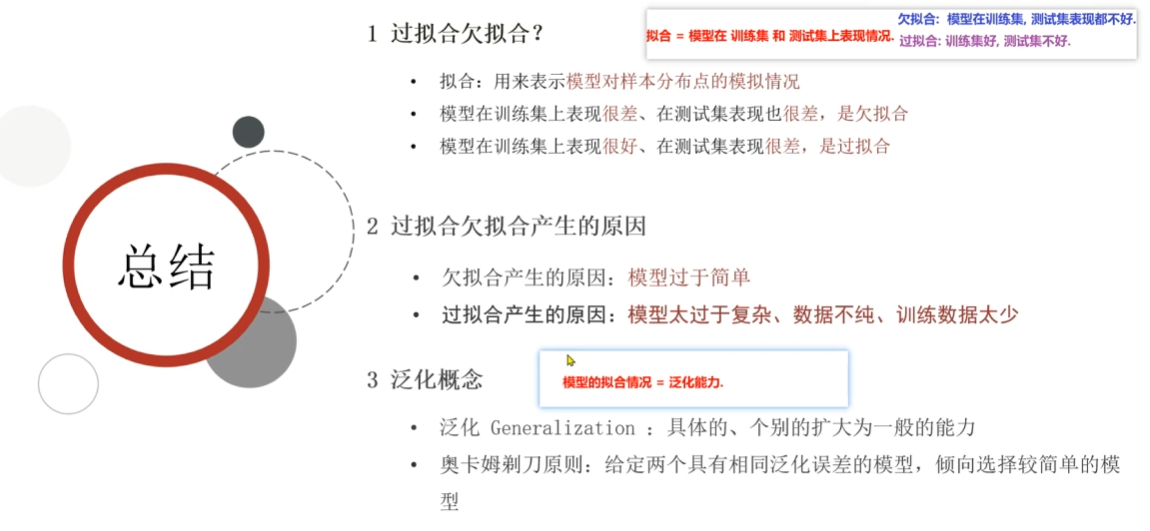
- 拟合:用来表示模型对样本点的拟合情况
模型在测试集和训练集上表现的好坏
-
欠拟合:模型在训练集上表现很差、在测试集表现也很差
原因:模型过于简单
-
过拟合:模型在训练集上表现很好、在测试集表现很差
原因:模型太过于复杂、数据不纯、训练数据太少
- 泛化:模型在新数据集(非训练数据)上的表现好坏的能力
奥卡姆剃刀原则:给定两个具有相同泛化误差的模型,较简单的模型比较复杂的模型更可取
【实操】机器学习开发环境
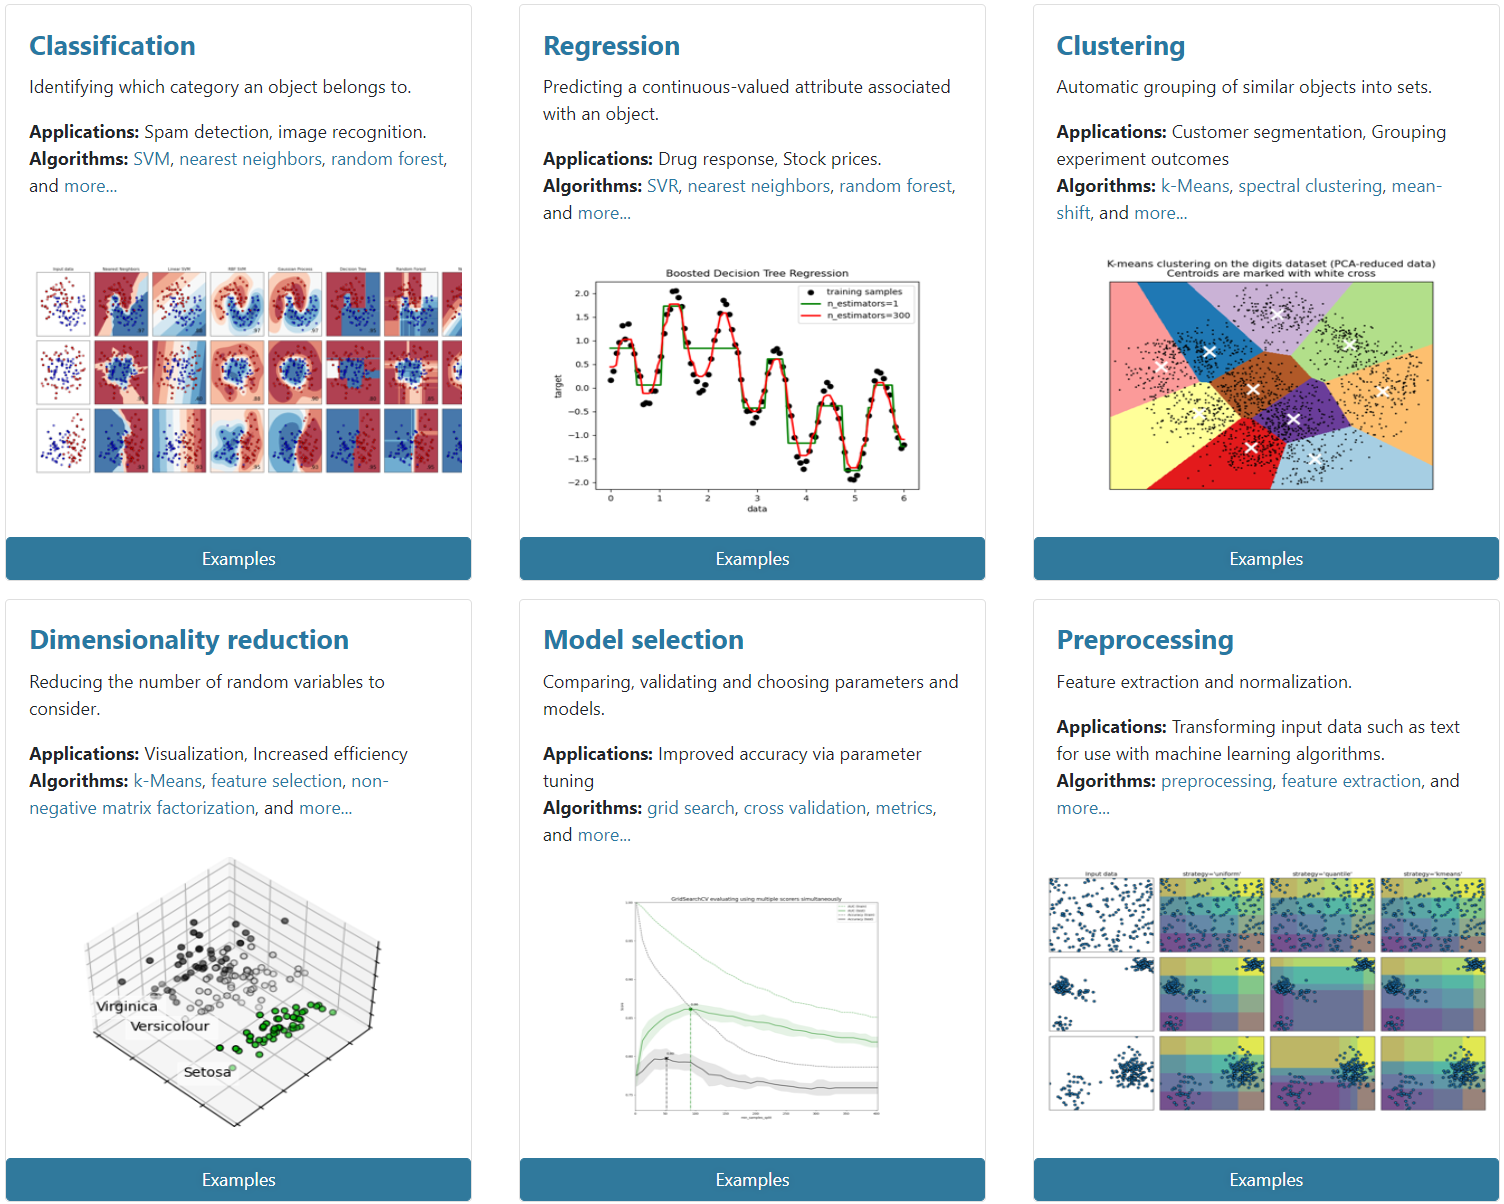
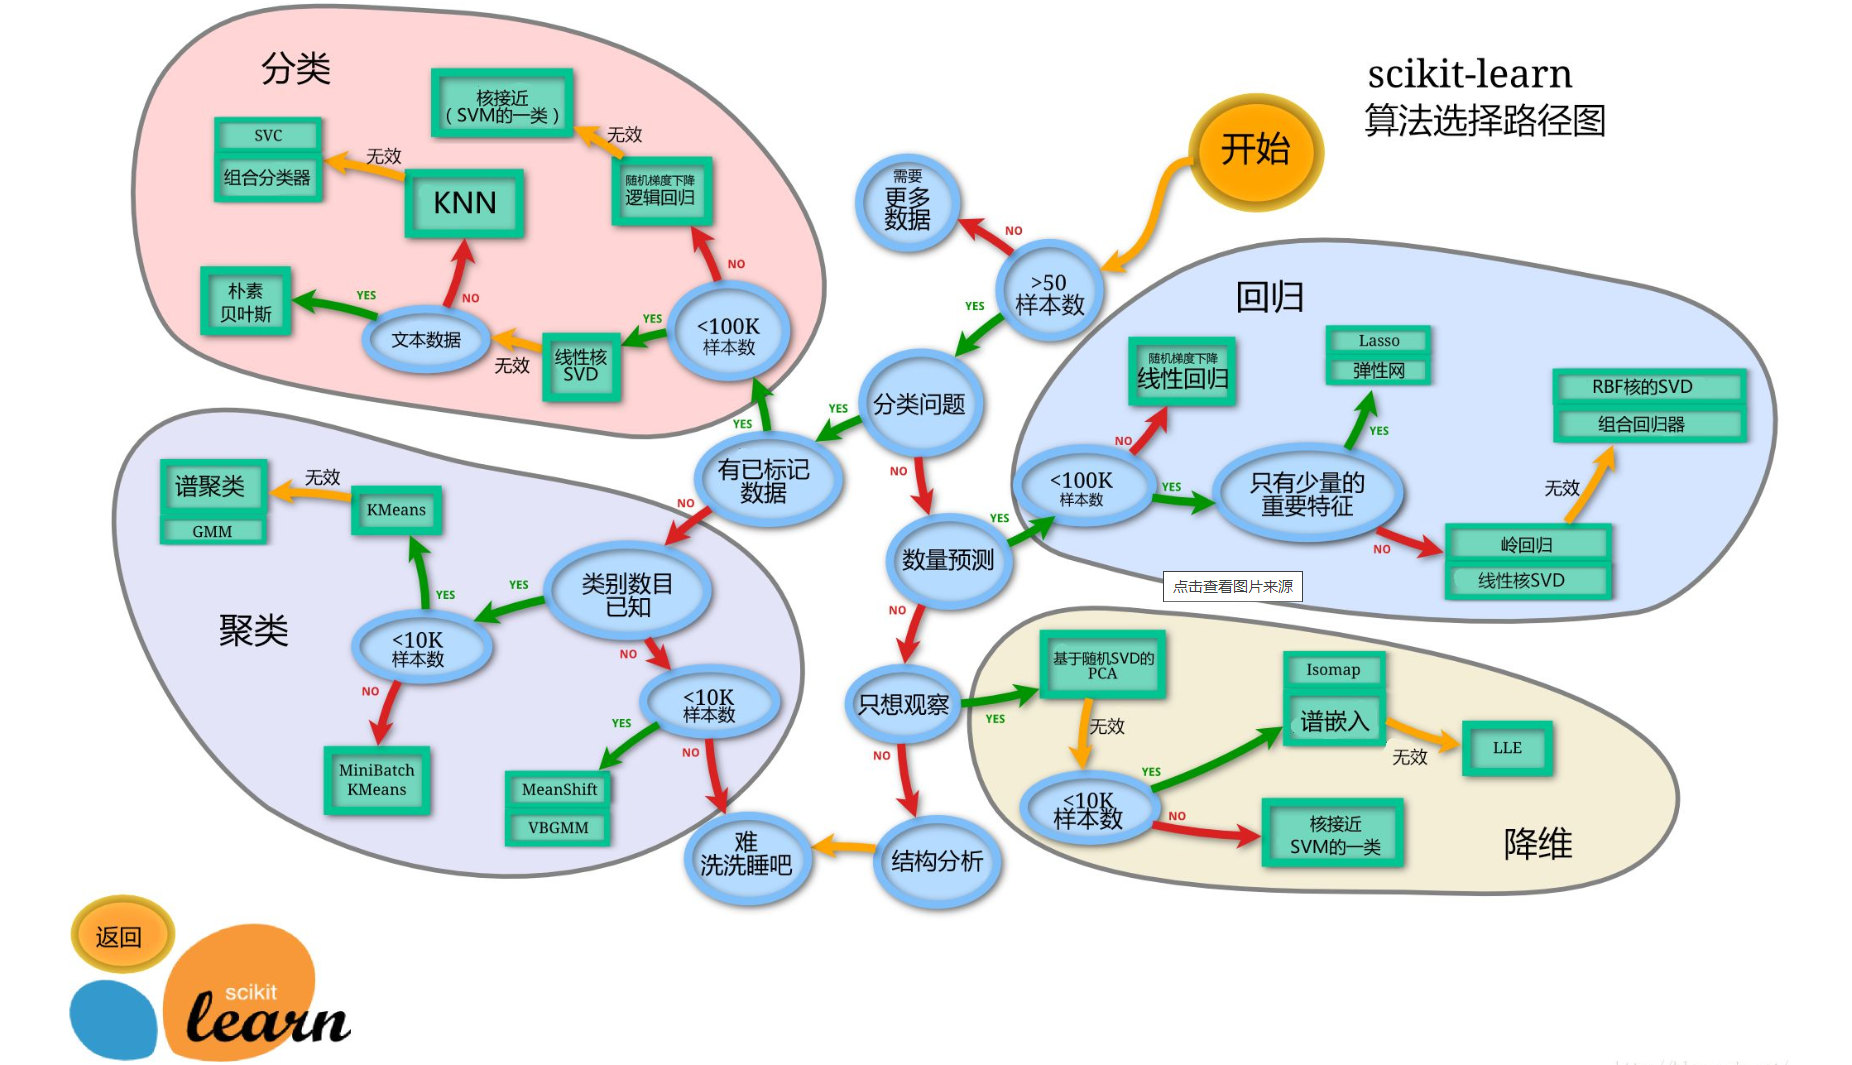
基于Python的 scikit-learn 库:
- 简单高效的数据挖掘和数据分析工具
- 可供大家使用,可在各种环境中重复使用
- 建立在NumPy,SciPy和matplotlib上
- 开源,可商业使用-获取BSD许可证
安装方法:
pip install scikit-learn
🐛:你的 pip 访问清华源网络 / SSL 出问题了,拿不到包列表
(base) C:\Windows\System32>pip install scikit-learn Looking in indexes: https://pypi.tuna.tsinghua.edu.cn/simple/ ERROR: Could not find a version that satisfies the requirement scikit-learn (from versions: none) ERROR: No matching distribution found for scikit-learn WARNING: There was an error checking the latest version of pip.解决:不连校园网执行
原因:校园网做了网络代理 / 防火墙 / 访问管控,拦截了清华 Anaconda 镜像站
机器学习官网:
https://scikit-learn.org/stable
作业
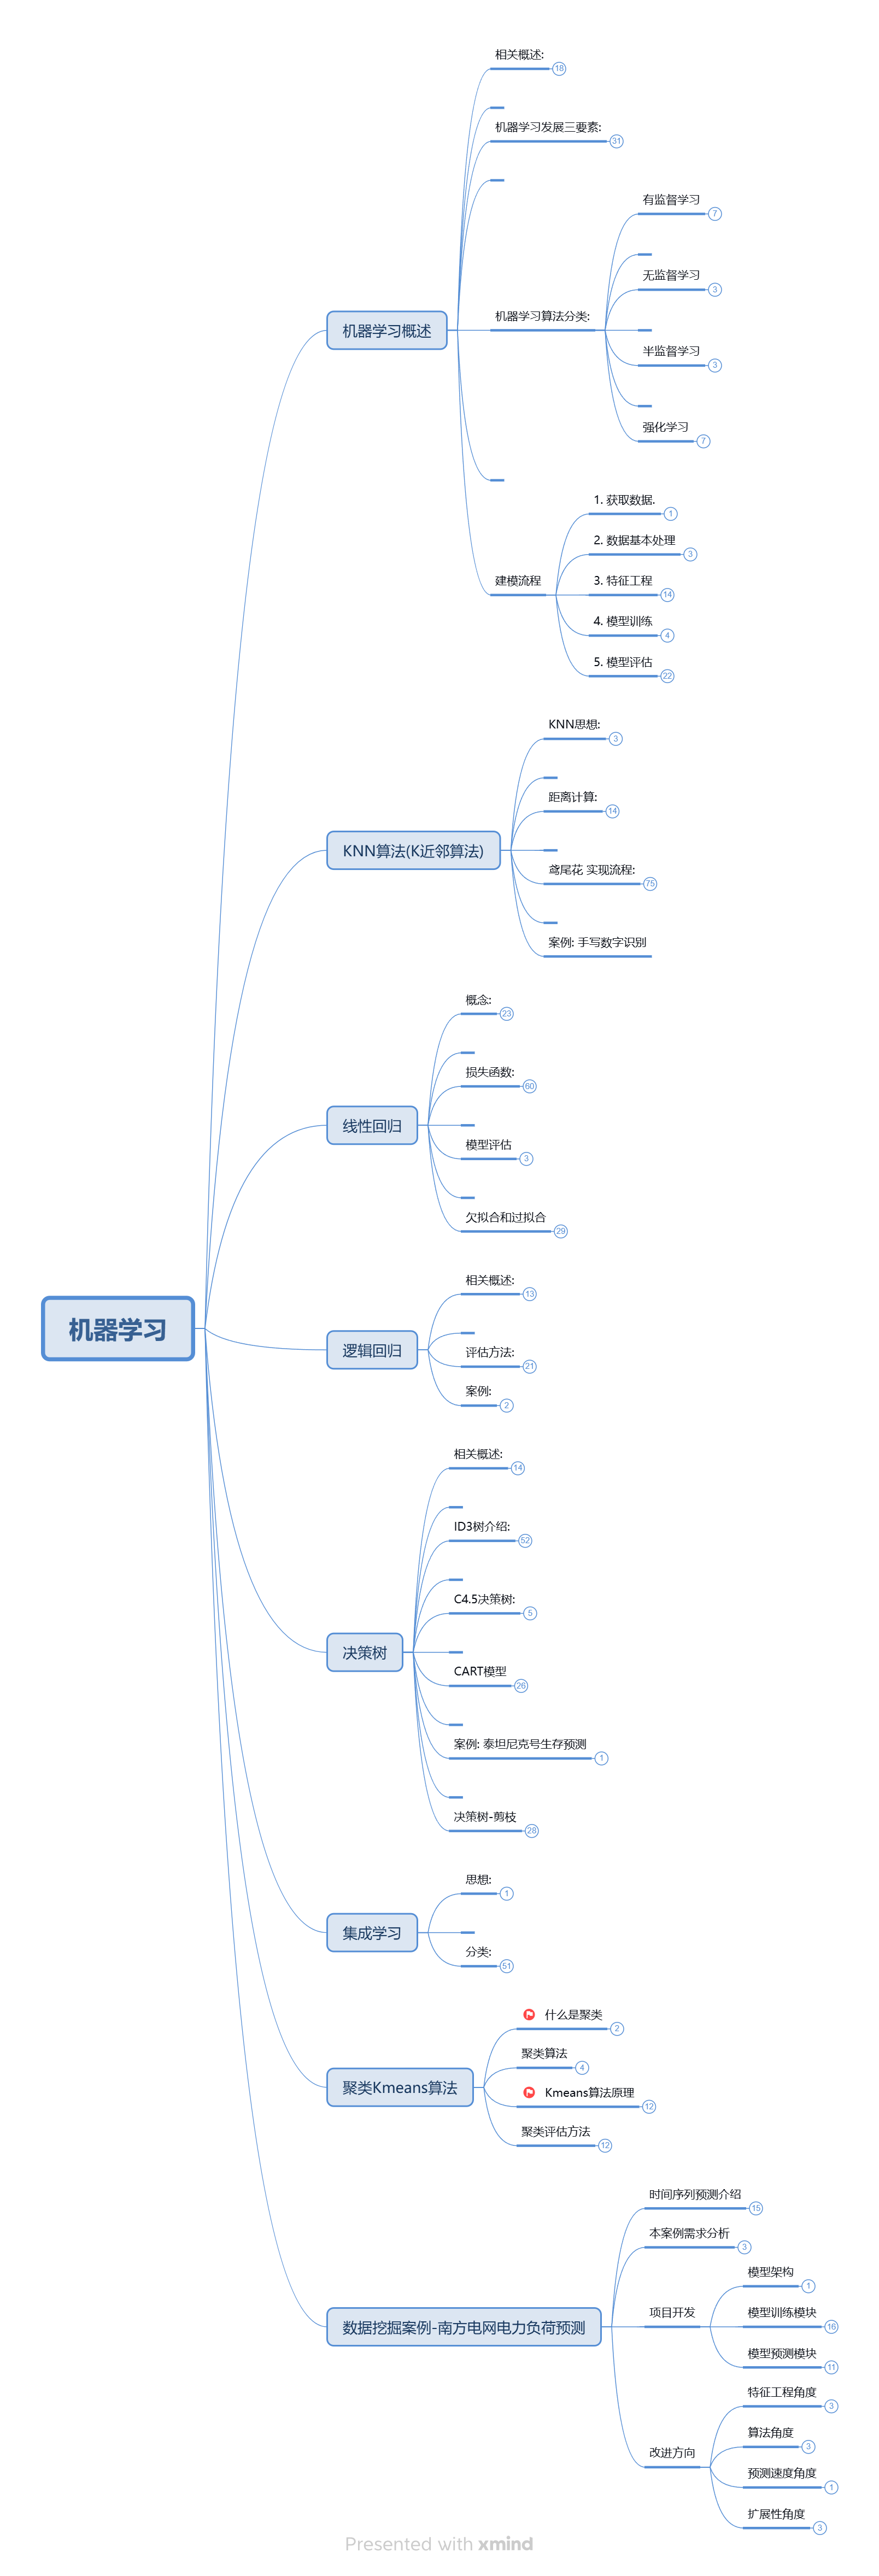
1.完成机器学习概述部分的思维导图
2.说明有监督学习和无监督学习的各自的特点及区别
3.说明下机器学习的建模流程
4.谈一下你对特征工程的理解
5.说下模型拟合问题及产生的原因
6.安装机器学习部分的开发环境
第二章 KNN算法
KNN算法简介
学习目标:
1.理解K近邻算法的思想
2.知道K值选择对结果影响
3.知道K近邻算法分类流程
4.知道K近邻算法回归流程
【理解】KNN算法思想
K-近邻算法(K Nearest Neighbor,简称KNN)。比如:根据你的"邻居"来推断出你的类别
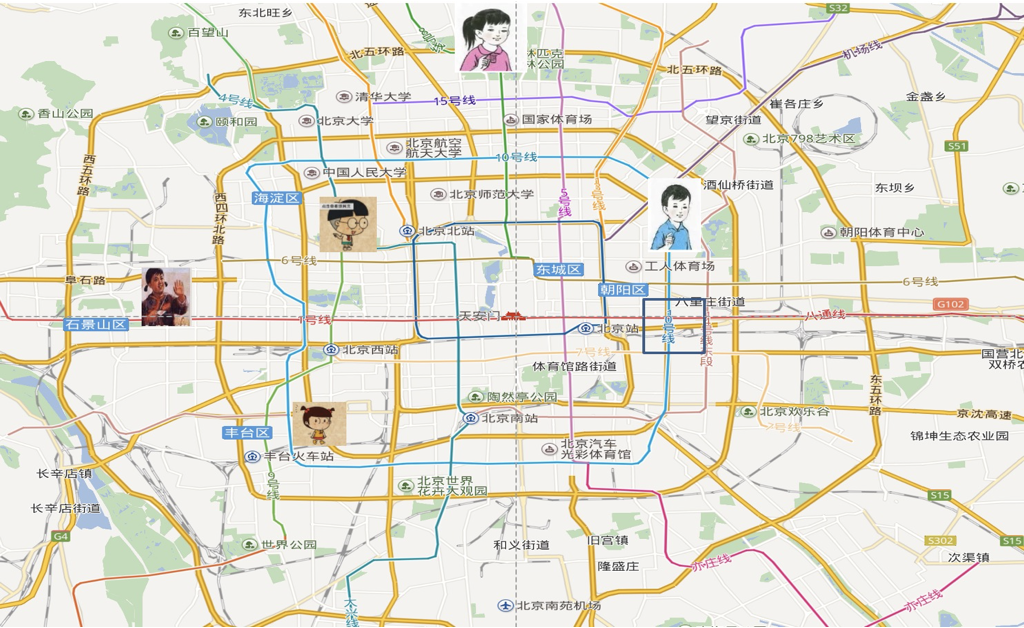
KNN算法思想:如果一个样本在特征空间中的 k 个最相似的样本中的大多数属于某一个类别,则该样本也属于这个类别
说人话:对于待预测样本,在特征空间找到距离最近的 k 个样本;若这 k 个样本多数是某一类,待预测样本就归为该类。
思考:如何确定样本的相似性?
样本相似性:样本都是属于一个任务数据集的。样本距离越近则越相似。
利用K近邻算法预测电影类型
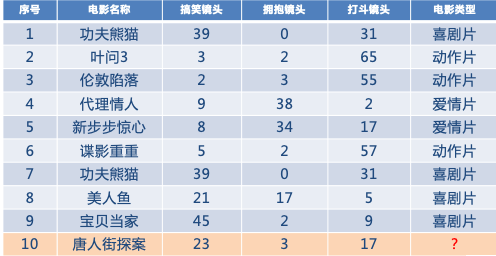

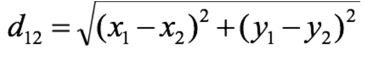

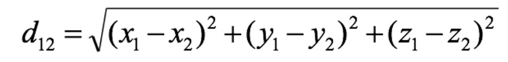
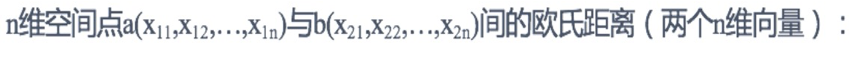
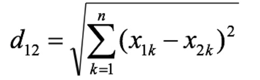
【知道】K值的选择
- k 很小(比如 k=1)
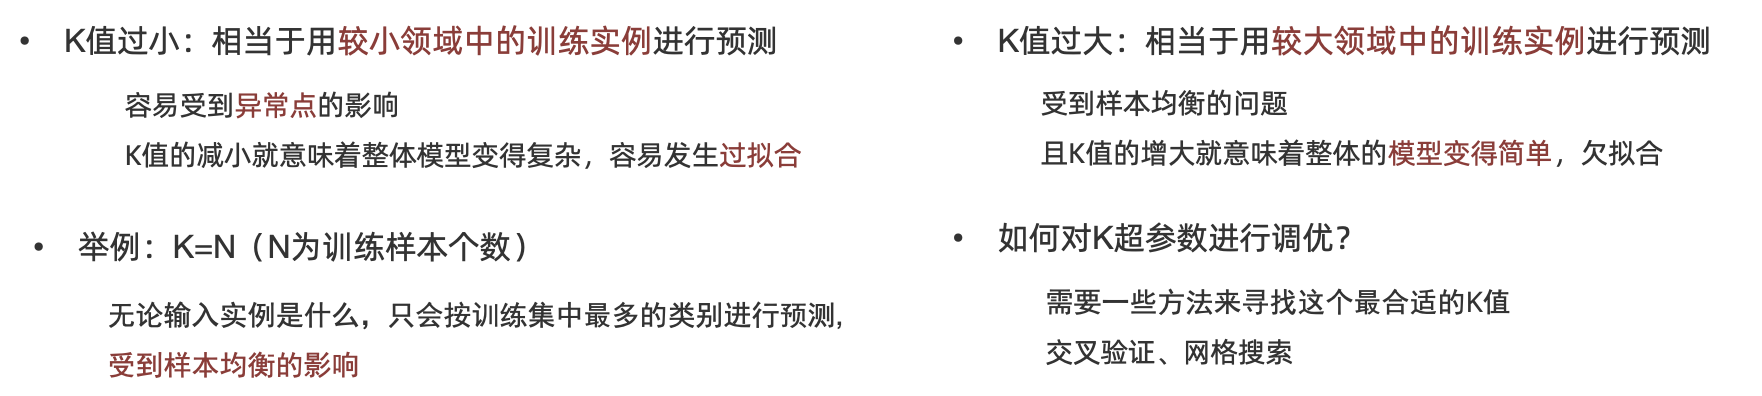
只看最近那 1 个邻居。容易被噪声、异常点带偏,模型太敏感。
过拟合:死记局部细节,泛化差。(如果k等于1,说明会过度学习这一个样本,更容易受到嘈杂数据 的影响)- k 很大(比如 k 等于全部训练样本)
直接拿整体样本最多的类别作为预测结果,完全忽略局部特征。
欠拟合:模型太简单,学不到数据规律。(k等于全部样本,相当于全部样本投个票,有没有这个算法意义不大)
【知道】KNN的应用方式
-
解决问题:分类问题、回归问题
-
算法思想:若一个样本在特征空间中的 k 个最相似的样本大多数属于某一个类别,则该样本也属于这个类别
-
相似性:欧氏距离
-
分类问题的处理流程:
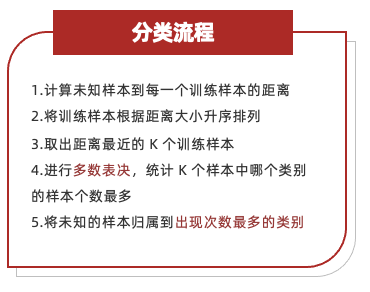
1.计算未知样本到每一个训练样本的距离
2.将训练样本根据距离大小升序排列
3.取出距离最近的 K 个训练样本
4.进行多数表决,统计 K 个样本中哪个类别的样本个数最多
5.将未知的样本归属到出现次数最多的类别
- 回归问题的处理流程:
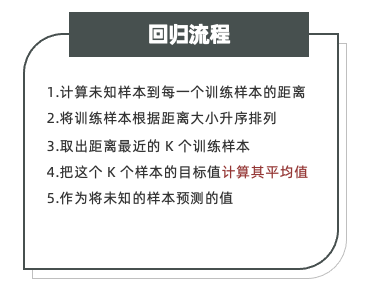
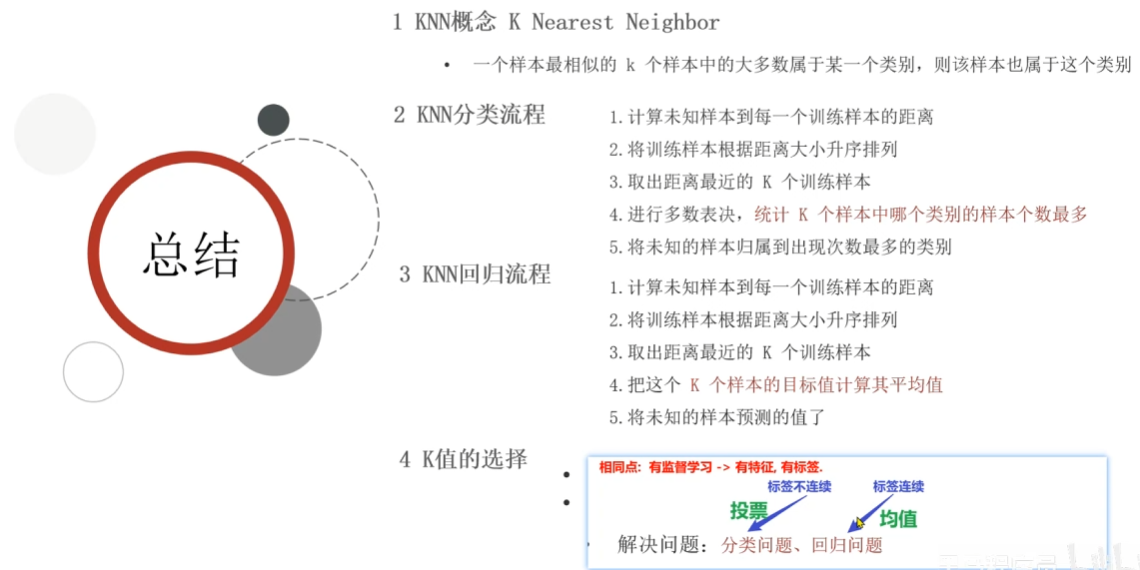
1.计算未知样本到每一个训练样本的距离
2.将训练样本根据距离大小升序排列
3.取出距离最近的 K 个训练样本
4.把这个 K 个样本的目标值计算其平均值
5.作为将未知的样本预测的值
API介绍
学习目标:
1.掌握KNN算法分类API
2.掌握KNN算法回归API
【实操】分类API
KNN分类API:
python
sklearn.neighbors.KNeighborsClassifier(n_neighbors=5) n_neighbors:int,可选(默认= 5),k_neighbors查询默认使用的邻居数
示例代码:
python
"""
KNN算法介绍(K Nearest Neighbors), K近邻算法
    原理:
        基于 欧式距离(或者其它距离计算方式)计算 测试集 和 每个训练集之间的距离, 然后根据距离升序排列, 找到最近的K个样本.
        基于K个样本投票, 票数多的就作为最终预测结果 -> 分类问题.
        基于K个样本计算平均值, 作为最终预测结果 -> 回归问题.
    实现思路:
        1. 分类问题
            适用于: 有特征, 有标签, 且标签是不连续的(离散的)
        2. 回归问题.
            适用于: 有特征, 有标签, 且标签是连续的.
    KNN算法, 分类问题思路如下:
        1. 计算测试集和每个训练的样本之间的 距离.
        2. 基于距离进行升序排列.
        3. 找到最近的K个样本.
        4. K个样本进行投票.
        5. 票数多的结果, 作为最终的预测结果.
    代码实现思路:
        1. 导包.
        2. 准备数据集(测试集 和 训练集)
        3. 创建(KNN 分类模型)模型对象.
        4. 模型训练.
        5. 模型预测.
"""

# 1. 导包.
from sklearn.neighbors import KNeighborsClassifier  # 分类
# from sklearn.neighbors import KNeighborsRegressor   # 回归

# 2. 准备数据集(测试集 和 训练集)
# train: 训练集
# test: 测试集
# neighbors: 最近邻的邻居数
x_train = [[0], [1], [2], [3]]      # 训练集的特征数据, 因为特征可以有多个特征, 所以是一个二维数组
y_train = [0, 0, 1, 1]              # 训练集的标签数据, 因为标签是离散的, 所以是一个一维数组
x_test = [[5]]                      # 测试集的特征数据

# 3. 创建(KNN 分类模型)模型对象.
# estimator: 估计器, 模型对象, 也可以用变量名 model做接收.
estimator = KNeighborsClassifier(n_neighbors=3)

# 4. 模型训练
# 传入: 训练集的特征数据, 训练集的标签数据
estimator.fit(x_train, y_train)

# 5. 模型预测.
# 传入: 测试集的特征数据, 获取到: 预测结果(测试集的标签, y_test)
y_pre = estimator.predict(x_test)

# 6. 打印预测结果.
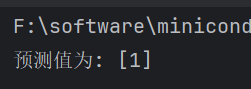
print(f'预测值为: {y_pre}')
📚
x_train写成这样会好看些:
python
x_train = [
	[0],
	[1],
	[2],
   [3]
]
如果有两个样本的话:
python
# X:4个样本,每个样本2个特征 → shape=(4,2)
x_train = [
    [0, 10],   # 样本1:特征1=0,特征2=10
    [1, 20],   # 样本2:特征1=1,特征2=20
    [2, 30],   # 样本3:特征1=2,特征2=30
    [3, 40]    # 样本4:特征1=3,特征2=40
]
✋
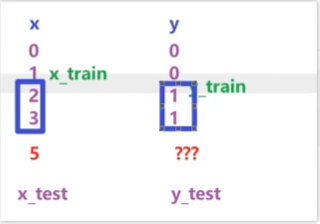
选取3个邻居,其中有2个邻居标签是1,所以结果为1。
【实操】回归API
KNN分类API:
python
sklearn.neighbors.KNeighborsRegressor(n_neighbors=5)
python
"""
KNN算法介绍(K Nearest Neighbors), K近邻算法
    原理:
        基于 欧式距离(或者其它距离计算方式)计算 测试集 和 每个训练集之间的距离, 然后根据距离升序排列, 找到最近的K个样本.
        基于K个样本投票, 票数多的就作为最终预测结果 -> 分类问题.
        基于K个样本计算平均值, 作为最终预测结果 -> 回归问题.
    实现思路:
        1. 分类问题
            适用于: 有特征, 有标签, 且标签是不连续的(离散的)
        2. 回归问题.
            适用于: 有特征, 有标签, 且标签是连续的.
    KNN算法, 回归问题思路如下:
        1. 计算测试集和每个训练的样本之间的 距离.
        2. 基于距离进行升序排列.
        3. 找到最近的K个样本.
        4. 基于K个样本的标签值, 计算平均值.
        5. 将上述计算出来的平均值, 作为最终的预测结果.
    代码实现思路:
        1. 导包.
        2. 准备数据集(测试集 和 训练集)
        3. 创建(KNN 回归模型)模型对象.
        4. 模型训练.
        5. 模型预测.
    总结:
        K值过小, 容易受到异常值的影响, 且会导致模型学到大量的"脏的特征", 导致出现: 过拟合.
        K值过大, 模型会变得简单, 容易发生: 欠拟合.
"""

# 1. 导包.
from sklearn.neighbors import KNeighborsRegressor       # KNN算法的 回归模型

# 2. 准备数据集(测试集 和 训练集)
# 开根号:     14.53      14.28       1           2.24
# 平方和:      211        204        1            5
# 差值:     (3,11,9)   (2,10,10)  (0,1,0)      (1,0,2)
x_train = [[0, 0, 1], [1, 1, 0], [3, 10, 10], [4, 11, 12]]      # 训练集的特征数据, 因为特征可以有多个特征, 所以是一个二维数组
y_train = [0.1, 0.2, 0.3, 0.4]                                  # 训练集的标签数据, 因为标签是连续的, 所以是一个一维数组
x_test = [[3, 11, 10]]                                          # 测试集的特征数据

# 3. 创建(KNN 回归模型)模型对象.
estimator = KNeighborsRegressor(n_neighbors=2)

# 4. 模型训练.
estimator.fit(x_train, y_train)

# 5. 模型预测.
y_pre = estimator.predict(x_test)

# 6. 打印预测结果.
print(f'预测值为: {y_pre}')
K=2,取这两个标签:0.3 和 0.4
平均值 = ((0.3+0.4)/2 = 0.35)
程序输出:
[0.35]
距离度量方法
学习目标:
(主要掌握欧式和曼哈顿)
1.掌握欧氏距离的计算方法
2.掌握曼哈顿距离的计算方法
3.了解切比雪夫距离的计算方法
4.了解闵可夫斯基距离的计算方法
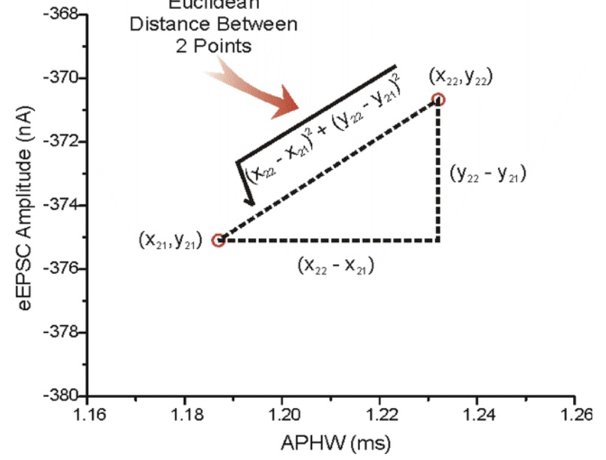
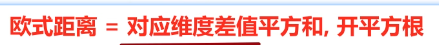
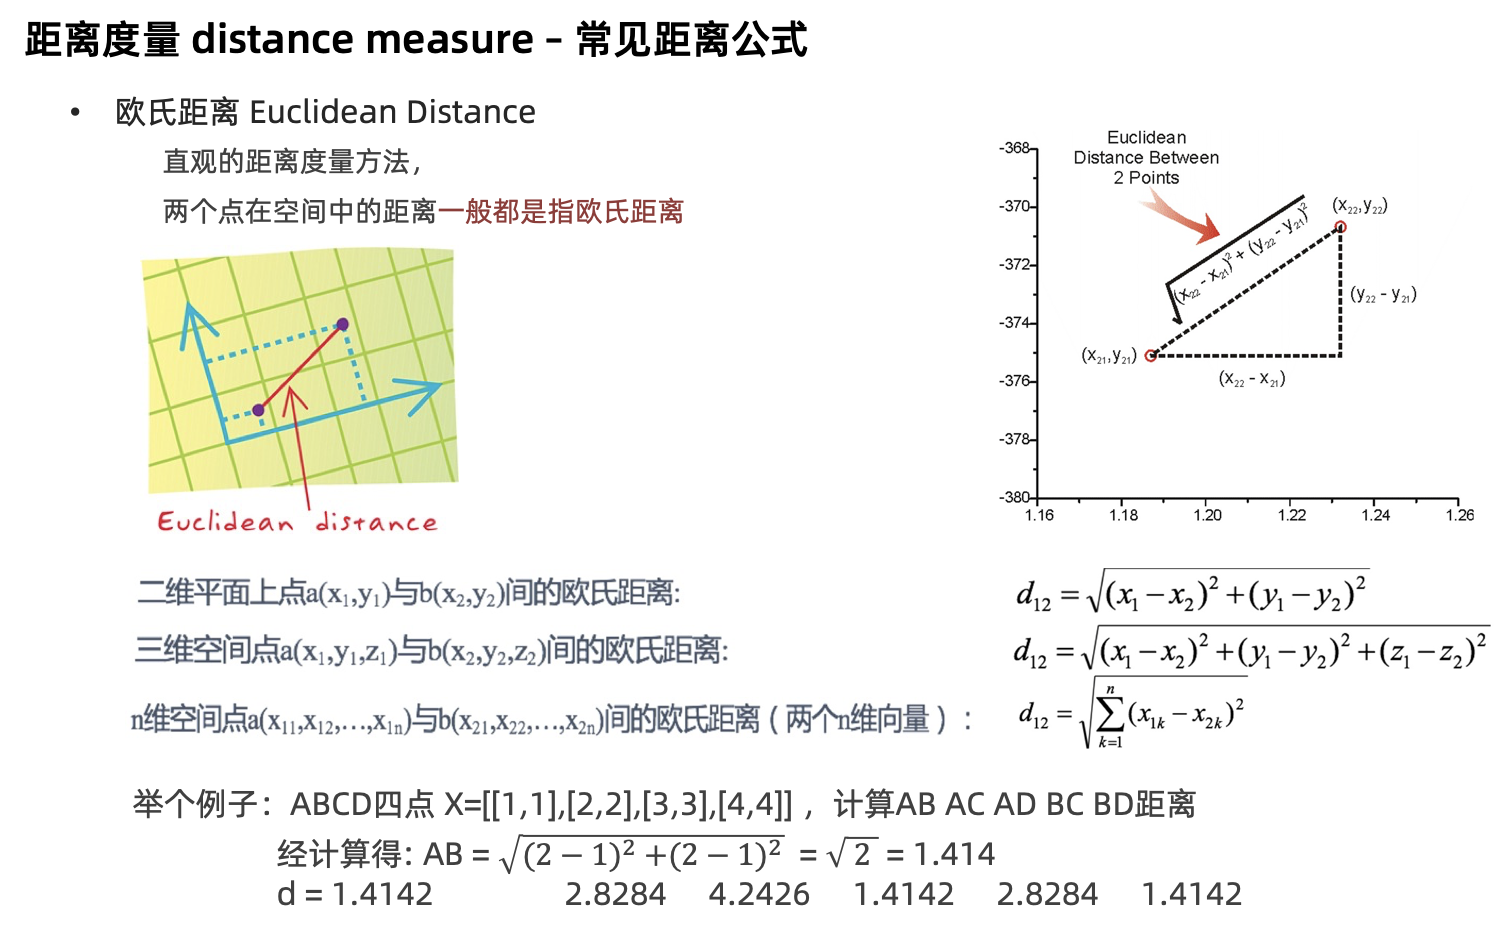
【掌握】欧式距离
对应维度差值的平方和,再开平方根
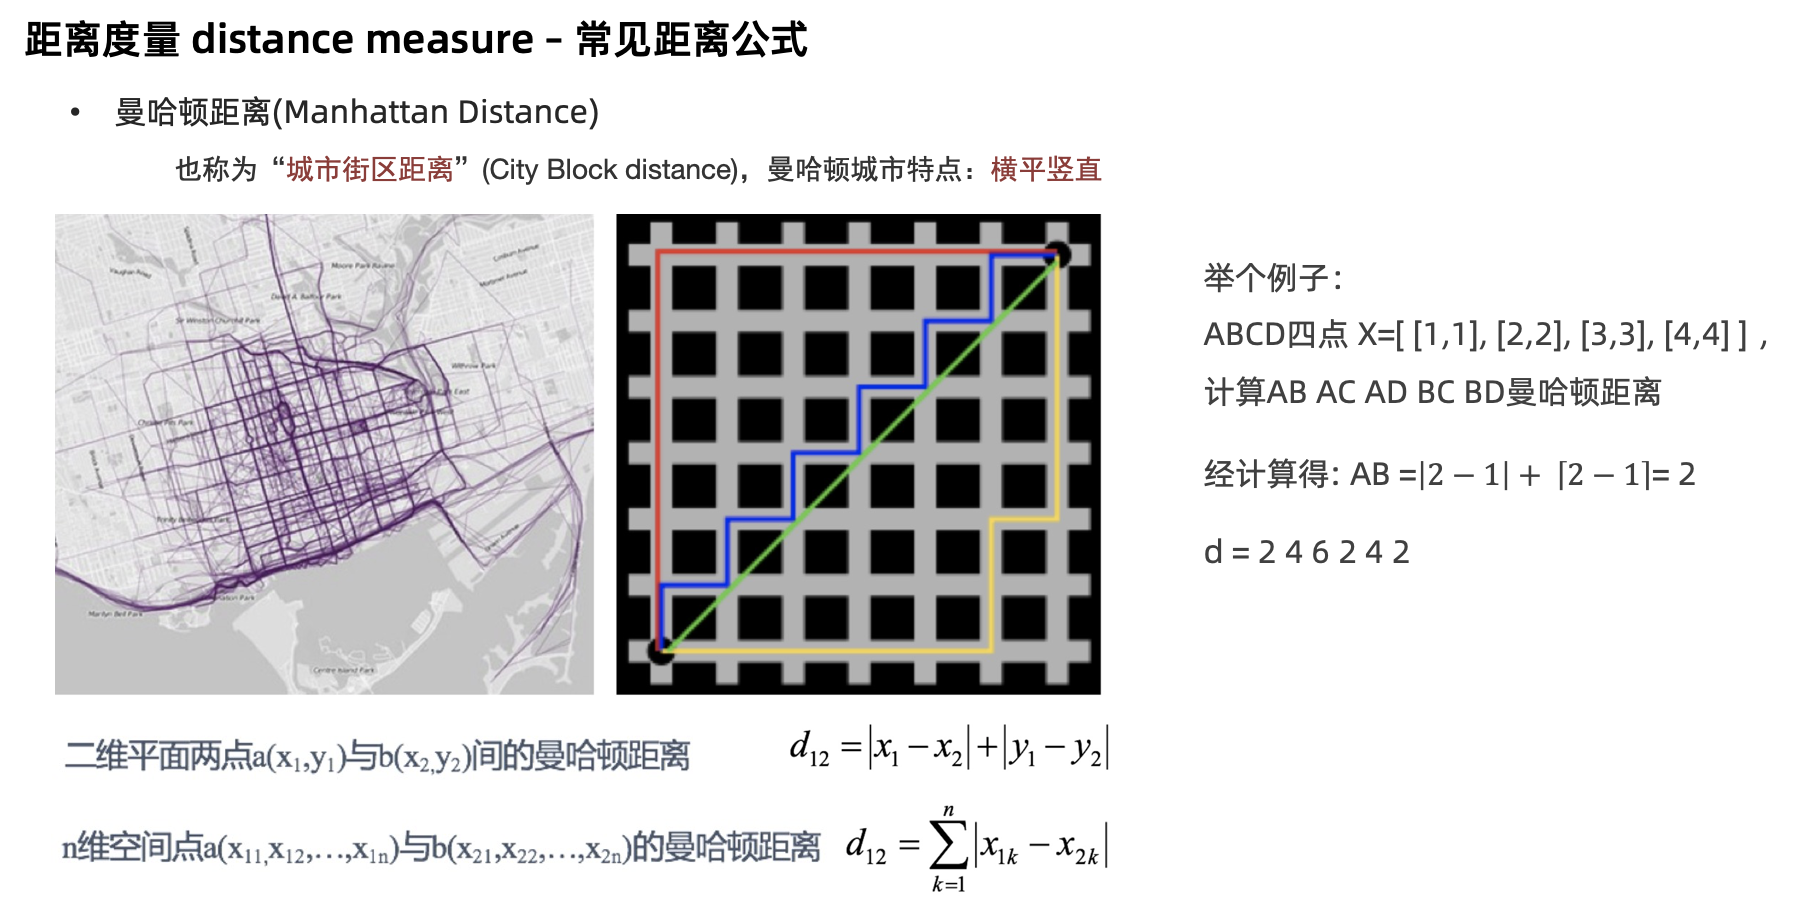
【掌握】曼哈顿距离
对应维度差值的绝对值之和
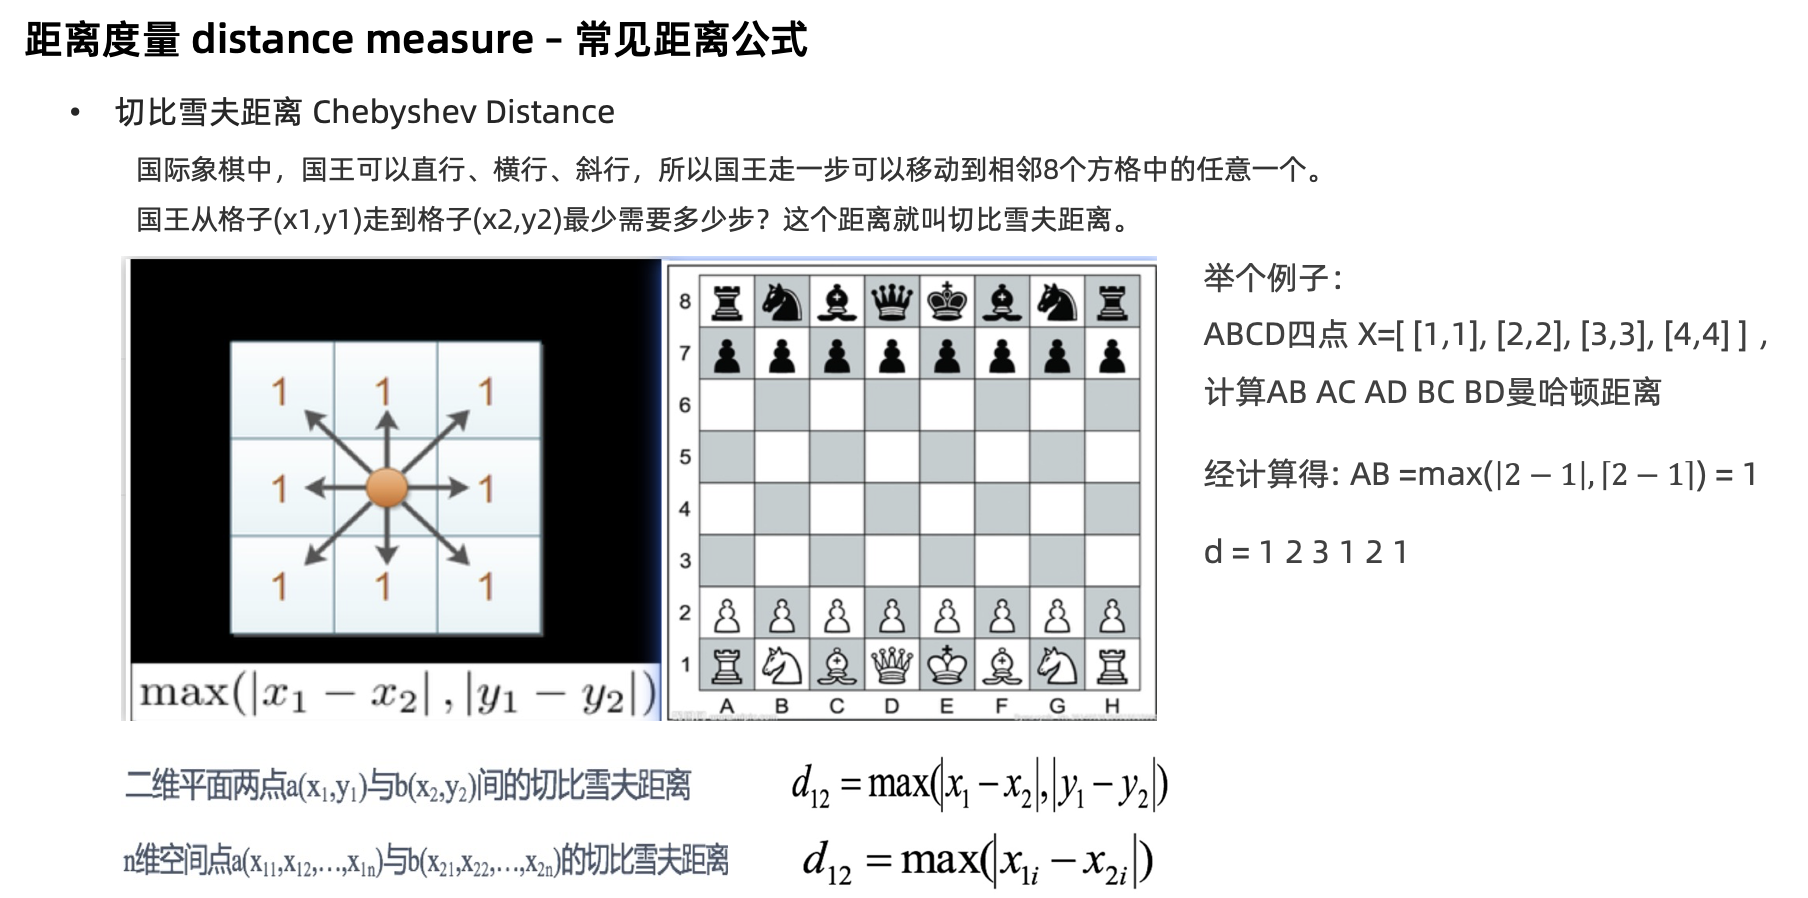
【了解】切比雪夫距离
对应维度差值的绝对值 ,求最大值
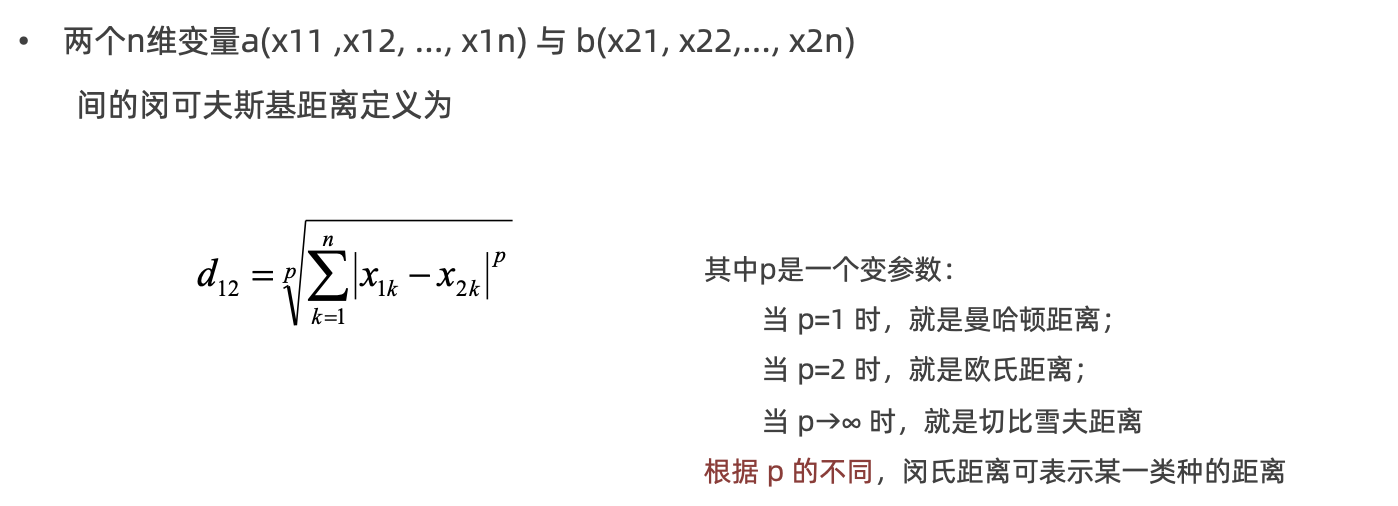
【了解】闵氏距离
•闵可夫斯基距离 Minkowski Distance 闵氏距离,不是一种新的距离的度量方式 。而是距离的组合 是对多个距离度量公式的概括性的表述
特征预处理
学习目标:
1.知道为什么进行归一化、标准化
2.能应用归一化API处理数据
3.能应用标准化API处理数据
4.使用KNN算法进行鸢尾花分类
【知道】为什么进行归一化、标准化
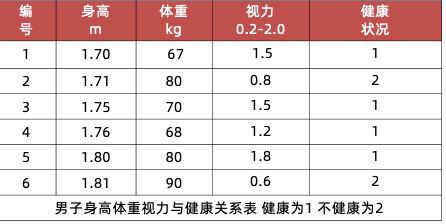
特征的单位或者大小相差较大,或者某特征的方差相比其他的特征要大出几个数量级 ,容易影响(支配)目标结果,使得一些模型(算法)无法学习到其它的特征。
【掌握】归一化
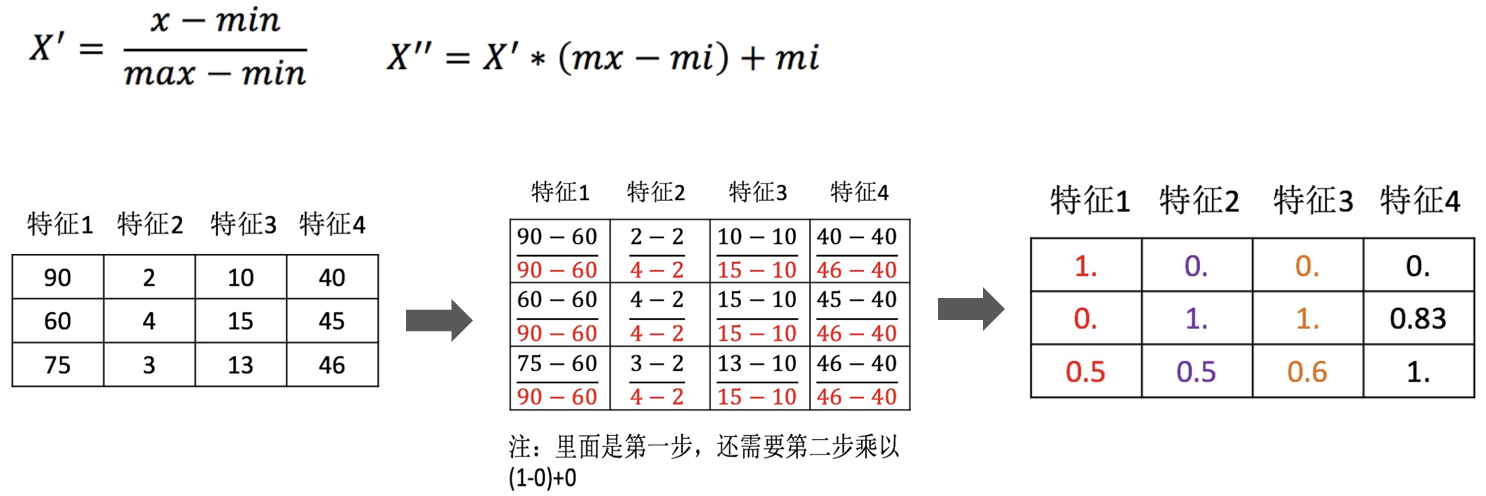
通过对原始数据进行变换把数据映射到**【mi,mx】**(默认为0,1)之间
数据归一化的API实现
python
sklearn.preprocessing.MinMaxScaler (feature_range=(0,1)... )feature_range 缩放区间
- 调用 fit_transform(X) 将特征进行归一化缩放
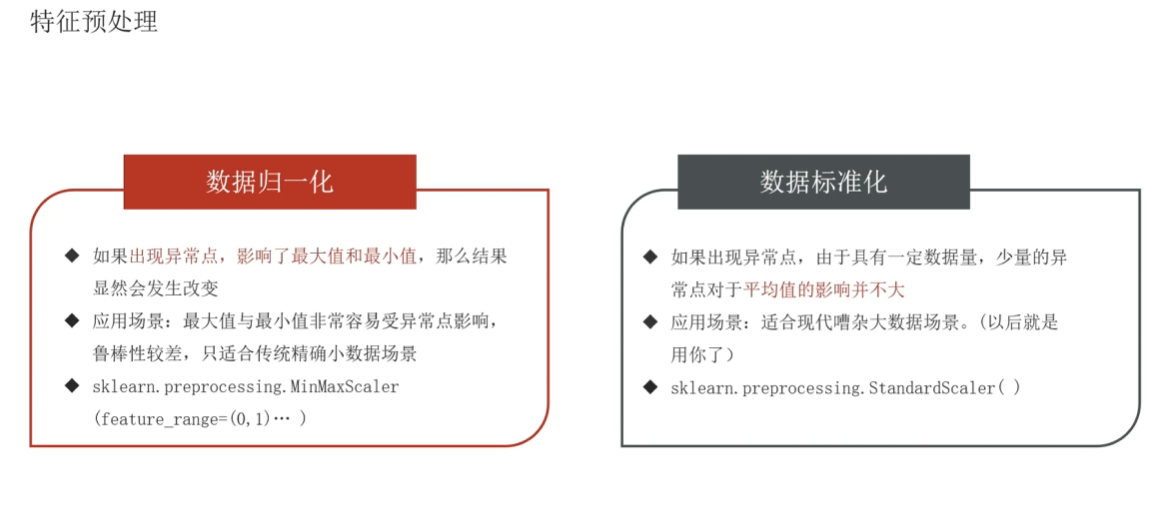
归一化受到最大值与最小值的影响,这种方法容易受到异常数据的影响, 鲁棒性较差,适合传统精确小数据场景
示例代码:
python
"""
案例: 演示特征预处理之 归一化操作.

回顾: 特征工程的目的 和 步骤
    目的:
        利用专业的背景知识 和 技巧处理数据, 用于提升 模型的性能.
    步骤:
        1. 特征提取.
        2. 特征预处理(归一化, 标准化)
        3. 特征降维.
        4. 特征选择.
        5. 特征组合.


特征预处理之 归一化介绍:
    目的:
        防止因为量纲(单位)问题, 导致特征列的方差值相差较大, 影响模型的最终结果.
        所以通过公式把 各列的值 映射到 [0, 1] 区间.
    公式:
        x'  = (当前值 - 该列最小值) / (该列最大值 - 该列最小值)
        x'' = x' * (mx - mi) + mi
    公式解释:
        x' ->  基于公式算出来的 结果
        x'' -> 最终的 结果.
        mx ->  区间的最大值
        mi ->  区间的最小值
    弊端:
        容易受到最大值 和 最小值的影响, 所以它一般用于处理 小数据集.
"""

# 导包
from sklearn.preprocessing import MinMaxScaler, StandardScaler  # 归一化对象


# 1. 准备数据集(归一化之前的原数据).
x_train = [[90, 2, 10, 40], [60, 4, 15, 45], [75, 3, 13, 46]]

# 2. 创建归一化对象.
# 参数feature_range 表示生成范围, 默认为: 0, 1  如果就是这个区间, 则参数可以省略不写.
transfer = MinMaxScaler()
# transfer = MinMaxScaler(feature_range=(3, 5))

# 3. 对原数据集进行归一化操作.
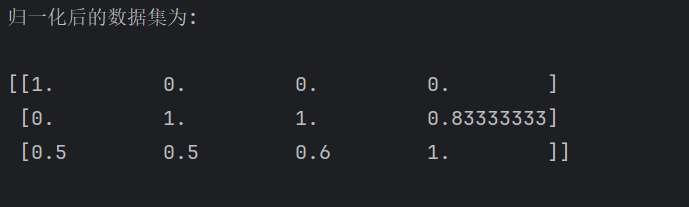
x_train_new = transfer.fit_transform(x_train)

# 4. 打印处理后的数据.
print('归一化后的数据集为: \n')
print(x_train_new)
✋
【掌握】标准化
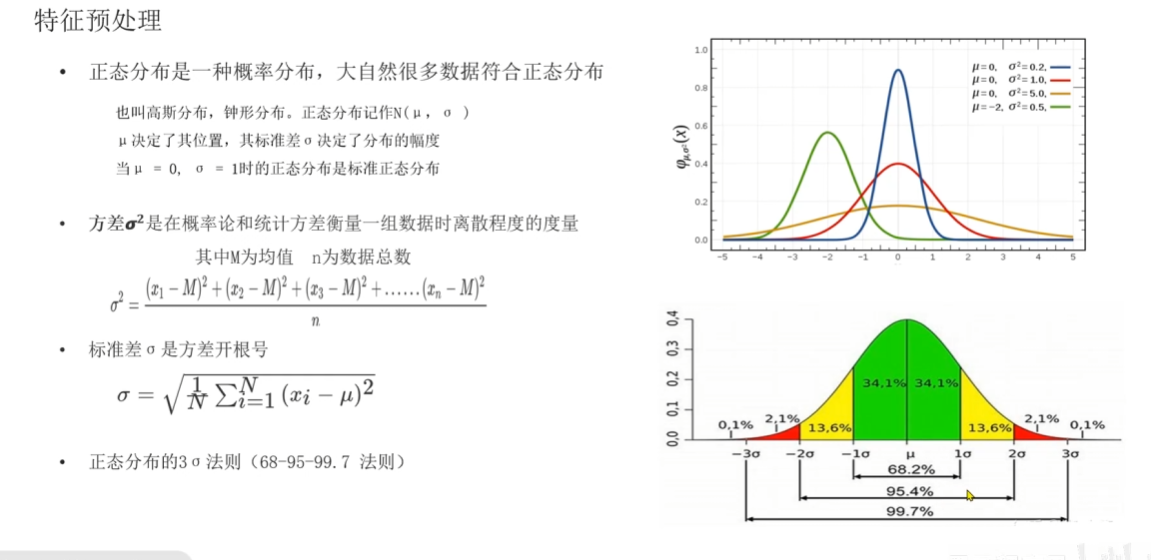
通过对原始数据进行标准化,转换为均值为0标准差为1的标准正态分布的数据
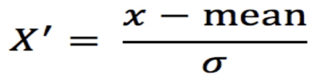
- mean 为特征的平均值
- σ 为特征的标准差
数据标准化的API实现
python
sklearn.preprocessing. StandardScaler()调用 fit_transform(X) 将特征进行归一化缩放
python
"""
案例: 演示特征预处理之 标准化操作.

回顾: 特征工程的目的 和 步骤
    目的:
        利用专业的背景知识 和 技巧处理数据, 用于提升 模型的性能.
    步骤:
        1. 特征提取.
        2. 特征预处理(归一化, 标准化)
        3. 特征降维.
        4. 特征选择.
        5. 特征组合.


特征预处理之 标准化介绍:
    目的:
        防止因为量纲(单位)问题, 导致特征列的方差值相差较大, 影响模型的最终结果.
        所以通过公式把 各列的值 映射到 均值为0, 标准差为1的 正态分布序列.
    公式:
        x'  = (当前值 - 该列平均值) / 该列的标准差

    应用场景:
        适用于 大数据集 的处理.

    结论:
        无论是归一化, 还是标准化, 目的都是为了解决因为量纲(单位)问题, 导致模型评估较低等问题.

回顾:
    方差计算公式: 该列每个值 和 该列均值的差 的平方和 的 平均值.
    标准差计算公式: 方差开平方根
"""

# 导包
from sklearn.preprocessing import StandardScaler  # 标准化对象


# 1. 准备数据集(标准化之前的原数据).
x_train = [[90, 2, 10, 40], [60, 4, 15, 45], [75, 3, 13, 46]]

# 2. 创建标准化对象.
transfer = StandardScaler()

# 3. 对原数据集进行标准化操作.
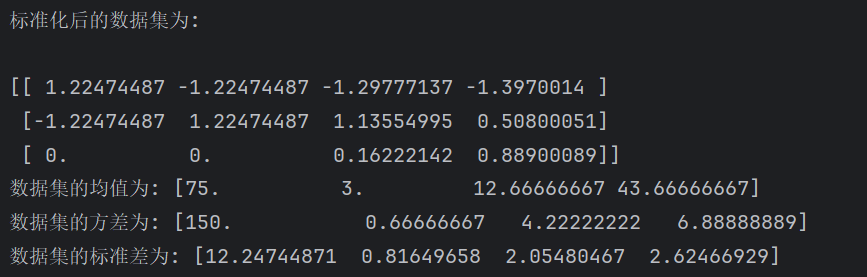
x_train_new = transfer.fit_transform(x_train)

# 4. 打印处理后的数据.
print('标准化后的数据集为: \n')
print(x_train_new)

# 5. 打印数据集的均值和方差.
print(f'数据集的均值为: {transfer.mean_}')
print(f'数据集的方差为: {transfer.var_}')
print(f'数据集的标准差为: {transfer.scale_}')
对于标准化来说,如果出现异常点,由于具有一定数据量,少量的异常点对于平均值的影响并不大
✋
🤖一句话区分使用边界
- 归一化
✅ 归一化适合:值域固定、确定无离群点(像素)
❌ 归一化不适合:值域不确定、存在异常值、真实业务大数据- 标准化
✅ 标准化适合:大多数业务数据集,含少量异常点;KNN、SVM、PCA
❌ 标准化不适合:需要把数据严格限定在 0~1 范围的场景
【实操】利用KNN算法进行鸢尾花分类
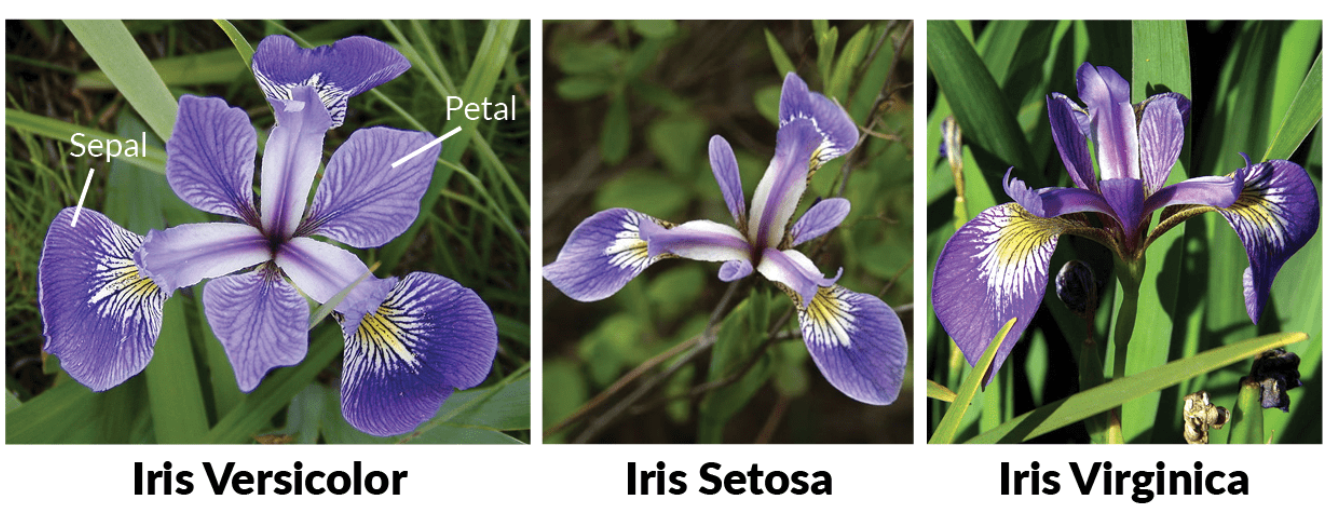
鸢尾花Iris Dataset数据集是机器学习领域经典数据集,鸢尾花数据集包含了150条鸢尾花信息,每50条取自三个鸢尾花中之一:Versicolour、Setosa和Virginica
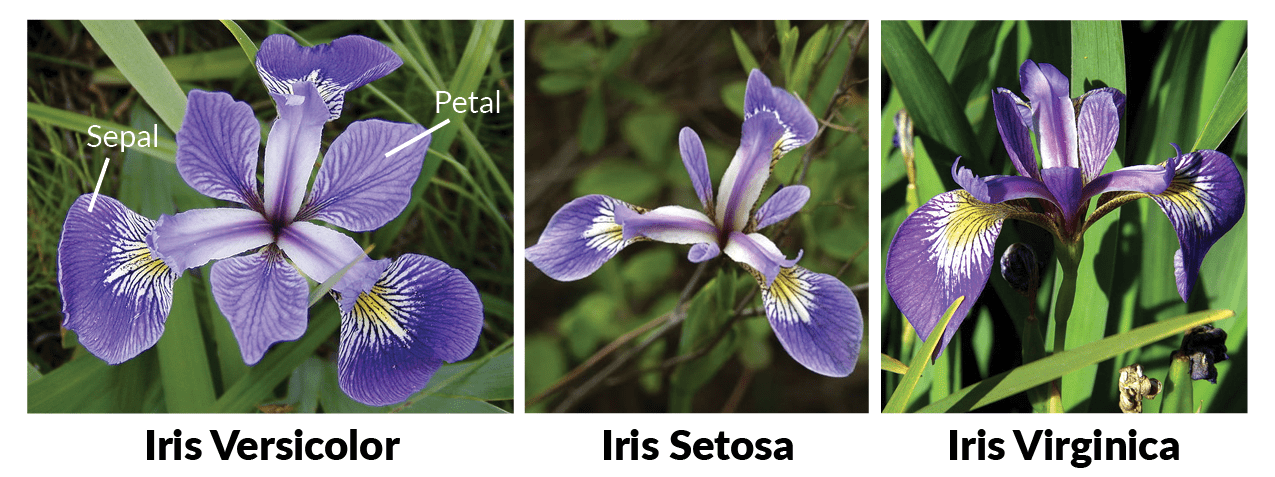
每个花的特征用如下属性描述:
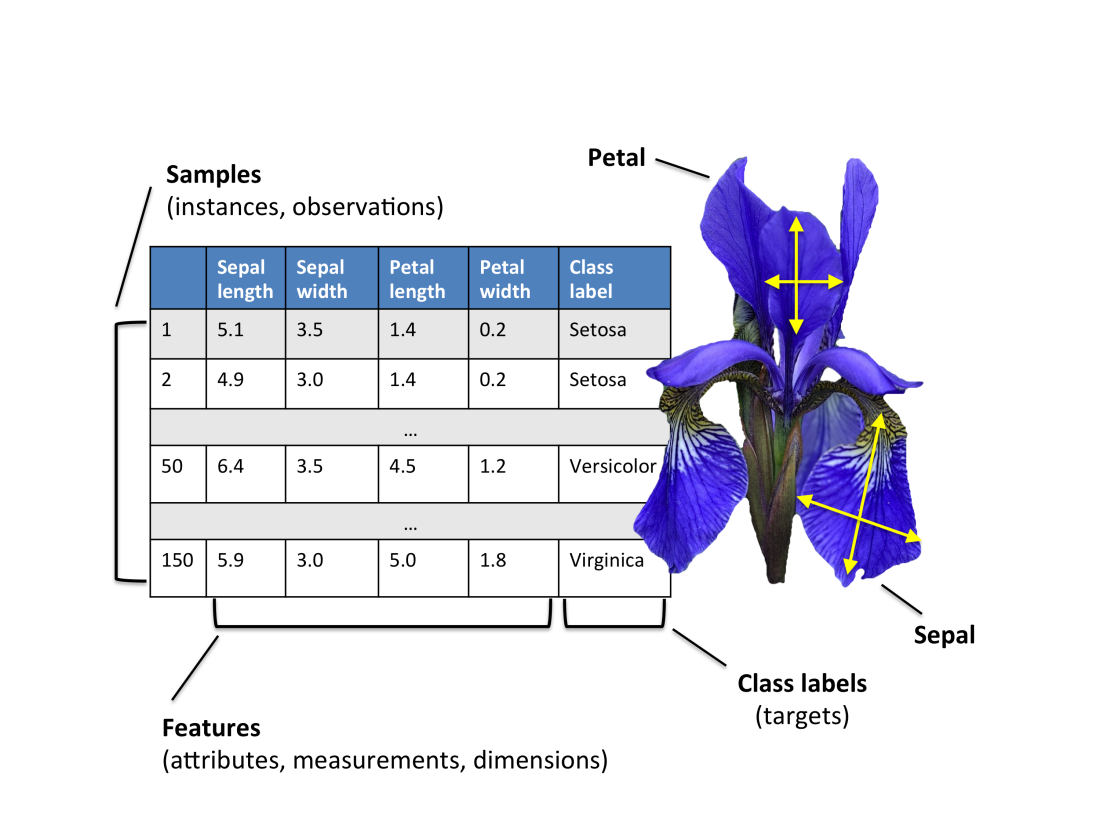
代码实现:
python
"""
案例: 通过KNN算法实现 鸢尾花的 分类操作.

回顾: 机器学习项目的研发流程
    1. 加载数据.
    2. 数据的预处理.
    3. 特征工程(提取, 预处理...)
    4. 模型训练.
    5. 模型评估.
    6. 模型预测.
"""

# 导入工具包
from sklearn.datasets import load_iris                  # 加载鸢尾花测试集的.
import seaborn as sns
import pandas as pd
import matplotlib.pyplot as plt
from sklearn.model_selection import train_test_split   # 分割训练集和测试集的
from sklearn.preprocessing import StandardScaler        # 数据标准化的
from sklearn.neighbors import KNeighborsClassifier      # KNN算法 分类对象
from sklearn.metrics import accuracy_score              # 模型评估的, 计算模型预测的准确率


# 1. 定义函数, 加载鸢尾花数据集, 并查看数据集.
def dm01_load_iris():
    # 1. 加载鸢尾花数据集.
    iris_data = load_iris()
    # 2. 查看数据集.
    # print(f'数据集: {iris_data}')              # 字典形态
    # print(f'数据集的类型: {type(iris_data)}')   # <class 'sklearn.utils._bunch.Bunch'>
    # 3. 查看数据集所有的键.
    print(f'数据集所有的键: {iris_data.keys()}')
    # 4. 查看数据集的键对应的值.
    # print(f'具体的数据: {iris_data.data[:5]}')            # 有150条数据, 每条数据有4个特征. 我们只看前5条
    # print(f'具体的标签: {iris_data.target[:5]}')          # 有150条数据, 每条数据有1个标签. 我们只看前5条

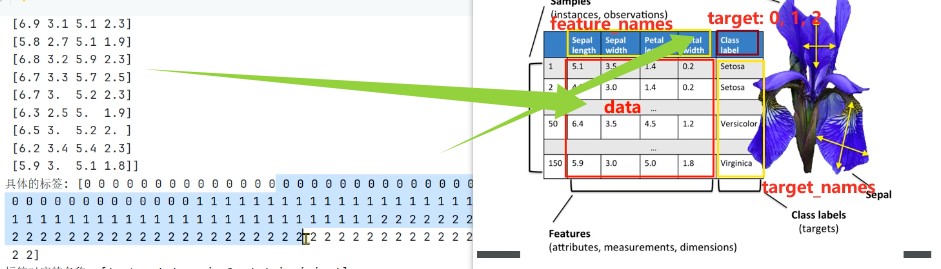
    print(f'具体的数据: {iris_data.data}')
    print(f'具体的标签: {iris_data.target}')
    print(f'标签对应的名称: {iris_data.target_names}')     # ['setosa' 'versicolor' 'virginica']
    print(f'特征对应的名称: {iris_data.feature_names}')    # ['sepal length (cm)', 'sepal width (cm)', 'petal length (cm)', 'petal width (cm)']
    # print(f'数据集的描述: {iris_data.DESCR}')
    # print(f'数据集的框架: {iris_data.frame}')               # None
    # print(f'数据集的文件名: {iris_data.filename}')             # iris.csv
    # print(f'数据集的模型(在哪个包下): {iris_data.data_module}') # sklearn.datasets.data

# 2. 定义函数, 绘制数据集的散点图.
def dm02_show_iris():
    # 1. 加载数据集.
    iris_data = load_iris()
    # 2. 把 鸢尾花数据集封装成 DataFrame对象.
    iris_df = pd.DataFrame(iris_data.data, columns=iris_data.feature_names)
    # 3. 给df对象新增1列 -> 标签列.
    iris_df['label'] = iris_data.target
    # print(iris_df)

    # 4. 通过 Seaborn绘制散点图.
    # 参1: 数据集. 参2: x轴. 参3: y轴. 参4: 分组字段. 参5: 是否显示拟合线.
    sns.lmplot(data=iris_df, x='sepal length (cm)', y='sepal width (cm)', hue='label', fit_reg=True)
    # 5. 设置标题, 显式.
    plt.title('iris data')
    plt.tight_layout()      # 自动调整子图参数, 以使整个图像的边界与子图匹配.
    plt.show()


# 3. 定义函数, 切分训练集和测试集.
def dm03_split_train_test():
    # 1. 加载数据集.
    iris_data = load_iris()

    # 2. 数据的预处理: 从150个特征和标签中, 按照 8:2的比例, 切分训练集和测试集.
    # 参1: 特征数据. 参2: 标签数据. 参3: 测试集的比例.  参4: 随机种子(种子一致, 每次生成的随机数据集都是固定的)
    # 返回值: 训练集的特征数据, 测试集的特征数据, 训练集的标签数据, 测试集的标签数据.
    x_train, x_test, y_train, y_test = train_test_split(iris_data.data, iris_data.target, test_size=0.2, random_state=23)

    # 3. 打印切割后的结果.
    print(f'训练集的特征: {x_train}, 个数: {len(x_train)}')     # 120条, 每条4列(特征)
    print(f'训练集的标签: {y_train}, 个数: {len(y_train)}')     # 120条, 每条1列(标签)
    print(f'测试集的特征: {x_test}, 个数: {len(x_test)}')       # 30条, 每条4列(特征)
    print(f'测试集的标签: {y_test}, 个数: {len(y_test)}')       # 30条, 每条1列(标签)


# 4. 定义函数, 实现鸢尾花完整案例 -> 加载数据, 数据预处理, 特征工程, 模型训练, 模型评估, 模型预测.
def dm04_iris_evaluate_test():
    # 1. 加载数据集.
    iris_data = load_iris()
    # 2. 数据的预处理, 这里是把150条数据, 按照 8:2的比例, 切分训练集和测试集.
    x_train, x_test, y_train, y_test = train_test_split(iris_data.data, iris_data.target, test_size=0.2, random_state=23)

    # 3. 特征工程(提取, 预处理...)
    # 思考1: 特征提取: 因为源数据只有4个特征列, 且都是我们用的, 所以这里无需做特征提取.
    # 思考2: 特征预处理: 因为源数据的4列特征差值不大, 所以我们无需做特征预处理, 但是, 加入特征预处理会让我们的代码更完善, 所以加入.
    # 3.1 创建标准化对象.
    transfer = StandardScaler()
    # 3.2 对特征列进行标准化, 即: x_train: 训练集的特征数据, x_test: 测试集的特征数据.
    # fit_transform: 兼具fit和transform的功能, 即: 训练, 转换. 该函数适用于: 第一次进行标准化的时候使用. 一般用于处理: 训练集.
    x_train = transfer.fit_transform(x_train)
    # transform: 只有转换. 该函数适用于: 重复进行标准化动作时使用, 一般用于对测试集进行标准化.
    x_test = transfer.transform(x_test)

    # 4. 模型训练.
    # 4.1 创建模型对象.
    estimator = KNeighborsClassifier(n_neighbors=3)
    # 4.2 具体的训练模型的动作.
    estimator.fit(x_train, y_train)     # 传入: 训练集的特征数据, 训练集的标签数据

    # 5. 模型预测.
    # 场景1: 对刚才切分的 测试集(30条) 进行测试.
    # 5.1 直接预测即可, 获取到: 预测结果
    y_pre = estimator.predict(x_test)       # x_test: 测试集的特征数据
    # 5.2 打印预测结果.
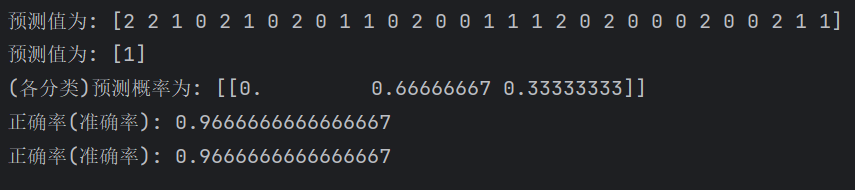
    print(f'预测值为: {y_pre}')

    # 场景2: 对新的数据集(源数据150条 之外的数据) 进行测试.
    # 5.1 自定义测试数据集.
    my_data = [[7.8, 2.1, 3.9, 1.6]]
    # 5.2 对数据集进行标准化处理.
    my_data = transfer.transform(my_data)
    # 5.3 模型预测.
    y_pre_new = estimator.predict(my_data)
    print(f'预测值为: {y_pre_new}')

    # 5.4 查看上述数据集, 每种分类的预测概率.
    y_pre_proba = estimator.predict_proba(my_data)
    print(f'(各分类)预测概率为: {y_pre_proba}')         # [[0, 0.66666667, 0.33333333]] -> 0分类的概率, 1分类的概率, 2分类的概率.

    # 6. 模型评估.
    # 方式1: 直接评分, 基于: 测试集的特征 和 测试集集的标签.
    print(f'正确率(准确率): {estimator.score(x_test, y_test)}')     # 0.9666666666666667

    # 方式2: 基于 测试集的标签 和 预测结果 进行评分.
    print(f'正确率(准确率): {accuracy_score(y_test, y_pre)}')         # 0.9666666666666667

# 5. 测试.
if __name__ == '__main__':
    # dm01_load_iris()
    # dm02_show_iris()
    # dm03_split_train_test()
dm04_iris_evaluate_test()- 查看数据集
python
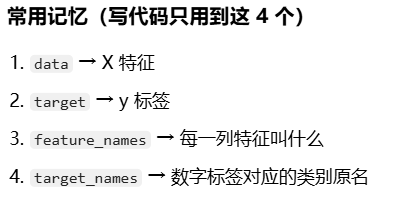
数据集所有的键: dict_keys(['data', 'target', 'frame', 'target_names', 'DESCR', 'feature_names', 'filename', 'data_module'])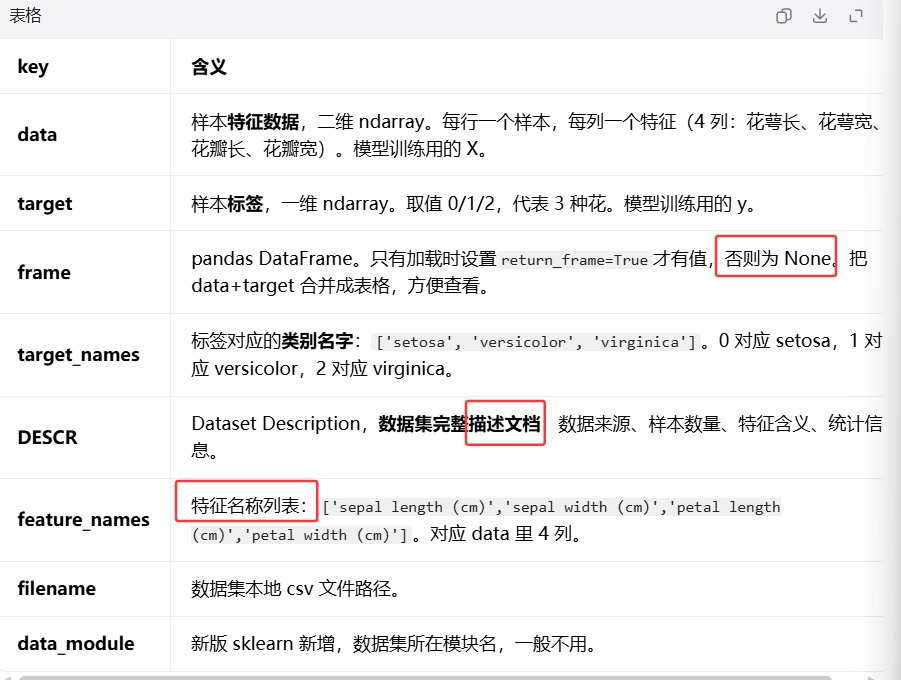
- 数据集可视化
python
# 2. 定义函数, 绘制数据集的散点图.
def dm02_show_iris():
    # 1. 加载数据集.
    iris_data = load_iris()
    # 2. 把 鸢尾花数据集封装成 DataFrame对象.
    iris_df = pd.DataFrame(iris_data.data, columns=iris_data.feature_names)
    # 3. 给df对象新增1列 -> 标签列.
    iris_df['label'] = iris_data.target
    # print(iris_df)

    # 4. 通过 Seaborn绘制散点图.
    # 参1: 数据集. 参2: x轴. 参3: y轴. 参4: 分组字段. 参5: 是否显示拟合线.
    sns.lmplot(data=iris_df, x='sepal length (cm)', y='sepal width (cm)', hue='label', fit_reg=True)
    # 5. 设置标题, 显式.
    plt.title('iris data')
    plt.tight_layout()      # 自动调整子图参数, 以使整个图像的边界与子图匹配.
    plt.show()
✋
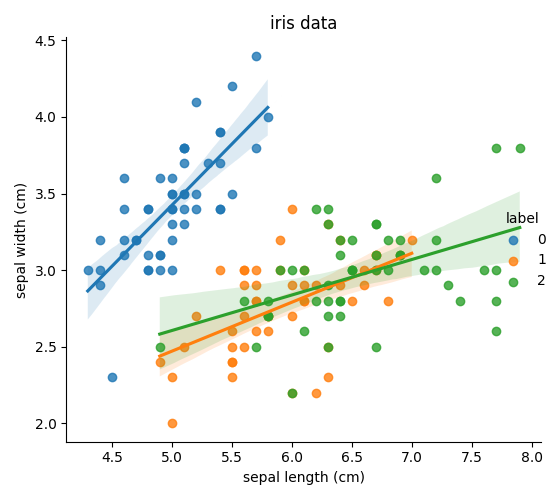
绘制散点图作用:看数据分布,观察不同类别是否能分开,找异常点,看特征之间关系。
- 切分训练集和测试集
python
# 3. 定义函数, 切分训练集和测试集.
def dm03_split_train_test():
    # 1. 加载数据集.
    iris_data = load_iris()

    # 2. 数据的预处理: 从150个特征和标签中, 按照 8:2的比例, 切分训练集和测试集.
    # 参1: 特征数据. 参2: 标签数据. 参3: 测试集的比例.  参4: 随机种子(种子一致, 每次生成的随机数据集都是固定的)
    # 返回值: 训练集的特征数据, 测试集的特征数据, 训练集的标签数据, 测试集的标签数据.
    x_train, x_test, y_train, y_test = train_test_split(iris_data.data, iris_data.target, test_size=0.2, random_state=23)

    # 3. 打印切割后的结果.
    print(f'训练集的特征: {x_train}, 个数: {len(x_train)}')     # 120条, 每条4列(特征)
    print(f'训练集的标签: {y_train}, 个数: {len(y_train)}')     # 120条, 每条1列(标签)
    print(f'测试集的特征: {x_test}, 个数: {len(x_test)}')       # 30条, 每条4列(特征)
    print(f'测试集的标签: {y_test}, 个数: {len(y_test)}')       # 30条, 每条1列(标签)
随机种子用来固定随机打乱的规则,保证每次切分训练集测试集得到相同样本,方便实验复现和参数对比。
- 实现鸢尾花完整案例
📚什么时候fittransfor,什么时候transfor?
- fit 阶段:拿训练集算一遍,把 4 个特征的均值、标准差写死在计算器面板上
- transform 阶段:不管传入测试集还是新样本,直接读取面板上保存好的数字计算,不再重新统计。
- (不能对测试集 fit)
如果对测试集执行 fit,就会用测试集的数据算出新均值标准差,相当于模型提前偷看测试数据 → 数据泄露,评估结果虚假。
📚类比 :老师手里有参考答案(y_test),学生(模型)看不到。 给学生题目(x_test),学生写出自己的答案(y_pre)。
✋
超参数选择的方法
学习目标:
1.知道交叉验证是什么?
2.知道网格搜索是什么?
3.知道交叉验证网格搜索API函数用法
4.能实践交叉验证网格搜索进行模型超参数调优
5.利用KNN算法实现手写数字识别
【知道】交叉验证
交叉验证是一种数据集的分割方法,将训练集划分为 n 份,其中一份做验证集、其他n-1份做训练集集
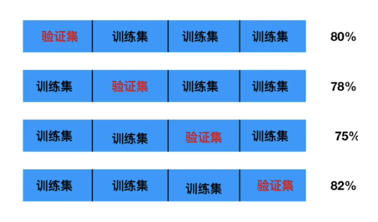
交叉验证法原理:将数据集划分为 cv=10 份:
1.第一次:把第一份数据做验证集,其他数据做训练
2.第二次:把第二份数据做验证集,其他数据做训练
3... 以此类推,总共训练10次,评估10次。
4.使用训练集+验证集多次评估模型,取平均值做交叉验证为模型得分
5.若k=5模型得分最好,再使用全部训练集(训练集+验证集) 对k=5模型再训练一边,再使用测试集对k=5模型做评估

【知道】网格搜索
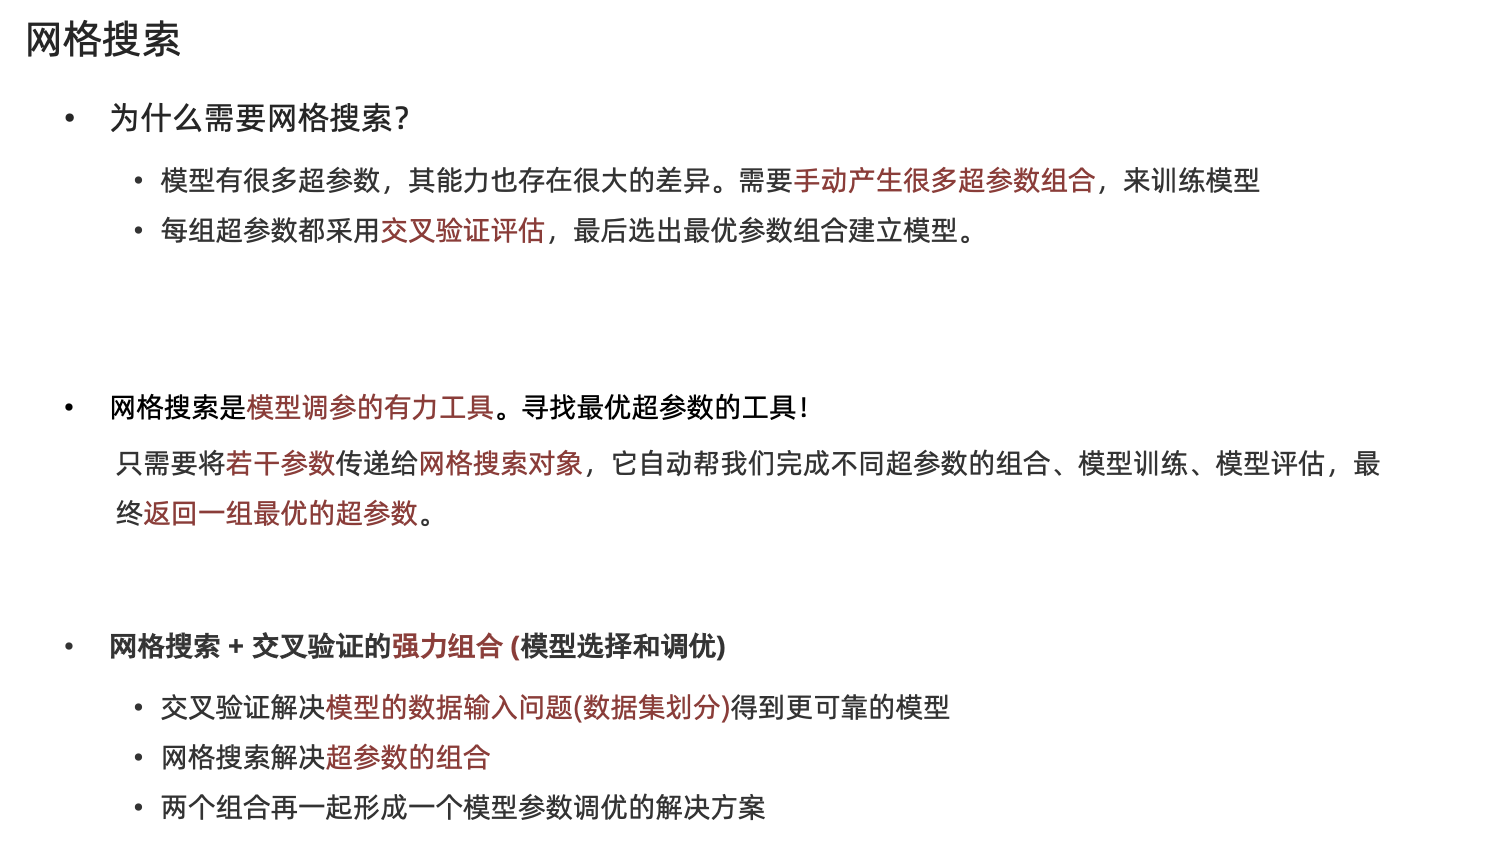
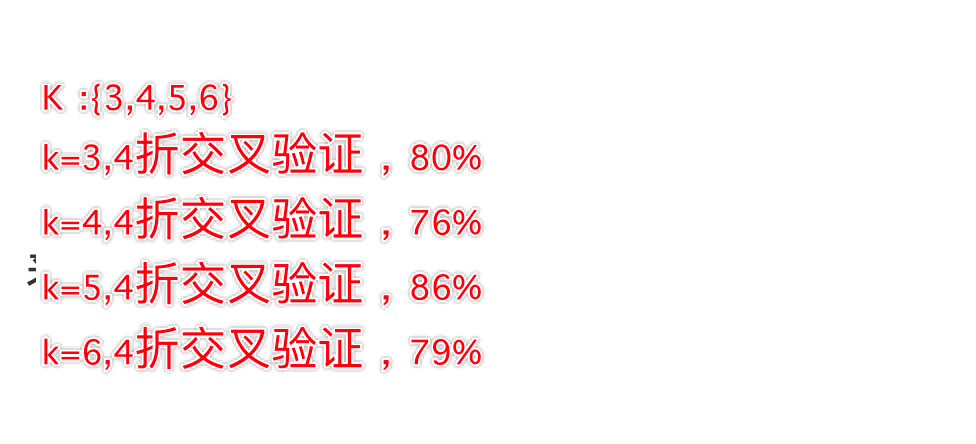
每组超参数都采用交叉验证评估
eg:
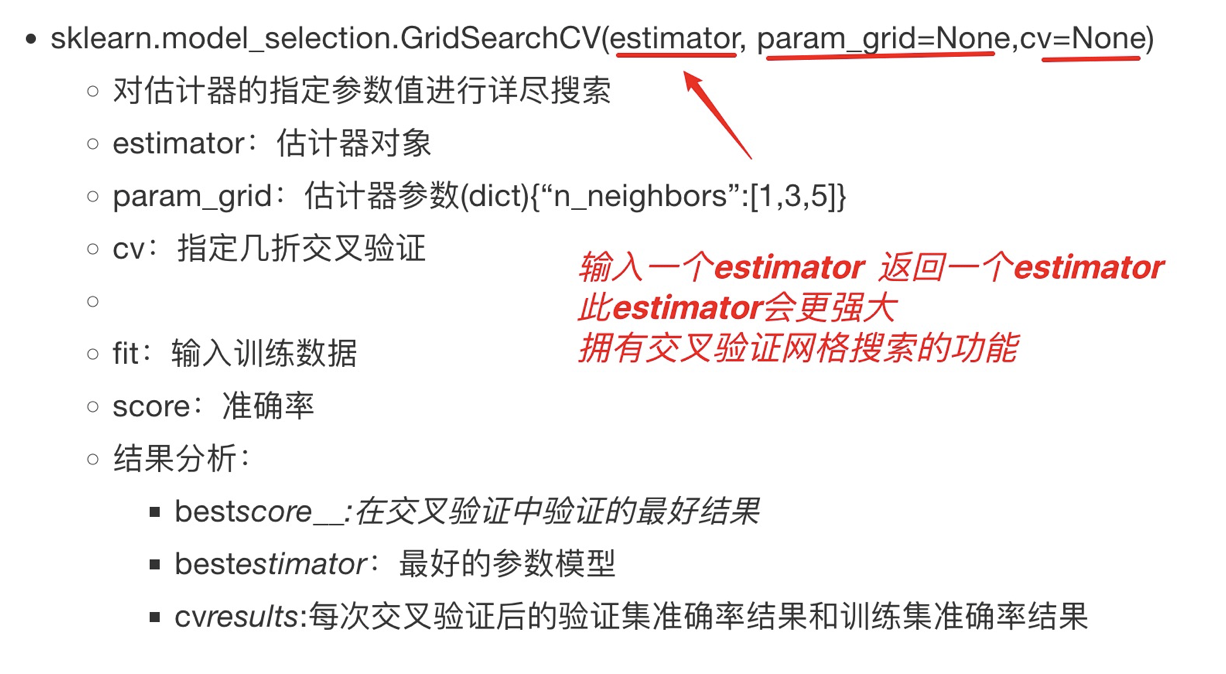
交叉验证网格搜索的API:
交叉验证网格搜索在鸢尾花分类中的应用:
python
"""
案例: 演示网格搜索 和 交叉验证.

交叉验证解释:
    原理:
        把数据分成n份, 例如分成: 4份  -> 也叫: 4折交叉验证.
        第1次: 把第1份数据作为 验证集(测试集), 其它作为训练集, 训练模型, 模型预测, 获取: 准确率 -> 准确率1
        第2次: 把第2份数据作为 验证集(测试集), 其它作为训练集, 训练模型, 模型预测, 获取: 准确率 -> 准确率2
        第3次: 把第3份数据作为 验证集(测试集), 其它作为训练集, 训练模型, 模型预测, 获取: 准确率 -> 准确率3
        第4次: 把第4份数据作为 验证集(测试集), 其它作为训练集, 训练模型, 模型预测, 获取: 准确率 -> 准确率4
        然后计算上述的 4次准确率的 平均值, 作为: 模型最终的 准确率.

        假设第4次最好(准确率最高), 则: 用全部数据(训练集 + 测试集)训练模型, 再次用(第4次的)测试集对模型测试.
    目的:
        为了让模型的最终验真结果更准确.

网格搜索:
    目的/作用:
        寻找最优超参数.
    原理:
        接收超参可能出现的值, 然后针对于 超参的每个值进行 交叉验证, 获取到 最优超参组合.
    超参数:
        需要用户手动录入的数据, 不同的超参(组合), 可能会影响模型的最终评测结果.

大白话解释:
    网格搜索 + 交叉验证, 本质上指的是 GridSearchCV这个API, 它会帮我们寻找最优超参(供参考).
"""
# 导入工具包
from sklearn.datasets import load_iris                               # 加载鸢尾花测试集的.
from sklearn.model_selection import train_test_split, GridSearchCV   # 分割训练集和测试集的, 寻找最优超参的(网格搜索 + 交叉验证).
from sklearn.preprocessing import StandardScaler                     # 数据标准化的
from sklearn.neighbors import KNeighborsClassifier                   # KNN算法 分类对象
from sklearn.metrics import accuracy_score                           # 模型评估的, 计算模型预测的准确率


# 1. 加载鸢尾花数据集.
iris_data = load_iris()

# 2. 数据预处理, 这里是: 切分训练集和测试集, 比例: 8:2
# 参1: 数据集的特征数据,   参数2: 数据集的标签数据, 参数3: 测试集的比例, 参数4: 随机种子.
x_train, x_test, y_train, y_test = train_test_split(iris_data.data, iris_data.target, test_size=0.2, random_state=22)

# 3. 特征工程 -> 特征预处理 -> 标准化.
# 3.1 创建标准化对象.
transfer = StandardScaler()
# 3.2 对训练集和测试集的特征数据进行标准化.
x_train = transfer.fit_transform(x_train)
x_test = transfer.transform(x_test)

# 4. 模型训练.
# 4.1 创建 KNN分类对象.
estimator = KNeighborsClassifier()
# 4.2 定义字典, 记录 超参可能出现的情况(值).
param_dict = {'n_neighbors': [i for i in range(1, 11)]}     # i的值: 1 ~ 10
# 4.3 创建 GridSearchCV对象 -> 寻找最优超参, 使用网格搜索 + 交叉验证方式
# 参1: 要计算最优超参的模型对象
# 参2: 该模型超参可能出现的值
# 参3: 交叉验证的折数, 这里的4折表示: 每个超参组合, 都会进行4次交叉验证.  这里共计是 4 * 10 = 40次.
# 返回值 estimator -> 处理后的模型对象.
estimator = GridSearchCV(estimator, param_dict, cv=4)
# 4.4 具体的模型训练动作.
estimator.fit(x_train, y_train)
# 4.5 打印最优超参组合.
print(f'最优评分: {estimator.best_score_}')                 # 0.9666666666666668
print(f'最优超参组合: {estimator.best_params_}')             # {'n_neighbors': 3}
print(f'最优的估计器对象: {estimator.best_estimator_}')      # KNeighborsClassifier(n_neighbors=3)
print(f'具体的交叉验证结果: {estimator.cv_results_}')


# 5. 模型评估.
# 5.1 获取最优超参的 模型对象.
# estimator = estimator.best_estimator_                 # 获取最优的模型对象.
estimator = KNeighborsClassifier(n_neighbors=3)
# 5.2 模型训练.
estimator.fit(x_train, y_train)
# 5.3 模型预测.
y_pre = estimator.predict(x_test)
# 5.4 模型评估.
# 参1: 测试集.   参2: 预测集
print(f'准确率: {accuracy_score(y_test, y_pre)}')        # 0.9666666666666667
利用KNN算法实现手写数字识别
MNIST手写数字识别 是计算机视觉领域中 "hello world"级别的数据集
- 1999年发布,成为分类算法基准测试的基础
- 随着新的机器学习技术的出现,MNIST仍然是研究人员和学习者的可靠资源。
本次案例中,我们的目标是从数万个手写图像的数据集中正确识别数字。
数据介绍
数据文件 train.csv 和 test.csv 包含从 0 到 9 的手绘数字的灰度图像。
-
每个图像高 28 像素,宽28 像素,共784个像素。
-
每个像素取值范围0,255,取值越大意味着该像素颜色越深
-
训练数据集(train.csv)共785列。第一列为 "标签",为该图片对应的手写数字。其余784列为该图像的像素值
-
训练集中的特征名称均有pixel前缀,后面的数字(0,783)代表了像素的序号。
像素组成图像如下:
python
000 001 002 003 ... 026 027
028 029 030 031 ... 054 055
056 057 058 059 ... 082 083
 | | | | ...... | |
728 729 730 731 ... 754 755
756 757 758 759 ... 782 783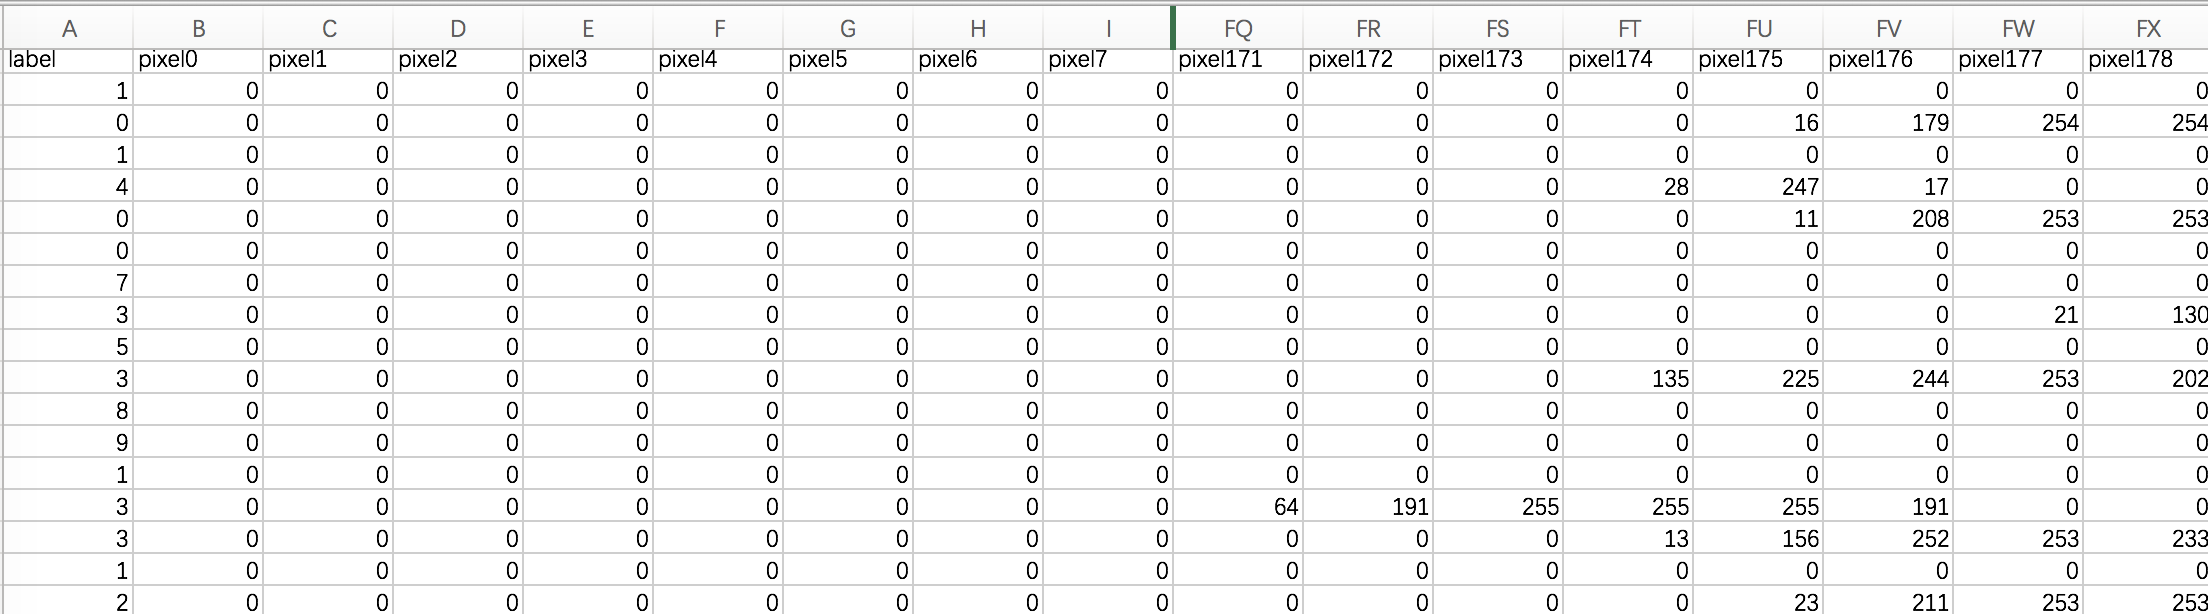
python
"""
案例: 演示 KNN算法 识别图片, 即: 手写数字识别案例.

介绍:
    每张图片都是由 28 * 28 像素组成的, 即: 我们的csv文件中每一行都有 784个像素点, 表示图片(每个像素)的 颜色.
    最终构成图像.
"""

import matplotlib.pyplot as plt
import pandas as pd
from sklearn.metrics import accuracy_score
from sklearn.model_selection import train_test_split
from sklearn.neighbors import KNeighborsClassifier
import joblib
from collections import Counter

# 扩展: 忽略警告.
import warnings
warnings.filterwarnings('ignore', module='sklearn') # 参1: 忽略警告, 参2: 忽略的模块.

# 1. 定义函数, 接收用户传入的索引, 展示 该索引对应的图片.
def show_digit(idx):
    # 1. 读取数据集, 获取到源数据.
    df = pd.read_csv('./data/手写数字识别.csv')
    # print(df)       # (42000行 * 785列)

    # 2. 判断传入的索引是否越界.
    if idx < 0 or idx > len(df) - 1:
        print('索引越界!')
        return

    # 3. 走这里, 说明没有越界, 就正常获取数据.
    x = df.iloc[:, 1:]
    y = df.iloc[:, 0]

    # 4. 查看用户传入的索引对应的图片 -> 是几?
    print(f'该图片对应的数字是: {y.iloc[idx]}')
    print(f'查看所有的标签的分布情况: {Counter(y)}')

    # 5. 查看下 用户传入的索引对应的图片 的形状
    print(x.iloc[idx].shape)       # (784,)  我们要想办法把 (784,) 转换成 (28, 28)
    # print(x.iloc[idx].values)      # 具体的784个像素点数据

    # 6. 把 (784,) 转换成 (28, 28)
    x = x.iloc[idx].values.reshape(28, 28)
    # print(x)   # 28 * 28像素点

    # 7. 具体的绘制灰度图的动作.
    plt.imshow(x, cmap='gray')      # 灰度图
    plt.axis('off')                 # 不显示坐标轴
    plt.show()


# 2. 定义函数, 训练模型, 并保存训练好的模型.
def train_model():
    # 1. 加载数据集.
    df = pd.read_csv('./data/手写数字识别.csv')
    # 2. 数据的预处理.
    # 2.1 拆分出特征列.
    x = df.iloc[:, 1:]      # 特征列.
    # 2.2 拆分出标签列.
    y = df.iloc[:, 0]       # 标签列.
    # 2.3 打印特征和标签的形状
    print(f'x的形状: {x.shape}')       # (42000, 784)
    print(f'y的形状: {y.shape}')       # (42000,)
    print(f'查看所有的标签的分布情况: {Counter(y)}')
    # 2.4 对特征列(拆分前)进行 归一化.
    x = x / 255
    # 2.5 拆分训练集和测试集.
    # 参1: 特征列.    参2: 标签列.      参3: 测试集的比例.    参4: 随机种子.      参5: 参考y值进行抽取, 保持标签的比例(数据均衡)
    x_train, x_test, y_train, y_test = train_test_split(x, y, test_size=0.2, random_state=21, stratify=y)

    # 3. 模型训练.
    # 3.1 创建模型对象.
    estimator = KNeighborsClassifier(n_neighbors=3)
    # 3.2 模型训练.
    estimator.fit(x_train, y_train)

    # 4. 模型评估.
    print(f'准确率: {estimator.score(x_test, y_test)}')
    print(f'准确率: {accuracy_score(y_test, estimator.predict(x_test))}')

    # 5. 保存模型.
    # 参1: 模型对象.    参2: 模型保存的路径.
    joblib.dump(estimator, './model/手写数字识别.pkl')        # pickle文件: Python(Pandas)独有的文件类型.
    print('模型保存成功!')

# 3. 定义函数, 测试模型.
def use_model():
    # 1. 加载图片.
    x = plt.imread('./data/demo.png')       # 28 * 28像素
    # 2. 绘制图片.
    # plt.imshow(x, cmap='gray')              # 灰度图
    # plt.axis('off')                         # 不显示坐标轴
    # plt.show()

    # 3. 加载模型.
    estimator = joblib.load('./model/手写数字识别.pkl')

    # 4. 模型预测.
    # 4.1 查看 数据集转换.
    print(x.shape)                  # (28, 28)
    print(x.reshape(1, 784).shape)  # (1, 784)
    print(x.reshape(1, -1).shape)   # 效果等同于 (1, 784), 语法糖.

    # 4.2 具体的转换动作, 记得: 归一化(因为训练模型的时候 使用了 归一化动作)
    # x = x.reshape(1, -1) / 255      # 可能会预测失败, 因为读图的时候, 像素值可能不是特别的精准.
    x = x.reshape(1, -1)              # 用原始的读取到的像素值, 做预测.

    # 4.3 模型预测.
    y_pre = estimator.predict(x)

    # 5. 打印预测结果.
    print(f'预测值为: {y_pre}')


# 4. 测试.
if __name__ == '__main__':
    # 绘制数字
    # show_digit(9)
    # show_digit(20)
    # show_digit(23)

    # 训练模型, 并保存模型.
    # train_model()

    # 模型预测(使用模型)
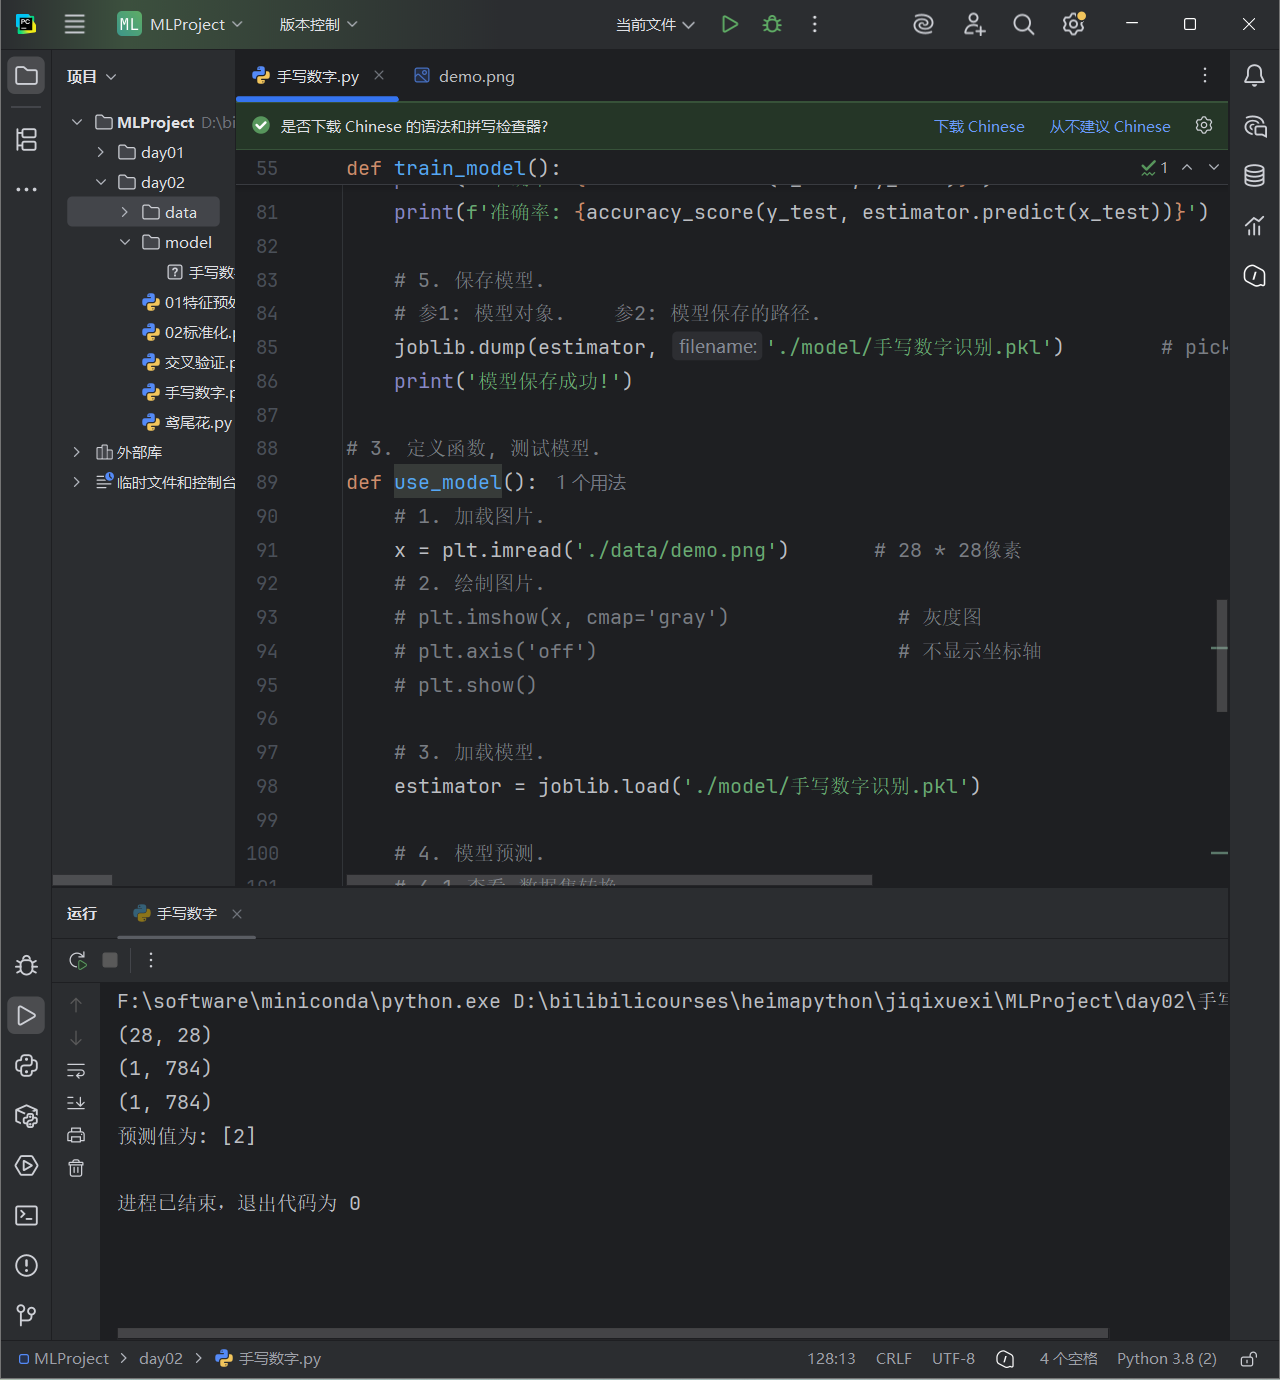
use_model()- 绘制数字
python
# 1. 定义函数, 接收用户传入的索引, 展示 该索引对应的图片.
def show_digit(idx):
    # 1. 读取数据集, 获取到源数据.
    df = pd.read_csv('./data/手写数字识别.csv')
    # print(df)       # (42000行 * 785列)

    # 2. 判断传入的索引是否越界.
    if idx < 0 or idx > len(df) - 1:
        print('索引越界!')
        return

    # 3. 走这里, 说明没有越界, 就正常获取数据.
    x = df.iloc[:, 1:]   #取特征
    y = df.iloc[:, 0]   #取标签

    # 4. 查看用户传入的索引对应的图片 -> 是几?
    print(f'该图片对应的数字是: {y.iloc[idx]}')
    print(f'查看所有的标签的分布情况: {Counter(y)}')

    # 5. 查看下 用户传入的索引对应的图片 的形状
    print(x.iloc[idx].shape)       # (784,)  我们要想办法把 (784,) 转换成 (28, 28)
    # print(x.iloc[idx].values)      # 具体的784个像素点数据

    # 6. 把 (784,) 转换成 (28, 28)
    x = x.iloc[idx].values.reshape(28, 28)
    # print(x)   # 28 * 28像素点

    # 7. 具体的绘制灰度图的动作.
    plt.imshow(x, cmap='gray')      # 灰度图
    plt.axis('off')                 # 不显示坐标轴
    plt.show()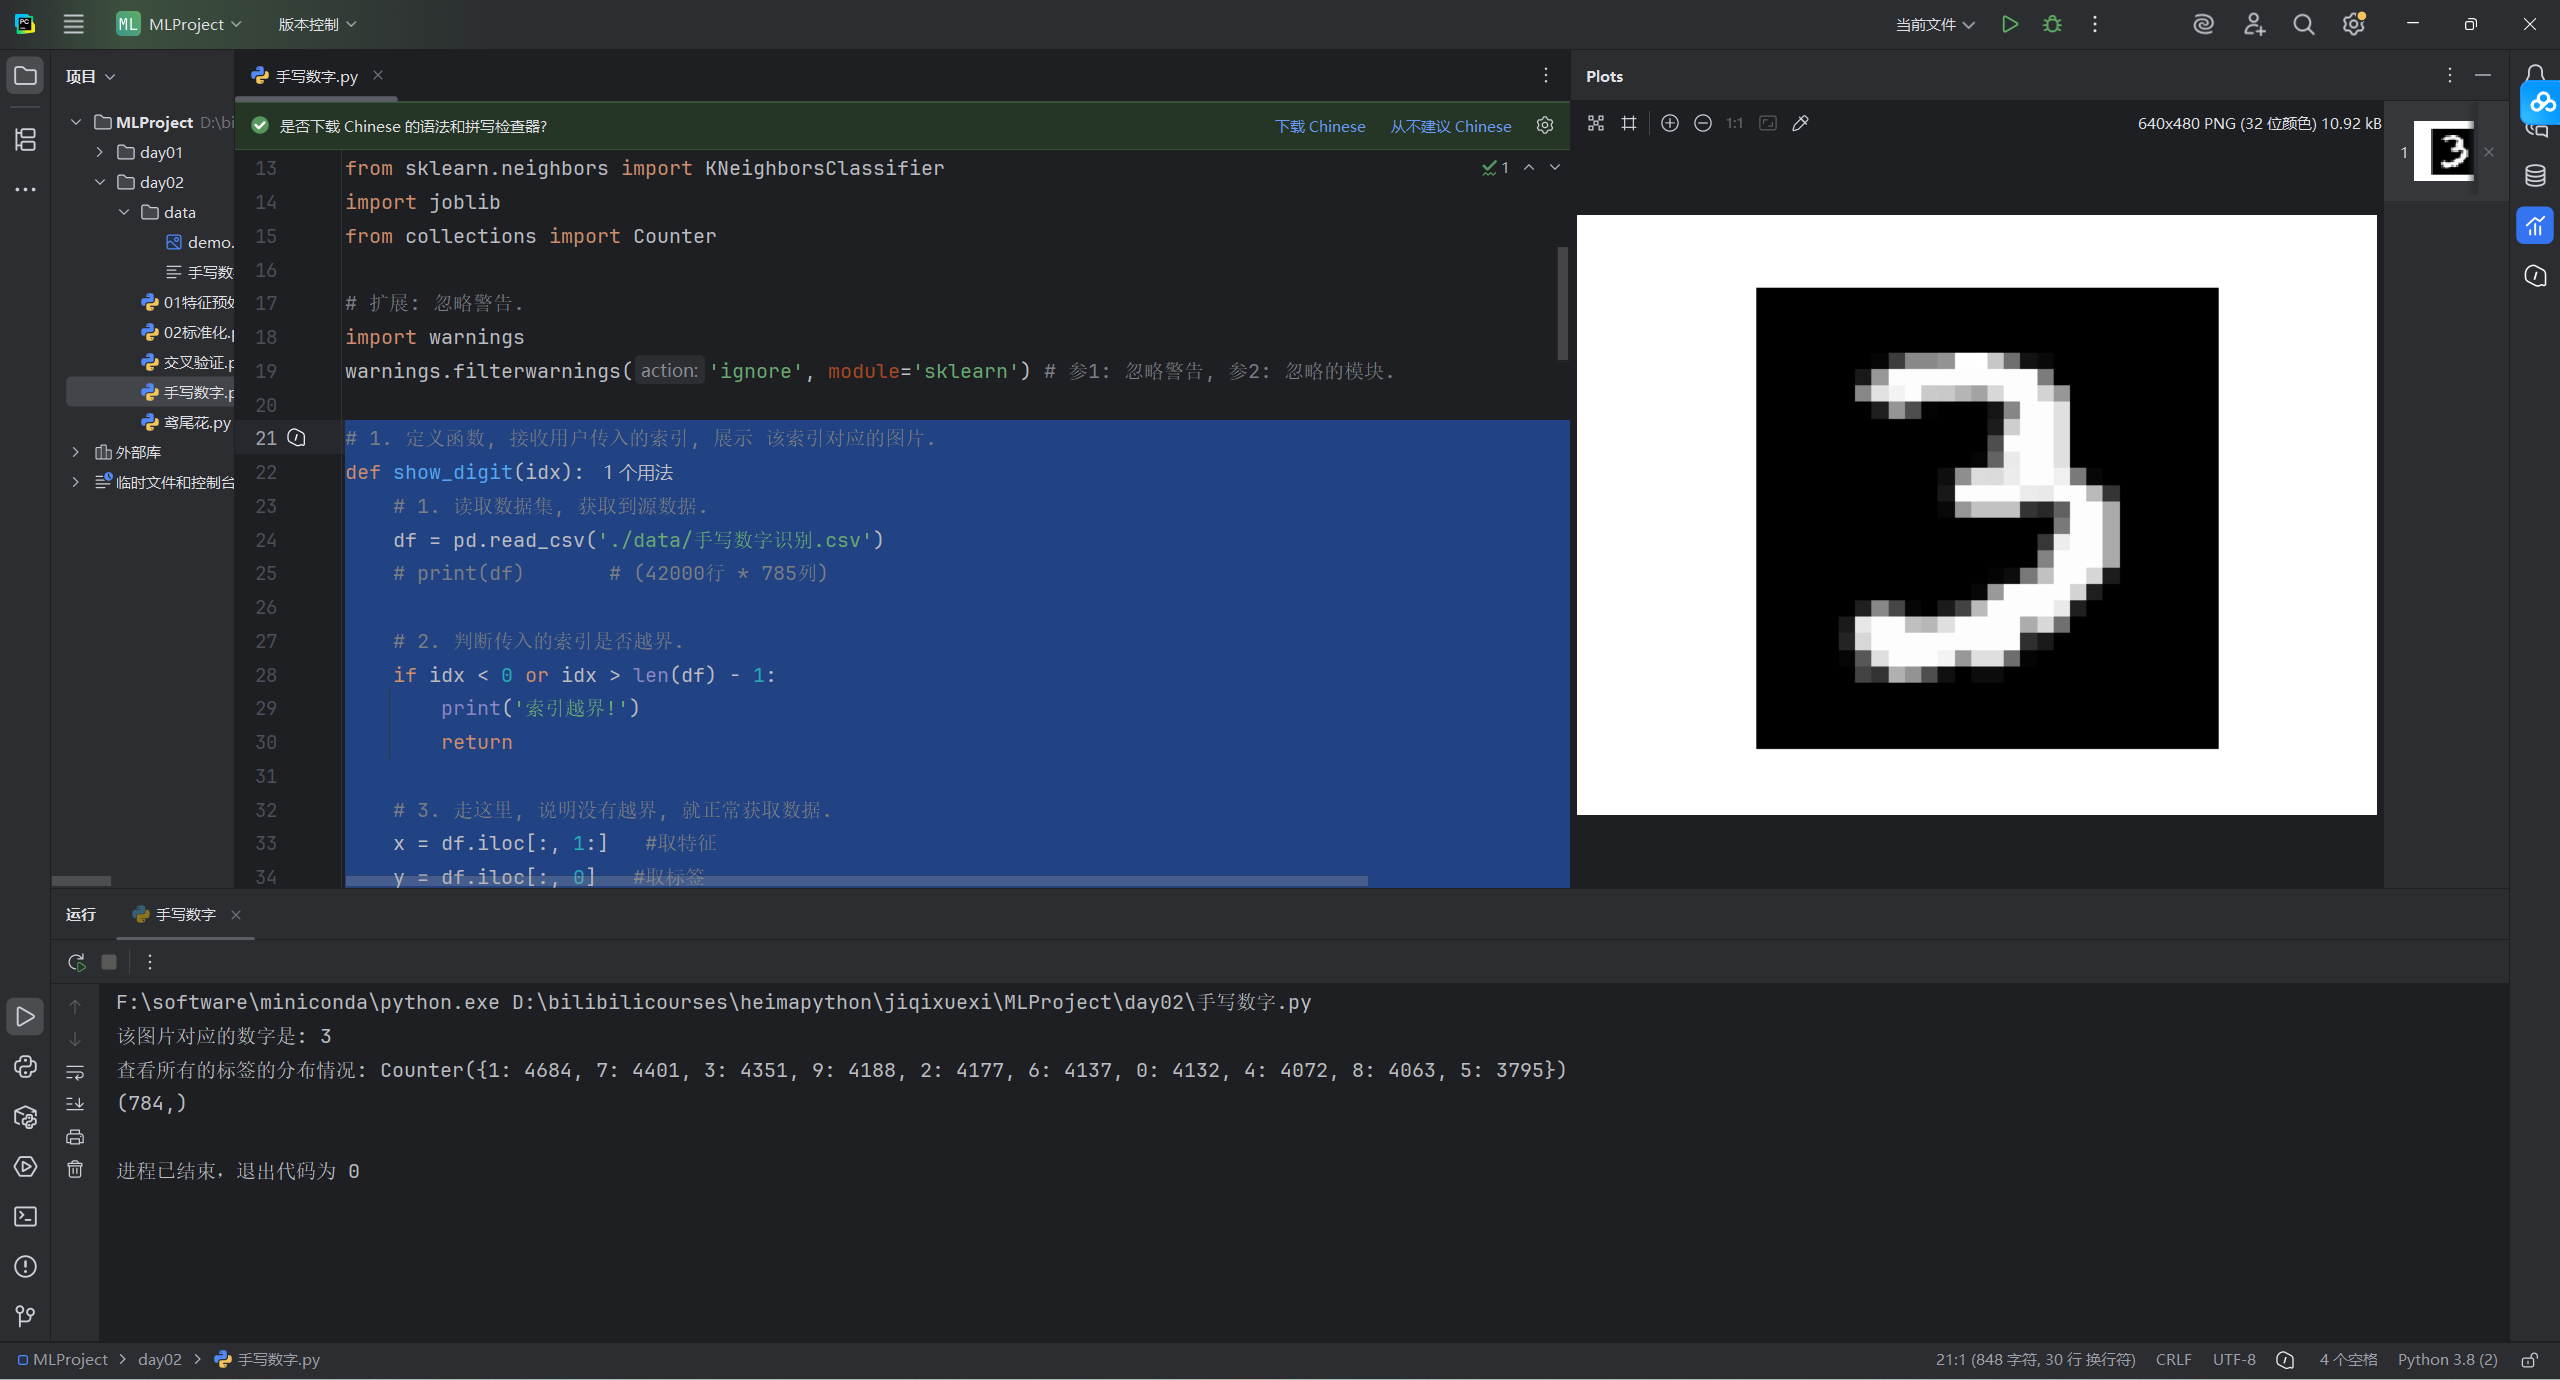
- 训练和保存模型
python
# 2.4 对特征列(拆分前)进行 归一化.
    x = x / 255
📚
问题:MNIST 所有像素特征区间都是 0~255,为什么还要做归一化(x/255)?
回答:所有像素取值范围一致,不存在量纲差异。归一化主要是缩小数值,方便计算,也是行业习惯;对于 KNN 模型,这一步不是必需的,对结果影响很小。
python
 # 4. 模型评估.
    print(f'准确率: {estimator.score(x_test, y_test)}')
print(f'准确率: {accuracy_score(y_test, estimator.predict(x_test))}')x_test:测试集特征(图片像素),用来让模型做预测y_test:测试集真实标签(标准答案),用来对比对错- 内部自动:
predict(x_test)→ 得到预测结果 → 和y_test对比算准确率
python
    # 5. 保存模型.
    # 参1: 模型对象.    参2: 模型保存的路径.
    joblib.dump(estimator, './model/手写数字识别.pkl')        # pickle文件: Python(Pandas)独有的文件类型.
📚
问题:保存的是什么?
回答:KNN模型保存的是全部训练样本、标签以及设置的超参,并非代码;因为KNN是惰性学习,没有训练出权重参数,所以文件体积会偏大。
python
# 2. 定义函数, 训练模型, 并保存训练好的模型.
def train_model():
    # 1. 加载数据集.
    df = pd.read_csv('./data/手写数字识别.csv')
    # 2. 数据的预处理.
    # 2.1 拆分出特征列.
    x = df.iloc[:, 1:]      # 特征列.
    # 2.2 拆分出标签列.
    y = df.iloc[:, 0]       # 标签列.
    # 2.3 打印特征和标签的形状
    print(f'x的形状: {x.shape}')       # (42000, 784)
    print(f'y的形状: {y.shape}')       # (42000,)
    print(f'查看所有的标签的分布情况: {Counter(y)}')
    # 2.4 对特征列(拆分前)进行 归一化.
    x = x / 255
    # 2.5 拆分训练集和测试集.
    # 参1: 特征列.    参2: 标签列.      参3: 测试集的比例.    参4: 随机种子.      参5: 参考y值进行抽取, 保持标签的比例(数据均衡)
    x_train, x_test, y_train, y_test = train_test_split(x, y, test_size=0.2, random_state=21, stratify=y)

    # 3. 模型训练.
    # 3.1 创建模型对象.
    estimator = KNeighborsClassifier(n_neighbors=3)
    # 3.2 模型训练.
    estimator.fit(x_train, y_train)

    # 4. 模型评估.
    print(f'准确率: {estimator.score(x_test, y_test)}')
    print(f'准确率: {accuracy_score(y_test, estimator.predict(x_test))}')

    # 5. 保存模型.
    # 参1: 模型对象.    参2: 模型保存的路径.
    joblib.dump(estimator, './model/手写数字识别.pkl')        # pickle文件: Python(Pandas)独有的文件类型.
print('模型保存成功!')- 加载和使用模型
📚
问题:保存的不是代码,为什么加载模型后就能预测?
回答:预测逻辑是 sklearn 库自带的代码,不用存入 pkl;pkl 保存的是模型的数据(训练样本、超参)。加载就是把这份数据读到内存,调用 predict 时,库代码读取这份数据,完成预测计算。
python
    # 4.2 具体的转换动作, 记得: 归一化(因为训练模型的时候 使用了 归一化动作)
    # x = x.reshape(1, -1) / 255      # 可能会预测失败, 因为读图的时候, 像素值可能不是特别的精准.
    x = x.reshape(1, -1)              # 用原始的读取到的像素值, 做预测.
📚
问题:训练时做了归一化,预测新图片为什么不除以 255?
回答:读图函数不一样。训练集像素范围 0~255,除以 255 得到
0~1;plt.imread 读取 png 图片,像素本身就是 0~1,再除以 255
就会数值错乱,所以不用再次归一化。核心:保证送入模型的数据范围和训练时一致。
📚问题:
y_pre = estimator.predict(x),为什么 predict 就可以调用模型?回答:
estimator是加载到内存的模型对象,里面存好了训练样本与超参。predict是模型对象自带的方法,传入新样本 x,就会执行 KNN 距离计算,输出预测标签。
✋