随机森林
-
核心原理:集成学习(Ensemble Learning)------"三个臭皮匠,顶个诸葛亮"。
-
集成学习 :通过构建并结合多个有差异的 模型(称为:基学习器 ),让每个模型(基学习器)独立做出预测,最终通过投票法 (分类任务)或平均法(回归任务)来汇聚结果,从而获得比单一模型更准确、更稳定的预测性能。
一句话总结:多个模型协同工作,共同决策。
【注意 】:如果所有模型都犯同样的错误,投票也无济于事(必须保证模型的多样性)。
-
-
随机森林的"随机"与"森林":
-
森林:由多棵决策树组成。
-
随机(两个关键机制):
- 随机选择样本:采用Bootstrap抽样(有放回抽样),保证每棵树看到的数据不完全相同。
- 随机选择特征:在每个分裂节点,随机选择一部分特征寻找最佳分裂点,增加树之间的差异性。
这样的随机性创造了模型的多样性。每棵树都有自己的"视角",当其组合起来后,既保留了各自的优势,又互相弥补缺陷,从而提升整体预测性能。
-
-
算法流程与预测机制:
-
算法流程:构建多棵树 -> 差异化训练 -> 独立预测 -> 投票表决
步骤 核心动作 具体操作与说明 01 构建多棵树 创建数十甚至数百棵决策树,每棵树都是一个独立的分类器,从而构成了一片"森林"。 02 差异化训练 每棵树使用不同的训练数据子集 和特征子集 进行训练。 引入随机性(Bootstrap抽样 + 随机特征选择) 03 独立预测 对于新数据,让森林中的每一棵树都独立给出自己的预测结果。 树与树之间互不干扰,可以并行计算( n_jobs=-1)。04 投票表决 汇总所有树的预测结果,得出最终结论。 分类任务 :采用多数投票(硬投票)或概率平均(软投票)。 回归任务:取所有树预测值的平均值。 -
投票机制:
- 分类任务(硬投票) :每棵树投出自己一票,最终选择获得票数最多的类别作为预测结果(如100棵树,60票"违约",40票"不违约",则预测结果为"违约")。
- 分类任务(软投票) :每棵树输出各类别的概率 ,对所有树的概率按类别分别求平均,最终选择平均概率最高的类别。【通常比硬投票更准】
- 回归任务 :每棵树输出一个数值预测,取所有树预测值的平均值作为最终结果。
-
-
随机森林 vs 单棵决策树
对比 单棵决策树 随机森林 模型结构 结构简单,可以直观看到决策路径 模型复杂,包含数十到数百棵树 可解释性 强(白盒模型,容易理解与可视化) 弱(黑盒特性,难以解释整体决策过程) 过拟合风险 高 (对训练数据过于敏感,容易过拟合) 低 (通过集成降低方差,抗过拟合能力强) 预测性能 预测性能有限,不稳定 预测准确率高,性能稳定 数据敏感度 对噪声数据敏感,微小变化可能导致树完全不同 对缺失值和异常值有较好的容忍度 特征工程 不需要特征缩放 不需要特征缩放,且自带特征重要性评估 计算与资源 训练预测速度快,内存占用小 支持并行训练(效率高),但内存占用大,预测时间相对较长 适用场景 需要高度可解释性、数据量小(<100样本)的简单场景 追求高准确率、复杂分类/回归任务、作为 baseline 模型 一句话总结:单棵树"简单直观但易过拟合",随机森林"黑盒复杂但稳定强大"。
-
案例:乳腺癌二分类
第一步:网格搜索 + 交叉验证(确定参数)
采用网格搜索调参 :利用
GridSearchCV或RandomizedSearchCV系统搜索最佳参数组合。pythonfrom sklearn.model_selection import RandomizedSearchCV import pandas as pd import seaborn as sns import matplotlib.pyplot as plt from sklearn.datasets import load_breast_cancer from sklearn.model_selection import train_test_split from sklearn.ensemble import RandomForestClassifier from sklearn.metrics import classification_report, roc_auc_score # 1、加载内置数据 cancer = load_breast_cancer() x = cancer.data y = cancer.target x_train,x_test,y_train,y_test = train_test_split( x,y,test_size=0.2,random_state=42 ) model = RandomForestClassifier( random_state=42, # 随机种子:固定随机性,保证每次运行结果一致,便于复现和调参 n_jobs=-1 # 并行计算:使用所有可用的CPU核心(-1)加速训练 ) # 定义参数分布/空间 param_grid = { 'n_estimators': [100, 200, 300], # 树的数量 'max_depth': [10, 20, 30, None], # 树的最大深度 'min_samples_split': [2, 5, 10], # 分裂最小样本数 'max_features': ['sqrt', 'log2'] # 最大特征数 } random_search = RandomizedSearchCV( estimator=model, param_distributions=param_grid, # 参数分布/空间 n_iter=20, # 随机抽取20种组合进行测试 cv=5, scoring='roc_auc', random_state=42, n_jobs=-1 ) random_search.fit(x_train, y_train) print(f"随机搜索最佳参数: {random_search.best_params_}") -------------------------------------------------------------------------------- 随机搜索最佳参数: {'n_estimators': 200, 'min_samples_split': 5, 'max_features': 'log2', 'max_depth': 20} --------------------------------------------------------------------------------第二步:模型构建与应用
pythonimport pandas as pd import seaborn as sns import matplotlib.pyplot as plt from sklearn.datasets import load_breast_cancer from sklearn.model_selection import train_test_split from sklearn.ensemble import RandomForestClassifier from sklearn.metrics import classification_report, roc_auc_score # 1、加载内置数据 cancer = load_breast_cancer() x = cancer.data y = cancer.target # 2、划分训练集和测试集 x_train,x_test,y_train,y_test = train_test_split( x,y,test_size=0.2,random_state=42 ) # 3、构建随机森林模型 model = RandomForestClassifier( n_estimators=200, # 树的数量:构建200棵决策树,通常100-500棵性价比最高 max_depth=20, # 每棵树的最大深度:限制为20层,防止树太深导致过拟合 min_samples_split=5, # 分裂最小样本数:节点样本数少于5个就不再继续分裂,防过拟合 max_features='log2', random_state=42, # 随机种子:固定随机性,保证每次运行结果一致,便于复现和调参 n_jobs=-1 # 并行计算:使用所有可用的CPU核心(-1)加速训练 ) # 4、训练模型 model.fit(x_train,y_train) # 5、评估模型 predictions = model.predict(x_test) # 获取预测标签(硬预测) y_pred_proba = model.predict_proba(x_test)[:,1] # 查看预测概率(软预测,取正类概率) print(classification_report(y_test, predictions)) # 分类报告 # AUC指标:衡量分类模型区分正负样本的能力。其范围为0 ~ 1(0.5为随机猜测,越接近1越好) # 正样本:我们想要检测的"目标类别",通常标记为 `1` # 负样本:非目标类别,作为背景对照,通常标记为 `0` print(f"AUC Score: {roc_auc_score(y_test, y_pred_proba):.3f}") # 6、特征重要性分析 # 获取特征重要性数值 (返回一个数组) importances = model.feature_importances_ # 将特征名与重要性得分打包成 DataFrame,便于排序查看 feature_names = cancer.feature_names # 直接获取特征名列表 feature_imp = pd.DataFrame({ 'feature': feature_names, 'importance': importances }).sort_values('importance', ascending=False) # 按得分降序排列 # 打印前 10 个最重要的特征 print("Top 10 重要特征:") print(feature_imp.head(10)) # 可视化:绘制水平条形图 plt.figure(figsize=(10, 6)) # 取前10个特征进行绘图 plt.rcParams['font.sans-serif'] = ['SimHei', 'Microsoft YaHei'] # 黑体优先,备选微软雅黑 plt.rcParams['axes.unicode_minus'] = False # 解决负号变成方框 sns.set(font="SimHei") # seaborn热力图也要指定字体 plt.barh(feature_imp['feature'][:10][::-1], feature_imp['importance'][:10][::-1]) plt.xlabel('重要性得分') plt.title('特征重要性排名 Top 10') plt.tight_layout() plt.show() --------------------------------------------------------------------------------- precision recall f1-score support 0 0.98 0.93 0.95 43 1 0.96 0.99 0.97 71 accuracy 0.96 114 macro avg 0.97 0.96 0.96 114 weighted avg 0.97 0.96 0.96 114 AUC Score: 0.996 Top 10 重要特征: feature importance 22 worst perimeter 0.129394 27 worst concave points 0.112522 23 worst area 0.108152 7 mean concave points 0.108065 20 worst radius 0.070216 6 mean concavity 0.066560 3 mean area 0.051580 0 mean radius 0.049044 2 mean perimeter 0.045237 13 area error 0.040987 ---------------------------------------------------------------------------------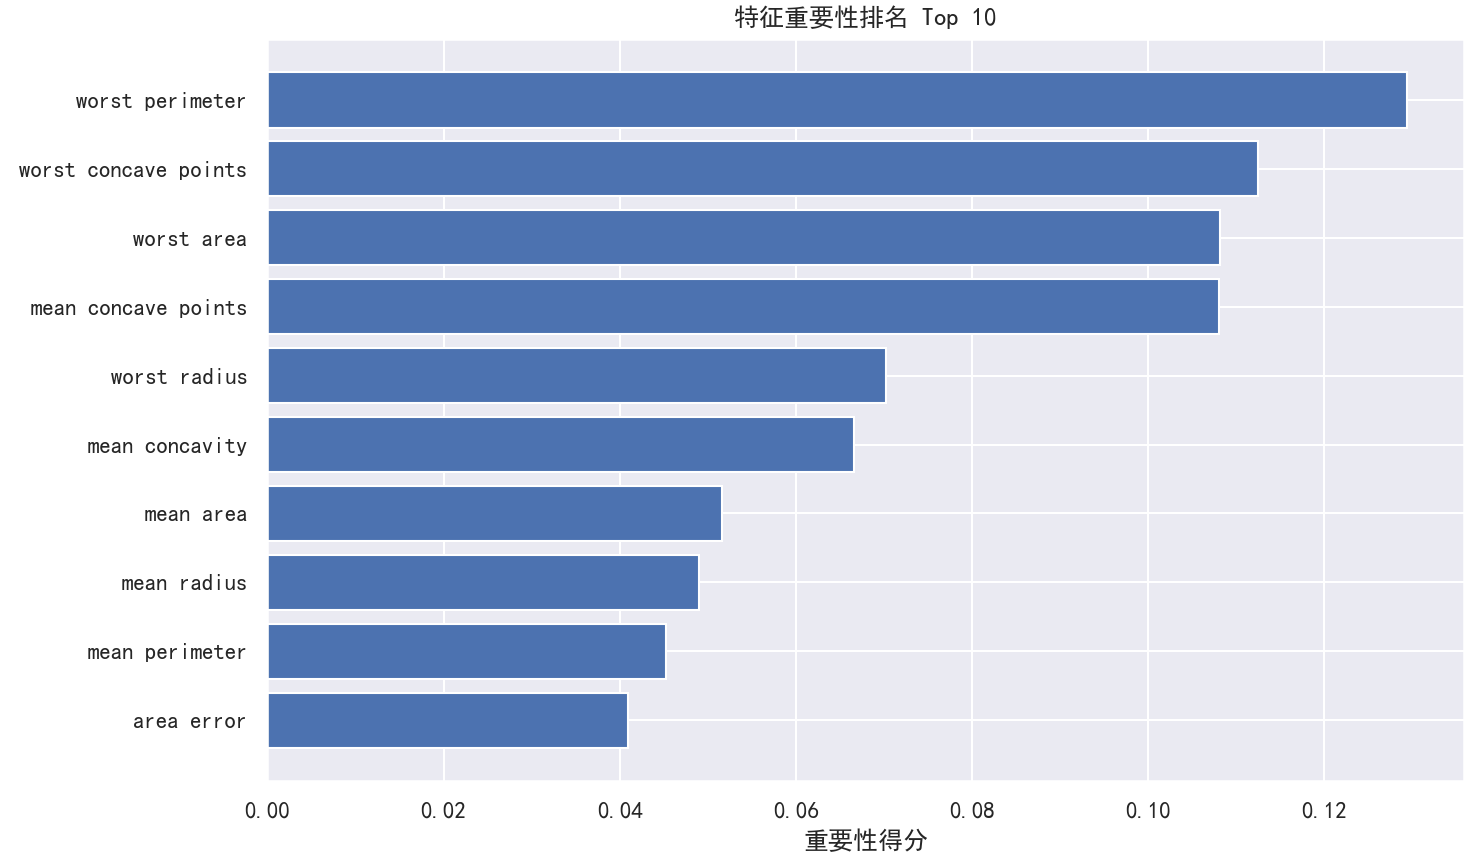
随机森林的参数讲解:
n_estimators(森林中树的数量)- 建议值:100 - 500
- 调优策略与注意事项 :越多通常越好,但收益递减。100是性价比最佳起点;继续增加会显著增加计算时间,性能提升微乎其微。
max_depth(每棵树的最大深度)- 建议值 :10 - 30 或
None - 调优策略与注意事项 :限制深度可以有效防止过拟合 。数据集大且复杂时,可设为
None让树自由生长;数据量小或噪声大时,必须限制。
- 建议值 :10 - 30 或
min_samples_split(分裂节点所需的最小样本数)- 建议值:2 - 20
- 调优策略与注意事项 :较大的值(如5-10)可以防止模型学习噪声,防止过拟合;过大会导致模型欠拟合(学不到规律)。
min_samples_leaf(叶子节点所需的最小样本数)- 建议值:1 - 10
- 调优策略与注意事项:(补充参数)常与split一起调。限制叶子节点样本数,也能有效平滑模型,防止过拟合。
max_features(每次分裂时考虑的最大特征数)- 建议值 :
'sqrt'或'log2' - 调优策略与注意事项 :
'sqrt'(分类默认)表示特征数的平方根;'log2'表示对数。降低该值能增加树之间的多样性,提升抗过拟合能力,但也可能降低单棵树的准确率。
- 建议值 :
-
优化技巧:
-
使用网格搜索调参 :利用
GridSearchCV或RandomizedSearchCV系统地搜索最佳参数组合。 -
处理类别不平衡:
-
调整权重 :在模型实例化时设置
class_weight='balanced',让模型自动调整权重,更关注少数类。pythonmodel = RandomForestClassifier( class_weight='balanced' ) -
数据采样:
- 欠采样(Undersampling):减少多数类样本(可能丢失信息)。
- 过采样(Oversampling):增加少数类样本(可能过拟合)。
- SMOTE算法:一种经典的合成少数类过采样技术,通过插值生成新的少数类样本,效果通常优于简单过采样。
-
-
特征工程优先(收益最大) :好的特征比复杂的模型更重要。利用
model.feature_importances_剔除重要性极低(如 <1%)的冗余特征,降低维度,提升训练速度。 -
并行计算加速:设置n_jobs=-1使用所有CPU核心,显著加快训练速度。对于大数据集,这能节省大量时间。
-