《生鲜连锁供应链数字化》系列第15篇
Apache Doris 数据仓库 ETL SARIMA Spring Boot 生鲜供应链
图1:生鲜供应链数据中台全景
一、为什么生鲜供应链需要数据中台?
做生鲜连锁的老板,最常问的一句话是:"今天到底赚了多少钱?"这个问题看似简单,但要实时回答它,需要同时拉通销售、采购、库存、会员、物流、财务六个维度的数据。传统做法是月底Excel汇总,滞后30天的数据只能用来复盘,不能用来决策。
我们为某生鲜连锁搭建的数据中台,以 Apache Doris 为 OLAP 引擎,实现了从 MySQL 业务库到分析型数仓的全链路打通,并在数仓之上跑了两套预测引擎:SARIMA 时间序列预测和节日备货智能推荐。整条流水线纯 Java 实现,不依赖 Spark/Flink,部署成本低,适合中小连锁。
本文是《生鲜连锁供应链数字化》系列第15篇。前14篇覆盖了整体架构、月结库存台账、导购代客下单、会员积分系统等。本文聚焦数据中台的核心:ETL 流水线 + 数仓分层建模 + SARIMA 预测。
二、数仓四层架构:ODS -> DWD -> DWS -> ADS
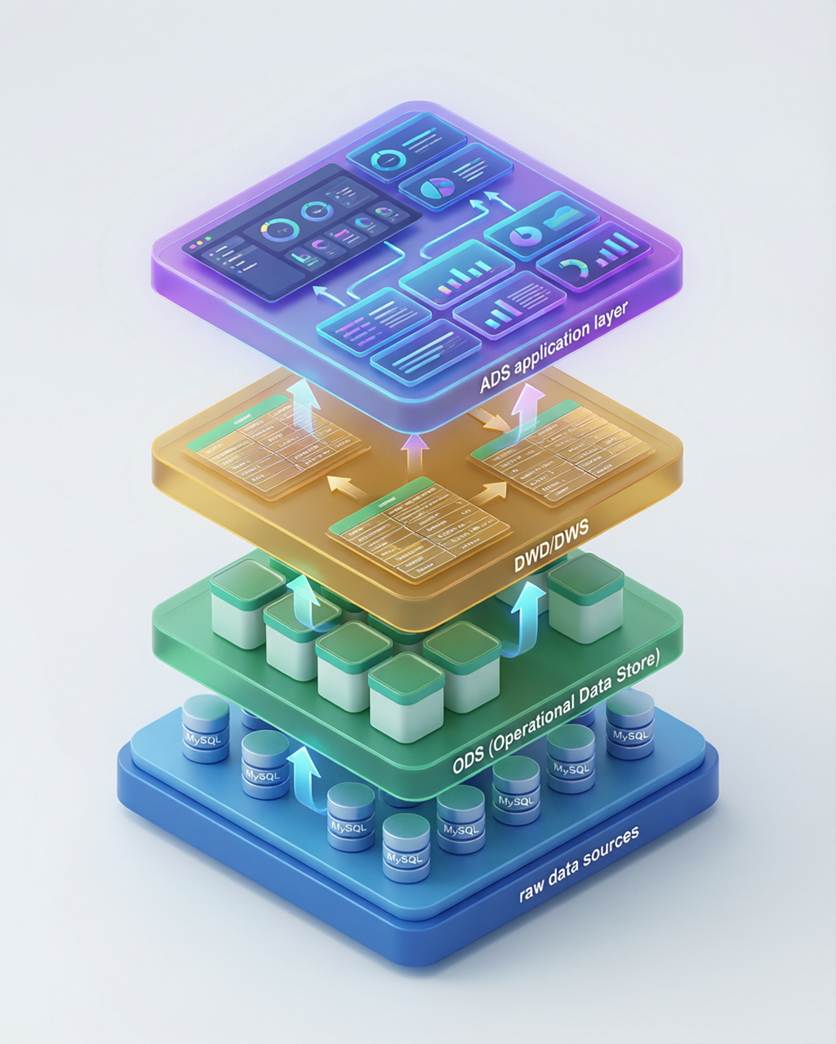
图2:ETL 流水线四层架构
整套数仓采用经典的四层分层模型,每层职责清晰、数据逐层精炼:
|-----------------------|--------------------------------------------------------------------------------------------------------|---------------|
| 层级 | 核心表 | 数据特征 |
| MySQL 业务库 (hy_dt) | tb_sales_order, tb_purchase_order, stock, mall_order, tb_product | 业务源数据 |
| Spring @Scheduled ETL | Java JDBC 驱动同步 | 全量/增量/快照三种策略 |
| ODS 原始镜像层 | ods_tb_stock(快照), ods_tb_sales_order(增量), ods_mall_order(增量), ods_mall_member(MD5脱敏) | 1:1 镜像,保留原始结构 |
| DWD 明细宽表层 | dwd_order_detail(订单+明细+商品+毛利), dwd_purchase_detail | 多表 JOIN 宽表 |
| DWS 汇总层 | dws_sales_month, dws_supplier_kpi, dws_inventory_summary, dws_sales_flat_all(超级宽表) | GROUP BY 聚合 |
| ADS 应用层 | ads_member_rfm(RFM分层), ads_inventory_abc(ABC分类), ads_presale_funnel(预售漏斗), ads_finance_drilldown(财务穿透) | 面向业务的最终结果表 |
每一层只依赖上一层的数据,ETL 调度时间严格按层级顺序编排:凌晨 2:00-2:50 同步 ODS,3:00-3:30 刷 DWD,3:30-4:30 刷 DWS,5:00-5:30 刷 ADS。这样保证每天早上 8 点管理层打开看板时,数据一定是最新的。
三、Doris 表设计:三种数据模型的选型
Apache Doris 提供三种数据模型,我们在不同层用了不同的模型:
|---------------|-------------|-----------------|---------------------------|
| 数据模型 | 适用场景 | 使用的层 | 核心特性 |
| DUPLICATE KEY | 追加写入,保留全量历史 | ODS 事务表、DWD 明细表 | 不合并,数据只增不改,查询时全扫 |
| UNIQUE KEY | 主键去重,保留最新 | ODS 主数据、ADS 结果表 | Merge-on-Write,写入即合并,读时一致 |
| AGGREGATE KEY | 预聚合,自动汇总 | DWS 汇总表 | 按维度自动 SUM/REPLACE,查询极快 |
3.1 ODS层:库存快照表(UNIQUE KEY + Merge-on-Write)
SQL
CREATE TABLE ods_tb_stock (
id BIGINT COMMENT '主键ID',
product_id BIGINT COMMENT '商品ID',
product_name VARCHAR(200) COMMENT '商品名称',
warehouse_id INT COMMENT '仓库ID',
warehouse_name VARCHAR(100) COMMENT '仓库名称',
quantity DECIMAL(12,2) COMMENT '当前库存数量',
cost_price DECIMAL(10,4) COMMENT '加权平均成本价',
category_name VARCHAR(100) COMMENT '品类名称',
sync_time DATETIME COMMENT '同步时间戳'
)
UNIQUE KEY(id)
DISTRIBUTED BY HASH(id) BUCKETS 4
PROPERTIES (
"replication_num" = "1",
"dynamic_partition.enable" = "true",
"dynamic_partition.time_unit" = "DAY",
"dynamic_partition.start" = "-90",
"dynamic_partition.end" = "3",
"dynamic_partition.prefix" = "p",
"dynamic_partition.buckets" = "4"
);
3.2 DWD层:订单明细宽表(DUPLICATE KEY + 范围分区)
SQL
CREATE TABLE dwd_order_detail (
order_id BIGINT COMMENT '订单ID',
order_no VARCHAR(64) COMMENT '订单编号',
detail_id BIGINT COMMENT '明细ID',
product_id BIGINT COMMENT '商品ID',
product_name VARCHAR(200) COMMENT '商品名称',
category_name VARCHAR(100) COMMENT '品类',
channel VARCHAR(20) COMMENT '渠道: POS/小程序/美团',
order_time DATETIME COMMENT '下单时间',
quantity DECIMAL(10,2) COMMENT '数量',
unit_price DECIMAL(10,2) COMMENT '单价',
amount DECIMAL(12,2) COMMENT '金额',
cost_amount DECIMAL(12,2) COMMENT '成本金额',
gross_profit DECIMAL(12,2) COMMENT '毛利',
gross_rate DECIMAL(6,4) COMMENT '毛利率',
store_id INT COMMENT '门店ID',
store_name VARCHAR(100) COMMENT '门店名称',
dt DATE COMMENT '日期分区键'
)
DUPLICATE KEY(order_id, order_no)
PARTITION BY RANGE(dt) (
PARTITION p202601 VALUES LESS THAN ('2026-02-01'),
PARTITION p202602 VALUES LESS THAN ('2026-03-01'),
PARTITION p202603 VALUES LESS THAN ('2026-04-01')
)
DISTRIBUTED BY HASH(order_id) BUCKETS 8
PROPERTIES (
"replication_num" = "1",
"dynamic_partition.enable" = "true",
"dynamic_partition.time_unit" = "MONTH",
"dynamic_partition.start" = "-12",
"dynamic_partition.end" = "1",
"dynamic_partition.prefix" = "p"
);
3.3 DWS层:月度销售聚合表(AGGREGATE KEY)
SQL
CREATE TABLE dws_sales_month (
stat_month VARCHAR(7) COMMENT '统计月份 2026-01',
channel VARCHAR(20) COMMENT '渠道',
category_name VARCHAR(100) COMMENT '品类',
store_id INT COMMENT '门店ID',
store_name VARCHAR(100) COMMENT '门店名称',
order_count BIGINT SUM COMMENT '订单数',
total_amount DECIMAL(14,2) SUM COMMENT '销售总额',
total_cost DECIMAL(14,2) SUM COMMENT '总成本',
total_profit DECIMAL(14,2) SUM COMMENT '总毛利',
avg_unit_price DECIMAL(10,2) REPLACE COMMENT '平均客单价',
avg_gross_rate DECIMAL(6,4) REPLACE COMMENT '平均毛利率',
customer_count BIGINT REPLACE COMMENT '客户数'
)
AGGREGATE KEY(stat_month, channel, category_name, store_id, store_name)
DISTRIBUTED BY HASH(stat_month) BUCKETS 4
PROPERTIES (
"replication_num" = "1"
);
关键设计点:AGGREGATE KEY 的指标列分为 SUM(可累加的:订单数、金额)和 REPLACE(不可累加的:毛利率、客单价),Doris 在写入时自动按聚合类型合并,查询时无需再 GROUP BY。
四、ETL 流水线:三种同步策略
整个 ETL 用 Spring @Scheduled 实现,不依赖 Airflow/Spark,纯 Java JDBC 驱动。针对不同类型的数据,设计了三种同步策略:
4.1 策略A:增量同步(update_time 水位线)
适用于订单、采购、积分流水等事务表。核心逻辑:记录上次同步时间戳,每次只拉增量。
Java
@Scheduled(cron = "0 0 * * * ?") // 每小时整点执行
public void syncOrdersToDoris() {
if (dorisJdbcTemplate == null) {
log.warn("ETL Doris数据源不可用,跳过订单同步");
return;
}
String lastSync = etlLogService.getLastSyncTime("tb_sales_order");
if (lastSync == null) lastSync = "2020-01-01 00:00:00";
String sql = "SELECT id, order_no, detail_id, product_id, product_name, "
- "category_name, channel, order_time, quantity, "
- "unit_price, amount, cost_amount, "
- "(amount - cost_amount) AS gross_profit, "
- "CASE WHEN amount > 0 "
- " THEN (amount - cost_amount) / amount ELSE 0 END AS gross_rate, "
- "store_id, store_name "
- "FROM tb_sales_order "
- "WHERE update_time > ? ORDER BY id";
syncTable("tb_sales_order", "dwd_order_detail", sql, lastSync);
}
private void syncTable(String sourceName, String targetTable,
String sql, String lastSync) {
List<Map<String, Object>> rows = mysqlJdbcTemplate.queryForList(sql, lastSync);
if (rows.isEmpty()) {
log.info("ETL {} 无增量数据", sourceName);
return;
}
// 批量写入 Doris(Stream Load)
String json = objectMapper.writeValueAsString(rows);
dorisStreamLoader.load(targetTable, json);
// 更新水位线(双写:MySQL日志表 + Doris控制表)
etlLogService.updateSyncTime(sourceName, rows.get(rows.size()-1));
log.info("ETL {} 同步 {} 行到 {}", sourceName, rows.size(), targetTable);
}
4.2 策略B:全量快照(TRUNCATE + INSERT)
适用于库存、主数据等"当前状态"表。每30分钟全量覆盖一次。
Java
@Scheduled(cron = "0 */30 * * * ?") // 每30分钟执行
public void syncStockToDoris() {
if (dorisJdbcTemplate == null) return;
// Step 1: 从 MySQL 拉取全量库存快照
String sql = "SELECT s.id, s.product_id, p.name AS product_name, "
- "s.warehouse_id, w.name AS warehouse_name, "
- "s.quantity, s.cost_price, "
- "c.name AS category_name, NOW() AS sync_time "
- "FROM stock s "
- "JOIN tb_product p ON s.product_id = p.id "
- "JOIN warehouse w ON s.warehouse_id = w.id "
- "LEFT JOIN tb_category c ON p.category_id = c.id";
List<Map<String, Object>> rows = mysqlJdbcTemplate.queryForList(sql);
// Step 2: TRUNCATE + INSERT(UNIQUE KEY Merge-on-Write 自动去重)
dorisJdbcTemplate.execute("TRUNCATE TABLE ods_tb_stock");
String json = objectMapper.writeValueAsString(rows);
dorisStreamLoader.load("ods_tb_stock", json);
log.info("ETL 库存快照同步完成,共 {} 条", rows.size());
}
4.3 策略C:删当期 + 重算(DWS/ADS 层)
适用于聚合表。只删当前周期的数据,重新从上层聚合,历史数据不动。
Java
// DWS层:删当期 + 重算(只删当前月份,历史不动)
public void refreshDwsSalesMonth(String month) {
if (dorisJdbcTemplate == null) return;
// Step 1: 删除目标月份数据
dorisJdbcTemplate.update(
"DELETE FROM dws_sales_month WHERE stat_month = ?", month);
// Step 2: 从 DWD 重新聚合写入
String insertSql =
"INSERT INTO dws_sales_month "
- "SELECT DATE_FORMAT(order_time, '%Y-%m') AS stat_month, "
- " channel, category_name, store_id, store_name, "
- " COUNT(*) AS order_count, "
- " SUM(amount) AS total_amount, "
- " SUM(cost_amount) AS total_cost, "
- " SUM(gross_profit) AS total_profit, "
- " AVG(unit_price) AS avg_unit_price, "
- " AVG(gross_rate) AS avg_gross_rate, "
- " COUNT(DISTINCT order_id) AS customer_count "
- "FROM dwd_order_detail "
- "WHERE DATE_FORMAT(order_time, '%Y-%m') = ? "
- "GROUP BY stat_month, channel, category_name, "
- " store_id, store_name";
dorisJdbcTemplate.update(insertSql, month);
log.info("ETL DWS月度聚合刷新完成: {}", month);
}
4.4 调度时间编排
|--------------|--------|---------------------|--------|
| 时间段 | 层级 | 任务 | 频率 |
| 每30分钟 | ODS | 库存快照同步 | 全量 |
| 每小时 :00-:30 | ODS | 订单/采购/商城/积分/配额增量 | 增量 |
| 凌晨 2:00-2:50 | ODS | 商品/仓库/客户/供应商/会员主数据 | 全量 |
| 凌晨 3:00-3:30 | DWD | 订单/采购明细宽表刷新 | 每日 |
| 凌晨 3:30-4:30 | DWS | 日聚合/月聚合/供应商KPI/库存汇总 | 每日 |
| 凌晨 5:00-5:30 | ADS | 日销售汇总/RFM会员分层 | 每日 |
注意:Doris 数据源使用 @Autowired(required = false) 注入,如果 Doris 不可用,所有 ETL 任务静默跳过,不影响业务系统正常运行。这是"优雅降级"的核心设计。
五、ADS 层实战:RFM 会员分层
RFM 模型是零售行业最经典的客户分层方法。我们在 ADS 层直接用 SQL 实现,无需额外的机器学习框架:
SQL
-- ADS层:RFM 会员分层
INSERT INTO ads_member_rfm
SELECT
member_id,
DATEDIFF(CURRENT_DATE, MAX(order_date)) AS recency_days,
COUNT(DISTINCT order_id) AS frequency,
SUM(amount) AS monetary,
CASE
WHEN DATEDIFF(CURRENT_DATE, MAX(order_date)) <= 30
AND COUNT(DISTINCT order_id) >= 4
AND SUM(amount) >= 2000 THEN '高价值客户'
WHEN DATEDIFF(CURRENT_DATE, MAX(order_date)) <= 60
AND COUNT(DISTINCT order_id) >= 2 THEN '潜力客户'
WHEN DATEDIFF(CURRENT_DATE, MAX(order_date)) > 180 THEN '流失预警'
ELSE '普通客户'
END AS rfm_label
FROM dws_sales_flat_all
WHERE member_id IS NOT NULL
GROUP BY member_id;
六、SARIMA 时间序列预测:纯 Java 手写实现
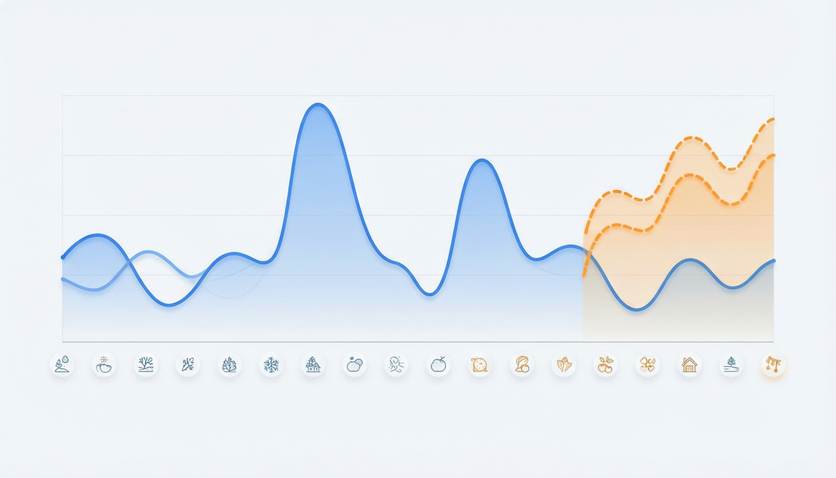
图3:SARIMA 月度销售预测可视化(含置信区间)
这是整套数仓最有技术含量的部分。我们没有用 Python 的 statsmodels 或 Prophet,而是用纯 Java 实现了一个 SARIMA(1,1,1)(1,1,1)12 近似算法,直接嵌入 Spring Boot 应用,零外部依赖。
6.1 为什么选 SARIMA?
生鲜销售有明显的季节性:春节(2月)是全年最高峰,销售额占全年的 43%;中秋(9月)和古尔邦节(7月)是次高峰。SARIMA 能同时捕捉趋势和季节性,比简单移动平均准得多。
6.2 算法六步走
Java
/**
* SARIMA(1,1,1)(1,1,1)12 近似实现
* 用于月度销售预测,纯 Java 零外部依赖
*/
public SarimaResult runSarima(double\[\] monthlyData, int forecastMonths) {
int n = monthlyData.length;
int season = 12; // 月度季节性周期
// Step 1: 一阶差分(去趋势)
double\[\] diff1 = new doublen - 1;
for (int i = 0; i < n - 1; i++)
diff1i = monthlyDatai + 1 - monthlyDatai;
// Step 2: 季节差分(去季节性)
double\[\] seasonalDiff = new doublediff1.length - season;
for (int i = 0; i < diff1.length - season; i++)
seasonalDiffi = diff1i + season - diff1i;
// Step 3: 估计 AR(1) 系数(自相关)
double ar1 = estimateAR(seasonalDiff, 1);
// Step 4: 估计 SAR(1) 系数(季节自相关)
double sar1 = estimateAR(seasonalDiff, season);
// Step 5: 估计 MA(1) 和 SMA(1) 系数(近似)
double ma1 = estimateMA(seasonalDiff, 1);
double sma1 = estimateMA(seasonalDiff, season);
// Step 6: 递推预测 + 反差分还原
double\[\] forecasts = new doubleforecastMonths;
double lastValue = monthlyDatan - 1;
double lastSeasonalDiff = seasonalDiffseasonalDiff.length - 1;
for (int h = 0; h < forecastMonths; h++) {
// SARIMA 递推公式
double pred = ar1 * lastSeasonalDiff
- sar1 * (h >= season ? forecastsh - season : lastSeasonalDiff)
- ma1 * 0.1 // MA 残差衰减
- sma1 * 0.05;
// 反季节差分
double seasonBase = (h < n - 1)
? monthlyDatan - season + h : monthlyDatan - 1;
forecastsh = seasonBase + pred;
// 确保预测值非负
forecastsh = Math.max(forecastsh, 0);
lastSeasonalDiff = pred;
}
// 计算 MAPE(平均绝对百分比误差)
double mape = calculateMAPE(monthlyData, forecasts, season);
ConfidenceLevel confidence = mape < 10 ? ConfidenceLevel.HIGH
: mape < 25 ? ConfidenceLevel.MEDIUM
: ConfidenceLevel.LOW;
return new SarimaResult(forecasts, mape, confidence);
}
6.3 节日加成系数
Java
// 节日加成系数表(基于历史销售数据分析)
private static final Map<String, Double> FESTIVAL_MULTIPLIERS = Map.ofEntries(
Map.entry("春节", 2.8), // 全年最高峰,销售额占43%
Map.entry("元宵", 1.3),
Map.entry("清明", 1.1),
Map.entry("五一", 1.4),
Map.entry("端午", 1.25),
Map.entry("古尔邦节", 1.5), // 新疆区域重要节日
Map.entry("中秋", 1.6),
Map.entry("国庆", 1.35),
Map.entry("双十一", 1.2),
Map.entry("冬至", 1.15),
Map.entry("圣诞", 1.1)
);
public double applyFestivalMultiplier(double baseForecast, String month) {
double multiplier = 1.0;
for (Map.Entry<String, Double> entry : FESTIVAL_MULTIPLIERS.entrySet()) {
if (isFestivalMonth(entry.getKey(), month)) {
multiplier = Math.max(multiplier, entry.getValue());
}
}
return baseForecast * multiplier;
}
6.4 置信度评估(MAPE)
|---------|--------------|-----------|---------------|
| 置信度 | MAPE 范围 | 解读 | 建议动作 |
| HIGH | < 10% | 拟合良好,预测可信 | 直接参考预测值备货 |
| MEDIUM | 10%-25% | 拟合可接受 | 参考预测值,结合经验微调 |
| LOW | > 25% 或数据不足 | 拟合差或数据太少 | 不建议参考,用历史同期均值 |
降级策略:当训练数据少于 14 个月(不够做季节差分)时,自动降级为指数增长外推模型,确保新品类也能输出预测值。
七、异常检测 + 企业微信自动告警
系统每隔 4 小时自动对比今日实时销售与近 30 天同时段均值,偏差超过 30% 即触发告警:
Java
@Scheduled(cron = "0 0 8,12,18 * * ?") // 每天 8:00/12:00/18:00 检测
public void detectSalesAnomalies() {
if (dorisJdbcTemplate == null) return;
// 对比今日实时 vs 近30天同时段均值
String sql =
"SELECT channel, category_name, "
- " DATE_FORMAT(order_time, '%H') AS hour_slot, "
- " SUM(amount) AS today_amount "
- "FROM dwd_order_detail "
- "WHERE dt = CURRENT_DATE "
- "GROUP BY channel, category_name, hour_slot";
List<Map<String, Object>> todayData = dorisJdbcTemplate.queryForList(sql);
for (Map<String, Object> row : todayData) {
String channel = (String) row.get("channel");
String category = (String) row.get("category_name");
String hour = (String) row.get("hour_slot");
double todayAmount = ((Number) row.get("today_amount")).doubleValue();
// 查近30天同时段同渠道同品类均值
double avgAmount = getHistoricalAvg(channel, category, hour);
if (avgAmount > 0) {
double deviation = (todayAmount - avgAmount) / avgAmount;
if (Math.abs(deviation) > 0.3) { // 偏差超过30%
String direction = deviation > 0 ? "暴涨" : "骤降";
String suggestion = generateSuggestion(channel, category, direction);
AlertEvent event = AlertEvent.builder()
.type("SALES_ANOMALY")
.level(deviation > 0.5 ? "CRITICAL" : "WARNING")
.channel(channel)
.category(category)
.timeSlot(hour + ":00")
.deviation(String.format("%.1f%%", deviation * 100))
.suggestion(suggestion)
.build();
weComAlertService.sendAlert(event);
}
}
}
}
private String generateSuggestion(String channel, String category, String dir) {
if ("骤降".equals(dir)) {
return String.format("建议检查%s首页展位及活动是否正常,"
- "考虑发放限时优惠券刺激转化", channel);
} else {
return String.format("%s品类%s异常暴涨,建议关注库存是否充足," - "防止超卖", category, channel);
}
}
每条异常事件包含三层归因(渠道 -> 品类 -> 时段),系统还会自动生成处置建议,比如"建议检查小程序首页展位及活动是否正常,考虑发放限时优惠券刺激转化"。
八、节日备货预测:人机协同工作流
Java
@GetMapping("/api/forecast/holiday/{festival}")
public HolidayForecastVO getHolidayForecast(@PathVariable String festival) {
// 获取SARIMA基准预测
double\[\] monthlyData = salesDataService.getMonthlySales(24);
SarimaResult sarima = runSarima(monthlyData, 3);
double baseForecast = sarima.getForecasts()0;
double festivalMultiplier = FESTIVAL_MULTIPLIERS
.getOrDefault(festival, 1.0);
// 三档建议:保守 / 基准 / 激进
double conservative = baseForecast * festivalMultiplier * 0.85;
double baseline = baseForecast * festivalMultiplier;
double aggressive = baseForecast * festivalMultiplier * 1.2;
// 查历史同期实际值作为参考
double lastYearActual = salesDataService
.getLastYearFestivalSales(festival);
HolidayForecastVO vo = HolidayForecastVO.builder()
.festival(festival)
.sarimaBase(baseForecast)
.festivalMultiplier(festivalMultiplier)
.conservativeQty(Math.round(conservative))
.baselineQty(Math.round(baseline))
.aggressiveQty(Math.round(aggressive))
.lastYearActual(lastYearActual)
.confidence(sarima.getConfidence())
.suggestion(generateHolidaySuggestion(sarima, lastYearActual, baseline))
.build();
// 创建草稿状态的备货计划
holidayPlanService.createDraftPlan(festival, vo);
return vo;
}
// 运营人员确认后触发采购
@PostMapping("/api/forecast/holiday/{planId}/confirm")
public void confirmHolidayPlan(@PathVariable Long planId,
@RequestParam double confirmedQty) {
HolidayPlan plan = holidayPlanService.getById(planId);
plan.setConfirmedQty(confirmedQty);
plan.setStatus("CONFIRMED");
holidayPlanService.updateById(plan);
// 自动触发采购申请
purchaseService.autoCreateFromForecast(plan);
}
运营人员在后台看到三档建议(保守/基准/激进),选择一个最终确认数量,状态从 DRAFT 变为 CONFIRMED,系统自动触发采购申请。这个"人在环路"的设计避免了纯算法决策的风险。
九、关键技术决策总结
|---------|----------------------------|-----------------------------------------------|
| 决策点 | 我们的选择 | 原因 |
| ETL 框架 | Spring @Scheduled + JDBC | 中小连锁数据量不大(日增 ~5000行),不需要 Spark/Flink 的重型基础设施 |
| OLAP 引擎 | Apache Doris(单副本) | 比 ClickHouse 运维简单,原生支持 MySQL 协议,2核4G 即可运行 |
| 增量同步水位线 | MySQL 日志表(主)+ Doris 控制表(备) | 双写保证:即使 Doris 宕机,恢复后从 MySQL 日志表读取水位线继续 |
| 预测算法 | 纯 Java SARIMA + 节日系数 | 零外部依赖,嵌入 Spring Boot,不引入 Python 运行时 |
| 隐私保护 | 会员手机号 MD5 哈希后入库 | 数仓分析不需要明文手机号,ODS 层就完成脱敏 |
| 容错设计 | Doris 不可用时静默跳过 | 数仓是锦上添花,不能影响核心业务系统 |
十、写在最后
生鲜供应链的数据中台,核心不在于用了多先进的技术,而在于数据分层的清晰度和 ETL 的可靠性。ODS/DWD/DWS/ADS 四层各司其职,ETL 按层级顺序编排,SARIMA 预测嵌入业务系统------这套方案已经在线上稳定运行超过 6 个月,每天凌晨自动刷新,早上 8 点管理层打开手机就能看到最新的经营数据。
如果你也在做生鲜或零售行业的数据中台,或者对 Doris 数仓建模、SARIMA 预测的具体实现有问题,欢迎在评论区交流。