🔥 星光编译者 · 个人主页
📚 学习专栏: 《C/C++ 成长笔记》 · 《Linux 实践手册》 · 《数据结构与算法》
🌄 向云端飞扬,编译属于自己的代码星河。
☕ 写在开篇
你好,这里是 星光编译者。
这里记录我在 C/C++、Linux、数据结构与算法 学习中遇到的真实问题、亲手验证过的代码,以及那些容易被忽略的实现细节。
比起简单罗列结论,我更愿意从问题出发,把一个知识点的来由讲清楚,把"为什么会这样"和"应该怎样解决"说明白,让每一次踩坑都沉淀成可以复用的经验。
如果这篇记录能帮你少绕一点路,或让某个模糊的地方忽然变得清晰,那么这次分享便有了意义。愿我们在一次次阅读、编译与调试中稳步向前,慢慢搭起属于自己的技术世界。
🔥 本文定位:沿着 x86 处理器的演进,串起绝对物理地址、实模式分段、保护模式分段、平坦模型、分页与虚拟内存。重点不是孤立背诵 GDT、段选择子和页表,而是回答:每一代机制解决了什么问题,又为什么会被下一代机制补充。
💡 学习目标 :掌握
segment × 16 + offset的实模式寻址;理解动态重定位;看懂保护模式下"选择子 → 描述符 → 线性地址"的路径;理解 Base、Limit、Type、DPL、P、G 等字段的职责;掌握 32 位经典分页的10 + 10 + 12拆分;能区分逻辑地址、线性地址、虚拟地址和物理地址。📌 阅读说明:本文以 x86 为主线。为便于入门,会先采用 8086 与 32 位经典分页模型,再补充现代 x86-64 的差异。二进制容量统一写作 KiB、MiB、GiB;日常资料中的 KB、MB、GB 在相关语境下通常指同一数量级。
文章目录
- 一、先抓住主线:地址管理到底在解决什么
- 二、最早的直觉:程序直接使用物理地址
- [三、8086 实模式:两个 16 位量如何组成 20 位地址](#三、8086 实模式:两个 16 位量如何组成 20 位地址)
- 四、分段的价值:动态重定位让程序可以搬家
- 五、实模式留下的问题:没有可靠的边界与权限
- 六、保护模式:从段值变成段选择子
- [七、GDT、GDTR 与段描述符:CPU 到哪里找元数据](#七、GDT、GDTR 与段描述符:CPU 到哪里找元数据)
- [八、选择子与特权级:Index、TI、RPL 分别做什么](#八、选择子与特权级:Index、TI、RPL 分别做什么)
- 九、为什么分段最终退居幕后
- 十、分页:用固定大小页面管理离散物理内存
- 十一、虚拟内存:隔离、按需调页与地址空间错觉
- [十二、Linux 与 x86-64:今天的地址变换到底怎样走](#十二、Linux 与 x86-64:今天的地址变换到底怎样走)
- 十三、常见误区、高频面试题与练习
- 总结
一、先抓住主线:地址管理到底在解决什么
学习内存管理时,很容易陷入一堆名词:段寄存器、选择子、描述符、页目录、页表、TLB、缺页异常。把它们一个个背下来并不难,难的是理解它们为什么会同时存在。
从处理器和操作系统的视角看,地址管理长期围绕三个问题演进。
1.1 定位:有限宽度的寄存器怎样访问更大的空间
8086 的通用寄存器和段寄存器是 16 位,地址总线却有 20 位。单个 16 位量只能表达 2^16 = 64 KiB,无法直接覆盖 2^20 = 1 MiB。实模式分段首先解决的是"地址位数不够"这一硬件问题。
1.2 保护:一个程序为什么不能随便访问另一个程序
如果程序直接使用物理地址,错误指针可能覆盖别的程序甚至操作系统的数据。保护模式把边界、类型、特权级等元数据放进段描述符,让 CPU 在执行访问时检查"地址是否越界""当前代码是否有权限"。
1.3 映射:进程看到的连续空间怎样落到离散物理内存
可变长的段容易产生外部碎片,也不适合只换入程序当前需要的一小部分。分页把空间切成固定大小页面,让虚拟上连续的页面映射到物理上分散的页框,并为按需调页、写时复制和进程隔离提供基础。
因此,整条演进路线可以先压缩为:
text
直接物理地址
    ↓  寄存器位宽不够
实模式分段:segment × 16 + offset
    ↓  缺少边界和权限
保护模式分段:selector → descriptor → linear address
    ↓  大段粒度粗、外部碎片、映射不灵活
分页:linear address → page tables → physical address
    ↓
每个进程获得独立虚拟地址空间,页面按需驻留物理内存
这里要特别注意:新机制通常不是按下开关后把旧机制从历史上删除,而是在架构兼容的前提下重新分工。现代 x86 仍能看到分段留下的结构,但普通内存管理的主角已经变成分页。
二、最早的直觉:程序直接使用物理地址
早期系统最自然的做法,是把指令里的地址直接解释为物理内存位置。
text
load 0x1234  →  访问物理内存 0x1234
store 0x2000 →  修改物理内存 0x2000
在单程序、没有复杂操作系统的环境中,这种模型简单直接:没有页表,不需要地址翻译,硬件成本也低。
但它很快暴露出三个限制。
第一,程序与装载位置绑定 。如果链接后把某条指令中的地址固定为 0x4200,程序换到别的位置运行,就需要修改指令或重做重定位。
第二,程序之间没有隔离。任何代码只要构造出某个物理地址,就可能读写那里。一个越界写不仅会破坏自己,也可能破坏其他任务和内核。
第三,多程序共享内存很困难。两个程序若都假定自己使用同一段物理地址,就无法直接同时装入;系统需要频繁调整程序、修补地址或交换整块内容。
所以,直接物理地址适合简单机器,却难以支撑多任务操作系统。接下来出现的分段,最初首先解决的还不是安全,而是更朴素的位宽问题。
三、8086 实模式:两个 16 位量如何组成 20 位地址
8086 拥有 20 位地址总线,因此最多可产生 2^20 = 1 MiB 的物理地址;但它的段寄存器和偏移量都是 16 位。解决办法是把地址拆成"段值 + 段内偏移"。
实模式下的地址计算公式为:
text
physical = (segment << 4) + offset也可以写成:
text
physical = segment × 16 + offset例如访问 0x05808:
text
segment = 0x0580
offset  = 0x0008

(0x0580 << 4) + 0x0008
= 0x05800 + 0x0008
= 0x05808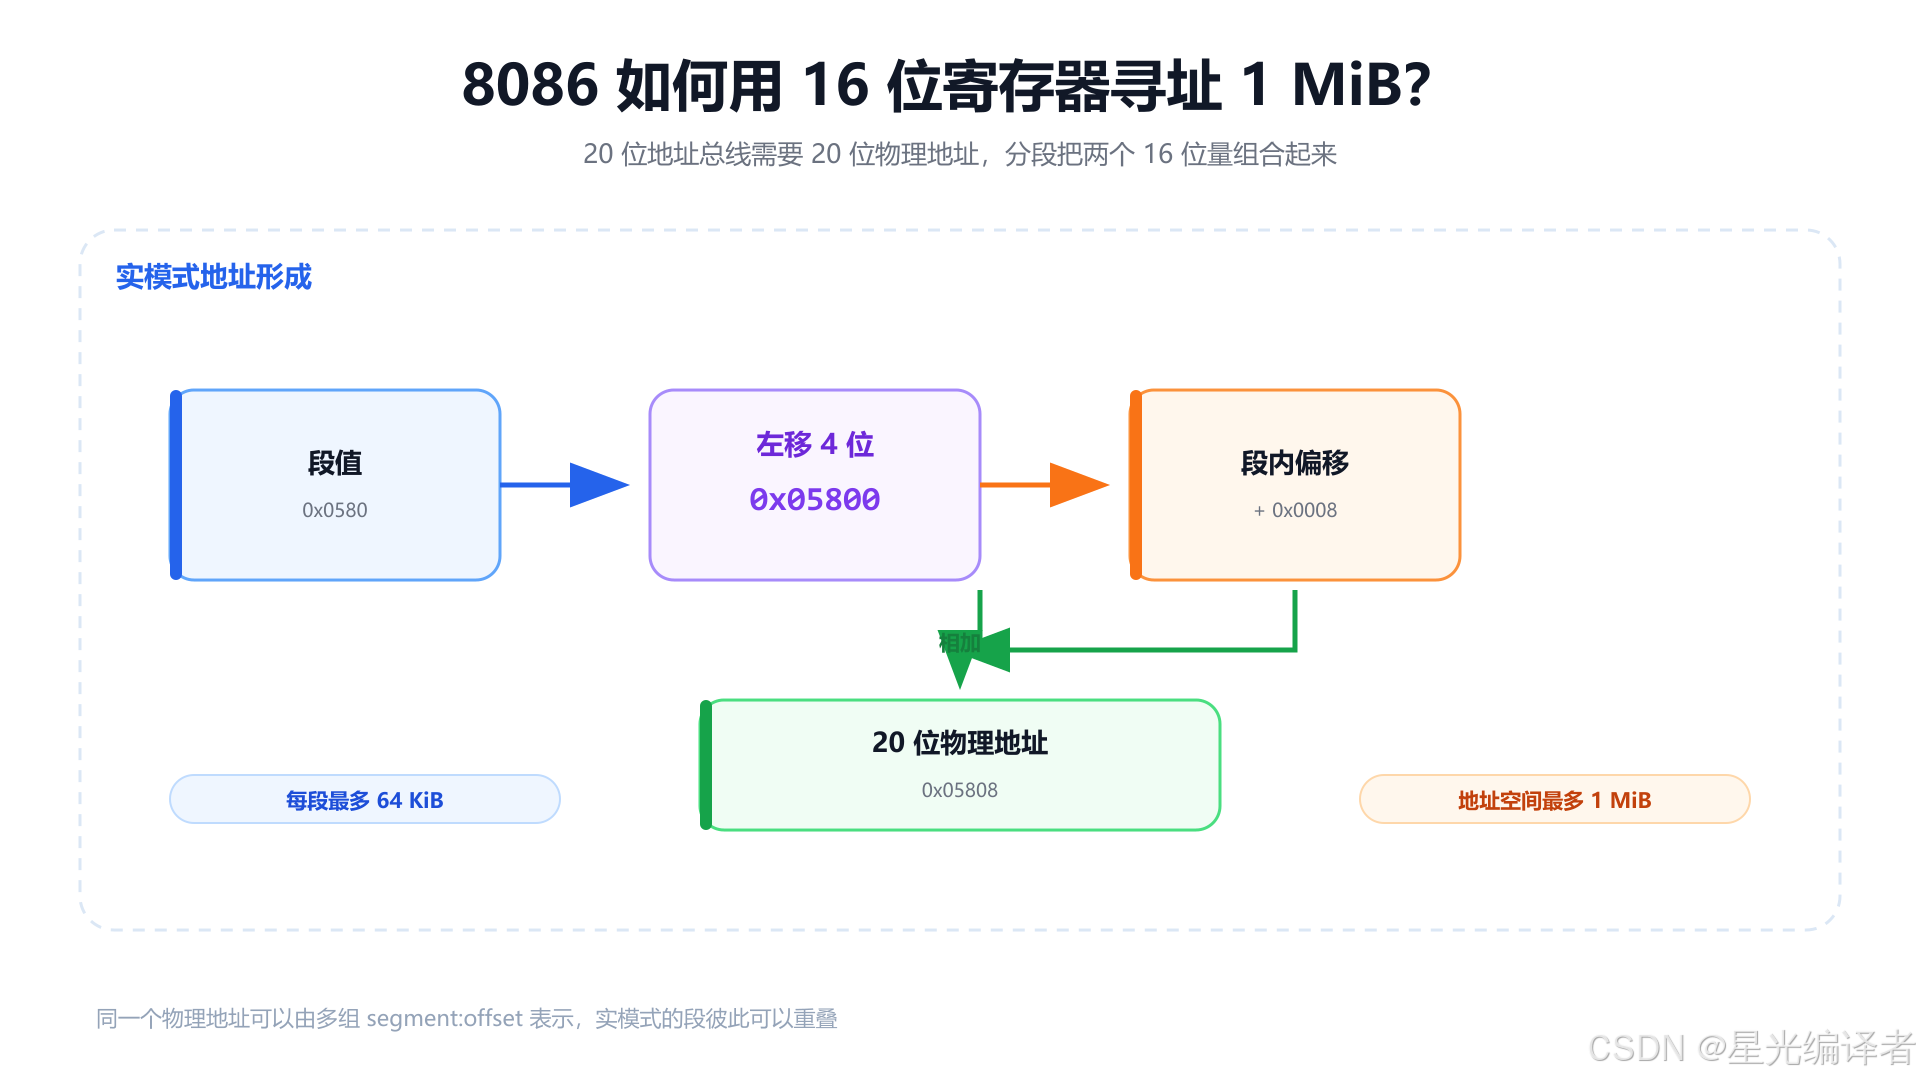
3.1 为什么每个段最多 64 KiB
段内偏移是 16 位,因此偏移范围是 0x0000 ~ 0xFFFF,最多覆盖 65536 个字节,也就是 64 KiB。这里的"段"不是说系统一定把 1 MiB 严丝合缝切成 16 个互不重叠的大块,而是表示一次地址计算所使用的窗口。
3.2 实模式的段可以重叠
段基址每次只向前移动 16 字节,所以大量段窗口会互相重叠。同一个物理地址通常可以由多组 segment:offset 表示。
例如:
text
0058:0008 → 0x00588
0057:0018 → 0x00588
0050:0088 → 0x00588因此,segment:offset 是一种逻辑表示,不是一张唯一的物理地址身份证。
3.3 20 位相加还存在回绕细节
0xFFFF:0xFFFF 的数学结果会超过 20 位。8086/8088 只有 20 根地址线,高位无法送出,结果会在 1 MiB 边界回绕。后来 80286 引入更宽地址能力,为兼容旧软件又出现了著名的 A20 控制问题。
入门阶段只需先记住主公式;研究启动流程、实模式兼容和操作系统引导时,再进一步讨论 A20 Gate。
四、分段的价值:动态重定位让程序可以搬家
分段不仅扩展了寻址位数,还带来一个极其重要的能力:运行时地址重定位。
4.1 静态重定位为什么限制内存管理
假设程序把一条数据访问写死为物理地址 0x4200。程序装到别处后,这个地址仍指向旧位置。装载器必须修改机器指令中的地址,或者保证程序永远放在原来的位置。
这会让操作系统很难搬移程序。内存出现碎片时,即使总空闲量足够,也未必能把程序移动到新的连续区域。
4.2 动态重定位怎样解耦程序与物理位置
程序只保存段内偏移,CPU 在每次访问时把当前段基址与偏移组合起来。
text
程序使用:offset = 0x0200

第一次运行:base = 0x4000 → address = 0x4200
第二次运行:base = 0x7000 → address = 0x7200
程序内部的偏移不变,只要改变运行时基址,就能把整段程序搬到别处。
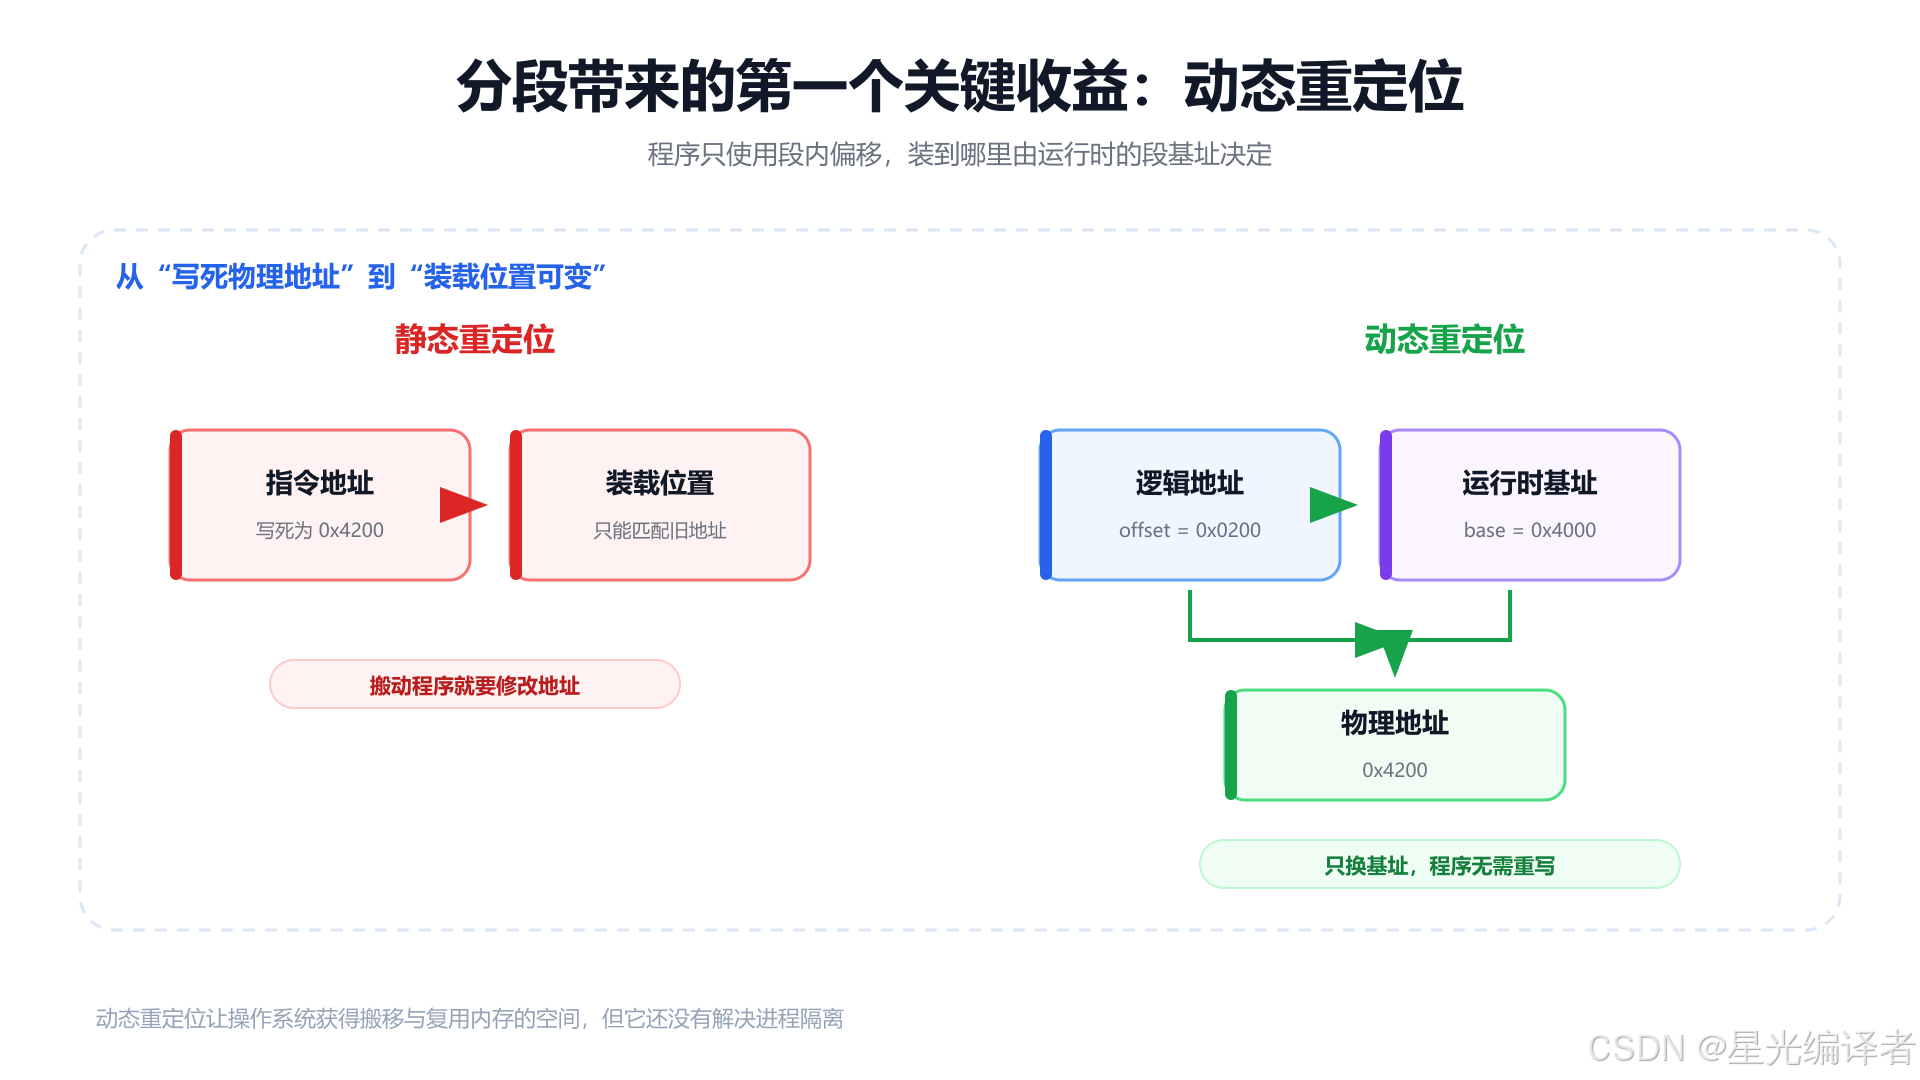
这一步的本质,是在程序看到的地址与内存实际位置之间加入一次转换:
text
程序地址 ≠ 最终物理位置后来的虚拟内存把这种解耦做得更加彻底,但思想在这里已经出现。
4.3 动态重定位没有自动带来保护
实模式的计算规则只负责"怎么算地址",没有描述"谁能访问"。只要程序能修改段寄存器或构造合适的地址,就可能落到其他程序的内存区域。
换句话说,实模式分段提升了可寻址性和可搬移性,却没有建立可靠的安全边界。
五、实模式留下的问题:没有可靠的边界与权限
多任务操作系统需要的不只是"能算出地址",还要保证每个任务只能在授权范围内运行。
至少需要下面几类检查:
- 边界检查:偏移有没有超过段的范围;
- 类型检查:代码段、数据段、栈段允许的操作不同;
- 权限检查:用户态代码不能随意进入内核数据;
- 存在性检查:目标是否已经装入内存;
- 系统结构保护:中断门、任务状态段等不能被普通程序当作普通数据使用。
如果这些规则只由软件自觉遵守,恶意程序可以故意绕过,错误程序也可能无意中破坏系统。于是 80286 引入保护模式,80386 又把通用寄存器和地址能力扩展到 32 位,让保护模式真正成为后来 32 位操作系统的基础。
保护模式的关键变化不是公式变复杂,而是:CPU 开始根据操作系统提供的元数据强制执行访问规则。
六、保护模式:从段值变成段选择子
进入保护模式后,段寄存器中不再直接保存一个拿来左移 4 位的段值,而是保存段选择子(segment selector)。
一次典型的分段地址变换可以概括为:
text
段寄存器中的 selector
    ↓
根据 TI 选择 GDT 或 LDT
    ↓
根据 Index 找到段描述符
    ↓
检查段类型、界限、存在位与特权级
    ↓
descriptor.base + offset
    ↓
得到 linear address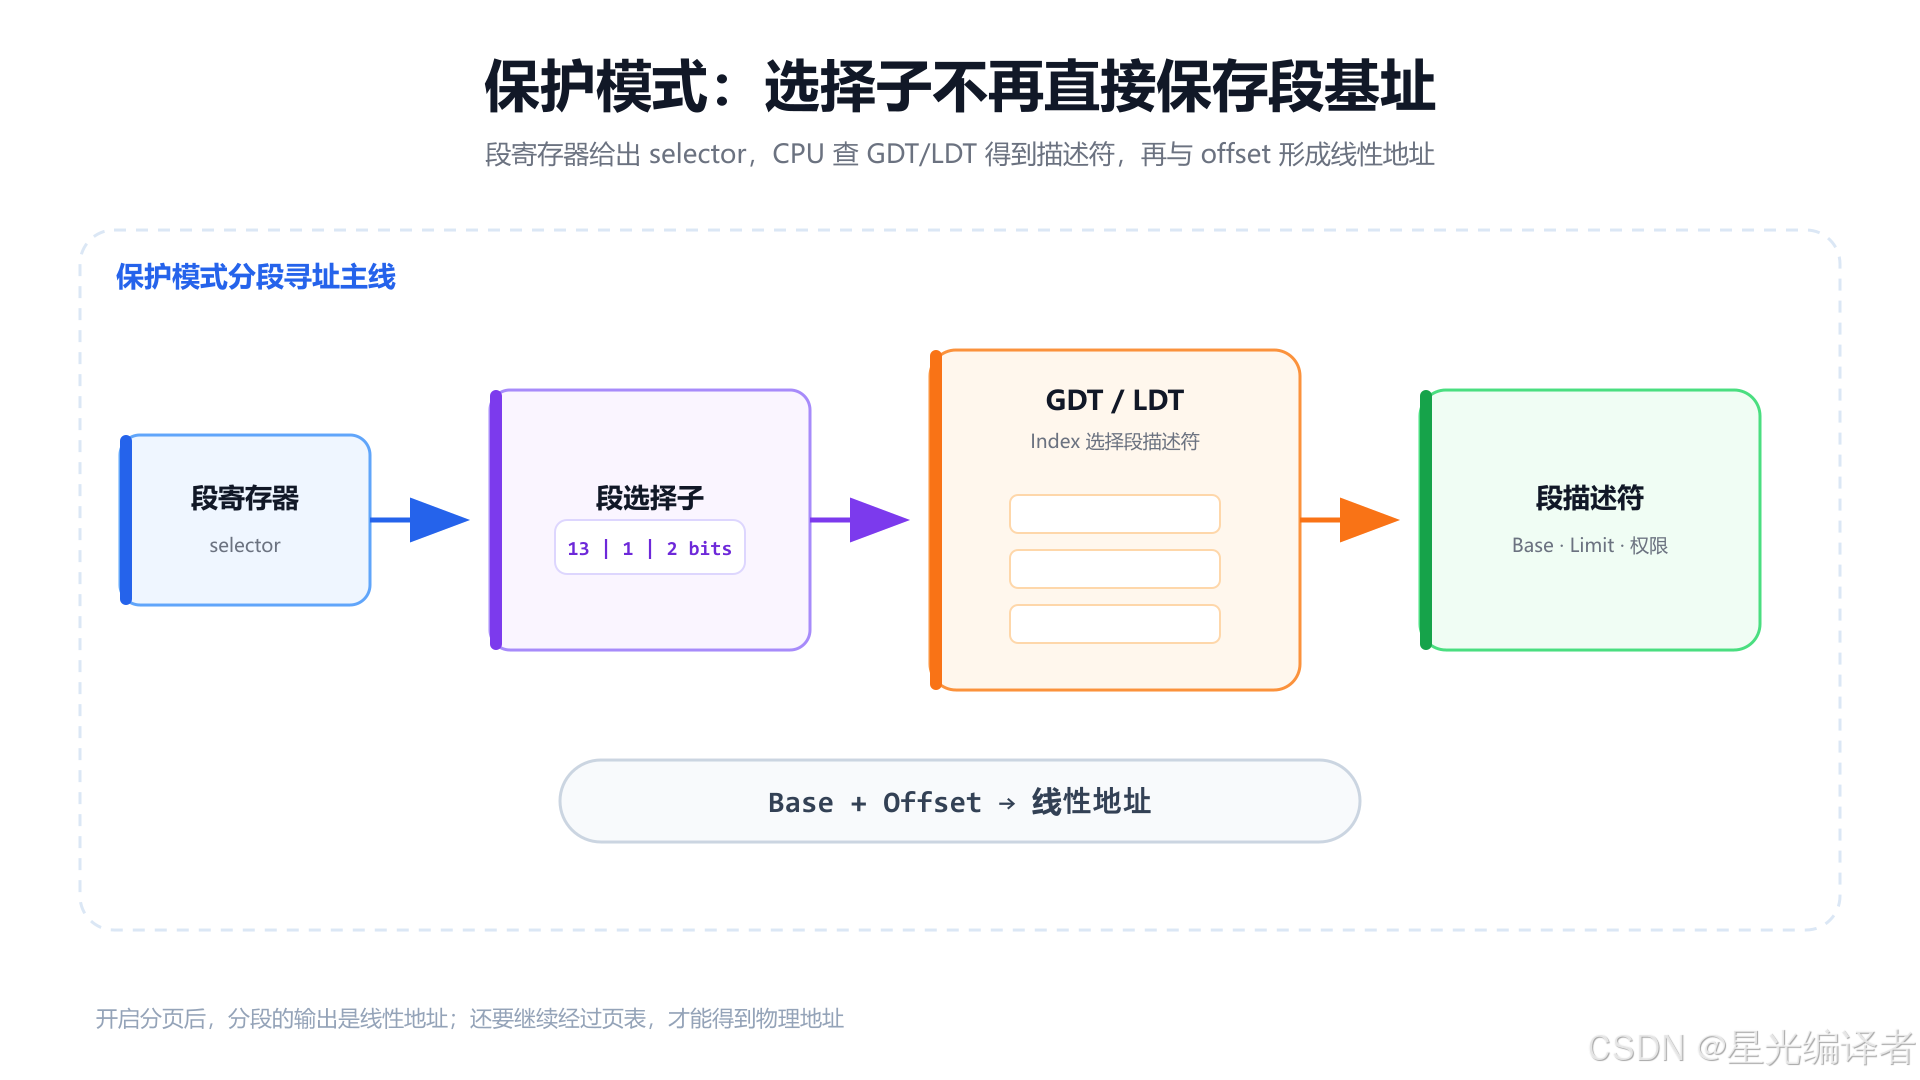
这里最容易犯的错误,是把最后一步无条件写成"得到物理地址"。更严谨的说法是:
- 分页关闭时:线性地址会直接作为物理地址使用;
- 分页开启时:线性地址还要经过页表翻译,才能得到最终物理地址。
因此,x86 保护模式下可以同时存在两级转换:
text
logical address --segmentation--> linear address --paging--> physical address6.1 逻辑地址是什么
Intel 文档中的逻辑地址由选择子和偏移组成:
text
logical address = selector : offset选择子说明使用哪个段,偏移说明访问段内哪个字节。程序里常见的指针值往往表现为偏移部分,而具体使用 CS、DS、SS、ES、FS 或 GS,则由指令语义和段覆盖前缀决定。
6.2 线性地址是什么
线性地址是分段之后、分页之前的地址。若操作系统把常规代码段和数据段的 Base 都设为 0,偏移值与线性地址数值相同,程序便看到一个从 0 开始的平坦空间。
数值相同不等于分段机制在 32 位保护模式中从硬件上消失,而是操作系统把它配置成"几乎透明"。
七、GDT、GDTR 与段描述符:CPU 到哪里找元数据
保护模式需要一张表保存各个段的基址、界限和权限,这就是描述符表。
7.1 GDT:全局描述符表
GDT(Global Descriptor Table)由操作系统维护,包含代码段、数据段和系统段等描述符。在一个处理器的当前执行环境中,GDTR 指向当前使用的 GDT。
32 位模式下,GDTR 包含:
- 32 位表基址;
- 16 位表界限。
界限字段记录"表大小减一",所以表最大覆盖 65536 字节。常见段描述符大小为 8 字节,因此最多容纳 8192 个 8 字节描述符。
text
65536 / 8 = 8192第 0 个 GDT 项是空描述符,所以普通选择子不会把它当作可用段。
7.2 LDT:局部描述符表
LDT(Local Descriptor Table)可以为任务提供局部描述符集合。现代通用操作系统很少依赖每进程 LDT 来组织普通地址空间,但架构结构仍然存在,某些兼容和特殊用途仍可能使用它。
7.3 段描述符的核心字段
32 位代码段或数据段描述符通常是 8 字节。字段在位图中被拆散布局,但理解时可以按职责归类。
Base:段基址
由多个字段拼成 32 位基址。CPU 将它与有效偏移相加,形成线性地址。
Limit:段界限
20 位界限字段与 G 粒度位共同决定段可覆盖的范围。
G = 0:界限以字节为单位;G = 1:界限以 4 KiB 为单位,低 12 位视为 1,从而可覆盖接近 4 GiB 的范围。
这里不能简单说 G = 0 时"段最大 1 MiB"而忽略界限是最后有效偏移;工程上更重要的是理解有效上界由 Limit、G、段扩展方向等规则共同解释。
Type 与 S:段类别和允许操作
S = 1:代码段或数据段;S = 0:系统描述符,例如 TSS、LDT 或门描述符相关结构。
Type 进一步描述可读、可写、可执行、扩展方向、已访问等属性。
DPL:描述符特权级
DPL 范围为 0~3,数值越小,特权越高。Ring 0 通常用于内核,Ring 3 通常用于用户程序;Ring 1 和 Ring 2 在主流桌面/服务器操作系统中较少用于普通进程隔离。
P:存在位
P = 1 表示描述符所代表的段存在,P = 0 时访问会触发段不存在异常。
历史系统理论上可以利用段不存在异常实现以段为单位的换入,但现代虚拟内存主要依靠页表 Present 位和缺页异常。不要把段描述符的 P 位与页表项的 Present 位混为一谈。
D/B、L、AVL
D/B会根据代码段、数据段或栈段语境影响默认操作数/地址大小与栈上界;L在 IA-32e 模式下标识 64 位代码段;AVL留给系统软件使用。
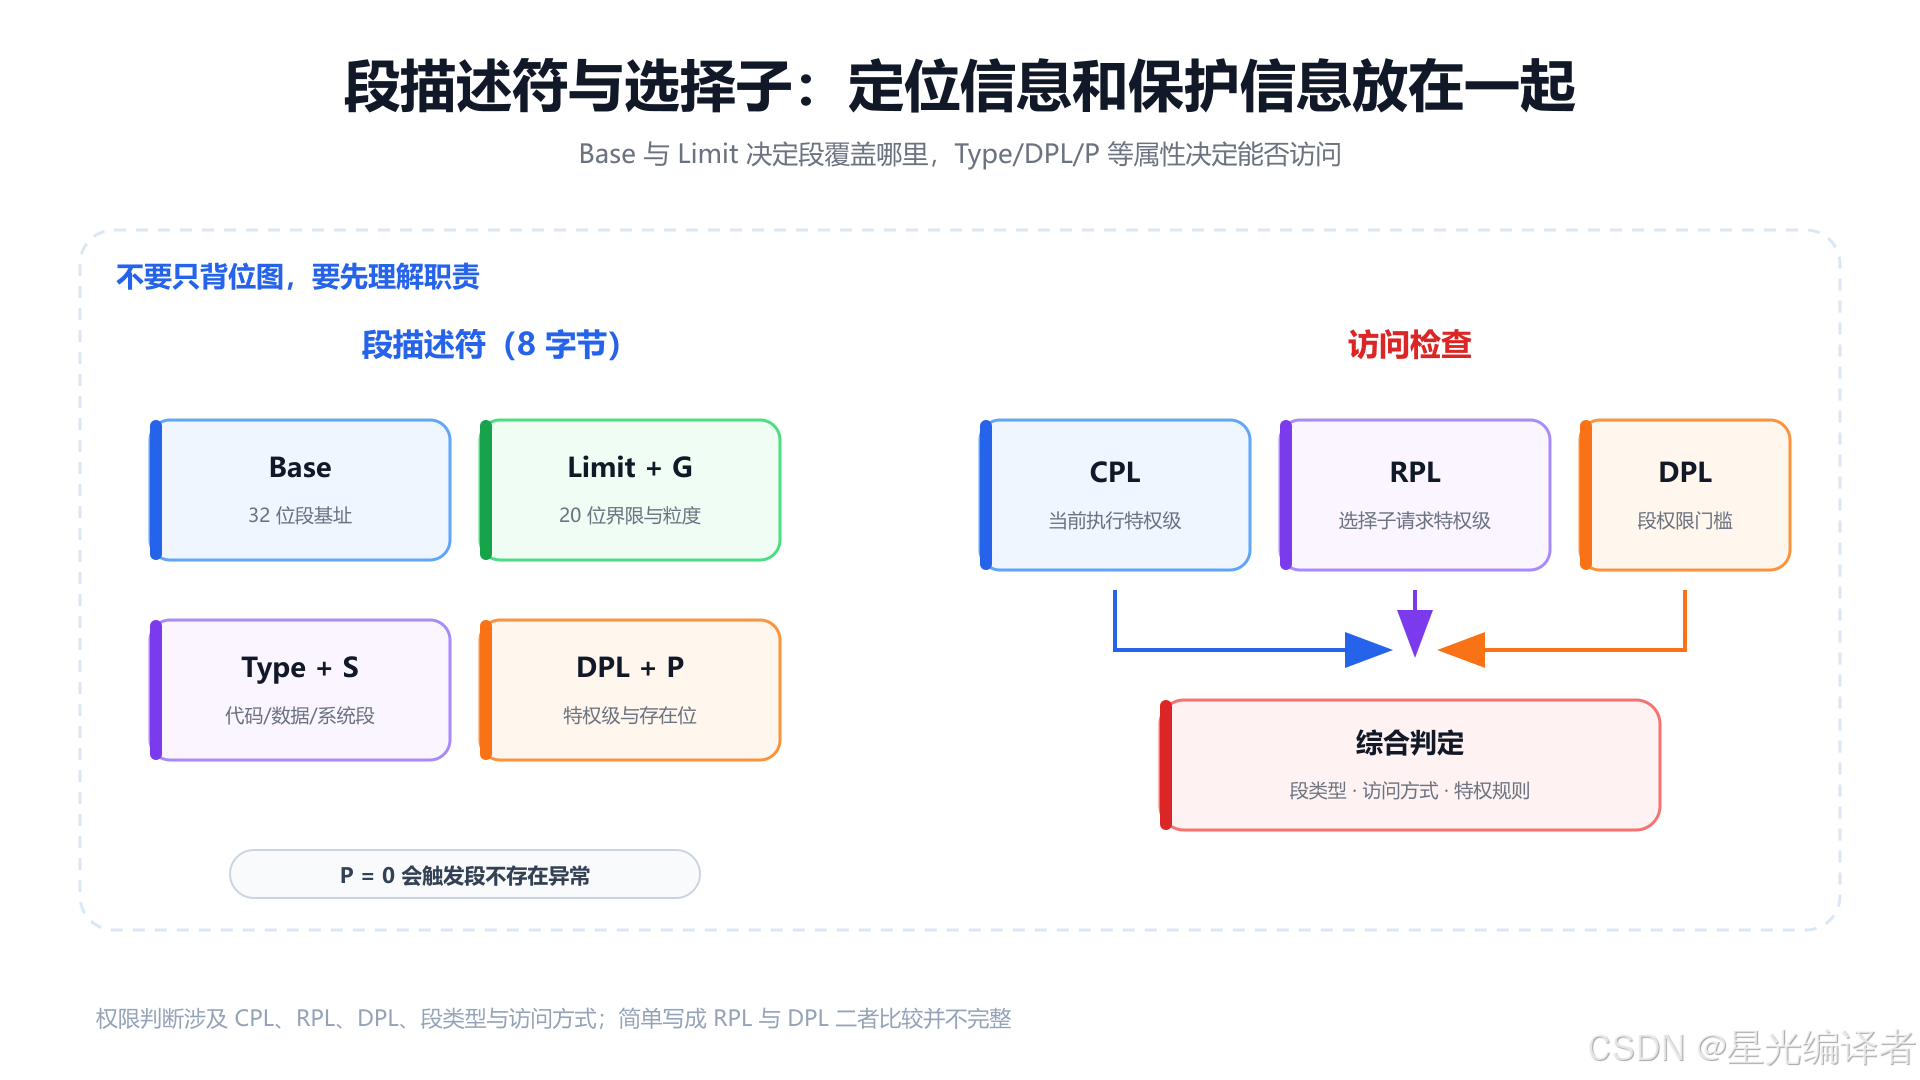
比死记各位的编号更重要的是记住:Base 与 Limit 解决"在哪里、到哪里",Type、DPL、P 等属性解决"是什么、谁能访问、现在是否存在"。
八、选择子与特权级:Index、TI、RPL 分别做什么
段选择子是 16 位,结构可以概括为:
text
15                         3  2  1 0
+---------------------------+---+----+
|          Index            |TI |RPL |
+---------------------------+---+----+
           13 bit            1   2
8.1 Index:选择第几个描述符
Index 占 13 位,范围为 0~8191。CPU 用它在 GDT 或 LDT 中定位一个描述符:
text
descriptor_address = table_base + Index × 8这里乘 8,是因为普通段描述符为 8 字节。
8.2 TI:选择哪张表
TI = 0:从 GDT 查找;TI = 1:从当前 LDT 查找。
8.3 RPL:请求者给选择子附带的特权级
RPL(Requested Privilege Level)占 2 位。它不是"目标段的权限",目标段的特权级在描述符 DPL 中。RPL 会参与有效权限判断,防止高特权代码拿着低限制的选择子替低特权调用者越权访问。
8.4 不能把权限检查简化成只比较 RPL 和 DPL
一些入门资料会说:"RPL 权限低于 DPL 就拒绝。"这个表述不完整。
对普通数据段访问,常见判断会考虑:
text
effective_privilege = max(CPL, RPL)然后再与 DPL 比较。CPL 是当前执行代码的特权级;此外,代码段是否一致、访问是读取还是执行、通过门转移还是直接装载段寄存器,规则都会变化。
所以,正确的入门结论是:
CPU 会综合 CPL、RPL、DPL、段类型和访问方式进行保护检查,而不是只做两个数字的单一比较。
如果目标是理解 Linux 用户态与内核态,先记住 Ring 3 不能直接访问只允许 Ring 0 的段和页面;如果目标是编写内核、虚拟机或引导程序,则必须继续查阅 Intel 手册中的完整保护规则。
九、为什么分段最终退居幕后
保护模式分段解决了边界和权限,但随着 80386 把寄存器和偏移扩展到 32 位,单个段已经可以覆盖 4 GiB 线性地址空间。此时分段的两个局限越来越明显。
9.1 32 位偏移让平坦模型成为可能
当代码段、数据段都配置为:
text
Base  = 0
Limit = 4 GiB 范围
则:
text
linear = 0 + offset = offset应用程序看到的地址值可以直接作为线性地址使用。操作系统不再依靠大量可变长段组织普通进程空间,这就是常说的平坦内存模型。
9.2 可变长大段会产生外部碎片
假设内存中有两个分别为 20 MiB 和 10 MiB 的空洞,总空闲量为 30 MiB。现在需要装入一个连续 30 MiB 的段,仍然会失败,因为没有单个连续区域足够大。
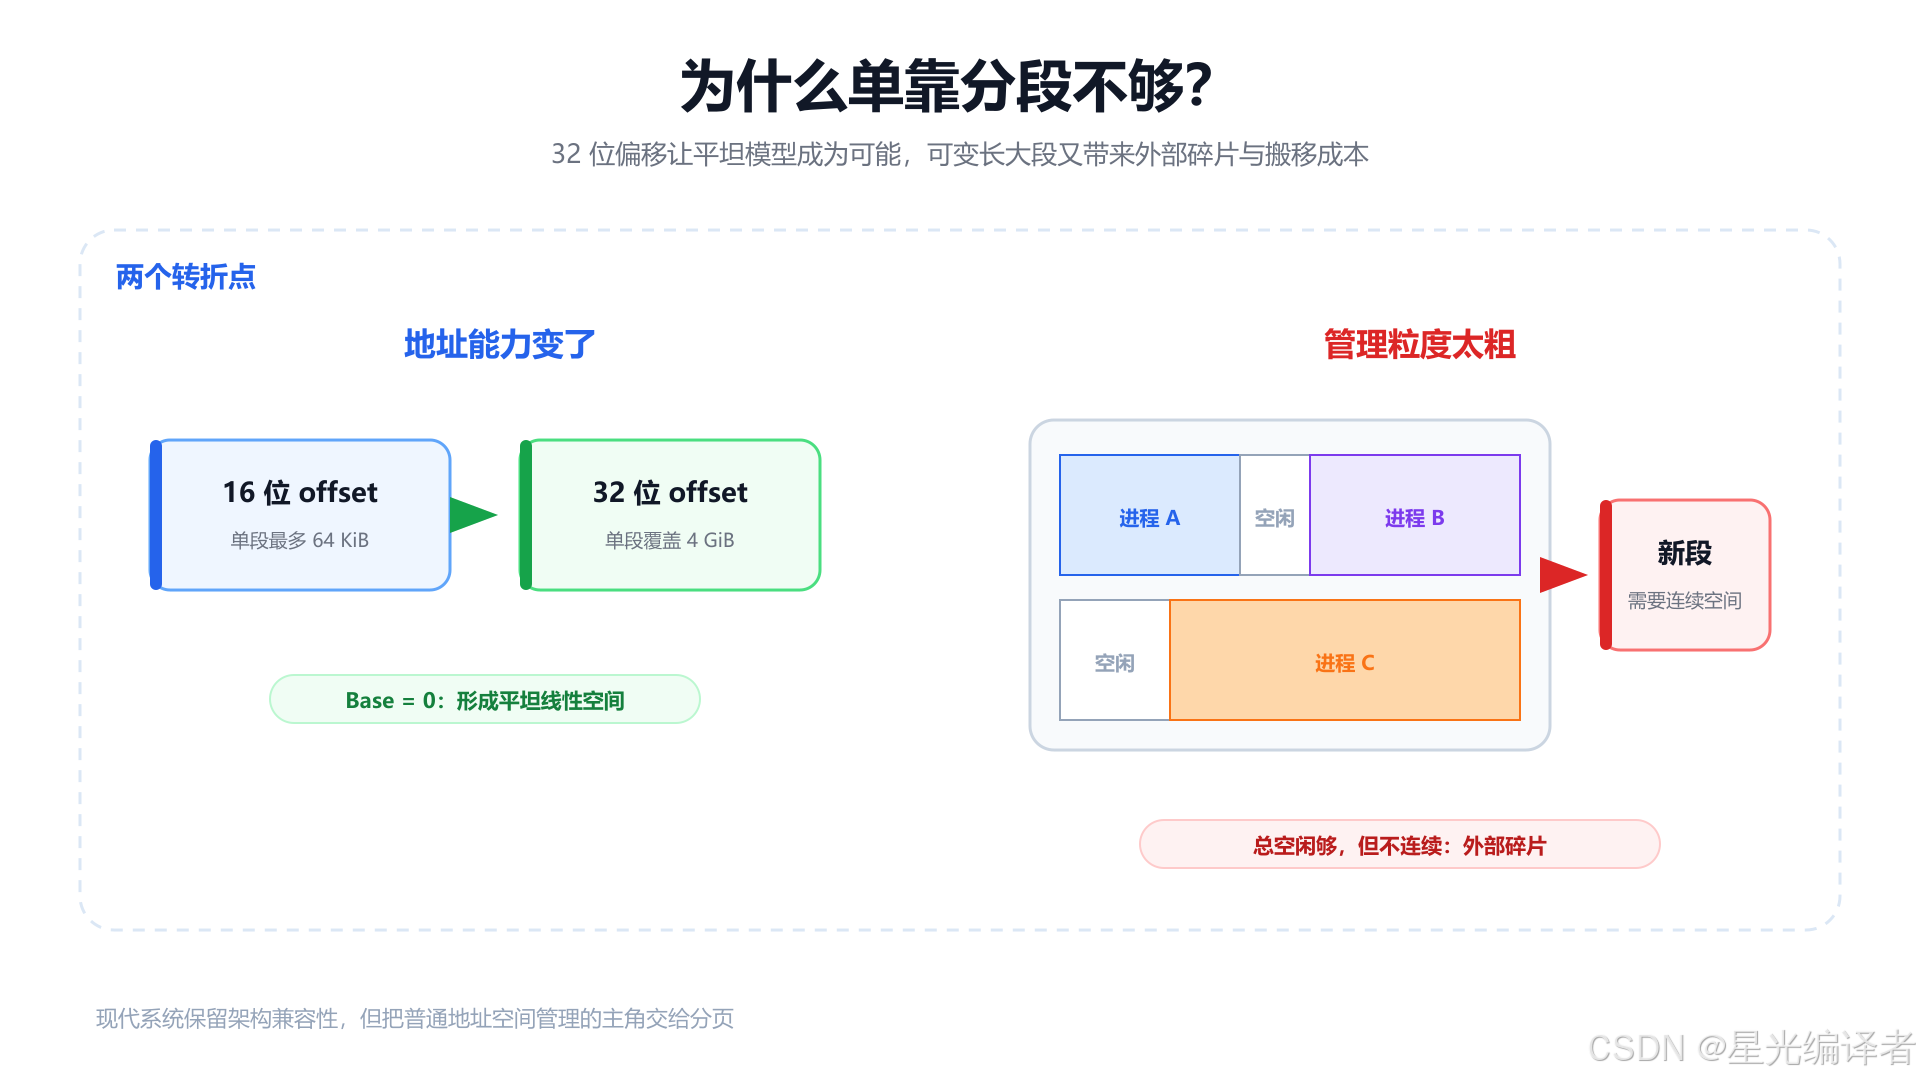
若要解决,只能尝试:
- 移动已有段,把空洞拼接起来;
- 把整个段换出到磁盘,再装到别处;
- 等待其他段释放。
这些操作成本很高,尤其磁盘远慢于内存。
9.3 交换整段的粒度太粗
一个程序的代码和数据可能很大,但某个时间窗口只活跃其中很小一部分。若必须以整个段为单位在内存与磁盘之间交换,会搬运大量暂时用不到的数据。
分页要做的,就是把管理粒度固定并缩小。不是要求一整个程序段连续驻留,而是只让当前需要的页面进入物理内存。
9.4 内部碎片与外部碎片不要混淆
- 外部碎片:空闲空间散落在多个不连续区域,总量够但无法满足连续大块请求;
- 内部碎片:已经分配的固定大小块内部有一部分没有被使用。
分页大幅缓解外部碎片,因为任意空闲页框都可参与映射;但最后一页没有填满时仍可能产生内部碎片。
十、分页:用固定大小页面管理离散物理内存
分页同时切分两个空间:
- 线性/虚拟地址空间被切成固定大小的页面(page);
- 物理内存被切成同样大小的页框(page frame)。
页面与页框大小一致,所以任意虚拟页面都能映射到任意空闲物理页框。
10.1 经典 32 位两级分页
以 4 KiB 页面、非 PAE 的 32 位经典分页为例,32 位线性地址可拆成:
text
31              22 21              12 11               0
+-----------------+------------------+-------------------+
| 页目录索引 10 位 | 页表索引 10 位    | 页内偏移 12 位     |
+-----------------+------------------+-------------------+
为什么页内偏移是 12 位?因为:
text
4 KiB = 4096 B = 2^12 B低 12 位刚好指出页面内的某个字节,高 20 位用于找到映射该页面的页表项。
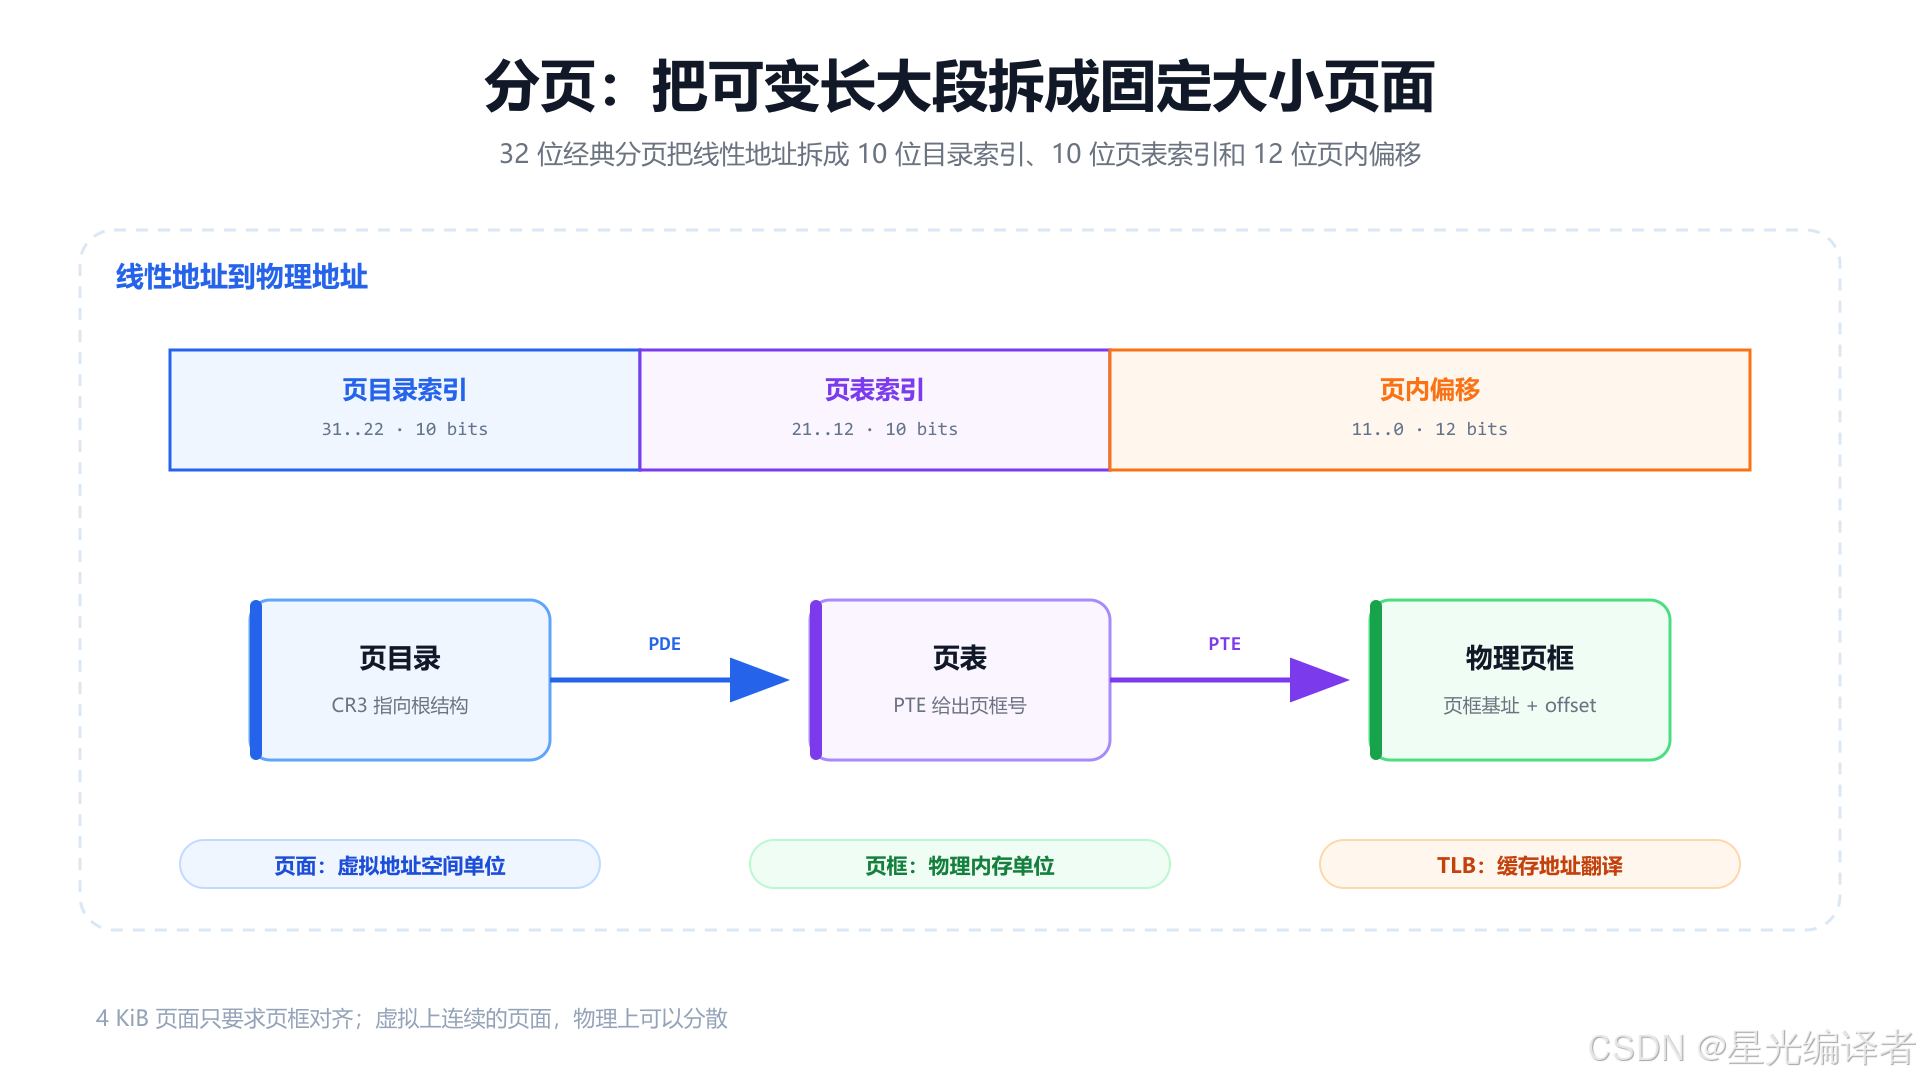
一次页表遍历可以抽象为:
text
CR3
 ↓
页目录基址
 ↓  用 bits[31:22] 选择 PDE
页表基址
 ↓  用 bits[21:12] 选择 PTE
物理页框基址
 ↓  加上 bits[11:0]
物理地址
10.2 虚拟连续不要求物理连续
假设进程看到连续的三个虚拟页面:
text
VPN 10 → PFN 91
VPN 11 → PFN  7
VPN 12 → PFN 45
虚拟地址连续,物理页框完全可以分散。页表负责保存映射关系,程序不需要知道页面实际放在哪里。
10.3 页表为什么要分层
32 位地址空间包含 2^20 个 4 KiB 页面。若为每个进程一次性建立完整单级页表,即使大量地址从未使用,也要为所有表项付出内存。
多级页表允许上层项标记整片区域未映射,只有真正使用某段地址时才建立下层页表。现代 x86-64 地址空间更大,页表层级也进一步增加。
10.4 TLB 为什么重要
如果每次读一个变量都要先访问多级页表,会额外产生多次内存访问。TLB(Translation Lookaside Buffer)缓存近期的虚拟页号到物理页框号映射。
text
TLB 命中:快速得到页框号
TLB 未命中:执行页表遍历,再把结果缓存
上下文切换、页表修改、跨核失效等问题之所以昂贵,很大一部分成本就来自 TLB 与地址翻译缓存的维护。
十一、虚拟内存:隔离、按需调页与地址空间错觉
分页是硬件地址映射机制;虚拟内存是操作系统利用分页建立的一整套抽象与策略。两者关系紧密,但不能完全画等号。
11.1 每个进程获得独立地址空间
两个进程都可以访问数值为 0x400000 的虚拟地址,但各自页表可以把它映射到不同物理页框。
text
进程 A: VA 0x400000 → 物理页框 100
进程 B: VA 0x400000 → 物理页框 812
相同虚拟地址不代表相同物理内存。只有操作系统主动把两个页表项指向同一页框时,才形成共享内存。
11.2 隔离不只是"地址不同",更来自权限位
页表项还带有读写、用户/特权、可执行等权限。CPU 在地址翻译时检查这些权限:
- 用户态访问内核页面会失败;
- 写入只读页面会触发异常;
- 在不可执行页面取指会失败;
- 未映射页面会触发缺页异常。
因此,进程隔离来自独立映射 + 硬件权限检查,不是简单给每个进程发一段不同的数字。
11.3 缺页异常不一定是错误
当访问的虚拟页面当前没有有效物理映射,CPU 触发 page fault。内核检查原因后可能:
- 为匿名内存分配一个新页框;
- 从文件读取对应页面;
- 把换出页从 swap 读回;
- 执行写时复制,创建私有副本;
- 发现访问非法,向进程发送信号或终止它。
所以,缺页异常既可能是正常的按需调页路径,也可能代表越界或权限错误。不能看到 page fault 就一概理解为"内存坏了"。
11.4 swap 不是虚拟内存的定义
swap 是虚拟内存系统可能使用的一种后备存储手段。即使系统没有启用 swap,进程仍然拥有虚拟地址空间、页表、权限隔离、文件映射和按需分配。
同样,物理内存满了也不能简单理解为"随便挑一页换到磁盘就行"。内核要考虑页面是否可回收、是否脏、是否有文件后备、是否被锁定、活跃程度和系统回收策略。
十二、Linux 与 x86-64:今天的地址变换到底怎样走
把前面的历史机制叠在一起,一次 x86 内存访问的概念路径是:
text
程序产生逻辑地址
    ↓
分段:selector + offset → linear address
    ↓
分页:linear address → page tables / TLB → physical address
    ↓
访问缓存与物理内存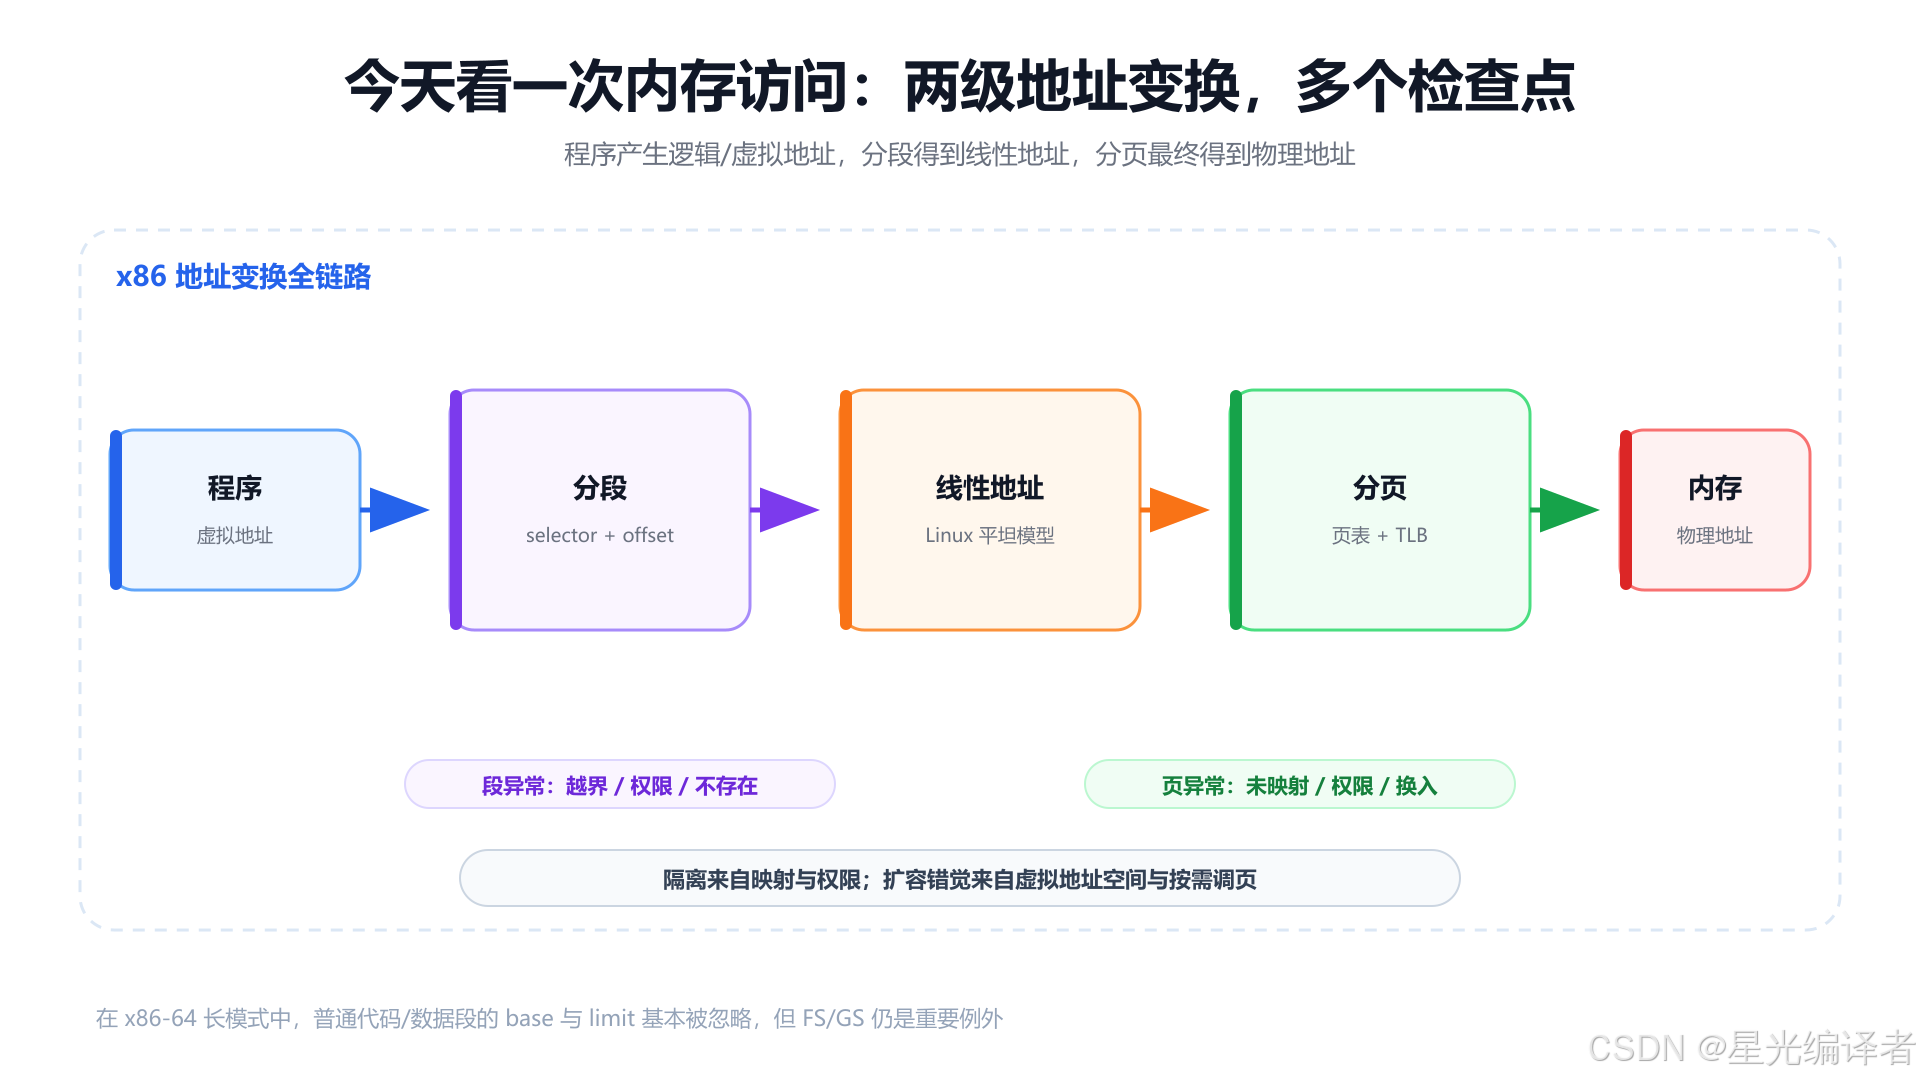
12.1 32 位 Linux 为什么常被称为平坦模型
Linux 通常把普通代码段和数据段设置为 Base 为 0、范围覆盖整个 32 位线性空间。于是程序使用的偏移值与线性地址数值相同,真正区分不同进程地址空间的是页表。
这就是"Linux 不依靠分段管理普通进程内存"的含义。它不是说 CPU 在保护模式中完全跳过所有段寄存器与描述符加载规则,而是说分段对普通地址数值的变换被配置得近乎透明。
12.2 x86-64 长模式中分段进一步弱化
在 64 位模式下,CS、DS、ES、SS 的常规 Base 基本按 0 处理,普通代码/数据段的 Limit 也基本被忽略,分页成为地址空间管理的绝对主角。
但不能说"64 位模式完全没有分段"。至少还有这些重要例外:
- FS、GS 的基址仍然有效;
- 操作系统常用 FS/GS 访问线程局部数据或每 CPU 数据;
- CS 中的部分属性仍决定当前代码执行模式与特权信息;
- GDT、TSS、门和特权转换相关结构仍有系统意义。
12.3 CPU 寄存器里存的是不是虚拟地址
在启用分页的普通进程环境中,程序可见指针和用于有效地址计算的寄存器值属于虚拟/线性地址语境,不能把它们直接当作 DRAM 物理地址。
但"所有寄存器永远只存虚拟地址"过于绝对。控制寄存器、页表项、DMA 描述符、设备寄存器和内核物理地址管理会涉及物理地址或页框号;某个普通数值寄存器本身也没有自动携带"这是虚拟地址"的类型标签。关键要看它被哪条指令、哪个硬件单元以什么语义使用。
12.4 今天应怎样建立正确心智模型
对应用开发者:
text
指针是进程虚拟地址空间中的位置对操作系统学习者:
text
虚拟地址由 MMU 结合当前地址空间的页表翻译对 x86 架构学习者:
text
历史上先分段得到线性地址,再由分页得到物理地址;
现代 64 位普通代码中,常规分段数值变换已基本透明。
这三句话分别处在不同抽象层次,并不矛盾。
十三、常见误区、高频面试题与练习
13.1 常见误区
误区一:8086 把 1 MiB 内存固定切成 16 个 64 KiB 段
不是。段基址以 16 字节为粒度移动,段窗口大量重叠;64 KiB 是 16 位偏移能够覆盖的最大范围。
误区二:实模式的段寄存器里存着完整物理基址
段值要先左移 4 位,才形成 20 位基址部分。它不是直接可用的 20 位完整物理地址。
误区三:分段只为了解决安全问题
8086 实模式分段首先解决 16 位寄存器怎样形成 20 位地址的问题,并带来动态重定位。保护与权限检查是保护模式强化的能力。
误区四:选择子就是段基址
保护模式下,选择子包含 Index、TI、RPL。它用于找到描述符,不直接等于段基址。
误区五:保护模式分段后一定直接得到物理地址
若开启分页,分段先得到线性地址,分页再把线性地址映射为物理地址。
误区六:权限检查只比较 RPL 和 DPL
不完整。CPU 还要考虑 CPL、段类型、访问方式、一致代码段和门等规则。
误区七:P 位为 0 就一定从磁盘换入
段描述符 P = 0 触发段不存在异常,页表项 Present 为 0 触发缺页异常。操作系统如何处理取决于上下文,可能换入,也可能判定非法访问。
误区八:分页彻底消灭了所有碎片
分页显著缓解外部碎片,但可能产生最后一页未用满的内部碎片;大页分配和物理连续内存需求也仍会面对碎片问题。
误区九:虚拟内存就是 swap
swap 只是可能的后备存储。虚拟内存还包括地址空间隔离、页表映射、权限控制、文件映射、按需分配与写时复制。
误区十:64 位模式完全没有分段
普通代码/数据段的 Base 和 Limit 基本淡出,但 FS/GS 基址、CS 属性、GDT/TSS 与特权转换仍然重要。
误区十一:一个虚拟地址永远对应一个固定物理地址
映射可以变化。页面可能被换出换入、迁移、写时复制,甚至在不同进程中映射到完全不同的页框。
误区十二:TLB 是页表的一部分
TLB 是处理器中的地址翻译缓存;页表通常由操作系统维护在内存中。TLB 缓存页表翻译结果,但不取代完整页表。
13.2 高频面试题
问题 1:8086 为什么需要分段?
20 位地址总线允许寻址 1 MiB,但寄存器只有 16 位。通过 segment << 4 再加 16 位 offset,可以形成 20 位物理地址。
问题 2:实模式物理地址怎样计算?
text
physical = (segment << 4) + offset在只有 20 根地址线的 8086/8088 上,超出 20 位的部分会回绕。
问题 3:分段怎样支持动态重定位?
程序使用相对段起点的偏移,运行时改变段基址即可把整个程序移动到不同位置,不必逐条修改内部地址。
问题 4:保护模式的段寄存器里保存什么?
保存段选择子。选择子通过 TI 指定 GDT/LDT,通过 Index 定位描述符,并携带 RPL。
问题 5:段描述符保存哪些关键信息?
段基址、段界限、粒度、段类型、存在位、特权级、默认操作数/地址大小以及长模式相关属性等。
问题 6:逻辑地址、线性地址、物理地址有什么区别?
逻辑地址是选择子加偏移;分段变换产生线性地址;开启分页时,线性地址再经页表变换得到物理地址。
问题 7:为什么 Linux 使用平坦模型?
把普通段 Base 设为 0、范围覆盖整个线性空间,分段不再改变普通地址数值,进程隔离和内存映射主要交给分页。
问题 8:分页为什么缓解外部碎片?
虚拟页面可映射到任意空闲物理页框,不要求整个程序或大段在物理内存中连续。
问题 9:32 位经典分页为什么是 10 + 10 + 12?
4 KiB 页面需要 12 位页内偏移;剩余 20 位分别用 10 位索引 1024 项页目录和 10 位索引 1024 项页表。
问题 10:页表和 TLB 的关系是什么?
页表保存完整映射,TLB 缓存近期翻译结果。TLB 未命中时处理器需要执行页表遍历。
问题 11:缺页异常一定表示程序错误吗?
不一定。它可能触发正常的按需分配、文件页装入、swap 换入或写时复制;也可能是非法地址或权限违规。
问题 12:为什么两个进程可以拥有相同数值的虚拟地址?
它们通常使用不同页表,同一虚拟页号可以映射到不同物理页框。
问题 13:x86-64 中 FS/GS 为什么仍重要?
它们仍支持非零基址,常用于线程局部存储和内核每 CPU 数据访问。
问题 14:GDT 最大可容纳多少个 8 字节描述符?
16 位表界限最多描述 65536 字节,除以 8 得 8192 项;第 0 项通常为空描述符。
13.3 排查清单
- 当前讨论的是实模式、32 位保护模式,还是 IA-32e 长模式?
- "地址"一词具体指逻辑、线性、虚拟还是物理地址?
- 分页是否开启?若开启,分段结果不能直接叫物理地址。
- 段寄存器保存的是实模式段值,还是保护模式选择子?
- 是否把段描述符的 P 位与页表项 Present 位混淆?
- 是否把 RPL 当成目标段权限,而忽略 CPL 和 DPL?
- 是否把 64 KiB 段理解成互不重叠的固定分区?
- 是否把外部碎片与内部碎片混为一谈?
- 是否把页面与页框混为同一个概念?
- 是否把 TLB 当作操作系统维护的完整页表?
- 是否把缺页异常一概当成程序错误?
- 是否把 swap 当成虚拟内存的全部定义?
- 是否用 32 位两级分页解释所有现代 x86-64 系统?
- 是否忘记 x86-64 中 FS/GS 和系统描述符仍有作用?
13.4 建议练习
练习一:手算实模式地址
分别计算 1234:5678、FFFF:000F 和 1000:0010 的物理地址,并找出两组能表示同一物理地址的 segment:offset。
练习二:画出选择子位图
给定选择子 0x002B,拆出 Index、TI 和 RPL,说明它会访问 GDT 还是 LDT。
练习三:计算 GDT 表项地址
假设 GDTR.base 为 0x00100000,选择子 Index 为 5,计算对应 8 字节描述符的起始地址。
练习四:解释平坦模型
分别写出 Base 为 0 和 Base 非 0 时,偏移 0x8048000 得到的线性地址,并说明为什么 Linux 更愿意把普通进程布局交给页表。
练习五:拆分 32 位线性地址
任选一个 32 位地址,计算页目录索引、页表索引和页内偏移。尝试用位运算表达:
cpp
directory = (address >> 22) & 0x3FF;
table     = (address >> 12) & 0x3FF;
offset    = address & 0xFFF;
练习六:观察进程地址空间
在 Linux 中读取 /proc/<pid>/maps,观察代码段、堆、共享库、栈和映射文件的虚拟地址范围。注意它展示的是虚拟映射,不是物理页框位置。
练习七:制造缺页
使用 mmap 申请一大片匿名空间,分别统计"只映射不访问"和"逐页写入"时的驻留集变化,理解虚拟地址预留与物理页面实际分配的区别。
练习八:查看页大小
使用 getconf PAGE_SIZE 或 sysconf(_SC_PAGESIZE) 查看系统基础页大小,再调查透明大页或 HugeTLB 为什么会使用更大页面。
练习九:理解写时复制
在 fork 前后观察父子进程的内存行为,解释为什么逻辑上复制了地址空间,却不必立刻复制所有物理页。
练习十:补充 x86-64 页表
在掌握两级分页后,再画出 4 级或 5 级页表结构,比较 CR3、PGD/PML4/PML5、页表层级与规范地址的关系。
13.5 参考资料
- Intel:Intel® 64 and IA-32 Architectures Software Developer Manuals
- Intel:System Programming Guide:Protected-Mode Memory Management 与 Paging
- Linux Kernel Documentation:Page Tables
- Linux Kernel Documentation:x86-64 Memory Management
总结
处理器下的内存管理并不是某一天突然发明出"虚拟内存",而是在硬件位宽、程序重定位、任务保护和内存利用率之间逐层演进。
整条主线可以压缩为:
text
早期程序直接使用物理地址
    ↓
8086 用 segment × 16 + offset 形成 20 位地址
    ├── 单段最大 64 KiB
    ├── 多个段可以重叠
    └── 动态基址让程序可以重定位
    ↓
实模式缺少可靠边界与权限
    ↓
保护模式用 selector 查 GDT/LDT 中的 descriptor
    ├── Base + Limit:定位与边界
    ├── Type + S:段类别与允许操作
    └── CPL/RPL/DPL/P:权限与存在性
    ↓
32 位偏移让平坦模型成为可能
可变长大段仍有外部碎片和粗粒度交换问题
    ↓
分页把线性空间切成固定大小页面
    ├── 虚拟连续,物理可以离散
    ├── 页表保存映射
    ├── TLB 缓存翻译
    └── 缺页异常支持按需装入
    ↓
操作系统借助分页建立独立虚拟地址空间
最值得记住的是下面八点:
- 实模式分段的直接动机,是用两个 16 位量形成 20 位物理地址。
segment:offset不是固定分区编号,同一物理地址可以有多种表示。- 动态重定位把程序内部偏移与实际装载位置解耦,但实模式没有可靠隔离。
- 保护模式的段寄存器保存选择子,选择子定位描述符,描述符同时携带基址、界限和权限。
- 开启分页后,分段先得到线性地址,分页再得到物理地址。
- Linux 的平坦模型是把普通分段配置得近乎透明,进程隔离主要依靠页表。
- 分页缓解外部碎片并支持离散映射,但仍有页表成本、TLB 成本和内部碎片。
- x86-64 中常规分段进一步弱化,却不能忽略 FS/GS、CS 属性、GDT 与 TSS。
当你能把一条普通指针访问还原成"逻辑地址 → 线性地址 → 物理地址",再回头看 GDT、段描述符、CR3、页表和 TLB,它们就不再是一堆零散缩写,而是同一条地址变换流水线上的不同职责。