一、引言
很多数据治理卡在一个典型问题上:元数据平台建起来了,表、字段、血缘、负责人也能查了,但业务部门仍然会问:"为什么销售额在经营看板、财务报表、活动复盘里不一样?"根因往往不是技术链路缺失,而是数据标准、命名规范、编码规范、指标口径和主数据没有和具体数据资产绑定起来。
二、为什么标准要放在元数据之后
元数据回答的是"有什么数据、在哪里、谁负责、怎么流转";数据标准回答的是"这些数据应该怎么被理解、命名、编码、计算和使用"。如果没有元数据,标准只能停留在文档里;如果没有标准,元数据平台只能成为"资产搜索引擎",很难解决跨部门协作中的语义冲突。
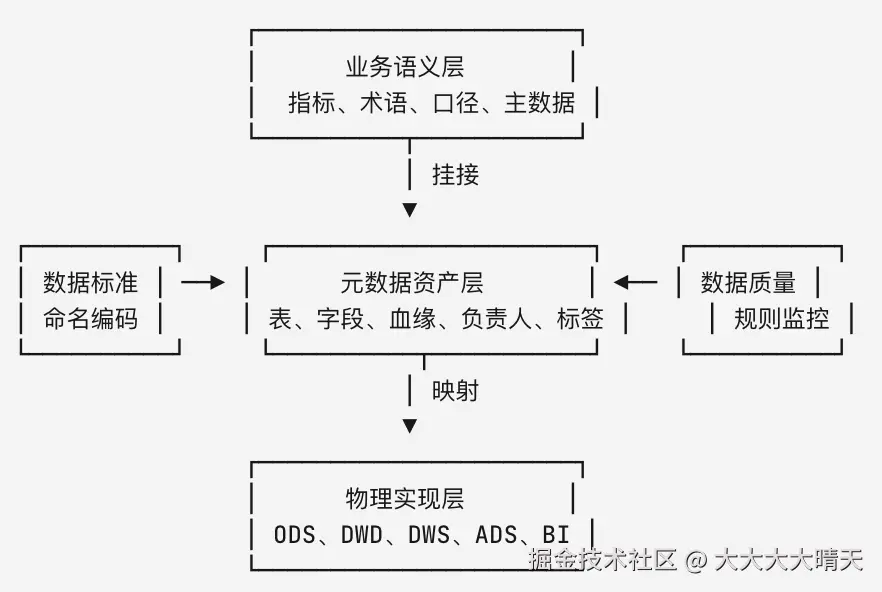
举个简单例子:
markdown
业务术语:有效订单
定义:已支付且未取消、未退款完成的订单
关联资产:
  - dwd_trade_order_df.pay_status
  - dwd_trade_order_df.cancel_status
  - dwd_trade_order_df.refund_status
关联指标:
  - 有效订单数
  - 有效成交金额
关联报表:
  - 经营日报
  - 促销活动复盘
只有当"有效订单"这个术语被挂接到字段、指标、SQL 表达式和报表上,业务才知道不同报表是否在使用同一个定义,工程团队也能判断字段变更会影响哪些指标。
三、数据标准管什么
数据标准不是"字段命名规范"的同义词,它至少包含业务定义、技术属性、质量要求、安全分类、生命周期和责任人。其价值之一是建立通用语言和结构化框架,帮助组织形成标准化的数据管理实践。落到大数据平台里,数据标准应当覆盖三个层面。
┌────────────────────────────────────────────┐
│                数据标准体系                 │
├────────────────────────────────────────────┤
│ 业务标准:业务术语、业务定义、业务规则、归属部门 │
├────────────────────────────────────────────┤
│ 技术标准:表名、字段名、类型、长度、分区、枚举值 │
├────────────────────────────────────────────┤
│ 管理标准:质量规则、安全分级、生命周期、责任人   │
└────────────────────────────────────────────┘
一个可落地的数据标准条目通常长这样:
| 标准项 | 示例 |
|---|---|
| 标准中文名 | 客户编号 |
| 标准英文名 | customer_id |
| 业务定义 | 在企业客户域中唯一标识一个客户主体的编码 |
| 数据类型 | string |
| 长度 | 32 |
| 是否主数据 | 是 |
| 所属主题域 | 客户域 |
| 质量规则 | 非空、唯一、格式合法 |
| 安全分类 | 内部数据 |
| 关联资产 | dim_customer.customer_id、dwd_order.customer_id |
| 责任角色 | 客户域数据 Owner、数据 Steward |
标准的关键不是"写全",而是"可被系统消费"。如果标准只存在于 Excel 或 Word,无法和字段、任务、指标、质量规则联动,它就很难在研发和分析过程中发挥作用。
四、命名规范解决协作成本
命名规范的目标不是追求形式统一,而是降低跨团队理解成本。一个字段名如果能表达主题、业务含义、度量对象和时间粒度,数据使用者就能少问很多问题。
推荐采用"层级 + 主题 + 对象 + 含义 + 修饰"的命名方式。
表命名:
  dwd_trade_order_df
  │   │     │     └── 分区/刷新方式:日分区全量
  │   │     └──────── 对象:订单
  │   └────────────── 主题域:交易
  └────────────────── 数仓层级:明细层

字段命名:
  actual_pay_amount
  │      │   └────── 度量对象:金额
  │      └────────── 动作/业务含义:支付
  └───────────────── 修饰:实际
常见命名建议如下:
| 类型 | 推荐规则 | 示例 |
|---|---|---|
| 数仓层级 | 使用稳定前缀 | ods_、dwd_、dws_、ads_、dim_ |
| 主题域 | 使用统一英文词根 | trade、user、product、finance |
| 主键 | 对象名 + _id | order_id、customer_id |
| 金额 | 业务含义 + _amount | pay_amount、refund_amount |
| 数量 | 业务含义 + _cnt 或 _count | order_cnt、visit_count |
| 时间 | 业务含义 + _time / _date | pay_time、stat_date |
| 状态 | 业务对象 + _status | order_status、refund_status |
| 标志位 | 业务含义 + _flag | is_valid_order_flag |
命名规范尤其要避免三类问题:
| 问题 | 示例 | 后果 |
|---|---|---|
| 同义不同名 | user_id、member_id、customer_id 混用 | 跨域 Join 和指标解释困难 |
| 同名不同义 | 不同表里的 status 含义不同 | 查询者误用字段 |
| 缩写失控 | ord_amt、act_py_amt | 新人和跨团队沟通成本高 |
命名规范应当和元数据平台联动:当字段命名不符合规则时,在建表评审、数据开发提交、数据资产注册阶段给出提示,而不是等到报表出错后再追责。
五、编码规范让数据可比较
编码规范管的是枚举值、状态值、层级码、地区码、行业码、组织码等"看似简单但影响巨大"的数据。跨系统不一致的编码会直接导致统计口径偏差。
典型问题如下:
ini
系统 A:性别
  1 = 男
  2 = 女
  0 = 未知

系统 B:性别
  M = 男
  F = 女
  U = 未知

系统 C:性别
  male   = 男
  female = 女
  null   = 未知
如果数仓不建立统一编码标准,后续每个指标、报表、模型都要重复处理映射逻辑。更糟糕的是,不同团队可能写出不同的映射规则。
建议将编码规范拆成三层:
markdown
┌──────────────┐
│ 源系统原始编码 │  保留原貌,用于追溯
└──────┬───────┘
       │ 映射
       ▼
┌──────────────┐
│ 企业统一编码   │  指标、报表、模型统一使用
└──────┬───────┘
       │ 扩展
       ▼
┌──────────────┐
│ 业务展示标签   │  面向报表、应用、用户界面
└──────────────┘
示例:
| 编码类型 | 源值 | 统一编码 | 展示值 |
|---|---|---|---|
| 性别 | M | 1 | 男 |
| 性别 | F | 2 | 女 |
| 性别 | U | 0 | 未知 |
| 订单状态 | PAID | 20 | 已支付 |
| 订单状态 | CANCELLED | 90 | 已取消 |
编码规范的落地点通常包括:
| 治理对象 | 落地方式 |
|---|---|
| 维表 | 建立统一码表,如 dim_gender_code、dim_order_status_code |
| 数据集成 | 在 ODS 到 DWD 过程中完成标准码转换 |
| 数据质量 | 检查字段值是否属于合法编码集合 |
| 指标计算 | 使用统一编码,不直接依赖源系统值 |
| 元数据 | 将字段和码表、枚举标准关联 |
六、指标体系不是指标列表
很多团队建设指标体系时,会先整理一个几百行的指标清单。但清单只回答"有哪些指标",没有回答"指标之间是什么关系、谁负责、怎么计算、何时使用"。真正的指标体系应该具备层级结构、业务归属、计算口径和资产血缘。
可以按"业务目标 - 分析主题 - 原子指标 - 派生指标 - 应用指标"组织。
markdown
业务目标:提升交易规模
│
├── 分析主题:流量
│   ├── 原子指标:访问用户数
│   └── 派生指标:访问转化率
│
├── 分析主题:交易
│   ├── 原子指标:支付订单数
│   ├── 原子指标:支付金额
│   └── 派生指标:客单价
│
└── 分析主题:履约
    ├── 原子指标:发货订单数
    └── 派生指标:履约及时率
一个指标定义建议至少包含以下字段:
| 维度 | 内容 |
|---|---|
| 指标名称 | 支付金额 |
| 指标英文名 | pay_amount |
| 指标类型 | 原子指标 |
| 业务定义 | 用户成功支付且未被取消的订单金额 |
| 统计粒度 | 用户、门店、商品、日期 |
| 时间口径 | 支付时间 |
| 计算公式 | sum(actual_pay_amount) |
| 过滤条件 | 支付成功、未取消、剔除测试订单 |
| 数据来源 | dwd_trade_order_df |
| 更新频率 | T+1 |
| 负责人 | 交易域数据 Owner |
| 关联报表 | 经营日报、活动复盘 |
| 质量规则 | 金额非负、日波动阈值、与财务对账差异阈值 |
指标体系的核心原则是:原子指标尽量稳定,派生指标通过规则组合生成,应用指标面向具体场景裁剪。这样既能保证复用,又能避免每个报表都重新定义一套口径。
七、口径管理解决结果不一致
"同一个指标为什么结果不同"通常来自五类口径差异。
markdown
┌──────────────┐
│ 指标结果不一致 │
└──────┬───────┘
       │
       ├── 时间口径不同:下单时间 vs 支付时间 vs 完成时间
       ├── 过滤条件不同:是否剔除退款、取消、测试订单
       ├── 统计粒度不同:订单粒度 vs 用户粒度 vs 商品粒度
       ├── 数据来源不同:业务库 vs 数仓明细表 vs BI 宽表
       └── 更新频率不同:实时、小时级、T+1、月结
以"销售额"为例,至少会出现三种合理但不同的口径:
| 场景 | 口径 | 适用部门 |
|---|---|---|
| 经营分析 | 支付成功金额,剔除测试订单,按支付时间统计 | 运营、业务负责人 |
| 财务核算 | 确认收入金额,考虑退款、折扣、税费、结算周期 | 财务 |
| 活动复盘 | 活动归因订单金额,按活动参与时间或支付时间统计 | 市场、增长 |
这些口径没有绝对对错,错误在于没有标明边界。口径管理要做的是把不同场景下的定义讲清楚,并把口径绑定到指标、SQL、数据集和报表。
推荐的口径管理结构如下:
markdown
指标:销售额
│
├── 经营口径
│   ├── 时间:支付时间
│   ├── 范围:支付成功订单
│   ├── 排除:测试订单、作弊订单
│   └── 用途:经营日报、业务看板
│
├── 财务口径
│   ├── 时间:收入确认时间
│   ├── 范围:可确认收入订单
│   ├── 调整:退款、税费、折扣、结算
│   └── 用途:财务报表、月结
│
└── 活动口径
    ├── 时间:活动归因窗口
    ├── 范围:参与活动用户订单
    ├── 规则:归因优先级、重复参与处理
    └── 用途:活动复盘
工程上可以将口径管理做成"指标版本 + 场景标签 + SQL 表达式 + 适用范围"。
yaml
metric_name      : sales_amount
metric_version   : v2.1
scenario         : operation_daily
time_basis       : pay_time
filter_condition : pay_status = 'PAID'
exclude_rule     : is_test_order = 0 and risk_flag = 0
owner            : trade_data_owner
valid_from       : 2026-01-01
valid_to         : null
当口径变化时,不建议直接覆盖旧定义,而应保留版本和生效时间。否则历史报表重跑、同比环比、审计追溯都会出现解释困难。
八、主数据管理稳住核心实体
主数据是企业中跨系统共享、长期稳定、具有核心业务意义的数据,例如客户、商品、组织、供应商、门店、账户等。它和指标治理的关系非常密切:如果客户、商品、组织这些核心实体不一致,指标再标准也会在维度归因上出错。
典型主数据问题如下:
css
客户主数据问题:
  CRM 系统:客户 A,编码 C001,名称 北京某某科技有限公司
  ERP 系统:客户 A,编码 100238,名称 北京某某科技
  售后系统:客户 A,编码 BJ-8891,名称 某某科技北京分公司

结果:
  销售额按 CRM 统计是一家公司
  财务应收按 ERP 统计是另一个主体
  售后满意度又落在第三个客户编码下
主数据管理要解决的是"哪个实体才是同一个实体"和"哪个属性值可信"。可以用黄金记录模式组织:
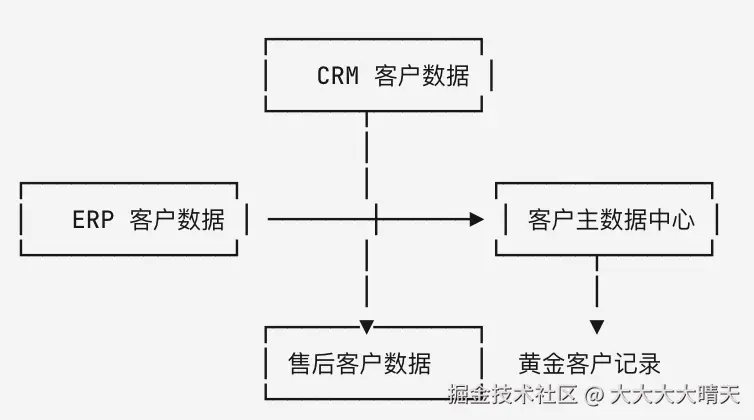
主数据管理通常包括六个动作:
| 动作 | 说明 |
|---|---|
| 识别 | 找出客户、商品、组织等核心实体 |
| 建模 | 定义主数据属性、层级、关系和生命周期 |
| 匹配 | 判断多个系统中的记录是否指向同一实体 |
| 合并 | 生成可信的黄金记录 |
| 分发 | 将主数据同步给下游系统和数仓 |
| 监控 | 检查重复、缺失、冲突、失效等质量问题 |
主数据与编码规范也要区分清楚:编码规范解决"值域如何统一",主数据解决"核心业务实体如何统一"。例如订单状态码属于编码治理,客户、商品、门店属于主数据治理。
九、标准如何挂接到资产
数据治理最容易失败的地方,是把标准写成制度,把研发过程留在制度之外。大数据工程师真正需要的是把标准嵌入数据链路。
推荐挂接关系如下:
业务术语
  │
  ├── 关联字段:表字段表达这个业务概念
  │
  ├── 关联指标:指标使用这个业务概念计算
  │
  ├── 关联码表:枚举值遵循这个业务定义
  │
  ├── 关联主数据:实体定义来自这个业务术语
  │
  └── 关联报表:报表展示这个业务概念
一条标准从"文档"进入"系统",至少要完成四类绑定:
| 绑定对象 | 示例 | 价值 |
|---|---|---|
| 字段 | dwd_order.customer_id 绑定"客户编号"标准 | 统一字段含义 |
| 指标 | pay_amount 绑定"支付金额"定义 | 统一计算口径 |
| 码表 | order_status_code 绑定订单状态编码 | 统一枚举值 |
| 主数据 | dim_customer 绑定客户主数据模型 | 统一核心实体 |
十、一个落地路线
如果已经有元数据平台,可以按以下顺序推进,不建议一开始就追求大而全。
sql
第 1 步:选主题域
  选择争议最大、报表最多、业务价值最高的主题域
  例如交易、客户、商品、财务

第 2 步:梳理核心术语
  先整理 20~30 个高频业务术语
  例如有效订单、支付金额、客户、活跃用户

第 3 步:绑定数据资产
  将术语关联到表、字段、指标、报表、负责人

第 4 步:统一指标口径
  先治理高频核心指标
  例如 GMV、销售额、订单数、转化率、复购率

第 5 步:治理编码和主数据
  优先治理跨系统 Join 和统计常用的对象
  例如客户、商品、门店、组织、订单状态

第 6 步:嵌入研发流程
  建表、改字段、上线指标、发布报表时检查标准挂接
整体路径可以表示为:
元数据盘点
   │
   ▼
核心资产识别
   │
   ▼
业务术语标准化
   │
   ▼
字段/指标/码表/主数据挂接
   │
   ▼
质量规则与口径校验
   │
   ▼
报表一致性与影响分析
最实用的切入点是"高频报表 + 核心指标 + 上游字段"。不要从全公司所有字段开始治理,而应从业务最常问、最容易争议、最影响决策的指标开始。
十一、工程实现建议
在平台能力上,可以把标准治理拆成五个模块:
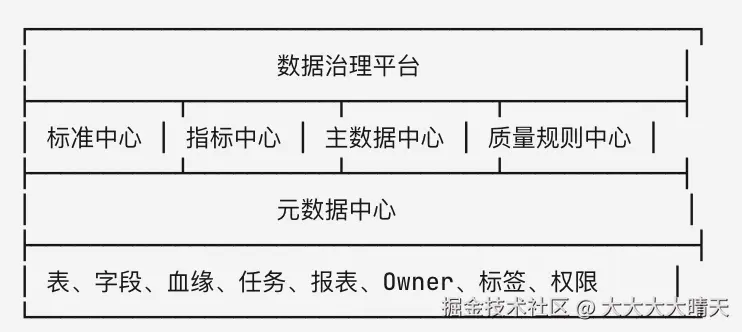
其中,元数据中心是底座,标准中心负责术语、命名、编码和字段标准,指标中心负责指标定义、公式、口径和版本,主数据中心负责核心实体统一,质量规则中心负责把标准变成可检测规则。
一个可执行的工程闭环如下:
markdown
建表申请
  │
  ├── 检查表名是否符合命名规范
  ├── 检查字段是否复用已有标准
  ├── 检查枚举字段是否绑定码表
  ├── 检查核心实体字段是否绑定主数据
  └── 检查指标宽表是否绑定指标口径
       │
       ▼
上线后监控
  │
  ├── 标准覆盖率
  ├── 字段命名合规率
  ├── 指标口径复用率
  ├── 主数据匹配率
  └── 报表口径一致性
以下指标可以用于衡量治理效果:
| 治理指标 | 含义 |
|---|---|
| 标准覆盖率 | 已挂接标准的字段数 / 应挂接字段数 |
| 指标复用率 | 使用统一指标定义的报表数 / 指标相关报表数 |
| 口径一致率 | 同名指标中口径一致的比例 |
| 主数据匹配率 | 成功匹配到主数据 ID 的记录比例 |
| 编码合规率 | 字段值落在合法编码集合内的比例 |
| 资产可解释率 | 有业务定义、Owner、来源和质量规则的资产比例 |