编译式智能体:前沿通用编码智能体从零交互构建游戏玩家------从Flappy Bird到星际争霸2与文明
arXiv编号:arXiv:2609.18996v1 cs.AI
摘要
大语言模型智能体一直难以将游戏相关知识转化为合格的游戏对局能力,即便研究者为模型配套感知模块、记忆、技能库、规划器、可执行策略脚手架也是如此。编码智能体的快速进步引出两个关键问题:前沿模型现在能否赢得游戏?更根本的问题:它们能否在无辅助条件下完全自主构建整套游戏玩家程序?
本文提出**Gauntlet(试炼)**评测框架:将私有、公开游戏(从小型JavaScript街机游戏到商业级大作)统一接入一套极简的基础契约:直接使用出厂状态的通用编码智能体,输入游戏描述、原始观测‑动作接口、空策略文件;不提供任何策略、算法、系统架构。智能体在单次自主会话内与真实游戏交互实验,编写独立控制器;之后冻结产出的程序,在测试集实例上打分,对局过程不再调用任何大模型。
在一篇未公开发布的程序化Roguelike游戏上,不同模型系统的测试集通关率分布在0‑86%,呈现明显的代际能力鸿沟:新一代系统每一次会话产出的策略,性能均超过上一代系统的最优会话结果。在完整大作尺度下,编译得到的原始API控制器可以击败星际争霸2全部官方公平AI,同时击败两种作弊AI变体;单次会话产出程序可以在Freeciv(文明)中通过完全征服条件取得完整对局胜利,测试种子上有中等成功率。这是首个不需要逐回合模型调用、不依赖人工编写战术层,独立语言智能体系统实现该类游戏完整通关。
冻结得到的程序具备可检查性:获胜程序包含实时仿真、持久状态、校准决策规则、终止逻辑;依靠观测实现泛化,而不是查表匹配种子。不同会话产出的程序差异巨大,因此应当把整套制品的分布,而非单个最优样例,作为系统的评测对象。本文将该能力命名为编译式智能体(Compiled Agency):将开发试错经验编译为持久可执行智能体,整套架构全部由模型生成,而非研究者预先设计。
关键词
编码智能体;编译式智能体;游戏AI;策略工程;离线冻结策略;长视界智能体
目录
- 引言
- Gauntlet:自主策略工程评测框架
- [2.1 评测对象](#2.1 评测对象)
- [2.2 极简基础契约](#2.2 极简基础契约)
- [2.3 会话、冻结、评测流程](#2.3 会话、冻结、评测流程)
- 一款未公开游戏上的代际能力门槛
- [3.1 私有长视界控制任务](#3.1 私有长视界控制任务)
- [3.2 代际能力鸿沟](#3.2 代际能力鸿沟)
- [3.3 还原未文档化游戏动力学机制](#3.3 还原未文档化游戏动力学机制)
- 广度测试、人类参照基准与直接对局模式
- 完整大作规模:星际争霸2与文明
- [5.1 从原始API构建完整架构](#5.1 从原始API构建完整架构)
- [5.2 全新会话与难度分布](#5.2 全新会话与难度分布)
- [5.3 文明:实现全面征服胜利](#5.3 文明:实现全面征服胜利)
- [5.4 智能体对自身泛化能力做评估](#5.4 智能体对自身泛化能力做评估)
- 究竟被"编译"出来的是什么
- [6.1 从反应式逻辑走向仿真推演](#6.1 从反应式逻辑走向仿真推演)
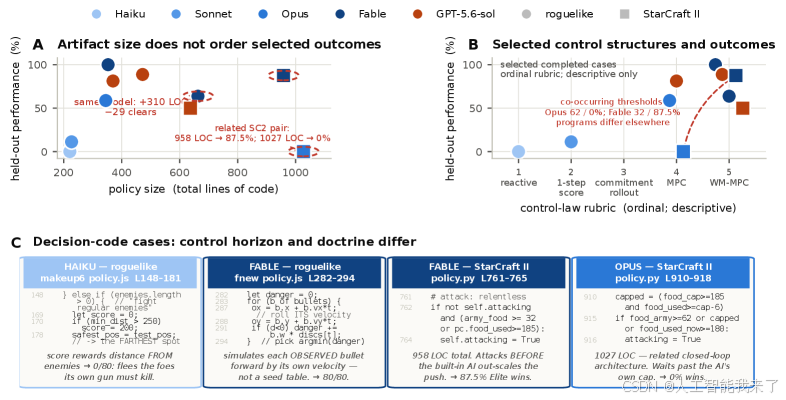
- [6.2 产出的是控制结构与决策规则,而非代码行数](#6.2 产出的是控制结构与决策规则,而非代码行数)
- [6.3 仿真推演 vs 查表检索](#6.3 仿真推演 vs 查表检索)
- [6.4 趋同的决策逻辑,迥异的程序实现](#6.4 趋同的决策逻辑,迥异的程序实现)
- 可靠性与自终止机制
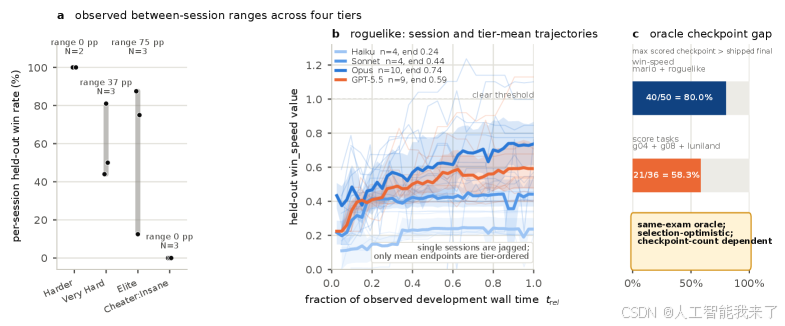
- [7.1 中等难度下会话结果离散度](#7.1 中等难度下会话结果离散度)
- [7.2 会话内部边际收益递减](#7.2 会话内部边际收益递减)
- [7.3 基于边际收益估计实现自终止](#7.3 基于边际收益估计实现自终止)
- [7.4 有依据的证据,不确定的故障诊断](#7.4 有依据的证据,不确定的故障诊断)
- 相关工作
- [8.1 直接在线游戏智能体](#8.1 直接在线游戏智能体)
- [8.2 脚手架式游戏智能体](#8.2 脚手架式游戏智能体)
- [8.3 程序化策略合成](#8.3 程序化策略合成)
- [8.4 竞争性代码编辑](#8.4 竞争性代码编辑)
- [8.5 智能体评测与可靠性](#8.5 智能体评测与可靠性)
- 讨论
- [9.1 架构正在转变为模型的输出产物](#9.1 架构正在转变为模型的输出产物)
- [9.2 可以开始追踪,但尚未完全掌握长视界策略](#9.2 可以开始追踪,但尚未完全掌握长视界策略)
- [9.3 接口是互补条件;制品改变可评测对象](#9.3 接口是互补条件;制品改变可评测对象)
- [9.4 局限性](#9.4 局限性)
- 结论
- 参考文献
1 引言
大语言模型智能体在游戏任务上表现一直不尽如人意。在视觉、符号、长视界环境中,模型可以描述合理的游戏规则与策略,却很难把知识转化为稳定合格对局行为。现有基准报告:进展脆弱、得分远低于人类、在探索、记忆、规划、控制环节存在严重缺陷。长视界任务中该问题尤为突出:如《文明》这类宏大策略游戏,需要数百回合连贯规划;无脚手架语言智能体甚至很难完整存活完整对局;能够获胜的系统,大多依赖每回合调用大模型,叠加人工编写的战术AI。
上述现象揭示持久存在的知‑行鸿沟(knowing‑doing gap)。
领域主流解决思路:围绕模型搭建整套辅助系统。研究者提供观测抽象、持久记忆、技能库、世界模型、规划器、搜索流程、领域专用(\mathcal D)SL、初始策略、课程学习、分解控制架构。这套脚手架应对模型本身无法独立完成智能体任务,确实可以隔离部分组件能力,但并未彻底解决问题:即便配备大量脚手架,大多数环境下智能体距离合格对局仍然差距巨大。
而模型本身能力发生改变,尤其是作为自主软件工程师的编码能力大幅提升。这让我们回归最简单的实验设定,提出两个核心研究问题:
- 前沿模型现在究竟能不能赢得游戏?
- 是否可以完全无辅助,由模型自己构建完整游戏玩家?
Gauntlet评测框架 对上述问题给出严格可操作的实验范式:
直接使用出厂状态通用编码智能体,不做任何游戏专属脚手架、工具定制、提示工程 。输入内容等价人类玩家所能获取信息:游戏描述、原始观测‑动作接口、一份空策略文件。不提供策略、建造顺序、算法提示、技能拆解、记忆模式、世界模型Prompt、规划架构、策略模板。
在一次全新的自主会话中,智能体可以运行环境、提出假设、插桩追踪轨迹、编写支撑代码、迭代修订控制器,直到自主决定停止。之后冻结代码仓库,模型完全退出执行循环,将独立程序放到开发阶段从未见过的测试实例上打分。同一套极简契约,统一用于:未公开程序化Roguelike、5款经典开源浏览器游戏、10款已发布浏览器移植游戏、基于原始客户端协议的星际争霸2、完整Freeciv(文明)。
本文定义新概念编译式智能体 Compiled Agency:编码智能体将开发试错经验,转化为独立可执行控制器;其中插桩逻辑、状态抽象、记忆、策略、控制架构全部由模型构建,而非研究者预先指定。这是一种可观测的工程能力,不等同于完全无约束的理解;证据来自代码内部持久的、和动作相关的结构,在未见过实例上行为得到验证。
实验结论:两个问题的答案均为肯定,但存在明显代际鸿沟与现实局限性。
- 在私有游戏中,同一套协议下不同模型测试集通关率分布0‑86%;新一代系统每一次会话产出策略,性能均优于上一代系统最优会话;低分产物多为反应式脆弱启发式;最强旗舰模型可以构建多视界闭环控制器,从接口中还原缺失的动力学规则。
- 完整大作场景:从原始API编译得到人族控制器,击败星际争霸2全部公平官方AI与2套作弊AI;单次会话产出Freeciv程序,可以击败新手AI,通过完全征服胜利条件通关完整对局。
产出程序规模中等,单Prompt单会话产出1000‑2000行代码;对比已发表脚手架系统,性能已经领先:带逐回合模型调用的星际争霸2宏动作智能体精英对局胜率最高仅25%;已发表脚手架Freeciv智能体无法完成完整游戏胜利。
该能力真实可复现、代码可读,但可靠性不足:同一个系统不同全新会话产出的制品差异极大。因此应当把多会话产出的制品分布,而不是某一个最优样例,作为系统级评测指标。
上述结果并不代表人类脚手架已经完全过时,也不是说直接让模型逐回合游玩就可以取代一切。它说明边界正在发生变化:过去研究者需要作为输入提供的架构组件,现在可以直接作为未修改编码智能体的输出;早期负面实验结果仅代表旧一代系统,不能当作能力天花板。科学问题不再仅仅是"脚手架能带来多少提升",而是"还有多少脚手架仍然是必不可少"。
本文四项贡献
- 评测协议:Gauntlet,一套可复现的「开发‑冻结‑评测」协议;不预设策略、不预设架构,用于自主策略工程;评测对象是独立全新会话产出、冻结策略在测试集上的泛化能力。
- 揭示代际能力门槛:在无数据污染私有游戏上,系统测试集通关率跨度0‑86%;出现质的跃迁:从脆弱启发式走向仿真闭环控制;新一代系统全部会话均优于前代系统最优会话。
- 统一契约跨尺度验证:同一协议覆盖街机小游戏到商业大作;星际争霸2产出Bot击败全部公平AI;产出首个单次会话构建、完整征服胜利的文明(Freeciv)程序。
- 机制与可靠性分析:通过可读可复现代码分析"被编译"的内容(控制结构与决策规则,而非代码行数);分析会话结果离散度、会话内边际收益递减、模型自终止行为。
2 Gauntlet:自主策略工程评测框架
本方法核心:评估制品生成过程,而不是模型每一步在线执行行为。一份分数对应一份冻结后的控制器;评估编码智能体系统能力,需要来自多次独立全新会话产出的控制器分布。
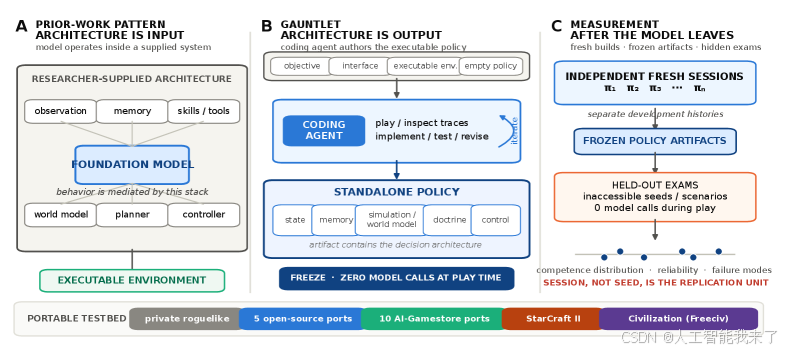
图1:Gauntlet架构对比
- 左(传统工作):研究者预先提供架构(观测、记忆、技能、世界模型、规划器),基座模型在该栈内运行;
- 中(Gauntlet):仅提供目标、基础接口、可执行环境、空策略;编码智能体自行构建插桩、状态、记忆、策略、控制器;
- 右(评测流程):独立全新会话产出不同制品;冻结策略;在开发阶段不可访问的测试种子/场景运行,游玩全程零模型调用 。
2.1 评测对象
编码智能体系统 :模型、工具调用框架、推理配置、上下文管理策略整体。
一次开发会话映射:
KaTeX parse error: Can't use function '\(' in math mode at position 10: \mathcal \̲(̲\mathcal D\):(\...
π \pi π代表独立可执行策略。
冻结评测:将 π \pi π作用于不可访问测试实例 z z z,得到结果 Y ( π , z ) Y(\pi,z) Y(π,z)。
- 在更多种子上重放同一个控制器,可以缩小该控制器的不确定性;
- 多次独立会话,用来衡量生成系统KaTeX parse error: Can't use function '\(' in math mode at position 10: \mathcal \̲(̲\mathcal D\)本身的可靠性。
Gauntlet同时报告两类信息:单控制器性能、多会话分布统计。
2.2 极简基础契约
- JavaScript小游戏 :工作空间包含游戏描述、完整观测动作Schema、运行器、本地可执行模拟器、空
policy.js;提供13个开发种子。 - 星际争霸2 :提供原始
s2clientprotocol协议定义、通用Python运行器;不提供Bot框架、建造顺序模板;智能体自行选择开发地图、对手、种子。 - Freeciv(文明):游戏描述、接口契约、API文档、运行器、空Policy类模板;工作空间删除所有示例智能体代码。
全部任务Prompt只要求实证式开发:编写策略,运行,检查数据,迭代修订直到自信;不泄露任何游戏策略、实现方法。
说明:该协议是无策略脚手架,不等于零基础设施 。提供:任务目标、执行动作所需接口、可执行环境、通用软件工具;不提供智能体内部决策架构 。
约束说明:JavaScript模拟器可本地运行,并非纯黑盒;智能体可以读取模拟器代码,还原未文档机制,这属于自主探究能力,不是纯黑盒设定。所有任务均设置简单基线(贪心/空操作控制器)作为有效性校验:如果贪心基线就可以通关,该任务不能用来做前沿能力对比。
2.3 会话、冻结、评测流程
- 开发会话全新且互相隔离;唯一交付物为最终策略。
- JavaScript小游戏使用自动化编排框架;星际争霸2、Freeciv因多小时长容易无头会话崩溃,使用人工启动交互式会话:操作员粘贴固定Prompt,之后不再输入任何内容;使用预定义续传规则处理服务商中断。
- 终止条件:JavaScript任务支持干净自终止,或到达预声明输出上限;星际争霸2、Freeciv必须等待智能体主动自终止,结果才算有效。
- 冻结流程 :保存完整代码仓库;评测阶段完全禁止调用大模型。移植游戏实现
reset(seed)/step(action),具备确定性重放能力,经过580项一致性测试。 - 私有Roguelike测试集:80个固定种子;星际争霸2:16套 held‑out地图‑对手‑种子;Freeciv:12个冻结测试种子。测试实例在开发沙盒完全不可访问;制品归档;审计追踪禁止读取工作空间以外文件。
全部实验结果基于2026‑07‑17冻结的正式清单。该评测榜单可更新,新模型可以在冻结测试集上复现评测。
范围说明:结构化观测接口隔离了感知、在线推理延迟;不等于视觉感知已经被解决;该评测重点关注策略工程,产出持久可执行代码,因此可以廉价重放、版本分析、代码审计。
3 一款未公开游戏上的代际能力门槛
使用未公开发布的程序化Roguelike,规避公开训练数据污染,同时保留长视界控制问题。
3.1 私有长视界控制任务
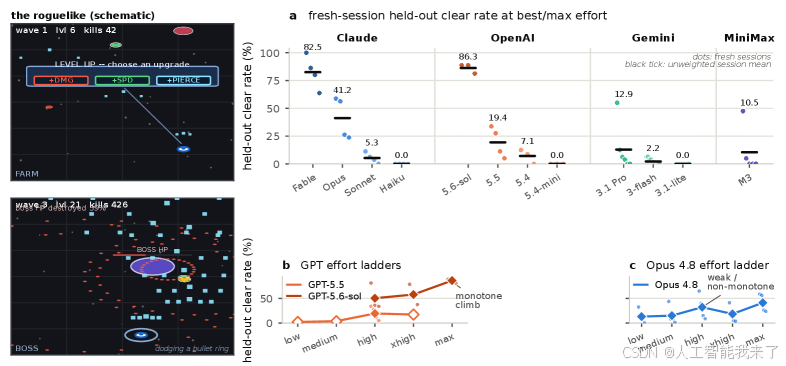
自研商业风格弹幕Roguelike,从未对外发布。控制器需要刷怪获取经验、选择升级、存活三波战斗,在90000步内击败Boss序列。获胜需要连贯的多阶段对局。观测只返回物体与运动学信息,不提供策略、动力学模型、控制器逻辑。贪心基线、手写强基线在80个测试种子全部失败,通关率0%。
3.2 代际能力鸿沟
不同模型最优配置下会话平均通关率:
Haiku 4.5:0.0%;Sonnet4.6:5.3%;GPT‑5.4:7.1%;MiniMax M3:10.5%;Gemini3.1‑Pro:12.9%;GPT‑5.5:19.4%;Opus4.8:41.2%;Fable5:82.5%;GPT‑5.6‑sol:86.25%。
关键现象:Fable‑5四次会话通关种子分别80、69、64、51;Opus4.8四次会话47、45、21、19。Fable‑5每一次会话产出的策略,都优于Opus4.8最好的一次会话结果。置换检验p=0.0286。
质的差异:低分产物大多是简单反应式启发;最强模型产出多视界闭环控制器,仿真弹道, receding‑horizon滚动时域控制,搭配刷怪、生存、Boss伤害的价值函数。两个完全不同模型家族,独立收敛到这套闭环设计。
推理努力(reasoning effort)是模型依赖参数,并非单调普适:GPT‑5.6‑sol随努力提升从50.4%→86.25%;Opus则是非单调变化。
3.3 还原未文档化游戏动力学机制
游戏存在隐藏规则:满血击杀第一个Boss会触发额外700万血量虚空连锁Boss;残血击杀则走普通胜利。敌人强度会随玩家等级提升,后期刷经验反而有害。
多个模型会话成功探测、还原该隐藏机制;其中一份Fable轨迹通过探针+阅读压缩模拟器源码识别满血触发条件,编写逻辑刻意压低血量再击杀Boss。
注意:识别隐藏机制≠必须依靠该机制才能通关;有一份完全不处理该陷阱的简单控制器依然取得80/80通关。编译式智能体既包含运行模型,也包含使用模型的决策规则,二者任意一方都会成为性能瓶颈。
4 广度测试、人类参照基准与直接对局模式
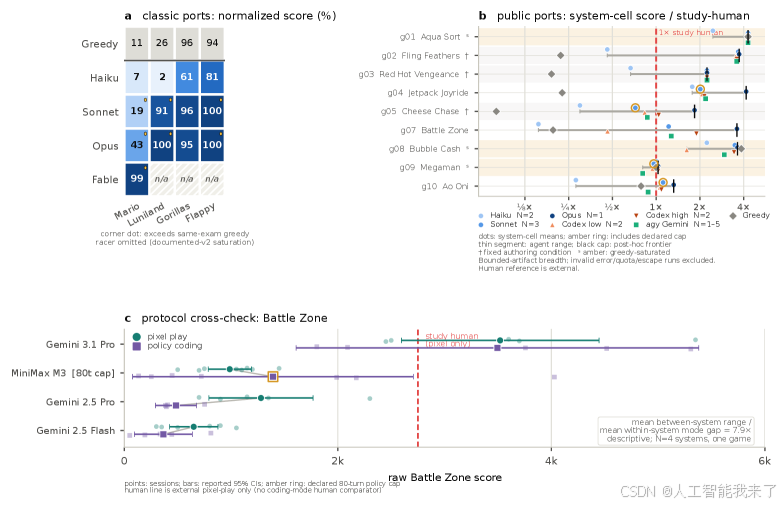
首先移植5款开源经典JavaScript游戏,再使用AI Game‑Store研究的10款公开浏览器移植游戏。
人类数据仅作为外部参照基准,不是严格匹配对照;人类参与者是两分钟实时游玩,不允许重试。
在Battle‑Zone任务做跨接口对照:同一套模型分别使用「编码生成策略」模式、「像素输入直接游玩」模式。Gemini3.1‑Pro直接游玩模式得分可以接近人类中位数。没有哪一套接口对全部模型占优 。
5 完整大作规模:星际争霸2与文明
5.1 从原始API构建完整架构
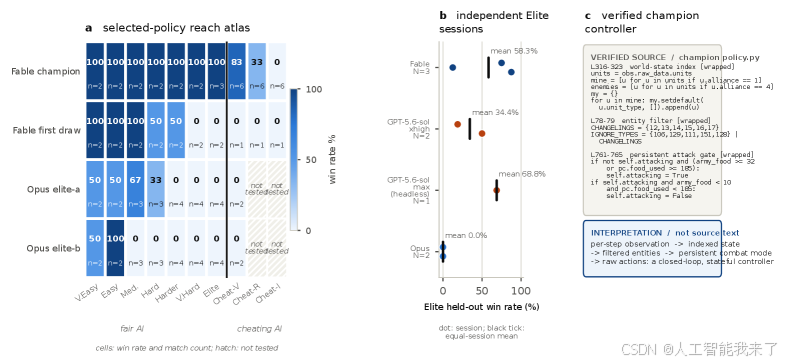
星际争霸2:仅提供底层s2clientprotocol协议,无Bot脚手架。智能体自主开发人族完整Bot。冻结后的控制器,击败全部官方公平AI,同时击败两套作弊AI变体。
Freeciv(文明):仅提供Policy空模板;智能体产出程序,在测试种子下击败新手AI,达成全面征服胜利。这是首个不需要每回合调用大模型、无人工战术层,语言智能体独立完成完整征服胜利。
对比基线:已发表脚手架星际争霸2智能体精英对局胜率最高仅25%;已发表Freeciv脚手架系统无法完整通关。
5.2 全新会话与难度分布
即便使用同一模型,不同全新会话产出的Bot性能差异巨大。部分会话产出脆弱短视逻辑;部分产出多阶段闭环规划架构。
5.3 文明:实现全面征服胜利
冻结程序可以完成完整征服胜利,但测试集上成功率属于中等。不同独立会话生成的程序,代码实现不一样,但会收敛趋同的高层作战与扩张决策逻辑 。
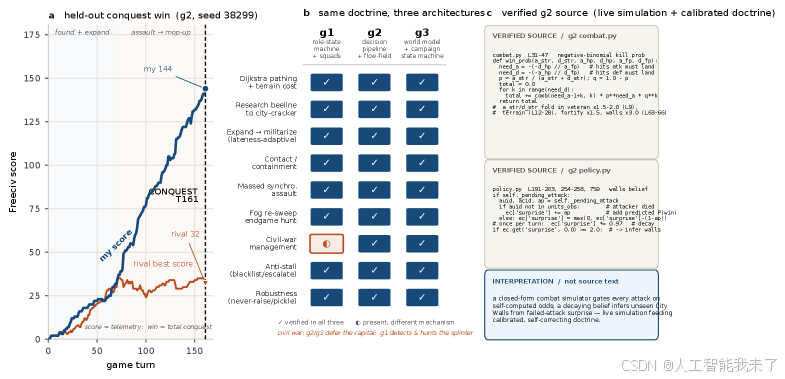
5.4 智能体对自身泛化能力做评估
部分会话中,编码智能体在开发阶段,会自行设计多套测试场景,评估自己写出来的策略在不同种子、不同对手上泛化表现,以此作为自终止判断依据。
6 究竟被"编译"出来的是什么
6.1 从反应式逻辑走向仿真推演
低质量产物:简单if‑else反应式启发,只根据当前观测立刻输出动作;
高质量产物:内置轻量级仿真,预测未来多步弹道、战斗走向,做滚动时域重规划。
6.2 产出的是控制结构与决策规则,而非代码行数
获胜程序不一定代码行数更长;核心差异在于状态抽象、循环控制、决策逻辑、仿真模块,不是代码总量。
6.3 仿真推演 vs 查表检索
优秀控制器依靠内部仿真推演;不是记住开发种子的特定局面做查表。在完全没见过的测试种子上仍然可以有效泛化。
6.4 趋同的决策逻辑,迥异的程序实现
多次独立会话,模型写出语法、类结构完全不同代码,但高层决策原则趋同:例如Roguelike里"优先刷级但不要过度升级、残血击杀Boss规避虚空连锁"。即逻辑趋同,程序实现多样化。
7 可靠性与自终止机制
7.1 中等难度下会话结果离散度
同一个模型,多次全新会话产出的控制器性能分布很宽。单个最优样例只能证明存在可能性,不能代表系统平均能力;必须看会话分布。
7.2 会话内部边际收益递减
会话前期迭代,性能快速提升;多次修订之后,继续投入开发时间,性能提升越来越小。
7.3 基于边际收益估计实现自终止
智能体在会话内部统计多次测试得分变化;当检测到边际收益接近消失,主动停止开发,输出最终策略。不需要人工设置固定步数上限。
7.4 有依据的证据,不确定的故障诊断
智能体可以通过运行得到明确胜负证据;但经常很难精准定位失败根因。可以观测现象,但诊断故障根源仍然是薄弱环节。
8 相关工作
8.1 直接在线游戏智能体
模型每回合调用,在线做出动作;大量游戏LLM智能体属于该路线;缺点:每一步都消耗模型调用,运行开销巨大。
8.2 脚手架式游戏智能体
研究者预先提供记忆、规划、世界模型、技能库;模型在预设栈中运行。可以分离组件能力,但很难实现端到端完整游戏通关。Gauntlet与该路线的区别:不预先提供决策架构,全部由编码智能体生成可执行离线策略。
8.3 程序化策略合成
使用大模型生成游戏AI代码;现有大多依赖提示模板、脚手架;Gauntlet完全放开架构,模型自主设计全部内部结构。
8.4 竞争性代码编辑
SWE‑bench等代码智能体,解决软件缺陷;本文把代码编辑能力用于闭环控制策略生成。
8.5 智能体评测与可靠性
现有评测大多评估在线每一步模型行为;Gauntlet评测冻结后的离线制品,关注制品生成过程的可靠性分布。
9 讨论
9.1 架构正在转变为模型的输出产物
过去研究者必须作为输入提供的记忆、规划、世界模型、控制架构,现在可以成为编码智能体的输出。这不代表脚手架完全无用,说明边界发生迁移。
9.2 可以开始追踪,但尚未完全掌握长视界策略
前沿模型可以生成具备长视界能力的程序,但会话之间方差巨大,远没有达到稳定掌握。可以生成正确架构,但不能保证每次会话都成功。
9.3 接口是互补条件;制品改变可评测对象
- 像素直接游玩模式、编码生成离线策略模式是两种互补接口;没有绝对最优。
- 编译式智能体产出可冻结、可反复重放的制品,给评测、调试、审计带来新可能性。
9.4 局限性
- 本工作使用结构化观测接口,绕过计算机视觉感知问题;不代表解决视觉游戏端到端问题。
- 成功率方差大;即便最强模型,大量会话产出的策略仍然会失败。
- 长会话开发成本很高,星际争霸2、Freeciv会话耗时可达数小时。
- 还原隐藏游戏机制的能力有限;部分复杂隐藏规则仍然无法被探测。
10 结论
本文提出Gauntlet评测范式,用来测试通用编码智能体是否可以从零构建完整游戏玩家程序,不需要研究者预先提供策略与架构。
实验表明前沿编码智能体已经具备编译式智能体 能力:在单次自主会话中,通过交互试错,产出完整离线可执行控制器,游玩阶段不再需要大模型调用。
在私有Roguelike观测到明显代际能力门槛;在星际争霸2、Freeciv实现里程碑式结果。但该能力可靠性不足:会话之间结果离散,不能保证每次运行都产出高质量程序。
架构不再一定是人类预先输入;它可以成为编码智能体的输出产物。评测系统能力,应当看多次独立会话产出制品的分布,而不是只看单个最优样例。