访问浏览器指纹检测网站时,页面往往只需要几秒钟,就能列出浏览器版本、语言、时区、屏幕分辨率、Canvas、WebGL 等信息。
这些数据并不是网站凭空知道的。
浏览器为了支持网页功能,会通过不同 API 暴露一部分软件和设备环境信息。例如,网页需要知道语言来显示对应内容,需要知道屏幕尺寸来调整布局,也可能读取图形能力来运行 WebGL。浏览器指纹技术利用的,正是这些原本服务正常网页功能的信息。
如果继续打开开发者工具查看网页代码,就可能看到它读取 navigator、创建 Canvas、获取 WebGL 信息,再把多个结果一起发送出去。
这时会出现一个更具体的问题:
浏览器指纹逆向,究竟是在逆什么?
这里所说的"逆向",主要是顺着网页代码和网络请求往回找:这些信息从哪里读取、经过了什么处理,最后又怎样组合后发送出去。
它并不等同于破解某种加密算法。
遇到经过压缩或混淆的 JavaScript 代码时,确实可能需要静态分析、断点调试或运行时观察,但最终目标仍然是找到:
浏览器暴露出的各种信息,是怎样一步步被读取、处理,并变成最终提交结果的。
所以,如果把浏览器指纹逆向理解成"拿到一个哈希值,再反推出用户真实设备",方向往往一开始就偏了。
实际分析中,更有价值的是重新找到这条过程:
网页读取了什么 → 怎样处理 → 怎样组合 → 最后哪些信息还会被一起判断。
理解这条过程之后,Canvas、WebGL、User-Agent、语言和时区才不再是一组彼此孤立的参数。
浏览器指纹逆向首先要找的是数据从哪里来
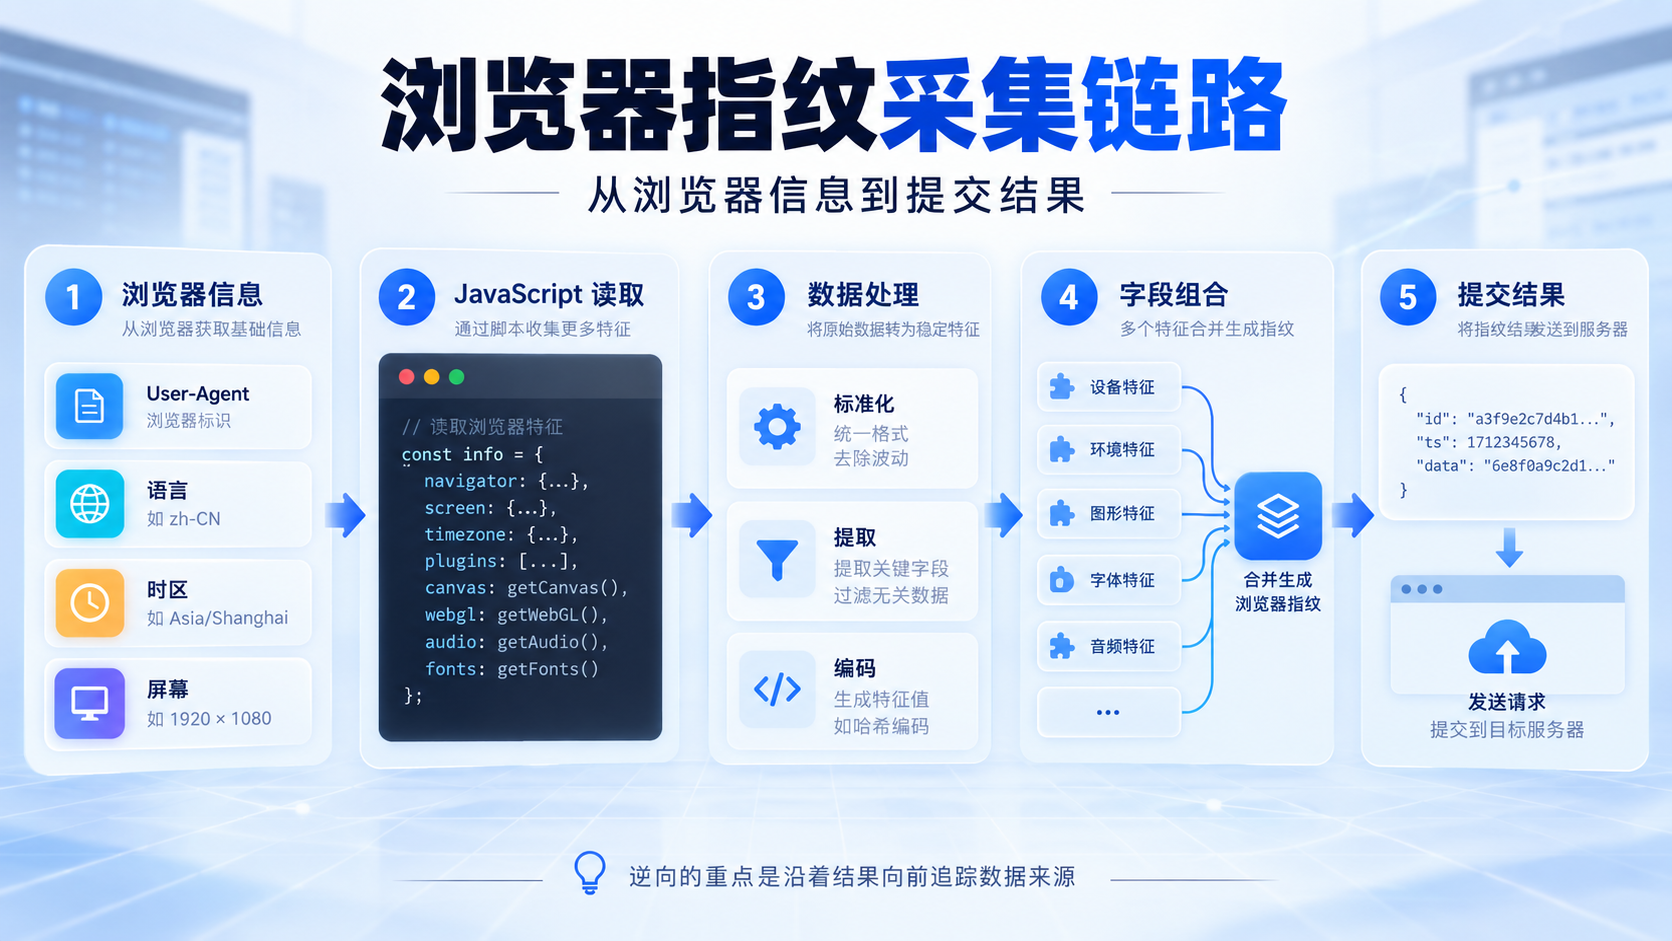
MDN 对浏览器指纹的定义很直接:网站可以利用浏览器和操作系统暴露的多种特征识别特定浏览器,其中可能包括浏览器版本、时区、语言、编解码器、字体、浏览器设置、屏幕尺寸和分辨率等信息。
浏览器并不存在一个专门叫"获取浏览器指纹"的统一接口。
通常的做法,是分别从多个浏览器 API 读取信息,再把这些结果组合起来。
所以看到一个最终的指纹字符串时,第一步通常不是研究这个字符串本身,而是往前追:
它的输入来自哪里?
一个简化的采集脚本可能是这样:
const snapshot = {
  userAgent: navigator.userAgent,
  languages: navigator.languages,
  platform: navigator.platform,
  hardwareConcurrency: navigator.hardwareConcurrency,
  screenWidth: screen.width,
  screenHeight: screen.height,
  colorDepth: screen.colorDepth,
  timeZone: Intl.DateTimeFormat().resolvedOptions().timeZone
};

console.table(snapshot);
这里还没有什么神秘算法,只是在读取浏览器公开提供的信息。
Navigator 是网页获取浏览器和设备部分状态信息的标准接口之一。例如:
-
navigator.userAgent可以读取 User-Agent; -
navigator.languages可以读取语言偏好; -
navigator.hardwareConcurrency可以读取浏览器公开的逻辑处理器数量。
User-Agent 可以简单理解为浏览器向网页声明的浏览器、版本和系统信息之一。现代浏览器也在逐步减少 User-Agent 暴露的细节,以降低它被用于指纹识别的价值。
真正进入逆向分析之后,需要继续问三个问题:
哪些 API 被调用了?返回值是否经过处理?最后哪些字段被一起提交或参与计算?
这比只盯着最终结果更重要。
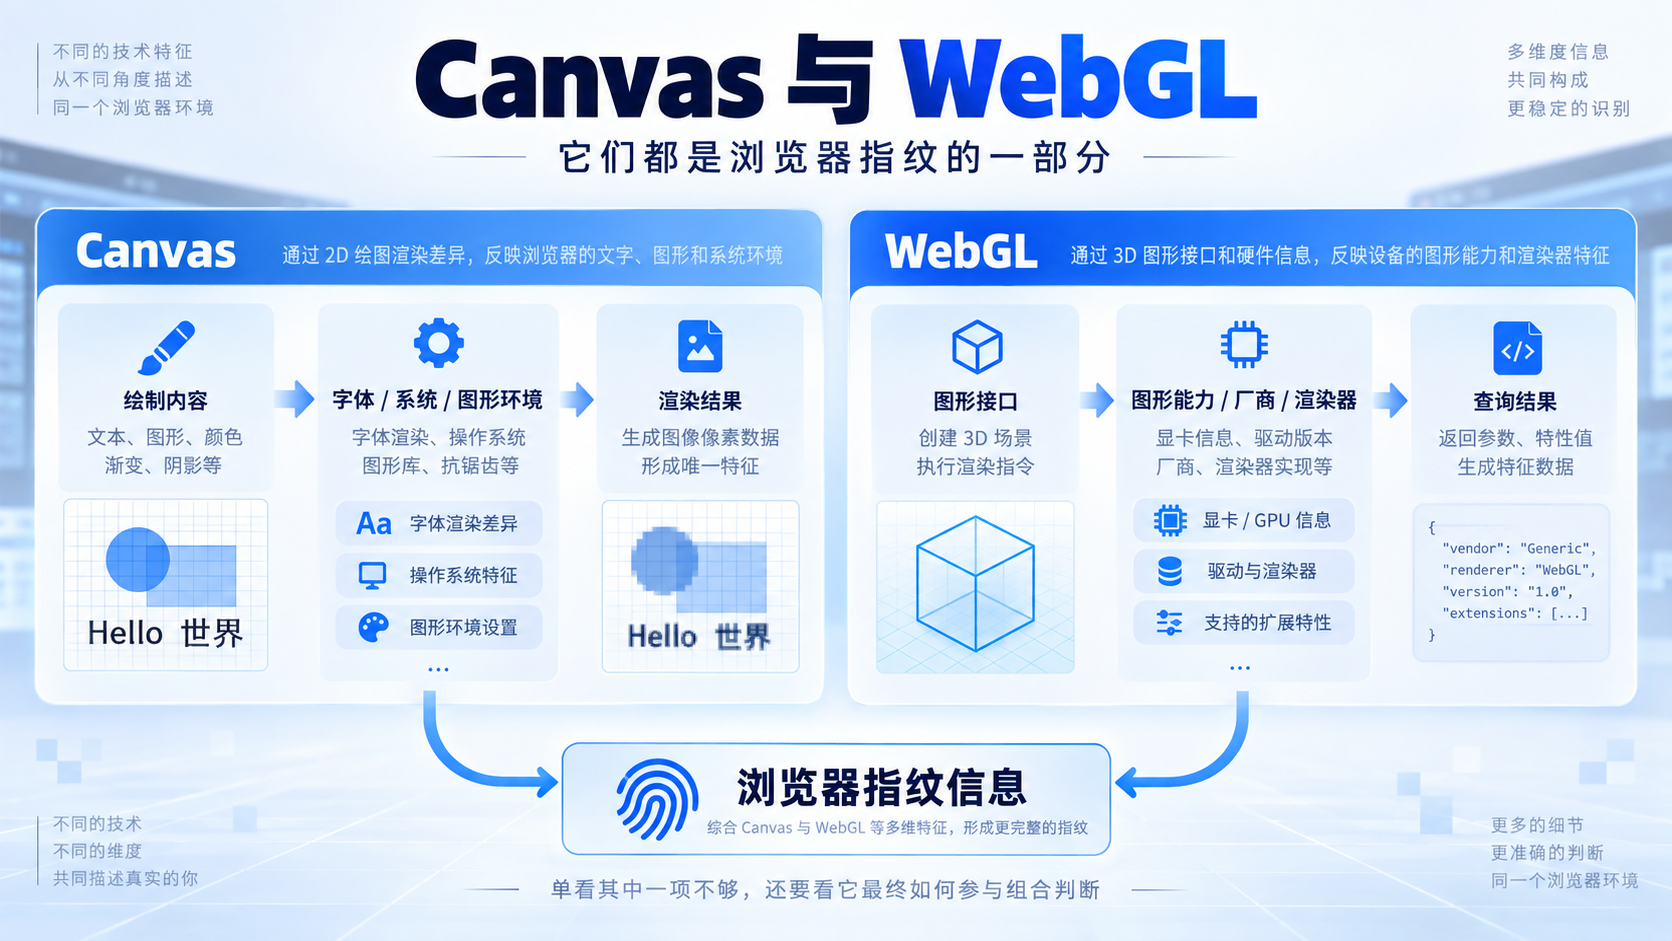
Canvas 为什么经常出现在浏览器指纹代码里
Canvas 本来的用途,是让 JavaScript 在网页中绘制文字、图形和图像。
浏览器可以通过 toDataURL() 等方法,把绘制后的画布内容转换成数据。
MDN:HTMLCanvasElement.toDataURL
在浏览器指纹采集中,一个常见做法是:
网页创建一个 Canvas,使用固定参数绘制文字或图形,然后读取最终绘制结果。
一个便于理解的简化示例:
const canvas = document.createElement("canvas");
const ctx = canvas.getContext("2d");

ctx.textBaseline = "top";
ctx.font = "16px Arial";
ctx.fillStyle = "#f60";
ctx.fillText("browser fingerprint", 10, 10);

const result = canvas.toDataURL();

console.log(result);
为什么同一段代码可能产生具有识别价值的结果?
可以把它理解成两台电脑用同一段代码画同一句文字。
JavaScript 只是告诉系统"画什么",真正完成绘制的还包括本机字体、操作系统、图形系统和浏览器。不同环境在字体形状、边缘平滑和像素处理等细节上可能存在差异。
因此,最终图像并不只由 JavaScript 代码决定。
实际的指纹脚本通常也不会直接保存完整图片,而可能进一步进行编码、截取或者计算哈希值。
所以逆向 Canvas 指纹时,真正需要还原的是:
绘制了什么 → 使用了哪些绘图参数 → 在哪里读取结果 → 结果又经过了什么处理。
如果只拿到了最后一个哈希值,却不知道它前面输入了什么,那么可解释的信息其实很少。
WebGL 看的不只是一个显卡名称
WebGL 是浏览器提供的图形接口,可以让网页调用设备图形能力完成 2D 和 3D 渲染。
因此,一些浏览器指纹脚本除了查看 WebGL 是否可用,还会读取浏览器支持哪些图形能力,以及当前图形渲染器暴露出的相关信息。
例如:
const canvas = document.createElement("canvas");
const gl = canvas.getContext("webgl");

if (gl) {
  const debugInfo = gl.getExtension("WEBGL_debug_renderer_info");

  if (debugInfo) {
    console.log(
      gl.getParameter(debugInfo.UNMASKED_VENDOR_WEBGL)
    );

    console.log(
      gl.getParameter(debugInfo.UNMASKED_RENDERER_WEBGL)
    );
  }
}
其中 WEBGL_debug_renderer_info 是一个 WebGL 扩展。
在浏览器允许的情况下,它可以读取更具体的图形厂商和渲染器信息。
不过,这个扩展是否可用,会受到浏览器以及隐私设置影响。
所以不能假设所有浏览器都一定能够返回完整的图形厂商和渲染器信息。
这也是逆向时容易忽略的一点。
没有返回某个字段,本身也可能反映当前浏览器环境的状态。
因此分析 WebGL 时,不应该只记住一个渲染器名称,还需要观察:
-
网页读取了哪些参数;
-
浏览器支持哪些图形能力;
-
哪些查询成功;
-
哪些查询失败;
-
最终哪些结果又被继续使用。
浏览器指纹通常来自多项信息
真正的浏览器指纹通常不是由一个参数决定的,而是由多项浏览器和设备信息共同组成。
| 信息 | 常见读取方式 | 主要反映什么 |
|---|---|---|
| User-Agent | navigator.userAgent |
浏览器和系统声明信息 |
| 语言 | navigator.language、navigator.languages |
浏览器语言偏好 |
| 时区 | Intl.DateTimeFormat() |
当前浏览器时区 |
| 屏幕 | screen |
分辨率、色深等显示信息 |
| 逻辑处理器数量 | navigator.hardwareConcurrency |
浏览器公开的处理器并发信息 |
| Canvas | Canvas API | 图形和字体渲染结果 |
| WebGL | WebGL API | 图形能力和部分渲染器信息 |
除此之外,网站在进行更完整的设备识别、账号状态判断或风险分析时,还可能观察另一类信息,例如:
-
Cookie;
-
本地存储(LocalStorage);
-
IndexedDB;
-
登录状态;
-
历史会话状态。
这些信息需要和浏览器指纹本身区分开。
Cookie、本地存储和登录状态严格来说并不是浏览器指纹参数,而是有状态的浏览上下文数据。
浏览器指纹更偏向利用浏览器和设备特征进行识别,而 Cookie 等数据记录的是:
这个浏览上下文之前发生过什么。
不过在更完整的账号环境、设备识别或风险判断中,这两类信息可能同时被观察。
因此,逆向时如果只定位了一个 canvas.toDataURL(),其实只完成了一小部分工作。
更值得继续追的是:
这个 Canvas 结果最后和什么放在了一起。
指纹哈希值通常不是最值得"逆"的部分
假设最后看到这样的逻辑:
const raw = [
  userAgent,
  language,
  timeZone,
  canvasResult,
  webglRenderer
].join("|");

const fingerprint = hash(raw);
这时真正有价值的,不是试图把 fingerprint 直接反推出原始机器。
哈希值(Hash)可以简单理解为:
把一组输入按照固定规则计算成一个结果值。
在正常使用单向哈希算法时,相同输入通常会得到相同的哈希值,因此它可以用于快速比对;但仅凭最终哈希值,通常无法完整恢复原始输入。
所以浏览器指纹逆向真正值得做的是继续往前找:
fingerprint
→ raw
→ 字段组合顺序
→ 字段处理过程
→ 每个字段的采集函数
→ 对应浏览器 API
这样,一个原本无法解释的字符串,就重新变成了一组可以分析的信息。
这也是为什么浏览器指纹逆向和传统意义上的"破解哈希值"并不是一回事。
重点不是还原最终哈希值,而是还原这个结果是怎样产生的。
为什么单个参数正常还不够
追到这里还没有结束。
假设一个浏览器环境分别返回了:
浏览器版本、操作系统信息、WebGL 渲染信息、屏幕分辨率、语言、时区,以及根据 IP 地址推断的地区。
单独看,每个值都有可能"正常"。
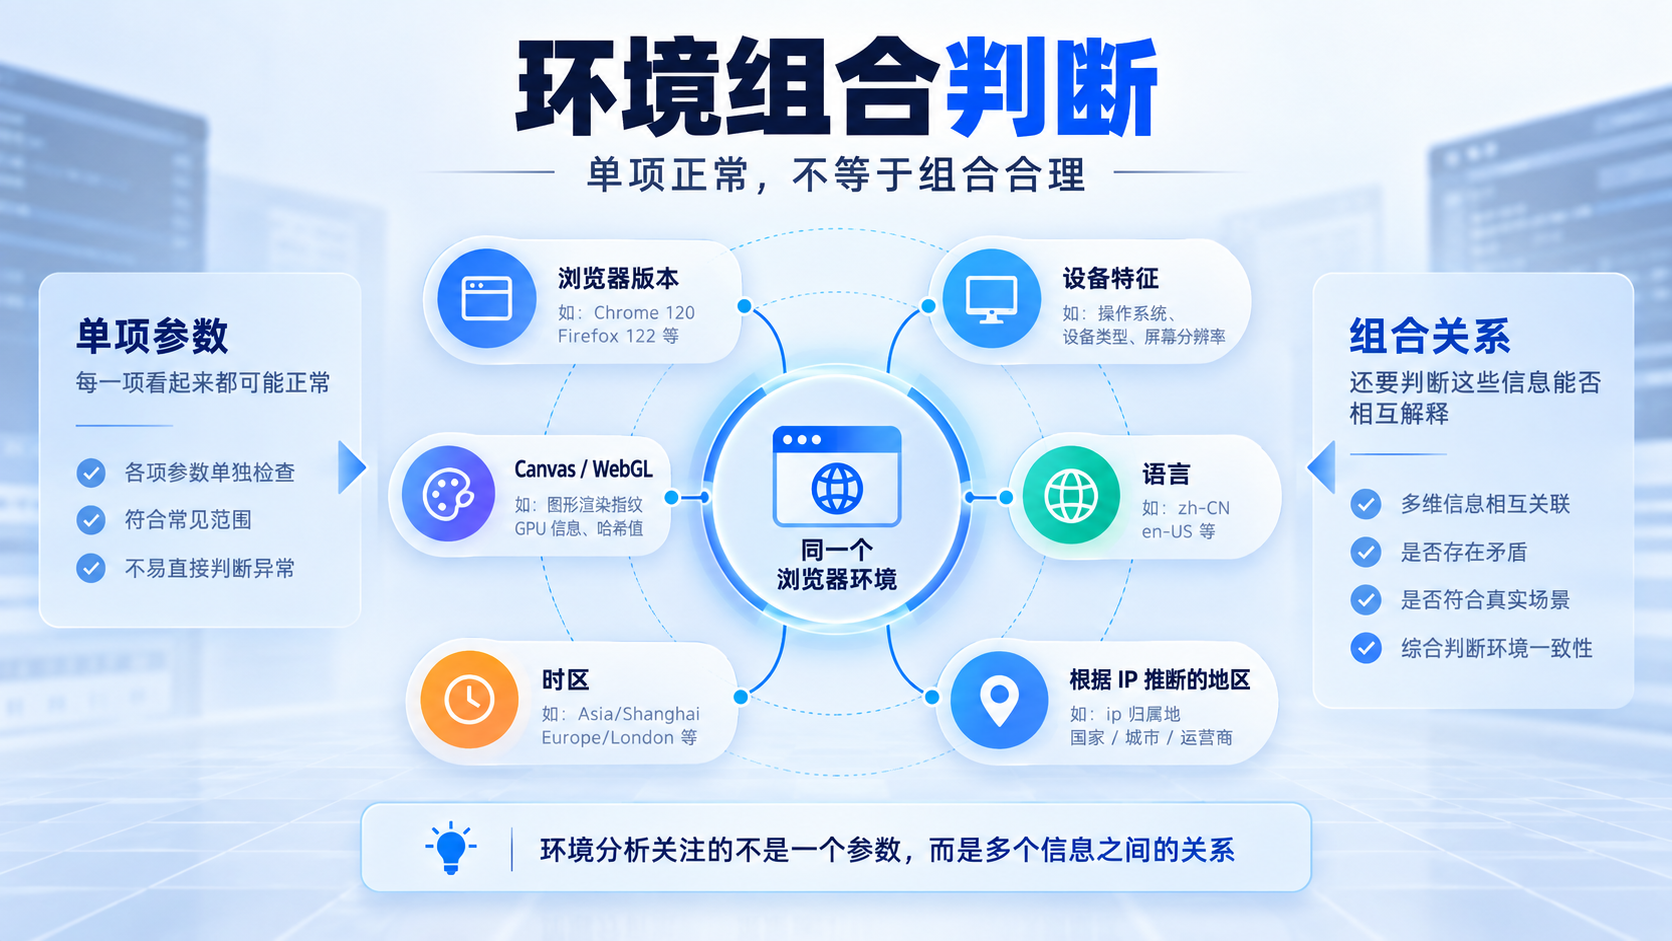
但在更完整的设备识别或风险判断中,这些信息还可能被放在一起检查,看它们是否形成合理的组合。
例如,网站可能同时观察根据 IP 地址推断的地区、浏览器时区和语言设置。
单独一个值并不能直接说明异常,但如果目标系统确实会组合这些信息,那么它们之间长期呈现出的关系就可能成为判断的一部分。
这里必须保留一个重要边界:
单个参数不一致,并不能直接证明浏览器环境有问题。
浏览器隐私保护、User-Agent 信息缩减、虚拟化环境、远程桌面、代理或 VPN,以及用户自己的系统设置,都可能让不同信息之间出现看似不一致的情况。
不同网站究竟采集哪些信息、如何处理这些信息,也没有一套统一规则。
因此真正值得分析的,不是某一个参数是否"完美",而是:
目标脚本究竟读取了哪些信息,以及哪些信息会被继续组合起来判断。
这也是浏览器指纹逆向从"找到某个 API"进一步走向"理解整个浏览器环境"的关键一步。
参数不同,不代表环境组合就合理
理解指纹浏览器时,也很容易出现一个误区。
不同账号之间当然需要区分,但在同一个账号环境内部,浏览器、设备和网络相关信息仍然需要能够相互解释。
如果每个账号都使用不同的 User-Agent、Canvas、WebGL 和代理,看起来已经完成了环境区分。
但参数不同,与这些参数能否形成合理的环境组合,是两个问题。
浏览器指纹来自一组浏览器和设备特征,而实际账号环境还可能涉及网络位置、本地数据和登录状态。
所以只修改其中几个参数,并不能单独说明整个环境已经形成稳定的一致关系。
实际检查时,更值得关注的是 浏览器环境一致性,也就是浏览器、设备和网络相关信息放在一起后,是否能够形成相互解释的组合。
Web4 Browser 的处理思路也建立在这一判断上:让 AI 参与浏览环境的生成、检测和持续维护,关注同一个账号的浏览器、设备、代理地区和本地状态能否保持合理的一致关系。
实际分析一个指纹脚本时,可以沿这条顺序追
面对自己编写、获得授权测试或用于研究的指纹脚本,可以按照下面的顺序分析。
1. 先看网页最后发送了什么
先打开开发者工具中的网络请求,观察网页最终向服务器提交了哪些字段。
不要一开始就在压缩后的 JavaScript 中逐行阅读。
网络请求通常能帮助你先确定:
页面向服务端提交了哪些值。
2. 根据提交字段找到对应的采集代码
确定字段以后,再回到 JavaScript 中搜索对应的字段名、对象属性、编码函数和浏览器 API。
逐步建立:
提交值 → 中间处理 → 原始采集代码
之间的对应关系。
这样比从整个脚本第一行开始阅读更容易找到重点。
3. 分清浏览器直接提供的值和计算后的结果
有些信息比较接近浏览器直接返回的结果。
例如:
-
User-Agent;
-
语言;
-
屏幕尺寸;
-
时区。
另一些结果则可能已经经过计算,例如:
-
Canvas 哈希值;
-
多字段组合哈希值;
-
风险标签;
-
其他计算后的标识。
如果不先区分这两类结果,很容易把已经加工过的数据误认为浏览器直接提供的原始参数。
4. 看哪些字段被放在一起
继续观察哪些信息只是单独上传,哪些会进入同一个数组、对象、哈希计算或其他判断过程。
这一步决定了后面应该继续研究:
一个参数本身,还是多个参数之间的关系。
5. 记录浏览器隐私保护带来的差异
某些 API 在不同浏览器和隐私设置下,可能降低返回精度、返回更通用的信息,甚至完全不可用。
所以:
读不到某个值,不一定说明脚本失效。
它也可能只是当前浏览器的隐私策略限制了信息暴露。
6. 最后再检查不同信息之间的关系
把设备声明、图形信息、根据 IP 地址推断的地区、时区和语言放回同一个浏览器环境中理解。
如果分析目标还涉及账号状态,再单独观察 Cookie、本地存储和登录状态等有状态信息,不要把它们与浏览器指纹参数混为一类。
做到这一步,浏览器指纹逆向就不再只是寻找某个 Canvas 哈希值是怎样生成的。真正需要还原的是网页从哪里读取浏览器信息、这些信息如何被处理和组合,以及哪些关系会继续参与判断。
相比盯住某一个最终哈希值,这更接近浏览器指纹逆向真正有价值的部分。