🔥承渊政道: 个人主页
❄️个人专栏: 《C语言基础语法知识》 《数据结构与算法》 《C++知识内容》 《Linux系统知识》 《算法刷题指南》 《测评文章活动推广》 《大模型语言路线学习》 《MySQL数据库学习》 《Python知识内容》 《cpolar知识学习》
✨逆境不吐心中苦,顺境不忘来时路!✨ 🎬 博主简介:
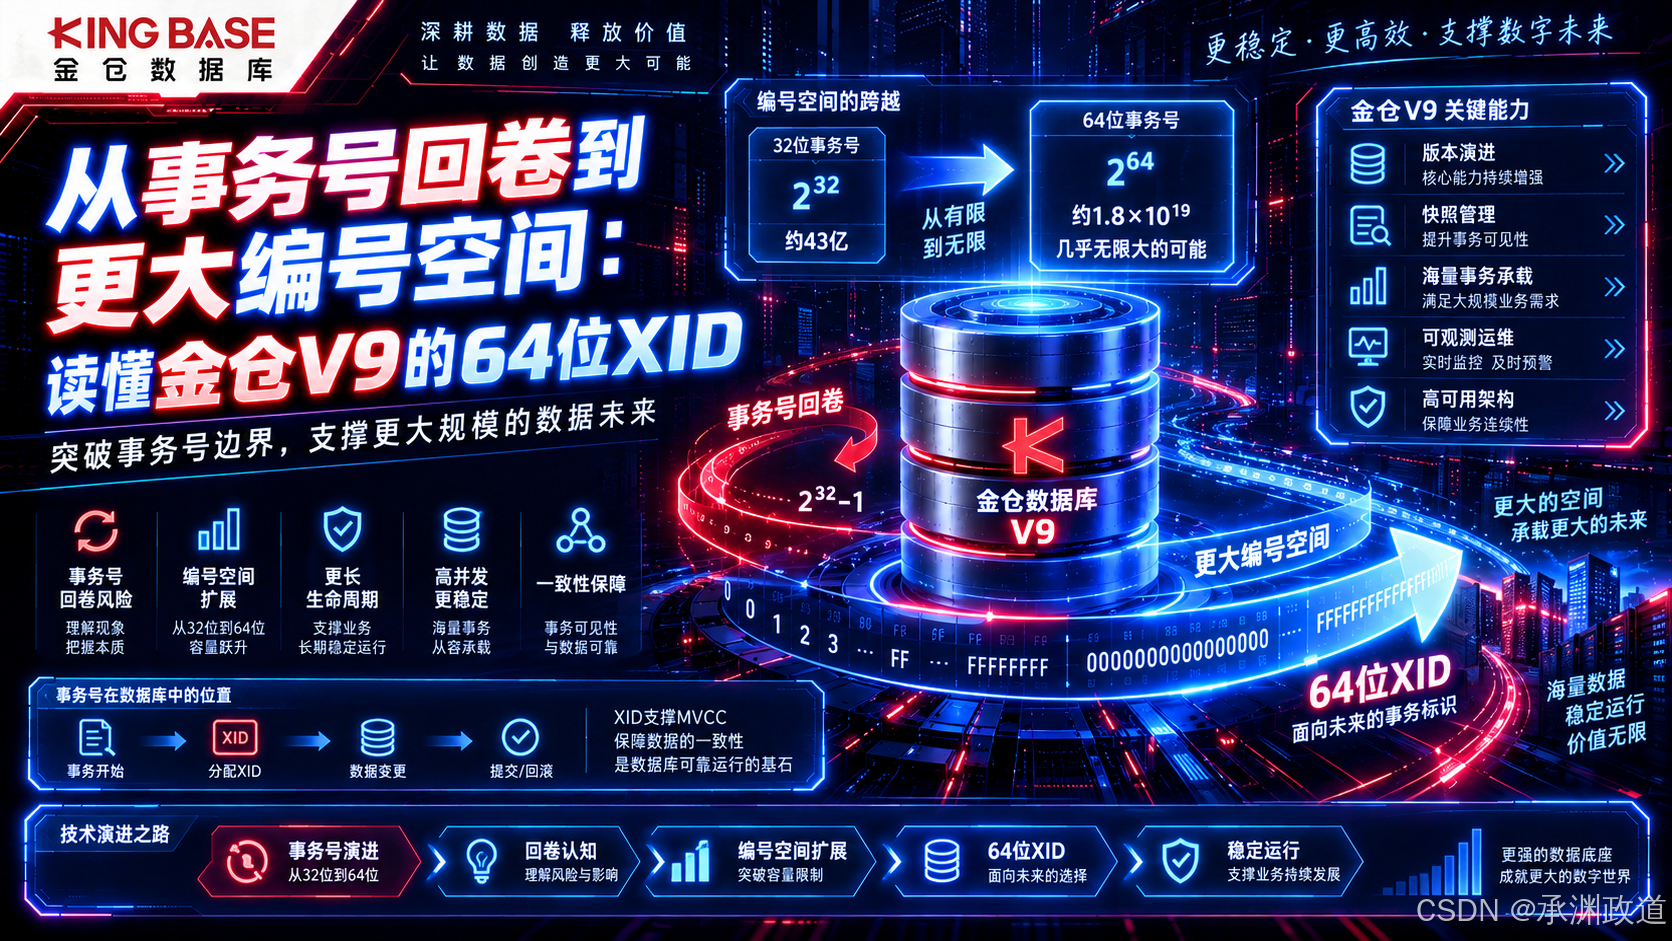
事务号从32位扩展到64位,改变的不只是一个数字的长度.它关系到数据库如何管理历史版本、怎样安排后台维护,以及持续写入的业务能获得多大的事务编号空间.围绕金仓V9V009R002C016的64位XID能力,可以沿着一条清晰的线索展开:先理解 32 位事务号的回卷问题,再分析内核改造涉及的模块,最后落到参数检查、升级验证和应用实践.这样,既能看见技术变化的价值,也能弄清它与日常运维的关系.
目录
- [一、32 位事务号为什么会成为运维关注点](#一、32 位事务号为什么会成为运维关注点)
- [二、64 位XID改造为什么不只是修改类型](#二、64 位XID改造为什么不只是修改类型)
- [三、理解金仓 V9 的能力范围与配套变化](#三、理解金仓 V9 的能力范围与配套变化)
- 四、把五个容易混淆的问题讲清楚
- 五、结合代码理解实现思路与参数验证
- 六、事务号扩展对内核演进的启示
- 七、应用开发者需要检查哪些地方
- 八、最佳实践与监控工具应如何配套
- 九、让内核变化转化为持续运行能力
一、32 位事务号为什么会成为运维关注点
1. 编号空间很大,但并非没有边界。
PostgreSQL 的普通事务标识 TransactionId 使用 32 位无符号表示,理论编码空间约为 2^32,也就是43亿个值.特殊值需要保留,普通编号则会随系统运行循环使用.
假设一个高写入系统每天消耗5亿至10亿个事务号,即使以十亿计的编号空间,也会在持续运行中迅速被推进.这只是用于理解数量级的假设,不是某类业务的统一负载标准.真正需要测量的是具体实例的事务号增长速度.
编号空间也不等于同时活跃事务数,更不是单表行数或累计事务数量的上限.
2. 循环编号必须能够正确区分新旧事务。
在多版本并发控制中,同一条记录可能存在多个版本.数据库需要判断某个版本对当前查询是否可见,而事务信息正是判断依据的一部分.
简单写成 t_xmin < current_xid,只能表达"比较先后"的直觉,不能替代完整的MVCC规则.真正的可见性还涉及快照、提交与回滚状态、当前事务,以及记录的更新或删除信息.编号循环以后,普通整数的大小关系更不能直接代表事务先后.
3. 冻结机制帮助旧版本跨越编号循环。
可以把 32 位编号空间想象成一个圆环:相对于某个普通 XID,约半个编号空间表示较早的事务,另一半表示较晚的事务.冻结处理使符合条件的旧插入事务不再依赖这种普通循环比较.PostgreSQL 回卷维护说明
由此带来三类需要长期关注的工作:
- 维护资源调度:大量冻结或清理集中发生时,可能增加 I/O、WAL 和复制回放负担.
- 长事务治理:持续保留的快照可能限制维护推进.事务年龄过大时,还需要考虑防回卷保护措施.
- 容量和告警规划:结合事务号消耗速度、清理进度、存储能力与响应时间,安排维护策略.
"剩余不到 100 万就自动进入单用户模式"不是可以套用的统一规则.事务年龄限制、拒绝分配新事务号的保护,以及管理员采取的恢复方式,是不同层面的问题.
更大事务号空间的讨论还涉及 zheap、zedstore、Postgres Pro 等不同技术方向.评价它们时,应分别考察存储方式、成熟度和适用版本,不能只比较一个位宽数字.
二、64 位XID改造为什么不只是修改类型
1. 行头布局会影响存储开销。
行版本需要保存事务相关信息.下面用教学模型展示值得关注的字段,帮助理解分析范围;该结构不对应 PostgreSQL 或金仓的真实二进制布局.
c
/* 教学模型:展示相关概念,不可用于读取真实数据库页。 */
typedef struct TupleTransactionFieldsModel {
    TransactionId t_xmin;  /* 插入事务 */
    TransactionId t_xmax;  /* 更新、删除或锁定相关标识 */
    CommandId     t_cid;   /* 事务内命令信息 */
    TransactionId t_xvac;  /* 历史 VACUUM FULL 相关概念 */
    MultiXactId   t_multi; /* 多事务锁定概念,实际并非独立字段 */
    ItemPointerData t_ctid;/* 行版本位置或版本链信息 */
} TupleTransactionFieldsModel;
真实 PostgreSQL 行头通过 t_choice 等联合体组织字段,部分信息共享存储位置.t_xvac 在 PostgreSQL 18 对应头文件中仍有定义,不能按"新版本已经移除"计算空间.PostgreSQL 行头源码
两个独立的 32 位字段改成 64 位,字段本身会增加8字节;三个独立字段则增加12字节.结构最终增加多少,还要考虑联合体、对齐和页布局.如果假设每行最终增加16字节,10 亿行对应约 16 GB 的额外空间,但这只是成本估算,不是金仓的实际开销结论.
2. CLOG 与 SLRU 需要适配更大的索引范围。
CLOG 保存事务提交状态.PostgreSQL 的状态编码每个事务使用 2 bit,因此按 8 KB 页面计算,一页可保存的事务状态数量为:
8192 × 8 / 2 = 32768
这里计算的是状态编码容量,不能把 XID 本身的 32 位宽度代入,算成每页 512 个事务.PostgreSQL CLOG 源码
扩大编号空间后,需要重新检查页号、段号、截断边界、缓存接口和并发控制.继续扩展 SLRU、设计环形缓冲区,或采用基于 segment 的 mmap 文件,都是可以讨论的工程方向;位宽增加本身不意味着必须放弃 SLRU.
3. VACUUM 的年龄管理需要与实现保持一致。
类似 relfrozenxid < oldestXid - 2000000000 的表达,可以帮助提出"年龄是否过大"的问题,却不是通用的源码判定条件.
64 位空间为维护调度提供了更大的设计余地,但有限位宽仍然有边界.冻结是否继续存在、安全水位怎样推进,以及如何回收事务状态,都需要结合具体实现分析.不能仅凭"64 位"就把冻结完全等同于普通空间清理.
4. 子事务和两阶段提交同样需要适配。
子事务关联、prepared transaction 的持久化状态,以及 pg_subtrans、pg_prepared_xacts 等相关接口,都属于检查范围.
例如,将高 32 位用于某种主体标识、低 32 位用于局部编号,是一种可能的编码设想,但不是子事务扩展的必选方案.是否需要独立命名空间、是否调整系统视图,应由实际设计决定.
5. 日志、复制和恢复决定升级边界。
分析 WalDataMessage、xl_xid 等相关概念时,需要区分传输消息、WAL 记录与数据页格式.它们处在不同层次,不能混在一起判断兼容性.
主从是否需要同时升级、哪些版本可以复制、恢复工具能否识别新格式,都应查阅明确的支持范围并进行演练.不能从"事务号加宽"直接推出一定兼容或一定不兼容.
三、理解金仓 V9 的能力范围与配套变化
1. 从具体版本识别能力。
V009R002C016 的 64 位事务 ID 讨论,重点在于扩大事务编号相关能力,改善 32 位事务号回收不及时、长事务影响维护时的业务连续性问题.
实际部署时,需要同时确认完整版本、兼容模式、升级路径及冻结参数定义.版本功能介绍可以帮助判断方向,但不能替代目标实例的配置检查和支持矩阵.
2. 冻结参数的类型与取值范围变化。
事务号空间扩展,也需要相应的参数类型和范围配合.四个关键参数的变更对照如下;"变更后"的数值表述按现有资料列示,其中的类型和数值疑点见表下注.
| 参数 | 变更前 | 变更后 |
|---|---|---|
vacuum_freeze_min_age |
integer,最大 1000000000 | int64,最大 2⁶⁴−1 ≈ 1.15×10¹⁹ |
vacuum_freeze_table_age |
integer,最大 2000000000 | int64,最大 2⁶⁴−1 |
vacuum_multixact_freeze_min_age |
integer,最大 1000000000 | int64,最大 2⁶⁴−1 |
vacuum_multixact_freeze_table_age |
integer,最大 2000000000 | int64,最大 2⁶⁴−1 |
数值说明:表中"变更后"包含需要核实的表述。数学上,2⁶⁴−1 约为 1.8447×10¹⁹,并非 1.15×10¹⁹;通常意义上的有符号 int64 上限为 2⁶³−1。具体产品参数还可能采用更小上限,因此表中的新上限不能直接用作配置依据,应通过对应版本说明书及
sys_settings的vartype、max_val确认。
这四项参数分别涉及普通事务和 MultiXact 的最小冻结年龄、表级冻结扫描年龄.比较时应分别记录类型、允许范围、默认值和当前值,避免将不同维度混在一起.
200000000、400000000、10000000000、20000000000 这类数值,只有对应到明确的参数和版本后才有意义,不能按顺序直接套入表格,也不能把当前配置当作默认值.
数值类型还存在一个常见误区:无符号 64 位最大值为 2^64-1,约 1.8447×10^19;有符号 int64 的最大值则为 2^63-1.产品可能采用更小的参数上限.因此,int64、2^64-1 和 1.15×10^19 不能混写成同一数值.
3. 实例内存管理需要一并观察。
max_dynamic_memory 所涉及的实例内存管控,是评估相关版本时的另一个关注点.应核对其覆盖范围、超限行为和告警方式,并观察并发事务与缓存增长下的资源表现.
事务标识加宽可能影响某些数据结构的占用,但是否明显增加实例内存,需要测量.两项功能在同一版本出现,也不代表内存管控必然只是为 XID 改造服务.
4. FastPath 与事务状态并发值得关注。
FastPath 槽位、CLOG 轻量锁分区、CSNLOG 轻量锁分区,是理解事务处理并发能力的几个观察点.CSNLOG 涉及提交序列管理,应与 XID 的分配和可见性机制分别分析.
不能仅由"分区数可配置"推断此前一定只有一把锁,也不能由"64 位 XID"推断 CSN 此前必然是 32 位.内部布局需要实现资料支持,并发收益则需要负载测试支持.
四、把五个容易混淆的问题讲清楚
1. 圆环只是帮助理解编号先后的模型。
可以用下面的关系图理解约半个编号空间的比较窗口:
text
           32 位编号按模 2^32 比较

    较早的编号  ←  参考 XID  →  较晚的编号
      约 2^31                  约 2^31

    普通编号循环使用,不能一直用整数大小判断先后。
    冻结的插入事务采用特殊语义,不参与普通循环比较。
这种模型不表示编号空间中有固定的"过去区域"或"未来区域",冻结水位也不是所有可见性判断的统一分界点.
可见性可以用以下概念流程理解.它不是可执行代码,也省略了数据库内核的具体分支:
text
判断一个行版本是否可见:
    检查插入事务是否属于当前事务,或已提交并满足快照条件
    若插入事务已冻结,按冻结插入事务的特殊语义处理
    若插入事务对当前快照不可见,则该行版本不可见
    继续检查更新、删除或锁定相关状态
    结合命令顺序等信息,决定该版本是否可见
即使采用 64 位标识,t_xmin < 当前事务快照 也不是完整算法.编号空间扩大,不会消除快照与提交状态的作用.
2. freeze 与删除老数据不同。
HEAP_XMIN_FROZEN、HEAP_XMIN_INVALID 和 FrozenTransactionId = 2 涉及冻结表示.需要结合版本理解:PG 9.4 之前会替换插入 XID,较新版本主要使用标志并保留原 xmin.冻结插入事务,不代表记录以后被删除或更新时仍然无条件可见.PostgreSQL 冻结说明
3. 预期收益与日常职责需要分别评价。
| 观察项目 | 更大事务空间的潜在价值 | 仍需完成的工作 |
|---|---|---|
| 集中冻结压力 | 为维护调度提供更大余地 | 观测 I/O、WAL 和清理耗时 |
| 回卷窗口 | 减轻有限编号空间带来的约束 | 核对产品实际安全边界 |
| 长事务影响 | 改善部分与编号年龄相关的风险 | 治理快照、锁等待和事务生命周期 |
| 复制延迟 | 可能改变维护相关的回放负载 | 对比实际复制与回放表现 |
| 表膨胀 | 不直接替代空间回收 | 持续运行适当的 VACUUM/Autovacuum |
| DDL 阻塞 | 不自动消除长事务持锁 | 继续检查锁等待和变更窗口 |
4. 冻结年龄与清理触发条件不能混用。
autovacuum_vacuum_insert_scale_factor、vacuum_freeze_table_age、vacuum_freeze_min_age 分别涉及不同的触发或年龄条件.调小某个参数,可能使特定维护更积极,但不代表整体资源开销一定降低.
更大的事务空间,可以让团队重新评估维护策略;是否需要调整,以及调整幅度多大,应由负载和清理表现决定.
5. 主从切换和备份恢复仍然需要演练。
物理备库主要通过 WAL 回放跟随主库变化,不能把它直接理解成独立执行相同冻结任务的主库.应分别验证 standby、promote、switchover、备份和恢复的行为,并使用明确支持的版本组合.
资料没有解释某个细节,只说明还需要补充确认,不能据此判断功能尚未完成.
五、结合代码理解实现思路与参数验证
1. 用类型模型讨论分层设计。
一种值得研究的思路,是区分事务号分配层与行版本存储层.下面展示"更宽的分配标识与较小的行内字段并存"的假设模型,不代表已经确认金仓采用该布局.
c
/* 假设性类型模型,用于讨论分层设计;非产品源码。 */
typedef uint64 kingbase_xid;       /* 分配层使用较宽标识 */

typedef uint32 kingbase_tup_xmin;  /* 假设行内字段保持较小宽度 */
typedef uint32 kingbase_tup_xmax;  /* 映射及解释规则需另行设计 */
这类设计可能希望减少对旧页格式、行头大小和工具链的冲击.但是否能保留 CLOG 结构、降低冻结频率、平滑升级,必须逐项证明.
三个类型定义不足以解释完整机制.映射的寿命、持久化、恢复和边界处理同样重要,也不能由此推出"主从无需同时升级"或"单表只能执行 43 亿次事务".
2. 分阶段评估调优,而不是一次性修改全部参数。
可以把工作分成迁移观察、参数实验和稳定运行三个阶段.若项目周期允许,1---3 个月、3---6 个月、6 个月之后可以作为管理安排的示例,但进入下一阶段应以验证完成为依据.
以下 SQL 展示参数调整的写法.数值属于实验候选,未在目标实例执行;ALTER SYSTEM 会修改配置,使用前必须确认范围、生效方式及回退值.
sql
-- 阶段一:迁移观察
-- 记录配置和维护频率,先建立基线。

-- 阶段二:在隔离环境评估参数变化
ALTER SYSTEM SET vacuum_freeze_min_age = 50000000;
-- 候选值:5000 万;只有低于当前值时才是调小。

ALTER SYSTEM SET autovacuum_freeze_max_age = 1000000000;
-- 候选值:10 亿;是否扩大维护窗口需与当前值比较。

-- 阶段三:在已有验证结果上评估表级扫描年龄
ALTER SYSTEM SET vacuum_freeze_table_age = 5000000000;
-- 候选值:50 亿;必须确认目标版本允许该范围。
如果当前值分别是 2 亿和 4 亿,前两条语句才分别对应"降到 5000 万"和"升到 10 亿";不能把这两个假设当成所有实例的默认配置.是否需要重启或重新加载,也必须逐项确认.
3. 先查清当前值、默认值与类型。
下面的只读示例适用于提供对应系统视图和字段的 KingbaseES 实例.不同版本或兼容模式可能有差异,需要按实际手册调整.
sql
SELECT version();

SELECT name,
       setting,
       boot_val,
       vartype,
       min_val,
       max_val,
       context,
       source
FROM sys_settings
WHERE name IN (
    'autovacuum',
    'vacuum_freeze_min_age',
    'vacuum_freeze_table_age',
    'autovacuum_freeze_max_age',
    'vacuum_multixact_freeze_min_age',
    'vacuum_multixact_freeze_table_age',
    'autovacuum_multixact_freeze_max_age',
    'autovacuum_vacuum_insert_scale_factor',
    'max_dynamic_memory'
)
ORDER BY name;
setting 与 boot_val 分别用于观察当前值和初始默认值;vartype、min_val、max_val 用于核对类型与范围;context 和 source 帮助理解生效方式与配置来源.参数未返回时,应先检查该版本是否提供它.
sql
-- 数据库事务年龄。
SELECT datname,
       age(datfrozenxid) AS xid_age
FROM sys_database
ORDER BY xid_age DESC;

-- 按事务开始时间查找较早的事务,不自动终止连接。
SELECT pid,
       datname,
       state,
       xact_start,
       CURRENT_TIMESTAMP - xact_start AS transaction_duration
FROM sys_stat_activity
WHERE xact_start IS NOT NULL
ORDER BY xact_start;
事务年龄与持续时间表达不同问题:前者关注编号推进,后者关注经过了多久.应把这两类信息与清理进度、业务行为一起分析.
4. 比较 PostgreSQL 版本时,分清 SQL 类型与内部机制。
xid8 并不是 PG 16 才出现的类型.PostgreSQL 13 已引入它,用于暴露 FullTransactionId.PostgreSQL 13 发行说明
分析 PG 16、17、18 的事务管理变化时,应分别查看普通 XID、FullTransactionId、MultiXact、冻结行为和相关提交记录.SQL 层存在较宽的事务标识,不等于所有行版本字段都已经加宽,也不等于回卷维护已经消失.
5. 跨数据库比较需要统一维度。
| 数据库或技术方向 | 事务管理关注点 | 维护机制关注点 | 比较时的边界 |
|---|---|---|---|
| PostgreSQL | 普通 XID、FullTransactionId、xid8 | freeze、VACUUM、Autovacuum | 不把 SQL 类型与行版本存储直接等同 |
| Oracle | 事务标识及 SCN 等不同概念 | undo、多版本管理 | SCN 不等于事务 ID,具体宽度按版本核对 |
| MySQL/InnoDB | TRX_ID 与记录版本信息 | undo、历史版本回收 | 字段宽度不是整体维护成本的充分指标 |
| KingbaseES V9 | 64 位 XID 及具体版本适配 | 冻结、清理、监控和升级 | 内部布局与收益需要实现资料或测试支持 |
| zheap / zedstore | 不同存储与版本管理设计 | 各自的历史版本处理方式 | 项目分别评估,TID 与 XID 不能混用 |
"6 字节""64 位"之类的描述必须指向具体字段,不能将 SCN、TRX_ID、TID 和 XID 当成完全等价的东西.产品化程度、兼容性和维护效果,也需要独立比较.
六、事务号扩展对内核演进的启示
1. 渐进式设计需要说明完整代价。
分配层与存储层分开演进,有机会减少兼容性冲击.但新增映射并不只增加一次查询,还涉及并发访问、状态回收、日志截断、崩溃恢复和升级工具.合理的设计,应把这些成本一起解释清楚.
2. 配置兼容性直接影响迁移体验。
保留适当的默认行为、扩展可调范围,有助于减少迁移初期的不确定性.若默认值发生变化,也应明确给出旧值、新值、变化原因和生效方式.例如,2 亿与 4 亿对应的是哪个参数,必须写清楚,而不能仅列一串数字.
3. 维护策略应从机制走向负载。
更大的编号空间,为改善维护体验提供了条件.最终仍要回答业务问题:后台维护是否更平稳,集中 I/O 是否减少,长事务影响是否更容易控制,故障恢复是否保持可靠.这些变化需要运行数据支持.
七、应用开发者需要检查哪些地方
1. 不用事务号推算业务顺序。
xid + 1 不适合用来预测下一笔成功订单.编号分配顺序、事务提交顺序和业务完成顺序并不相同.应用应使用明确的业务标识,并检查驱动、序列化、日志和监控是否存在固定32位假设.
2. 告警应留出足够的响应时间。
把"剩余 1000 万事务时告警"改成"剩余 100 万事务时告警",会让告警更晚触发,减少响应余量.是否合适,需要依据真实消耗速度和维护能力判断.
若剩余余量为 R,近期消耗速度为V,可以用 R / V 粗略观察剩余时间.但负载可能突变,维护也可能推动边界,因此它只能辅助判断,不能当成准确倒计时.
3. 把升级放进完整回归流程。
除主从事务标识兼容性外,还要按实际使用情况验证提交与回滚、连接重试、批处理、两阶段提交、恢复与切换.目标是确认升级后的应用行为,而不只是数据库能否启动.
八、最佳实践与监控工具应如何配套
1. 给出面向具体版本的操作说明。
用户需要知道哪些旧约束改变了,哪些冻结和清理配置仍需关注,以及新增了哪些操作要求.版本适用范围、参数变化、支持的升级路径和兼容性边界,应能在同一套资料中找到.
2. 用指标展现长期运行状态。
除实例内存及 max_dynamic_memory 相关信息外,还可关注事务平均寿命、时长分布、最老事务、编号消耗速度、冻结推进、清理耗时与空间增长.平均值可能掩盖少量超长事务,应同时观察最大值或分位数.
3. 用可复现记录评价技术变化。
一次有说服力的测试,需要清楚说明条件与边界.
| 记录项 | 应记录的信息 |
|---|---|
| 版本与环境 | 完整服务端版本、兼容模式、硬件、操作系统、部署方式 |
| 数据与负载 | 表规模、更新比例、并发量、事务持续时间、测试时长 |
| 配置 | 当前值、默认值、来源、改动内容、生效方式 |
| 对照指标 | 吞吐、延迟、事务年龄、维护耗时、空间、WAL、复制表现 |
| 长事务实验 | 快照保持期间与事务结束后的清理差异 |
| 恢复与迁移 | 恢复、切换和升级的实际结果及异常情况 |
| 结论边界 | 已复现现象、未触及的限制、仍不能确认的实现细节 |
参数实验应在隔离环境开展,并保留基线和回退方式.本文提供的 SQL 是方法示例,没有附加未经执行的测试输出.
九、让内核变化转化为持续运行能力
金仓 V9 的 64 位 XID,把数据库能力的讨论带向更基础的问题:如何管理不断增长的事务历史,如何安排维护工作,以及如何让业务在长期运行中保持可控.
编号空间扩大具有技术价值,但这种价值要通过清晰的功能范围、可解释的实现和可复现的验证体现.它与语法兼容、复制能力和恢复工具一样,最终都要服务于具体业务.
对使用者而言,关注新特性的同时,继续做好事务治理、空间管理、参数核对和恢复验证,才能把内核进步落实到稳定的日常运行中.
🚀真正的勇者不是流泪的人,而是含泪奔跑的人!
敬请期待下一篇文章内容
每日心灵鸡汤: 别在情绪最重的时候,替自己的人生下结论!
有时候,你感觉天都塌了,情绪压得你喘不过气,无处释放,甚至觉得这一天过不去了.可等几天再回头看,很多当时以为无法承受的事,不过尔尔.所以,别在情绪最重的时候,替自己的人生下结论.