🔥承渊政道: 个人主页
❄️个人专栏: 《C语言基础语法知识》 《数据结构与算法》 《C++知识内容》 《Linux系统知识》 《算法刷题指南》 《测评文章活动推广》 《大模型语言路线学习》 《MySQL数据库学习》 《Python知识内容》 《cpolar知识学习》
✨逆境不吐心中苦,顺境不忘来时路!✨ 🎬 博主简介:
数据库性能调优最难的地方,往往不是"找不到参数可以调",而是很难在可控环境中真实复现生产问题.在实际生产系统中,一次数据库性能波动通常不是由单一 SQL、单一参数或单一资源瓶颈造成的,而是业务请求、事务并发、SQL 执行顺序、数据分布、缓存状态、锁竞争、连接行为以及数据库内部机制共同作用的结果.传统的基准测试、脚本压测或者单 SQL 优化,可以帮助我们发现局部问题,但它们与真实生产负载之间往往仍存在明显差异.最终经常出现一种情况:测试环境调得很好,上线后表现却完全不同.因此,更可靠的数据库性能评测方式,不应该只是"模拟一个类似的压力",而是尽可能将生产环境中的真实工作负载完整保存下来,再在隔离环境中进行高保真重放.这正是基于生产Capture(捕获)的完整重放技术所解决的问题.
目录
- 1.真实负载如何高效重现?Kreplay并行回放模式实测解析
- 2.真实业务是并发的,回放也不该只有一条队伍
- 3.该串行的继续串行,可以并行的不再排队
- 4.2247万条请求,从132分钟降到49分钟
- 5.快了,更要真实了
1.真实负载如何高效重现?Kreplay并行回放模式实测解析
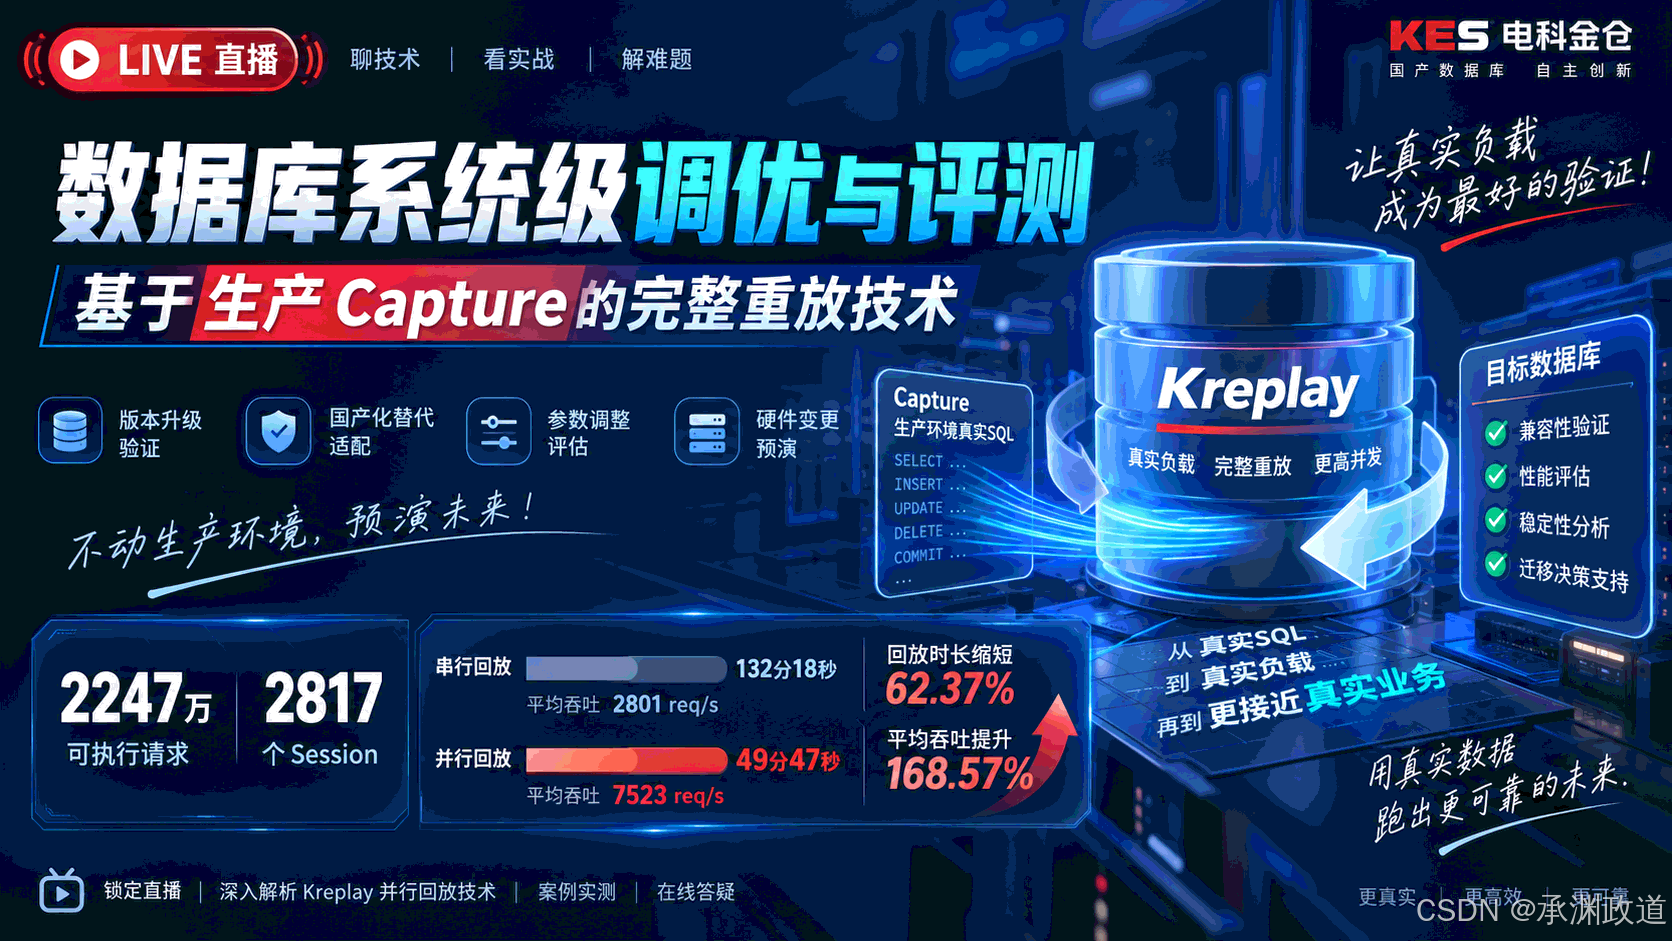
2247万条可执行请求、2817个Session.同一份真实负载、同一目标数据库、同一硬件环境下:回放时间从132分18秒缩短至49分47秒,平均吞吐从2801 req/s提升至7523 req/s.这是Kreplay并行回放模式的一组实测结果.但这次升级解决的,不只是"回放更快".更重要的是:让大规模真实负载的回放方式,也更接近真实业务本来的运行方式.
在数据库国产化替代与版本升级的浪潮中,如何验证新环境能否平稳承接生产负载,始终是运维与DBA团队最头疼的问题之一.直接切换风险太高,全量回归又耗时耗力.Kreplay给出的答案是:把生产环境真实发生的SQL请求完整捕获下来,在目标数据库上原样重放,用最接近实战的方式提前暴露兼容性、性能与稳定性隐患.而并行回放模式的引入,则让这一验证过程从"能跑"迈向了"跑得快、跑得真".
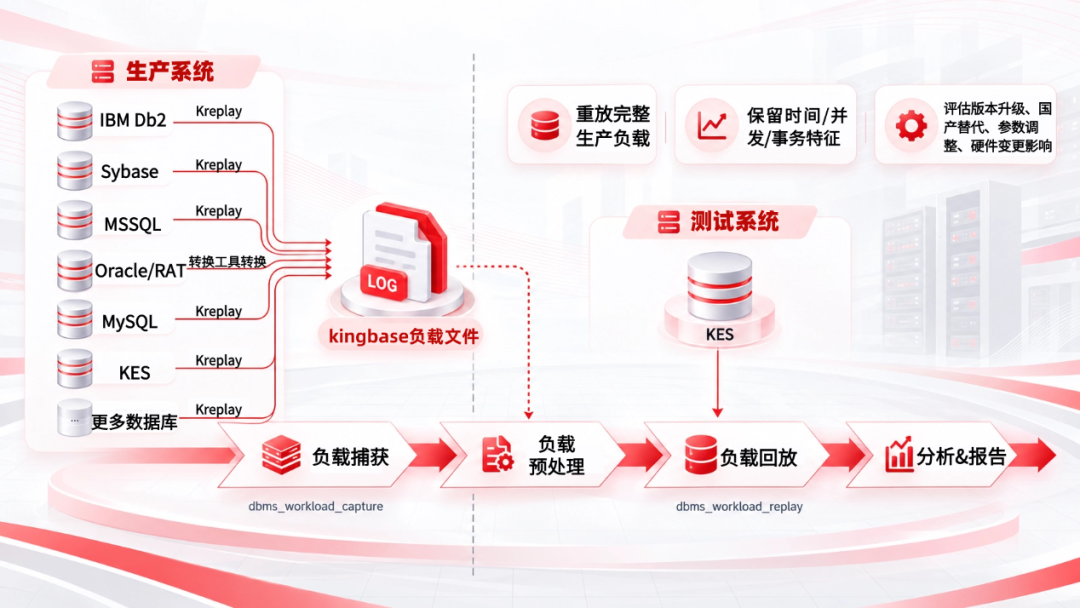
Kreplay作为电科金仓自主研发的一款数据库回放工具,用于在正式适配之前,通过捕获生产系统上的真实工作负载,并在测试系统中进行生产工作负载的完整重放,以评估系统更改(如版本升级、国产替代、参数调整、硬件变更等)的总体影响.它解决的是一道经典难题:如何在不动生产环境的前提下,尽可能真实地预演未来.
Kreplay作为电科金仓自主研发的一款数据库回放工具,用于在正式适配之前,通过捕获生产系统上的真实工作负载,并在测试系统中进行生产工作负载的完整重放,以评估系统更改(如版本升级、国产替代、参数调整、硬件变更等)的总体影响.
2.真实业务是并发的,回放也不该只有一条队伍
过去,为保证执行顺序,回放通常采用全局时间戳排序:将不同Session产生的SQL统一排序,再依次执行.这种方式足够稳妥,但随着回放规模进入千万级,一个问题开始变得突出:生产环境中原本互不依赖、可以同时执行的多个Session,在回放时也被排进了同一条队伍.一条慢SQL,可能让后面大量无关请求一起等待.
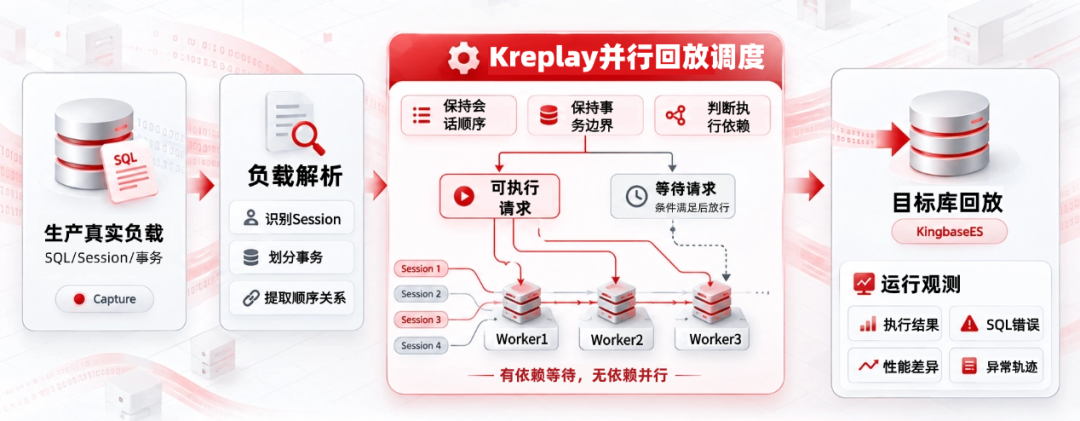
不仅回放时间被拉长,原生产环境中的并发关系也被削弱.而真实数据库上线后面对的,恰恰不是一条整齐的SQL队列,而是大量Session同时运行,由此产生的锁竞争、事务冲突和资源争用.所以,Kreplay并行回放要解决的问题很明确:既不能为了并发打乱原有执行关系,也不能让彼此无关的请求继续相互等待.
3.该串行的继续串行,可以并行的不再排队
Kreplay并行回放不是简单地"多开几个线程".它会保留同一Session内必要的执行顺序、事务边界以及相关执行约束,同时让已经满足执行条件、彼此独立的Session并行推进.过去是所有SQL围绕一条全局队列推进;现在,则把等待控制在真正需要等待的范围内.这样既保留了真实负载中的必要执行关系,也释放了原本就存在的并发空间.
4.2247万条请求,从132分钟降到49分钟
在本次测试中,共包含:2817个Session,22472516条可执行请求.两种模式使用同一份捕获到的真实负载(Capture)、同一目标数据库版本及相同硬件环境.
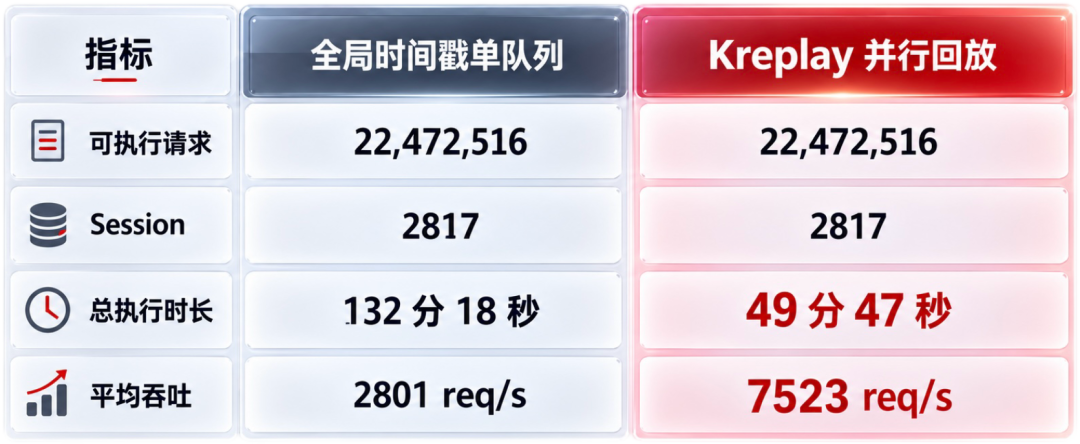
在本次测试环境下:平均吞吐提升168.57%、回放时长缩短62.37%.这意味着,当真实业务负载进入千万级规模后,回放机制本身不必再因为全局串行成为验证效率的瓶颈.
5.快了,更要真实了
如果只看49分钟,很容易把这次升级理解为一次单纯的性能优化.但对KReplay来说,真正重要的变化是:以前解决的是,生产环境发生过的SQL,能不能在目标数据库重新跑一遍.现在进一步解决的是,这些SQL能不能以更接近生产环境的并发方式重新跑一遍.这意味着,在数据库正式迁移上线之前,目标环境可以更充分地面对真实业务中的多Session并发、资源竞争和事务压力.同时,KReplay仍会记录回放过程中的执行进度、SQL错误、事务异常等信息,为后续兼容性分析、性能定位和迁移决策提供依据.从真实SQL,到真实负载,再到更接近真实业务的并发运行方式.
🚀真正的勇者不是流泪的人,而是含泪奔跑的人!
敬请期待下一篇文章内容
每日心灵鸡汤: 往前走,走到更高处!
人只有卸下负重往前走,才会看到前面有新的东西.不要总想着留住那些正在消散的,或者沉溺在已经预料到失去的.如果觉得自己在进退维谷里,那这里就不是属于你的地方,就一定要走到前面,走到高处.记住:当你下定决心往前走、变更好时,你就一定不会比现在的自己差!