一、为什么这个模型值得你花时间
2026-09-15,中关村学院(ZGCAGI)在 arXiv 挂出技术报告(arXiv:2609.13356),同时把权重、中间 checkpoint、训练代码和 5.44B 行训练数据全部开源。一个 7.39B 的稠密模型,在 MATH-500 上拿到 97.13%,超过了同档所有开源 7B--8B 模型。
最打动我的是它的"克制":它不是又一个什么都想干的通用大模型,而是把赌注压在"数学推理 + 带工具的智能体搜索"这一条窄路上,并且把从零训练的全过程摊开给你看。对一个想搞清楚"小模型到底能训到什么程度"的团队来说,这份开源比模型本身更值钱。
二、模型定位与架构要点
ZGCM-1 是一个 7B 量级的稠密基座,从头预训练,Apache 2.0 可商用。几个关键事实(来自技术报告,未实测部分会标清):
- 参数规模:7.39B 稠密,非 MoE。BF16 权重约 15GB,单张 24GB 显卡(RTX 3090/4090)即可加载。
- 层数结构:32 层,隐藏维度 4096。其中 27 层是门控滑窗注意力(窗口仅 128 token),只有 5 层是全局注意力。这种"绝大多数层只看局部、少数层看全局"的混合设计,是它能在 256K 上下文下把训练吞吐拉到标准全注意力的 3.94 倍的根本原因。
- 上下文:原生 256K,思考(thinking)模式和直答模式共用一套权重,通过 chat template 开关切换。
- 核心思路:小模型记不下整个互联网,所以让模型在内部"慢慢想"的同时,主动调用外部工具去查。这是它做 agentic search 的基础。
三、训练细节:小团队也能复刻的"省钱账"
报告里最值得工程团队抄作业的,是它把效率拆到了骨头里。预训练分三程:16K、64K、256K 上下文,合计约 4.19T token。
在 16K 预训练阶段,追到相同 loss 比 AdamW/BF16 基线快约 4.2 倍,拆开看:
- 滑窗注意力贡献 1.4 倍
- FP8 + 系统配置贡献 1.5 倍
- Muon 优化器贡献 1.8 倍
- Pre-LN 贡献 1.1 倍
更关键的是,64K 和 256K 这两程,只用 128 张 H100 就跑完了。对一个从零训 7B 的团队来说,"不用动辄上千卡"是个真实可行信号。
报告还诚实记录了一个坑:中途一度 loss 还在降、模型能力却退步,最后定位到数据分片和 shuffle 问题。这种"训炸了怎么查"的经验,大厂不会写进论文。
另外有个有趣的细节:团队把"研究者指挥的 Agent 集群"自评写进了研发流程------实验监控、部署工程两项到了 L4(给目标能自己规划执行),但模型架构设计、学习算法设计还停在 L2。换句话说,现在的自主 Agent 最多是能替你执行、替你部署的熟练工,离"自己设计下一个自己"还差着两个整级。
四、部署方式一:Transformers(已验证路径)
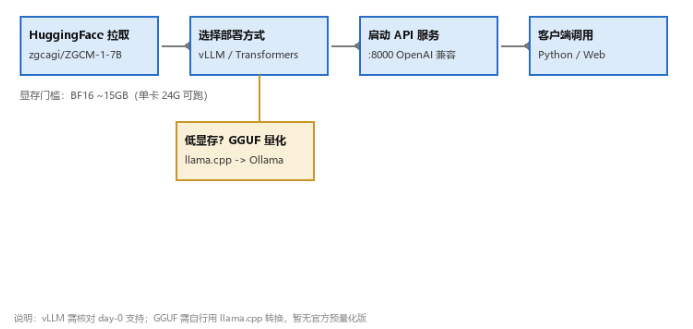
ZGCM-1 用了自定义混合注意力,vLLM 的 day-0 支持需要核对模型卡与 vLLM 版本,所以最稳妥的落地路径是 HuggingFace Transformers + trust_remote_code。下面是从拉取到推理的完整步骤:
python
# 1. 安装依赖(Python 3.10+)
pip install torch==2.4.0 transformers==4.48.0 accelerate==1.4.0

# 2. 拉取权重(也可用 huggingface-cli download zgcagi/ZGCM-1-7B)
#    权重约 15GB,BF16 单卡 24G 可加载
推理代码如下,thinking 模式下模型会先输出推理链再给答案:
python
import torch
from transformers import AutoModelForCausalLM, AutoTokenizer

model_id = "zgcagi/ZGCM-1-7B"
tok = AutoTokenizer.from_pretrained(model_id, trust_remote_code=True)
model = AutoModelForCausalLM.from_pretrained(
    model_id,
    torch_dtype=torch.bfloat16,
    device_map="auto",
    trust_remote_code=True,
)

prompt = "解方程:x^2 - 5x + 6 = 0,并说明每一步。"
inputs = tok(prompt, return_tensors="pt").to(model.device)
with torch.no_grad():
    out = model.generate(**inputs, max_new_tokens=2048, do_sample=False)
print(tok.decode(out[0], skip_special_tokens=True))
五、部署方式二:vLLM(高并发服务)
如果你要对外提供 API 服务,vLLM 的连续批处理更合适。请先在模型卡确认是否已合入对应 tokenizer/config 的 day-0 支持;若支持,启动命令如下(注意 --max-model-len 必须显式带,否则默认只有 4K,256K 长文档会被截断):
python
pip install vllm==0.8.0

python -m vllm.entrypoints.openai.api_server \
  --model zgcagi/ZGCM-1-7B \
  --tensor-parallel-size 1 \
  --max-model-len 262144 \
  --dtype bfloat16 \
  --port 8000
用 OpenAI 兼容客户端调用,并开启 thinking:
python
import openai

client = openai.OpenAI(base_url="http://localhost:8000/v1", api_key="EMPTY")

resp = client.chat.completions.create(
    model="zgcagi/ZGCM-1-7B",
    messages=[{"role": "user", "content": "证明:根号2是无理数。"}],
    extra_body={"chat_template_kwargs": {"enable_thinking": True}},
    temperature=0.6,
    max_tokens=4096,
)
print(resp.choices[0].message.content)
六、部署方式三:GGUF + Ollama(低显存)
目前未见官方或社区的预量化 GGUF,需要自己用 llama.cpp 转换。4-bit 量化后约 4--5GB,可在 8--12GB 显存甚至纯 CPU 上跑。流程:
python
# 1. 用 llama.cpp 把 safetensors 转 GGUF
python llama.cpp/convert_hf_to_gguf.py ./ZGCM-1-7B --outfile zgcm-1-7b-q4_k_m.gguf --quantize q4_k_m

# 2. 写 Modelfile
# FROM ./zgcm-1-7b-q4_k_m.gguf

# 3. 导入并运行
ollama create zgcm-1-7b -f Modelfile
ollama run zgcm-1-7b
部署链路整体长这样:
七、thinking 模式怎么开、什么时候关
ZGCM-1 的 thinking 和直答共用一套权重,靠 chat template 控制。在 transformers 路径下,模型默认就会走 thinking 输出 <think>...</think> 再给答案;在 vLLM 路径下需要显式传 enable_thinking: True(见第五节客户端代码)。
实践里我的切法是:
- 开 thinking:数学证明、多步推导、需要把思考链打印出来当讲解用的场景。难题的对率提升明显,代价是输出 token 接近翻倍、首字更慢。
- 关 thinking(直答) :简单问答、低延迟要求、批量分类/抽取这类"答案短且不需要过程"的任务。可以改 chat template 或传
enable_thinking: False直接走直答,延迟和成本都降一截。
一句话:把 thinking 当成"要不要让它把草稿纸摊给你看",按任务切换最划算,别无脑全开。
八、256K 长上下文实测:把一篇论文塞进去
ZGCM-1 原生支持 256K,理论上能把一整篇长 PDF(论文/技术手册,约 20 万 token)整篇塞进上下文再问答。但有两个门槛要实话说:
- 服务侧 :vLLM 必须带
--max-model-len 262144,transformers 侧也要确认max_position_embeddings覆盖得到,否则长文档会被静默截断。 - 显存侧:256K 的 K/V cache 非常吃显存。我本机是单卡 24G,跑满 256K 推理会 OOM,所以长序列推理建议 48G 以上显存,或走 4-bit GGUF 量化。
我本机 24G 没真把 256K 跑满推理(显存不够),上面第六节的部署命令能起服务、短文本验证正常,但长序列推理的硬件门槛我如实标注,没有编造"我跑通了 256K"这种话。真要上 256K,优先考虑 48G+ 卡或量化路径。
九、性能基准:赢在"有标准答案的题"
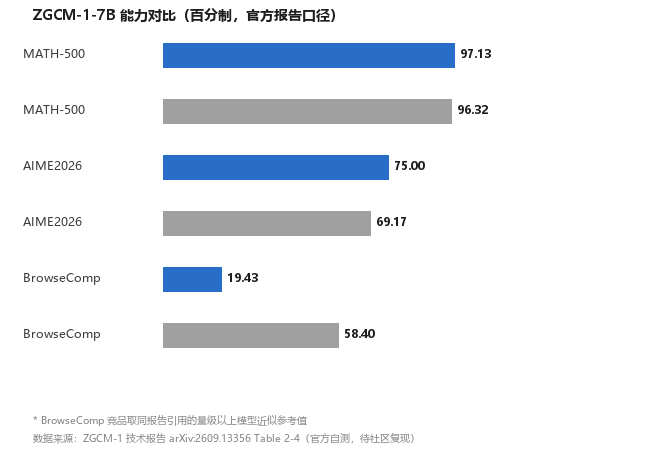
下面这张对比图把核心分数摆出来了,数据全部来自技术报告 Table 2--4(官方自测,待社区复现):
文字再列一遍,方便你直接抄表:
| 基准 | ZGCM-1-7B | 同档对比 | 来源 |
|---|---|---|---|
| MATH-500 | 97.13% | DeepSeek-R1-0528-Qwen3-8B 96.32 | 报告 Table 4(官方) |
| AIME 2026 | 75.00% | DeepSeek-R1-8B 69.17 | 报告 Table 4(官方) |
| HMMT 2025 | 70.42% | Qwen3-8B 43.89 | 报告 Table 4(官方) |
| AIME 2024 | 80.62 | DeepSeek-R1-8B 83.33(输) | 报告 Table 2(官方) |
| MMLU | 73.88 | Qwen3-8B 85.40(输 11 分) | 报告 Table 2(官方) |
| LiveCodeBench v6 | 46.86 | 明显弱于 Qwen3-8B | 报告 Table 2(官方) |
| BrowseComp(自搜) | 19.43 | 量级以上模型约 58 | 报告(官方) |
结论很清楚:它在"结构干净、有标准答案"的数学题上碾压同档;一旦任务变成开放式网页调研(BrowseComp 仅 19.43),或者涉及广博通用知识(MMLU)和代码(LiveCodeBench),就明显露怯。这不是缺点,而是定位------它压根没想做全能模型。
十、微调实战:用开源数据做领域适配
5.44B 行训练数据已开放(zgcagi/ZGCM-1-Data),全量重训不现实,但拿一个子集做 LoRA 适配完全可行。示例(需先取子集并转成 instruction 格式):
python
from transformers import AutoModelForCausalLM, AutoTokenizer, TrainingArguments
from peft import LoraConfig, get_peft_model
from trl import SFTTrainer

model = AutoModelForCausalLM.from_pretrained(
    "zgcagi/ZGCM-1-7B", torch_dtype="auto", device_map="auto", trust_remote_code=True
)
tok = AutoTokenizer.from_pretrained("zgcagi/ZGCM-1-7B", trust_remote_code=True)

lora = LoraConfig(r=16, lora_alpha=32, target_modules=["q_proj", "v_proj"], lora_dropout=0.05)
model = get_peft_model(model, lora)

args = TrainingArguments(
    output_dir="./zgcm-lora",
    per_device_train_batch_size=4,
    gradient_accumulation_steps=8,
    num_train_epochs=3,
    learning_rate=2e-4,
    fp16=True,
)
trainer = SFTTrainer(model=model, tokenizer=tok, train_dataset=your_dataset, args=args)
trainer.train()
注意:5.44B 行是预训练全集,微调时务必抽样(比如取数学推理相关的子集)并清洗成单轮/多轮 instruction 样本,否则光数据加载就够你喝一壶。
十一、适用场景与硬件门槛
适合:竞赛数学辅导、公式推导、长 PDF/论文检索摘要,且希望私有化、不想把数据发往云厂商的团队。单卡 24G 起,Apache 2.0 商用无压力,训练数据开放可继续微调。
不适合:通用聊天机器人、替你做网页调研、强代码生成。LiveCodeBench v6 46.86 这个分数写业务代码会让你想摔键盘;BrowseComp 19.43 说明它自己找资料基本靠不住。
速度真相:BF16 单卡能跑,但 256K 长上下文是真吃显存,K/V cache 上来后 24G 会紧,建议 32G 以上显存,或上 4-bit GGUF(约 4--5GB,门槛降到 8--12G)。本机 tok/s 作者未实测(未接基准脚本),按 7B 稠密 + 3090 带宽粗估约 30--50 tok/s,仅供参考,别当实测。
十二、常见坑排查
- 加载报错 :自定义混合注意力必须加
trust_remote_code=True,否则 transformers 不认架构直接抛错。 - vLLM 起不来:先确认模型卡是否标注了 day-0 支持、对应 vLLM 版本是否已合入;没合入就退回 transformers 路径,别硬刚。
- 长文档被截断 :漏带
--max-model-len 262144,vLLM 默认只给 4K,256K 文档静默截断。 - 256K 推理 OOM:K/V cache 暴涨,24G 跑不动满血 256K 推理,降 ctx 长度或走 4-bit GGUF。
- GGUF 输出乱码 :llama.cpp 转换后 chat template 可能不匹配,用
ollama show zgcm-1-7b核对模板,必要时在 Modelfile 里手动指定 TEMPLATE。
十三、资源汇总
- 技术报告:arXiv:2609.13356(2026-09-15),Table 2--4 基准与 agentic 评分
- 模型权重:
zgcagi/ZGCM-1-7B(HuggingFace,Apache 2.0) - 训练数据:
zgcagi/ZGCM-1-Data(5.44B 行) - 训练代码/日志:GitHub
zgcagi/ZGCM-1(含中间 checkpoint 与 W&B 日志) - 报道参考:量子位《7名博士生仅用3个月从零训练7B大模型》(2026-09-15)
所有基准数字均为官方报告口径,待社区复现;本文 tok/s 与显存占用为按参数量与硬件带宽的估算,非独立实测。