文章目录
一提本地部署大模型,很多人的第一反应就是得先买张四五千的显卡。我原来也这么想,直到把天天背去上班的ThinkBook 14翻开,折腾三个晚上,硬是把一个270亿参数的模型跑起来了。
下面就是我这三个晚上的全部过程。想在自己电脑上跑大模型的,感兴趣的可以接着往下看。
一、设备条件
先看我的机器,联想ThinkBook 14 G7+ IAH。
| 项目 | 配置 |
|---|---|
| 处理器 | Intel Core Ultra 9 285H |
| 内存 | 32GB LPDDR5X,8533 MT/s |
| 显卡 | Intel Arc 140T核显,共享内存 |
| 硬盘 | 954GB |
| 系统 | Windows 11专业版24H2 |
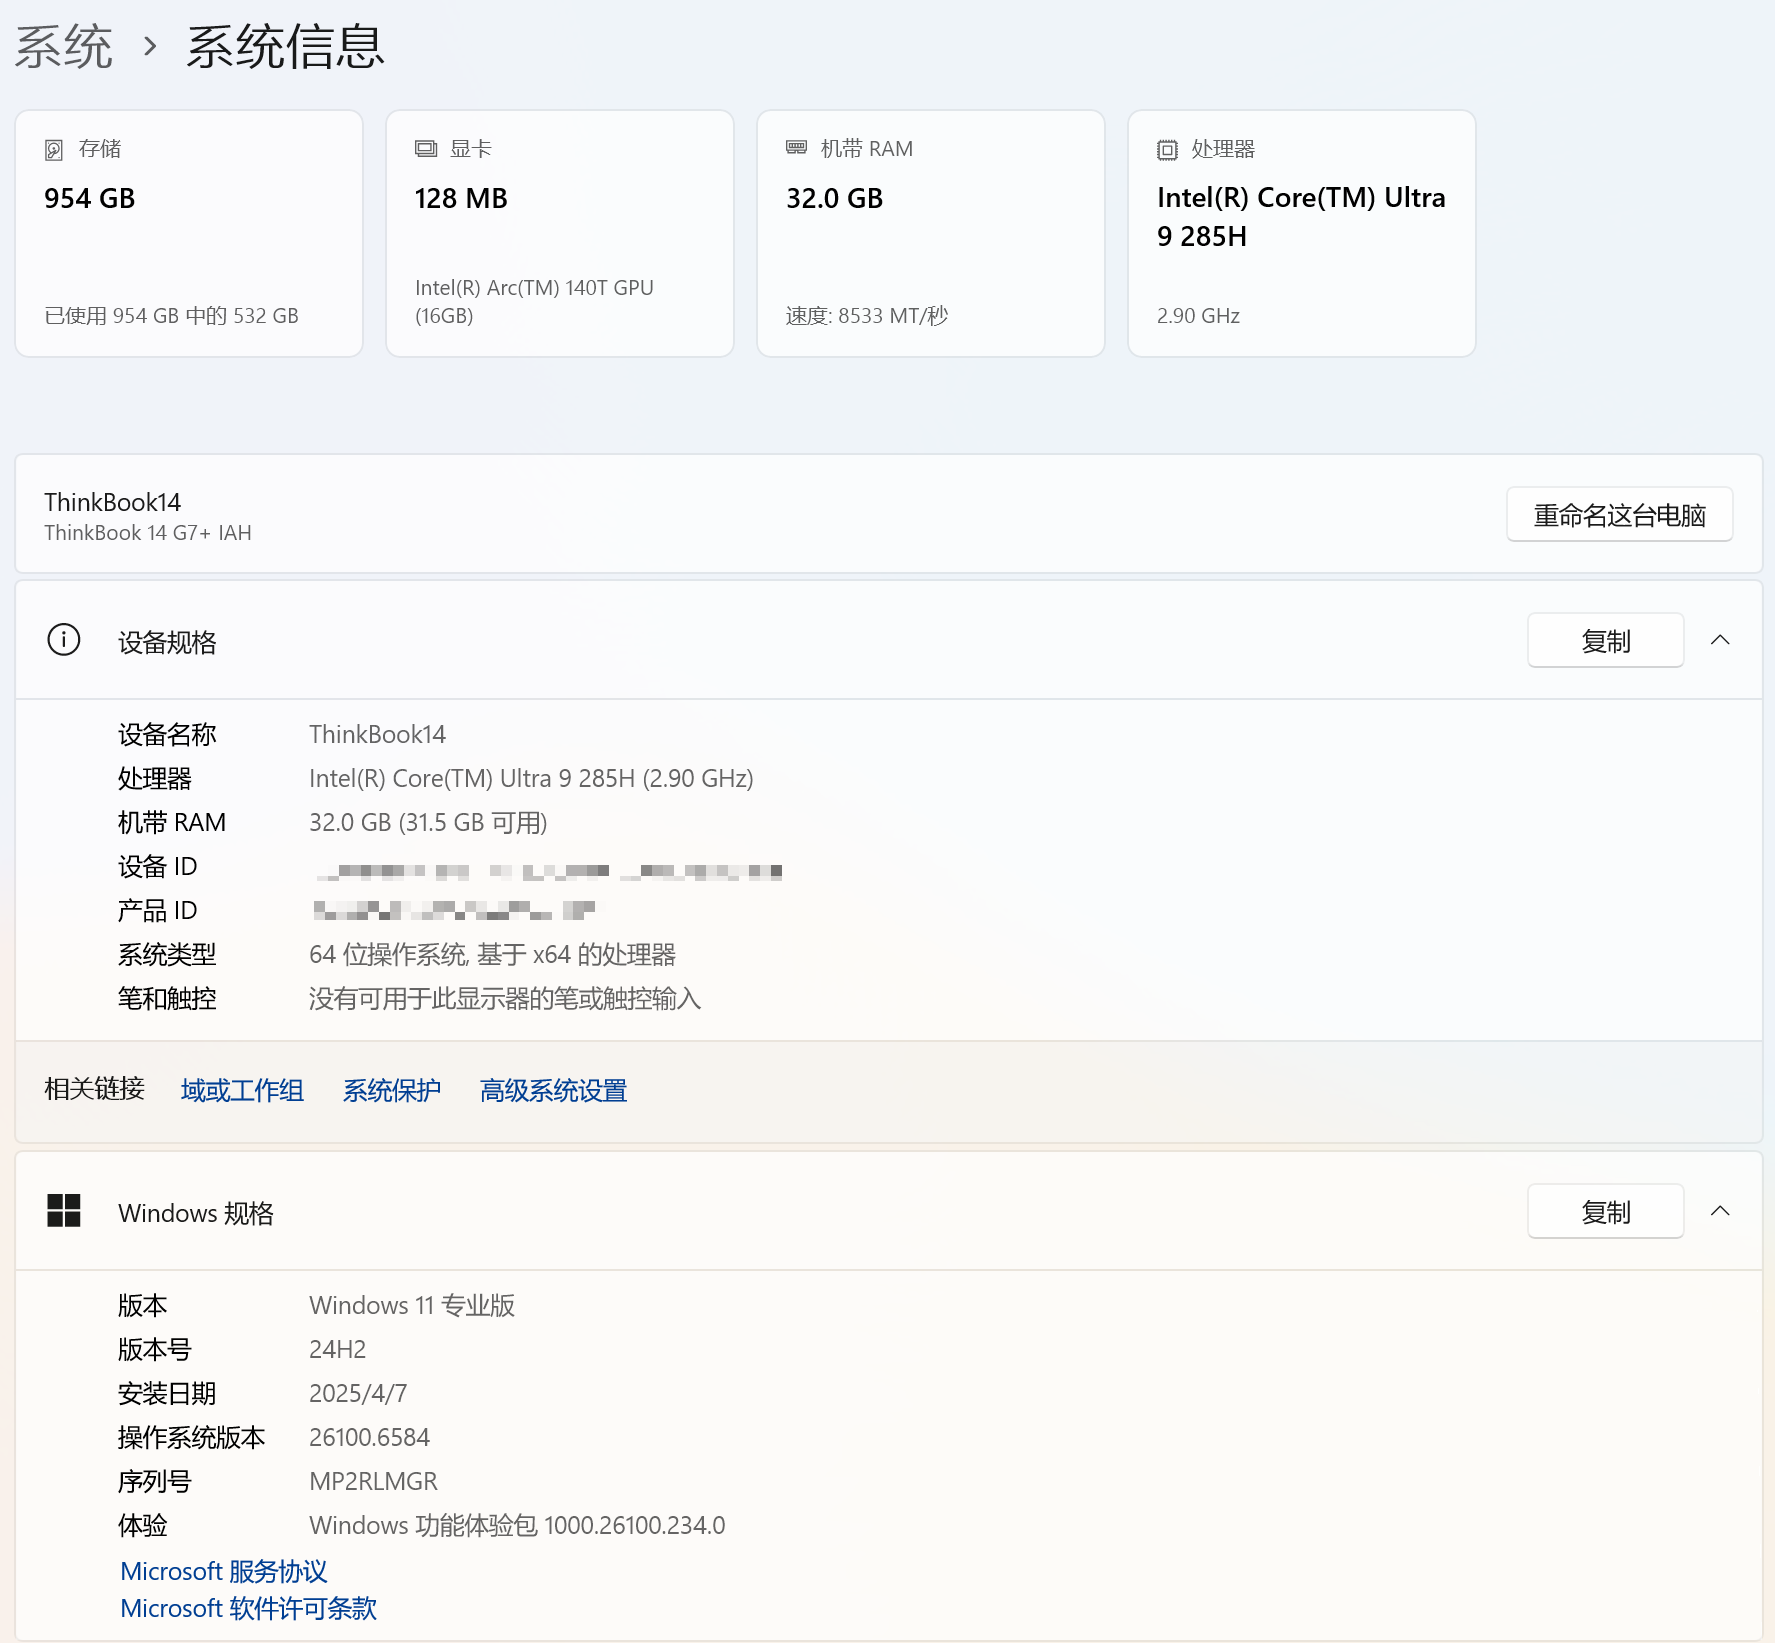
图:笔者的部署环境 联想ThinkBook14
这台机器没有独显,系统里显卡那一栏显示的128MB是共享显存,当不了真正的显存用。这是我踩过的第一个认知坑。
那它靠什么跑模型?靠那32GB内存,还有Arc核显能分到的那部分。说白了,就是饭桌上菜太多坐不下,干脆端个小板凳凑合。慢是慢点,但能吃上。
二、部署方案
本地跑模型的工具不少,Ollama和LM Studio我都装过,最后留在机器上的是llama.cpp。
Ollama:一条命令装完,敲一句ollama run就能对话,模型库里的现成模型也最多,上手最快。代价是后端的编译选项和启动参数全被封在里面,我这块核显能不能吃到Vulkan加速,所以不考虑。
LM Studio:图形界面最省事,模型从搜到加载全在窗口里点完,适合完全不想碰命令行的人。代价是它整套是封闭的桌面程序,运行时跟着它的版本走;我要的是一个能自己挑后端、长期挂在后台的服务,这些界面对我就是多余的。
llama.cpp:C++底层,中间没有多余的封装层,同一台机器上出字速度比Ollama快不少。代价是路径怎么放、参数怎么给,都得自己写。
我选它有三个原因。
1)它轻量,一个压缩包解压就能用,不往系统里塞东西。
2)它支持Vulkan后端,我这块Arc核显能吃到加速。
3)它同时给命令行和网页界面,还能对外开一套OpenAI兼容的接口。
再就是我自己爱折腾,参数一项一项调过去,要是只想开箱聊两句、不打算接进别的Agent,Ollama和LM Studio都比我这个省事得多。
llama.cpp你可以理解成一把万能钥匙,市面上GGUF的模型它基本都能支持。
模型我选的是 Qwen3.8-27B 。它是阿里在2026年8月14日开源的,原生多模态,能直接读图片和视频,原生上下文262K,用YaRN还能往外推到1M。最关键是它用Apache 2.0协议,免费商用,随便下载随便部署。
27B这个尺寸也刚好卡在甜点上,能力够用,体积又不离谱,可以把它当本地常驻模型用。
三、下载llama.cpp
llama.cpp下载地址: https://github.com/ggml-org/llama.cpp
进Releases页面,找Windows的预编译包。一定要挑带vulkan字样的版本 ,比如llama-b10955-bin-win-vulkan-x64。
拿错版本,核显加速就用不上,速度会掉一大截。
我把它放在D:\.llama.cpp\下面,建两个子目录,一个是程序目录llama-b10955-bin-win-vulkan-x64,一个是模型目录models。程序和数据分开,后面换模型不会乱。
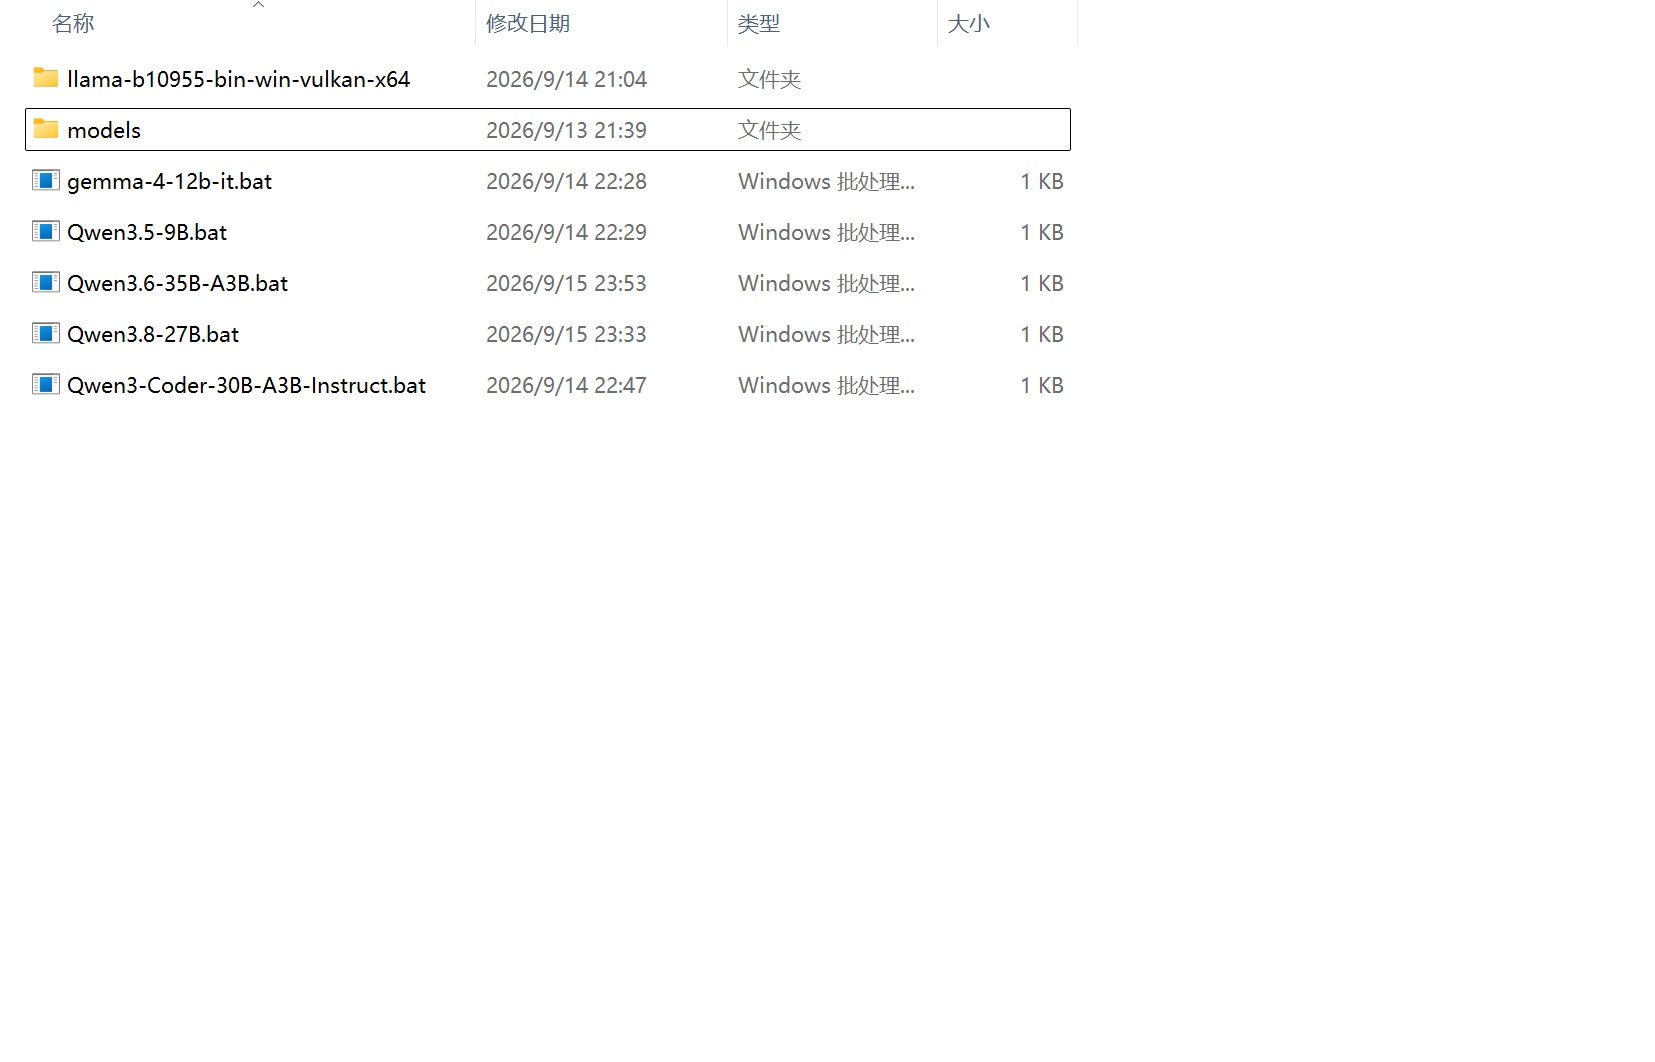
图:D盘根目录的文件布局
四、下载模型
模型我是从魔搭社区下的,网址是 https://modelscope.cn/
这是国内做模型分发比较大的社区,下载速度比从境外的源上拉实在得多。我这个27B模型下载很快,下载下来也没有花多少时间。
模型页地址是 https://modelscope.cn/models/unsloth/Qwen3.8-27B-GGUF
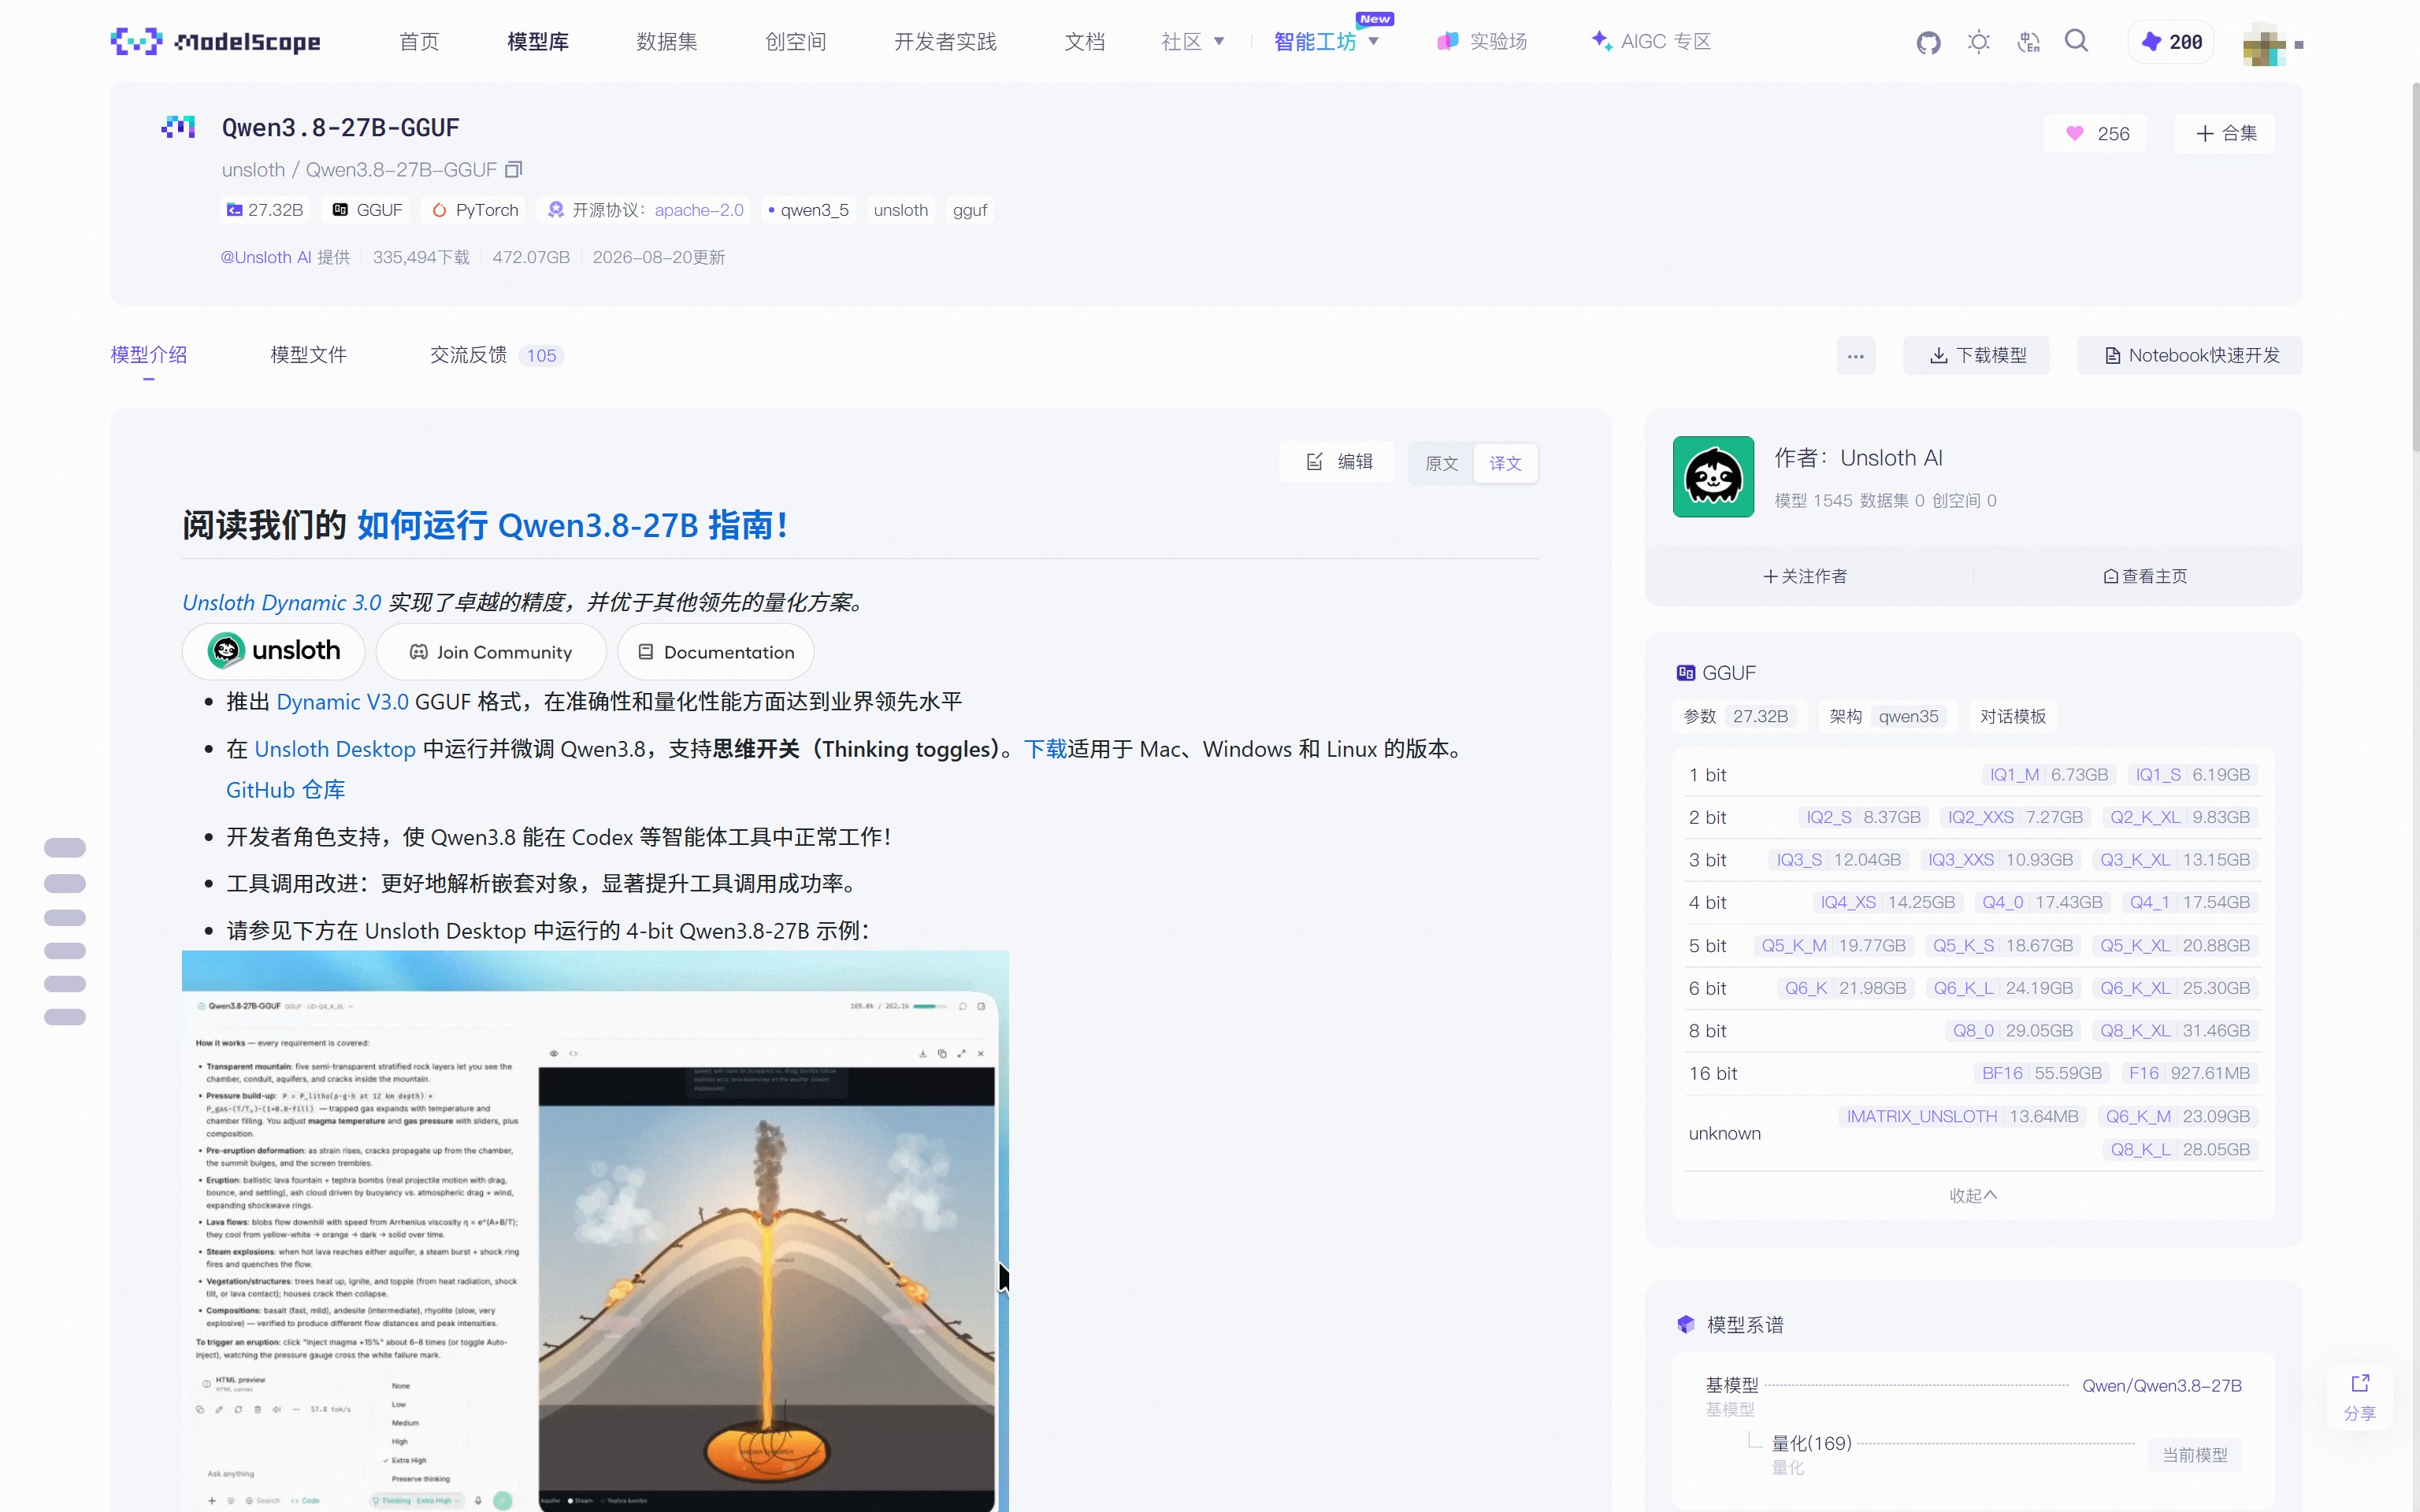
图:魔搭社区上的Qwen3.8-27B-GGUF模型页
下载前得先定一个参数:量化精度。同一个模型,量化档位不同,体积和脑子聪明程度都不一样。
说白了跟衣服抽真空打包一个道理,压得越狠越省地方,料子总归会有点变形。常见档位我列在下面,你对着自己的机器挑。
| 量化档位 | 体积 | 显存建议 |
|---|---|---|
| 8bit | 约27GB | 32GB起 |
| 6bit | 约21GB | 24GB能塞 |
| 5bit | 约18.5GB | 24GB基本合适 |
| 4bit | 约15.9GB | 16GB的标准答案 |
| 3bit | 约11.7GB | 12GB可以试 |
| 2bit | 约9.6GB | 8GB勉勉强强 |
我下的是两个文件,主模型Qwen3.8-27B-Q4_K_M.gguf,外加一个视觉编码器mmproj-F16.gguf。后者是给多模态读图用的,不下载也不影响文字对话。
下载命令就一行:
bash
modelscope download --model unsloth/Qwen3.8-27B-GGUF --local_dir ./Qwen3.8-27B经验分享:量化档位别贪高。我一开始想上5bit,结果发现内存不够分,最后还是退回了4bit。
五、启动脚本
模型和程序都躺好了,剩下就是启动。在D:\.llama.cpp\根目录下新建一个文件Qwen3.8-27B.bat,把下面这段贴进去:
bat
@echo off
chcp 65001 >nul
title Qwen3.8-27B

set LLAMA_DIR=D:\.llama.cpp\llama-b10955-bin-win-vulkan-x64
set MODEL_PATH=D:\.llama.cpp\models\Qwen3.8-27B\Qwen3.8-27B-Q4_K_M.gguf
set MMPROJ_PATH=D:\.llama.cpp\models\Qwen3.8-27B\mmproj-F16.gguf
set API_KEY=sk-你的密钥自己填

cd /d %LLAMA_DIR%

llama-server.exe ^
  -m "%MODEL_PATH%" ^
  --mmproj "%MMPROJ_PATH%" ^
  --no-mmproj-offload ^
  -c 32768 ^
  -t 16 ^
  -b 512 ^
  -ctk q8_0 ^
  -ctv q8_0 ^
  -fa on ^
  --image-min-tokens 1024 ^
  --temp 0.70 ^
  --top-p 0.90 ^
  --top-k 50 ^
  --parallel 1 ^
  --repeat-penalty 1.08 ^
  --host 127.0.0.1 ^
  --port 8080 ^
  --api-key %API_KEY%

pause**这个密钥得自己换掉。**脚本里的密钥我留的是占位符,因为它是一串明文,任何能访问你127.0.0.1:8080的程序都能直接拿去用。要是打算把服务开给局域网里的同事,这一步更省不得。
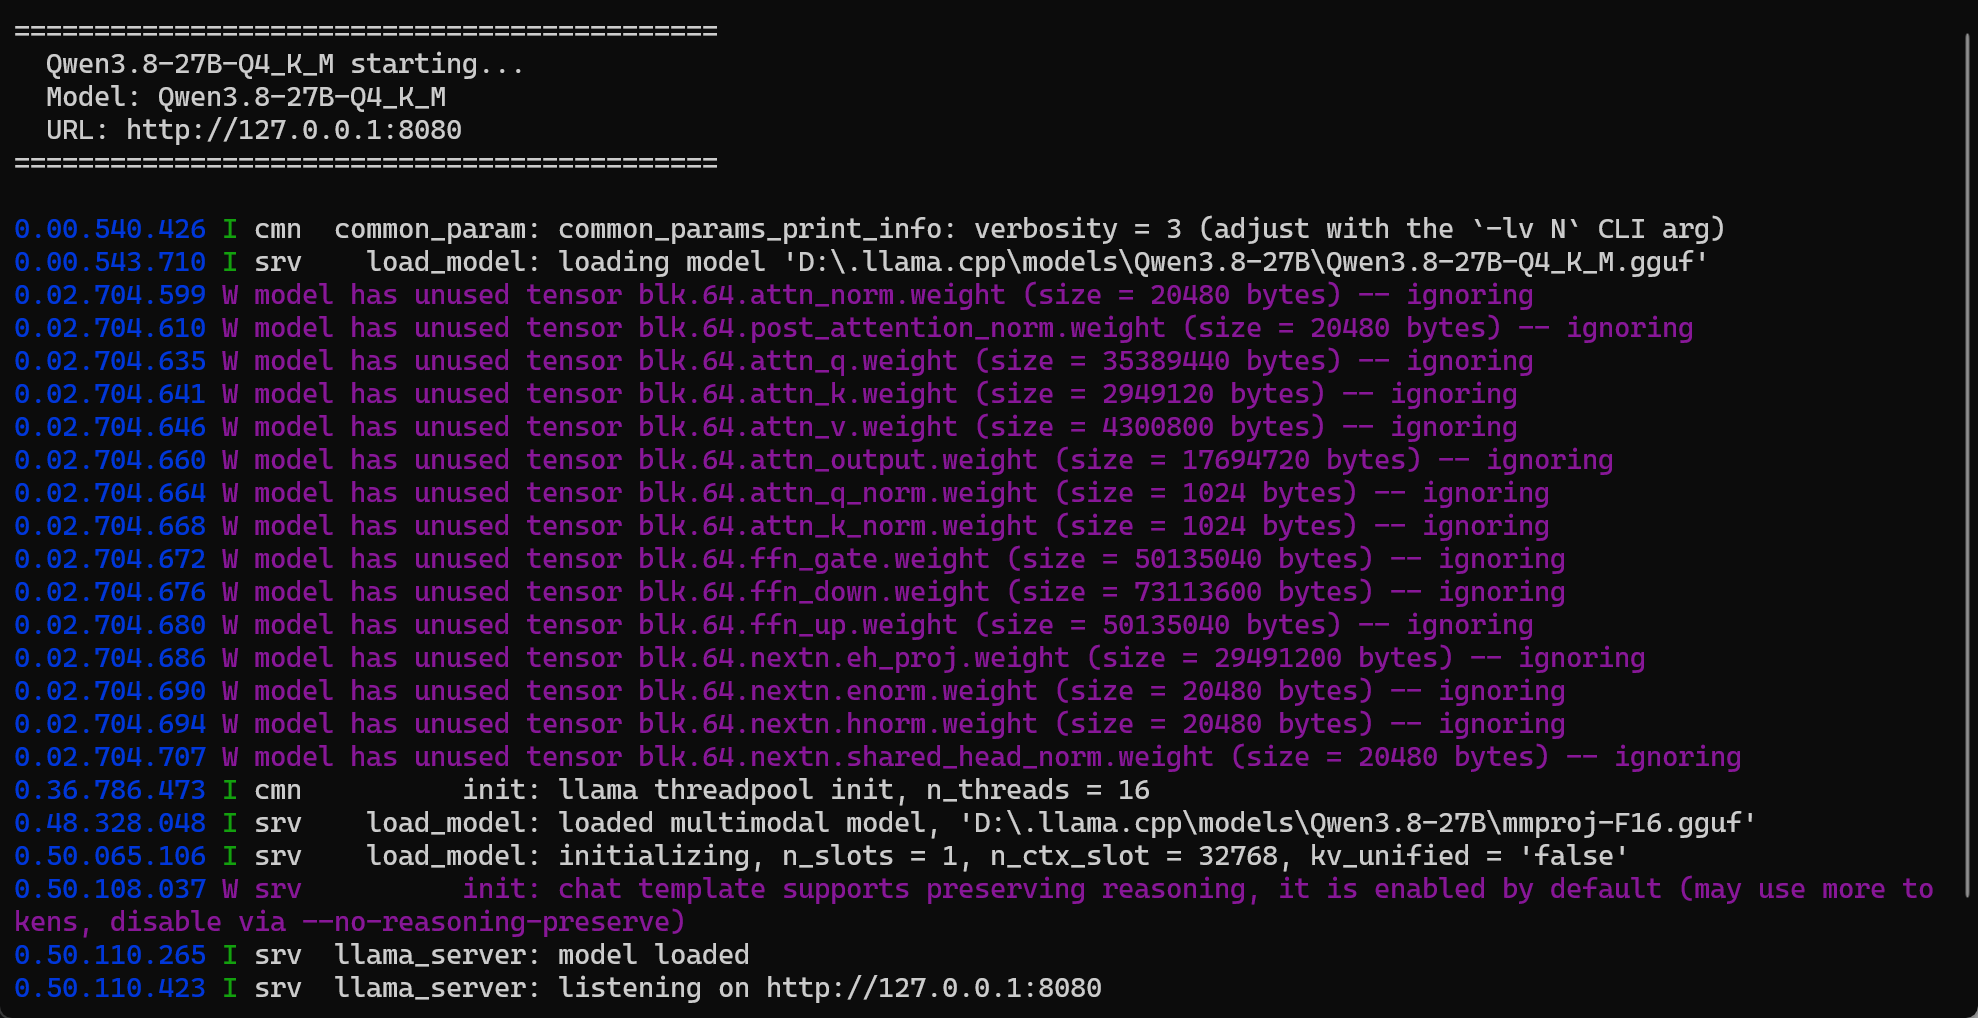
图:llama-server启动过程
脚本里的参数我逐个说一遍,调过的会说下为什么。
-m后面跟主模型文件的路径,也就是前面下好的那个Qwen3.8-27B-Q4_K_M.gguf。
--mmproj是视觉编码器的路径,也就是mmproj-F16.gguf,读图这一步靠它。
--no-mmproj-offload是让视觉模块别往显卡上挤,核显这点共享显存本来就紧张,留在内存里更稳。
-c 32768是上下文长度,直接决定内存里给对话历史留多大地方,调大了内存被吃光,调小了长文章塞不进去。
-t 16是线程数,Ultra 9 285H的能效核和性能核加起来正好16个,试下来比较平衡,拉满了反而会抢资源变慢。
-b 512是批大小,管的是提示词读进去的快慢。
-ctk q8_0和-ctv q8_0压的是KV缓存精度,按默认精度存,长上下文场景内存会疯长,压到8位基本看不出损失。
-fa on打开Flash Attention,相当于给注意力计算换了套更省内存的算法,不开内存顶不住。
--image-min-tokens 1024是每张图编码后保底占用的token数,图像细节靠它留住。
--temp 0.70、--top-p 0.90、--top-k 50这三个控制输出随机性,想让它更稳就往下调温度,想让它更有想法就往上加。
--parallel 1是同时处理的请求数,设1就是一次只服务一个。
--repeat-penalty 1.08是重复惩罚,压住它翻来覆去说同一句话。
--host 127.0.0.1和--port 8080是监听的地址和端口,也是浏览器里要访问的地址。
--api-key取的是脚本前面那个API_KEY,也就是你自己填的密钥。
这份脚本我最早是照着别人的模板改的,已经用了一段时间了,除了因受制于硬件输出速度慢之外,没有其他毛病。
启动成功后,浏览器打开http://127.0.0.1:8080,就能看到自带的对话界面。
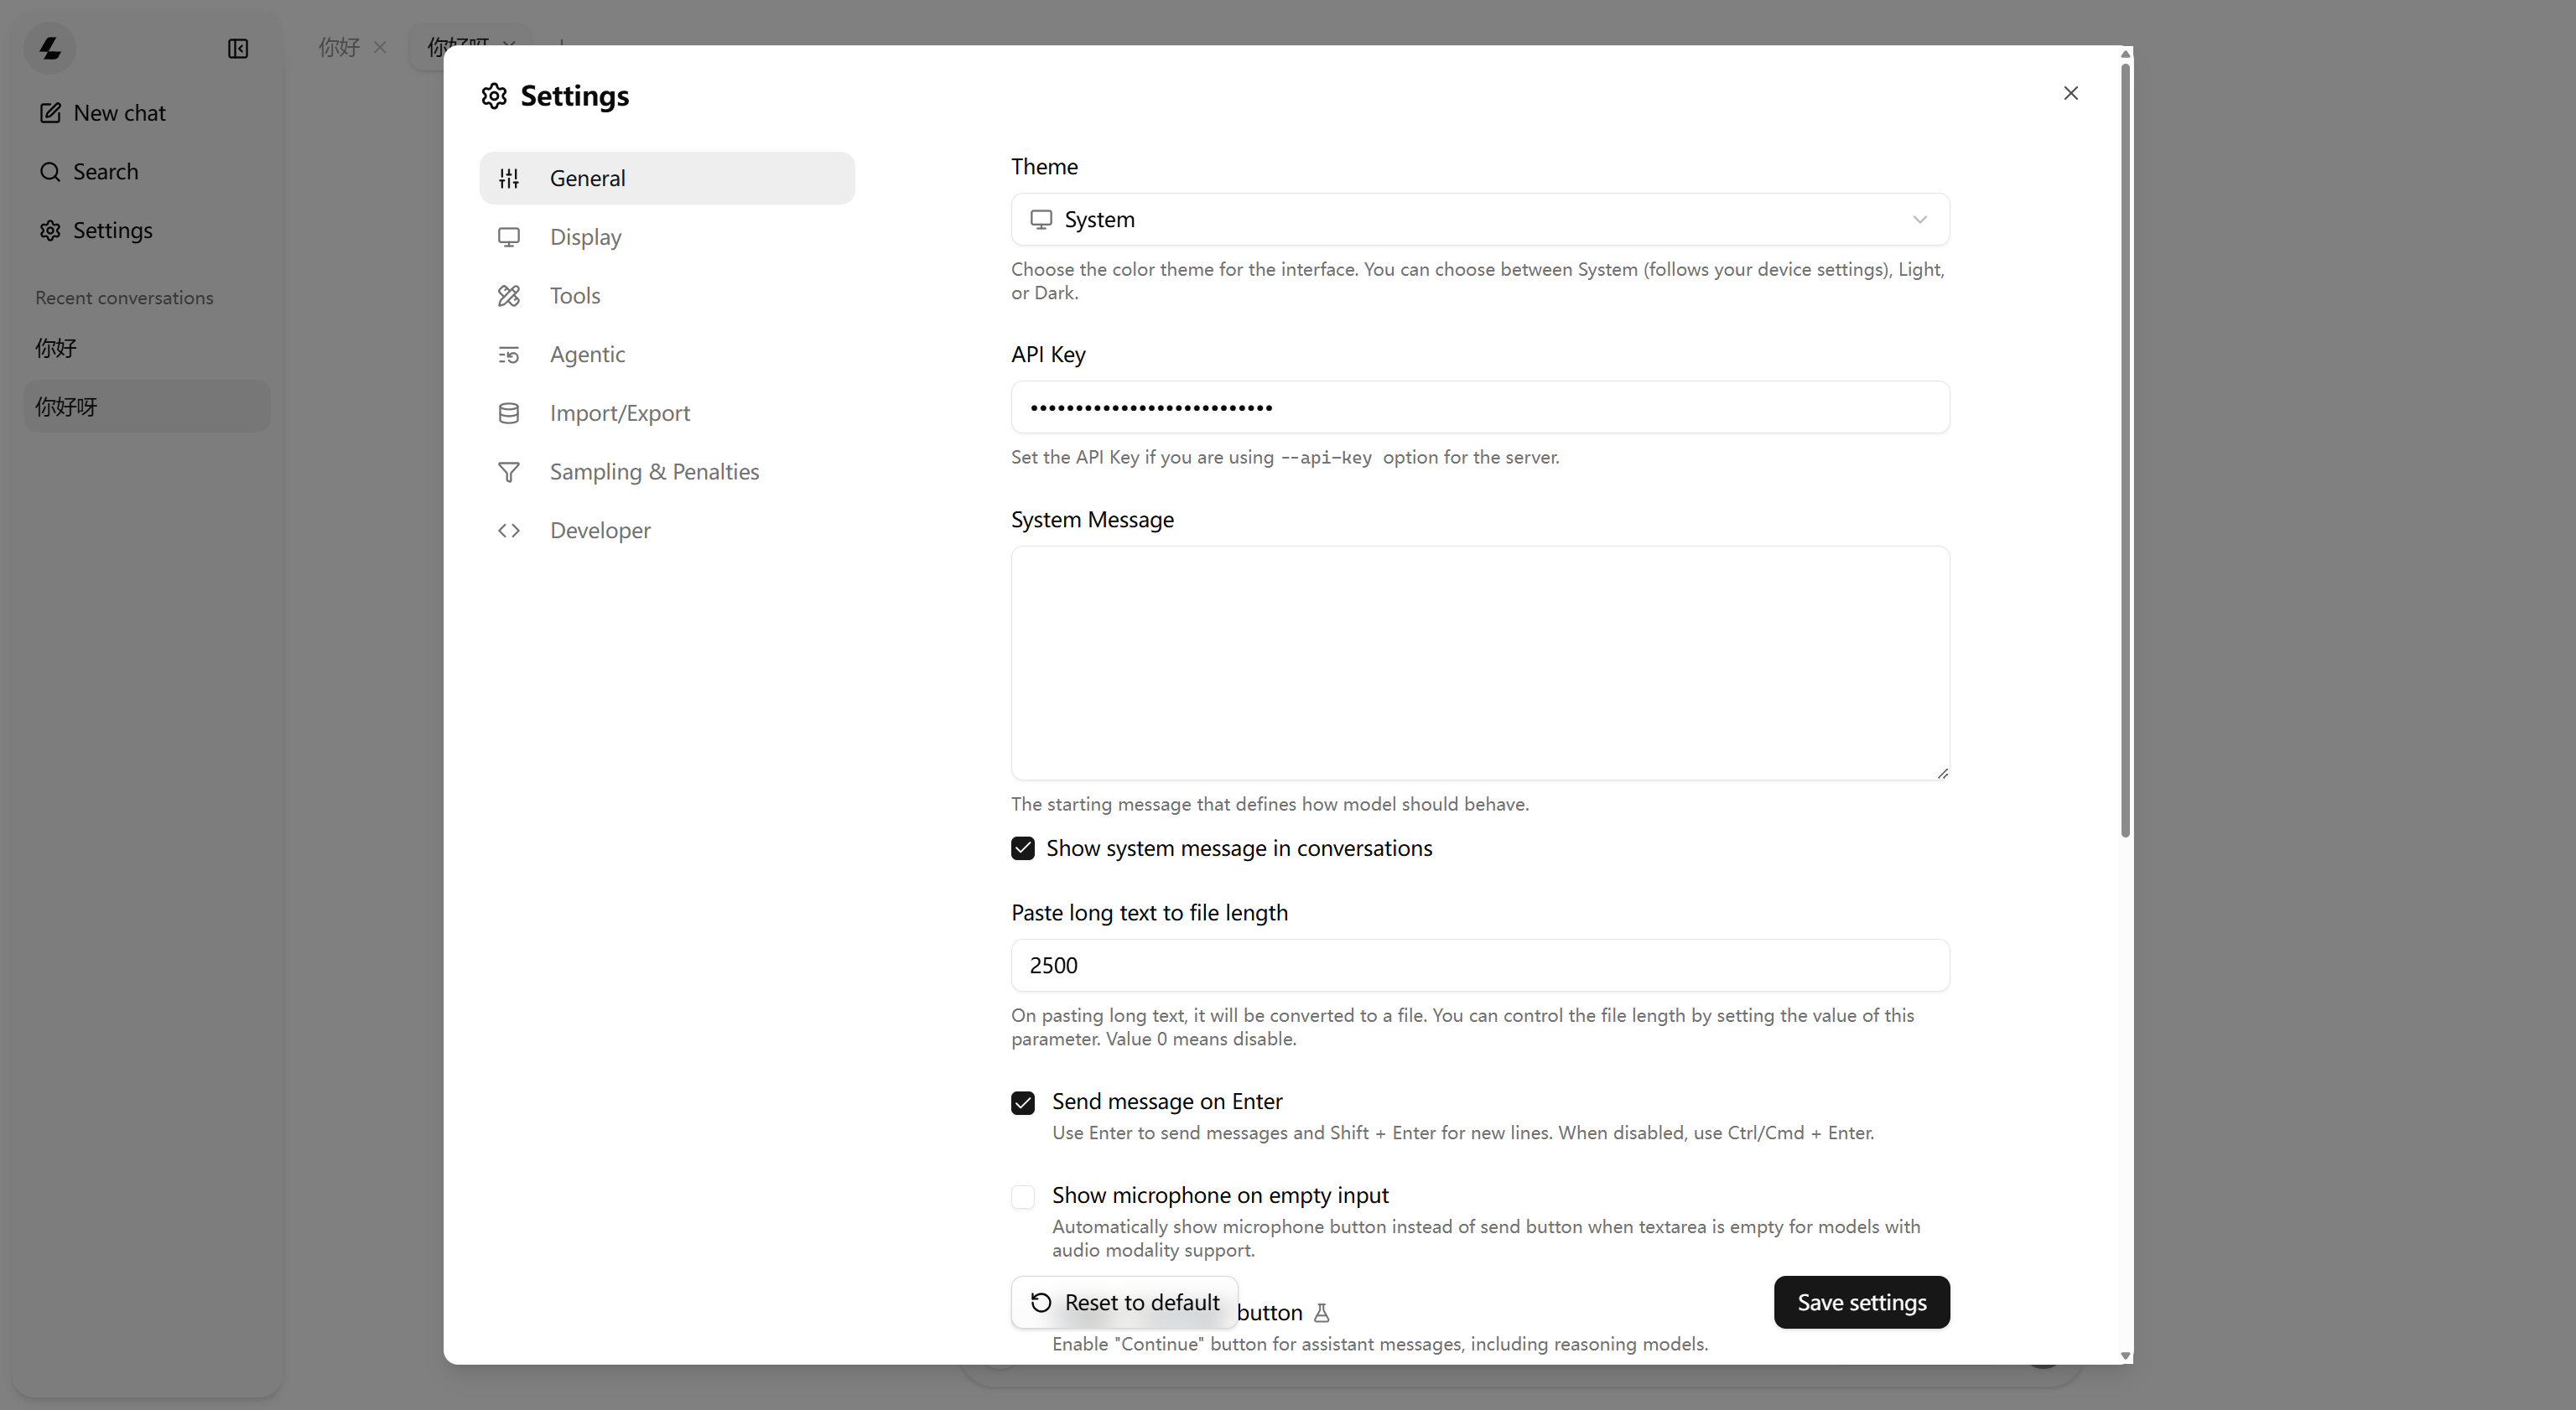
图:llama.cpp的网页设置页
六、实测效果
先说速度:**10.42 t/s,**这是刚装好测试的速度。我的电脑除了跑模型,我还要做其他事情,实际在使用中比较要更慢一点,大概就3 ~ 5 t/s。
这个数字什么概念?大概就是看它往外吐字,比打字机慢一点,比手写快不少。比如:问天气,一般几秒就回复了。写一首诗,大概30秒左右。做一个贪吃蛇网页游戏,得等40分钟。
下面是让它写了首七言律诗,整体还不错,韵脚压在「阳」「苍」「黄」「肠」「觞」上,颔联颈联的对仗也站得住,写完之后自己还附了段赏析。
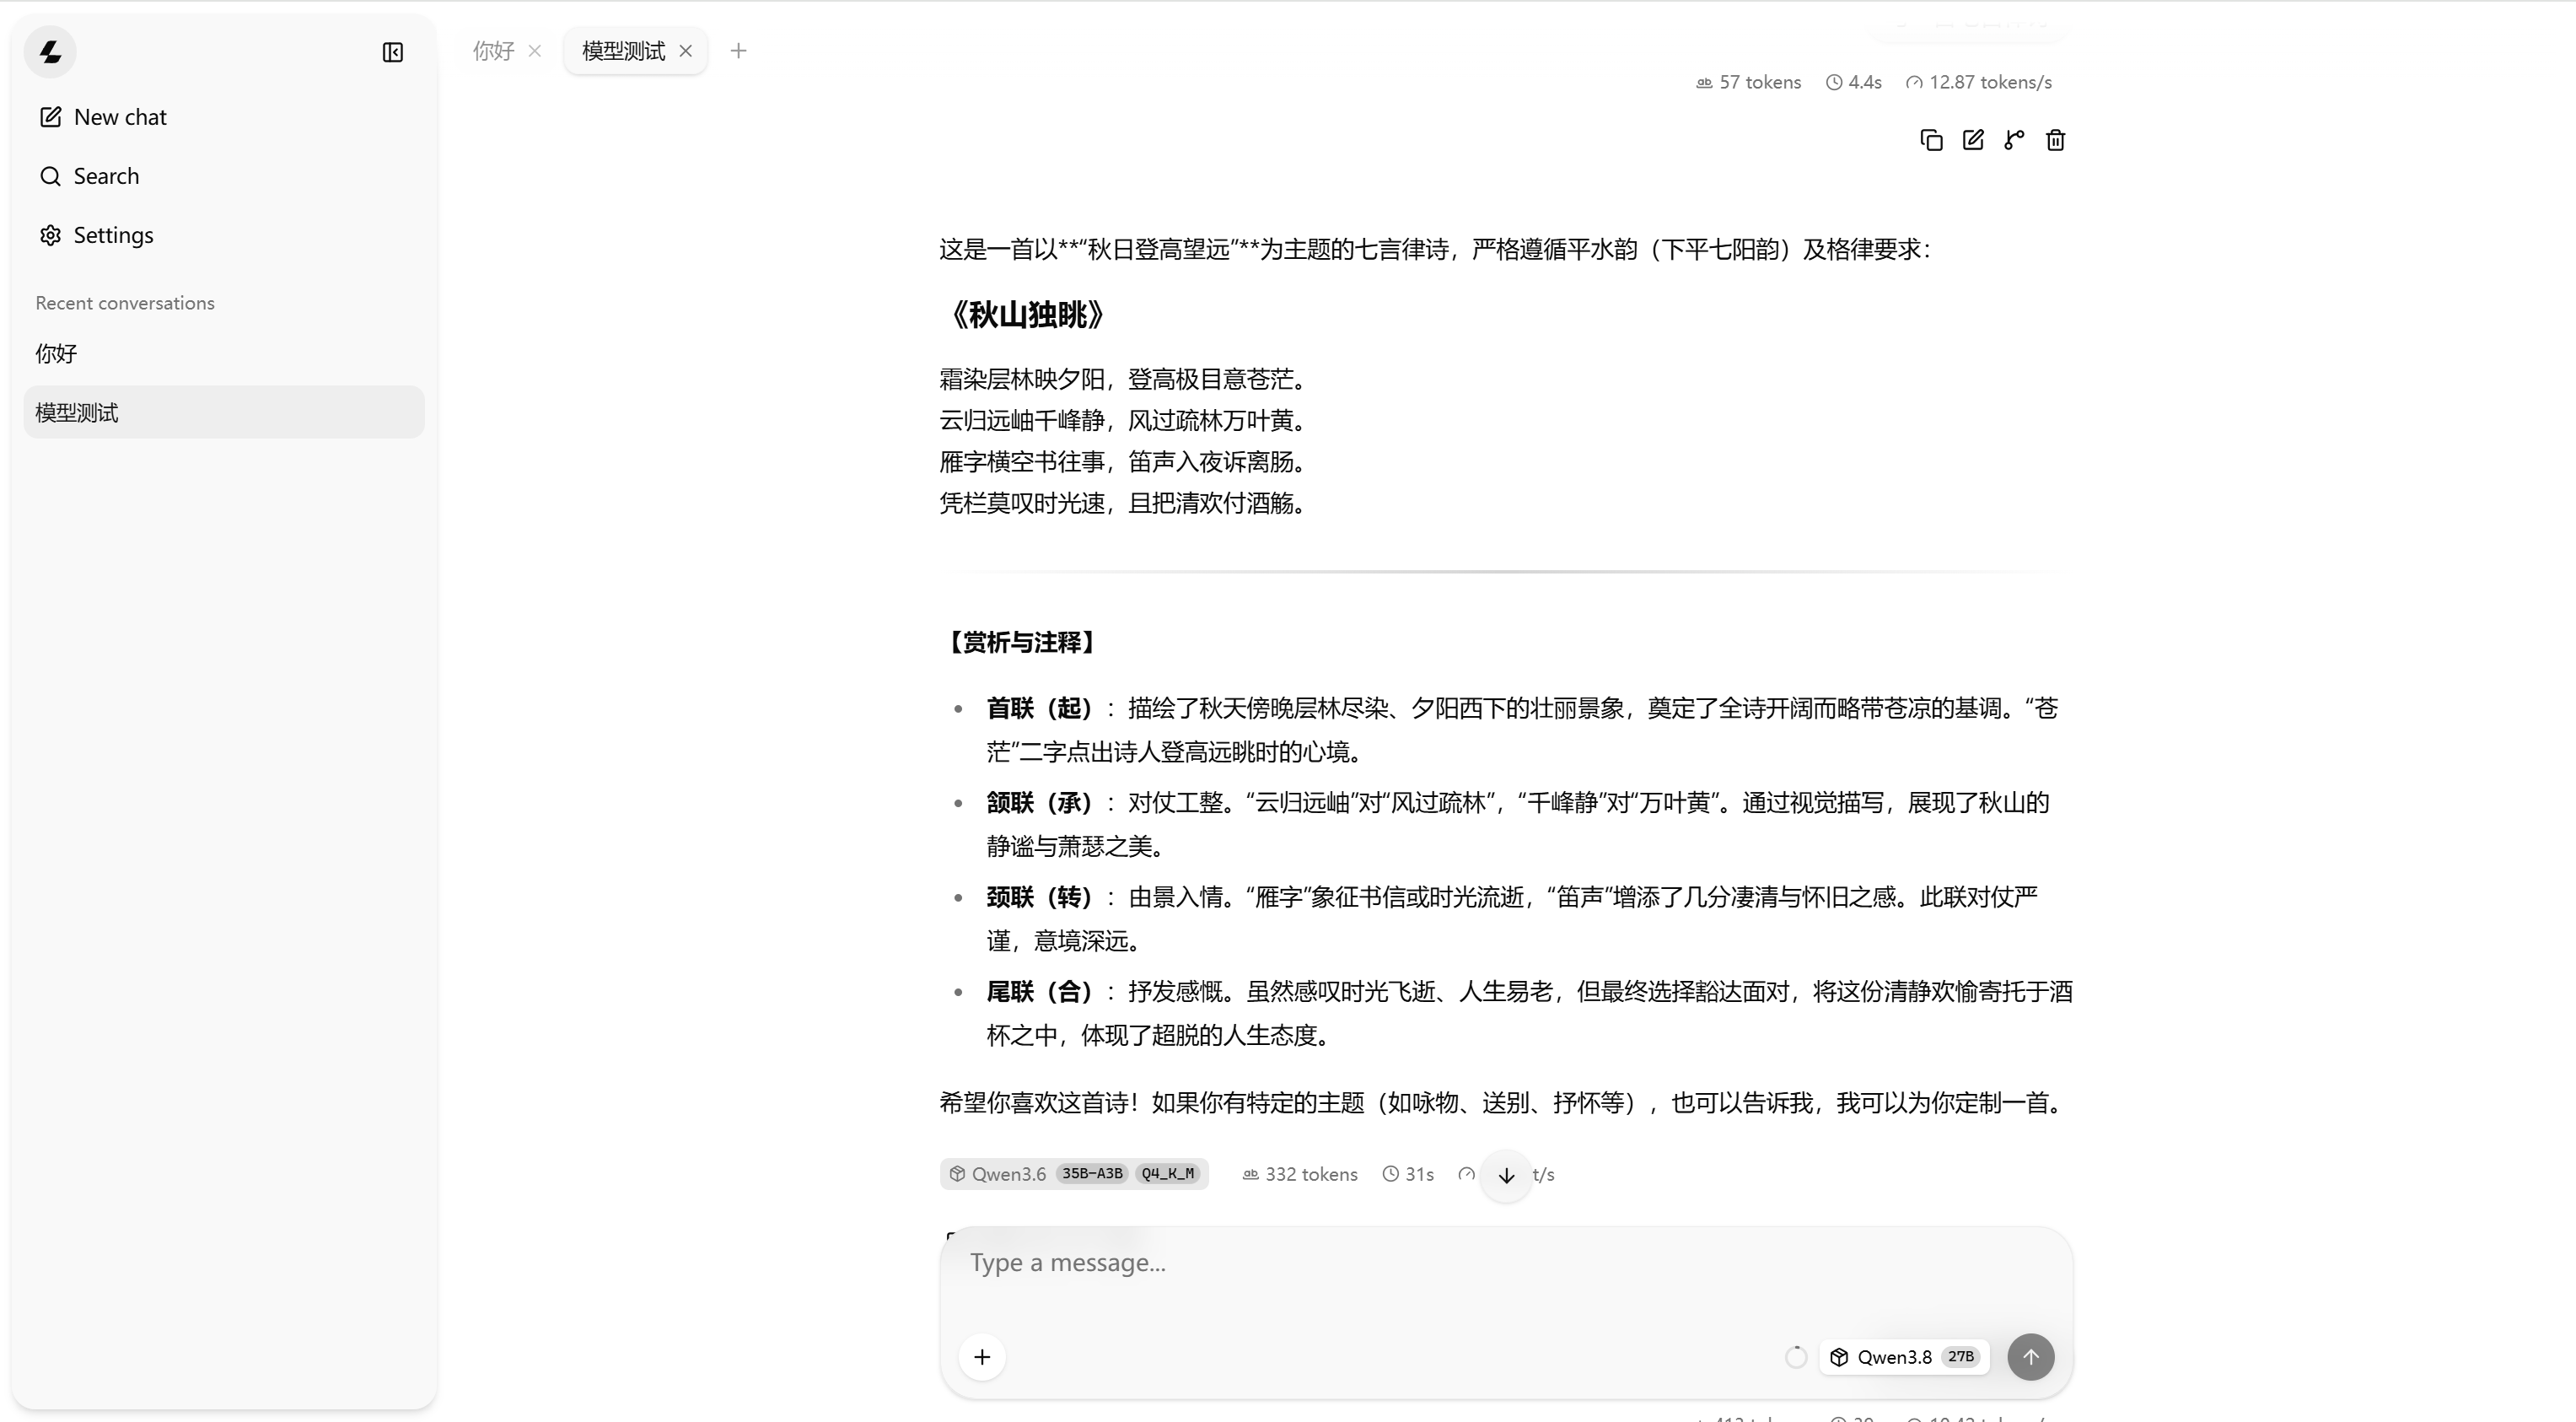
图:让模型照着格律写七言律诗
一个能装进轻薄本的模型,能对话、写诗、写短文、做游戏还是不错的,但它也不是万能的。做数学推导、超长文档的精确引用,还是会掉链子,这种复杂任务还是老实交给云端大模型。受限于我的电脑配置,目前只能这样子了,想让模型跑更快,还得换个好一点的设备才行。
七、接进DeepSeek Harness
我把它接进了本地的DeepSeek Harness客户端,配置就三步。API地址填http://127.0.0.1:8080/v1,API协议选openai-completions,模型名和密钥填启动时设的那组。
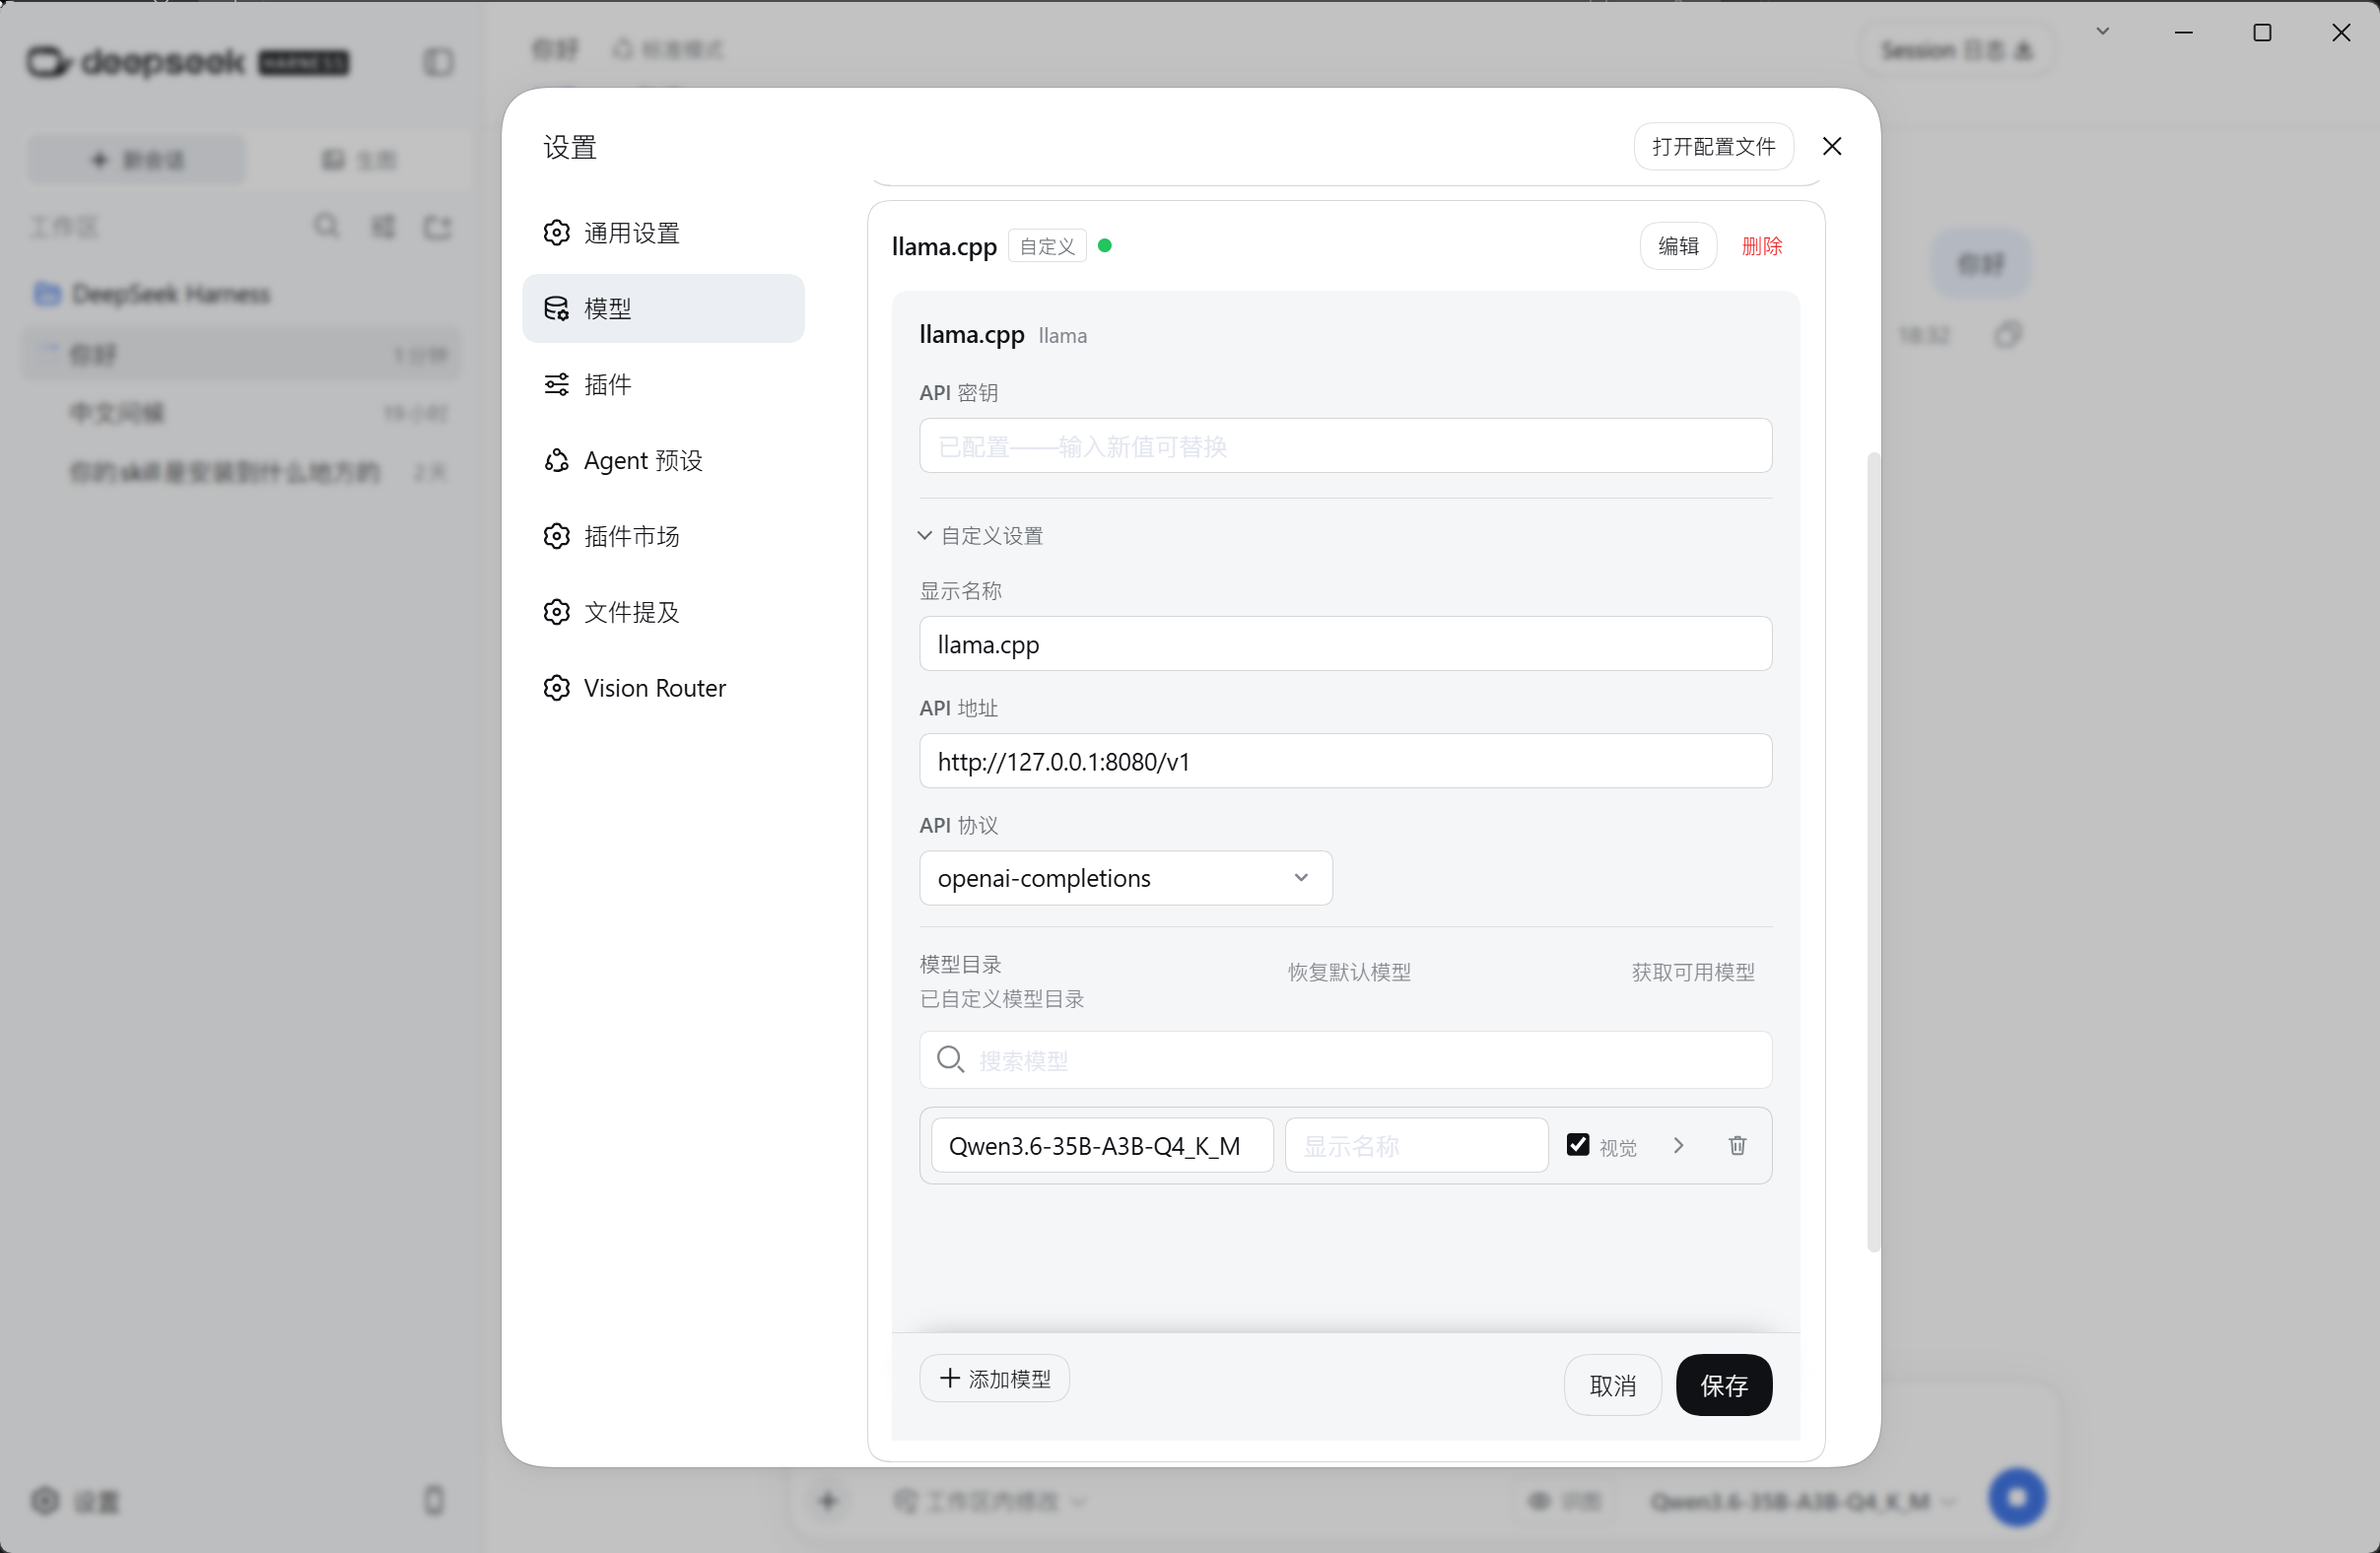
图:在DeepSeek Harness里配置本地模型
接好之后,它就是桌面端一个随时能敲的助手。写文档、改代码这类活儿,全程不联网,数据一个字都不出你的机器。这一点才是我坚持折腾本地部署的原因。云端模型再便宜再快,有些东西还是不适合往里传。
八、劝退提醒
**第一,速度是真的慢。**3 ~ 5 t/s意味着你没法拿它做实时对话,更别说跑自动化流程。想要爽快体验,还是得有张正经的独立显卡。
**第二,占地方也占内存。**17GB的模型文件先占着硬盘,跑起来还要吃掉一大半内存。后台再开几个浏览器和IDE,机器就开始喘了。
**第三,第一次跑起来要等。**模型加载进内存大概要几十秒,风扇会明显转起来,别以为是坏了。
有疑问的话可以在评论区留言交流。觉得有用的话,欢迎点赞关注。
参考资料
本文为原创文章,遵循 CC 4.0 BY-SA 版权协议,转载请附上原文出处链接和本声明。