一、背景
1.1 推理服务部署方式
推理服务会被部署在 K8s 中运行,同一个模型可能会有多个部署实例:
▸跨集群:同一模型会在多个集群各部署一份,形成多个推理服务实例。
▸同集群:机型、网络、部署形态不同,也会拆成多个实例。
▸实例内部:每个实例有多台副本(Pod);每个实例共享一个 KV Cache 池。
用户请求某个模型时,网关要做两次选择:先选哪个实例,再选该实例下的哪台副本。
1.2 与普通 HTTP 网关的差别
普通 HTTP 网关通常假设:请求开销相近、处理时间短、后端无状态。因此,按 QPS 或连接数做负载均衡通常就够了。相比之下,推理请求有下列差异:
1.请求成本不等价: 上下文长度不同的请求占用的资源量差异大,两个后端即使各有 10 条在途请求,实际负载也可能相差一个量级。不适用轮询或随机分发。
2.缓存状态需要亲和: 推理引擎会为已处理的前缀保留 KV cache。多轮对话的下一轮如果切换后端,之前的 prefill 就要全部重做,首 token 时延可能成倍增加。因此,「最空的后端」与「最快的后端」往往不是同一个。
3.异构能力难以固化: 不同机型运行同一模型时,吞吐、时延和并发上限都不同。固定权重只能反映配置时的状态,难以长期匹配真实能力。
二、AITC 网关方案总览
2.1 两级路由架构
| 层级 | 组件 | 功能 | 部署 |
|---|---|---|---|
| 一级 | Higress + 自研 WASM 插件 aitc-ai-lb | 选目标推理实例 | 全局一个 |
| 二级 | 自维护 vllm-router | 选目标推理副本 | 每个推理实例一个 |
一级网关按实时时延、在途请求、健康状态和请求前缀选择实例;二级网关在实例内部选择副本。
2.2 一级网关:Higress + 自研 WASM 插件
Higress 是基于 Istio 和 Envoy 构建的企业级 AI 原生 API 网关,经过阿里巴巴大规模生产验证。它具备高性能、热更新、流式处理、安全治理和 WASM 扩展能力,适合作为统一入口。
Higress 原生能力不能覆盖 AI 推理所需的跨集群异构实例、多信号评分和前缀亲和选路,Higress 推出的原生 AI 路由插件能力较弱,不适用我们的网关路由场景。因此,我们开发 aitc-ai-lb 插件补齐实例级推理路由能力,并复用 Higress 的鉴权、限流、路由和可观测能力。
2.3 二级网关:自维护 vllm-router
大多数模型使用 vLLM 部署,vllm-router 能直接复用其生态,并提供 K8s 服务发现、健康检查和 Prefill/Decode 分离调度。所以我们选用 vllm-router 作为二级路由。
但是 vllm-router 原生版本的负载统计和路由策略存在问题:
1.负载统计有问题:1.1 定期从推理服务副本 API 抓取负载数: 定期抓取导致负载数更新慢,容易导致羊群效应 ------ 大量请求同时被打到同一个副本。1.2 Router 自己统计 in-flight 技术: 代码存在 bug,统计的负载数量不可信
2.路由策略不满足我们的需求。
因此我们自己维护 vllm-router,用 RAII + 时间桶维护精确在途计数,并设计符合需求的路由策略。详情见章节 5。
三、架构
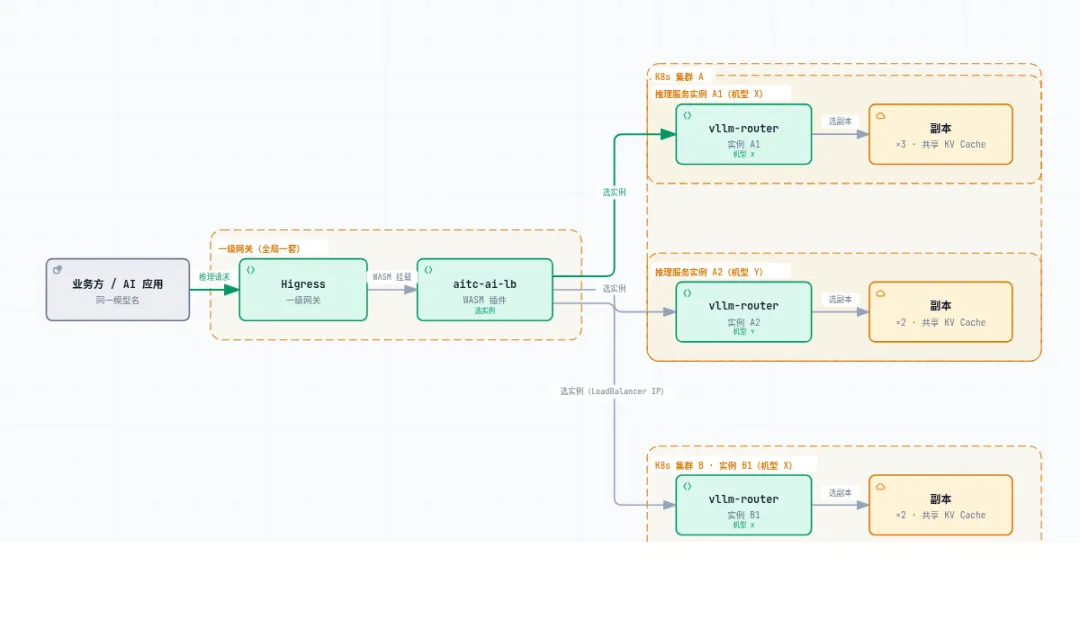
1.一级网关的选择目标对象是实例,落点是一组实例对应的 vllm-router,通过 LoadBalancer IP 访问 vllm-router。
2.每个实例自带一个 vllm-router,只看得到自己实例下的副本。并不感知其他实例。
四、一级网关:Higress 与 aitc-ai-lb
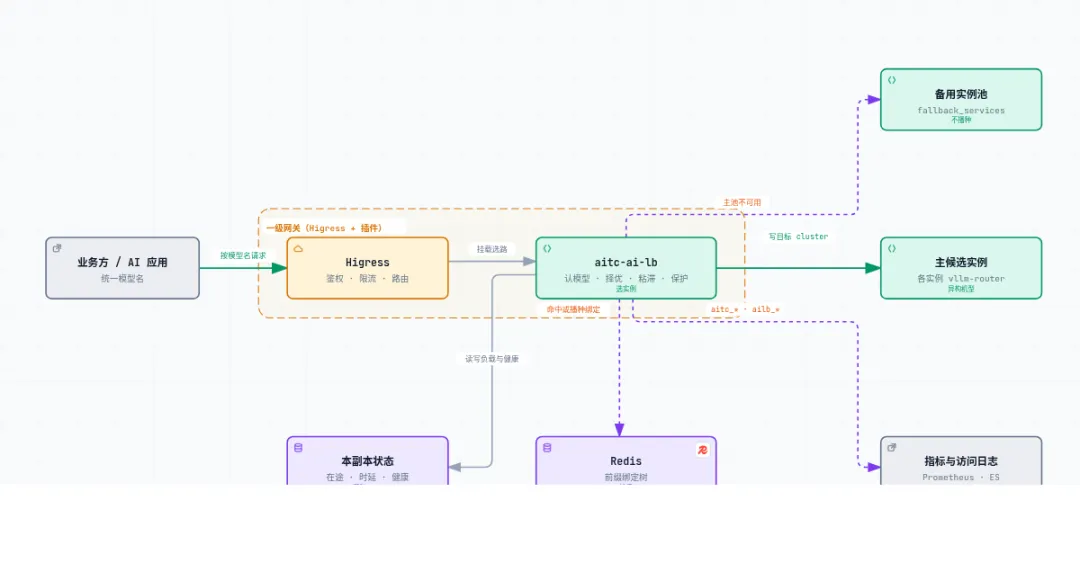
一级网关全局只有一套,由 Higress 及插件 aitc-ai-lb 实现 AI 流量路由能力:
1.Higress: 提供网关基本的功能。
2.aitc-ai-lb: 提供针对 AI 流量的负载均衡能力,将请求打到对应的推理实例。
4.1 Higress
Higress 是基于 Istio 和 Envoy 的 AI 原生 API 网关。在这套方案里,它提供下列功能
1.统一入口与路由: 按域名、路径、模型名称,将流量接到对应的 AI 路由上。例如: 当用户请求 GLM-5.3 时,将请求转发到 GLM-5.3 的路由规则处理,下一步由 aitc-ai-lb 选择目标 GLM-5.3 部署实例。
2.鉴权: 消费者鉴权、安全治理。
3.可观测底盘: 提供 access log、Envoy 指标、流量指标等监控数据。
4.WASM 扩展: 扩展性强,支持用 WASM 插件自定义所需能力并热更新生效;本方案的实例级推理路由就是通过自研 WASM 插件 aitc-ai-lb 实现的。
Higress 默认的负载均衡,以及官方 AI 路由插件,覆盖不了我们的场景,所以我们通过自研的 aitc-ai-lb 插件实现负载均衡路由。
4.2 aitc-ai-lb
aitc-ai-lb 是一级网关中的 AI 流量路由插件,整体负责在多个推理实例(异构、跨集群)中选择最合理的目标服务
1.负责完成"候选收集、状态感知、路由决策、请求改写、结果观测"闭环。
2.路由目标是部署实例,不是实例内部的单个 worker。
插件的核心能力包括:
▸前缀匹配:支持根据请求路径前缀匹配目标服务,可为不同的模型、业务接口或租户配置独立的路由规则。
▸路由评分:综合后端健康状态、实时负载、资源使用率、历史响应延迟、并发数等指标,对候选后端进行动态评分,并优先选择评分较高的服务实例。
▸亲和性设置:支持设置请求特征与后端服务之间的 affinity / antiaffinity 硬过滤,确保请求只被转发到满足亲和性的后端服务。
▸兜底服务:当请求无法匹配到符合条件的后端,或所有候选后端均不可用时,自动转发至预设的兜底服务,提升系统的可用性和容错能力。
▸监控指标:提供请求量、成功率、错误率、响应延迟、路由命中情况、后端健康状态、实例负载以及兜底流量等监控指标,支持 Prometheus 等监控系统,便于问题排查和运行状态分析。
▸故障隔离与恢复:支持异常实例自动摘除、周期性健康检查和恢复后自动重新加入,避免故障扩散并缩短服务恢复时间。
4.2.1 路由架构
aitc-ai-lb 的路由决策架构图如下:
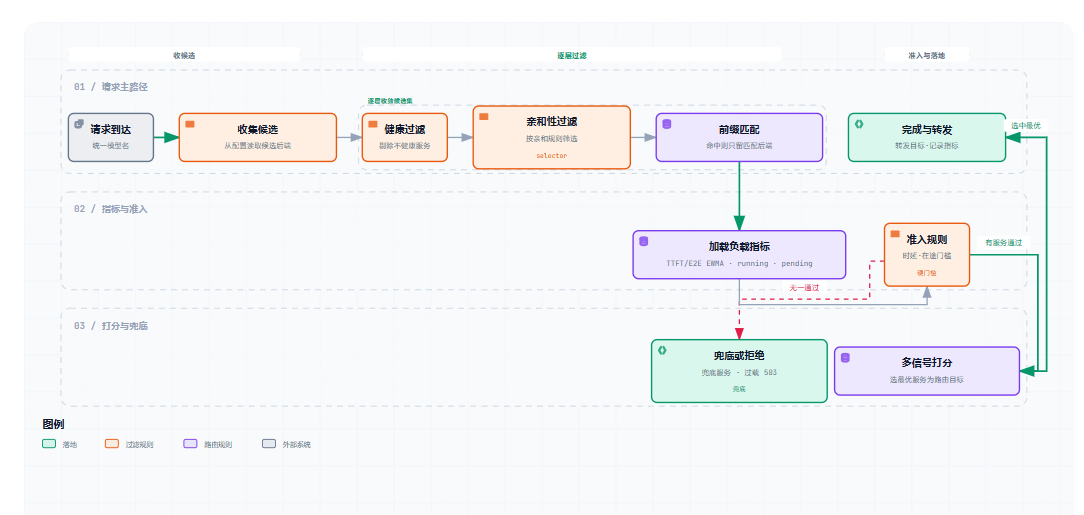
aitc-ai-lb 把一次路由决策拆成一串明确定义的阶段,一次请求通常按以下顺序处理:
1.收集候选:从配置中收集候选后端。
2.健康过滤:将不健康的服务从候选集中剔除。
3.亲和性过滤:根据用户配置的亲和性规则,筛选当前请求匹配的后端服务,不符合的服务从后端集中剔除。
4.前缀匹配:当用户配置前缀匹配时,查询当前请求是否存在前缀匹配的后端服务,如果存在,则将其他服务从候选集中剔除。
5.加载负载指标:读取候选集中每个服务的 TTFT/E2E EWMA、running 和 pending 等负载指标。
6.准入规则 :对候选集中的服务进行准入规则验证,当有服务通过验证时,进行下一步多信号打分 ,将不满足要求的服务从候选集剔除;否则进入兜底或拒绝。
7.多信号打分 :根据打分规则,从候选集中选择最优的服务作为路由目标,并进入 完成与转发。
8.兜底或拒绝:当配置兜底服务时,将请求转发到兜底服务;当配置了过载拒绝时,返回 503,并提示服务端过载。
9.完成与转发:将请求转发的目标服务,并记录相关指标。
整体路由决策不是简单的轮询或按权重随机,而是"硬约束收敛候选池,实时状态进行软评分,前缀命中优先保持 KV Cache 亲和,失败域分层兜底"。
4.2.2 模型映射与统一入口
aitc-ai-lb 对客户端暴露统一的 model 名称,允许同一推理实例的多个后端服务使用不同的 upstream model。
▸请求转发时,插件会把客户端的 model 改写成目标服务所需的 model。
▸同一个 Higress 路由可以接入不同模型名、不同部署形态的服务,业务方无需感知后端命名差异。
4.2.3 多信号智能选路与过载保护
为了实现多信号智能选路与过载保护,普通请求在通过健康过滤和硬约束过滤后,会进入一个有序的策略链(policy chain)。每一条策略(policy)都包含以下四个步骤:
1.admission (准入) :根据 TTFT (Time To First Token,首字时延)、E2E (End-to-End latency,端到端时延)、running (当前在途请求数) 或 pending (排队请求数) 等指标阈值,剔除不满足准入条件的后端服务。特别地,当后端服务的 running 请求数低于配置的 prefer_serving_below (优选服务阈值) 时,该后端被视为"优选服务"(serving backend),即使其历史 TTFT 较高或超过 admission 阈值,也能够获得优先承接请求并豁免部分护栏限制,避免服务因历史指标不佳且长时间无流量而无法被访问。
2.rate limit / serving 预过滤:限制单个服务(service)在本 Gateway Pod 中 running 请求的占比,并在存在低负载的优选服务(serving backend)时,优先使用该子集进行选路。
3.多信号评分:对候选后端服务的各项指标进行 min-max 归一化处理,然后按各信号权重求和,再乘以服务自身的 service weight (服务权重) 计算分数。
4.选择与命中门槛:根据配置选择命中的后端服务
▸global_best 策略:选择得分最高的后端服务
▸p2c (Power of Two Choices) 策略:随机比较两个候选后端并选择其中最优者,以缓解突发流量下的羊群效应。
为了降低羊群效应,aitc-ai-lb 使用 Envoy SharedData 存储 running 和 pending 等实时负载指标,确保同一网关副本内的后续请求能快速感知到最新的负载情况。
4.2.4 前缀缓存机制
当开启前缀缓存机制后,插件将请求发送到前缀匹配的后端服务:
1.将请求前缀与后端绑定关系保存到 Redis。
2.当请求前缀命中时,将命中的后端作为唯一候选。
3.当请求前缀命中时,采用宽松的准入验证规则。
针对缓存命中的后端服务,不使用普通的准入验证规则,而使用更宽松的准入验证规则,设计上有两点考虑:
1.缓存命中时服务处理请求更快:命中请求不做全量 prefill,边际成本只有 decode,后端在同样负载下能比平时承接更多请求,阈值理应放宽(如 ttft_ms 可放宽到普通阈值的 2~3 倍);轻度超载时把请求改道到空闲后端做冷 prefill,反而比继续钉住更贵。
2.放宽不等于无底线:哪怕缓存全部命中,也不能把请求无限发到钉住的后端。负载超过"宽松准入验证规则"时,仍进入溢出路径,避免把单个后端持续打爆。
前缀缓存过期机制:
1.利用 redis 的 TTL 机制清理前缀缓存,当前缀匹配时,刷新 TTL。
2.如果前缀缓存命中的服务返回的 Response 异常时,插件自动清除该前缀缓存,避免异常响应被长期缓存。
4.2.5 请求特征亲和性路由
aitc-ai-lb 支持针对请求特征(例如 HTTP Header)的亲和性路由,允许用户根据请求特征来控制流量的走向,实现对目标服务选择的硬性过滤。当用户请求与亲和性规则规则匹配时,系统会将候选服务池收敛到符合条件的服务子集。
适用场景:
▸租户隔离: 确保特定租户的流量只路由到其专属的服务实例,实现资源隔离和数据安全。
▸应用或业务流量隔离: 将不同应用或业务模块的请求分发到各自独立的服务,避免相互影响,提高稳定性。
▸A/B测试或灰度发布: 根据请求中的特定标识(如用户ID、版本号)将一部分流量路由到新版本服务进行测试,而大部分流量仍指向稳定版本。
▸多活或灾备: 在多数据中心部署时,根据用户地域信息将请求路由到最近或指定的可用数据中心。
通过这种方式,即使在复杂的服务拓扑中,用户也能灵活地根据业务需求,通过请求特征主动选择最合适的服务,从而提升系统灵活性、可维护性和资源利用效率。当过滤导致没有符合条件的服务时,系统会优先采取兜底策略,而不是直接拒绝请求,以保障服务的可用性。
4.2.6 健康监测与故障自愈
插件支持维护后端健康状态:
▸当请求多次返回配置的 4xx/5xx 状态时,健康管理器累计失败并可将后端移出健康集合;
▸插件使用 envoy 的 tick 机制,定时对 unavailable 后端发送探测请求,连续成功达到阈值后恢复健康状态。
4.2.7 故障容忍、过载保护
当没有符合条件的服务时,插件会根据配置策略进行处理:
1.兜底策略:fail-open 为原则。 当主候选池无健康后端、selector 筛选为空、Redis 读取失败或 policy 链未命中时,插件按失败原因分级兜底,默认不中断请求:
▸切换 fallback_services: 配置了兜底服务时,从兜底服务池重新选择目标并转发;
▸按权重百分比分发: 未配置兜底服务时,在预设服务间按权重比例分流;
2.过载拒绝:fail-fast 为例外。 仅在"所有候选后端均已超过硬阈值、且指标数据可信"的明确过载场景下快速失败,返回 429(如需 503 请确认代码是否实现,当前仅见 429)。对健康状态缺失、Redis 不可用等基础设施异常一律 fail-open,避免控制面或状态存储故障扩散为入口服务中断。
4.3.8 可观测性
提供下列监控信息,保证选路全链路可追踪,可查看服务的流量分布、ttft 等指标:
▸选路日志: 每次成功选路记录影响选路的策略、目标服务、upstream model 及是否触发 fallback;前缀命中时记录命中后端与前缀 hash;触发 fallback 时记录候选后端的指标快照,便于事后归因。
▸指标: 提供 Prometheus metrics 指标,覆盖 running/pending、TTFT、E2E、请求状态码、后端健康状态、前缀命中/溢出/清除及 Redis 延迟等维度。
五、二级网关:官方局限与自研策略
二级网关选用的是 vLLM 官方的 vllm-router:一个部署在每个推理实例前面的轻量路由层,我们配置其通过 K8s label selector 发现该实例下的 worker Pod,在它们之间分发请求。选它的原因很直接------我们的推理服务大多跑在 vLLM 上,vllm-router 能直接复用这套生态,自带服务发现、健康检查和 Prefill/Decode 分离调度,不需要从零造轮子。
但 vllm-router 的官方版本维护较慢,它的负载统计方式和路由策略在我们的生产场景下暴露出问题。所以我们维护了自己的分支,针对选路和负载计数做了改动。
5.1 原 vllm-router 的不足
官方路由策略里,与负载感知相关的是 power_of_two:随机抽两台 worker,把请求发给负载更低的那台。配置实践和源码核对下来,这个策略在我们这边不可靠,问题有两个。
不足一:策略与场景不符。 推理场景里,worker 数量有限,扫一遍全局负载几乎没有成本。power_of_two 却只随机抽两台再二选一:已经明显过载的 worker 仍可能进候选;随机抽样本是为了在大规模集群里省掉全量比较,放到我们的规模上。
不足二:负载指标不可信。 power_of_two 的负载来自 worker 上报的 /get_load:部分部署形态根本拿不到;PD 分离时,「上报值」和 router 实际转发的在途请求也对不上。router 自己计数的那条路更糟:+1/-1 靠手工配对,仅 PD 路径上就有 20 多个调用点,散落在错误分支和流式闭包里。任何一条 early-return、客户端断连、任务取消漏掉 -1,那台 worker 的计数就永久偏高------只增不减,永远排在最后,再也拿不到流量。进程不重启不会恢复,从外面也看不出来,只是那台 worker 一直很闲。
5.2 路由策略改动总览
对着 5.1 的两个不足,一项换选路策略,一项把负载数字做可信:
| 改动 | 对着哪条不足 | 做法 |
|---|---|---|
| 新策略 soft_k_choice | 不足一:power_of_two 随机抽两台,过载 worker 仍可能进候选 | 先取全局负载最低的 k 台,再在 k 台里按 in-flight 加权随机;k=1 退化为 least-loaded |
| in-flight 计数重构 | 不足二:手工 +1/-1 泄漏后计数永久偏高 | RAII guard 随请求生命周期自动扣减;时间桶到期剪枝,泄漏最多残留一个 TTL |
两项合在一起才是「可信负载 + 分散选路」:没有可信的 in-flight,任何负载感知策略都没有意义。
5.3 改动的技术详细介绍
5.3.1 选路策略 soft_k_choice
思路是先收敛候选、再软选择:router 自己维护精确的 in-flight 计数作为负载,选路时先取全局负载最低的 k 台,再在这 k 台里按 in-flight 加权随机挑一台(负载越低权重越高)。通过增加随机性,使流量可能被分配到多个 worker 上,而不是永远选择最好的那个,可以缓解羊群效应。
与 power_of_two 的两处本质差别:
1.候选集不同:是全局负载最低的 k 台,不是随机抽的两台样本,不会把已经明显过载的 worker 抽进候选。
2.最后一跳不同:是加权随机而非必选更优。同一瞬间并发进来的请求看到的是同一张 top-k 快照,但最终选择是随机的,天然在 k 台上散开,羊群效应被消解在最后一跳。
k 默认 2,取 1 时退化为严格的 least-loaded。PD 部署可以给 prefill 和 decode 分别指定策略。Prometheus 的 vllm_router_running_requests 指标跟随该策略的 in-flight,负载变化对外可见。
5.3.2 in-flight 精确计数:RAII guard 与时间桶自愈
这是让负载数字可信的根基,分两层做。
第一层:RAII guard 杜绝漏减。 计数不再依赖手工配对的 +1/-1 回调。请求占用 worker 时 acquire 一个 guard,guard 被销毁时自动 -1:非流式请求随函数返回销毁,流式请求被 move 进转发闭包,流正常结束、中途出错、客户端断连都会触发销毁。PD 路径上原来散落的 20 多处手工调用点全部删除,prefill 和 decode 两阶段各持有一个 guard;重试循环里每次 attempt 独立持有 guard,不存在某次重试漏减的可能。释放的正确性由语言机制保证,不再依赖人在每条分支上记得调用。
第二层:时间桶兜底自愈。 guard 仍可能泄漏------比如被意外塞进一个永不结束的任务。所以计数不是一个简单整数,而是按时间分桶:每个 worker 的 in-flight 按固定桶宽(默认 5 秒)分桶记录,acquire 记在当前桶,release 精确扣回原桶;超过存活时长(TTL,默认 600 秒)的桶被整体剪掉,泄漏的那一份计数随所在桶到期自动归零,最多残留一个 TTL,不需要重启进程。选路读的是所有存活桶的聚合值,惰性剪枝保证热路径开销可忽略。时间源使用单调时钟而非系统时间,避免 NTP 回拨把所有桶一次误判过期。
可观测性配套。 剪枝时如果剪掉的桶计数不为零,会打一条带 worker 地址和被剪数量的 warn 日志。正常情况下桶到期时应该已空,剪掉非零只有两种可能:确实发生了泄漏,或有请求跑满了整个 TTL。这是唯一能证明「泄漏发生过」的证据------自愈之后其他一切看起来都正常。Prometheus gauge 在剪枝后也会补发一次,否则指标会停在泄漏的高值上。
5.3.3 效果对比
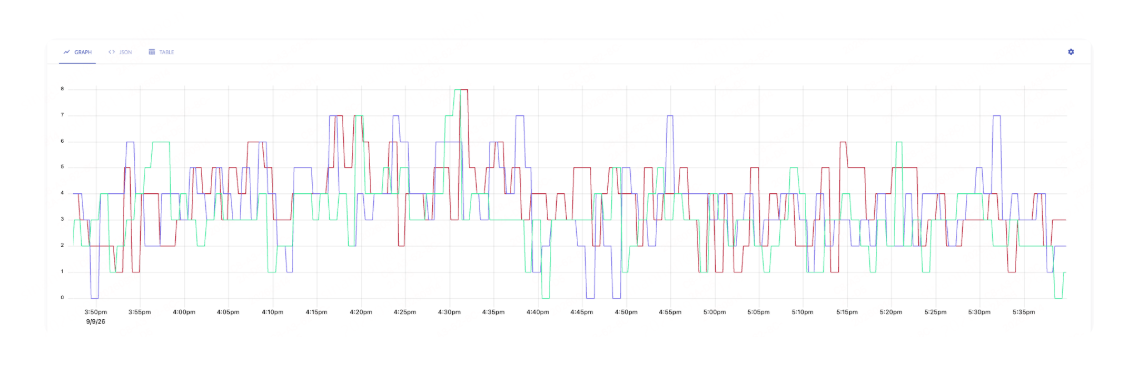
下面是 power_of_two 与 soft_k_choice 策略的测试对比,图中展示 works 处理的请求数量
1.soft_k_choice 在流量较高时,多个 works 处理的请求数量
2.power_of_two 在流量较高时,多个 works 处理的请求数量
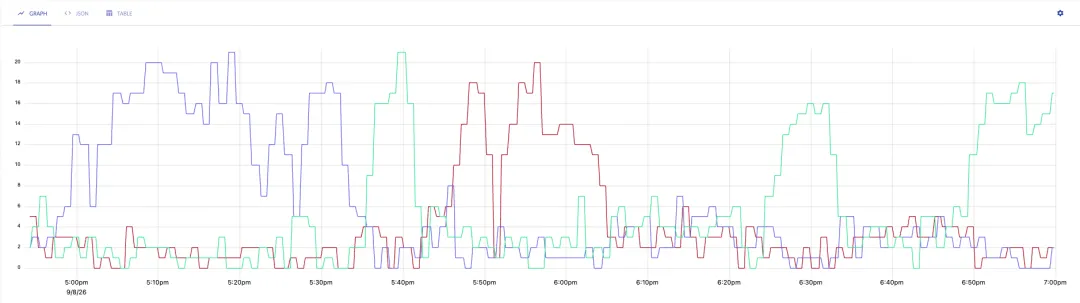
对比结果: soft_k_choice 策略下,多个 works 的负载更均衡。
六、总结
这套推理网关采用两级选路架构,并已在生产环境稳定运行。其核心价值体现在以下三个方面:
1.降低系统复杂度。 一级负责跨集群的实例选择,二级负责实例内的副本选择。清晰的职责边界将复杂问题拆分到不同层级,降低了开发难度和配置复杂度,也便于各层独立发布与演进。
2.承载较高流量。 该方案能够稳定处理百万级日请求量,并适配耗时较长的流式推理请求。
3.选路策略贴合推理场景。 一级综合模型约束、实时负载、前缀亲和与过载状态选择实例;二级根据 worker 负载筛选低负载候选,再通过加权随机分散并发请求。两级策略既能提高 KV cache 利用率,又能避免流量集中到少数实例或副本,使高流量下的负载分布更加均衡。