什么是文本格式知识库?
文本格式知识库是百数知识库四类里最常用的一种,专门存放纯文档类资料:操作手册、管理制度、产品说明、FAQ、Markdown、PDF 等。上传后系统自动做文本分段和向量化,智能体被问到相关问题时,按语义检索原文片段来回答,是 RAG 落地的主力类型。
什么时候选文本知识库,而不是其他类型?
| 资料长什么样 | 该选哪种知识库 |
|---|---|
| 大段文字:手册、制度、FAQ、说明文档 | 文本格式(本篇) |
| 行列表格:价格表、参数表、台账 | 表格格式(支持 NL2SQL 查行) |
| 截图、拍照件、扫描件 | 照片格式(走 OCR) |
| 已经在百数表单里跑的业务数据 | 表单格式 |
功能说明
文本格式适用于各类文档资料,例如操作手册、管理制度、说明文档、Markdown、PDF 等,支持上传 PDF、TXT、MD、Word 等文本类文件。系统会自动完成文本分段与向量化处理,支持长篇资料检索,智能体可直接调取原文内容,是最常用的知识库类型。
创建流程
创建完 文本格式 的知识库后,进入知识库详情页,添加内容。
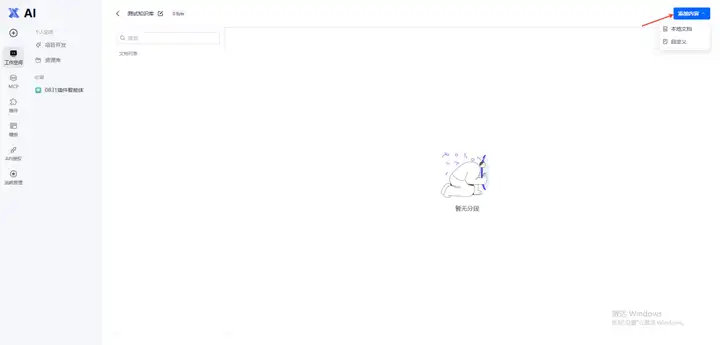
支持2种方式:本地文档和自定义。
两种添加方式怎么选?
| 对比项 | 本地文档 | 自定义(在线填写) |
|---|---|---|
| 数据来源 | PDF/TXT/DOCX/MD 文件 | 直接在网页里粘贴/输入文字 |
| 适合场景 | 已有成型文档、批量上传手册 | 几条 FAQ、临时小知识、快速测试效果 |
| 单条规模 | 大,最多 300 文件 / 单文件 100MB | 小,适合几百到几千字的片段 |
| 维护成本 | 改文档后重新上传 | 直接在线改 |
本地文档方式
是将电脑本地文档导入知识库。
创建步骤如下:
1)上传文件,支持 PDF、TXT、DOCX、MD,最多可上传 300 个文件,每个文件不超过 100MB,PDF 最多 500 页。
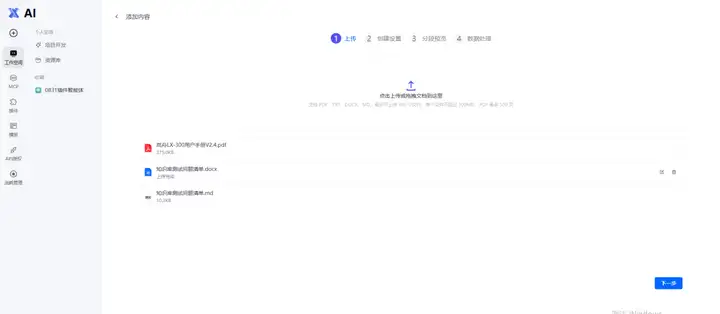
2)创建设置:
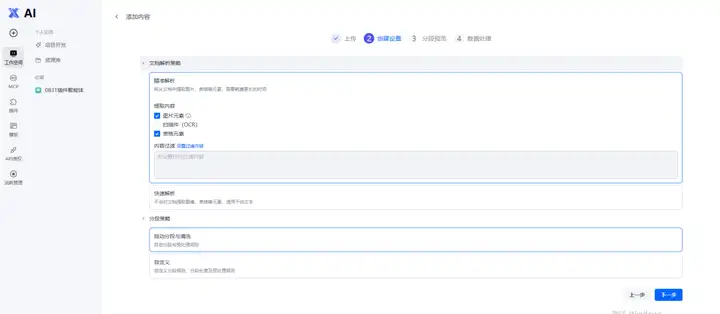
- 文档解析策略 :文档解析策略用于控制上传文档时的内容提取规则,定义系统如何识别文档内各类元素。精准解析模式可提取文档中的图片、表格等内容;也可按需开启扫描件 OCR 识别,同时支持配置内容过滤,剔除页眉、页脚等无效信息。
- 分段策略 :分段策略就是把长文档切成一段一段的文本切片,保证每一段内容意思完整,这样智能体检索的时候,更容易找到匹配内容。你可以选择系统自动切分清洗,也可以自己设置分段规则。
- 自动分段与清洗:系统按内置规则自动切分文本,并清理多余空行、无效符号等噪声内容,普通文档直接选用即可。
- 自定义:手动配置分段长度、分隔符与清洗规则,针对业务手册、技术文档等特殊材料精细化调整。
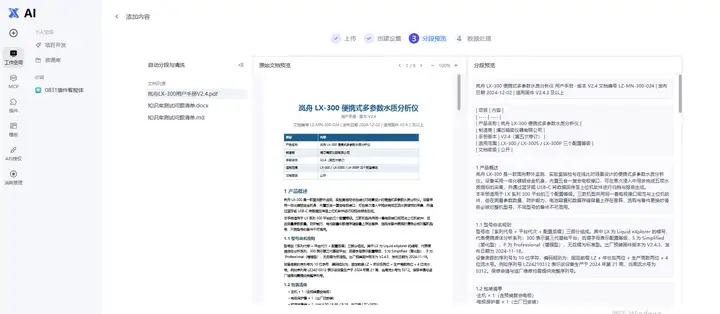
3)分段预览:用于查看文档经过文档解析、分段策略处理后切分出来的文本切片。可以直观校验切片效果,检查是否存在内容截断、语义断裂、乱码、冗余内容等问题。如果分段效果不佳,可返回修改分段策略或文档解析规则,重新处理文档,避免后续智能体检索匹配不准。
4)数据处理:系统按照预设分段规则解析文档,完成文本切片与向量化,处理完毕后文档才存入知识库,可供智能体检索调用。
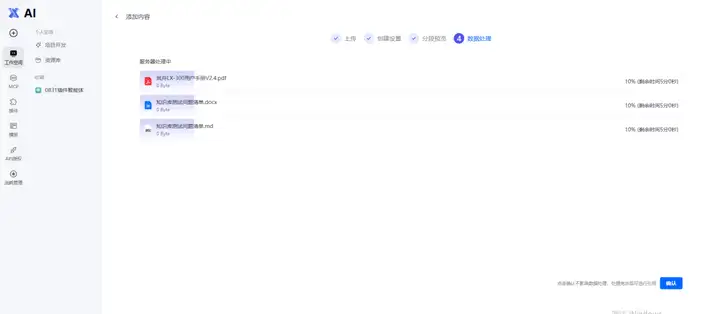
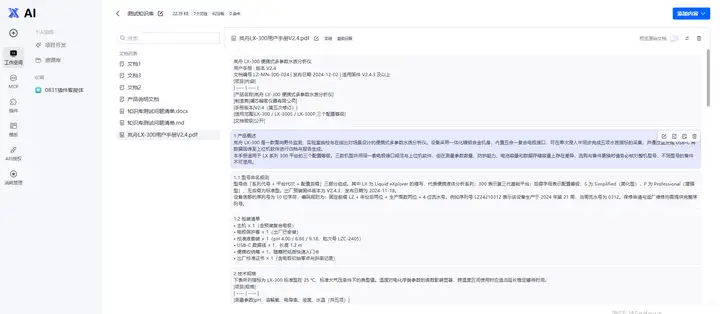
5)内容预览:用于查看文档经过分段、清洗之后的切片结果。可以直观核对文本拆分效果,检查是否存在内容丢失、分段不合理、乱码等问题,提前发现并优化知识库素材,避免后续智能体检索匹配异常。
自定义方式
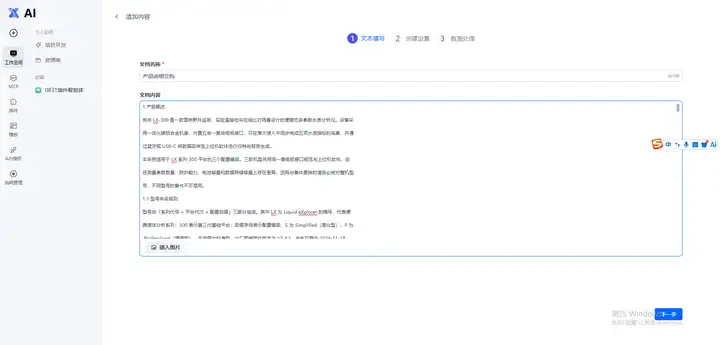
内容页面填写,创建步骤如下:
1)文本填写:填写文档内容和文档内容。
自定义方式特别适合:
-
临时验证效果:先粘贴几条 FAQ 试试智能体答得准不准,不用真的上传大文件;
-
零散小知识:一条常见问题、一段口径话术;
-
多轮迭代:在线改完立刻重新处理,比来回传文件快。
2)创建设置:
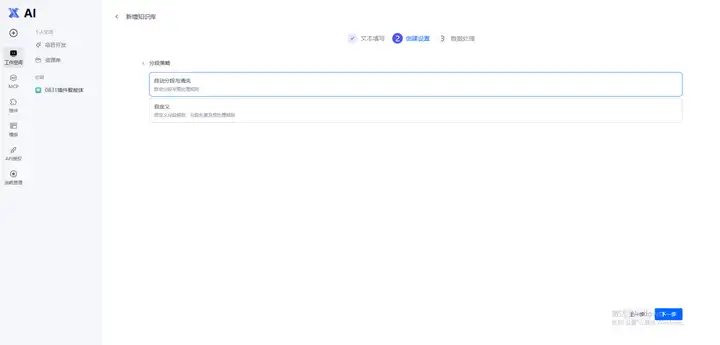
分段策略就是把长文档切成一段一段的文本切片,保证每一段内容意思完整,这样智能体检索的时候,更容易找到匹配内容。你可以选择系统自动切分清洗,也可以自己设置分段规则。
- 自动分段与清洗:系统按内置规则自动切分文本,并清理多余空行、无效符号等噪声内容,普通文档直接选用即可。
- 自定义:手动配置分段长度、分隔符与清洗规则,针对业务手册、技术文档等特殊材料精细化调整。
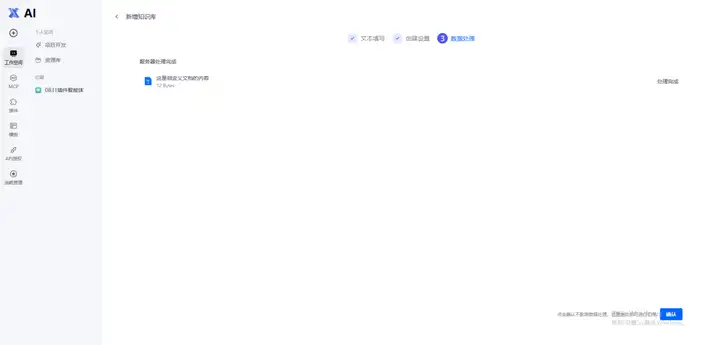
3)数据处理:系统按照预设分段规则解析文档,完成文本切片与向量化,处理完毕后文档才存入知识库,可供智能体检索调用。
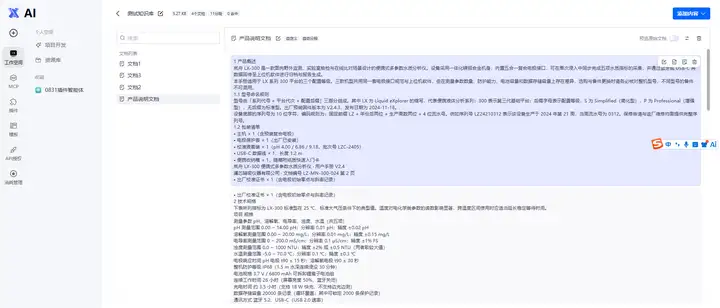
4)内容预览:用于查看文档经过分段、清洗之后的切片结果。可以直观核对文本拆分效果,检查是否存在内容丢失、分段不合理、乱码等问题,提前发现并优化知识库素材,避免后续智能体检索匹配异常。
常见问题 FAQ
Q1:文本知识库支持哪些格式?最多传多少?
A:支持 PDF / TXT / DOCX / MD;最多 300 个文件,单文件 ≤100MB,PDF ≤500 页。扫描版 PDF 记得在解析策略里开 OCR。
Q2:自动分段和自定义分段什么时候用哪个?
A:普通文档直接用自动分段+清洗,省心;业务手册、技术文档、结构特殊的材料用自定义,手动调分段长度和分隔符。改完一定看分段预览。
Q3:分段预览里发现内容被切散了怎么办?
A:回去调分段长度(调大)或指定分隔符(如按标题、按句号切),重新处理后再看预览,直到一个完整知识点落在同一片里。
Q4:本地文档和自定义内容能混在一个文本知识库里吗?
A:可以。两者都进入同一个知识库,系统统一切片和向量化,检索时一起参与召回。
Q5:为什么要有「分段预览」和「内容预览」两步?
A:分段预览看切片切得对不对(结构层);内容预览看清洗后最终长什么样(效果层)。两道都过,入库后召回才稳。
Q6:文档里的表格、图片能被检索到吗?
A:开启精准解析模式后可以提取文档中的表格和图片内容;纯图片里的文字需另开 OCR。
上线前检查清单
□ 资料确实是文档类,没有误传表格/截图?
□ 扫描件是否开了 OCR?
□ 分段预览里切片是否语义完整、无截断?
□ 内容预览里是否无乱码、无页眉页脚等噪声?
□ 大文件是否控制在 100MB / PDF 500 页以内?
核心概念术语表
| 术语 | 一句话解释 |
|---|---|
| 文本知识库 | 存放手册/制度/FAQ 等纯文档资料的知识库类型 |
| 本地文档导入 | 从本地上传 PDF/TXT/DOCX/MD 文件入库 |
| 自定义录入 | 直接在网页粘贴文字,适合小片段和快速测试 |
| 文档解析策略 | 控制如何从文件里提取文字、表格、图片 |
| 精准解析 | 可识别文档内表格和图片的解析模式 |
| OCR | 把扫描件/图片里的文字识别成可检索文本 |
| 分段策略 | 把长文档切成一段段的规则 |
| 自动分段清洗 | 系统自动切分并清理空行、噪声,适合普通文档 |
| 分段预览 | 切片后的检查视图,确认没有切散语义 |
| 向量化 | 把文本转成向量,供语义检索使用 |
| 内容预览 | 清洗后最终入库内容的检查视图 |
元信息
适用产品:百数AI 知识库 / 文本格式|支持格式 PDF/TXT/DOCX/MD|单库上限 300 文件 / 单文件 100MB|文档更新时间:2026-09