目录标题
Boosting:
核心思想:它采用加法模型和前向分步算法,每一步都针对前一步的错误进行修正,不断提升整体预测能力
常见算法:包括 AdaBoost(权重Boosting)和 GBDT、XGBoost、LightGBM(梯度Boosting)等
一、思想和概念
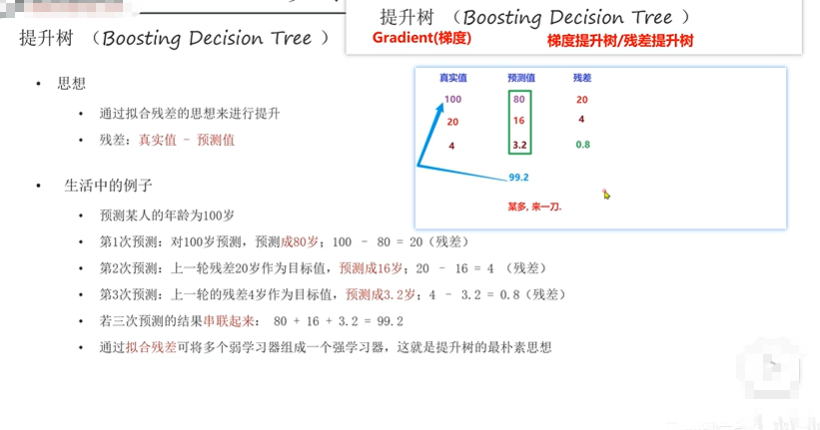
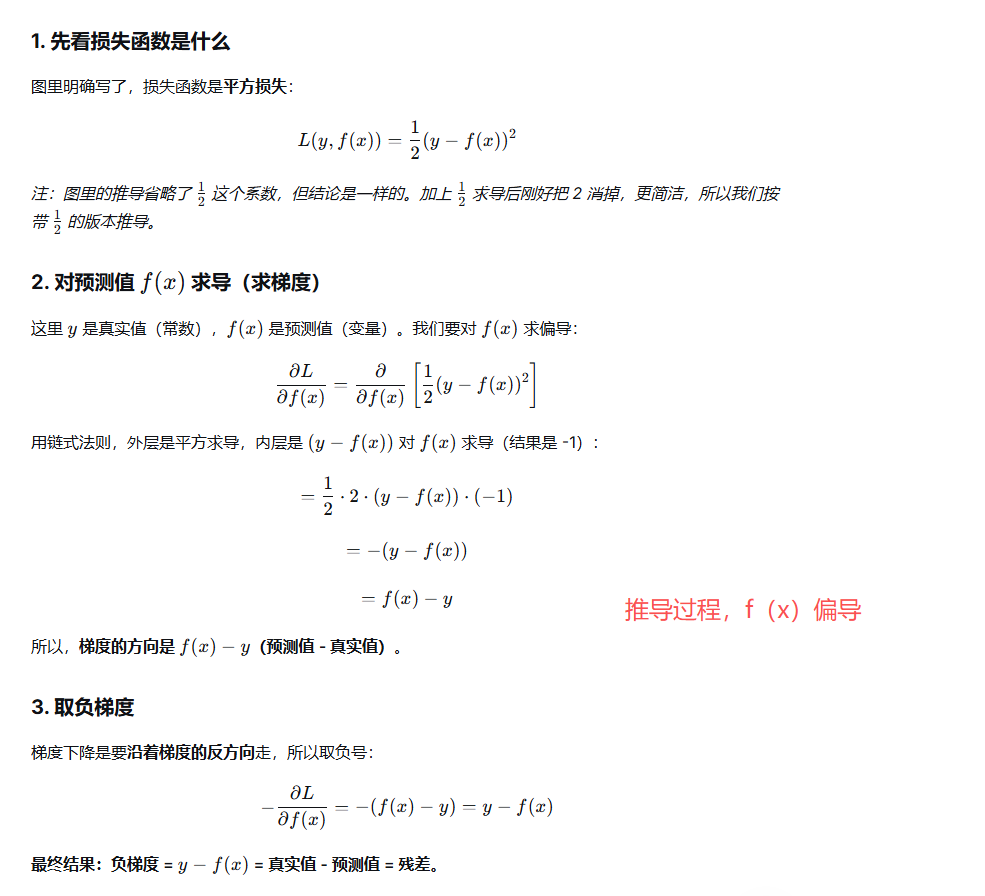
二、推导为啥负梯度就是残差
先区别 平方损失,损失函数,最小二乘
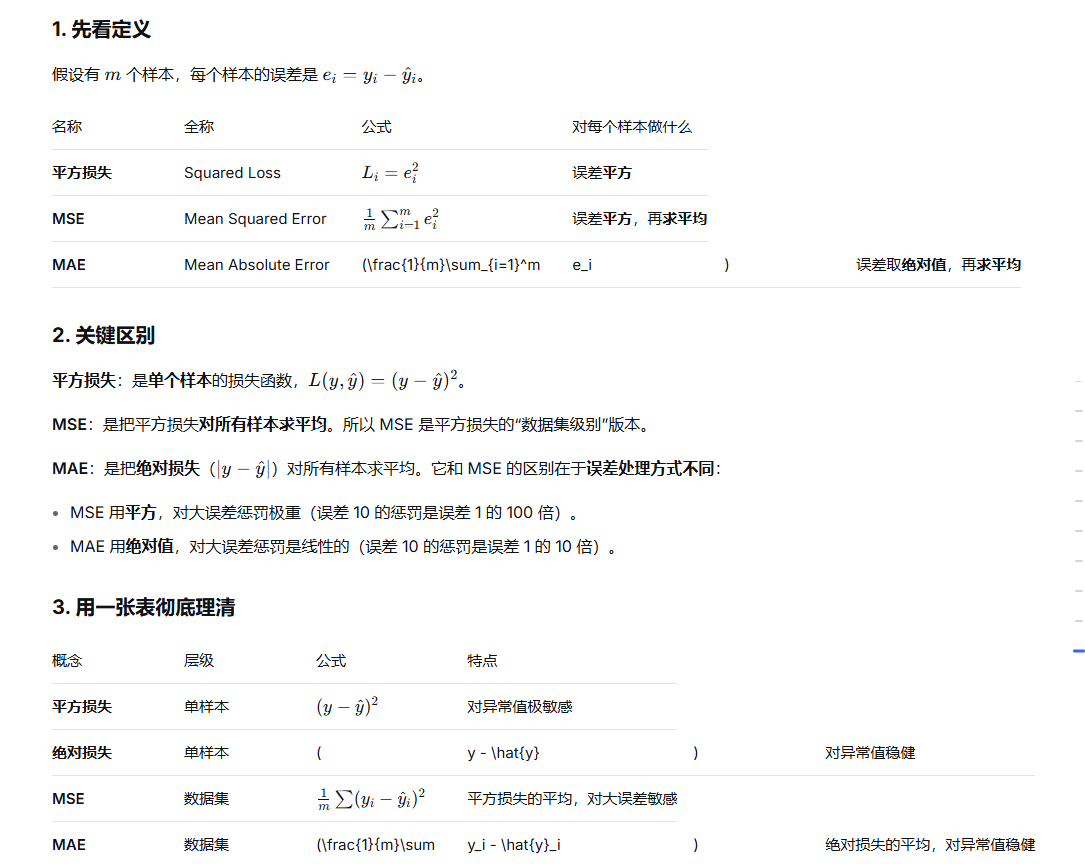
损失函数: MSE , MAE ,还有一个开MSE根号得RMSE
平方损失是单个样本的损失函数
平方损失 和损失函数 对比
平方损失 和 最小二乘 对比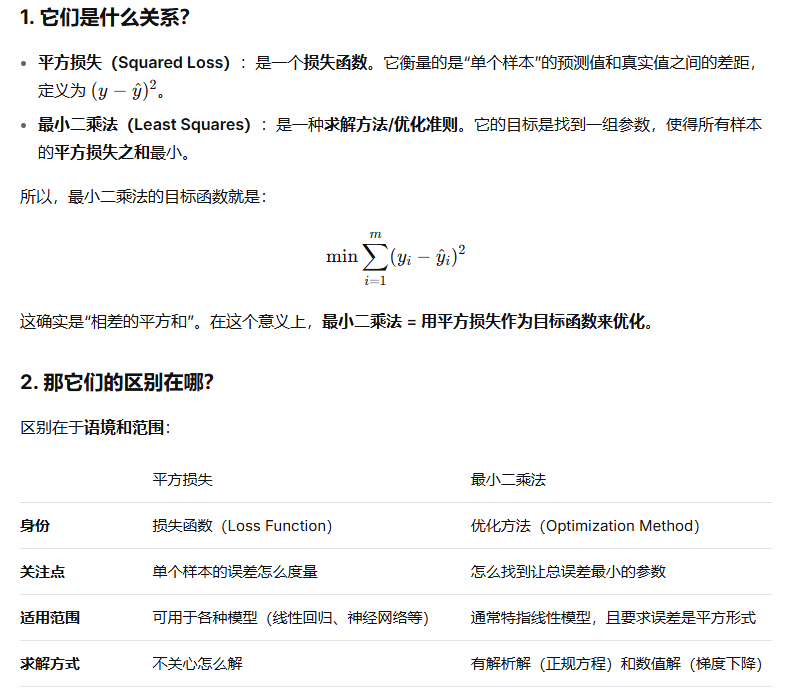
下面这个推导没看明白,重新问ai才看明白推导
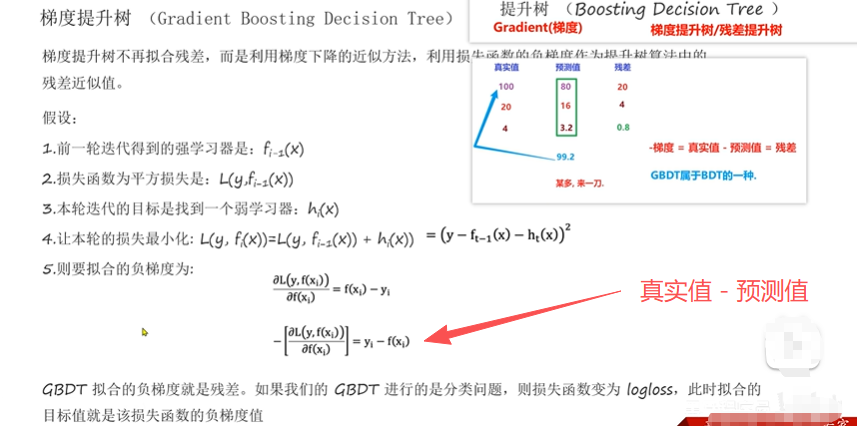
看了下面这个推导才知道为啥负梯度是真实值减去预测值 (下面这只是单个样本,只是GBDT实战只是多了 ∑ i = 1 n \sum_{i=1}^{n} i=1∑n)
三、GBDT实战推导
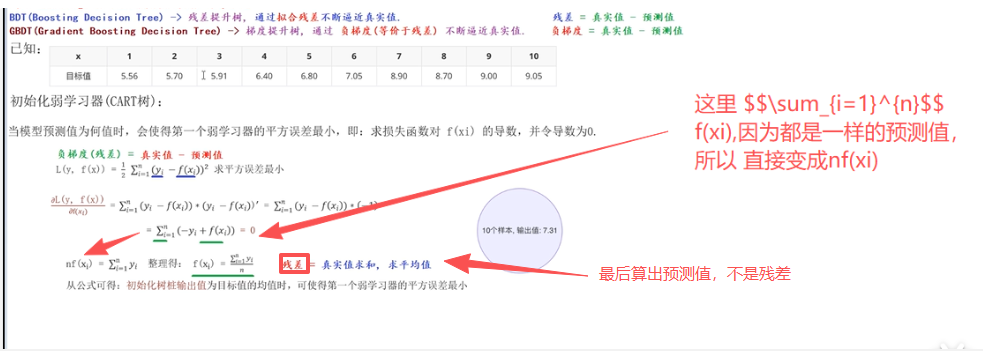
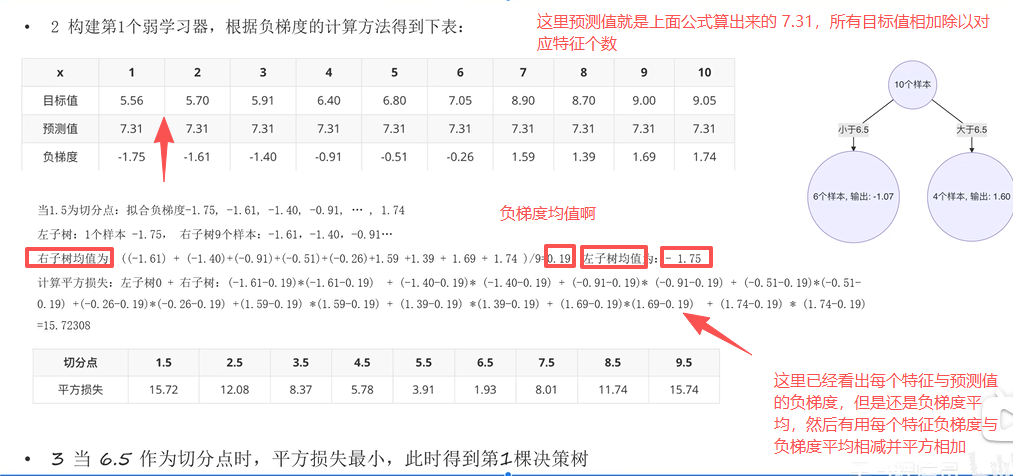
开始构建第一个弱学习器
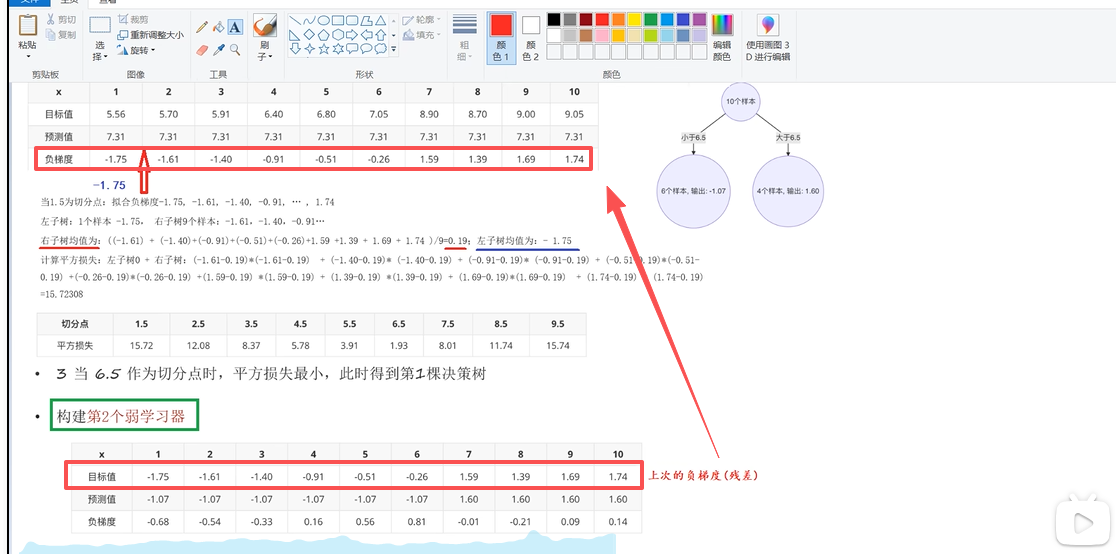
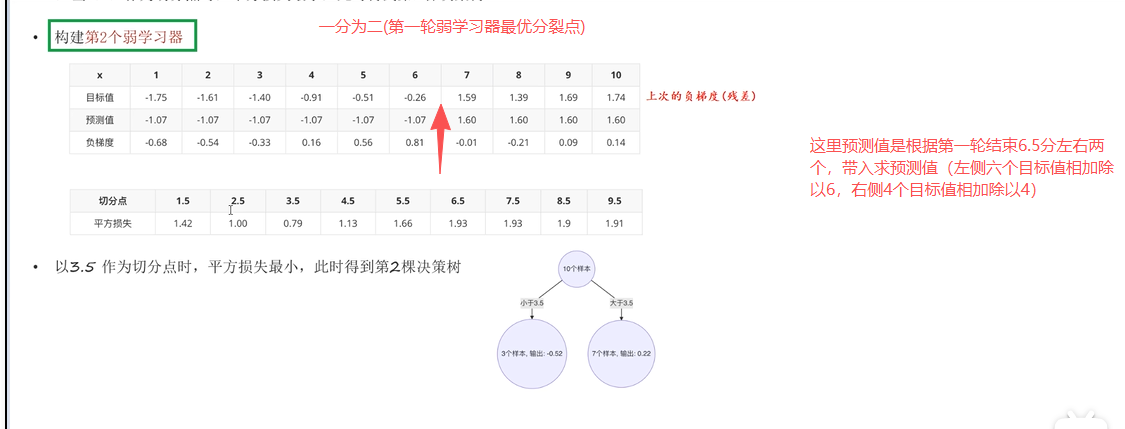
开始构建第二个弱学习器
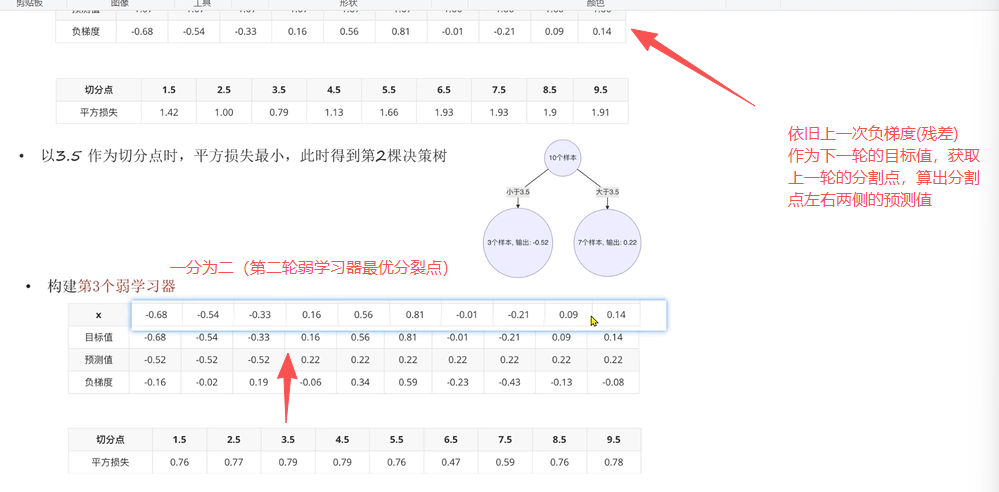
一轮算出预测值,从而就算出负梯度。这个负梯度就是第二轮的目标值,但是光负梯度还不够,还要找分割点。(算出分割点左右的平均负梯度,让当前弱机器学习返回负梯度即参照更准确点)
(用到上一轮的负梯度和最优分割点,从而根据分割点求出左右两侧的预测值,算出负梯度。重复左右负梯度均值,算平方损失,找到第二个弱学习器最优分割点)
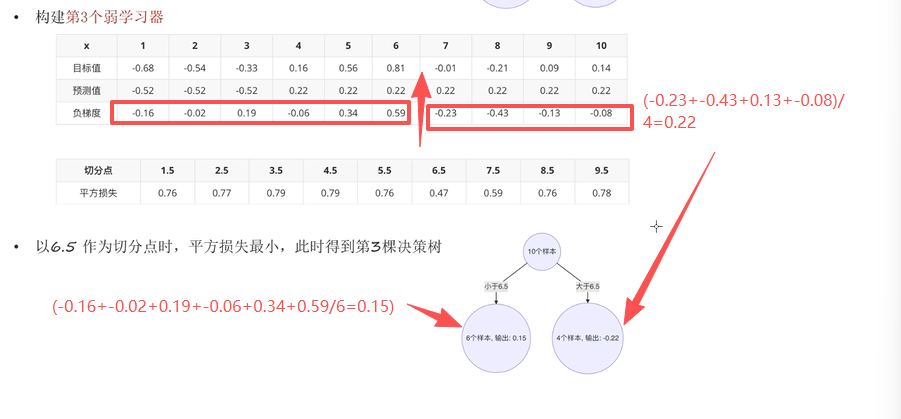
开始构建第三个弱学习器(重复第二轮步骤)
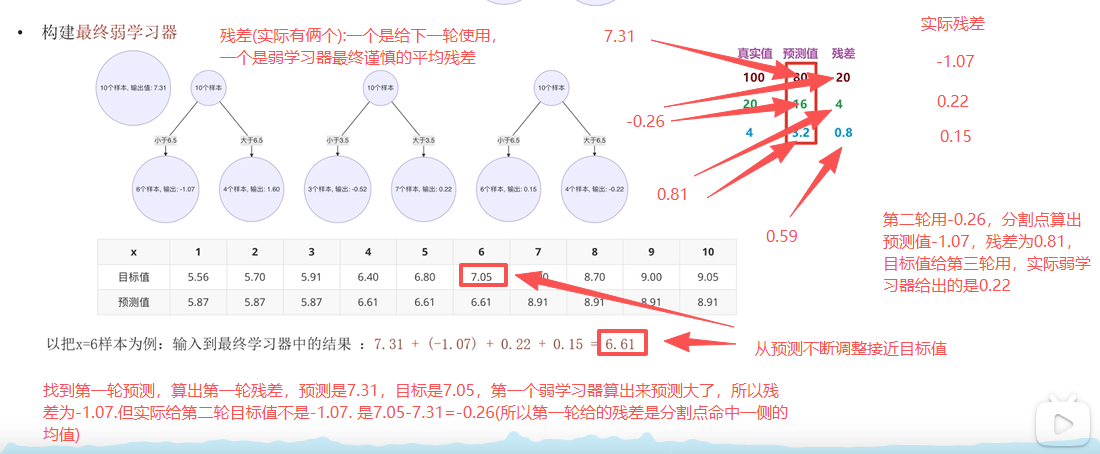
四、残差给下一轮和实际弱学习器计算的值不一致我能理解,但是为啥还要给下一轮分割点呢
残差只是一个粗糙的"纠错信号":
第一轮预测值全是 7.31,目标值有高有低(5.56 到 9.05)。这时算出来的负梯度(残差)是 -1.75、-1.61 ... 1.74。这个残差告诉你"每个样本该往哪调".
把样本按特征 x 排序,找一个切分点(比如 6.5),把样本分成左右两组。然后分别计算左右两组的"平均残差",用这两个平均值去代替原本每个样本各自的残差。(这就是项目里:弱学习器实际返回的残差)
为什么这么做?为啥需要这个最优分割点
因为决策树(CART)不是线性模型,它不能给每个样本一个独立的预测值,它只能给"落在同一片叶子里的样本"一个相同的输出值。所以 GBDT 必须把样本分组,然后给每组算一个"代表值"。这个"代表值"就是该组残差的均值,它是对该组所有样本"最优的纠错力度"。