机器人学习领域一直有个核心难题,如何在不依赖大量真实机器人rollout的情况下,判断通用机器人策略是否真正理解了指令,并进一步利用这些经验提升策略在陌生物体和新任务上的表现。真实世界中的策略评估通常需要反复执行任务,研究者不仅要准备不同的物体、场景和相机位置,还需要通过多次实验获得具有统计意义的结果。当策略在某类任务上失败时,后续改进往往还需要重新采集专家示范数据。这个过程成本较高,也限制了通用机器人策略的迭代速度。近期,来自斯坦福大学和清华大学的研究团队在ICLR 2026上提出Ctrl-World,一种面向机器人操作的可控多视角生成式世界模型。论文将预训练视频扩散模型改造成能够理解机器人动作、预测未来视觉状态并与VLA策略闭环交互的世界模型。研究发现,Ctrl-World可以在想象空间中生成长时序机器人操作轨迹,用于评估策略的指令跟随能力,也可以筛选成功轨迹并将其用于策略后训练。
论文链接:https://arxiv.org/abs/2510.10125
代码链接:https://ctrl-world.github.io
本文作者邓镝,审校韩煦。
一、研究背景
现代通用机器人策略通常根据多视角观测和语言指令输出一段动作序列。尽管视觉语言动作模型已经能够处理多种操作任务,但当物体、场景、相机位置或语言指令发生变化时,策略仍然可能表现脆弱。评估通用策略通常需要在不同任务和环境中进行大量真实世界rollout,以获得具有统计意义的结果。这类评估过程需要重复执行任务,会降低策略迭代速度。另一方面,当评估发现策略存在不足时,现有方法通常还需要重新采集专家数据,才能针对失败案例进行改进。这里的rollout指从一个初始观测开始,由策略连续输出动作并逐步生成后续状态的完整运行过程。
学习一个预测模型并在想象空间中迭代,是一种具有扩展性的替代方案。给定当前观测和动作,世界模型可以预测未来观测,策略再根据预测结果输出下一段动作。然而,已有动作条件世界模型主要关注被动视频预测,难以支持现代通用策略的策略在环交互。
论文指出,现有方法通常只模拟单一第三人称相机,容易受到部分可观测影响,并在接触密集型操作中产生幻觉。它们还缺少捕捉高频动作因果影响所需的细粒度控制能力,同时难以在长时序视频生成中维持时间一致性。
因此,Ctrl-World的目标是构建一个能够支持多视角预测、细粒度动作控制和长时序一致性的世界模型,并使通用机器人策略可以在想象空间中完成多步交互。
论文的核心设计包括三个部分。多视角联合预测用于生成包括腕部相机在内的多个视角,帧级动作条件用于将视觉动态与控制信号对齐,记忆检索则通过加入稀疏历史帧并向对应帧中投影机器人位姿,使模型能够关注过去的相似状态。作者据此将预训练的被动视频生成模型适配为兼容策略交互的模拟器。
二、研究方法
1. 闭环交互过程
机器人观测包括多个相机视角和机器人位姿,策略根据当前观测与语言指令输出一段动作序列,世界模型根据当前观测和动作序列生成未来的多视角观测。随后,将最终预测观测返回给策略,策略再产生下一段动作。通过这种自回归方式,策略和世界模型可以完全在想象空间中交互,形成长时序rollout。
2. 预训练视频扩散主干
Ctrl-World从带有时空Transformer的预训练视频扩散主干初始化。具体来说,作者使用预训练的1.5B Stable Video Diffusion模型,并保留预训练视频模型中的参数和结构。
为了继承预训练视频模型已有的知识,作者只新初始化了一个用于输入动作的MLP神经网络,其他参数在初始化时保持不变。之后,模型使用扩散损失进行微调。
训练时,未来视频作为预测目标,并在扩散步骤中加入高斯噪声。模型输入由历史帧、带噪的未来帧以及机器人位姿和动作条件组成,模型学习预测原始未来视频。
3. 多视角联合预测
现代VLA模型通常使用多个第三人称相机获取全局信息,并使用腕部相机观察精细操作。因此,世界模型需要在每个时间步生成空间上一致的多视角预测。
Ctrl-World将多个输入图像沿token维度拼接,并联合预测所有相机视角。联合预测使模型能够同时利用第三人称视角和腕部视角的信息。论文实验显示,多视角联合预测可以改善一致性,并显著减少视觉幻觉。
图1展示了Ctrl-World的整体用途。模型生成包括腕部视角在内的多视角预测,通过帧级条件实现细粒度动作控制,并通过位姿条件记忆检索维持长时序动态。
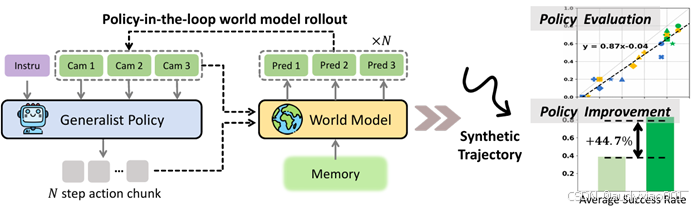
图 1 Ctrl-World 面向通用机器人策略的策略在环rollout ,结合多视角联合预测、帧级动作条件和位姿条件记忆检索,用于想象空间中的策略评估与合成数据生成。
4. 位姿条件记忆检索
世界模型的预测误差会随着rollout时间增长而不断累积,最终导致状态漂移和生成结果不连贯。为缓解这一问题,Ctrl-World在输入中加入历史帧。
模型以一定间隔采样多个个历史帧,并将相应的机器人手臂位姿通过空间Transformer嵌入这些帧。这样,模型可以根据机器人手臂位姿识别历史中的相关帧,并将未来预测重新锚定到相似的历史状态。
图2展示了这一机制在腕部相机预测中的作用。由于腕部相机在同一条轨迹中的视野变化较大,模型需要利用其他相机视角和历史帧,生成一致的腕部视角预测。
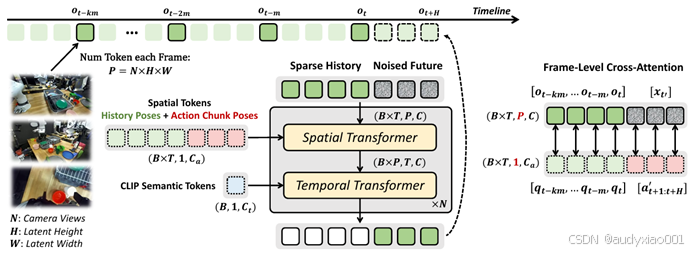
图 2 Ctrl-World 以预训练视频扩散模型为基础,通过三项改进成为可控、时间一致的世界模型:(1 )多视角输入与联合预测,实现统一的信息理解;(2 )记忆检索机制,向上下文中加入稀疏历史帧,并通过帧级交叉注意力将位姿信息映射到每一帧,使预测锚定到相似的历史状态;(3 )帧级动作条件化,更好地对齐高频动作与视觉动态。
5. 帧级动作条件
预训练视频模型只根据文本和图像进行条件控制,这限制了模型的控制精度。为实现可控生成,Ctrl-World进一步使用策略输出的动作序列作为条件。
作者将动作序列转换为笛卡尔空间中的机器人手臂位姿,并与历史位姿连接起来。随后,空间Transformer使每个时间步的视觉token关注对应的位姿嵌入。
对于历史帧,位姿条件来自历史机器人位姿。对于未来帧,位姿条件来自策略输出动作转换得到的未来位姿。这样,视觉动态可以与具体时间步的动作建立对应关系。
图3展示了不同动作序列在Ctrl-World中产生的不同rollout。论文指出,即使动作之间只相差几厘米,模型也可以生成不同的未来预测。移除帧级位姿条件后,模型的控制精度会下降。
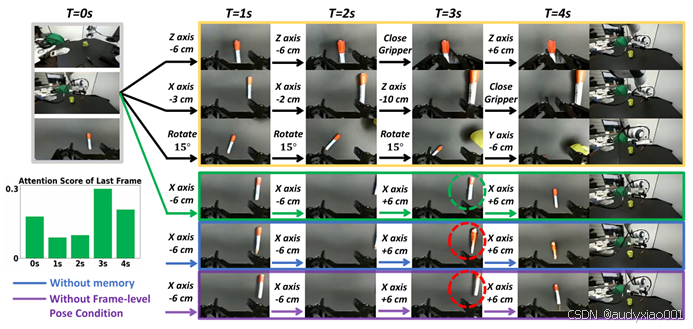
图 3 不同动作序列在Ctrl-World 中产生不同的未来轨迹。移除记忆机制会导致预测模糊,移除帧级位姿条件会降低控制精度。
三、实验设置
论文围绕三个问题开展实验。第一,Ctrl-World能否生成具有空间一致性和时间一致性的长时序轨迹,并保持较高的可控性。第二,Ctrl-World能否在想象空间中评估不同通用机器人策略,并复现它们在真实世界中的性能排序。第三,Ctrl-World能否通过发现和合成成功轨迹,改进策略的指令跟随能力。
实验使用DROID平台。该平台包括一台Panda机器人和Robotiq Gripper,配备一个腕部相机以及两个随机放置的第三人称相机。DROID数据集包含95,599条来自564个场景的轨迹,其中约76,000条成功轨迹和约19,000条失败轨迹。
训练时,模型联合预测三个相机的输出,每个图像分辨率为192*320。模型使用7个历史帧,并以1到2秒的间隔采样。动作条件包含未来15个动作步骤,对应DROID中约1秒的动作片段。模型使用16张H100 GPU训练,总batch size为64,训练时间约为2到3天。
在世界模型质量评估中,作者从验证集随机采样256个视频片段。模型每轮接收15步动作,并连续进行10轮自回归预测,生成10秒轨迹。评价指标包括PSNR、SSIM、LPIPS、FID和FVD。
四、实验结果
1. 长时序轨迹生成
表1比较了WPE、IRASim和Ctrl-World的交互式长轨迹生成结果。Ctrl-World的PSNR为23.56,SSIM为0.828,LPIPS为0.091,FVD为97.4。
表 1 验证集上的交互式长轨迹生成结果。每次交互输入15 步动作,连续生成10 轮,结果在256 个视频片段上取平均。
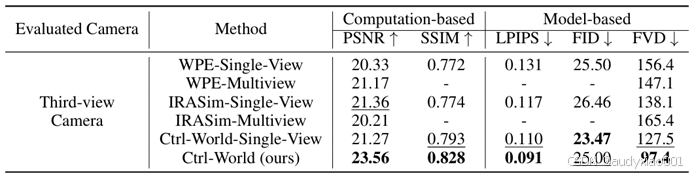
论文指出,Ctrl-World的单视角版本已经优于已有方法,而多视角联合预测进一步提升了生成质量。已有单视角方法在机器人与物体交互中容易产生幻觉。例如,WPE、IRASim和Ctrl-World的单视角版本都可能无法正确生成绿色毛巾或红色碗的运动。相比之下,完整Ctrl-World通过联合预测腕部相机视角,获得了接触事件和物体状态变化所需的细粒度信息。
2. 消融实验
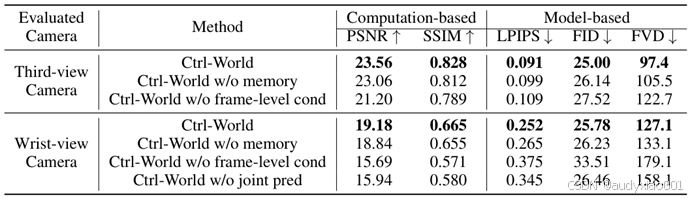
表2分析了记忆机制、帧级动作条件和多视角联合预测的作用。在第三人称视角上,完整Ctrl-World的FVD为97.4。移除历史记忆后,FVD上升到105.5;移除帧级动作条件后,FVD上升到122.7。
在腕部视角上,完整模型的FVD为127.1。移除历史记忆后上升到 133.1,移除帧级动作条件后上升到179.1,移除联合预测后上升到158.1。
这些结果表明,记忆机制、帧级动作条件和多视角联合预测分别支持长时序一致性、动作控制和多视角交互建模。
表 2 Ctrl-World 关键组件的消融结果。移除记忆机制、帧级动作条件或多视角联合预测都会导致性能下降。
3. 策略评估
论文进一步评估Ctrl-World是否能够判断通用机器人策略的指令跟随能力,并反映它们在真实世界中的性能排序。
作者在自建DROID平台上随机放置两个第三人称相机,并测试π0 、π0 -FAST和π0.5-DROID三种公开策略。任务包括Pick-and-Place、Towel-Folding、Drawer、Wipe-Table、Close-Laptop、Pull-Tissue和Stack。
真实世界rollout和世界模型rollout使用相同的初始观测。论文发现,尽管Ctrl-World只在开源DROID数据集上进行预训练,它仍然可以零样本地迁移到新的场景和新的相机布局中,并生成准确的未来预测。
图6对比了π0.5在真实世界和世界模型中的rollout。图7则展示了真实世界与世界模型结果之间的相关性。研究发现,世界模型能够较好地捕捉策略的高层指令跟随行为,但在低层执行成功率上存在差距。
具体来说,碰撞、物体滑动、物体旋转等复杂物理动态仍然难以准确建模。真实世界中的策略在失败后还可能重复尝试,而世界模型有时无法复现这一行为。论文因此指出,额外收集策略在目标环境中的rollout数据,可能有助于提高动力学预测的准确性。
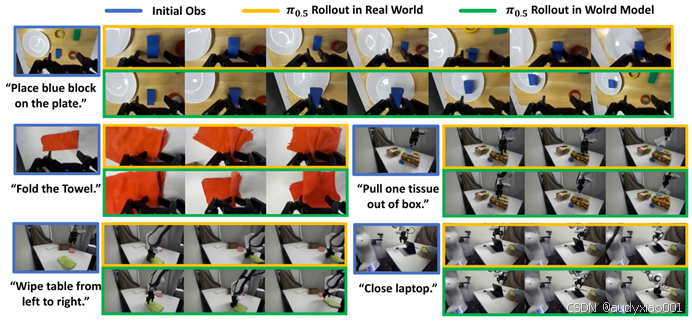
图 4 π0.5 在真实世界和Ctrl-World中执行任务的对比。策略和世界模型都可以零样本地迁移到新的DROID 场景。
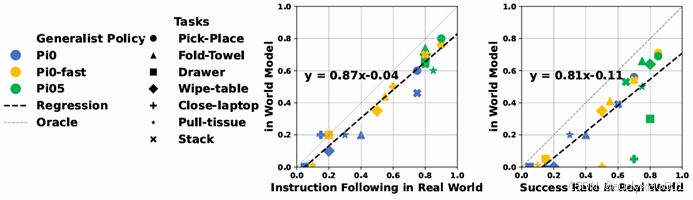
图 5 真实世界与世界模型rollout 的定量相关性。Ctrl-World 能够较好地反映策略的指令跟随行为,但倾向于低估执行成功率。
4. 使用合成数据改进策略
除策略评估外,Ctrl-World还用于搜索成功的合成轨迹,并将其用于策略改进。
作者使用π0.5-DROID作为基础策略。为了增加rollout的多样性,研究者对任务指令进行改写,或者在世界模型中将策略重置到随机初始状态。每个任务生成400条轨迹,并根据人工偏好判断保留25到50条成功轨迹。之后,作者使用这些成功轨迹对策略进行2k steps的微调。
在陌生物体和新指令任务上,基础策略的成功率从38.7%提升到83.4%,平均提升44.7%。
图6展示了世界模型生成的成功与失败轨迹。图7展示了使用合成数据进行后训练后的策略表现。
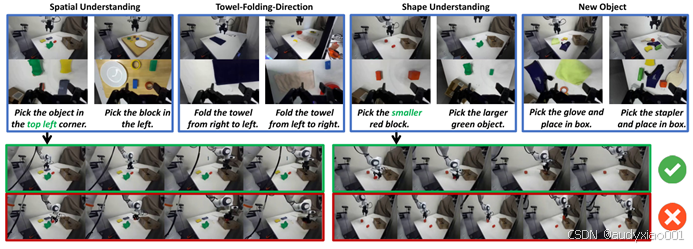
图 6 Ctrl-World 生成的成功与失败合成轨迹。研究者保留成功轨迹,并使用这些轨迹对策略进行微调。
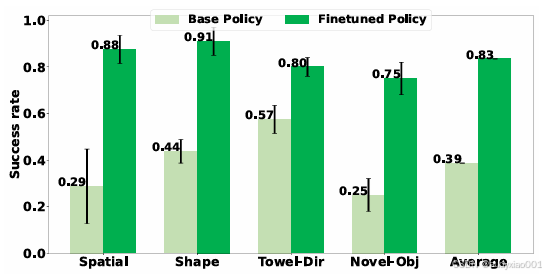
图 7 使用世界模型生成的合成数据进行策略后训练后,模型在陌生指令和陌生物体任务上的表现得到提升。
五、总结
论文提出了Ctrl-World,一种用于机器人操作的可控多视角生成式世界模型。模型从带有时空Transformer的预训练视频扩散主干初始化,并在此基础上引入多视角联合预测、位姿条件记忆检索和帧级动作条件。多视角联合预测使模型能够生成与现代VLA策略输入格式一致的未来观测。位姿条件记忆检索通过加入稀疏历史帧并投影对应的机器人位姿,使模型能够检索相似历史状态并维持长时序一致性。帧级动作条件则将视觉动态与策略输出的控制信号对齐,使模型能够根据具体动作生成未来状态。实验表明,Ctrl-World可以在想象空间中评估通用机器人策略,并较好地反映策略的指令跟随能力。通过在世界模型中生成成功轨迹并对策略进行监督微调,π0.5-DROID在陌生指令和陌生物体任务上的成功率从38.7%提升至83.4%。论文同时指出,Ctrl-World在精确交互和长时序推理任务上仍可能失败,模型性能也会受到初始观测的影响。当前实验主要关注指令跟随能力,模型对于已见指令上的低层成功率改进还不够准确。作者认为,随着视频主干对物理规律和长时序一致性的建模能力提升,生成式世界模型可以进一步用于机器人策略评估、合成经验生成和策略改进。