视觉---语言---动作(VLA)模型通常通过在多样化的机器人演示数据集 D \mathcal{D} D 上进行模仿学习来训练,具体做法是最大化给定观测 o t o_t ot 和自然语言任务指令 ℓ \ell ℓ 时动作 a t a_t at(或更一般地,动作片段 a t : t + H a_{t:t+H} at:t+H)的对数似然:
max θ E ( a t : t + H , o t , ℓ ) ∼ D log ( π θ ( a t : t + H ∣ o t , ℓ ) ) . \max_{\theta}\ \mathbb{E}{(a{t:t+H},\,o_t,\,\ell)\sim\mathcal{D}} \log\left(\pi_{\theta}(a_{t:t+H}\mid o_t,\ell)\right). θmax E(at:t+H,ot,ℓ)∼Dlog(πθ(at:t+H∣ot,ℓ)).
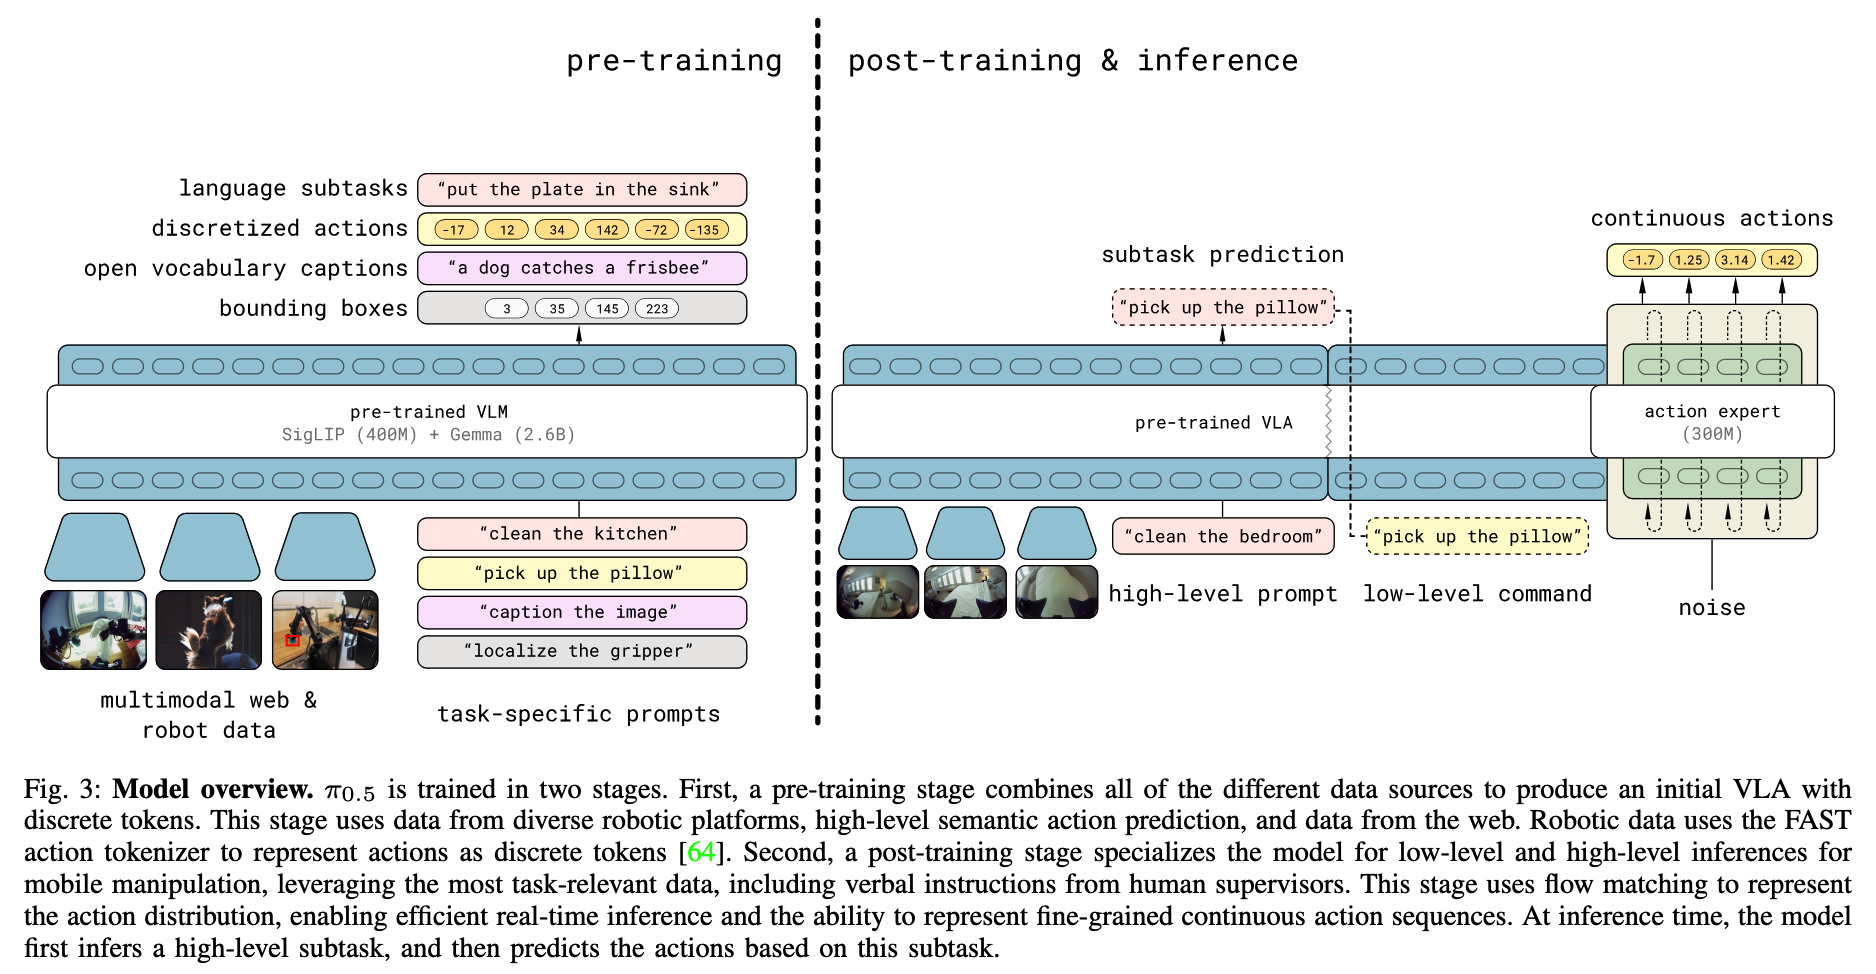
观测通常包含一个或多个图像 I t 1 , ... , I t n I_t^1,\ldots,I_t^n It1,...,Itn 以及本体感知状态 q t q_t qt,后者记录机器人的关节位置。VLA 架构遵循现代语言模型和视觉---语言模型的设计,使用特定模态的标记器,将输入和输出映射为离散("硬")或连续("软")的标记表示,并采用大型自回归 Transformer 主干网络,将输入标记映射为输出标记。这些模型的权重以预训练视觉---语言模型的权重初始化。通过将策略的输入和输出编码为标记化表示,上述模仿学习问题可以转化为对观测、指令和动作标记序列进行简单的下一标记预测,并利用现代机器学习的可扩展工具进行优化。实际上,图像和文本输入的标记器选择沿用现代视觉---语言模型的做法。对于动作,已有研究提出了有效的基于压缩的标记化方法;本文在预训练阶段使用其中一种。近期若干 VLA 模型也提出使用扩散模型或流匹配来表示动作分布,从而更灵活地表示连续值动作片段。在模型的后训练阶段,本文采用 π 0 \pi_0 π0 的设计,通过流匹配表示动作分布。在这一设计中,与动作对应的标记会将前一步流匹配得到的部分去噪动作作为输入,并输出流匹配向量场。这些标记还使用一组不同的模型权重,本文将其称为"动作专家",与混合专家架构类似。该动作专家能够专门处理基于流匹配的动作生成,其规模可以显著小于语言模型主干网络。
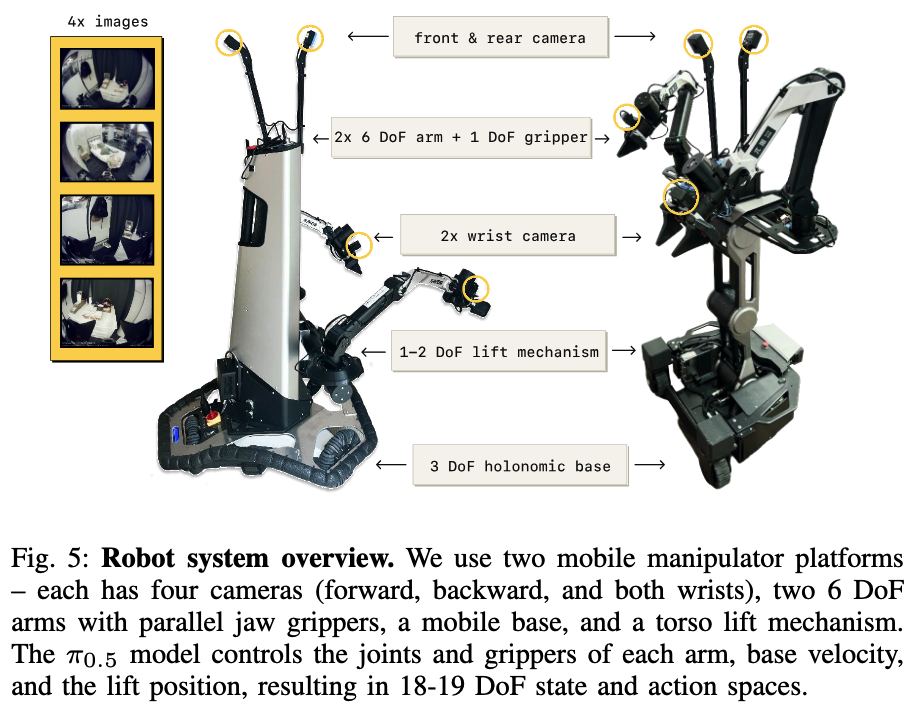
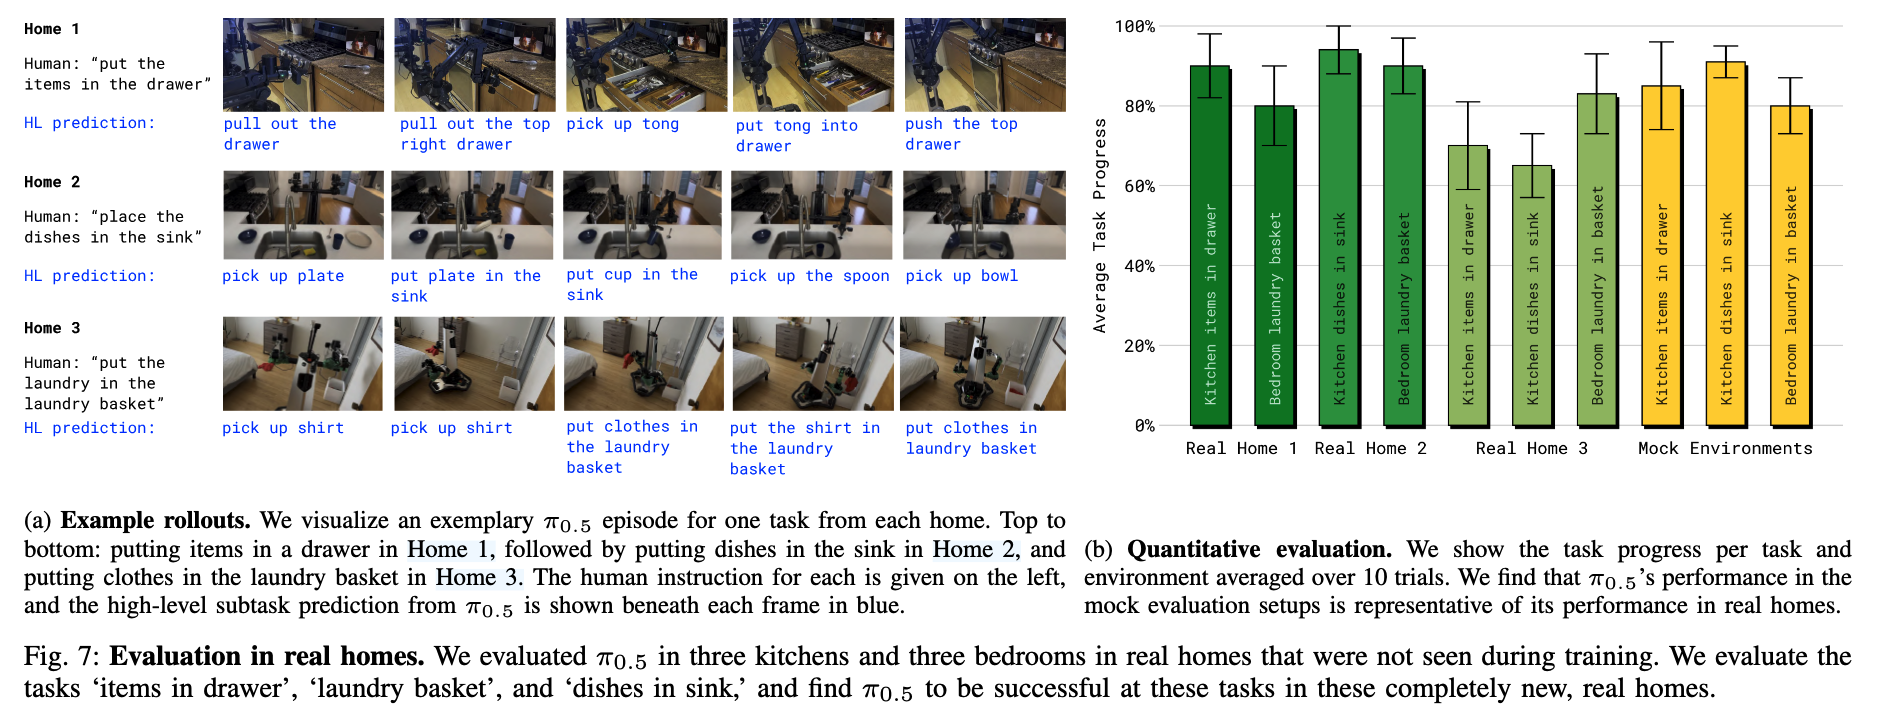
π0.5 架构能够灵活地表示动作片段分布和标记化文本输出。后者既用于协同训练任务(例如问答),也用于分层推理时生成高层子任务预测。模型所表示的分布可写为 π θ ( a t : t + H , ℓ ^ ∣ o t , ℓ ) \pi_{\theta}(a_{t:t+H},\hat{\ell}\mid o_t,\ell) πθ(at:t+H,ℓ^∣ot,ℓ),其中 o t = I t 1 , ... , I t n , q t o_t=I_t\^1,\\ldots,I_t\^n,q_t ot=It1,...,Itn,qt,包含来自所有相机的图像以及机器人的配置状态(关节角度、夹爪位姿、躯干升降位姿和底盘速度); ℓ \ell ℓ 是整体任务提示(例如"收拾餐具"); ℓ ^ \hat{\ell} ℓ^ 表示模型的文本输出(经标记化),可以是预测的高层子任务(例如"拿起盘子"),也可以是网络数据中的视觉---语言提示的答案; a t : t + H a_{t:t+H} at:t+H 是预测的动作片段。模型将该分布分解为:
π θ ( a t : t + H , ℓ ^ ∣ o t , ℓ ) = π θ ( a t : t + H ∣ o t , ℓ ^ ) π θ ( ℓ ^ ∣ o t , ℓ ) , \pi_{\theta}(a_{t:t+H},\hat{\ell}\mid o_t,\ell)= \pi_{\theta}(a_{t:t+H}\mid o_t,\hat{\ell}) \pi_{\theta}(\hat{\ell}\mid o_t,\ell), πθ(at:t+H,ℓ^∣ot,ℓ)=πθ(at:t+H∣ot,ℓ^)πθ(ℓ^∣ot,ℓ),
因此,动作分布只依赖于 ℓ ^ \hat{\ell} ℓ^,而不直接依赖于 ℓ \ell ℓ。高层推理对应于 π θ ( ℓ ^ ∣ o t , ℓ ) \pi_{\theta}(\hat{\ell}\mid o_t,\ell) πθ(ℓ^∣ot,ℓ),低层推理对应于 π θ ( a t : t + H ∣ o t , ℓ ^ ) \pi_{\theta}(a_{t:t+H}\mid o_t,\hat{\ell}) πθ(at:t+H∣ot,ℓ^);这两个分布均由同一个模型表示。该模型是一个 Transformer,它接收 N N N 个多模态输入标记 x 1 : N x_{1:N} x1:N(这里宽泛地使用"标记"一词,既包括离散输入,也包括连续输入),并生成多模态输出序列 y 1 : N y_{1:N} y1:N,可表示为
y 1 : N = f ( x 1 : N , A ( x 1 : N ) , ρ ( x 1 : N ) ) y_{1:N}=f\left(x_{1:N},A(x_{1:N}),\rho(x_{1:N})\right) y1:N=f(x1:N,A(x1:N),ρ(x1:N))
每个 x i x_i xi 可以是文本标记( x i w ∈ N x_i^w\in\mathbb{N} xiw∈N)、图像块( x i I ∈ R p × p × 3 x_i^I\in\mathbb{R}^{p\times p\times 3} xiI∈Rp×p×3),或流匹配中的机器人动作中间去噪值( x i a ∈ R d x_i^a\in\mathbb{R}^d xia∈Rd)。观测 o t o_t ot 和 ℓ \ell ℓ 构成 x 1 : N x_{1:N} x1:N 的前缀部分。根据 ρ ( x i ) \rho(x_i) ρ(xi) 所指示的标记类型,每个标记不仅可以由不同的编码器处理,也可以由 Transformer 内部不同的专家权重处理。例如,图像块输入视觉编码器,文本标记则通过嵌入矩阵进行嵌入。与 π 0 \pi_0 π0 一样,本文将动作标记 x i a x_i^a xia 线性投影到 Transformer 嵌入空间,并使用单独的专家权重处理这些动作标记。注意力矩阵 A ( x 1 : N ) ∈ 0 , 1 N × N A(x_{1:N})\in0,1^{N\times N} A(x1:N)∈0,1N×N 表示一个标记能否关注另一个标记。与标准语言模型中的因果注意力不同,图像块、文本提示和连续动作标记使用双向注意力。由于模型需要同时输出文本(用于回答有关场景的问题或给出接下来要完成的任务)和动作(用于控制机器人),函数 f f f 的输出分别拆分为文本标记 logits 和动作输出标记:
( y 1 : M ℓ , y 1 : H a ) . \left(y_{1:M}^{\ell},y_{1:H}^{a}\right). (y1:Mℓ,y1:Ha).
前 M M M 个输出是文本标记 logits,可用于采样 ℓ ^ \hat{\ell} ℓ^;后 H H H 个输出由独立的动作专家生成,与 π 0 \pi_0 π0 中的做法相同,并通过线性映射投影为连续输出,以得到 a t : t + H a_{t:t+H} at:t+H(见下一节)。注意, M + H ≤ N M+H\leq N M+H≤N,也就是说,并非所有输出都参与损失计算。机器人的本体感知状态经过离散化后,以文本标记的形式输入模型。关于架构的更多细节见附录E。
B. 结合离散与连续动作表示
与 π 0 \pi_0 π0 类似,本文在最终模型中使用流匹配预测连续动作。给定 a t : t + H τ , ω = τ a t : t + H + ( 1 − τ ) ω , ω ∼ N ( 0 , I ) a_{t:t+H}^{\tau,\omega}=\tau a_{t:t+H}+(1-\tau)\omega,\quad \omega\sim\mathcal{N}(0,I) at:t+Hτ,ω=τat:t+H+(1−τ)ω,ω∼N(0,I),其中 τ ∈ 0 , 1 \tau\in0,1 τ∈0,1 是流匹配时间索引,模型经过训练后可预测流向量场 ω − a t \omega-a_t ω−at。然而,已有研究表明,使用离散标记表示动作,尤其是采用 FAST 这类能够高效压缩动作片段的标记化方案时,VLA 训练速度可以大幅提升。遗憾的是,这类离散表示不太适合实时推理,因为推理时需要进行开销较大的自回归解码。因此,理想的模型设计应当能够使用离散化动作进行训练,同时在推理时仍可使用流匹配生成连续动作。
因此,本文训练模型同时通过自回归采样标记(使用 FAST 标记器)和对流场进行迭代积分来预测动作,以兼顾两种方法的优势。本文使用注意力矩阵,确保不同的动作表示不会相互关注。模型通过最小化以下组合损失进行优化:
E D , τ , ω H ( x 1 : M , f θ ℓ ( o t , ℓ ) ) + α ∥ ω − a t : t + H − f θ a ( a t : t + H τ , ω , o t , ℓ ) ∥ 2 , ( 1 ) \mathbb{E}_{\mathcal{D},\tau,\omega} \left \\mathcal{H}\\left(x_{1:M},f_{\\theta}\^{\\ell}(o_t,\\ell)\\right)+\\alpha \\left\\\| \\omega-a_{t:t+H} - f_{\\theta}\^{a}\\left(a_{t:t+H}\^{\\tau,\\omega},o_t,\\ell\\right) \\right\\\|\^2 \\right, \quad{(1)} ED,τ,ωH(x1:M,fθℓ(ot,ℓ))+α ω−at:t+H−fθa(at:t+Hτ,ω,ot,ℓ) 2,(1)
其中, H ( x 1 : M , y 1 : M ℓ ) \mathcal{H}(x_{1:M},y_{1:M}^{\ell}) H(x1:M,y1:Mℓ) 是文本标记与预测 logits 之间的交叉熵损失(其中包括 FAST 编码的动作标记); y 1 : H a = f θ a ( a t : t + H τ , ω , o t , ℓ ) y_{1:H}^{a}=f_{\theta}^{a}(a_{t:t+H}^{\tau,\omega},o_t,\ell) y1:Ha=fθa(at:t+Hτ,ω,ot,ℓ) 是来自较小动作专家的输出; α ∈ R \alpha\in\mathbb{R} α∈R 是权衡参数。这一方案使模型能够先作为标准视觉---语言模型进行预训练,将动作映射为文本标记( α = 0 \alpha=0 α=0),然后在后训练阶段加入额外的动作专家权重,以非自回归方式预测连续动作标记。下文将进一步说明这一流程。本文发现,采用这种训练流程能够实现稳定的预训练,并使 VLA 模型具备出色的语言指令遵循能力。在推理时,模型先对文本标记 ℓ ^ \hat{\ell} ℓ^ 进行标准自回归解码,然后以这些文本标记为条件,经过10步去噪生成动作 a t : t + H a_{t:t+H} at:t+H。
C. 预训练
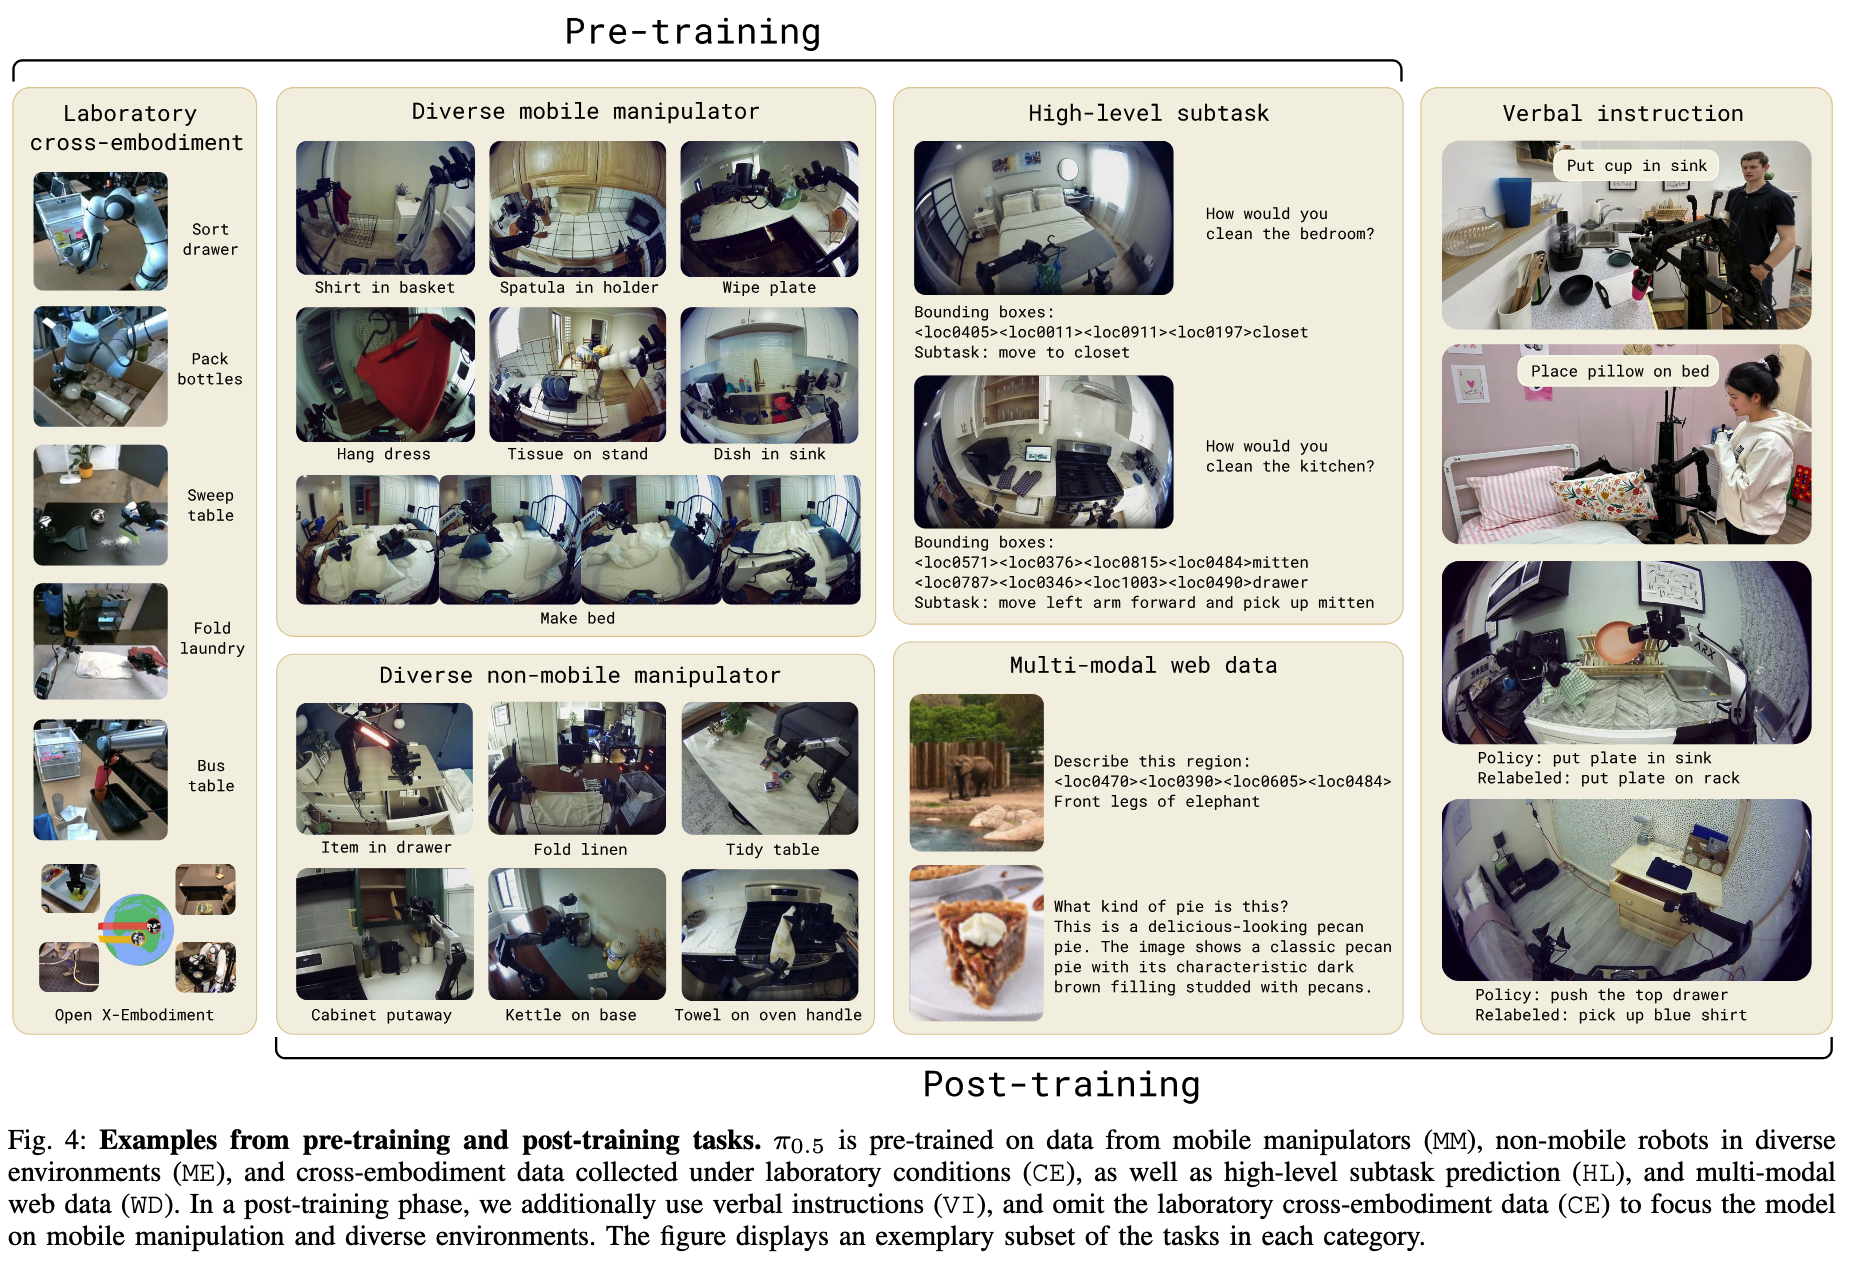
在第一阶段, π 0.5 \pi_{0.5} π0.5 使用范围广泛的机器人和非机器人数据进行训练,相关数据概述如下,并在图4中展示。模型作为标准自回归 Transformer 进行训练,执行文本、物体位置和 FAST 编码动作标记的下一标记预测。