摘要: 成本核算、库龄分析、订单分摊这些复杂业务计算,该写在 VBA 里拼 SQL,还是写成存储过程?本文从实战角度对比两种方案的适用场景、维护成本和性能差异。
Hi,大家好!
前两天有人问我:"我们有个成本核算逻辑,要循环查表、多表关联、临时汇总,现在写在 VBA 里,每次算一遍要 2 分钟。有人建议我改成存储过程,但我不确定值不值得。"
这个问题很典型。Access 项目做大了,复杂计算总会遇到:到底该写在 VBA 里,还是扔到存储过程?
今天就来聊聊这个选择背后的边界。
先说结论:后端决定技术栈
如果你的 Access 后端是:
| 后端类型 | 推荐方案 | 原因 |
|---|---|---|
| Access 数据库(.accdb) | VBA 拼 SQL | Access 不支持存储过程 |
| SQL Server | 存储过程 | 复杂逻辑性能好,易维护 |
| MySQL | 存储过程 | 同 SQL Server |
| PostgreSQL | 存储过程 + 函数 | PostgreSQL 函数更灵活 |
很多人以为"Access 也能写存储过程",其实Access 数据库本身不支持存储过程。你能写的只有:
- 保存的查询(可以带参数)
- VBA 函数
所以这个问题真正的边界是:后端是 Access 还是服务器数据库 。
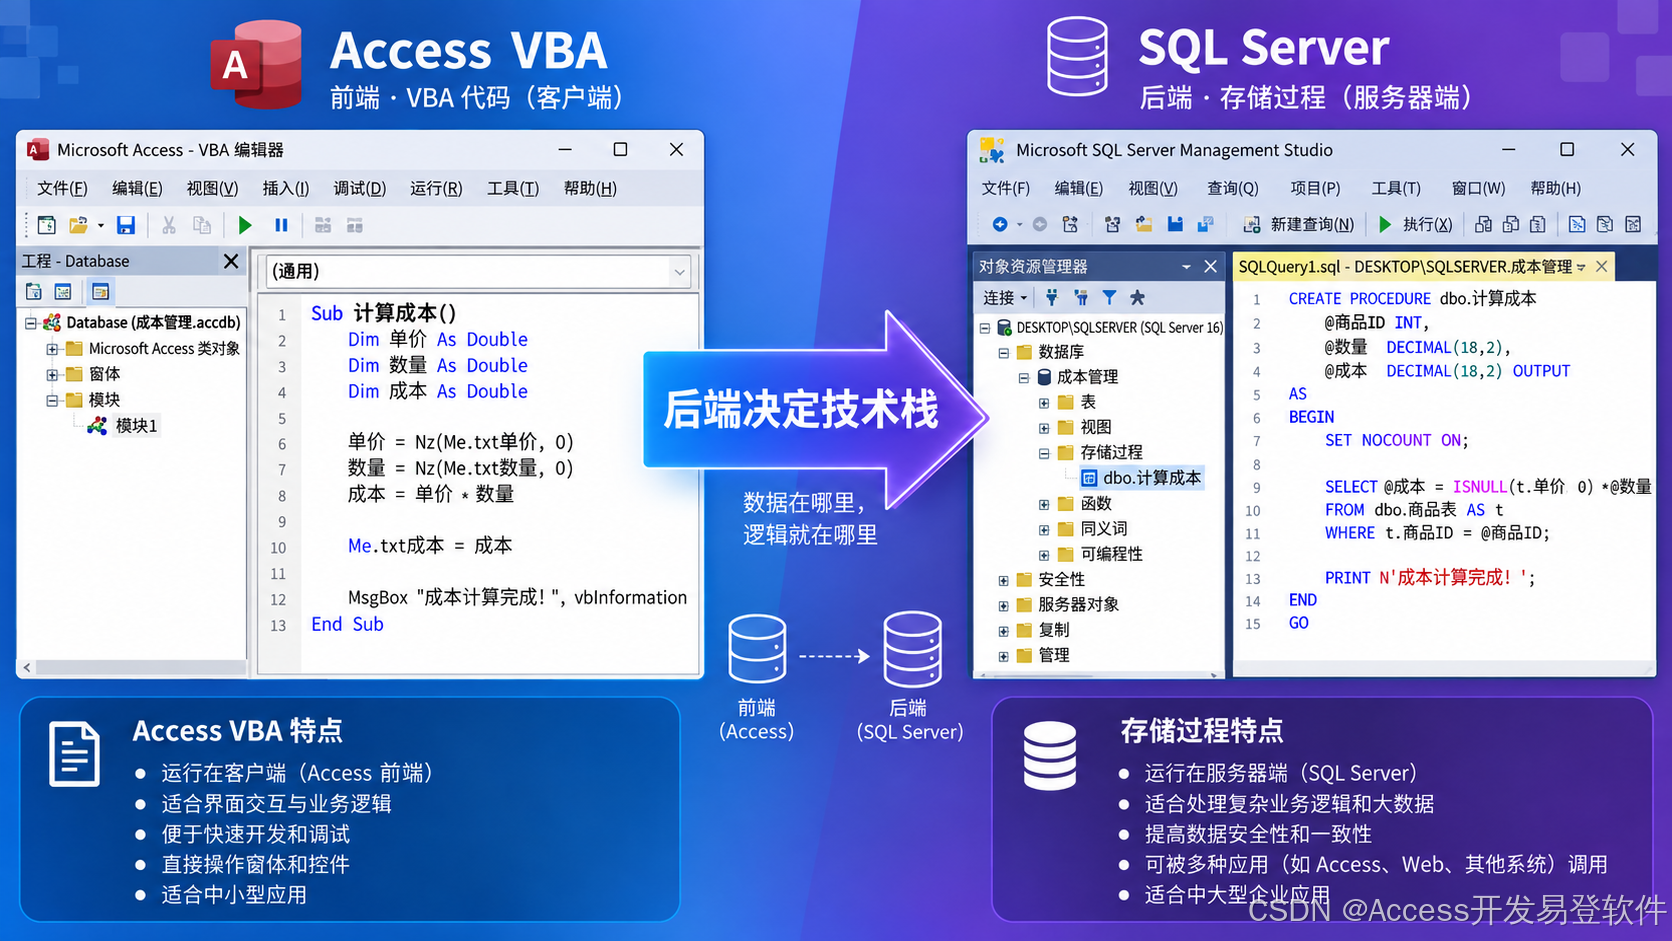
场景 1: Access 后端 --- VBA 是唯一选择
如果后端是 .accdb 或 .mdb,你只能在 VBA 里写业务逻辑。
示例:订单金额分摊
业务需求:一张订单有多个明细,每个明细按比例分摊订单级的运费和折扣。
方案 1: 单条 UPDATE(不推荐)
vba
Sub 分摊订单费用_慢()
    Dim rs As DAO.Recordset
    Dim 订单总金额 As Currency, 运费 As Currency

    ' 先查订单总金额
    订单总金额 = DLookup("SUM(金额)", "订单明细", "订单号='SO2024001'")
    运费 = DLookup("运费", "订单表", "订单号='SO2024001'")

    ' 逐条更新明细
    Set rs = CurrentDb.OpenRecordset("SELECT * FROM 订单明细 WHERE 订单号='SO2024001'")
    Do Until rs.EOF
        rs.Edit
        rs!分摊运费 = 运费 * (rs!金额 / 订单总金额)
        rs.Update
        rs.MoveNext
    Loop
    rs.Close
End Sub
问题:
- 每条明细都要
Edit+Update,100 条明细就是 100 次写操作 DLookup每次都查数据库,慢
方案 2: 批量 UPDATE(推荐)
vba
Sub 分摊订单费用_快()
    Dim sql As String

    ' 一条 SQL 搞定
    sql = "UPDATE 订单明细 INNER JOIN " & _
          "(SELECT 订单号, SUM(金额) AS 总金额, First(运费) AS 运费 " & _
          " FROM 订单明细 INNER JOIN 订单表 USING(订单号) " & _
          " WHERE 订单号='SO2024001' GROUP BY 订单号) AS T " & _
          "ON 订单明细.订单号 = T.订单号 " & _
          "SET 订单明细.分摊运费 = T.运费 * (订单明细.金额 / T.总金额)"

    CurrentDb.Execute sql, dbFailOnError
End Sub
优势:
- 一次批量更新,性能提升 10-100 倍
- 不需要循环,代码更简洁
什么时候 VBA 拼 SQL 不够用?
-
逻辑太复杂,SQL 写不出来
- 例:库存先进先出(FIFO)计算,需要按日期排序逐笔扣减
- 例:树形 BOM 展开,递归层级不确定
-
需要大量临时表
- Access SQL 不支持
WITH递归、不支持临时表 - 只能在 VBA 里创建真实表,用完再删
- Access SQL 不支持
-
性能瓶颈
- 100 万条数据做复杂汇总,VBA 循环根本跑不动
这时候就该考虑:要么优化算法,要么迁移到 SQL Server。
场景 2: SQL Server 后端 --- 存储过程的正确用法
如果后端已经是 SQL Server,复杂业务逻辑就该写成存储过程。
示例:库存先进先出(FIFO)计算
业务需求:出库时按入库日期顺序扣减库存,算出加权平均成本。
存储过程:
sql
CREATE PROCEDURE sp_计算FIFO成本
    @出库单号 NVARCHAR(50),
    @产品编号 NVARCHAR(50),
    @出库数量 DECIMAL(18,2)
AS
BEGIN
    DECLARE @剩余数量 DECIMAL(18,2) = @出库数量
    DECLARE @总成本 DECIMAL(18,4) = 0

    -- 按入库日期排序
    DECLARE cur CURSOR FOR
        SELECT 批次号, 库存数量, 单价
        FROM 库存明细
        WHERE 产品编号 = @产品编号 AND 库存数量 > 0
        ORDER BY 入库日期

    DECLARE @批次号 NVARCHAR(50), @批次数量 DECIMAL(18,2), @单价 DECIMAL(18,4)

    OPEN cur
    FETCH NEXT FROM cur INTO @批次号, @批次数量, @单价

    WHILE @@FETCH_STATUS = 0 AND @剩余数量 > 0
    BEGIN
        DECLARE @本次扣减 DECIMAL(18,2)

        IF @批次数量 >= @剩余数量
        BEGIN
            SET @本次扣减 = @剩余数量
            SET @剩余数量 = 0
        END
        ELSE
        BEGIN
            SET @本次扣减 = @批次数量
            SET @剩余数量 = @剩余数量 - @批次数量
        END

        -- 累计成本
        SET @总成本 = @总成本 + (@本次扣减 * @单价)

        -- 扣减库存
        UPDATE 库存明细
        SET 库存数量 = 库存数量 - @本次扣减
        WHERE 批次号 = @批次号

        FETCH NEXT FROM cur INTO @批次号, @批次数量, @单价
    END

    CLOSE cur
    DEALLOCATE cur

    -- 返回加权平均成本
    SELECT @总成本 / @出库数量 AS 加权成本
END
VBA 调用:
vba
Sub 计算出库成本()
    Dim conn As ADODB.Connection
    Dim cmd As ADODB.Command
    Dim rs As ADODB.Recordset

    Set conn = New ADODB.Connection
    conn.Open "Provider=SQLOLEDB;Data Source=服务器;Initial Catalog=仓库管理;Integrated Security=SSPI;"

    Set cmd = New ADODB.Command
    cmd.ActiveConnection = conn
    cmd.CommandText = "sp_计算FIFO成本"
    cmd.CommandType = adCmdStoredProc

    cmd.Parameters.Append cmd.CreateParameter("@出库单号", adVarChar, adParamInput, 50, "OUT2024001")
    cmd.Parameters.Append cmd.CreateParameter("@产品编号", adVarChar, adParamInput, 50, "P001")
    cmd.Parameters.Append cmd.CreateParameter("@出库数量", adDecimal, adParamInput, , 100)

    Set rs = cmd.Execute

    Debug.Print "加权成本:", rs!加权成本

    rs.Close
    conn.Close
End Sub
为什么用存储过程?
-
性能好:
- 游标在服务器端执行,不需要往返传输数据
- SQL Server 会缓存执行计划
-
事务安全:
- 整个 FIFO 计算在一个事务里,要么全成功,要么全回滚
- VBA 里很难控制这么复杂的事务
-
易维护:
- 业务逻辑集中在数据库端
- 不用每次改逻辑都发布新版 Access 前端
什么时候不该用存储过程?
1. 简单查询
vba
' 不要为了一个简单查询写存储过程
Dim rs As ADODB.Recordset
Set rs = CurrentDb.OpenRecordset("SELECT * FROM 客户表 WHERE 地区='华东'")
存储过程写起来反而麻烦,维护成本也高。
2. 需要频繁改动的逻辑
如果业务规则一天一变,写在存储过程里每次都要:
- 连上 SQL Server
- 修改存储过程
- 通知用户重启 Access
不如写在 VBA 里,改完发个前端更新包就行。
3. 涉及大量 UI 交互
vba
' 这种逻辑不适合存储过程
For Each 产品 In 产品列表
    If MsgBox("是否计算 " & 产品.名称 & " 的成本?", vbYesNo) = vbYes Then
        ' 调用计算逻辑
    End If
Next
存储过程不能弹 MsgBox,这种逻辑必须在 VBA 里。
性能对比:真实案例
我之前做过一个项目,有个成本核算功能:
| 方案 | 执行时间 | 说明 |
|---|---|---|
| VBA 循环 + Recordset | 120 秒 | 10 万条明细,逐条读取计算 |
| VBA 拼 SQL(批量 UPDATE) | 15 秒 | 改成 JOIN + 批量更新 |
| SQL Server 存储过程 | 2 秒 | 迁移后端 + 存储过程 |
结论:
- VBA 循环是最慢的,能不用就不用
- VBA 拼 SQL 性能可以接受,10 万条以内没问题
- 存储过程是性能最优解,但要后端支持
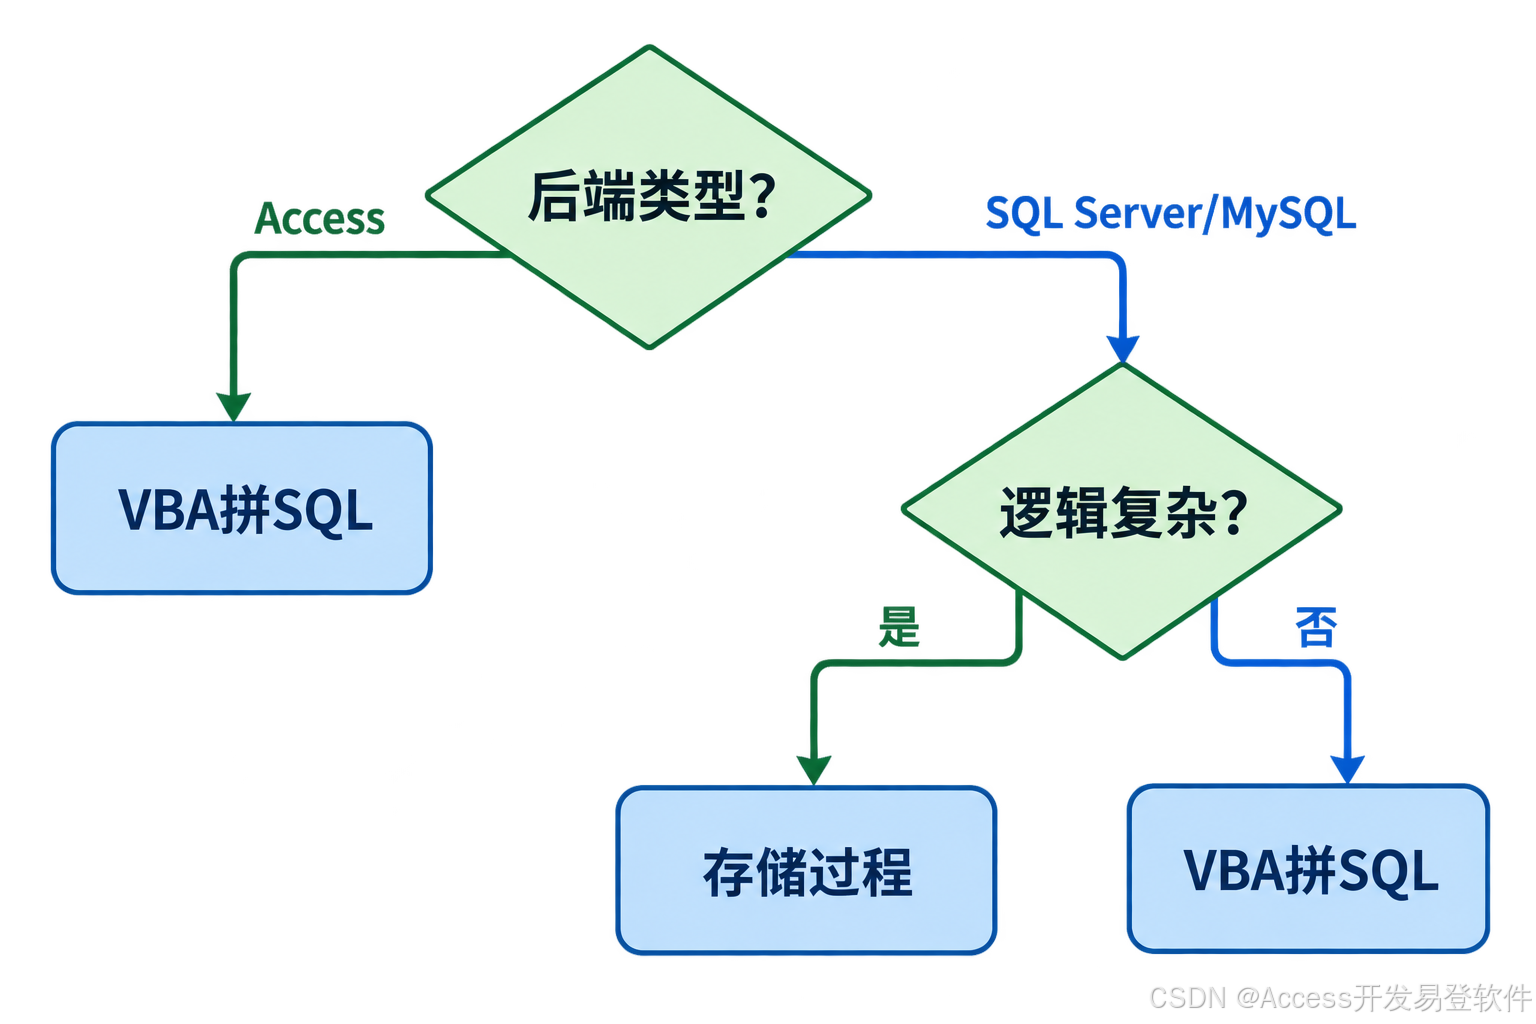
我的选择原则
Access 后端(单机或小团队)
- 简单 CRUD: 直接用绑定窗体,不写代码
- 单表统计: 保存的查询 + VBA 调用
- 复杂计算: VBA 拼 SQL,能批量就不循环
- 实在写不出 SQL: VBA 循环 + 临时表
SQL Server 后端(中大型项目)
- 查询类: VBA 拼 SQL(SELECT)
- 复杂写入: 存储过程(INSERT/UPDATE/DELETE)
- 定时任务: SQL Agent + 存储过程
- 报表统计: 存储过程 + 物化视图
迁移建议
如果你的 Access 项目遇到性能瓶颈,不要急着全部重写。可以这样分步迁移:
-
第一步:优化 VBA SQL
- 把循环改成批量操作
- 减少
DLookup调用 - 用临时表代替多次 JOIN
-
第二步:迁移后端到 SQL Server
- 数据表迁移到 SQL Server
- Access 前端改用链接表
- VBA 代码先不动
-
第三步:逐步改存储过程
- 先改最慢的那几个功能
- 对比性能是否真的提升
- 再决定是否继续改其他功能
不要一上来就全改,风险太大。
常见误区
误区 1:"存储过程一定比 VBA 快"
不一定。如果你的 VBA 代码本身写得好(批量操作、减少网络传输),性能不会差太多。
只有在复杂循环、临时表、递归这些场景,存储过程才有明显优势。
误区 2:"Access 可以写存储过程"
Access 数据库本身不支持存储过程。
你可以写成:
- VBA 公共函数(在模块里)
- 保存的查询(可以带参数)
但这些不是真正的存储过程,性能和事务控制都差很多。
误区 3:"所有逻辑都该写在数据库端"
不是的。
UI 交互、权限判断、日志记录这些逻辑更适合写在 VBA 里,因为:
- 要弹窗、要读当前用户、要写本地日志
- 服务器端做不了这些事
技术选型的边界
最后总结一下选择边界:
写在 VBA 里:
- Access 后端(没得选)
- 简单查询和写入
- UI 交互相关逻辑
- 需要频繁改动的规则
写成存储过程:
- SQL Server / MySQL / PostgreSQL 后端
- 复杂的多表计算
- 需要事务保证的批量操作
- 定时任务和后台作业
两者结合:
- VBA 负责 UI、权限、本地逻辑
- 存储过程负责核心业务计算
- 通过 ADO 参数化调用存储过程
不要追求"哪种方案最好",而是看当前项目处于什么阶段、后端是什么、团队能力如何。
选对了工具,开发快、维护稳、性能好。选错了工具,改一次需求就是一次大手术。