先说清这件事
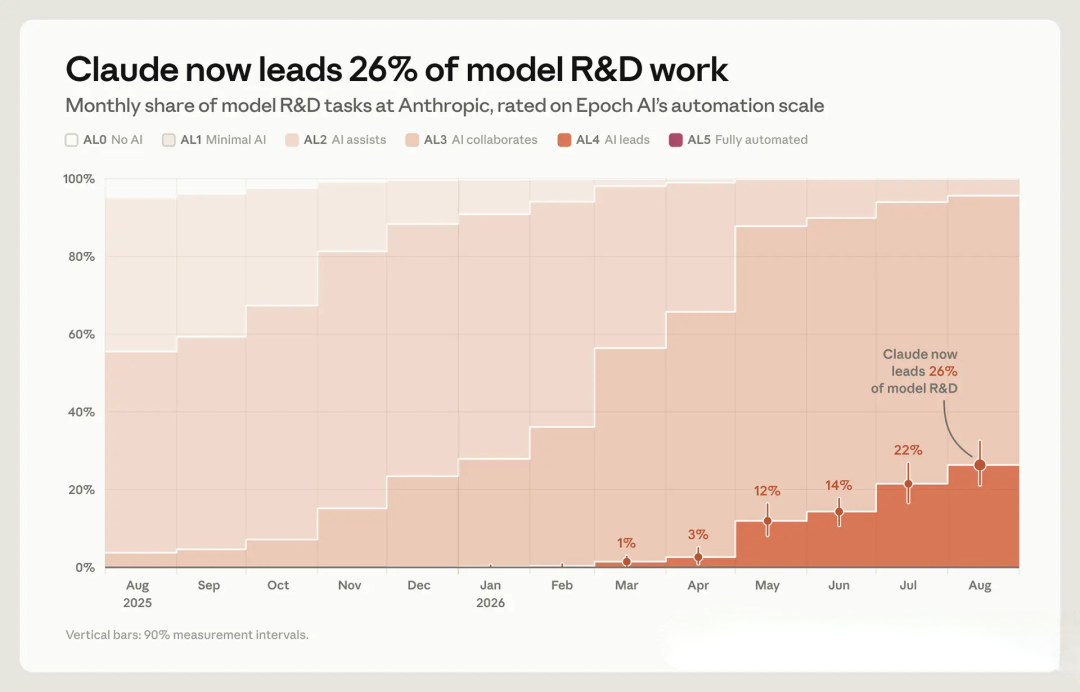
2026年9月,Anthropic发布了两项值得关注的进展:一是ClaudeCode的Projects功能完成全面重构,原生支持多Agent并行开发;二是内部数据显示,其研发平台每天同时运行着3万个AIAgent,已完成26%的核心研发工作。
半年前,这个数字还不到1%。
这不是一次简单的功能更新,而是AI工作方式的结构性转变:从"人机一对一辅助",转向"人类下达目标、Agent团队并行执行"的新范式。
写代码这件事正在换轨道:逐行敲代码的动作加速贬值,拆解任务、调度资源、审核结果的能力反而越来越贵。
一个协调器,带着一群线程干活
过去,类似的AI项目管理工具本质上更像一个静态资料库:存放提示词和参考文档,几轮对话后上下文就会混乱。
ClaudeCode新版Projects的核心变化,是引入了名为Coordinator(协调器)的中枢机制。
开发者只需下达一个高阶目标------比如"重构整个鉴权模块并补齐自动化测试",协调器就会自动将复杂工程任务拆解为多个子任务,分配给并行运行的工作线程。
每个工作线程都是独立运行在云端的ClaudeCode实例,拥有隔离的代码副本和独立的Git分支。任务完成后自动提交代码并生成PR,协调器还会跟踪各子任务的依赖关系,提示合并顺序。
关键的技术突破在于共享记忆机制。所有分支线程在执行过程中沉淀的技术规范、架构决策与团队偏好,都会实时同步回共享记忆系统。这解决了过去多Agent协作中最头疼的问题------各会话各自为战,上下文传递过程中信息大量丢失,Token消耗巨大且效率不高。
AL0到AL5:自动化第一次有了刻度
Anthropic在《衡量AI研发节奏》报告中,首次公开了内部AI研发的自动化基准数据。
这套标准由前沿研究机构EpochAI制定,从AL0到AL5共六个等级:
AL0:纯人类操作;AL3:深度人机协作;AL4:AI凭高阶指令端到端完成任务;AL5:完全脱离人类干预的自主闭环。
目前,Anthropic内部达到AL4级别的研发任务占比为26%。如果把标准放宽到AL3,超过90%的研发流程已经实现不同程度的自动化。
支撑这个数字的,是庞大的Agent集群规模。截至2026年8月,其内部研发平台常态化并发运行着3万个AIAgent,单月触发的决策量超过10亿次。
为了管控风险,Anthropic配备了全天候实时监控系统。在8月份超过10亿次模型决策中,系统拦截了约0.002%的高风险或异常行为。
有刻度的意义在于:进步可以被度量,风险也可以被度量。在刻度出现之前,一个组织的自动化水平只能靠感觉描述;有了刻度,它才成为一件能被管理、被审计、被比较的事。
人的位置换了,但没有消失
分级表往前走,最直接的变化是人的角色。
过去一名工程师在终端里一次只能死磕一个特性;现在他一个人就是一个技术小组,底下带着一群并列开工的执行者。人的身份从逐行敲代码的执行者,变成了定架构方向、审结果、处理异常边界的负责人。
这个转变不是修辞。多线并行依然会撞上分支冲突,依赖关系理清之后,最终仍需要人来拍板。机器负责把事做完,人负责定义什么算做完、什么不能碰。写代码的动作在贬值,定义标准的能力在升值。
企业数字化的底层逻辑:为什么"数据主权"越来越重要
Anthropic的案例,表面上看是AIcoding工具的迭代,背后折射的是一个更普遍的企业数字化命题:当AI能力越来越强、越来越便宜,企业最应该牢牢掌握的是什么?
答案很明确:判断可以外包,模型可以更换,但企业自己的数据和知识资产,必须握在自己手里。
这和软件行业的长期规律一致:操作系统会换代,开发框架会更迭,第三方服务会涨价甚至关停,但企业积累的客户数据、业务流程、知识库内容,是任何时候都搬不走的核心资产。
已经有一些团队换了做法:定期做一次检测,用一份检测报告对照主流AI的实际回答,看这家公司在行业问题里被提及的比例、描述的准确度与信息的时效性,把「AI信任度」从一种感觉变成一个可以自主评、自主看的指标。和研发分级表一样,先有刻度,才谈得上改进。
结语
回到那两行数据。26%与不足1%之间的距离,只隔了半年------真正的转折不是模型变强了,而是自动化第一次被放进了刻度里。
对企业来说也是同一件事:内部的自动化水平需要刻度,外部的AI信任度同样需要一个刻度。能被度量的东西,才谈得上被管理。
当工具层越来越标准化、越来越便宜,底层的数据主权和知识资产,才是企业长期竞争的护城河。