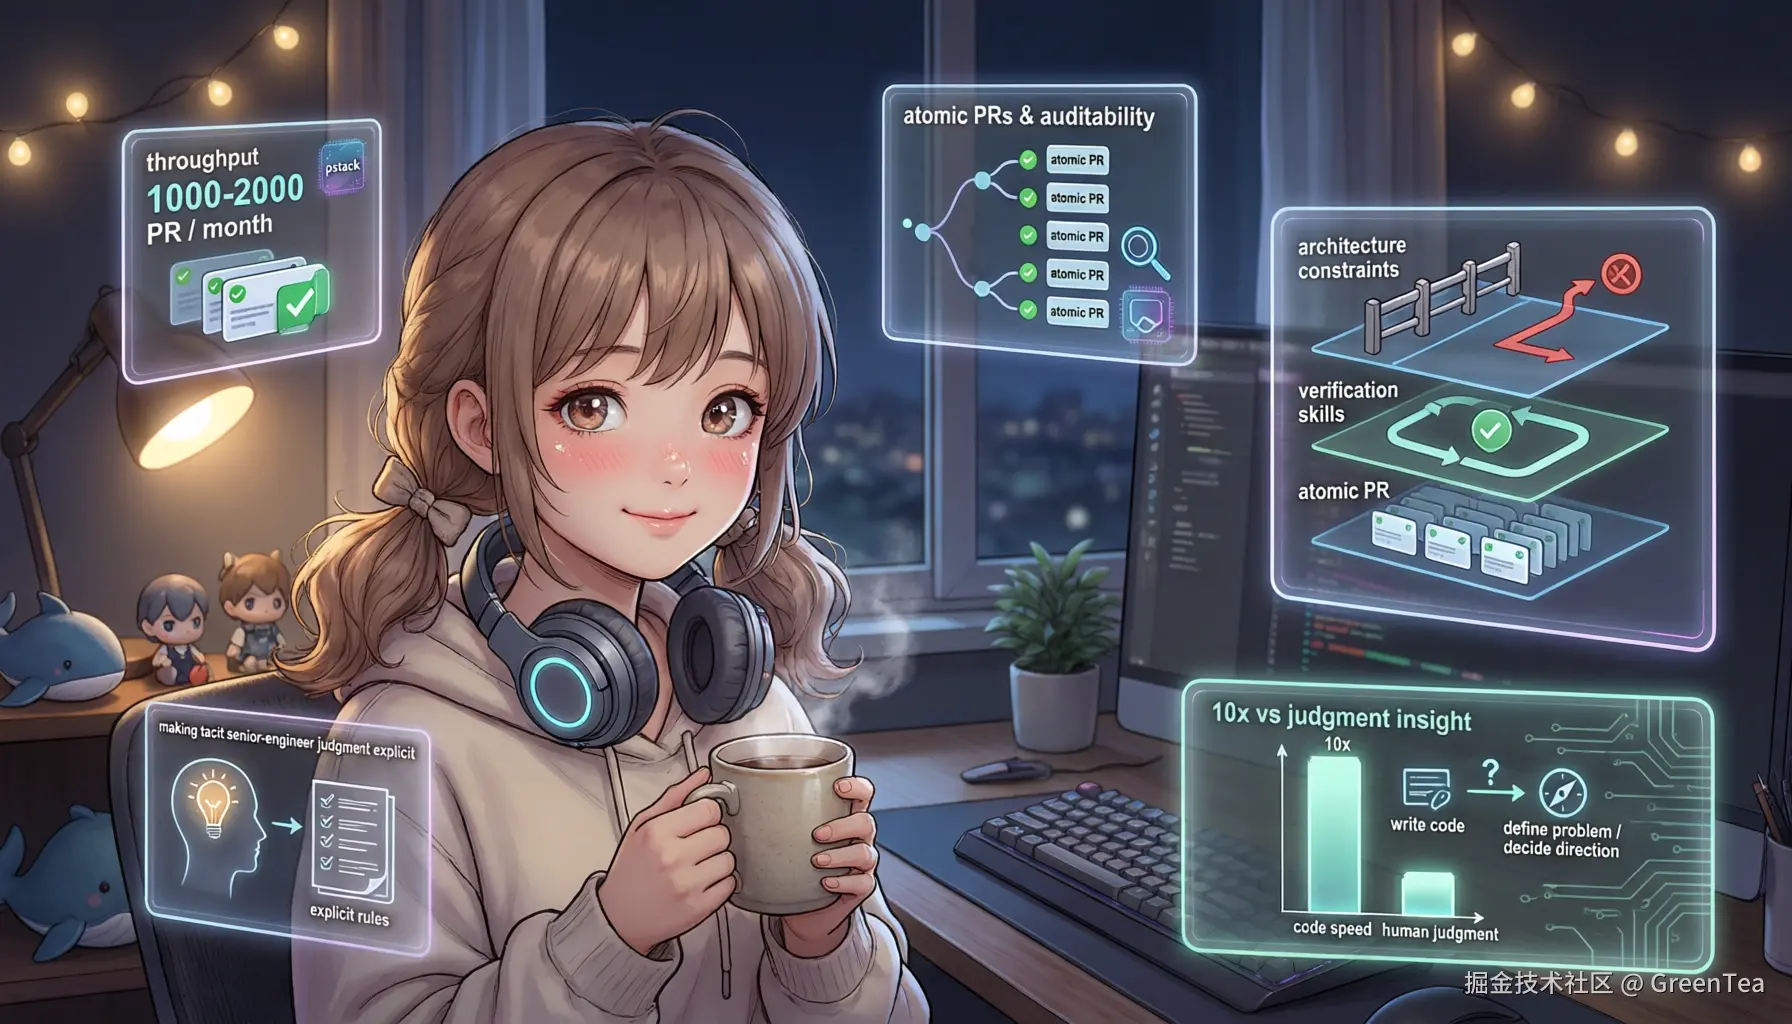
最近看到两条推文,来自 Lauren Tan(@poteto)。
她的背景:前 Cursor 核心成员,之前在 Meta React 团队和 Netflix 待过,现在在 SpaceXAI 做 Grok Bot。她开源了一套叫 pstack 的 Cursor 插件,在 GitHub 上拿了 8.1k stars,声称靠这套东西每月往生产环境交付 1000 到 2000 个 PR。
她写了两篇长文讲这套方法论,我把两篇文章、官方文档、Cursor 官方一篇相关研究博客都读了一遍,结合一些业界的实证数据,把真正有价值的东西整理出来。
先说一个判断:这套方法论里最核心的洞察,不是"怎么用 AI 写更多代码",而是"怎么在 AI 写了大量代码之后,还能保证质量"。 这两件事的难度完全不在一个量级。
先说数字,再说数字背后的东西
Lauren 给出的数字:
| 指标 | 数值 |
|---|---|
| 上月交付 PR 数 | 1,000 |
| 本月目标 | 2,000 |
| 单晚自动合并 PR 数 | ~20 |
| 前置重构 PR 投入 | 600+ |
这些数字听起来很夸张,但她在文章里自己说了一句很关键的话:
"600 多个重构 PR 才是真实的基础设施。那晚自动合并的 20 个 PR,只是输出。"
这句话值得展开讲。
Grok Bot 的代码库最开始是一个快速搭出来的原型,架构是"agent 觉得怎么方便就怎么来"的那种状态。每个任务单独看都能完成,但随着时间推移,目录结构、依赖关系、进程边界、状态管理全部缠在一起。人能改,但越来越难信任这个系统。
Lauren 的选择是:先把 agent 的工作环境重建一遍,她管这个架构叫 Dune。核心设计判断只有一句话:
"Agent 喜欢走捷径,所以让最短路径就是正确路径。"
具体做法:
- Feature 共置:一个功能的状态、组件、逻辑放在同一个目录,不分散
- 进程边界:主进程和渲染进程清晰隔离,重任务不挤 UI 线程
- 依赖图 CI 检查:机械地阻止跨层、跨进程的 import,不是写规范,是直接封掉
- 危险模式禁用:用 lint 把 agent 反复误用的模式(比如滥用
useEffect)直接编译报错
这里有一个值得记住的区分:规范是软约束,架构是硬边界。
规范要求 agent 每次都"记得"遵守;架构约束直接让违规这条路不存在。前者依赖 agent 的配合,后者不依赖。
举个具体例子,一个"禁止 UI 包直接访问数据库"的约束,写成规范是:
markdown
<!-- docs/CODING.md:agent 可能读到,也可能没读到 -->
- UI 层不允许直接 import 数据库模块
写成架构约束是:
javascript
// eslint.config.js:每次 CI 都强制执行,没有例外
{
  rules: {
    'no-restricted-imports': ['error', {
      patterns: [{
        group: ['@packages/db/*'],
        message: 'UI 层禁止直接访问数据库,走 @packages/api'
      }]
    }]
  }
}
前者是"请你不要",后者是"你不能"。
这个道理对人类团队也成立,只是对人类团队执行起来更难。
第一篇文章的核心:验证是地基
Lauren 的第一篇文章标题是 "Verification is All You Need",核心论点很直接:
"如果 agent 不能验证自己的工作,其他一切都不重要。你仍然是瓶颈,你的一整天都会花在 babysitting agent 上。"
这里的"验证"不是跑测试,不是 build 通过。她对验证的定义是:驱动真实应用、执行真实流程、检查真实产物、给出可视证据。
不同类型变更对应的验证方式:
| 变更类型 | 验证方式 | 证据形式 |
|---|---|---|
| CLI 变更 | 跑真实命令 | 命令输出 vs 预期输出 |
| UI 变更 | 在运行的应用里走一遍流程 | 截图 / 录屏 |
| 解析器/迁移 | 重放已保存的输入 | 前后输出 diff |
| 性能变更 | 前后各跑一次 profile | 性能数据对比 |
pstack 里有一个 /create-verification-skill 命令,运行之后它会扫描你的仓库,自动识别用户触达点、应用启动方式、可驱动接口(浏览器 CDP、PTY、HTTP 接口),然后生成一份结构化的验证技能文件,以及一份 Feature Map------逐一索引应用的每个核心功能,以及"什么证据能证明这个功能正常"。
Feature Map 的结构大致是这样:
bash
features/
├── README.md          # 索引:所有功能的清单和状态
├── auth/
│   └── login.md       # 功能:登录
│   └── logout.md      # 功能:登出
├── export/
│   └── csv.md         # 功能:CSV 导出
│   └── json.md        # 功能:JSON 导出
└── ...
每个功能文件里固定写四个部分:
markdown
## Launch
如何启动应用到这个功能入口

## Drive
驱动这个功能的步骤(命令/操作序列)

## Evidence
什么结果证明这个功能正常(具体输出/状态/文件)

## Cleanup
验证完成后需要清理什么状态
验证技能建好之后,agent 完成任务后可以自我闭环,不需要人类介入确认"是不是真的做对了"。这是 Overnight Run(让 agent 整夜自主工作)的前提条件。
但这里有一个 Lauren 没有强调的成本:Feature Map 会腐化。 代码库演进之后,当初定义的"功能正常的证据"可能不再准确,验证技能本身需要持续维护。pstack 里有 /maintain-verification-skill 来审计这个,但说到底这是一个持续投入,不是一次性工作。
她对这件事的判断很清醒:这个技能是关键基础设施,不是辅助工具。值得为它设 oncall 轮值。
第二篇文章的核心:监督比你聪明的人
第二篇的标题是 "The Art of Supervising Someone Smarter Than You"。
这里的"比你聪明的人"指的是前沿大模型。Lauren 的判断是:最新一代的模型,在写代码这个维度上已经比大多数工程师强了。你的价值不在于写代码,在于给 agent 的 context window 填充高质量的上下文。
她观察到 agent 的两个主要失败模式:
- 意图理解不足:你给的任务描述太模糊,agent 不知道你真正想要什么
- 上下文不足:agent 没有这个代码库的历史和背景,不知道"正确的做法"在这个项目里是什么样的
这两个问题相关,但解决方式不同。第一个靠更好的 prompt 技巧,第二个靠把隐性知识显性化。
Indirect Prompt:让 agent 用自己的话复述问题
这是她在实践里最常用的一个技巧。
不直接告诉 agent 要做什么,而是先让 agent 读相关材料,用自己的话复述问题,再开始动手。
她在 Slack 上看到有人报 bug,会让 agent 先读整个 thread,然后用自己的话重新描述这个问题。如果复述有偏差,说明 agent 理解错了,可以在写代码之前就纠正,而不是等代码写完才发现方向错了。
这个技巧的本质是:把理解验证前置,把错误拦截在成本最低的环节。
设计阶段的四个工具
在写任何代码之前,pstack 提供了几个专门的工具:
/how------追踪系统当前行为
读代码,回答"这个系统现在是怎么工作的",不是猜,是基于代码实际内容给出运行时流程、关键类型、非显而易见的部分。对于大系统,会先派 2 到 4 个只读 explorer 并行扫描,再汇总。
/why------挖掘历史决策
追溯"为什么这个限制是 5"、"当初这么设计的理由还成立吗"。它会查 git 历史、issue tracker、团队聊天记录、文档,然后给出一份带来源引用的报告。直接证据和推断会分开标注,找不到答案也会明说"没有人记录过原因"------这本身也是一个答案。
/arena------多方案竞争
N 个 subagent 并行尝试同一个设计任务,各自在独立的 worktree 里工作,然后由一个不同模型家族的评审 agent 按照统一的评分标准打分,最后由协调者把胜出方案和落选方案里的好东西合并起来。
/interrogate------多模型交叉 Review
把同一份 diff 发给几个不同模型家族的 reviewer,让它们各自找问题。不同模型有不同盲区,两个模型独立报出的同一个问题,置信度会高很多。Lead reviewer 会把所有发现分成四类:Act on / Consider / Noted / Dismissed,每个 Dismissed 都附有理由。
对 Plan Mode 的批评
这一段我很认同,直接引用:
"Plan Mode 常被用来说服自己 agent 会做正确的事。但现实是,抽象的计划只给你一种生产力的错觉。一份长篇大论的计划看起来很有成效,但可能缺乏实质。"
pstack 的思路是:用详尽的调查(/how + /why)、实证证据(验证技能)、严格验证(行为检查)来取代长篇计划。计划的价值在于它是否基于真实证据,而不在于它有多长。
23 条工程原则
pstack 里内置了 23 条工程原则,agent 在执行任务时会加载相关原则,并在回复里说明哪条原则影响了哪个决策。
这些原则的使用方式很巧妙:不是用来背的,是用来"steering"的。 当你发现 agent 在做一件不对的事,你可以用原则的名字来精准纠正,而不是重新解释一遍:
"apply prove it works. show me the real output, not the build log."
"use subtract before you add. delete the obsolete adapters first, then design what's left."
每条原则背后是一份完整的规则说明,agent 已经读过,所以一个短语就能精确重定向行为。
挑几条我觉得最有实际价值的:
核心原则
- Laziness Protocol:优先删除,做能解决问题的最小变更
- Subtract Before You Add:先去掉死重,再在上面建东西
- Attack the Premise:两个以上修复尝试都失败了,停下来质疑它们共享的前提
- Minimize Reader Load:折叠读者必须记在脑子里的层和隐藏状态
- Build the Lever:写一个能做这件事或能证明这件事的脚本,让 reviewer 可以重跑
架构原则
- Model the Domain:把重复的业务规则编码进一个结构,而不是散落各处的条件判断
- Boundary Discipline:在边界处验证,信任内部类型
- Type System Discipline:让非法状态在类型层面就不可表示
- Migrate Callers Then Delete Legacy APIs:迁移调用方和删除旧 API 在同一个 PR 里完成
验证原则
- Prove It Works:验证真实产物,不是代理指标。"It compiles" 不是证据
- Fix Root Causes:先重现问题、追溯到根因,再改代码
- Test Behavior, Not Implementation:以用户调用代码的方式来测试,断言字面预期值
委托原则
- Guard the Context Window:把大量阅读路由给 subagent,把结论留在主对话
- Never Block on the Human:可逆的工作继续推进,把结果展示给人,而不是停下来等许可
元原则
- Encode Lessons in Structure:你重复过两次的建议,应该变成 lint 规则、CI 检查或者脚本
Overnight Run:让 agent 整夜工作
这是整套系统的"payoff"------前面所有基础打好之后,你才可以放心地让 agent 整夜自主工作。
关键不是"信任",是结构化的合约。Lauren 给出的模板:
bash
我要睡觉了。在一个 fresh worktree 里把所有 caller 迁移到新 parser。
完成条件:0 个旧 caller,所有 parser fixtures 通过,旧 API 已删除。
保留决策日志。不要在提交前问我。
/loop 直到完成。如果真的卡住了,停下来写清楚原因。
逐行拆解:
- "我要睡觉了"------会话覆盖,agent 停止等待人类输入,继续推进
- "完成条件"------每次迭代可以自动运行的检查,pass/fail 是明确的
- "fresh worktree"------和你本地的其他工作物理隔离,不会冲突
- "不要问我"------预先回答了 agent 本来会等待的权限问题
- "如果卡住了,写清楚原因"------逃生舱,胜过 8 小时的目标偏移
一个常见的坑:"工作 4 小时"不是一个合法的完成条件。这给 agent 的是一段时间,不是一个可以验证的状态。你会在早上发现 4 小时的动态,而不是一个结果。
Overnight Run 每次迭代的核心循环:
一个变更、一次检查、一行日志,每次迭代都这样。没有帮助的变更被丢弃,不会留下来。连续没有进展意味着换方向,不是停下来,完成条件永远不会悄悄放宽来宣布胜利。
早上审计
/show-me-your-work 生成一份决策日志(TSV 格式),记录每次迭代的时间、阶段、决策、原因、证据指针、结果。
更关键的是:它会用另一个不同模型家族的 agent 去读这份日志和整夜的 transcript,然后给你一份"哪些地方值得你关注"的摘要。 你审计的是关键决策,不是逐行重读整夜的工作。
用 Cursor 官方研究来交叉验证
Cursor 在 2026 年 2 月发了一篇博客 "Towards self-driving codebases",讲的是他们内部的一个研究项目:建了一个能同时运行数千个 agent 的系统,连续跑了一周,让 agent 自主构建了一个 Web 浏览器,产出了绝大部分 commit。
这篇博客有几个核心结论,逐条和 Lauren 的方法论对比。先放一张汇总表,下面逐条展开:
| 结论 | Cursor | Lauren | 一致性 |
|---|---|---|---|
| 复杂任务必须拆解 | ✅ | ✅ | 完全一致 |
| 约束比指令更有效 | ✅ | ✅ | 完全一致,Lauren 更彻底 |
| 给意图不给步骤 | ✅ | ✅ | 完全一致 |
| 接受错误率换吞吐量 | ✅ | ⚠️ 更强调预防 | 方向一致,策略不同 |
| 移除中央协调者 | ✅ | ❌ 强协调者 | 分歧,规模决定架构 |
| 实证驱动 | ✅ | ✅ | 完全一致 |
| 人类负责判断 | ✅ | ✅ | 完全一致 |
结论一:单 agent 处理复杂任务会迷失,必须拆解
Cursor 发现,让单个 agent 负责"构建一个浏览器",它很快就迷失方向,频繁停下来宣称成功,尽管离目标还很远。核心问题是任务太大,必须拆解成子任务。
Lauren 的原子 PR、playbook 自动拆解,本质上解决的是同一个问题。两者完全一致。
结论二:约束比指令更有效
Cursor 原文:
"Constraints are more effective than instructions. 'No TODOs, no partial implementations' works better than 'remember to finish implementations.'"
Lauren 的做法更彻底:不只约束 agent 的行为,直接封死违规的路径(CI 依赖图检查、lint 禁用危险模式)。两者完全一致,Lauren 的执行更硬核。
结论三:给意图,不给步骤
Cursor 发现,给 agent 列具体步骤,会让它只完成被列出的事,忽略没被列出但同样重要的事。高层任务应该给意图,让 agent 自己找路径。
Lauren 说同一件事的版本:
"不要告诉 agent 每一步该做什么。告诉它你想要什么,以及你怎么知道它完成了。"
完全一致。
结论四:接受错误率换吞吐量
Cursor 的研究项目明确做了一个取舍:接受一个小但稳定的错误率,最后做一次 reconciliation pass,而不是追求每一步都完美从而大幅拖慢系统。
Lauren 的模式不同:她更强调在合入前拦截问题,Shipping playbook 要求每个 PR 独立通过验证才合入。
这里两者有分歧,原因是场景不同。 Cursor 的研究项目是构建一个独立的浏览器,可以接受事后清理;Lauren 维护的是生产环境的真实产品,事后修复成本更高。企业落地时要先判断自己的系统属于哪一类。
结论五:移除中央协调者
Cursor 在系统演进过程中移除了中央协调者角色,让 worker agent 之间直接协调。
Lauren 的 /poteto-mode 本质是一个强中央路由器。
两者方向不同。 这不是谁对谁错的问题,是规模问题。几十个 agent 的系统,中央协调者能提供质量控制;几千个 agent 的系统,协调者本身会成为瓶颈。企业落地先从中央协调者模式开始,等规模真的成为瓶颈再考虑去中心化。
结论六:实证驱动,而非假设驱动
Cursor 说:
"Empirical over assumption-driven. We wanted to use data and observation to make adjustments, rather than coming in with assumptions based on human organizations."
Lauren 的 23 条原则和 22 个 playbook,全部来自她和团队的真实失败案例,不是理论推导。
完全一致。 大多数团队在设计 AI 工作流时,会不自觉地把人类工作流程映射进去。但 agent 的失败模式和人类完全不同,用人类流程去约束 agent,往往在最需要约束的地方没有约束,在不需要约束的地方过度约束。
结论七:人类的角色
Cursor 的博客结尾:
"While taste, judgement, and direction came from humans, AI was a significant force-multiplier."
Lauren 的 Outer Loop / Inner Loop 划分,说的是同一件事。
完全一致,也是整套系统最根本的前提。
业界数据:这些方法到底有多大用
方法论说得再好,还是要看数据。我查了几篇相关研究。
AI Code Review 的真实有效性
一篇来自墨尔本大学和莫纳什大学的论文,分析了 CodeRabbit 在真实 GitHub 项目中的 31,073 条 review 评论,开发者对 AI review 的反馈分布:
拒绝的主要原因:false positive、超出范围、与开发者意图不符。LLM 的评论 75.9% 集中在功能性问题上,对长期可维护性问题的覆盖率在持续下降。
另一篇大规模研究(24,005 个 review 实例)按问题类型对比 LLM 和人类 reviewer 的表现:
| 问题类型 | LLM Review 表现 |
|---|---|
| 代码风格/命名/格式 | 与人类持平 |
| 简单逻辑错误 | 较好 |
| 功能缺陷 | 中等,false positive 率较高 |
| 架构问题 | 87% 被遗漏 |
| 可演化性/长期维护性 | 覆盖率低且持续下降 |
这两个数据放在一起,结论很清楚:多模型 review 对风格统一和明显错误有价值,但不能替代人类的架构判断。 Lauren 的系统里,/interrogate 是辅助手段,最终的架构决策还是她自己在做。
企业实测:AI 代码的 review 瓶颈
CMU 和 Stanford 的一篇论文,跟踪了一家企业在强制推行 AI 编码工具后的 196,212 个 PR,核心数据:
| 指标 | 政策前 | 政策后 | 变化 |
|---|---|---|---|
| 人均 PR 吞吐量 | 基线 | 2.09x | +109% |
| AI 生成 PR 的 review 周期 | 基线 | +20~22% | 变慢 |
| 人类 substantive review 占比 | 39% | 21% | -18pp |
| 自动化 AI review 覆盖率 | ~19% | ~84% | +65pp |
| Merge 率 | 稳定 | 稳定 | 无显著变化 |
| Revert 率 | 基线 | 略降 | 无质量崩溃 |
这篇论文没有说"自动化 review 优于人类 review",它说的是:在 AI 大幅提升代码产出的情况下,人类 review 能力没有同步提升,企业被迫将 review 转移给自动化,而这个转移在粗粒度质量指标上没有造成崩溃。
这是一个更诚实的描述。质量没有崩溃,但风险被转移了,不是被消除了。
落地路线:什么能直接用,什么还需要人
先放一张全景表,再逐块展开:
现在就能落地的
机械约束(性价比最高)
lint 规则、CI 依赖图检查、目录结构约束、类型系统约束。这些不需要 AI,今天就能做,对 AI 和人类都有效。
验证技能
建立 Feature Map,定义"每个功能正常的证据是什么",让 agent 能自我闭环。这是 Overnight Run 的前提。
原子 PR 规范
每个 PR 做一件事,可以被独立验证和回滚。这是所有后续自动化的基础。
Indirect Prompt
让 agent 先复述问题再动手。成本几乎为零,收益立竿见影。
需要人工持续的
架构决策
87% 架构问题被 LLM 遗漏,这个数据短期内不会根本改变。架构层的判断需要深度理解业务上下文和演进方向,这部分必须有人。
验证技能的维护
Feature Map 会随代码演进腐化,需要持续投入。
原则库的维护
随着代码库和业务演进,新的问题模式需要新的原则,旧的原则可能失效。这需要一个 owner。
暂时不要尝试的
- 让 agent 自主做架构决策
- 完全无人值守的新功能开发
- 用多模型 review 替代人工架构评审
最后
Lauren 这套系统能做到每月 1000+ PR,核心原因不是工具本身,是三个前提条件的叠加:
- 她个人对 Grok Bot 的架构和业务有极深的理解,所有高层判断都是她在做
- 600 多个重构 PR 打下的架构地基,让 agent 的"最短路径"就是"正确路径"
- 她把大量隐性工程判断显性化,编码成了 agent 可以执行的结构
少了任何一个前提,这套系统的效果会大打折扣。
AI 生成代码的速度提升了 10 倍,但人类做架构判断、业务理解、意图对齐的速度没有同步提升。这意味着瓶颈已经从"写代码"转移到了"定义问题和判断方向"。
Cursor 的博客和 Lauren 的文章,在这个最根本的判断上完全一致:工具会越来越好,但 taste、judgment、direction,仍然来自人。
参考来源:
- pstack 官方文档:github.com/cursor/plugins/tree/main/pstack
- Lauren Tan pstack Guide Part 1 & 2(X / Thread Navigator)
- Cursor 官方博客:Towards self-driving codebases,2026 年 2 月
- "Is Agentic Code Review Helpful?",University of Melbourne / Monash University,2026
- "AI Writes Faster Than Humans Can Review",CMU / Stanford,2026