问"加一套审批流要写多少代码",很少有人能给出可信答案。原因不是大家懒得算,而是这句问话里其实混着三件事:给现有项目接一个现成引擎、从零做一套带审批的后台、自己造一个引擎。这三档的工期差两个数量级,却被同一句话压在一起。
这次我把第一档的数拿实了:jeeflow 已经在 13 个框架上各接入过一次,每一层的 diff 都还在 git 里。我把它们一个一个数了一遍,包括我自己数错的两次。
一、先交代我数错的两次
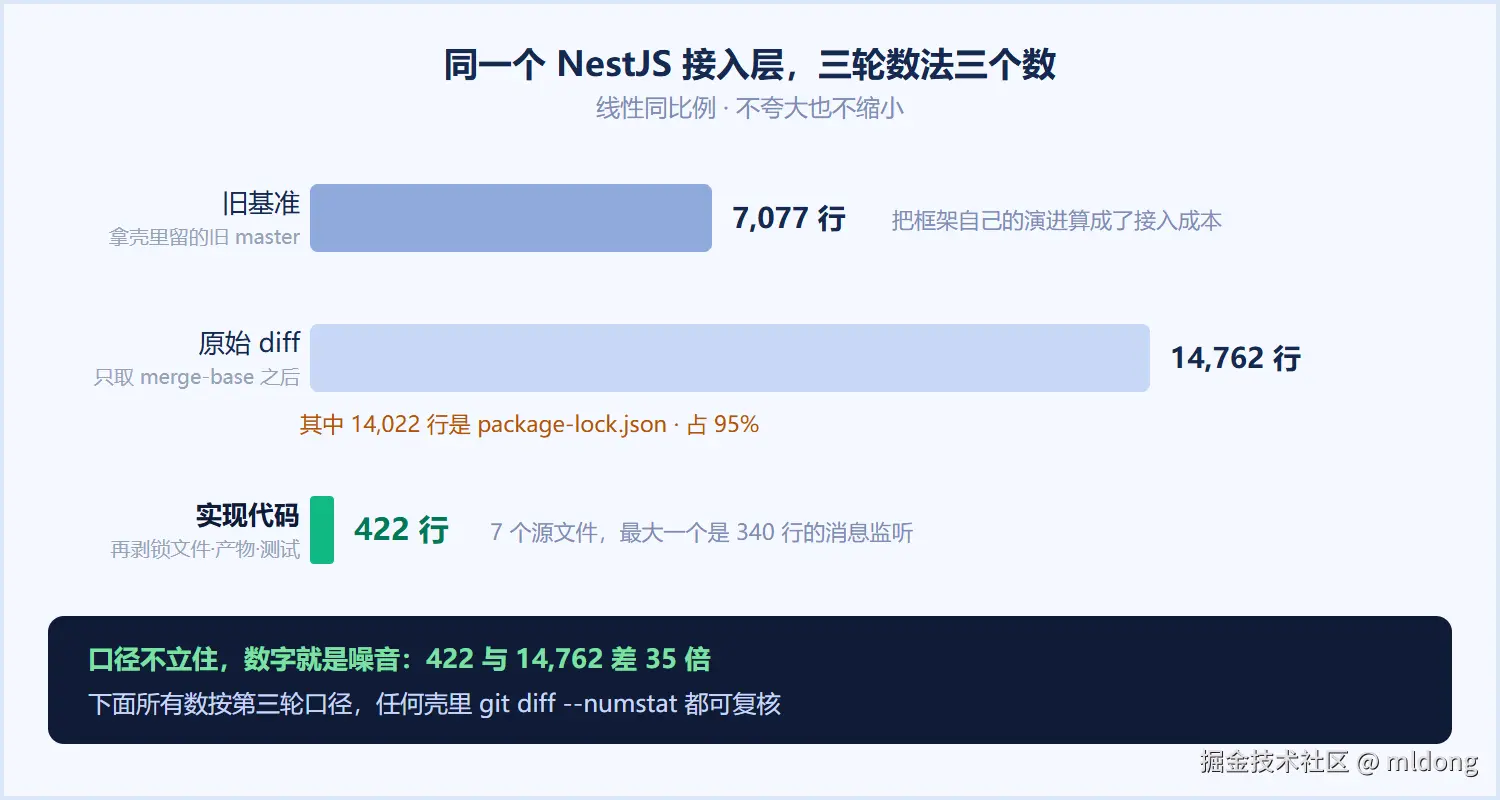
第一轮,我用集成壳里留着的 master 引用取合并基线。结果 NestJS 报出 7,077 行------那里面大半是框架自己这两个月的演进,跟"接入审批流"没有一行关系。基准必须从隔壁基础仓重新 fetch 之后再取。
第二轮,基准对了,git diff --shortstat 吐出来 14,762 行,比第二名整整多一个数量级。我盯着这个数看了半分钟才反应过来,去翻文件列表:
bash
package-lock.json                                    14022 +
src/modules/wf/core/wf-message.listener.ts              340 +
src/modules/wf/controller/wf.controller.ts               21 +-
14,022 行是一个锁文件,占掉 95%。它确实是这次提交写进去的,但没有任何人会在排期时把它算成"审批模块的开发量"。
第三轮才是下面用的口径:只统计新增和修改的文件(删除单独记一笔,不然"清掉旧引擎"会被记进接入成本),再剥掉锁文件、dist/ 这类产物和测试代码。
按这个口径,NestJS 那 14,762 行缩成 422 行,7 个源文件,最大的一个是 340 行的消息监听。虚报了 35 倍。
口径不先立住,后面所有数字都是噪音。所以这张文里每一个数,你都可以在任意一个集成仓里 git fetch 对应框架仓库、git diff --numstat <merge-base> HEAD 复现一遍。
二、13 个框架,422 到 1,798 行
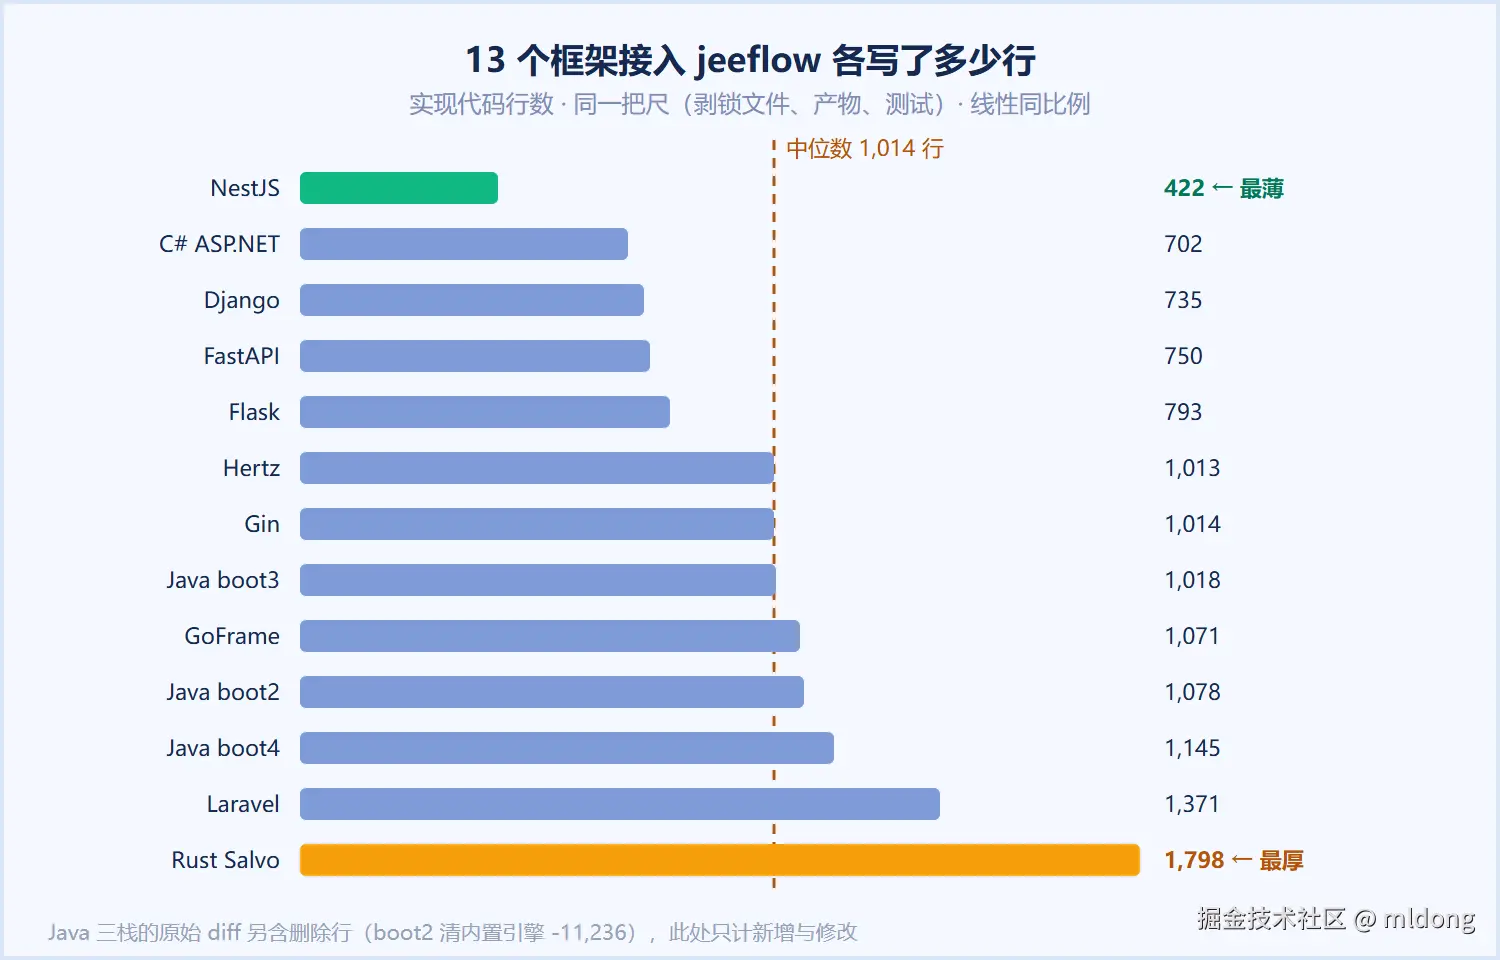
| 框架 | 实现代码 | 消息监听 | HTTP 转发 | SPI 对接 | 装配与工厂 | 字典与元数据 |
|---|---|---|---|---|---|---|
| NestJS | 422 | 340 | 19 | 0* | 63 | 0 |
| C# ASP.NET Core | 702 | 206 | 99 | 159 | 23 | 103 |
| Django | 735 | 207 | 50 | 0* | 266 | 202 |
| FastAPI | 750 | 276 | 52 | 0* | 414 | 8 |
| Flask | 793 | 276 | 49 | 0* | 441 | 27 |
| Hertz | 1,013 | 299 | 222 | 100 | 365 | 13 |
| Gin | 1,014 | 299 | 224 | 100 | 365 | 13 |
| Java boot3 | 1,018 | 317 | 162 | 395 | 118 | 26 |
| GoFrame | 1,071 | 298 | 242 | 103 | 385 | 0 |
| Java boot2 | 1,078 | 317 | 164 | 441 | 130 | 26 |
| Java boot4 | 1,145 | 317 | 162 | 441 | 130 | 95 |
| Laravel | 1,371 | 261 | 159 | 421 | 349 | 0 |
| Rust Salvo | 1,798 | 752 | 135 | 264 | 634 | 0 |
中位数 1,014 行,最厚与最薄差 4.3 倍。
换成原始 git diff(把测试和构建元数据算回来),同一批壳落在 702 到 1,852 行:最薄还是 C# 的 12 个文件,最厚还是 Salvo 的 21 个文件。
带 * 的几栏是分类假象,不是没写。Python 三栈和 NestJS 把用户、组织架构这些对接逻辑直接写进了 jeeflow_factory.py 这类装配文件里,按文件名归类就成了 0。它们确实在,只是没单独成文件------这本身就是个信息:文件怎么切,由语言生态的习惯决定;要写多少逻辑,由引擎留给你填的口子决定。
三、这一千行到底是什么
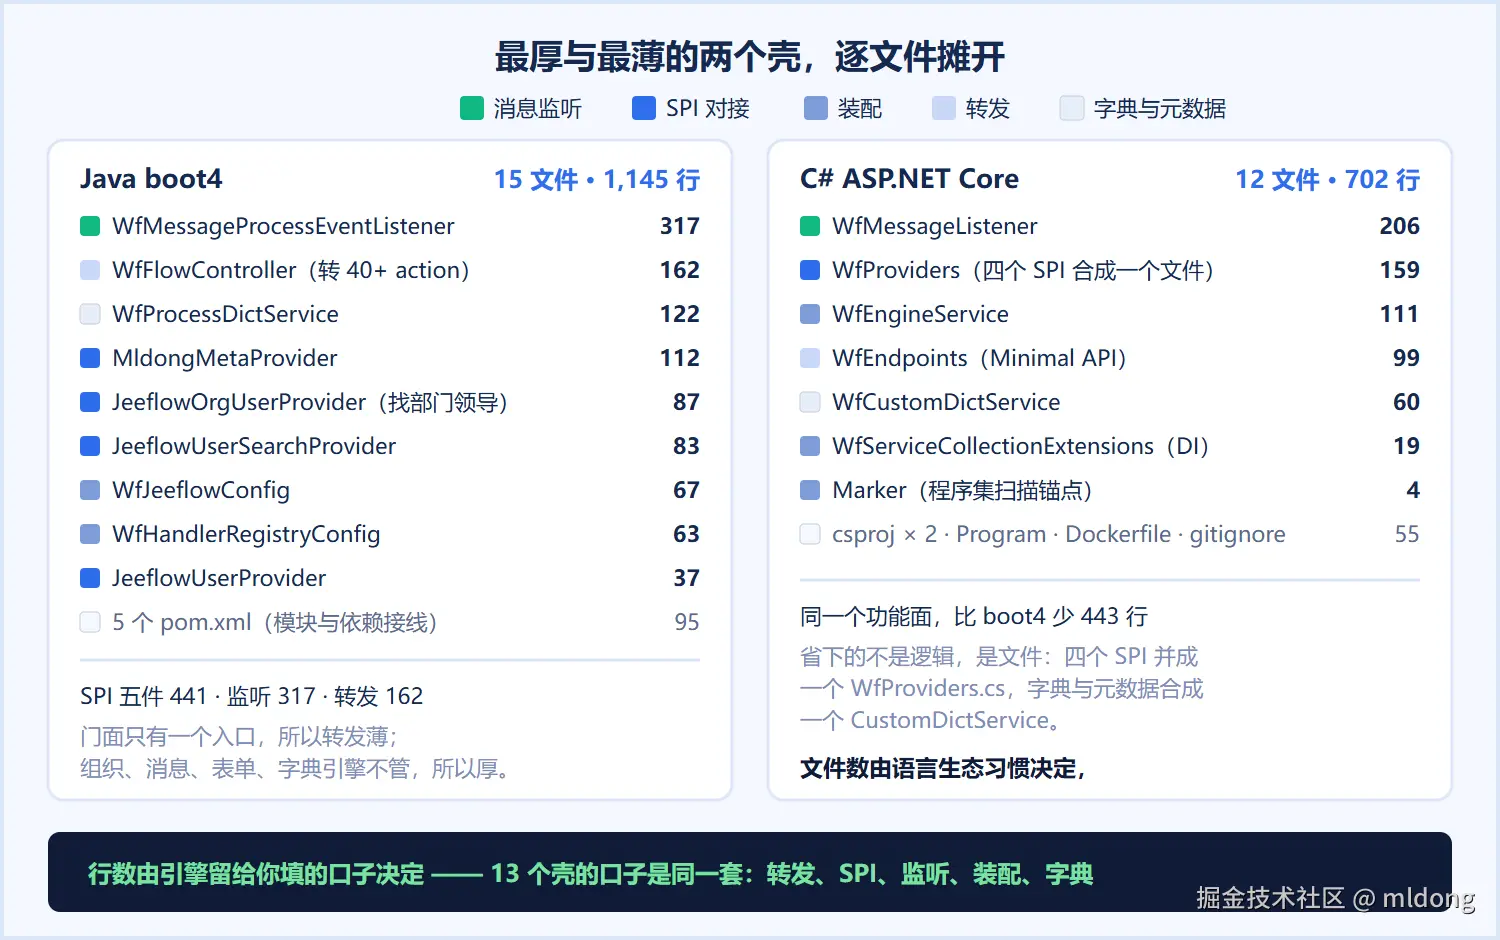
把最厚的 Java boot4 和最薄的 C# 逐文件摊开对照,会发现两边其实是同一套东西,只是切法不同。
boot4 的 1,145 行里:一个 WfMessageProcessEventListener 317 行负责听引擎事件写站内信;一个 WfFlowController 162 行把 40 多个 action 全转出去;WfProcessDictService 122 行和 MldongMetaProvider 112 行给流程设计器供字典与表单元数据;三个 provider 共 207 行回答"当前用户是谁、他部门领导是谁、怎么按名字搜人";两个 config 130 行把引擎实例挂进 Spring 容器;剩下 95 行是 5 个 pom.xml 的模块接线。
C# 的 702 行做的是同一件事:监听 206、四个 SPI 合并成一个 159 行的 WfProviders.cs、引擎服务 111、Minimal API 转发 99、字典 60、DI 注册 19。
比 boot4 少的 443 行,省的不是逻辑,是文件。 Java 要一个类一个文件、要有包名、要有独立的配置类和注册器;C# 一个文件塞四个类就行。
四、最厚的那块不是流程,是发消息和找人
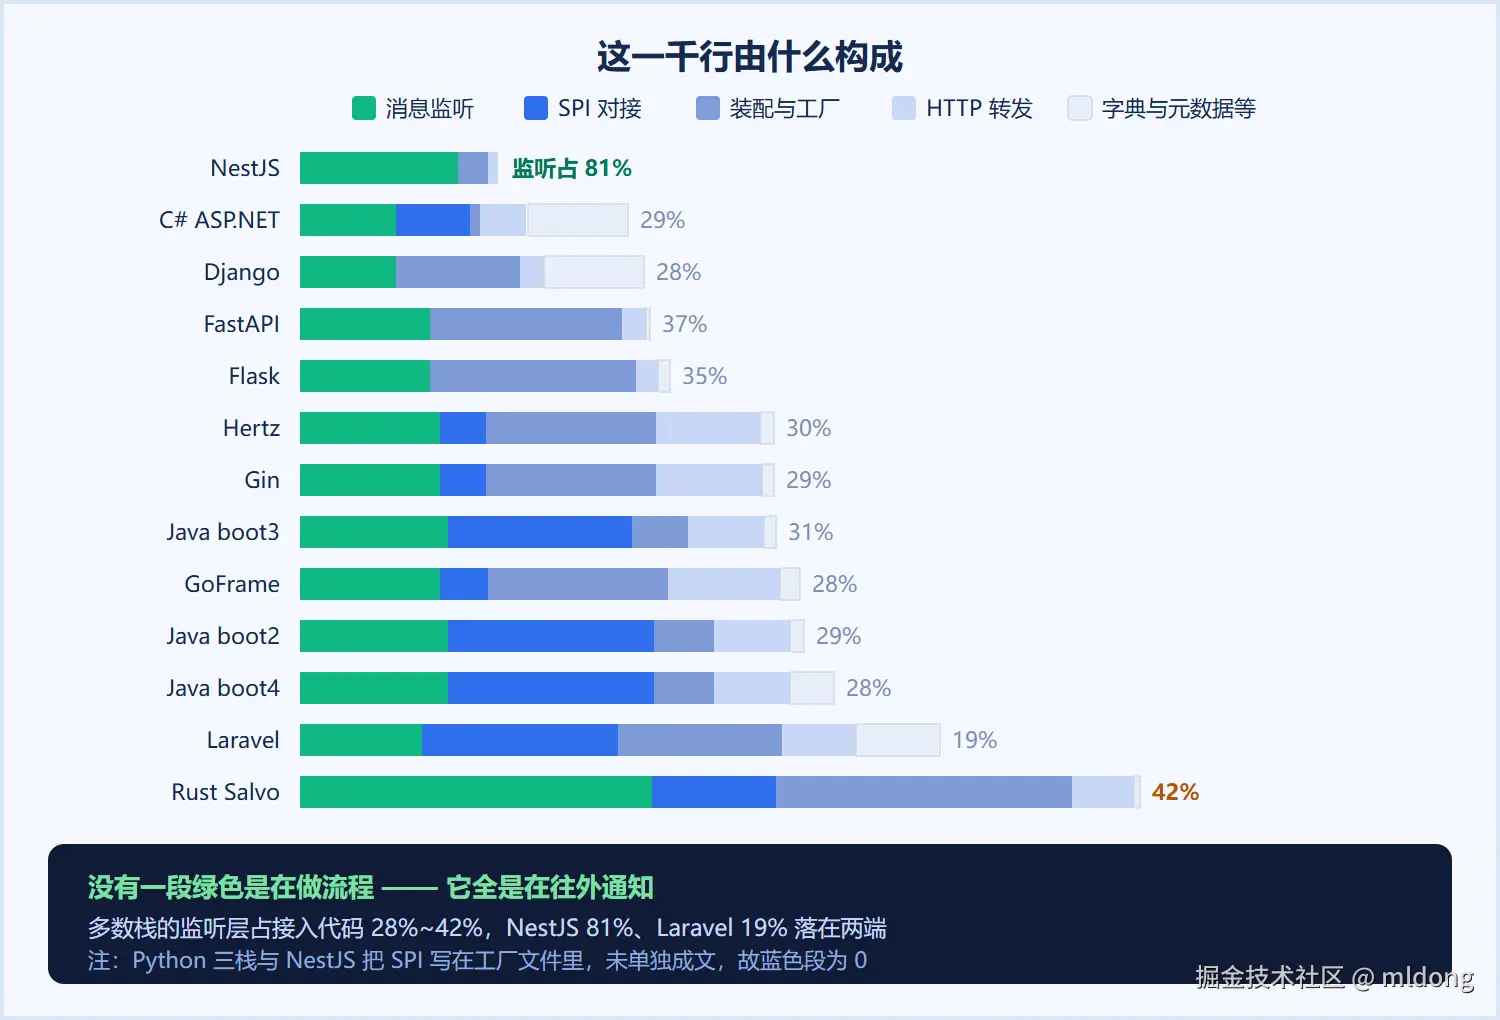
把 13 个壳按职责堆起来看,绿色那段(消息监听)在每一行里都占着一大块:206 到 752 行,多数栈落在 28%~42%,NestJS 高到 81%、Laravel 低到 19%。
引擎本体那一块呢?0 行。因为流程流转的代码根本不在你仓库里。
原因很直接:引擎故意不发消息。 它的输入是"谁在哪个节点做了什么",输出是"下一个该谁做",不需要知道你们公司用站内信、企业微信还是钉钉机器人,也不该知道。所以这一层是空的,等你填。
而这一层从来填不便宜。任务创建要给办理人发一条,办理完成要给发起人回一条,抄送要按 N 个人各发一条,驳回要换文案,超时要补提醒,然后还得管已读未读、跳转链接、消息分类。写少了漏提醒被业务方追着问,写多了同一件事轰炸三遍。Salvo 那 752 行就是这么来的。
"找人"是同一个道理。boot 系和 Laravel 那 400 行 SPI 全花在这上面------引擎只肯接受一个结果:"这个节点该谁办"。至于这个人是不是副职、他领导出差了要不要往上跳一级,是你的组织树说了算。
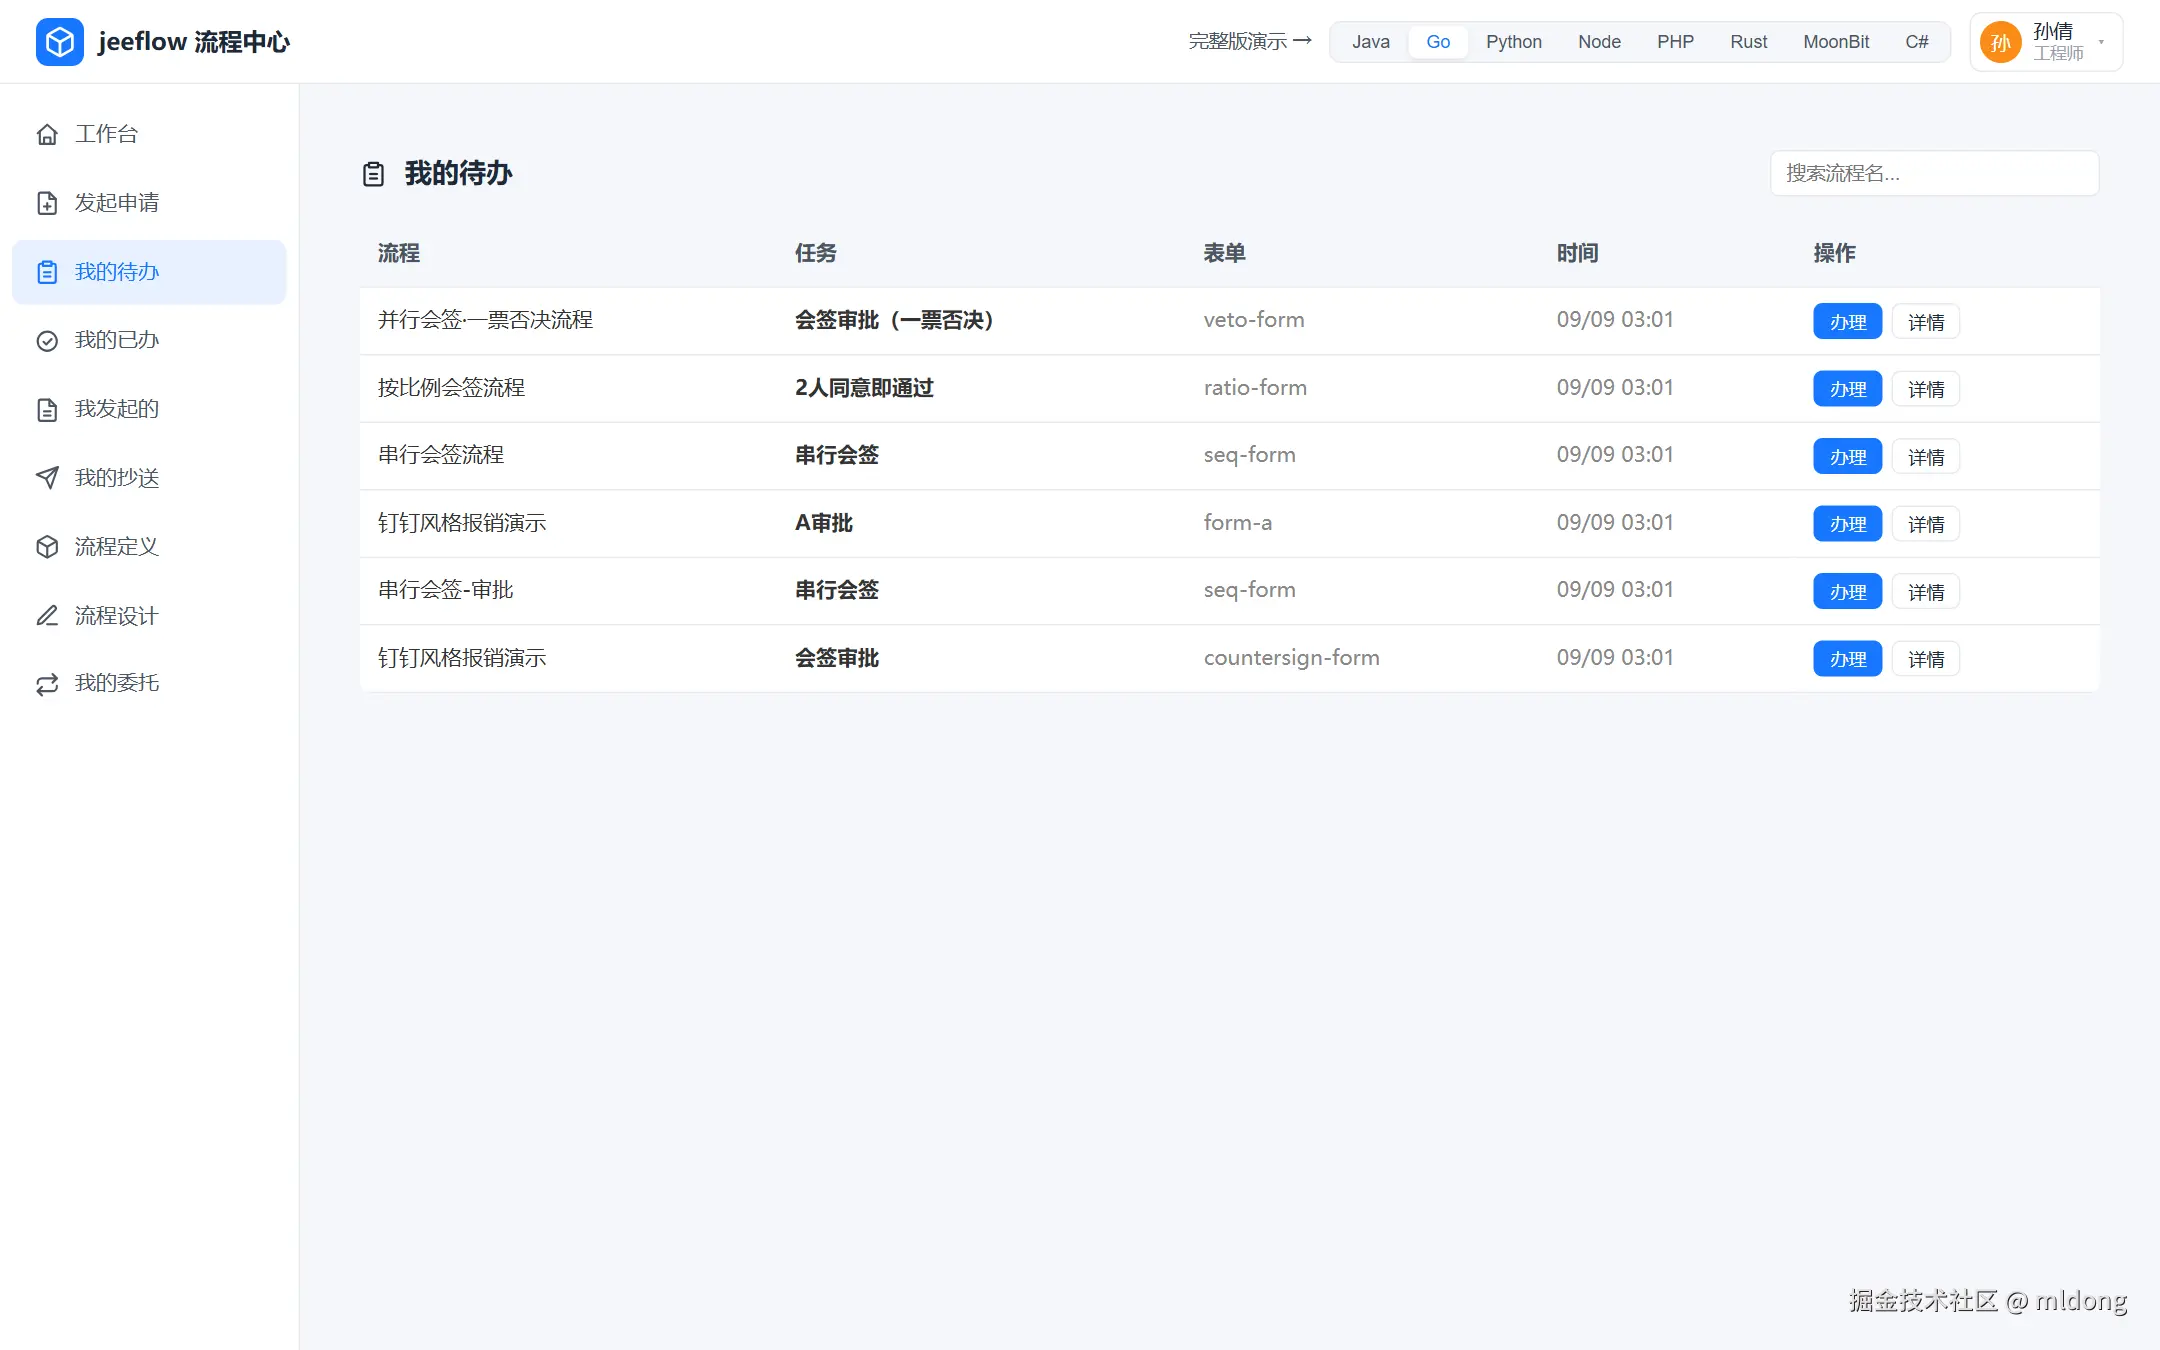
上面那一千多行换到界面上,就是这张图:一个 Go 后端,六条待办排在那儿,会签、一票否决、按比例通过、报销各占一行,点「办理」进去填表单写意见。这张截图来自公开演示站 jeeflow-demo.mldong.com/?lang=go,右上角切到 Java、Python、Node、PHP、Rust、MoonBit、C# 任何一格,左边这一列待办和中间这个办理抽屉都不用改一行代码------因为那 13 个壳里的转发层,最终都收敛到同一个门面入口。
五、第二笔账:换成引擎之后少了 11,226 行
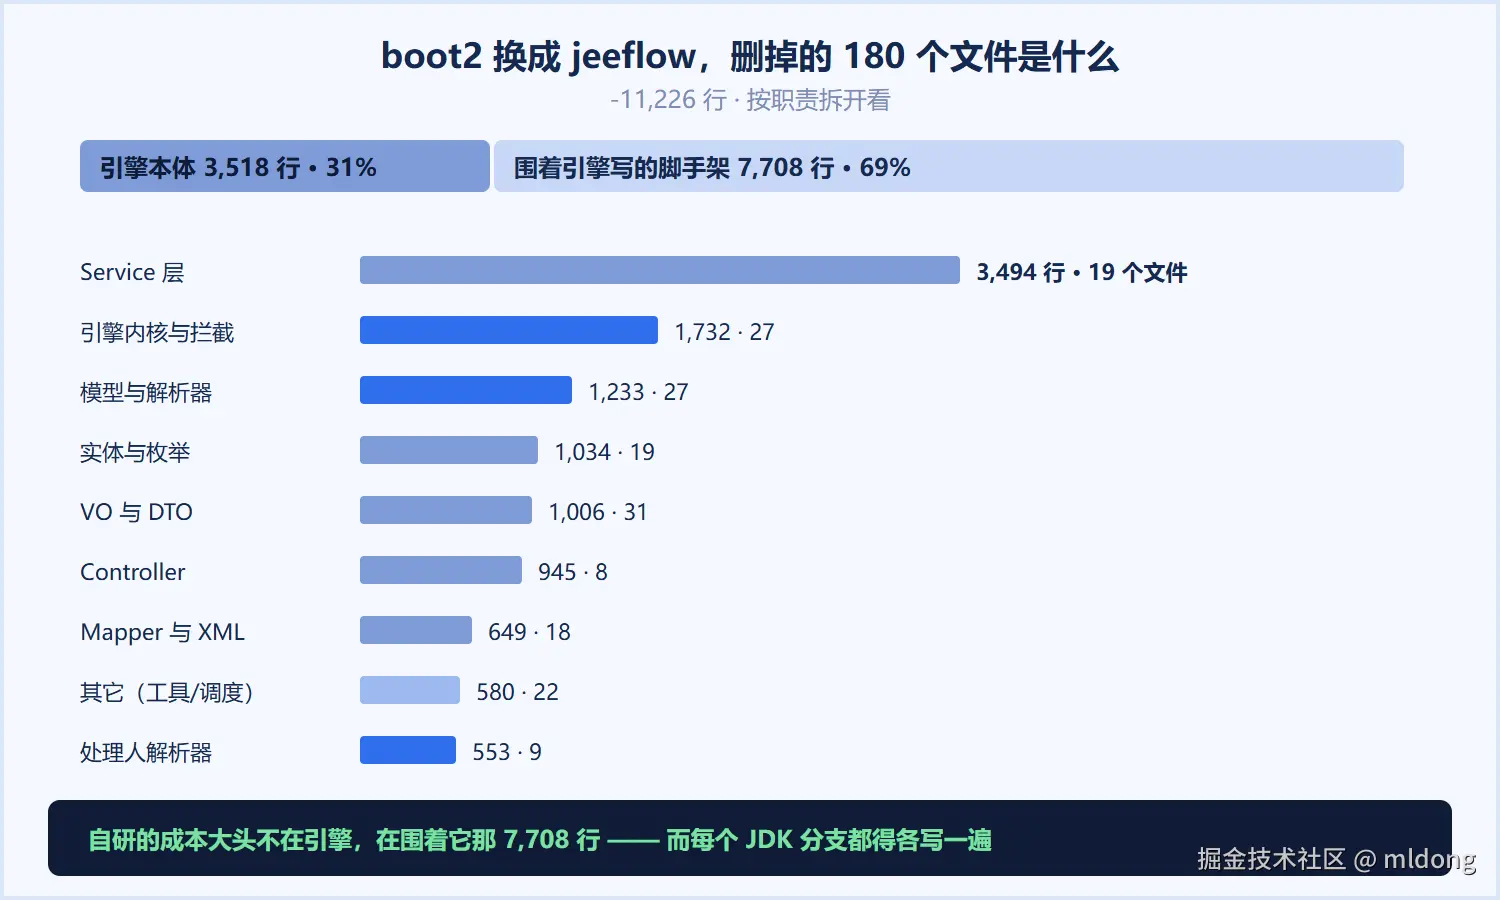
boot2 和 boot3 这两个壳特殊:它们本来自带一套内置工作流模块,切到 jeeflow 做的是减法。
新增 9 个、修改 3 个   →   +1,078 行
删除 180 个文件 → -11,226 行(git diff --shortstat 报 -11,236,多出的 10 行来自修改文件里的删除,按被删文件累加是 11,226。)
删掉的东西值得逐类看一眼,因为它说明了"自研一套审批流"的真实成本在哪:
| 删掉的类别 | 文件 | 行数 |
|---|---|---|
| Service 层 | 19 | 3,494 |
| 引擎内核与拦截 | 27 | 1,732 |
| 模型与解析器 | 27 | 1,233 |
| 实体与枚举 | 19 | 1,034 |
| VO 与 DTO | 31 | 1,006 |
| Controller | 8 | 945 |
| Mapper 与 XML | 18 | 649 |
| 其它(工具、调度) | 22 | 580 |
| 处理人解析器 | 9 | 553 |
引擎本体只占 3,518 行(31%),剩下 7,708 行(69%)全是围着它写的脚手架------Service、Mapper、VO、DTO、实体、枚举。
这才是"自研很贵"的准确说法。贵的不是那台状态机,是它周围必须长出来的一整圈数据访问和接口皮。而这圈东西,boot2 和 boot3 当年是各自维护一份的(boot3 那笔删除是 -11,265 行),同一套语义写两遍,还得保证行为一致、两边一起修 bug。
六、第三档:自己造一台引擎要多久
我把 jeeflow-csharp 的提交时间线拉出来当尺子。那是我最省的一次,因为前面已经有七种语言垫着:
09-06 01:07  M0  仓骨架 + 45 个 action 清单 + 5 个技术验证
09-06 01:33  M1  引擎核心 + 内存仓储,100 个用例绿
09-06 02:00  M2  MySQL 仓储 + 事务模板,真库 120 用例绿
09-06 02:53  M3  持久化与门面 45 个 action,153 用例全绿
09-06 03:07  M4  demo 起服务 + 冒烟 20/20
09-06 03:28  M5  发版就绪收口
2 小时 21 分,一台新语言的工作流引擎。
然后从 09:31 到 12:01,又花掉两个半小时处理跟引擎一点关系都没有的事:发布流水线里 API Key 的输出名大小写写错导致 401、宿主机内存紧张 CoreCLR 起不来要压 GC 上限、老版本 Docker 的 seccomp 拦掉运行时系统调用、CI 机器上没有 Python 逼着把冒烟脚本改成纯 shell。
所以第三档的账要这么算:引擎本体两小时能立起来,把它变成别人能直接用的东西再搭半天进去,而这还只是一台引擎。 流程设计器、审批前端、移动端、八种语言之间的契约对齐和文档,都是另外的账。
七、三档工期,以及怎么自己动手验
| 你在哪一档 | 量级 | 真正花时间的是 |
|---|---|---|
| ① 已有项目接现成引擎 | 千行级,一到两天 | 消息监听和组织架构对接,不是流程 |
| ② 从零要一套带审批的后台 | 一周级 | 权限、组织、表单、附件这些引擎之外的东西 |
| ③ 自己造引擎 | 月级起,且要一直养 | 八种语义对齐、跨版本回归、别人提的 issue |
第一档最实在的验证方式不是读我这篇文章,是在你自己的机器上跑一遍。十三套后端都配了一键部署脚本,挑你熟的栈,一条命令起一个带完整审批流的环境:
bash
curl -fsSL https://www.mldong.com/deploy/mldong-boot4-jeeflow/deploy.sh | bashGo 系换 mldong-goframe-jeeflow / mldong-gin-jeeflow / mldong-hertz-jeeflow,Python 系 mldong-fastapi-jeeflow / mldong-flask-jeeflow / mldong-django-jeeflow,其余 mldong-nestjs-jeeflow、mldong-laravel-jeeflow、mldong-salvo-jeeflow、mldong-csharp-jeeflow、mldong-boot2-jeeflow、mldong-boot3-jeeflow 同名同规则。起来之后登录进去,流程设计、发起、待办、审批、抄送、统计全都在------就是第四节那张图的那一屏。
参考资料
- jeeflow 引擎文档站 jeeflow-doc.mldong.com
- 八语言引擎演示站(同一份流程定义逐个对比) jeeflow-demo.mldong.com
- 框架集成演示站 jeeflow-pro.mldong.com
- GitHub 组织 github.com/mldong (jeeflow-java / go / python / node / php / rust / moon / csharp)
- mldong 快速开发框架与一键部署 www.mldong.com