MySQL慢查询的解决思路
在项目实现中,MySQL的慢查询的查找我是通过开启慢查询日志(使用默认的2秒即为慢查询)来定位慢查询语句的;开启慢查询的配置文件
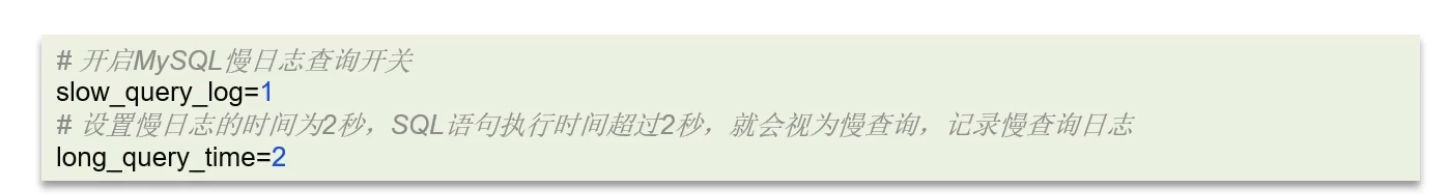
慢查询产生的原因是主要有一下几个查询语句:
聚合查询;多表查询;表数据量过大的查询。这几个慢查询可以通过explain来查看慢查询产生的原因:
key和key_len可以检查是否命中索引;type字段可以查看sql是否存在进一步优化的空间,是否催在全索引扫描或全盘扫描,全表扫描说明索引失败了,这时可以去检查索引主要看where,group by等约束的字段;全索引是使用了索引但还是便利了整个索引树。
extra字段可以判断是否出现回表的情况,如果出现了可以添加索引等修复
索引
索引就跟一本书的目录一样,如果使用普通的查找,我要找莫章节某一小节的内容,需要一页页的去找很麻烦,所以数据库采用了跟目录一样的一种数据结构(B+树),这样就能快速的根据"目录"快速的定位到数据了。
MySQL数据库的索引采用了B+树来存储数据的。基于为什么使用B+树,因为二叉树在出现极端情况下会出现只有左端或右端有叶子节点,这会使得数据的查询变成了0(n),红黑树虽然解决的这个问题但如果一个数据表中有成千上万条数据红黑树只有两个节点会非常膨大查询也会变得缓慢;B树解决了红黑树的困惑,B树会让这颗树永远只有三层,但MySQL官方没有使用B+树,MySQL官方使用了更加优秀的数据结构------B+树;B加树是在B树的基础上改造的,B+树只有叶子节点存储数据,其他节点只用来key和指针,只用来指路;并且叶子节点之间还用了双向链表相连接,为啥使用双向链表不使用红黑树这种?红黑树这种不是有序的数据需要采用双向便利来获取数据会多次使用磁盘io,即使他查找的速度快但是磁盘io比查找更致命。所以,使用B+树有几个有点:
1.阶数更少,路劲更短,查找的速度更快
2.磁盘io次数减少,非叶子节点只存储指针和key,叶子节点才存储数据,减少了查找过程中的磁盘io
3.B+数便于扫库和区间查询。因为叶子之间使用了双向链表。
聚集索引/非聚集索引/回表查询
什么是聚集索引?
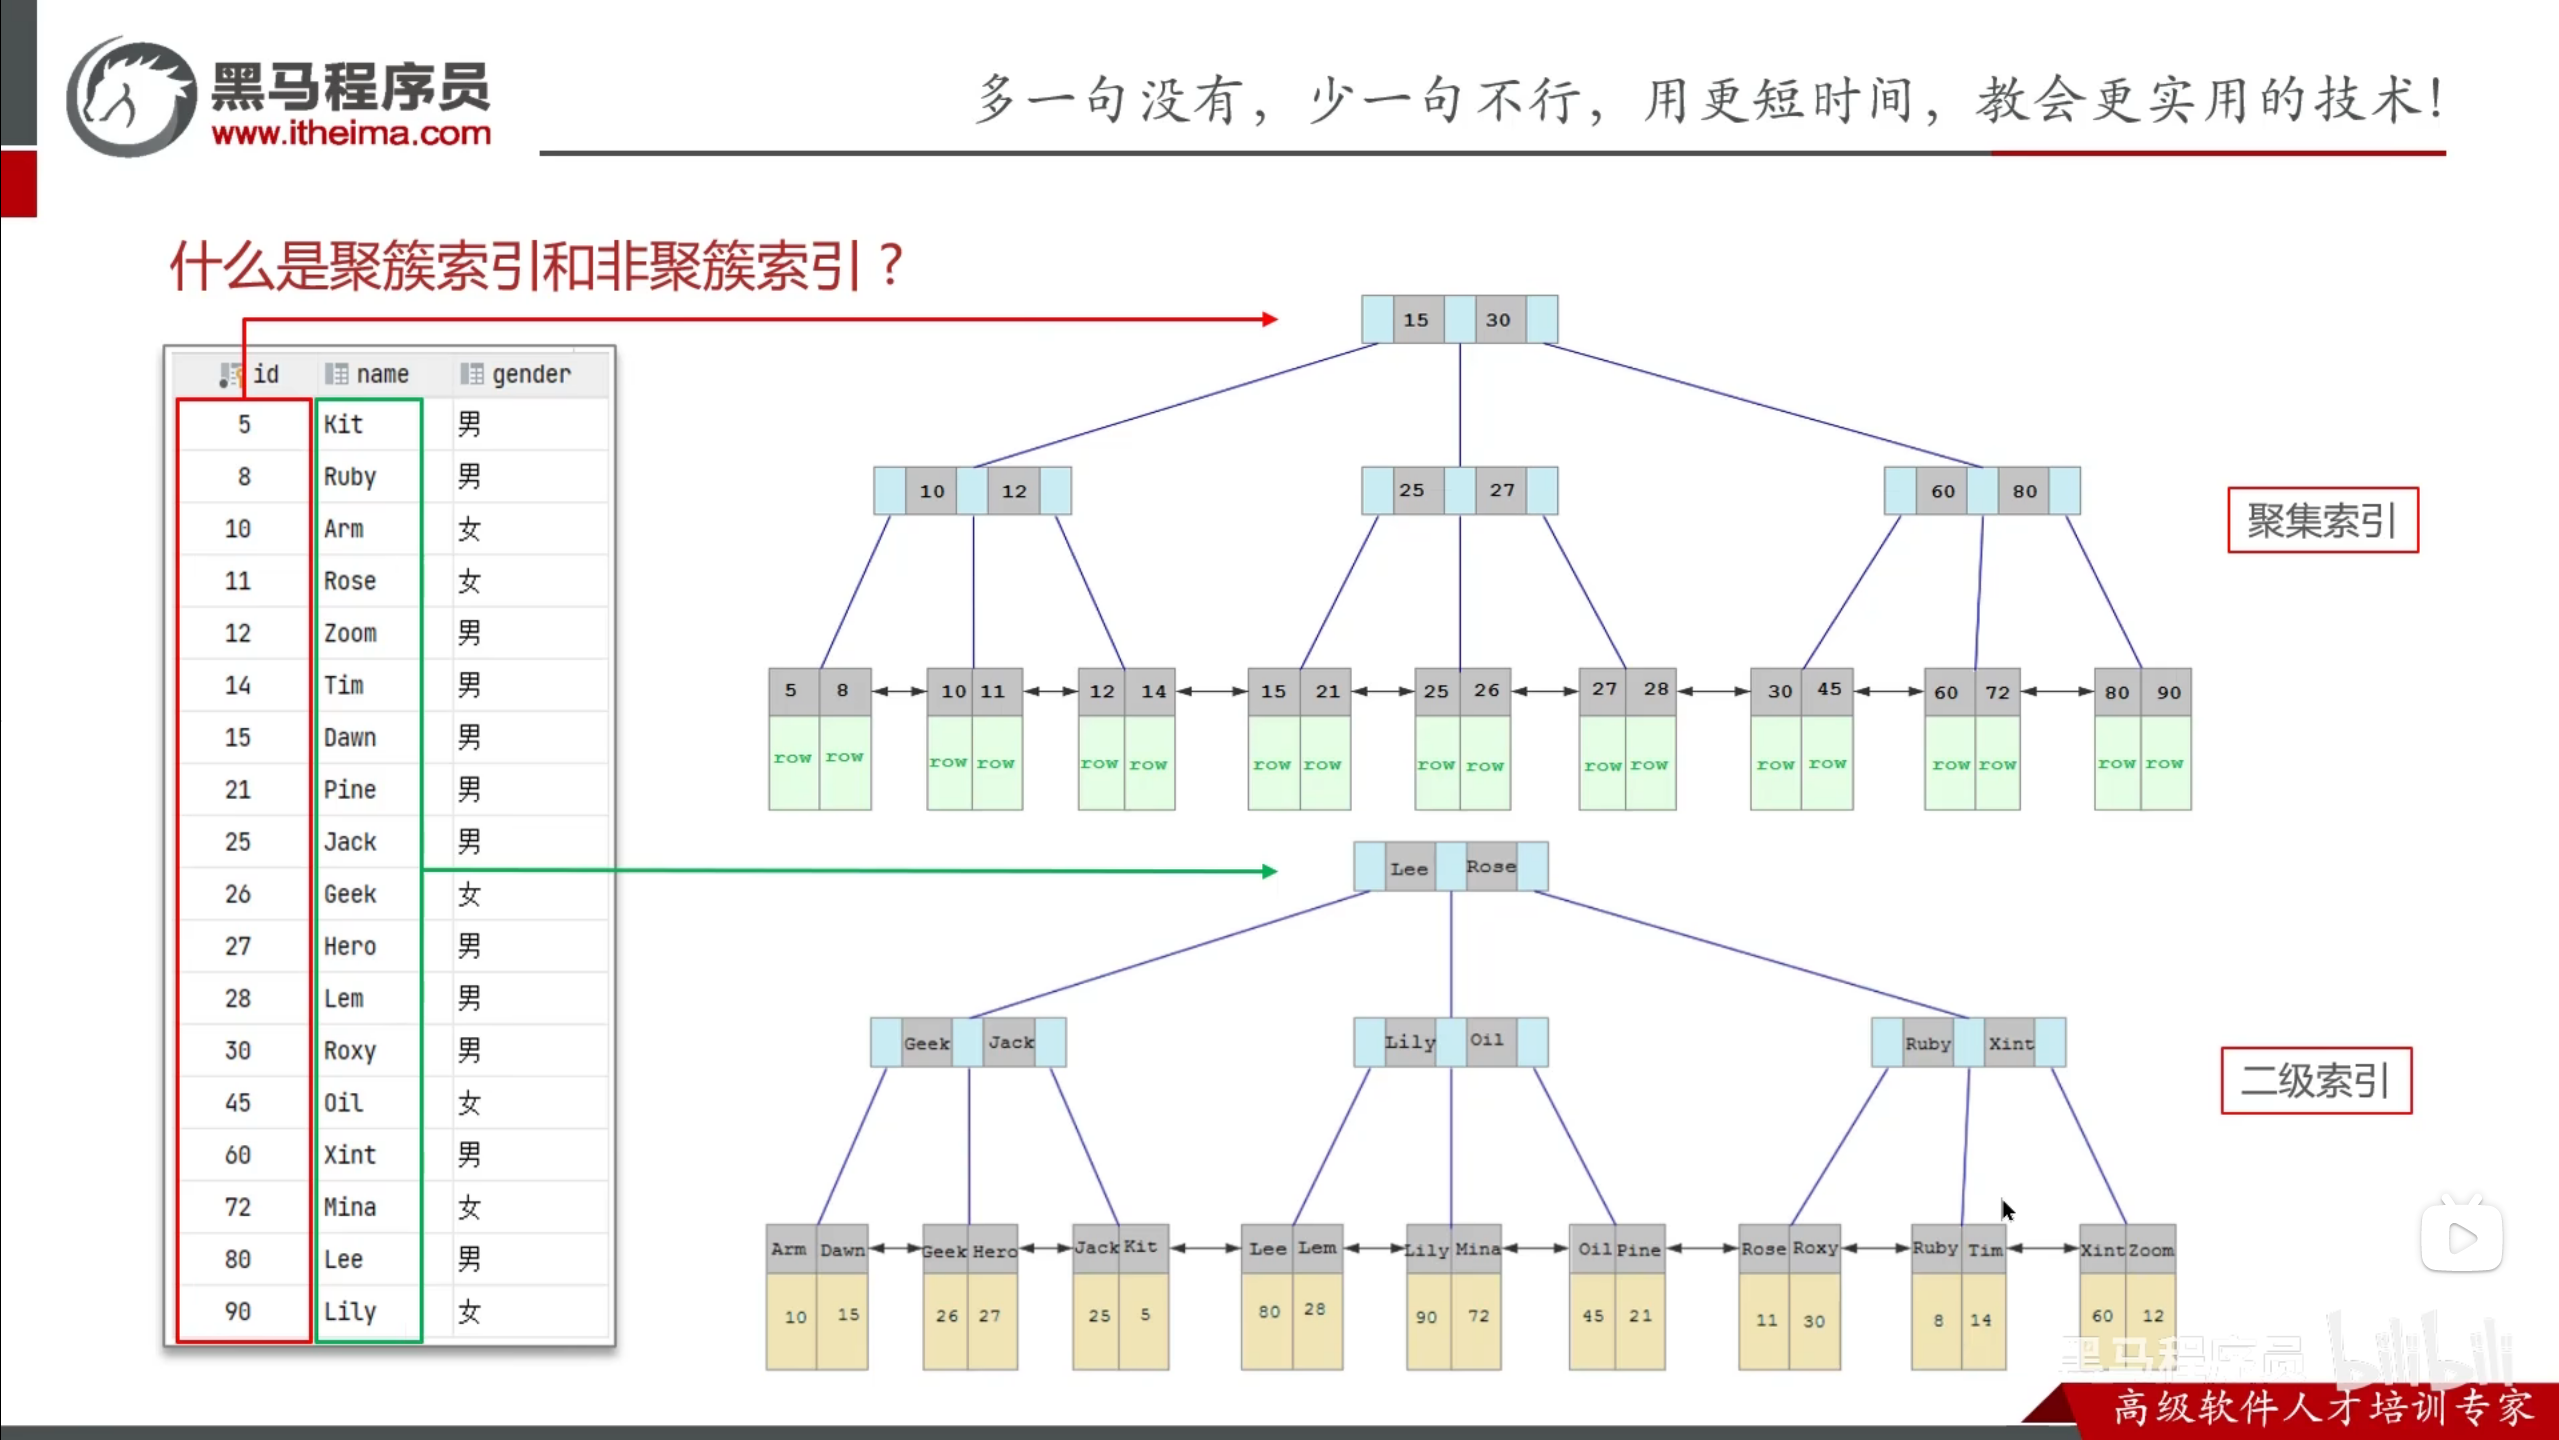
聚集索引可以理解为主键,当然有可能主键不存在,这时就会以唯一索引来作为聚集索引;当这两个都没有时,innoDB会自动生成一个隐藏的聚集索引。聚集索引在B+数中的叶子节点存放了整行数据的索引
什么是非聚集索引呢?非聚集索引可以创建多个,当我们经常查询某个字段的数据时就可以把这个字段变成索引,这个索引就是飞聚集索引,非聚集索引的叶子节点只存建立了索引的字段数据个聚集索引。
什么是回表查询呢?
如下图当我们通过select * from user name = kit查询数据时,数据库会采用聚集索引,先通过那么=kit去二级索引中查找到这个数据,这个二级索引会存有聚集索引,然后回到聚集索引查找完整的数据
什么是覆盖索引呢?
覆盖索引就是使用了索引并且能一次查全数据的的索引,比如上面的二级索引,当我们使用select id name from name = 'kit'这条sql语句就使用了覆盖索引。
MySQL的超大分页查询处理
什么是MySQL的超大分页查询呢?就是要比如select * from user limit 9000000,10;这个sql会去数据库里查询9000010条数据(包括数据和主键),即使是这个查询走的是聚合索引,查索引9000010条数据的磁盘io也非常慢。覆盖所以+子查询select * from user u(select id from user limit 90000,10) t where u.id = t.id;这个覆盖索引+子查询的执行顺序是先子查询select id user limit 9000000,10.因为这个是id很小,不像上面的 * 存在大量数据的磁盘io故查询速度会快很多很快就能找到需要的10个id,最后select * from user u (10个id)t where u.id = t.id;这个还是聚合索引速度会非常快,最终查到数据,增加效率
什么时候需要创建索引?
创建索引的前提是数据量足够大且查询频繁的表,创建索引的字段要常作为查询条件,排序条件,分组字段,创建索引时还要尽量使用联合索引,这样能减少回表查询的次数提高效率,还要控制索引的数量,因为这个表不止有查,还有增删改,索引过多增删改的束缚就会越大而得不偿失。
什么情况下索引会失效?
1.违反了最左法则:联合索引是有顺序的,当一联合索引中跳过了左边的索引整个索引就失效
2.范围查找右边的索引会失效:当三个联合索引查询时,中间的索引使用了范围查询,中间索引的右边索引会失效;失效也不一定是回表查询,例如查的就是a,b,c三个联合索引的字段,只是索引失效则需要在符合a和b的数据上读取符合c的数据。
3.不要再索引上进行运算操作,索引上进行运算操作索引会失效
4.进行索引查询时字符串不加 ' ' 这个单引号索引也会失效
5.以%开头的模糊查询索引也会失效。
事务的特性是什么?
原子性:事务是不可分割的单位,要么全部成功,要么全部失败。
一致性:事务完成时数据必须保持一直,数据不能凭空产生也不能凭消失
隔离性:数据库系统提供的隔离系统,保证事务不受外部并发操作的影响
持久性:事务一旦提交或回滚,数据库中的数据改变就是永久的。
举例分析:银行转账:当张三给李四转账,不能因为张三转账200块钱给李四的瞬间机器坏了而扣掉张三的钱没给李四加钱这个是原子性;隔离性:假如张三和王五同时给李四转账,不会因为两个人是并发操作导致李四的账户钱变多变少;一致性:原本张三只有500块钱,李四有300块钱,转账后资产总和不能改变还得是800块钱;持久性:转账成功后,钱就扣了,不能因为机器坏了就不扣了。原子性,隔离性和持久性都是为了一致性。
事务的并发问题
脏读:脏读就是读取别人修改但未提交的数据,这个数据对方可能会回滚,比如老王去查余额,此时张三给老王转账了500块钱,但转账的瞬间机器坏了事务未提交,老王读到的是张三转账后的数据,但老王下次来查询可能会查到张三转帐前的数据
重复读:重复读是读到别人修改了并提交的数据,比如老王去查余额,第一次查到500块钱,此时老李给老王转账500块钱,,老王第二次查余额看到余额多了500块钱,这就是重复读。
幻读:幻读主要说的是范围查询;比如老王的老婆去银行查询老王有多少张银行卡,此时老王有3张银行卡,就在查完的瞬间,老王有办理了一张卡,老王的老婆再次查询查到了老王有四张卡。
MySQL的日志undo log和redo log
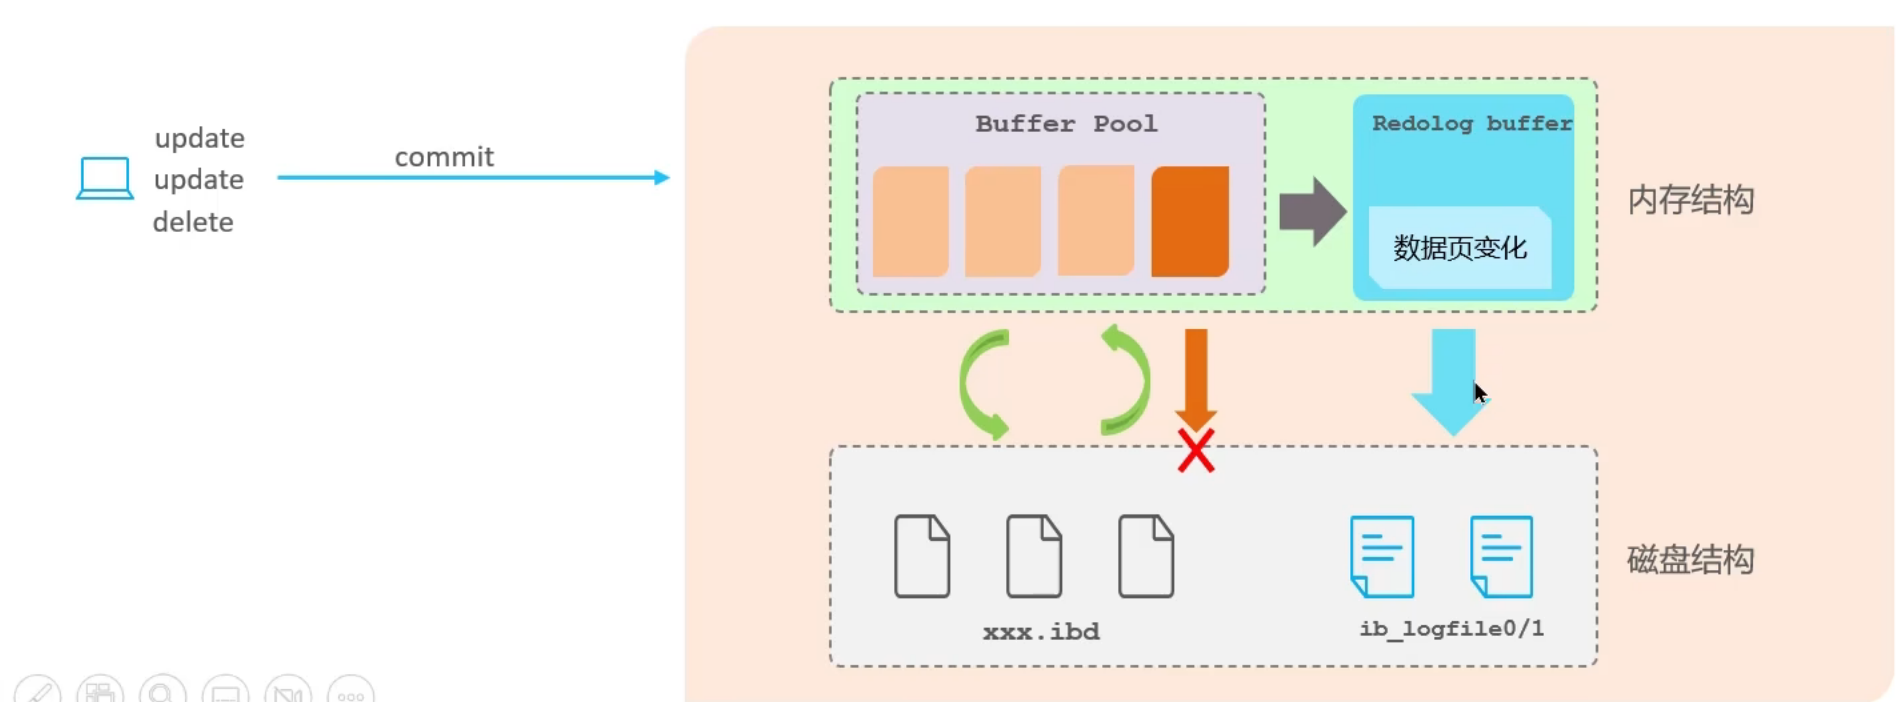
redo log:redo log 是记录的是数据也的物理变化,可用于服务器宕机时的数据恢复。流程如下:
当内存缓冲区的数据发生变化时会记录一redo log日志,并且同步到磁盘中的日志文件,如果此时服务器宕机了重启时就会根据磁盘的日志文件进行恢复数据,如果服务器没有宕机,缓冲区的数据就会按顺序写入磁盘。这个redo log主要就是保证了事务的持久性
undo log:undo log主要记录的是逻辑日志,比如update user set money = 500where id = 1;undolog会记录这个sql语句,当服务器宕机时可以通过这个undo log来进行事务的回滚
简单来说redo log 是保证了事务的持久性,undo log保证了事务的原子性和一致性
MySQL的主从同步的原理
MySQL主从同步的核心就是二进制文件binglog,binglog主要记录的是ddl(对表的操作)和dml(增删改的操作),从库会读取主库的文件binglog到自己的relay log中,后续会开启一个线程去执行relay log文件进行主从同步。
分库分表
分库分表的前提:数据量无限增大,主从分离,查询增加索引已经解决不了性能的优化了就需要分库分表了
分库分表有垂直分库,垂直分表和水平分库水平分表
垂直分库:以表为依据,根据业务的不同进行不同表拆分到不同的数据库中,特点是能进行分级管理,更方便维护监控和扩展;并且在高并发的场景下提高磁盘io和数据连接。
垂直分表:以字段为依据,根据字段的属性将不同的字段拆分到不同的表中。拆分的原则是可以将不常用的字段拆分到一个表中,把text等大字段拆分出来放到附表中;好处:常用与不常用的分开:冷热分离,减少io的过度争抢;拆分大字段的好处:提高的单页存储的行数,MySQL的的数据页只有16kb,大字段可能超过16ke造成溢出;减少无用的io,大字段大多数情况也是不常用字段,并且大字段数据量过大,会产生很多无用io;
水平分库:将一个库的数据拆分到不同的数据库中,拆分的依据是数据量非常大,大到一个数据库装不下了。此时会有一个问题,Java程序怎么能找到数据所在的数据库呢?可以根据路由规则,比如用id节点取模;根据id的范围查找;水平分库的好处是解决了单库的大数量,高并发的场景问题,提高了系统的稳定性和可用性
水平分表:将一个表的数据拆分成多个表(在同一个库中);优点是优化了单表的数据量过大的性能,避免了io争抢和减少锁表的几率。