pytorch中如何读取数据主要是涉及到两类,一类是dataset,一类是dataloader.
左侧的数据类比为垃圾,不同颜色代表不同类型的垃圾。蓝色是可回收的垃圾,也就是我们的目标数据。
dataset主要是告诉我们,我们如何去获取其中的垃圾。我们想把蓝色的可回收垃圾提取出来,并且能完成对蓝色垃圾的编号。当我们想获取其中具体某一个垃圾的时候,就可以根据编号去获取其中的垃圾。同时每个数据还有对应的label.
dataset主要是提供一种方式去获取数据以及其对应的label值。
dataloader是对可回收垃圾进行打包,我们将数据送到网络中的时候,一般是一批批送进去的,会一批批打包压缩数据。dataloader是为后面的网络提供不同的数据形式。
我们知道神经网络经常是需要对一个数据迭代多次,只有当我们知道,我们总共有多少的数据要去训练的时候,它才知道我们要训练多少次才能把这整个数据集给它迭代完。
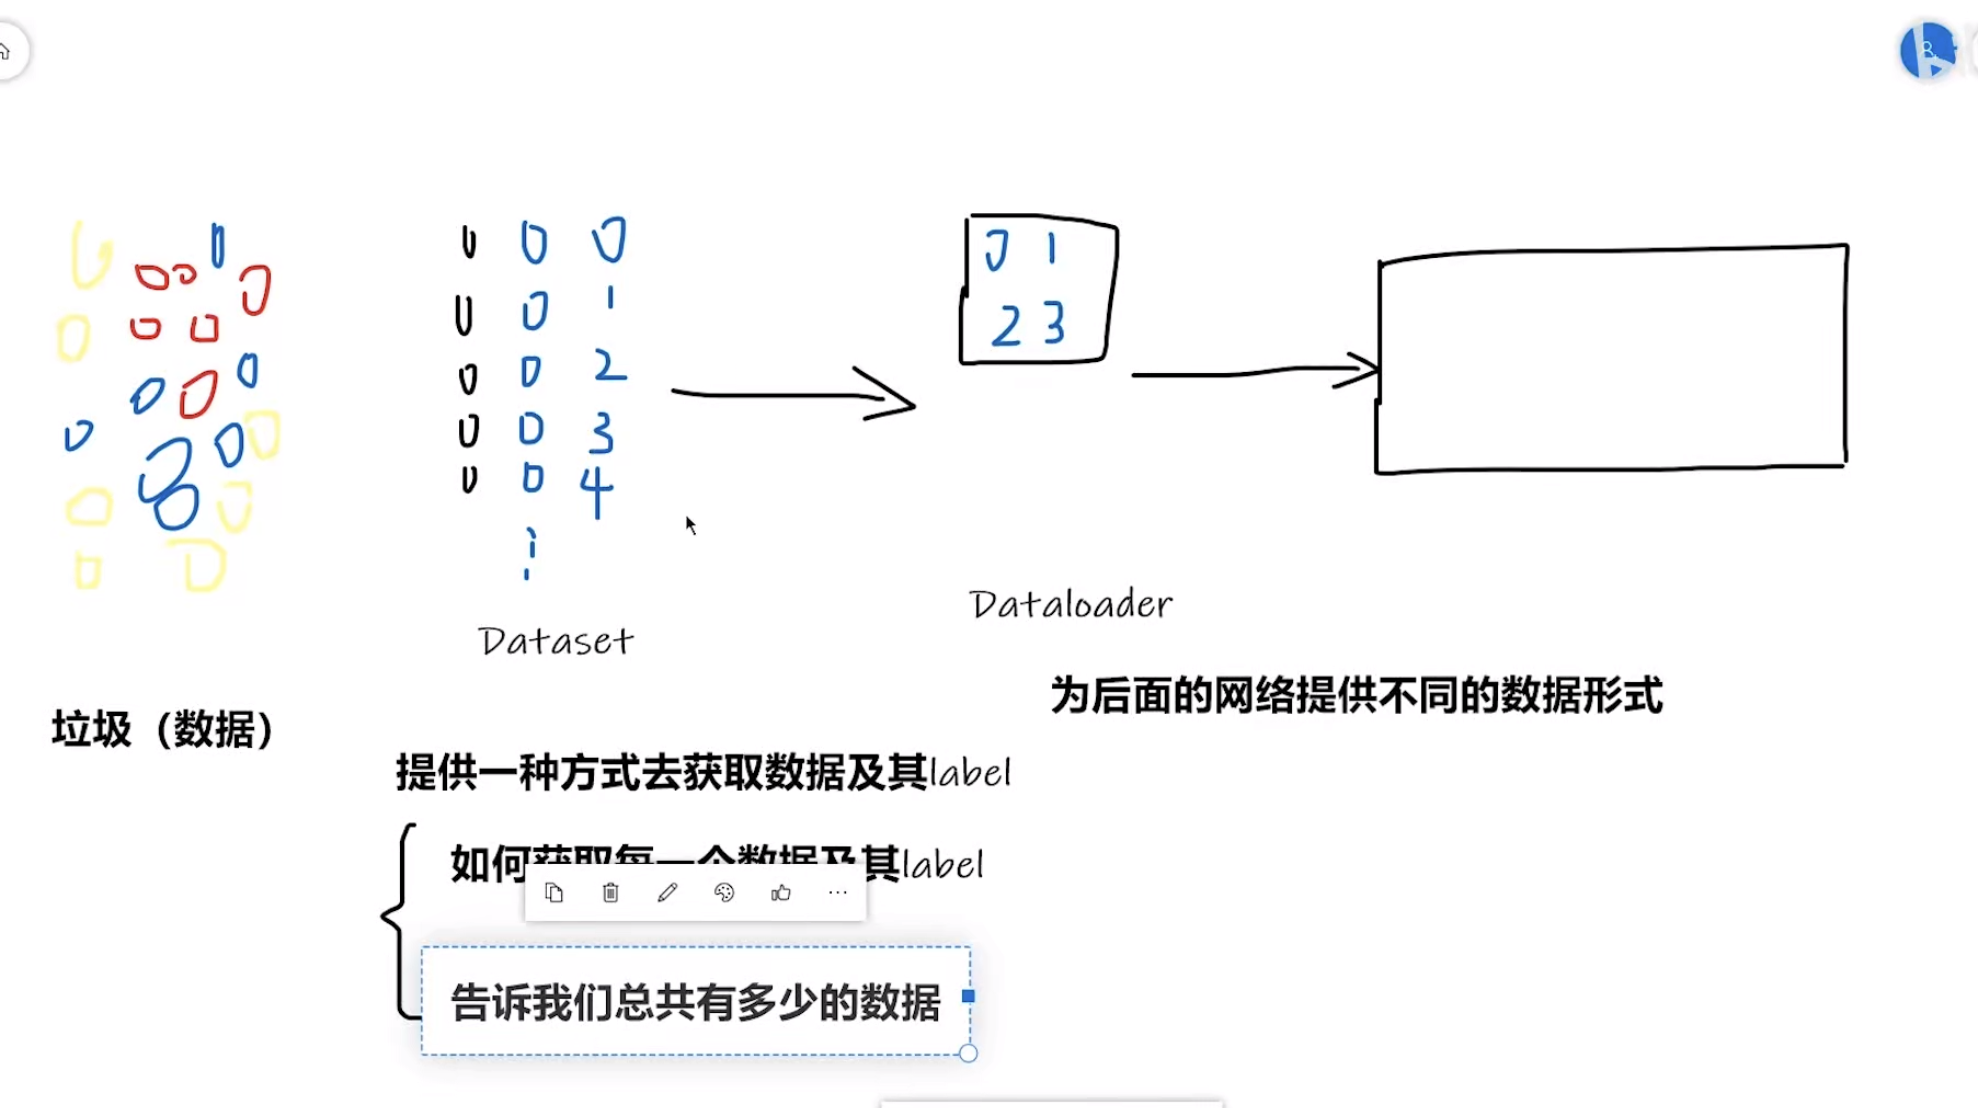
上图最右侧的是垃圾回收器。
我们先准备一个数据集如下:
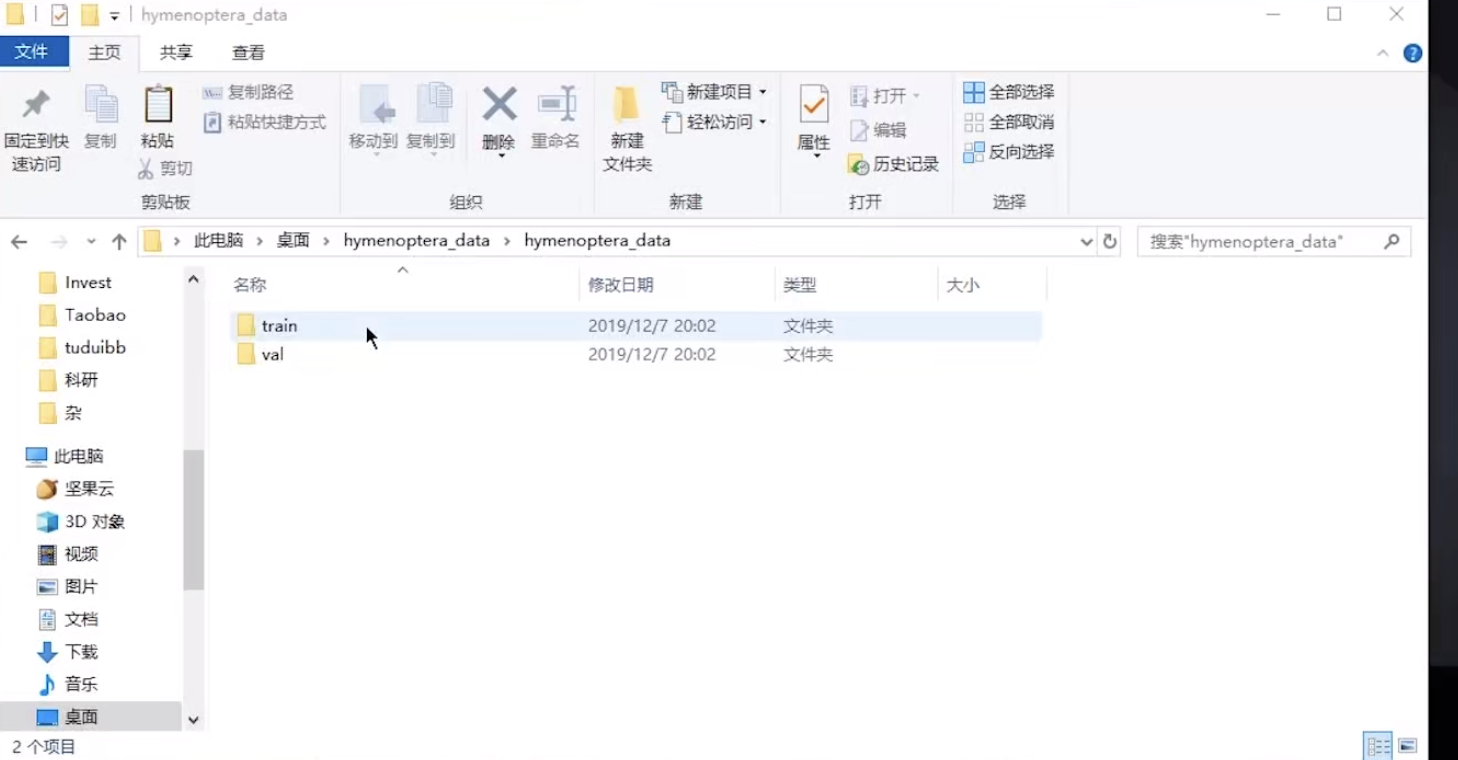
这个数据集首先分为了train训练数据集和val验证数据集。
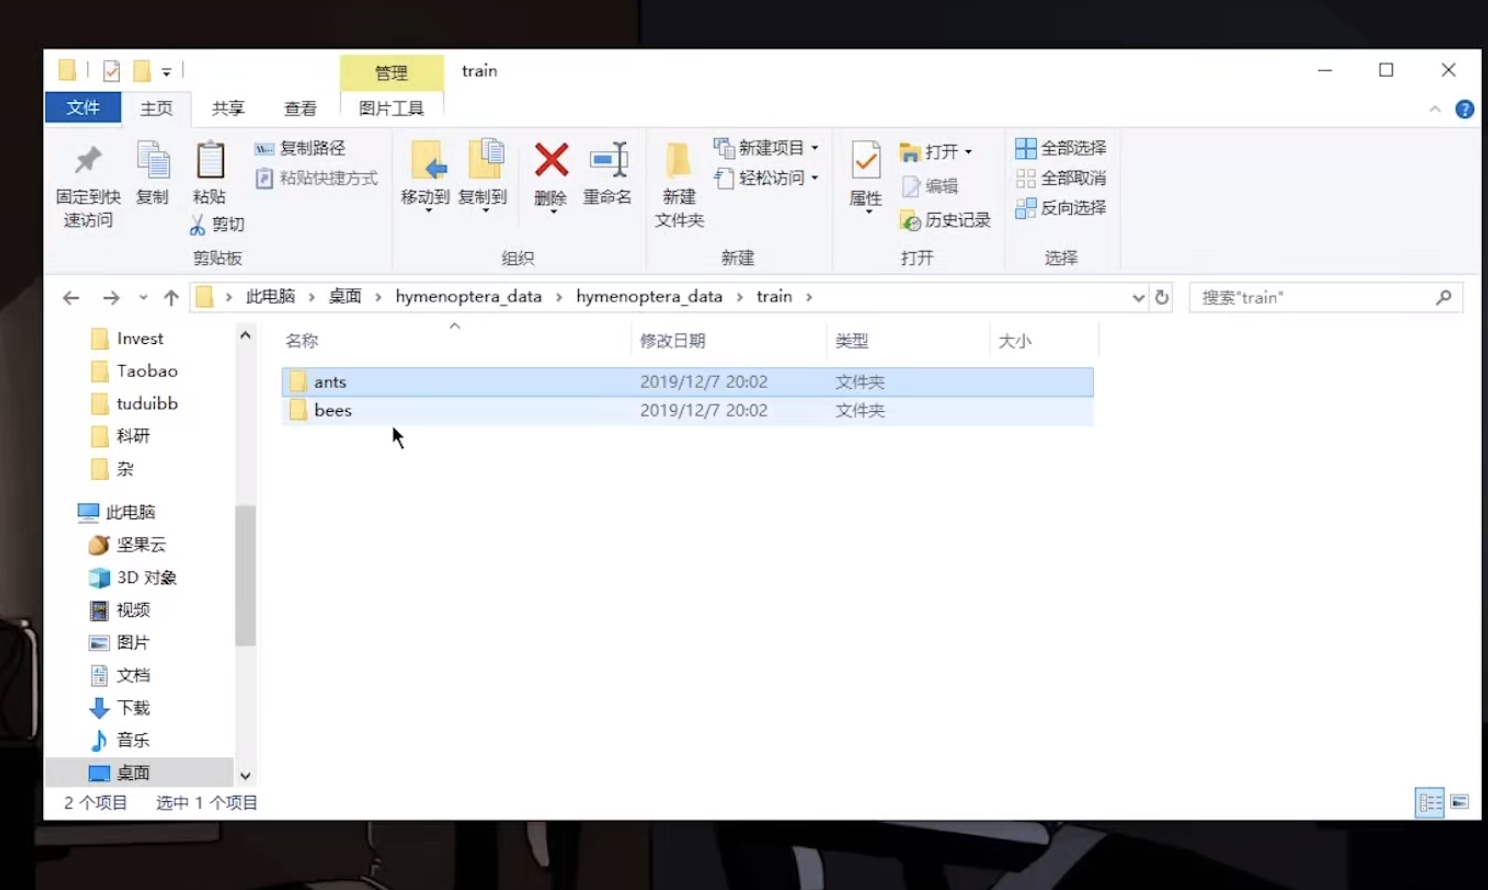
train训练数据集中有蚂蚁和蜜蜂文件夹,分别放置了大量蚂蚁和蜜蜂的图片。文件夹的名称就是这些图片所对应的label,也就是ants就是蚂蚁图片对应的label,bees是蜜蜂图片对应的label.
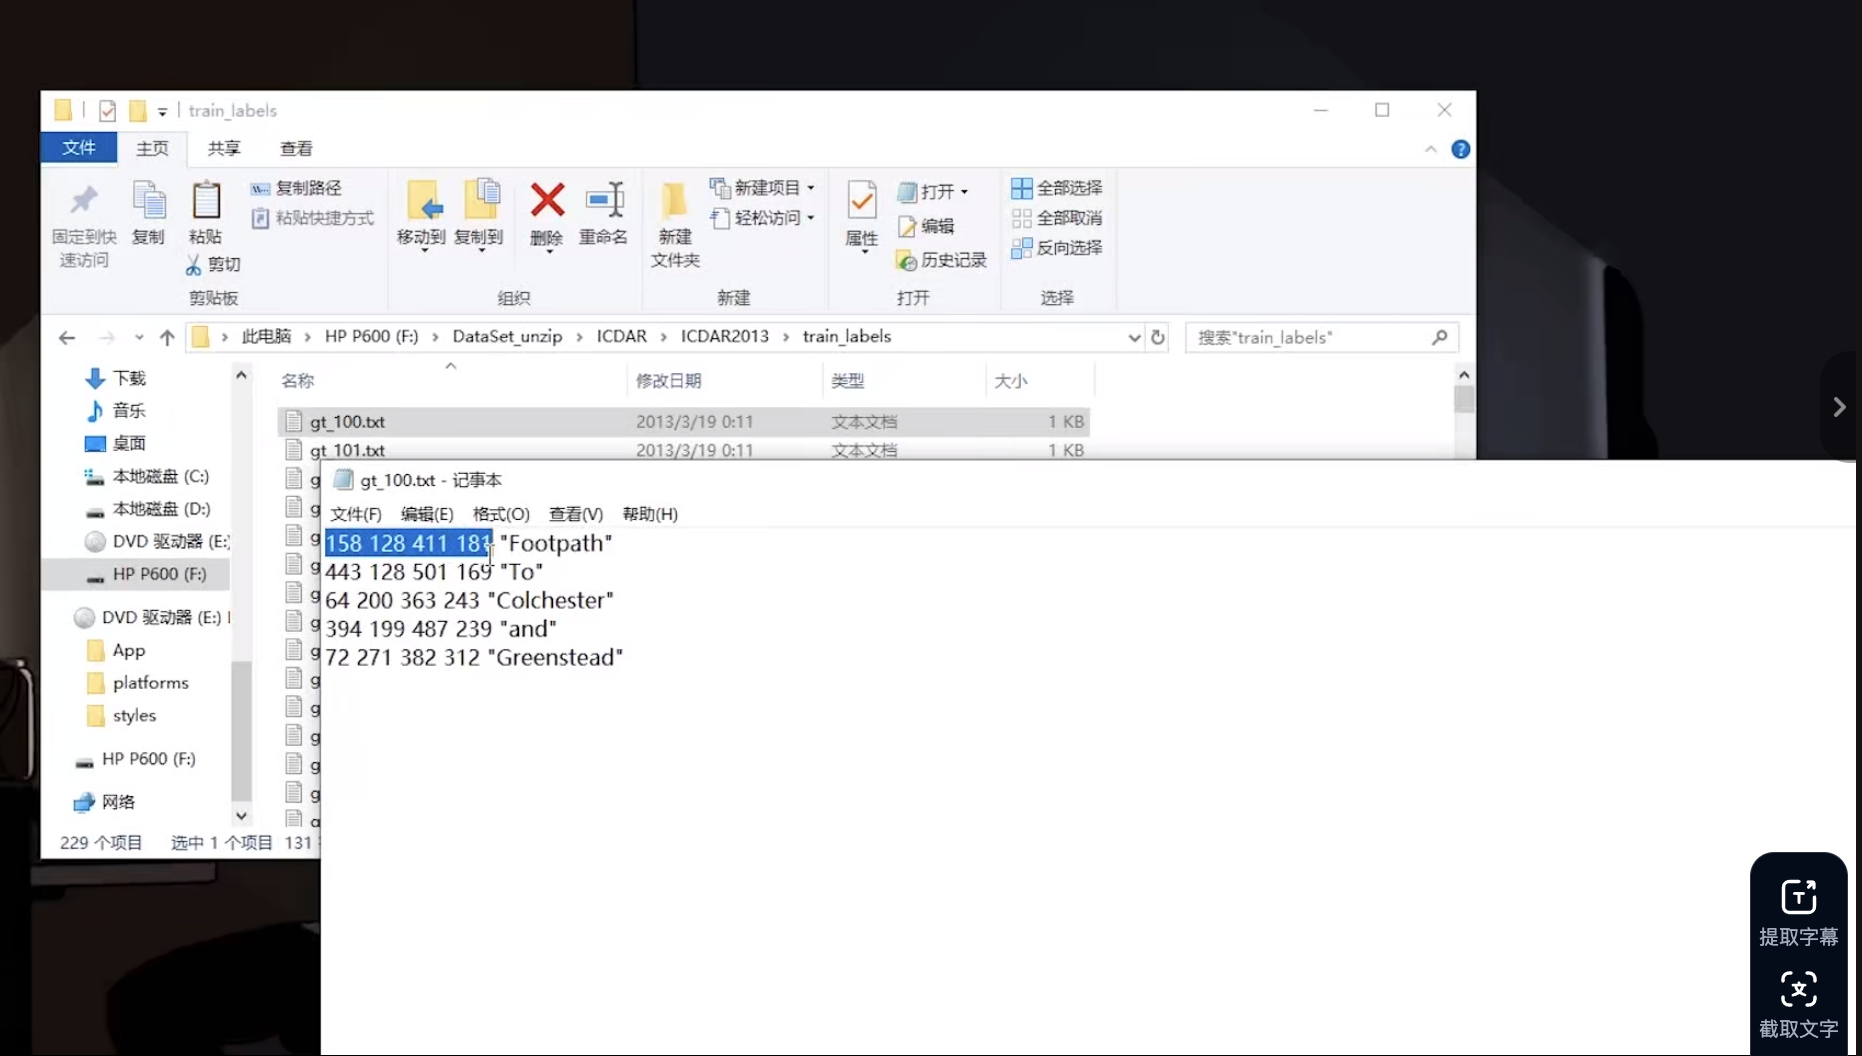
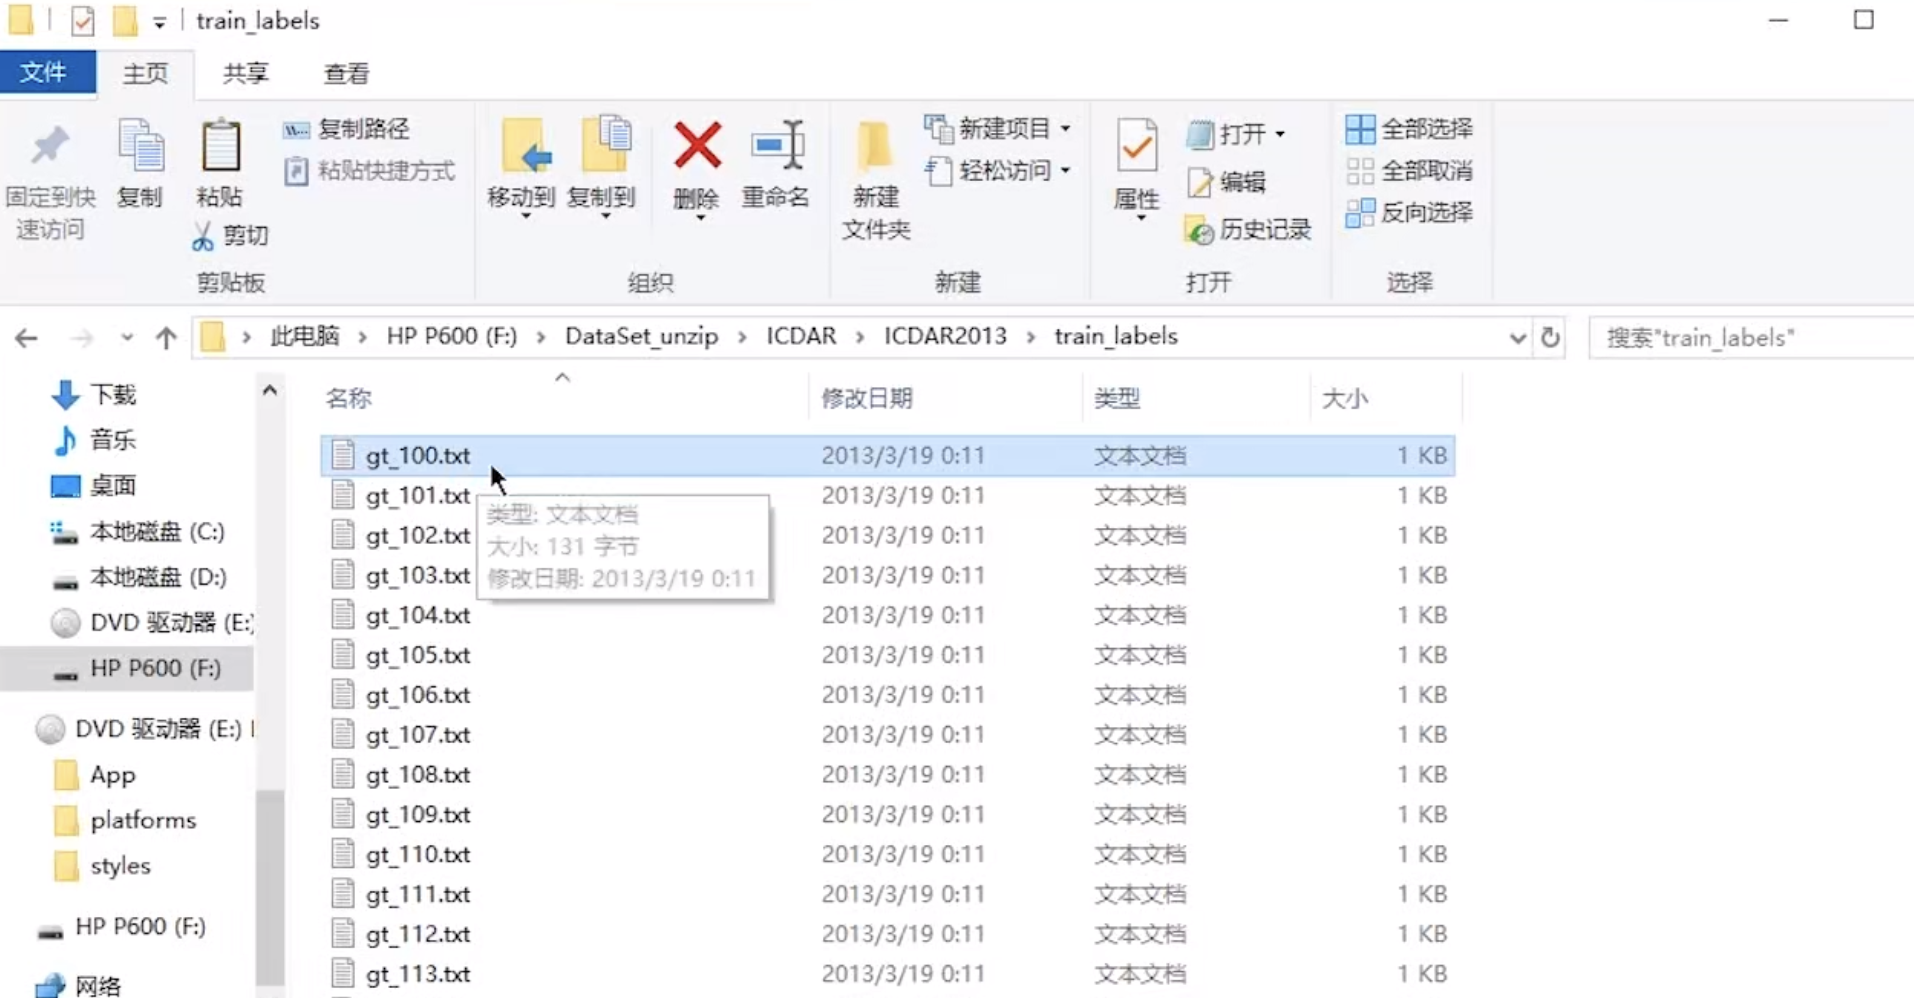
另外一种训练数据集的组成形式是如下这样的:
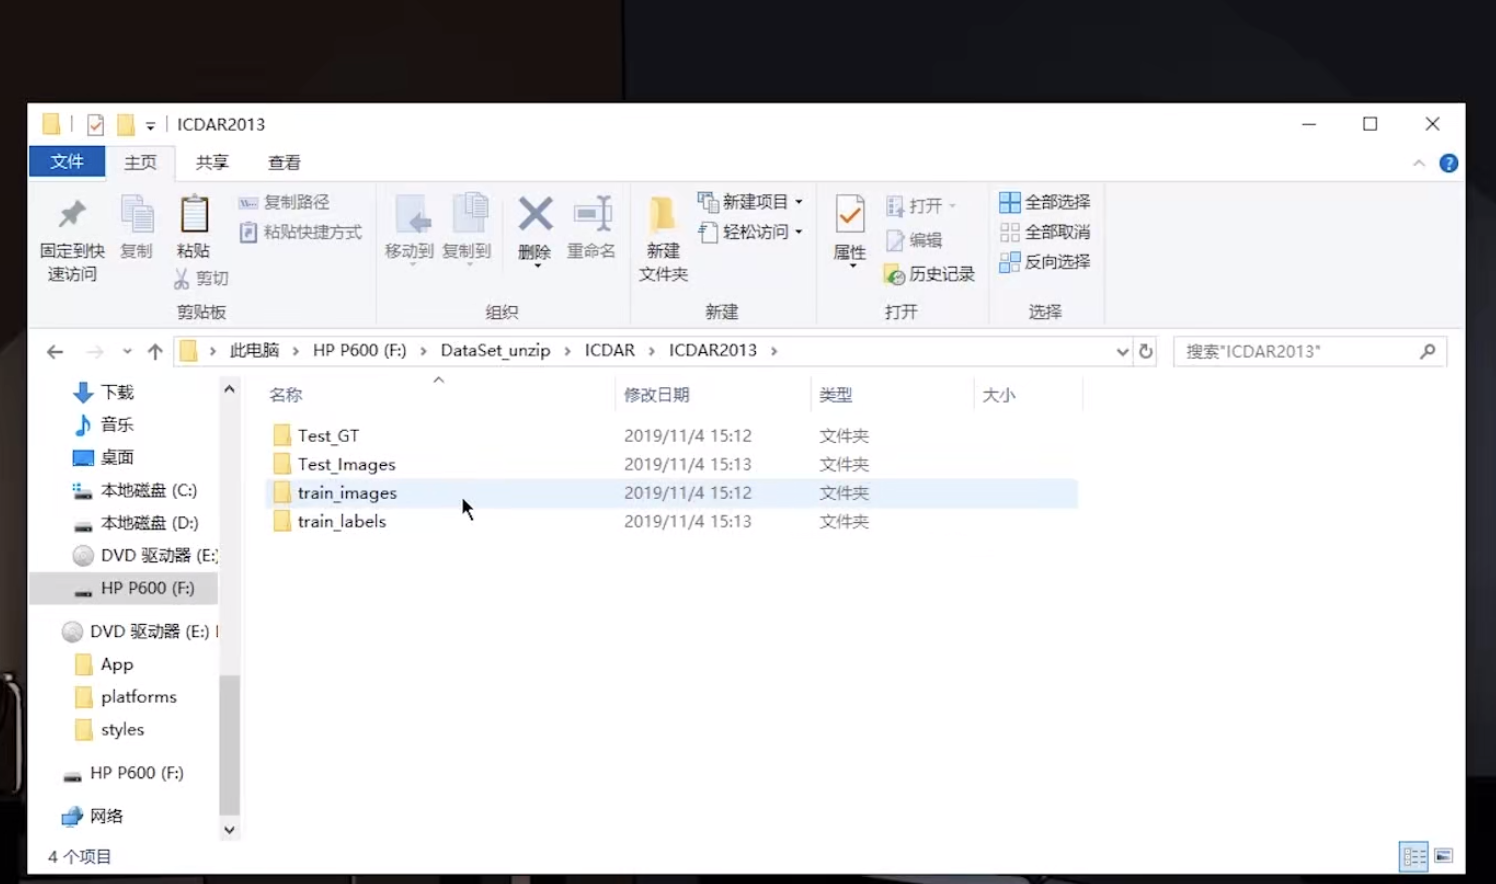
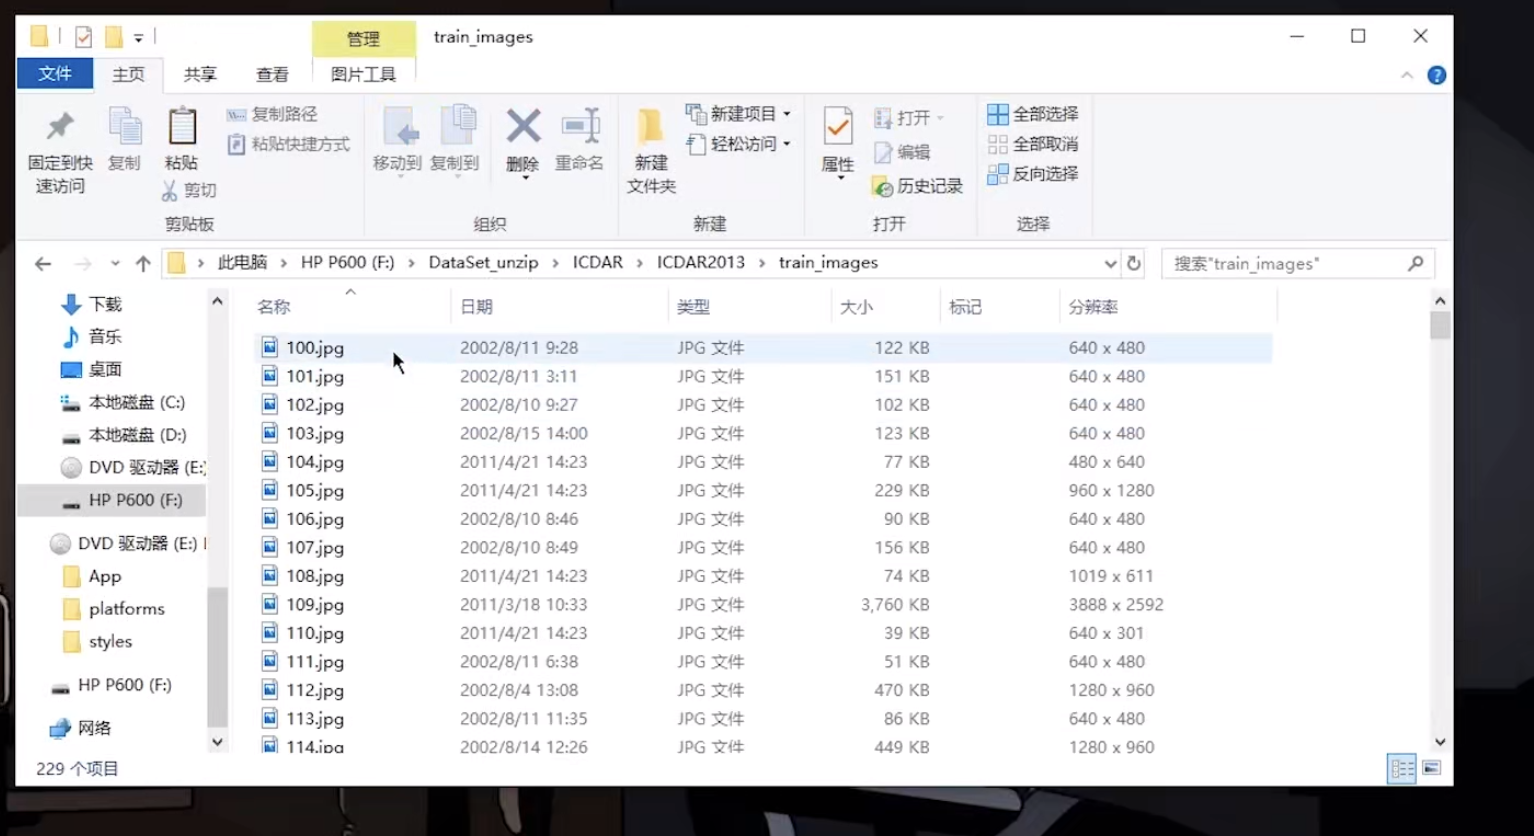
里面存储了坐标信息和这个文字里是什么。
第三种常用的数据组织形式是把label名写在图片的名称上面。
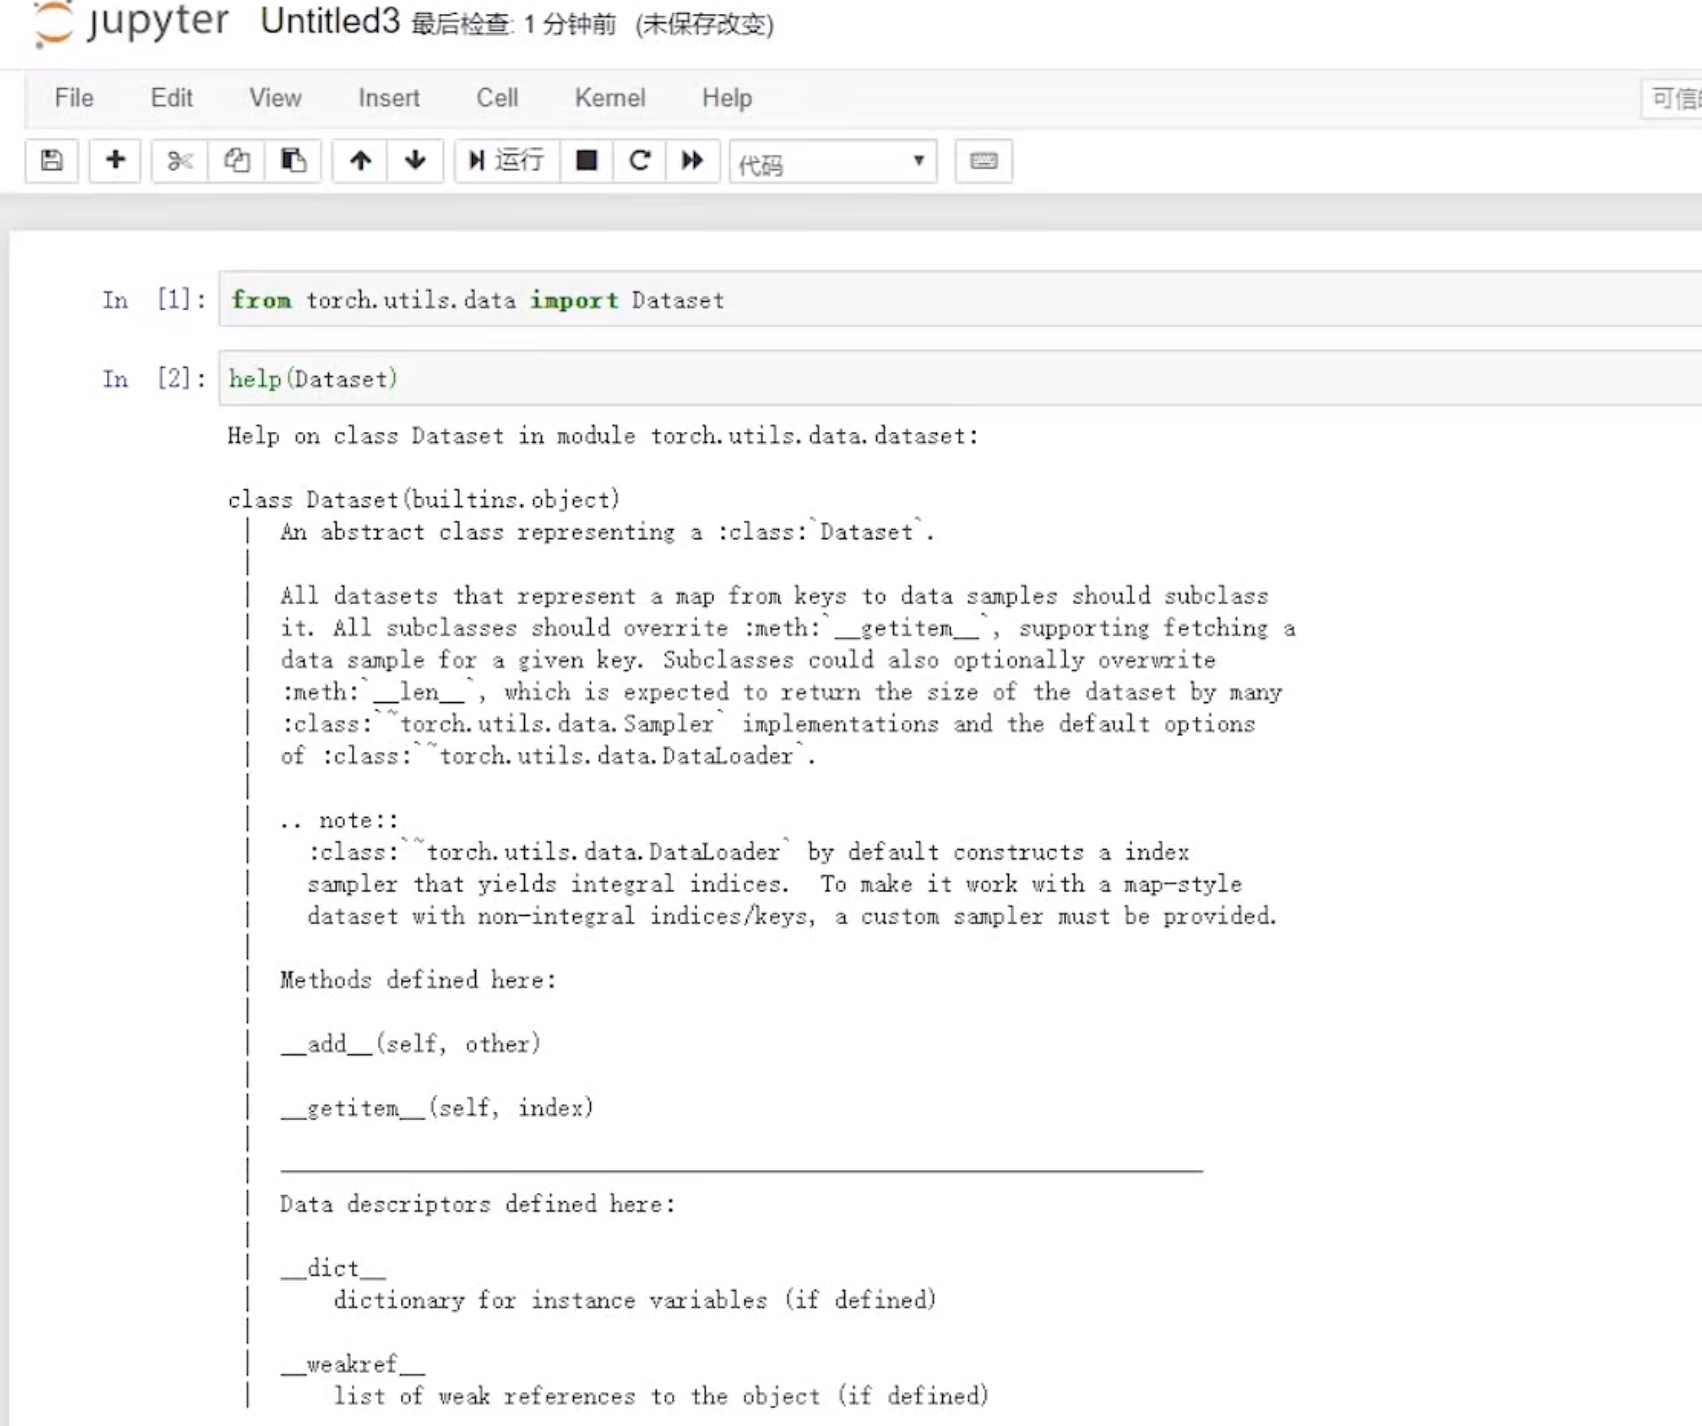
列头的方括号里星号变成数值,就表示这行代码执行完成了。
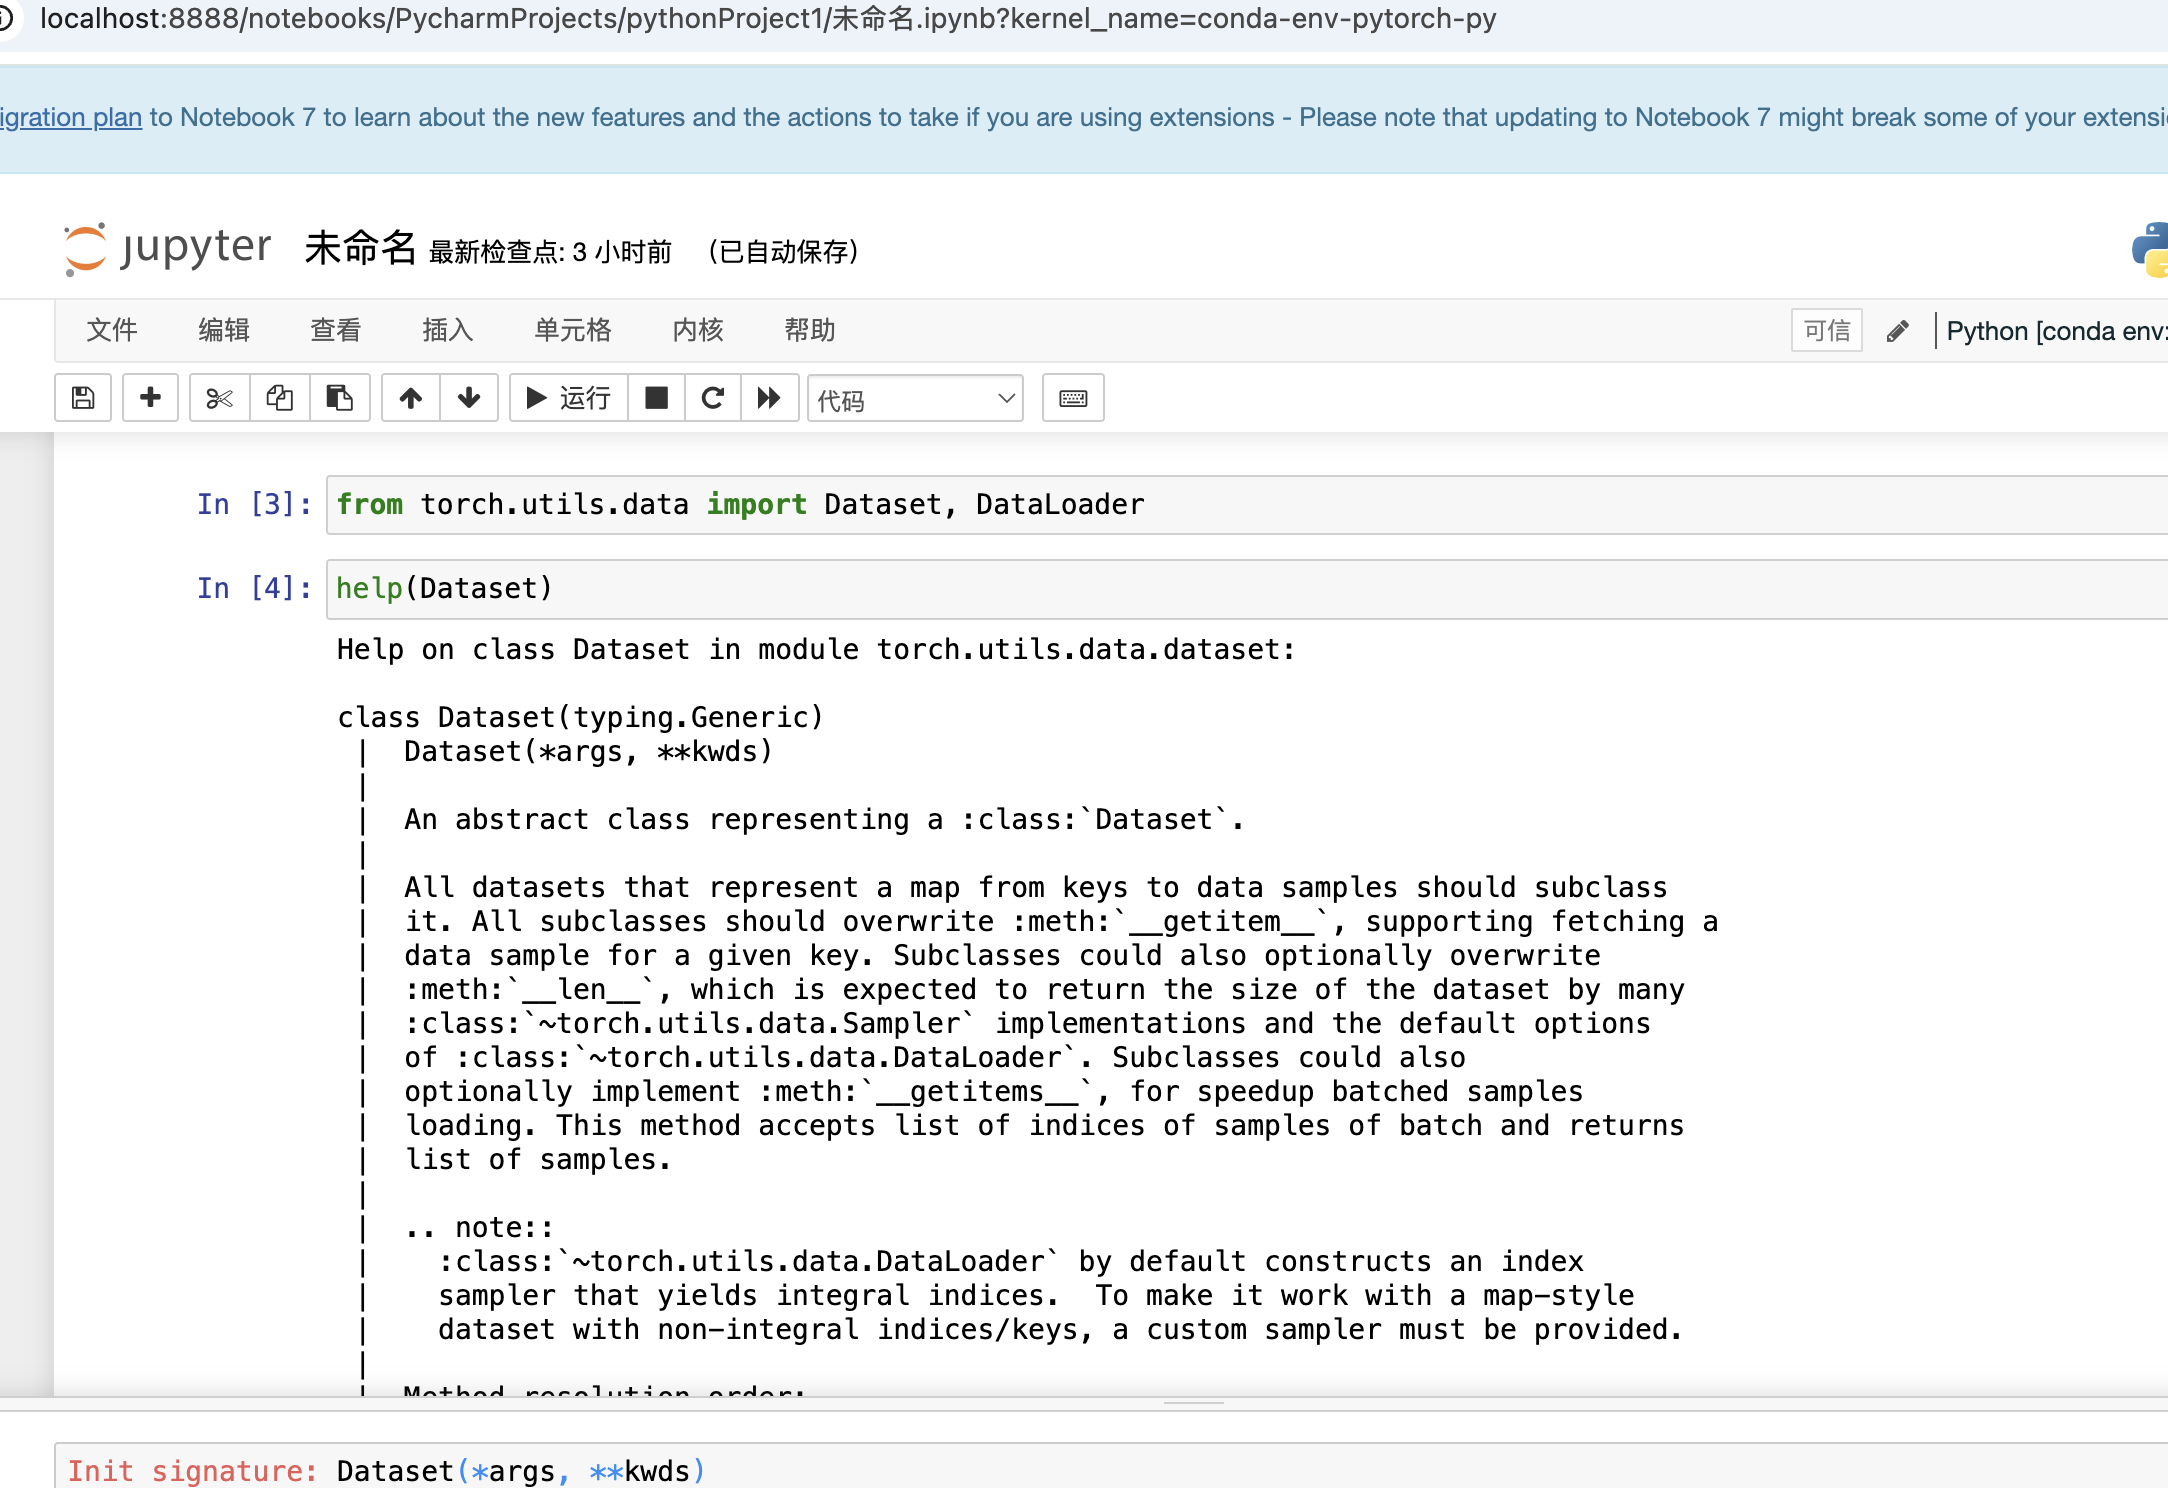
dataset??表示也是获取帮助文档的方式: